Після розділення програмістів: одна метрика для людей, які розробляють за допомогою AI-агентів
Це переклад. Основна версія — оригінал англійською; посилайтеся на неї.
Перевірений горизонт делегування, коефіцієнт посилення, датована карта назв ролей і 41 зареєстрована передбачення, оцінена щороку до 2031 року
Vadym Chernets, PhD, архітектор AI-систем · ORCID 0009-0007-4845-3163
SSRN 7589918 · DOI 10.2139/ssrn.7589918 · Zenodo 10.5281/zenodo.23267267 · GitHub
Завантажити цю статтю
- SSRN (офіційна версія): ssrn.com/abstract=7589918 · DOI 10.2139/ssrn.7589918
- Zenodo (архівована, вільний доступ): doi.org/10.5281/zenodo.23267266
- OSF (41 передбачення, зареєстровані 9 жовтня 2026): doi.org/10.17605/OSF.IO/VW6P9
- GitHub (повний текст як Markdown): github.com/vadimchernets/papers/tree/main/after-the-programmer-divide; код додатка В: github.com/vadimchernets/delegation-horizon
SSRN містить офіційну версію; посилайтеся на неї.
Ключові слова: AI-агенти; агентний AI; непрограмісти; агенти кодування; назви посад; найм на основі навичок; теорія принципала-агента; розробка ПО кінцевими користувачами; компетенція в галузі AI; перевірений горизонт делегування; точка перехрестя кваліфікацій; попередньо зареєстровані передбачення
Анотація
Бухгалтер просить агента про інструмент для звірки; розробник просить його змінити систему рахування. Кожен має прийняти роботу одного дня й показати, що вона витримує перевірку. До жовтня 2026 р. юристи теж ставили завдання тим же агентам. Приблизно в 400 000 сеансів верифікований постачальником успіх на роботах, що виробляють код, становив 34% для професій програмування та 29% для інших, хоч професія — це не освіта. Жодна кар'єрна сходинка не говорить, чого можна очікувати від людини, що будує через агентів. Я пропоную міру замість титулу. Верифікований горизонт делегування — це найбільший цільний фрагмент роботи, виміряний референтними годинами кваліфікованого фахівця, який людина регулярно передає агентам та приймає після незалежної перевірки, яку агенти не бачили. Коефіцієнт посилення, прийняті референтні години на годину уваги, — це верифікована пропускна спроможність, а не причинна оцінка прискорення. Обидва оцінюються за доменом, від Години до Квартала; настільна перевірка виправила один поріг. Три великих роботодавці спробували підрахувати жетони й відмовилися від них у 2026 р.: рейтинг видалено, таблицю лідерів зманіпульовано, бюджет витрачено. Перевірену роботу складніше обіграти витратами, та кожен залишившийся маршрут відповідає зазначеному захисту. Датована карта записує суперничаючі назви (будівельник, менеджер агента, принципал та інші) без вибору. Нейтральність фону — це гіпотеза про те, що при рівному горизонті освіта програмування перестає передбачувати перевірену якість. Точка переходу кредентіалу — це момент, доменом за доменом, коли продукти людей без IT-освіти починають випереджати продукти програмістів під тими ж перевірками, після чого ступені й етикетки старшинства втрачають вагу. Сорок одне датоване передбачення, оцінене 9 жовтня 2026 р. за медіаною трьох сліпих прогнозів моделей, зареєстровані на OSF та оцінюються щорічно до 2031 р.; дослідження, яке ніколи не проводилося, вважається невдачею, та випередження в своєму домені становить 0,35.
Виконавче резюме
На 2026 рік бухгалтери порівнювали агентів кодування так, як програмісти робили роком раніше, адвокати будували свої власні інструменти з ними, а люди поза сферою програмного забезпечення стали швидко зростаючою частиною користувачів агентів кодування одного постачальника; у записах іншого постачальника, близько 400 000 сесій, професії, які не займаються програмуванням, відстали від програмістів на кілька відсоткових пунктів у перевіреному успіху на кодовій роботі (34% проти 29%). Там, де виконується робота, межа між програмістами та всіма іншими стала тонкою. У назвах посад, рівнях оплати та резюме вона залишається там, де вона була.
Деякі програмісти та деякі фахівці предметної області тепер поділяють робочий процес: вони передають роботу агентам і вирішують, чи прийняти її. Завдання та робочі процеси об'єдналися попереду цілих професій, тому інформативне питання про людину — як великий шматок роботи вони можуть передати і довести, з якої б сторони старої межі вони не походили. Міра, яку я пропоную для цього питання, горизонт перевіреної делегування, спирається на кілька проектних рішень, і це резюме дає причину для кожного. Одиниця — це час, який потрібен був би кваліфікований фахівець (година, день, тиждень, місяць, квартал), тому що обидві старі ієрархії можуть це прочитати, і не потрібно перекладу між професіями. Інструмент узгодження бухгалтера та зміна виставлення рахунків розробника дотримуються того ж правила. Рахується лише робота, яка пройшла перевірку, яку агенти не бачили, і узгодження між моделями однієї родини не рахується такою перевіркою, тому що їхні помилки корельовані. Друге число, коефіцієнт посилення, записує, скільки перевіреної роботи кожна година уваги людини дає (невдала робота все ще коштує уваги, а непідконтрольний час агентів — ні), так що той, хто працює поруч з агентом у коротких циклах, одержує кредит так само, як той, хто передає великі шматки. Обидва числа зберігаються за доменом з симетричної причини: адвокат, який переходить до програмного забезпечення, та програміст, який переходить до права, втрачають те ж саме — здатність прийняти роботу в галузі, яку вони не знають. Пороги версіонуються як правила v1.1 та перевірені на столі, і тест за столом уже виправив один з них (Додаток E).
Назви ще не встановлені. Builder, agentic engineer, agent manager, AI operator, orchestrator та principal — усі використовуються у жовтні 2026, кожна з власником та датою. Я наношу їх на карту без вибору, щоб яка б не переможила, можна було прочитати в одній шкалі: розробник на тиждень, менеджер агента на день.
Ринок уже спробував скорочений шлях. У 2026 році підрахунки токенів були спробовані як міра персоналу у великих роботодавців та не вдалися протягом кількох місяців: неофіційний рейтинг працівника в Meta був видалений, а офіційні вказівки компанії пізніше виключили підрахунки токенів, таблиця лідерів на Amazon була маніпульована порожніми завданнями та видалена, а Uber витратив свій щорічний бюджет AI протягом чотирьох місяців. Підрахунок входів винагороджує витрачання. Підрахунок прийнятої роботи, перевіреної незалежно, важче надмірно завищити таким чином за конструкцією. Способи, які залишилися (легкі перевірки, щедрі оцінювачі, прихована допомога та робота розрізана на шматки), кожен зустрічає захист у розділі 5.8: випадкові аудити, незалежні оцінювачі годин, публічний реєстр збоїв, узгоджена одиниця роботи та внесені помилки.
Два передбачення несуть мою датовану тезу. Нейтральність тла говорить, що на тому ж щаблі освіта програмування припиняє передбачати перевірену якість. Точка перехрестя облік — це момент у галузі, коли продукти, створені людьми без освіти в ІТ, починають переважати ті, які розробили програмісти, які використовують тих же агентів, після чого ступінь та мітки «молодший» та «старший» втрачають вагу. Паритет якості приходить раніше цього моменту, перехід вимог до ступеня в оголошеннях про роботу є його видимим знаком, і кожна частина датована та перевірена окремо. Основне передбачення суперечить поточній думці, і стаття говорить так там, де вона його висловлює. Кожне передбачення також називає результат, який його спростував би, так що читач може заздалегідь побачити, як виглядатиме провал. Усі 41 з'являються в таблиці з імовірностями, порогами, резервними джерелами та кінцевими датами, зареєстровані на OSF 9 жовтня 2026 (DOI 10.17605/OSF.IO/VW6P9) та оцінені за правилом Брієра кожного року до 2031. Двадцять сім розв'язуються на основі публічних даних. Чотирнадцять потребують дослідження, зареєстрованих окремо перед збиранням даних, і відсутні або неоднозначні докази записуються як невирішені та не рахуються як успіх; дослідження, яке ніколи не проводилося, є невдачею програми тестування та залишається в таблиці результатів. Імовірності були зафіксовані 9 жовтня 2026 року як медіана трьох сліпих прогнозів моделей, які я прийняв, і зареєстровані на OSF; імовірність переважання у своїй галузі становить 0,35.
Коли будівництво коштує мало, довіра стає рідкісним фільтром. Магазини додатків та хости коду затоплені, платформи закривають двері невідомим учасникам, і агенти все більше пишуть рішення замість того, щоб прийняти чуже. Поруч з людиною, яка будує, видимі дві партнерські функції: завершувач приносить продукт людям, а гарант підписується за нього. Друга назва походить від опису ролі з 2025 року, і я також пропоную міру для гаранта.
1. Вступ
23 вересня 2026 року блог для бухгалтерів порівняв двох агентів кодування, Claude Code та Codex, для категоризації трансакцій та узгодження рахунків (Growthy, 2026). Рік раніше це порівняння належало програмістам, і в потоках програмістів воно й досі існує, з таборами та відданостями. Те, що змінилося, — це читач. Люди, які нині обирають між агентами, ведуть книги, пишуть контракти та проводять кампанії, а агенти, між якими вони обирають, — це ті, яких використовують розробники програмного забезпечення.
Десятиліттями економіка підтримувала дві драбини. У програмному забезпеченні сходинками були junior, середнього рівня, senior, staff та principal, оцінені за роками досвіду та кількістю інженерів, потрібних проекту. В інших місцях сходинками були аналітик, консультант, менеджер, директор та партнер. Драбини зустрічалися біля дверей IT-відділу в тому сенсі, що професіонал з другої драбини отримував програмне забезпечення, замовляючи його у когось з першої. У 2025 та 2026 роках обидві драбини почали описувати ту саму роботу. Розробники були повідомлені, що їхньою основною діяльністю стала делегування та верифікація (GitHub, 2025b). Професіонали поза програмним забезпеченням, з агентом у терміналі чи вікні стільниці, почали будувати інструменти, сайти та невеликі застосунки, які раніше замовляли (Bloomberg Law, 2026; OpenAI, 2026). Жодна драбина не говорить, що можна довіряти такій особі щось доставити, і жодна не говорить, як порівняти колишнього розробника з колишнім аналітиком, які тепер роблять ту саму роботу.
Наступні запитання стосуються того, як слід називати людей на об'єднаній стороні цієї границі, як слід вимірювати їхній рівень, коли диплом та роки служби перестають говорити роботодавцю, що вони можуть доставити, та коли границя може зникнути. Останнє з них отримує відповідь у вигляді датованих прогнозів.
Те запитання також має датовану основу. 8 жовтня 2026 року я висловив прогноз: протягом одного-двох років здатність агентів буде зростати настільки, що технічна освіта більше не буде потрібна, і люди без неї будуватимуть кращі застосунки, сайти та продукти, з кодом кращим за код програмістів. Пізніше того ж вечора я додав наслідок. Коли продукти, створені людьми без IT-освіти, почнуть обганяти створені IT-професіоналами, IT-дипломи та мітки junior та senior швидко втратять вагу в резюме. (Обидва твердження перекладені з моїх записів того дня.) Розділи 6 та 11 перетворюють обидва на прогнози з датами, мірами, порогами та результатами, які б їх спростували. Друге твердження називає момент, який решта статті називає точкою переходу кваліфікацій.
Супровідна робота в цій серії стежила за не-програмістами від чату до агентів та визначила чотири рівні за місцем роботи агента та тим, що має мати особа (Chernets, 2026a). Вона рахувала перехід тільки тоді, коли агент створив артефакт, і відмовилася зробити менеджера агентів посадовим найменуванням, використовуючи термін «для шаблону поведінки, а не для ролі, на яку будь-хто повинен наймати, тому що поведінка залишає докази, а назва — ні» (Chernets, 2026a, розділ 8.4). Поточна робота починається з цієї умови: рівень надається, і будь-яка назва може бути до нього прикріплена, тільки на доказ, тобто робота, передана агентам, прийнята особою та підтверджена перевіркою, яку агенти не бачили.
Розділ 3 надає датовану карту назв у обігу в жовтні 2026 року. Розділ 5 надає масштаб, на якому можуть бути прочитані будь-які з цих назв, горизонт верифікованої делегації з його другою віссю, коефіцієнт посилення. Розділ 6 висловлює дві гіпотези, нейтральність фону та точку переходу кваліфікацій, і запитує, скільки досвіду ремесла може замінити процес перевірок. Розділи 7 та 8 розглядають довіру, границю, яка не розчиняється, та дві партнерські функції поруч з особою, яка будує. Розділ 11 висловлює датовані прогнози з ймовірностями, порогами та резервними джерелами, зареєстровані на OSF та оцінені щороку до 2031 року в публічному доступі.
Я не обираю серед назв. Ринок обере, ймовірно, протягом кількох місяців, і робота, яка ставить на одне слово, неправильна в день, коли перемагає інше. Те, що робота може виправити, — це масштаб. Розділ 5 визначає його повністю; коротко, горизонт верифікованої делегації запитує, як велику частину роботи, у годинах, які б потребував кваліфікований фахівець, особа регулярно передає агентам і приймає з незалежною перевіркою позаду прийняття, а коефіцієнт посилення запитує, скільки таких годин кожна година власної уваги особи дає. Обидва зберігаються для кожної галузі, датовані та розміщені на п'яти сходинках від години до кварталу. Малюнок 1 розміщує дві старі драбини поруч з тією.
Одне визначення точки переходу кваліфікацій служить для цілої роботи. В галузі це момент, коли продукти, створені людьми без IT-освіти, прийняті під тією ж незалежною перевіркою, починають обганяти ті, що створені програмістами, які використовують тих самих агентів, після чого диплом та мітки junior та senior втрачають вагу при найму. Паритет якості — це крок перед тим моментом, і перетин вимог ступеня в оголошеннях про роботу — його видимий знак. Нейтральність фону, гіпотеза про те, що освіта перестає передбачати перевірену якість на рівній сходинці, — це механізм, який це пояснив би. Кожна з цих чотирьох частин несе свій власний датований прогноз (розділ 6.2).
Докази відібрані з 2025 та 2026 років, період, у якому місяць розробки агента змінює те, що має рахувати міра. Широко цитована цифра ставить наймання нових випускників у великих технологічних фірмах далеко нижче рівня 2019 року. Це залишено, як і порівняння з піком найму 2022 року, тому що вони вимірюють світ до агентів. Серії з до-агентів входять тільки як попередники, і макроекономіка найму наводиться контрапунктом платформи LinkedIn розділу 2.4. Старша робота також входить як теорія, прецедент або аналогія: Jaques про часовий діапазон відповідальності, Jensen та Meckling про вартість делегування, золота лихоманка та фотограф.
Малюнок 1. Дві драбини та одна міра.
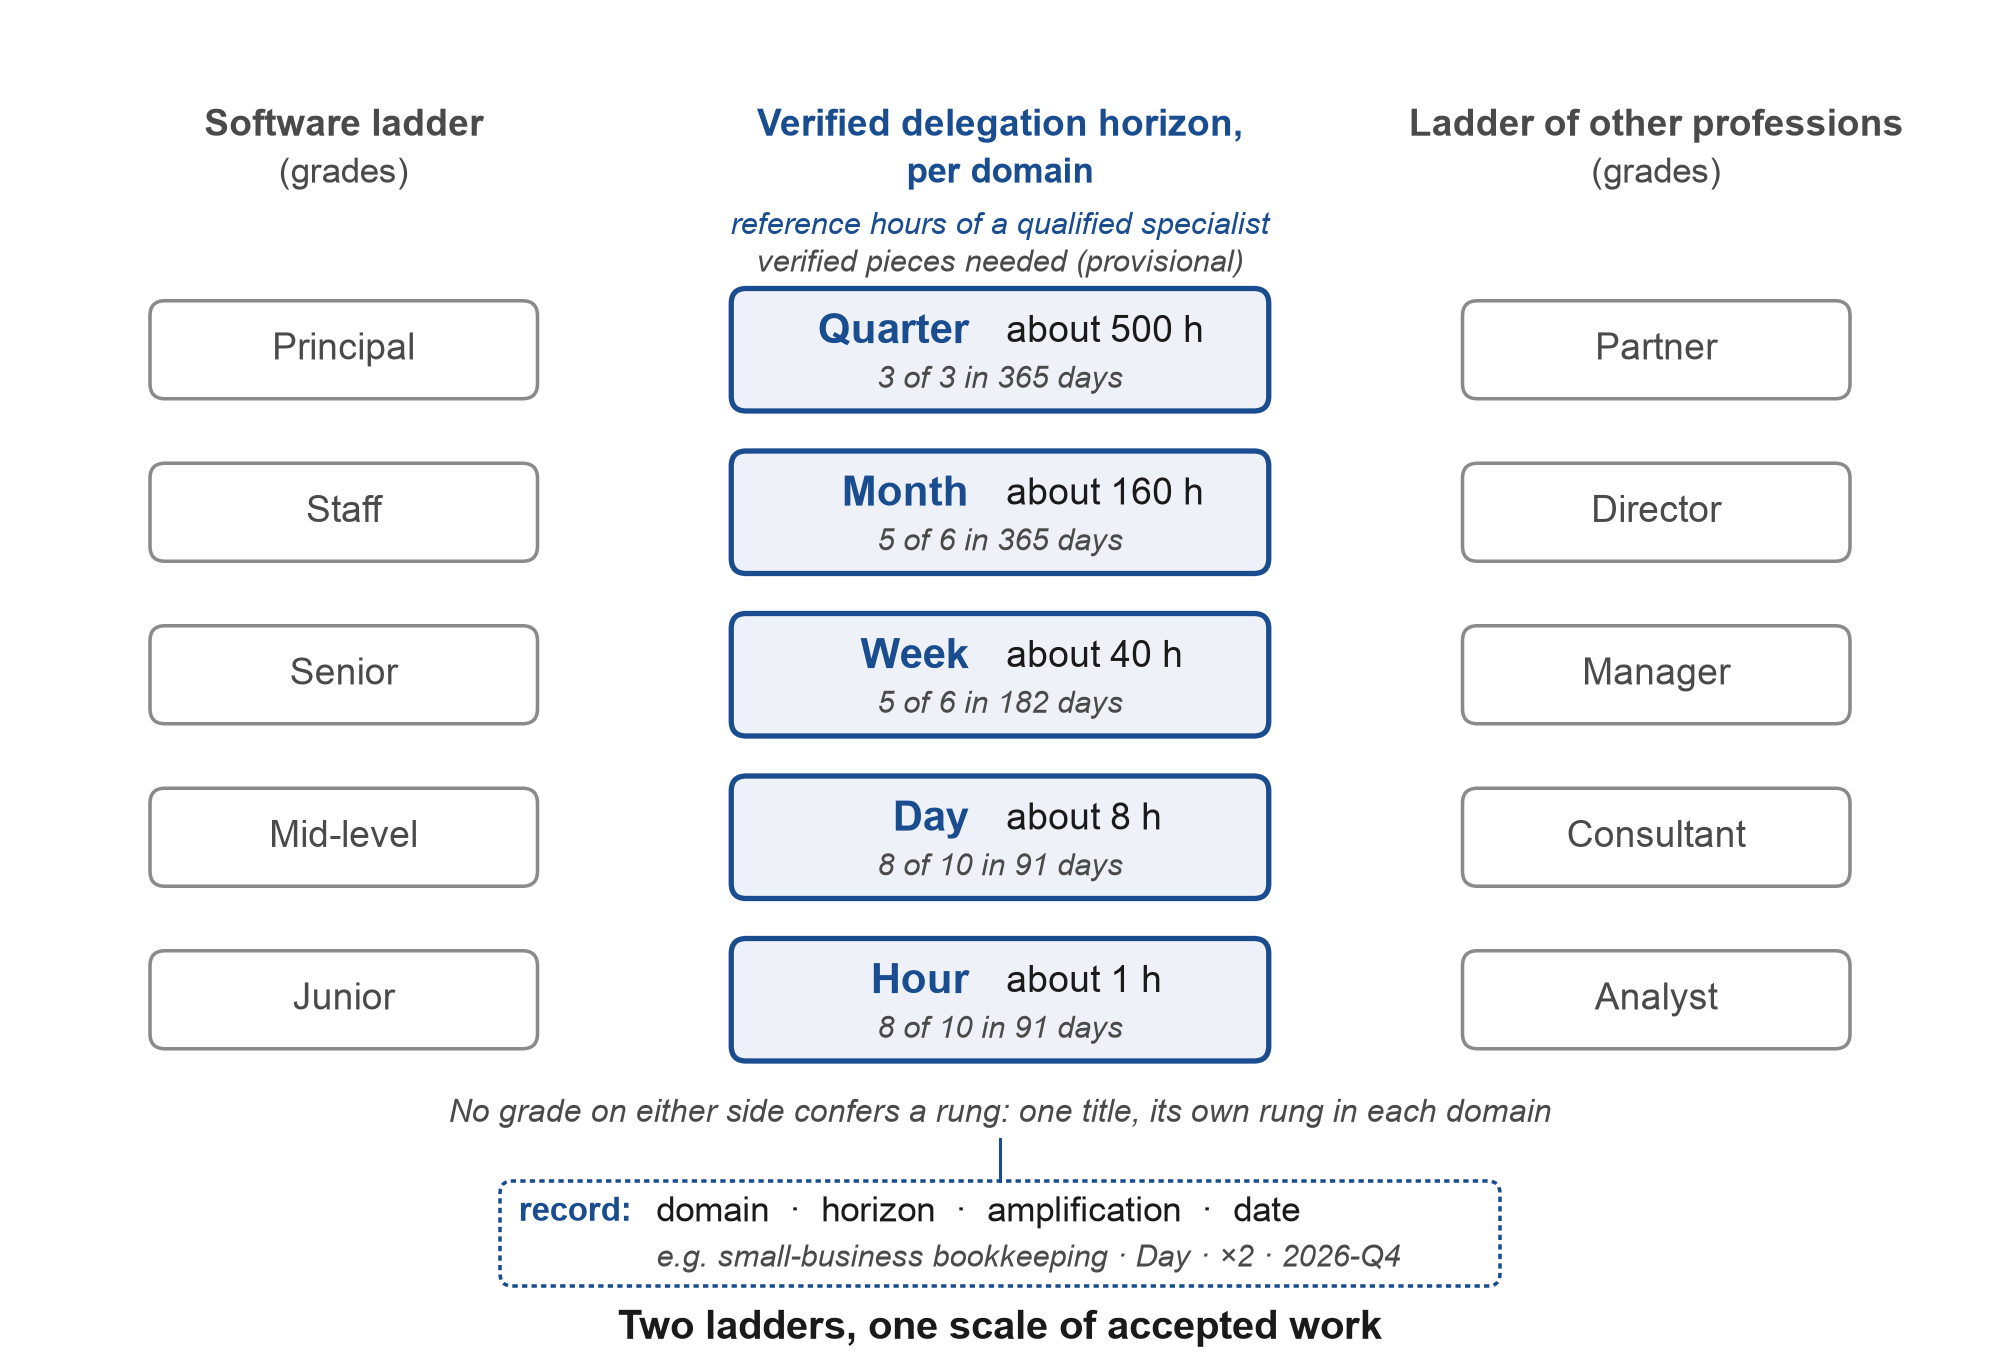
Примітка: старі драбини розташовані пліч-о-пліч з п'ятьма сходинками та навмисно не з'єднані: жоден клас на будь-якій драбині не дає сходинку, і та сама особа займає окрему сходинку в кожній галузі (розділ 5.2). Сходинки рахуються в еталонних годинах кваліфікованого фахівця, з підрахунками та вікнами розділу 5.2 (правила v1.1). Показаний запис — це той, що надрукований опрацьованим прикладом Додатку C4.
Далі розділ 2 викладає докази конвергенції, а розділ 4 описує, як перший показник ринку не спрацював, що характерно для показника такого роду. Розділ 9 перевіряє, які теми розмов програмістів переходять на інші професії, а розділ 10 виводить наслідки. Розділ 12 збирає докази проти тези, розділ 13 визначає її граничні умови, а розділ 14 робить висновок.
2. Два світи конвергують: докази з 2025 та 2026
2.1 Посада програміста, перевизначена
Постачальники, які продають розробникам, тепер описують посаду розробника як керування агентами. У своєму описі GitHub щодо «нової ідентичності розробника» розташував делегування та перевірку в центрі роботи (GitHub, 2025b). Anthropic провела опитування 132 власних інженерів та дослідників у серпні 2025 року. Вони повідомили про використання штучного інтелекту приблизно в 60% своєї роботи та самооцінений приріст продуктивності приблизно на 50%, й описували себе як тих, що стають більш «повнофункціональними». Більшість сказали, що могли повністю делегувати лише п'яту частину своєї роботи, а 27% їхньої роботи, яка підтримувалася штучним інтелектом, складалася з завдань, які взагалі не були б виконані без штучного інтелекту (Anthropic, 2025a). Міра, побудована виключно на повному делегуванні, тому бачила б щонайбільше п'яту частину того, що роблять найбільш просунуті користувачі світу зі штучним інтелектом, що є причиною того, чому Розділ 5 додає другу вісь. Той же звіт назвав «парадокс наглядання»: нагляд за моделлю вимагає навичок програмування, які атрофуються, коли все передається їй.
Слова слідували за роботою. Андрей Карпатий назвав «vibe coding» 2 лютого 2025 року (Karpathy, 2025), Collins зробив це словом року (Collins Dictionary, 2025), а через рік Карпатий перейшов до «agentic engineering». На Sequoia's AI Ascent 30 квітня 2026 року він сформулював різницю як «vibe coding піднімає мінімум, agentic engineering розширює максимум» (Karpathy, 2026; Willison, 2026a). Академічна стаття описала інженера, орієнтованого на агентів, як новий професійний архетип з відповідальністю, яка переходить від авторства коду до власництва результатів (Alenezi, 2026), а Microsoft описала моделі роботи своїх клієнтів як автора, редактора, директора та оркестратора (Microsoft, 2026b).
2.2 Всі інші, всередині одних і тих же агентів
Два постачальники повідомляють про широке використання агентів кодування людьми, які не займаються розробкою програмного забезпечення, з різними обмеженнями вибору та вимірювання. OpenAI повідомила в червні 2026 року, що кількість тижневих користувачів її агента кодування, які не є розробниками, зросла в 137 разів серед окремих користувачів та в 189 разів серед організацій з серпня 2025 року (OpenAI, 2026). Базис був низьким, і дані належать постачальнику. Той же звіт надає розподіл, який важливий для Розділу 5. У вибірці близько 0,1% індивідуальних користувачів агента в травні 2026 року 80,6% зробили щонайменше один запит, тривалість якого при ручному виконанні, згідно з оцінкою моделі, перевищила 30 хвилин, 70,2% щонайменше один понад годину, а 25,6% щонайменше один понад вісім годин. Це частки користувачів, які роблять довгі запити, з тривалістю, оціненою моделлю, що відрізняється від частки завершення або верифікованого горизонту, і Розділ 5 пояснює, чому різниця має значення. Більше чверті роботи агента для бізнес-функцій складалася з інженерної роботи.
Дослідження Anthropic щодо Claude Code, опубліковане 16 червня 2026 року, є найбільш релевантними суспільними даними для цієї тези (Anthropic, 2026e). Воно проаналізувало близько 400 000 сеансів приблизно 235 000 людей між жовтнем 2025 року та квітнем 2026 року. Експертиза оцінювалася на основі поведінки за трьома ознаками: як точно людина сформулювала завдання, що вона попросила перевірити, і хто кого коригував. Бухгалтер, який не знав Python, але написав точні правила узгодження та виявив граничні випадки, був оцінений як експерт. У сеансах, де був створений код, кожна з десяти найбільших професій не відставала від професій програмування більш ніж на сім відсоткових пунктів у верифікованому успіхові, де успіх означає досягнення, підтримане свідоцтвом, таким як успішне проходження тестів або зафіксована робота. Класифікація постачальника спирається частково на сигнали у стенограмі сеансу, такі як явне підтвердження користувача, і звіт зазначає, що дещо вищий показник менеджерів може частково відбивати те, як вони повідомляють про успіх, так що «верифікований» тут є терміном постачальника, а не незалежною перевіркою. Коли агрегується за сеансами кодування, це становило 34% проти 29% (приблизно 30% проти 26% у всіх сеансах), і менеджери показали дещо кращі результати, ніж програмісти. Ці дані сортують людей за професіями і нічого не говорять про освіту: бухгалтер може мати ступінь з інформатики, а програміст може не мати жодного. Звіт зробив висновок, що «агенти кодування роблять досвід у кодуванні менш релевантним для успішного програмування». Люди прийняли близько 70% рішень про те, що робити, а агент близько 80% рішень про те, як робити. Інструкція експерта спровокувала близько дванадцяти дій агента, новачка близько п'яти.
Та ж зміна проявляється в джерелах, які не походять від компаній, які продають агентів. Адвокати, від молодших партнерів до партнерів, будували робочі прототипи своїх власних інструментів за допомогою Claude Code замість того, щоб очікувати на постачальників, і частка адвокатів з широким доступом до штучного інтелекту зросла з 61% у 2025 році до 83% у 2026 році (Bloomberg Law, 2026; Artificial Lawyer, 2026). Бухгалтери порівнюють агентів (Growthy, 2026). Lovable, конструктор додатків на основі браузера, перевищив 600 мільйонів доларів у річних доходах у вересні 2026 року (TechCrunch, 2026a). За однією оцінкою, Claude Code створив близько 4% публічних комітів на GitHub на початку лютого 2026 року (SemiAnalysis, 2026).
2.3 Драбини під напругою
Роботодавці почали перейменовувати свої драбини, не сказавши ще, що їх замінює. З 1 червня 2026 року Deloitte дав своїм приблизно 181 500 робітникам США нові посадові назви, організовані за групами посад, і додав рівень лідерства (Business Insider, 2026). Його внутрішні рівні та принципи оплати залишилися на місці (Fortune, 2026a), так що це було перейменування без змін у критеріях оцінки. LinkedIn повідомлялося замінив свою програму асоційованого менеджера продукту на трек «Associate Product Builder» і відкрив роль «Full Stack Builder» для людей з будь-якої функції (Lenny's Newsletter, 2025). Microsoft нараховував 3 233 з 20 000 опитаних користувачів штучного інтелекту, близько 16%, як «Frontier Professionals», які запускають багатокрокові агенти і переробляють свої процеси (Microsoft, 2026a). Srinivasan та Wei стверджували в Harvard Business Review у лютому 2026 року, що компаніям потрібні менеджери агентів, і очікували, що цей титул стане стандартним протягом 12–18 місяців (Srinivasan & Wei, 2026). Деякі роботодавці йдуть далі й включають нову роль у своїх вакансіях: State Street оголосив про «Agentic Product Builder», який все ще вимагає програмування (State Street, 2026). 7 жовтня 2026 року Dust представив «AI Operator» як особу, яка будує та підтримує спільні робочі потоки агентів (Dust, 2026).
Найм помітив це. Частка співбесід при прийомі на роботу, під час яких обговорювалося використання штучного інтелекту кандидатами, зросла з 0,33% у третьому кварталі 2025 року до 4,54% у другому кварталі 2026 року (Metaview, 2026). Це питання входить у найм до того, як існує будь-яка шкала для оцінки відповіді.
2.4 Вакансії, найм на початковому рівні та освіта
Оголошення про роботу в США, що згадують «agentic AI», зросли з 151 у 2024 році до 16 541 у 2025 році (Stanford HAI, 2026). Інший підрахунок, проведений Lightcast, виявив понад 86 000 оголошень у 2025 році, що згадували навички agentic AI, з річним зростанням згадок цих навичок на 280% і середнім оголошеним окладом $153 000; навички були переважно додані до існуючих посадових найменувань (Lightcast, 2026a). AI Index підраховує оголошення, що містять фразу «agentic AI», тоді як блог Lightcast підраховує оголошення, які містять навички agentic за власною таксономією, що пояснює більшість різниці між 16 541 та близько 86 000. Ці цифри вимірюють різні речи і тут розділені.
Найм на початкові посади послабився, і причини обговорюються. LinkedIn виявив, що найм на початкові посади в США в квітні–червні 2026 року впав на 7,6% у річному розрізі, порівняно з 6,9% для всіх рівнів, і в професіях, які AI доповнює, найм на початкові посади впав на 9,6%, порівняно з 6,5% для всіх рівнів у цих професіях (LinkedIn Economic Graph, 2026). LinkedIn сам атрибутує більшу частину падіння економічній невизначеності, ніж AI, і зазначає, що серед початкових ролей найбільше впали ті, які не експоновані до AI, у Франції, Сполученому Королі встві та Сполучених Штатах. Оновлення серпня 2026 року дослідження Stanford «canaries» виявило зайнятість осіб віком 22–25 років у професіях, експонованих до AI, приблизно на 19% нижче очікування без порівнянної різниці для досвідчених працівників, і описує результат як описовий (Stanford Digital Economy Lab, 2026a). Два інші джерела виявляють той самий механізм. Економісти Федерального резервного банку Далласа, використовуючи мікродані поточного опитування населення, виявили скорочення зайнятості, пов'язане з експозицією до AI, лише серед молодих працівників, спричинене переважно меншою кількістю людей, які переходять на роботу з-поза робочої сили, ніж звільненнями (Atkinson & Yamco, 2026). У даних резюме, які охоплюють близько 65 мільйонів працівників, молодша зайнятість у фірмах, які прийняли генеративний AI, була приблизно на 9% нижче, ніж у тих, які не прийняли, через шість кварталів після прийняття, знову ж через повільніший найм, ніж звільнення (Hosseini & Lichtinger, 2026). По всій економіці лабораторія Yale Budget Lab все ще не знаходить чітких ознак того, що професії, експоновані до AI, гірше справляються, ніж порівнянні незвільнені (Yale Budget Lab, 2026), тому тиск приходиться на початковий рівень, а не на професію в цілому. Роботодавці посилалися на AI у 101 743 оголошених скороченнях робочих місць у першій половині 2026 року, приблизно 23% усіх оголошених скорочень (Challenger, Gray & Christmas, 2026).
Освіта також рухається. Кількість нових студентів, що вступають на спеціальність комп'ютерні науки, впала на 13% у відділах, охоплених опитуванням Taulbee 2026 року, яке підраховує відділи, що присуджують PhD у Північній Америці; його автори описують це як перші чіткі ознаки скорочення в конвеєрі прийому, поряд із рекордним виробництвом ступенів (Computing Research Association, 2026). Польовий експеримент з 673 німецькими учнями у IT виявив приріст 26–31 пункту відсотка на завданнях поза їхньою формальною підготовкою при наявності AI (Stanford Digital Economy Lab, 2026b). Спільна рамкова програма OECD та Європейської комісії червня 2026 року включає область, яка називається «Manage AI» (OECD & European Commission, 2026).
Таблиця A1 (Додаток F) містить список десяти сигналів цієї конвергенції з їхніми джерелами, і для кожного — те, що він показує і те, що він не показує. Разом вони також показують, де відсутні вимірювання: дані постачальника про непрограмістів, що використовують агенти кодування, показують зростання, не якість їхніх результатів. Близькість професій у перевіреному успіху стосується професії, не ступеня. Перейменовані драбини та сегменти опитування — це назви, не вимірювання. І слабший початковий щабель не показується як спричинений AI.
Ці сигнали показують з деякою впевненістю, що встановлення та прийняття роботи агентів тепер відбувається з обох боків старої межі, і що роботодавці, школи та постачальники почали переіменовувати речи. Чи роблять люди за межами програмного забезпечення цю роботу так само добре, як програмісти? Сигнали залишають це відкритим, і вони також не показують вимірювання для цього. Розділ 5 пропонує вимірювання, Розділ 11 встановлює дати щодо питання якості, а Розділ 12 визначає докази, які передбачення повинні подолати.
Докази 2026 року розділяють людей, які можуть показати, що результат правильний, від тих, які не можуть. Освіта в програмуванні — це один шлях до цієї здатності. Експертиза в галузі, звичка перевіряти та інструменти для перевірки — це інші способи, і дані Розділу 2.2 свідчать про те, що вони можуть замінити першу частіше, ніж припускають старі драбини, хоча й не те, що вони завжди можуть. Вимірювання Розділу 5 побудоване для перевірки цього твердження.
3. Імена в обігу: датована карта
3.1 Чому я не обираю одне ім'я
Кожні кілька тижнів у 2026 році компанія чи консультант, іноді журнал, пропонували ім'я для людей, описаних тут, і деякі з цих імен залишаться в ужитку. Оскільки використання невизначене, я роблю дві речі замість того, щоб рекомендувати одне: наносячи на карту імена вже в ужитку, включаючи ті, що перейняті, з указанням того, хто кожне представив, коли й у якому сенсі, і пропонуючи міру, за якою будь-яке з них можна прочитати. Якщо перемагає «builder», запис читається як «builder at Week»; якщо перемагає «agent manager», він читається як «agent manager at Day». Пріоритет затверджується для міри, драбини, визначень і передбачень, включаючи терміни, що їх називають (verified delegation horizon, amplification gain, credential crossover point), а не для будь-якої назви ролі; імена ролей, додані у розділі 3.3, пропонуються як кандидати без пріоритету.
3.2 Шість шарів
Кандидати не всі конкурують за одне місце. Одні називають навичку, яку матимуть майже всі, інші професію, міру, момент, партнера чи сигнал, що не спрацював. Таблиця A2 (Додаток F) перелічує імена вже в ужитку, з їхніми авторами, а у другій частині — імена, запропоновані в цьому дослідженні або використані тут лише як звичайні описи, разом із варіантами, що були розглянуті й відкладені, щоб читач міг побачити всю сім'ю. Рисунок 2 розташовує імена за шарами і за датою, коли кожне було представлено.
Рисунок 2. Імена в обігу за шарами і за датою, коли кожне було представлено.
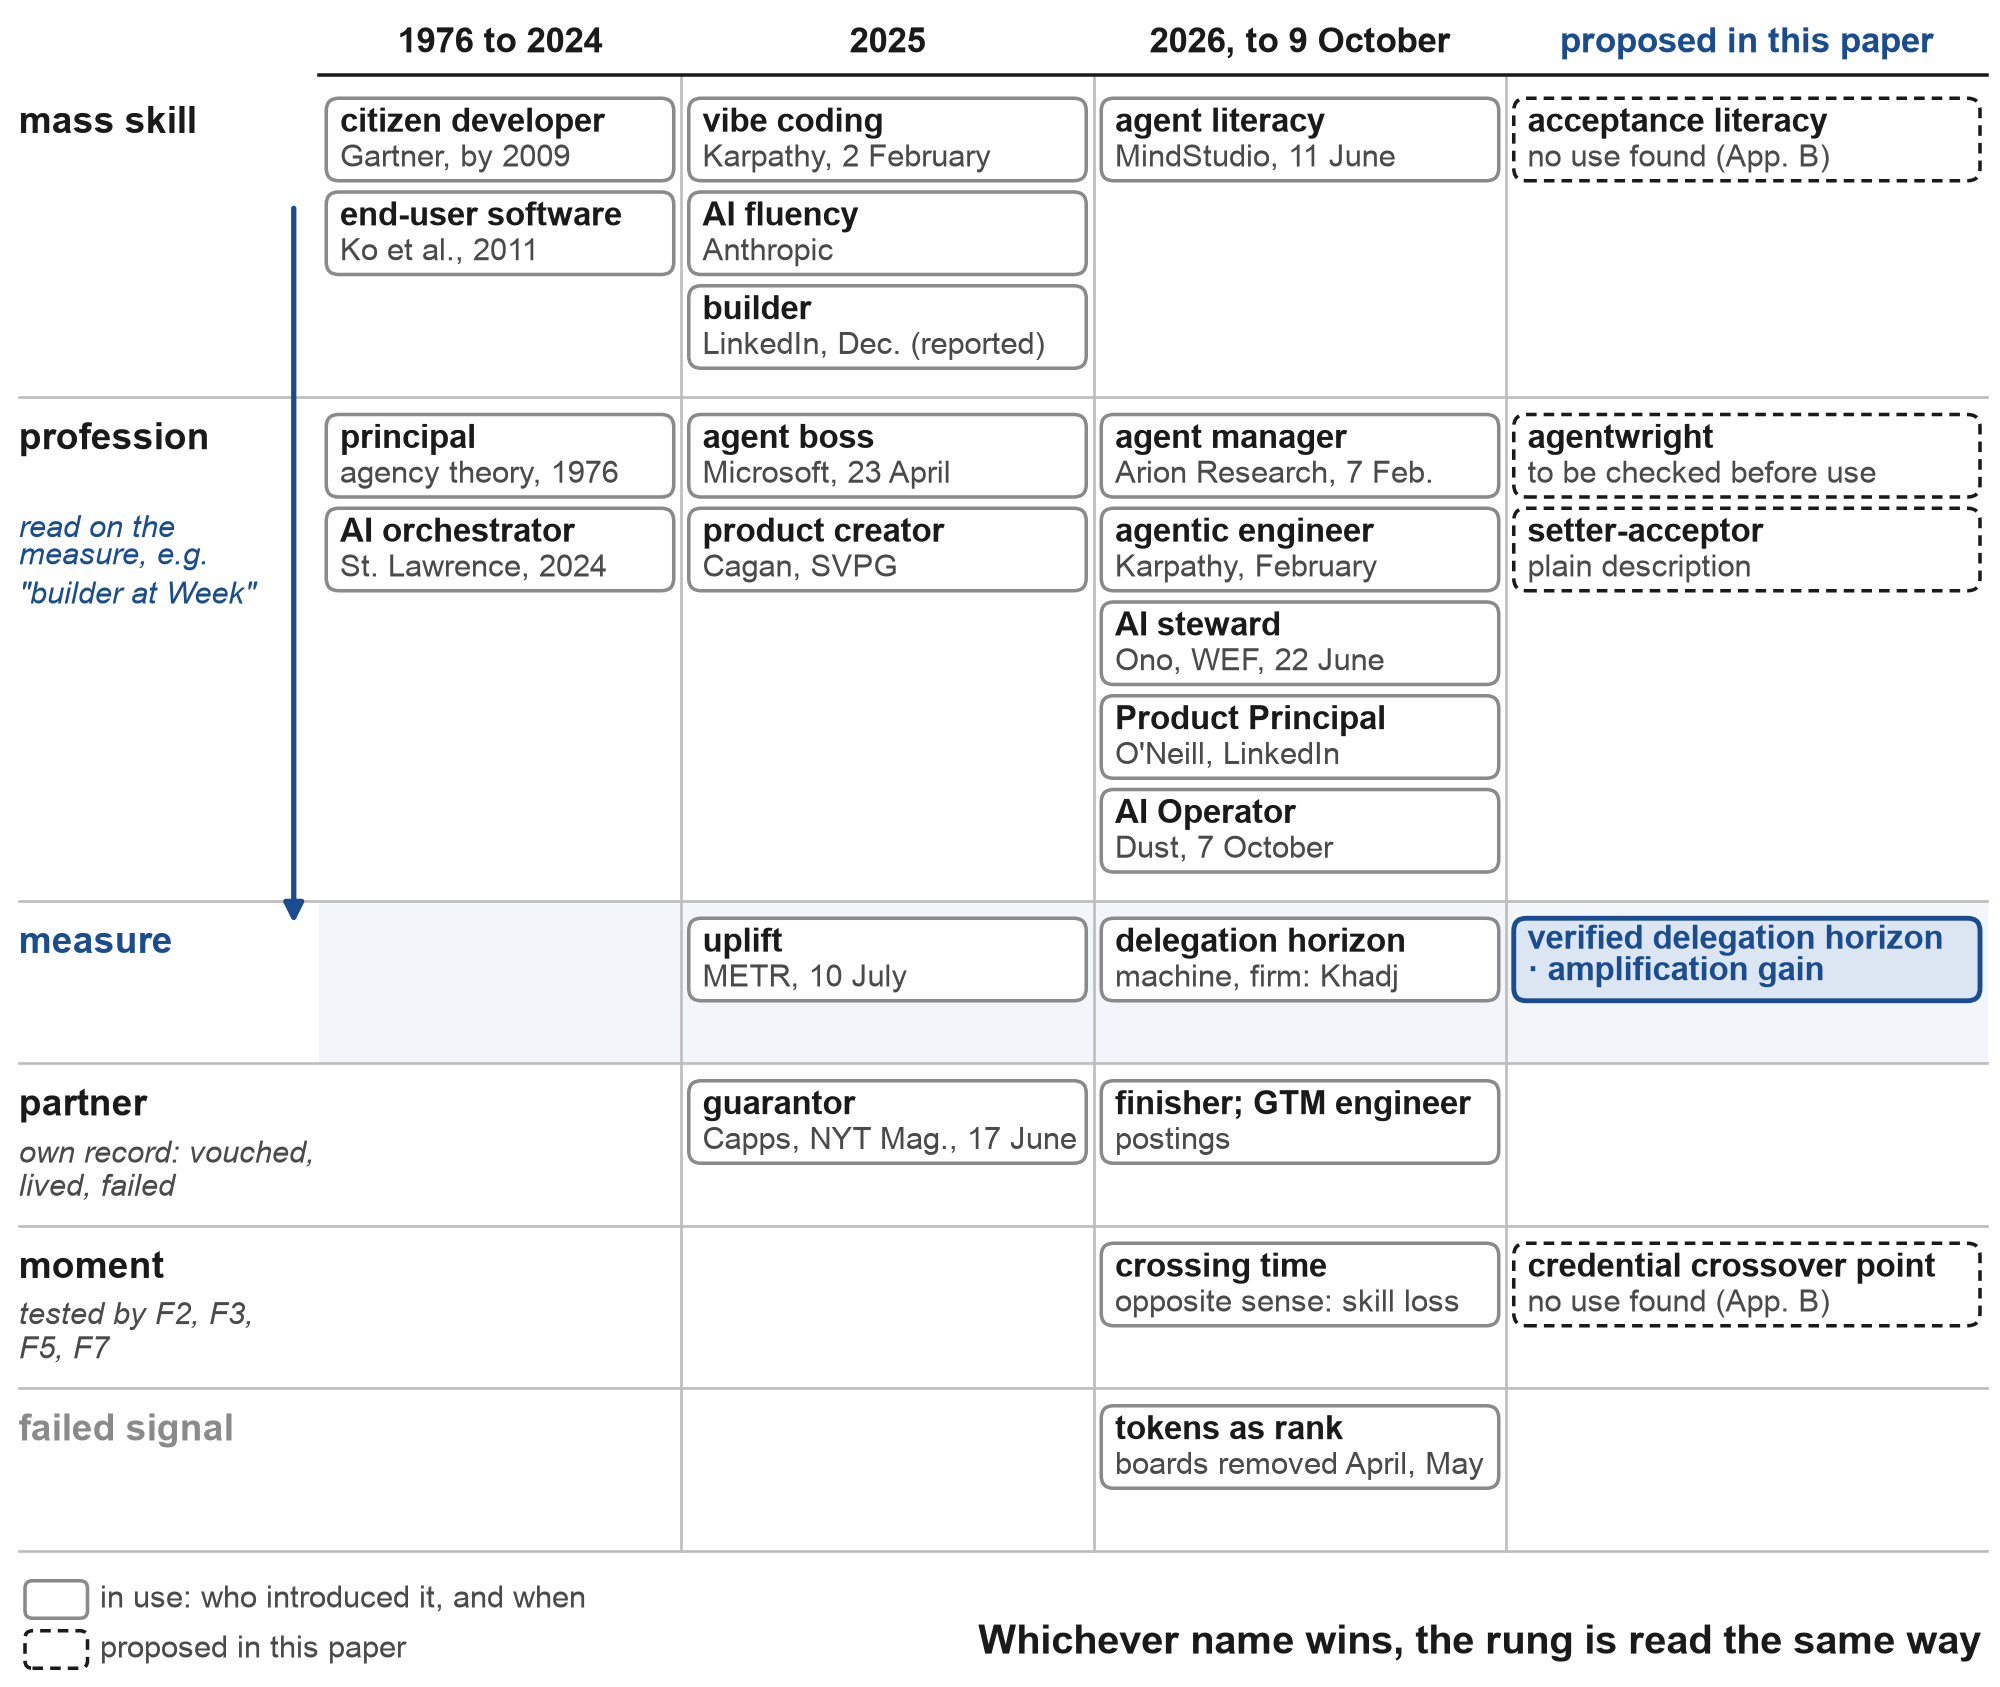
Примітка: Авторів і дати див. таблицю A2. Ім'я, джерелом якого є лише рік, наводиться без місяця. Рисунок є вибіркою; таблиця A2 перелічує кожного кандидата. Лише шари «масової навички» й професії читаються за мірою («builder at Week», «agent manager at Day», розділ 3.1). Партнер має свій запис про те, скільки продуктів було засвідчено, як довго кожний тривав і скільки не спрацювало (розділ 7.2), і момент не є щаблем, а перевіряється датованими передбаченнями F2, F3, F5 і F7 (розділ 11.2). «Delegation horizon» у рядку міри — це сенс машини чи фірми (Khadj, 2026; Alonso, 2026), а не особистісна міра розділу 5. Рисунок не містить судження про те, яке ім'я переважить.
3.3 Зауваження щодо карти
«Builder» ймовірно перемагає в масовій HR: LinkedIn прийняв його, і журналісти писали в 2026 році, що в районі Bay Area кожен тепер є «builder» (SF Standard, 2026). Немає причин боротися зі словом, оскільки воно нічого не говорить про рівень, а рівень — це те, що надає міра.
Імена менеджерів (agent manager, AI operator, orchestrator) — горизонтальні: вони описують керування агентами в загальному вигляді, не в якій-небудь конкретній галузі. Розділ 6.3 дає причину очікувати, що вони повторитимуть долю «prompt engineer» — назви, яка була скрізь у 2023 році й була оголошена застарілою в 2025 році (Fortune, 2025; TechRepublic, 2025).
«Principal» має найміцнішу теорію у своєму основі й найгірші колізії. У теорії агентства principal — це сторона, яка делегує й несе витрати на моніторинг (Jensen & Meckling, 1976), а конституція Anthropic для своїх моделей називає «principals» тих, від імені яких діє модель (Anthropic, 2026b). Verheul (2026) стверджує, що коли машини виконують функцію агентства, люди в фірмі займають лише посади principal, і кар'єрна драбина зникає. Я приймаю цей діагноз і пропоную нову драбину на його місце. Однак у управлінні ідентичністю та доступом «agent principal» називає власну ідентичність агента, що є зворотним сенсом від задуманого, тому англійську фразу «Agent Principal» не слід використовувати для позначення особи. «Product Principal» O'Neill є прецедентом майже в цьому сенсі й цитується як такий, а фреймворк AIDEs компанії JetBrains уже описує рівні розробника як властивості відносин principal-agent (Tikhomirov, 2026).
Імена, запропоновані тут (agentwright, setter-acceptor, agent director), входять до цієї сім'ї як кандидати, жодне з них не є улюбленим. Agentwright вільне в наукових базах даних, що були пошукані, але пошукові системи розбивають його на «Agent Wright», воно звучить як інструмент тестування браузера, який розробники знають, і до жовтня 2026 року слово вже використовувалося для пакета Python та каталогу навичок агентів, тому воно залишається варіантом, якому потрібна уточнювальна позначка.
Одне спостереження щодо значення можна записати без того, щоб забрати вибір у ринку. За сенсом, «principal» лежить найближче до професії розділу 8 — роботи, виконаної для інших з відповідальністю за результат, а «builder» — найближче до масової навички, роботи, виконаної для себе.
4. Чому потрібна міра: рік, коли токени спробували як показник старшинства
Ринок не чекав на шкалу. У 2026 р. він спробував кілька, і оскільки епізоди різняться за характером, вони розглядаються окремо тут, у порядку їхнього виникнення.
У Meta один із працівників створив внутрішню панель управління з прізвиськом "Claudeonomics", яка ранжувала близько 85,000 колег за спожитими токенами, понад 60 трильйонів за тридцять днів (Shopifreaks, 2026a). Це був проект одного працівника, без офіційного статусу, і його видалили в квітні після того, як про нього повідомили поза компанією. Офіційна позиція Meta рухалась окремо. З лютого використання AI стало офіційною частиною оцінювання працівників, і на початку вересня видання WIRED та CIO повідомили про нові вказівки, за якими Meta «не буде використовувати панелі управління адаптацією AI або підрахунки токенів для оцінювання впливу» та відмовилися від ярлика «AI Native» як критерію (CIO, 2026b; Shopifreaks, 2026b). У Amazon таблицю лідерів використання токенів ігрифіковували порожніми завданнями і видалили в травні (CIO, 2026a), що є найчистішою формою Goodhart's law: коли міра стала цільовим показником, вона перестала вимірювати. Випадок Uber — це бюджетна подія. Компанія витратила свій річний бюджет на AI за чотири місяці і обмежила працівників $1,500 на місяць (Fortune, 2026b). У липні генеральний директор Cognition сказав, що компанії повинні вимірювати продуктивність, а не використання AI (Fortune, 2026c).
Контрприклади мають значення. Shopify додає питання про використання AI до своєї оцінки продуктивності та рецензій колег (Shopify, 2026), і один коментатор очікує, що метрики токенів будуть «менш значущими, але не скасованими» (Kingy AI, 2026). Питання про те, як людина використовує AI, — це інша справа, ніж ранжування за обсягом, і прогноз F8 у розділі 11 їх розрізняє.
Гілки розробників, досліджені в розділі 9, демонструють той самий інстинкт у окремих людей. Вони представляють себе вхідними даними: щомісячним рахунком за AI у $1,148, скрин-шотом підписки, близько 330 з деяких 600 завершених запитів на злиття (одиниця, описана в гілці як дуже наближена), 36 етапів побудованих за три дні. Один із них опублікував економію, яку його агент розрахував для нього без перевірки розрахунку, що є епізодом з токенами, повторений однією особою. Кожна з цих вибірок показує, що було витрачено або виробленого; те, що було прийнято, кимось і після якої перевірки, не записується.
Я отримую один прямий урок для міри: підраховуйте роботу, і тільки роботу, яка пройшла перевірку, невідому для агентів. Узгодженість серед моделей однієї сім'ї не може бути тією перевіркою, оскільки їхні помилки корельовані, і їхня узгодженість дає менше незалежних суджень, ніж це виглядає (Chernets, 2026b). Витрачання більше токенів не може завищити міру, побудовану таким чином, оскільки неприйнята робота нічого до неї не додає. Інші способи завищення залишаються, і розділ 5.8 їх перелічує разом з їхніми захистами.
5. Показник: перевірений горизонт делегування та коефіцієнт посилення
5.1 Референтні години
Обидві осі використовують одну одиницю — референтну годину: час, який потрібен кваліфікованому фахівцю, щоб виконати ту саму роботу вручну. Еталон обраний ззовні умисне. Те, чи могла б дана людина виконати роботу сама, не входить до виміру, так само як і її фахова підготовка. Інструмент звірення бухгалтера та модуль виставлення рахунків розробника вимірюються однаково — за часом, витраченим на них компетентним фахівцем.
Референтні години походять з одного з двох джерел. Одне — це заморожена база завдань, чиї часи ручного виконання було виміряно в 2025 та 2026 роках; GDPval, з завданнями з 44 професій та часами експертів, демонструє, що таку базу можна побудувати (Patwardhan et al., 2025). Інше — два незалежні оцінювачі, які оцінюють години, не знаючи, хто виконав роботу; якщо оцінювачі в галузі розходяться занадто сильно, еталоном замість цього може бути медіана каліброваної панелі з п'яти до дев'яти оцінювачів, помічених за рунгом (Додаток G2). Я навмисне заморожую базу, як колись метр тримали в сховищі поблизу Парижа, тому що через кілька років мало хто буде виконувати ці завдання вручну, і не буде чого порівнювати. База повинна містити для кожної галузі завдання на кожному рунгу — кожне з письмовою декларацією того, що вважається виконаним, виміряними часами ручного виконання, прихованими перевірками та кількома навмисними помилками, чиє виявлення є частиною умов прийняття. Часи ручного виконання GDPval — це перевірені самозвіти експертів, тоді як часи перевірки були виміряні, що є стандартом, якого база повинна дотримуватися або покращувати. Щоб виміру не судити саме себе, горизонт оцінюється на одному наборі завдань, а якість, яку використано для перевірки гіпотез про нього (Розділ 6), — на іншому.
5.2 Перевірений горизонт делегування
Визначення. Перевірений горизонт делегування особи в галузі — це найбільший обсяг роботи в референтних годинах, при якому особа регулярно передає роботу агентам, приймає її та має підтвердження від незалежної перевірки, яку агенти не бачили.
Правило в одному абзаці. Делегована робота вважається перевіреною та входить до горизонту лише коли виконуються всі такі умови. Вона була встановлена з письмовою декларацією того, що вважатиметься виконаним, і її референтні години походять з бази даних або від двох оцінювачів. Особа прийняла її як один цілісний результат: місяць роботи, розбитий на 160 однозвідинних завдань, — це 160 годин, тоді як робота, виконана етапами та прийнята як одне ціле, враховується цілою за референтними годинами того цілого. Незалежна перевірка підтвердила це, і перевірка є незалежною, коли вона відрізняється від агентів у джерелах даних (вхідних даних, які агенти не створили), в доступі (агенти не могли це бачити чи редагувати) та в стимулах (той, хто її проводить, не отримує користі від успіху). Чотири типи відповідають вимогам: приховані тести прийняття, кваліфікований рецензент-людина, реальне використання призначеними користувачами або модель іншої сім'ї, яка перевіряє на основі джерел, які відкрила ця особа, та залишає вердикт, який можна перевірити. Самоперегляд та узгодженість моделей однієї сім'ї не розраховуються, оскільки їх сліпі плями збігаються з сліпими плямами агентів. У вікні, встановленому для кожного рунгу (91 день для години та дня, 182 для тижня, 365 для місяця та кварталу), особа прийняла необхідну кількість робіт розміром не менше цього в галузі (десять для години та дня, шість для тижня та місяця та три для кварталу), і щонайменше вісім з десяти пройшли, що означає п'ять з шести для тижня та місяця та всі три для кварталу. Від рунгу тижня та вище щонайменше одна з цих робіт повинна містити навмисні помилки. Одна пропущена навмисна помилка, будь-якого типу, блокує рунги від тижня та вище для цього вікна, і робота з нею не розраховується ні до рунгу, ні до коефіцієнта посилення. Коли помилку неможливо скасувати (гроші переведені, запис пацієнта, документ, який неможливо повернути), кожна така робота повинна пройти, з прихованим тестом або кваліфікованою людиною як стандартною перевіркою та моделлю іншої сім'ї як другою лінією, і суворіше правило застосовується лише до цих робіт. Кожна передача записується в журнал, включаючи невдачі та залишені завдання, з урахуванням уваги, яку вони вимагали. Рунг знову підтверджується кожного кварталу: на рівні тижня та вище щонайменше одна перевірена робота розміру рунгу повинна бути в межах останніх 91 дня, тому горизонт не може базуватися на роботі старшій за рік. Абзаци нижче пояснюють обґрунтування кожної частини.
Правило оцінювання. У вікні, встановленому для кожного рунгу (91 день для години та дня, 182 для тижня, 365 для місяця та кварталу), рунг враховується, якщо особа прийняла необхідну кількість робіт розміром не менше цього в галузі (десять для години та дня, менше вище, як описано далі), і щонайменше вісім з десяти пройшли перевірку одного з цих типів: приховані тести прийняття, кваліфікований людський рецензент, реальне використання призначеними користувачами або модель іншої сім'ї, яка перевіряла на основі джерел. Самоперегляд та узгодженість моделей однієї сім'ї не розраховуються. Коли помилку неможливо скасувати (гроші переведені, запис пацієнта, документ, який не можна повернути), кожна така робота повинна пройти, і суворіший поріг застосовується лише до цих робіт. Для цих робіт стандартною перевіркою є прихований тест або кваліфікована людина, з моделлю іншої сім'ї як другою лінією.
Вищі рунги. Один підрахунок десяти вивів би вищі рунги поза досягненням будь-кого, оскільки десять робіт по 40 референтних годин за три місяці — це 400 годин роботи фахівця, а десять робіт по 500 годин — 5000. Тому правило подовжує вікно та знижує підрахунок в міру зростання рунгу: десять робіт за 91 день для години та дня, шість за 182 дні для тижня, шість за 365 днів для місяця та три за 365 днів для кварталу, з тією ж часткою вісьма з десяти (що означає п'ять з шести для тижня та місяця та всі три для кварталу). Більш ранна версія вимагала чотирьох з чотирьох для місяця; настільний тест Додатку E показав, що це зробило місяць складніше заробити, ніж квартал для людини будь-якої надійності, і підрахунок був змінений. Від рунгу тижня та вище щонайменше одна робота розміру рунгу у вікні повинна містити навмисні помилки. Будь-яка навмисна помилка, яку пропустить людина, незалежно від типу, блокує рунги від тижня та вище для того вікна, і робота з пропущеною навмисною помилкою не розраховується як перевірена, ні до рунгу, ні до коефіцієнта посилення. Квартал має залишатися рідкісним рунгом, і наведені вище підрахунки встановлені саме так.
Кожна передача реєструється. Журнал реєструє кожен фрагмент, передані агентам, включаючи ті, що не пройшли перевірку, і ті, від яких відмовилися перед тим, і тільки фрагмент, прийнятий як одна цілісна доставка, рахується до сходинки. Місяць роботи, розбитий на 160 одногодинних квитків, — це 160 годин, а не місяць: еталонні години оцінюються для доставки, яку користувач, клієнт або рецензент приймають цілісно, у дусі когерентних завдань METR. Також справедливо й навпаки: робота, виконана етапами й прийнята як одна цілісна доставка, рахується цілком, за еталонними годинами цієї доставки, скільки б етапів це не забрало.
Незалежність. Перевірка є незалежною, коли вона відрізняється від агентів у даних (вона використовує вхідні дані, які агенти не виробили), у доступі (агенти не могли бачити або редагувати це) і в стимулах (той, хто її проводить, нічого не виграє від успіху). Модель іншої родини додає різноманітність помилок. Вона рахується тільки коли перевіряє проти джерел, які відкрила людина, і її вердикт є одним входом, який можна перевірити.
Один фрагмент роботи проходить цей шлях (Рисунок 3). Завдання встановлюється з письмовим формулюванням того, що буде рахуватися за виконане. Його еталонні години беруються з банку або від двох оцінювачів. Агенти виконують роботу, поки людина витрачає свою увагу, що реєструється. Людина приймає, відхиляє або залишає фрагмент, незалежна перевірка підтверджує або спростовує, і рядок журналу записується в той момент, з датою початку, збереженою як окреме поле, де це важливо. Якщо існує затримана результативність (прийняте подання, реліз, що ще працює через місяць), вона записується коли це трапляється. Горизонт і посилення обчислюються з цих записів, з датою.
Рисунок 3. Один фрагмент роботи, один запис.
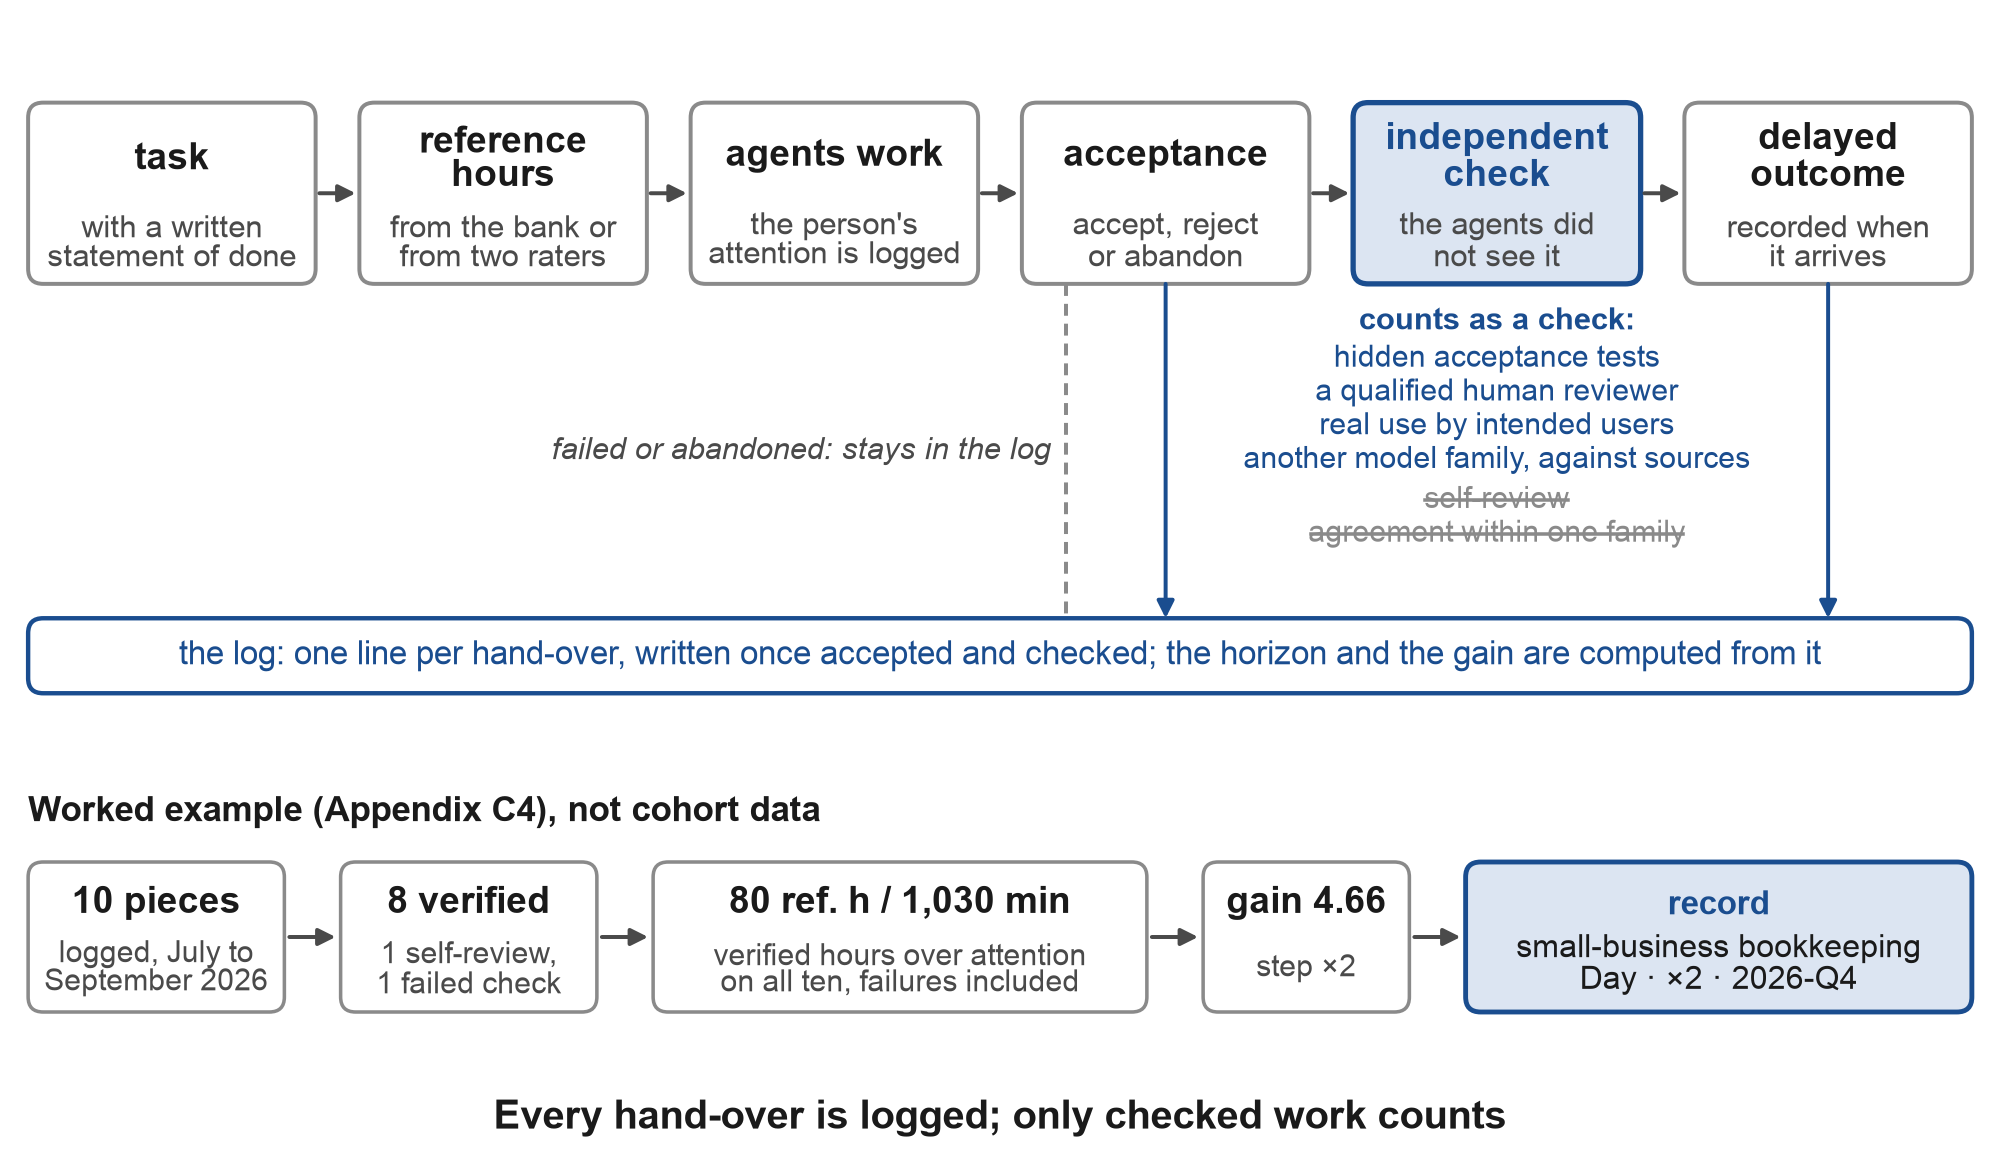
Примітка: верхній рядок — це шлях розділу 5.2. Чотири види незалежної перевірки — це ті, що відповідають правилу оцінювання. Самоперевірка та узгодженість між моделями однієї родини не рахуються. Невдалі та залишені фрагменти залишаються у журналі й додають свої хвилини до знаменника коефіцієнта посилення. Нижній рядок — це опрацьований приклад додатку C4, конструйований журнал, а не дані когорти: десять фрагментів, вісім перевірених, 80 еталонних годин проти 1030 хвилин уваги, коефіцієнт 4,66 (крок ×2) і запис «ведення обліку малого бізнесу · День · ×2 · 2026-Q4».
Повторна перевірка. Горизонт підтверджується знову кожний квартал. Парадокс нагляду Anthropic (розділ 2.1) пояснює чому: горизонт, отриманий коли навичка перевірки занепадає, позичений, і щоквартальна перевірка показує, чи він все ще утримується. Для сходинок, вікна яких тривають довше за квартал (Година, День, Тиждень, Місяць і Квартал), перевірка має конкретну форму: принаймні один перевірений фрагмент розміру сходинки має припасти на останні 91 день, щоб сходинка не спиралася на фрагменти, близькі до року.
5.3 Драбина
Я називаю п'ять сходинок в одиницях часу, тому що одиниці часу не потребують перекладу між професіями, можуть бути прочитані з журналів і зростають з технологією без перейменування. Таблиця 1 наводить їх з прикладами та кількістю, яка потрібна для кожної.
Таблиця 1. Драбина перевіреного горизонту делегування.
| Сходинка | Розмір роботи, переданої та перевіреної | Приклад у програмному забезпеченні | Приклад в інших областях | Потрібно перевірених фрагментів, період |
|---|---|---|---|---|
| Година | Близько 1 еталонної години | Скрипт, невелика виправка | Відповіді, витягнуті зі стопки документів | 8 з 10 за 91 день |
| День | Близько 8 | Функція, невеликий внутрішній інструмент | Звіт в кінці місяця з його перевірками | 8 з 10 за 91 день |
| Тиждень | Близько 40 | Сайт або внутрішній інструмент за специфікацією з нічними запусками | Повна перевірка приналежності, система кампанії | 5 з 6 за 182 дні |
| Місяць | Близько 160, зазвичай в кількох потоках | Реліз продукту; правила прийняття, за якими працюють інші | Інструменти практики, з правилами, які використовують колеги | 5 з 6 за 365 днів |
| Квартал | Близько 500 | Лінія продукту з живими користувачами | Лінія обслуговування, керована через агентів | 3 з 3 за 365 днів |
Примітка: Сходинка отримується тільки за правилом оцінювання розділу 5.2, окремо в кожній області, з кількостями правил v1.1 (додаток E). Жодна оцінка на старій драбині не дає сходинку, і людина може бути на рівні Тижня в фінансових інструментах і на рівні Дня у веб-додатках.
Запис для резюме або HR файлу містить область, горизонт, посилення та дату, наприклад «ведення обліку малого бізнесу · День · ×2 · 2026-Q4». Дата належить до запису, тому що та сама сходинка буде означати щось інше через рік, як технологія рухається.
5.4 Коефіцієнт посилення
Не всі, хто добре працює з агентами, передають їм великі фрагменти. Один із розробників у розділі 9, який будує з чотирма машинами, описує три з них як «посилення особистої ефективності» без автономного агента на них. Автономні агенти, які він також запускає, «не прижилися» для повсякденної роботи, пише він, і він вважає за краще «посилення, а не делегування» (переклад). Його найдовший потік тривав 36 етапів протягом трьох днів, кожен етап передано та затверджено, а потім агента попросили підтвердити, що все розгорнулось. За правилом розділу 5.2, це підтвердження є самоперевіркою, тому його опублікований запис не показує жодної перевіреної сходинки, а потік не дає чисел для його посилення. Де він би стояв з незалежною перевіркою, залежить від того, що було прийнято. Якби 36 етапів були прийняті як одна цілісна доставка, потік би рахувався цілком, за його еталонними годинами, як це робить поетапна робота додатку C, розділу C4. Якби кожен етап був прийнятий окремо, кожен був би невеликим фрагментом і він стояв би на Години на першій осі. Пост не говорить, який. Але він будує інструменти, які замінюють програмне забезпечення, яке він раніше купував, і він називає знаменник другої осі сам, коли називає час єдиним вузьким місцем.
Він не виняток. Anthropic повідомила, що користувачі з досвідом від шести місяців і більше були "набагато менш схильні делегувати більші обов'язки через директивні моделі використання", працювали з моделлю більш ітеративно та приносили складніші завдання, з успіхом на три-п'ять пунктів вищим після контролю (Anthropic, 2026d). На Claude.ai спільне використання випередило автоматизацію 52% проти 45% у листопаді 2025, а розмови виявилися успішнішими за одноразові програмні запити, 67% проти 49% (Anthropic, 2026a). Люди у краще оплачуваних професіях робили приблизно в 1,5 рази більше ходів, а жінки автоматизували на 7,3 пункти менше, ніж чоловіки в тій же професії (Anthropic, 2026f). У опитуванні Stanford 1500 працівників найпереважніший варіант у 47 з 104 професій був рівним партнерством між людиною та агентом (Shao et al., 2025). Міра, побудована лише на делегуванні, таким чином, недооцінила б найдосвідченіших користувачів, найвищооплачуваних та жінок, хоча ніщо в цих даних не говорить про те, що їхня робота гірша.
Визначення. Коефіцієнт збільшення — це еталонні години прийнятої, перевіреної роботи, поділені на години уваги людини, витраченої на це, протягом останніх 91 дня в галузі, незалежно від часового горизонту положення людини. Робота, виконана із зовнішньою допомогою (колега або підрядник виправляє її поза записами), реєструється як така й не додає нічого до чисельника, тоді як хвилини людини на ній залишаються у знаменнику. Увага охоплює планування, інструктаж, читання, перевірку та виправлення. Час, протягом якого агент працює, поки людина робить щось інше, не рахується.
Коефіцієнт збільшення — це перевірена пропускна спроможність: прийнята, перевірена продукція на годину уваги. Це не причинна оцінка того, наскільки швидше та ж людина працює з агентами, ніж без них. Прибуток у такому порівняльному сенсі потребує контрольного показника — тієї ж людини або подібних людей, які виконують той же вид роботи без агентів, і лише порівняльне дослідження може його забезпечити.
Невдала робота не додає нічого до чисельника і всі її хвилини додаються до знаменника, що робить самообман видимим. У випробуванні METR у 2025 році досвідчені розробники вважали, що штучний інтелект прискорив їх, тоді як вимірювання показало, що вони працювали на 19% повільніше (METR, 2025).
Кроки другої осі — це ×1 ("день за день"), ×2, ×5 ("тиждень за день"), ×20 ("місяць за день") і ×60 ("квартал за день"). Обидві шкали незалежні, тому крок на одній не дорівнює рівню на іншій. Коли людина запускає кілька агентів паралельно, увага все ще рахується один раз, у власних хвилинах людини: година, витрачена на спостереження за трьома потоками, — це одна година у знаменнику, розділена між частинами пропорційно хвилинам, записаним проти кожної. Оцінка повідомляється разом із параметром, який її вироблив (модель та інструменти, вид перевірки та рівень завдань), тому що та ж людина отримає різні оцінки при суворішій перевірці.
5.5 Дві осі, чотири профілі та стеля
Розміщення людей на обох осях дає чотири профілі (Рисунок 4). Учень має короткий горизонт і низький коефіцієнт. Посилювач має короткий горизонт і високий коефіцієнт, як будівельник 36 етапів, якщо його етапи приймалися один за одним. Делегант має довгий горизонт і високий коефіцієнт. Четвертий профіль, який я називаю наглядачем, — це довгий горизонт із низьким коефіцієнтом: агенти працюють довго, а перевірка та переробка з'їдають користь, тому це більше ознака попередження, ніж рівень.
Дві осі пов'язані стелею. Увага йде на постановку роботи та на її перевірку. Позначимо H еталонні години одного завдання, V — години уваги, яку займає його перевірка, і S — години, витрачені на його постановку. Тоді коефіцієнт G = H / (S + V + переробка), і тому G ≤ H / V. Якщо перевірка сама по собі займає чверть часу вручну, коефіцієнт не може перевищити ×4, як би довго не працював агент без нагляду. За тією ж межею, кроки ×2, ×5, ×20 і ×60 доступні лише коли перевірка займає не більше 50%, 20%, 5% і близько 1,7% часу вручну (Рисунок 4). Це спрощена модель із заявленими обліковими межами: вона не враховує цінність роботи, яку людина не могла б виконати взагалі, вона припускає, що час перевірки пропорційний до розміру завдання, і вона діє на одне завдання, тому людина, яка дешево перевіряє малі завдання, може подолати стелю, обчислену для великих. На рівні економіки Catalini et al. (2026) роблять той же висновок: обмежуючим фактором стає "пропускна спроможність людської верифікації", і відкривається "Розрив вимірюваності" між тим, що можуть виконати агенти, і тим, що люди можуть собі дозволити перевірити.
GDPval показує, що означає межа на практиці. На його еталонній підмножині з 220 завдань його експерти повідомили (і автори перевірили) в середньому 404 хвилини на завдання вручну, а рецензування виробу займало 109 хвилин, близько 27%, що встановлює стелю біля ×3,7 для завдань такого роду. Моделі зробили свої чорновики в 90–327 разів швидше, ніж експерти. Проте у сценарії, коли людина спробує модель, а потім виправить її роботу, розрахунок авторів (а не вимірювання) дав GPT-5 прискорення 1,12, коли модель спробована один раз, і 1,39, коли спробована кілька разів, два стовпці однієї таблиці (Patwardhan et al., 2025). Незалежно від швидкості агента, ціна перевірки встановлює стелю, і ця ціна зростає з рівнем, оскільки більший фрагмент коштує більше перевіряти. Kamara (2026) називає цю вартість фрикцією верифікації. Практики у Розділі 9 висловлюють це своїми словами: після певної точки перевірка коду агента "все менше й менше відрізняється від переписування його від руки", і може зайняти більше часу, ніж писати його самому (перекладено).
Той самий коефіцієнт можна досягти двома шляхами. Довга повідь передає великий фрагмент і перевіряє його в кінці; короткі, швидкі цикли передають малі фрагменти і перевіряють кожен по мірі надходження. Моя гіпотеза полягає в тому, що перевірка малих фрагментів в процесі часто дешевша, ніж перевірка великого результату в кінці, і дані Anthropic вказують саме на це. Розмови були успішнішими за одноразові запити, і за власною екстраполяцією авторів одноразові запити досягають 50% успіху на завданнях близько 3,5 годин, тоді як розмови досягали б це на завданнях близько 19 годин (Anthropic, 2026a). Частка спільного використання впала нижче автоматизації в серпні 2025 року і повернулася вперед, 52% проти 45%, до листопада. Шлях короткого циклу близький до того, що вивчає література про співпрацю людини та ШІ, і коефіцієнт збільшення визнає його так само повною мірою, як довге делегування. Прогнози F19–F21 у Розділі 11 тестують шлях короткого циклу.
Рисунок 4. Дві осі, чотири профілі та стелі, встановлені перевіркою.
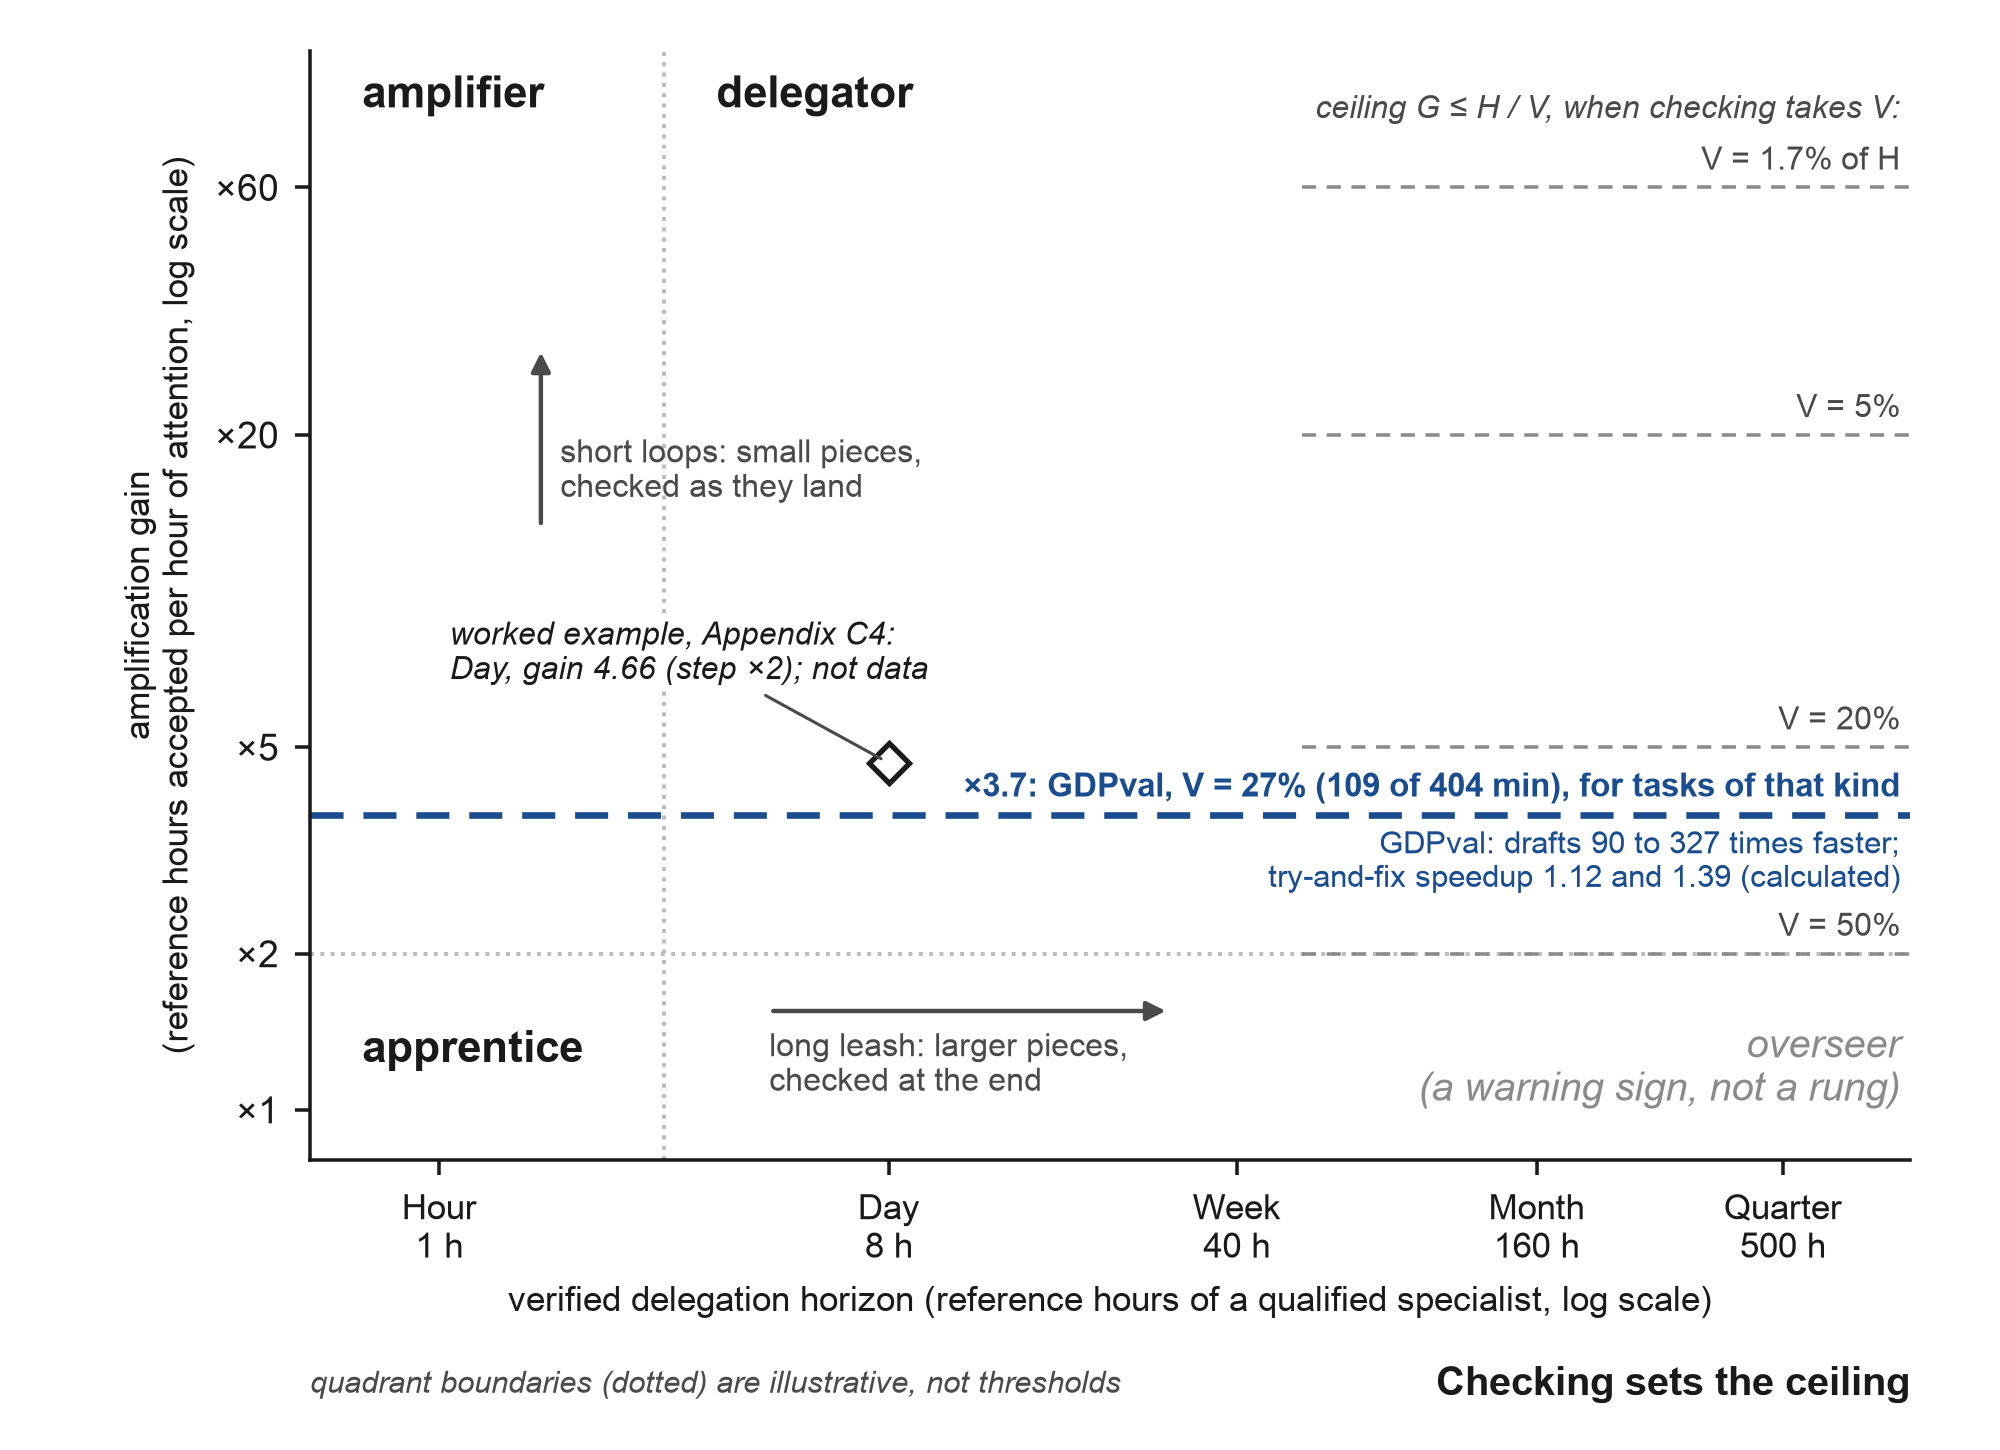
Примітка: Квадранти — це профілі, а не щаблі, і їх межи є ілюстративними. Кожна сіра лінія — це межа G ≤ H / V з розділу 5.5 для заданої частки часу перевірки V у часі ручної роботи H. Акцентна лінія використовує середні значення GDPval за його золотою підмножиною зі 220 завдань, 404 хвилини ручної роботи та 109 хвилин експертної рецензії результатів моделі (Patwardhan et al., 2025), і застосовується для завдань такого типу. Прискорення 1.12 та 1.39 — це розрахунок авторів, а не вимірювання. Ромб — це розроблений приклад з додатка C4, а не дані. Він знаходиться вище лінії GDPval, тому що стеля обчислюється за типом завдання, і малі частини, перевірені дешево, можуть перевищити стелю, обчислену для великих (розділ 5.5). Випадок 36 етапів у розділі 5.4 не відображений на графіку: посилання не дає виграшу та незалежної перевірки.
5.6 Звідки взялась міра, і що нового
Міра має своїх попередників, а найдавніший — Еліотт Жак, який вимірював рівень будь-якої роботи в будь-якій функції за часовим діапазоном дискреції: найдовший час, протягом якого людина працює на основі власного судження, перш ніж хтось переглядає результат. Він стверджував, що справедливу зарплату зростає разом із цим діапазоном (Jaques, 1956). Перевірений горизонт делегування переносить цю ідею в епоху агентів з однією змінною. Жак вимірював, як довго людина працює без перевірки, тоді як ця міра підраховує, скільки роботи людина передає агентам, приймає і перевіряє. Ці два можуть розходитися, і його шари, віднесені в місяцях та роках, не відповідають цим щаблям.
Теорія «принципал-агент» — другий попередник. Jensen і Meckling (1976) оцінили делегування як моніторинг, забезпечення та залишкові втрати. Перевірка — це вартість моніторингу при передачі роботи агенту, а горизонт позначає точку, де перевірка більшого шматка більше не окупається.
METR вимірює машини на тій же осі. Його часовий горизонт — це тривалість завдання в людино-годинах, яке модель виконує при заданому рівні успішності (Kwa et al., 2025). Навесні 2026 року передова модель на його панелі приладів досягла близько 17 годин при 50% успіху, хоча сам METR попереджує, що вимірювання вище 16 годин ненадійні з його поточними завданнями. Горизонт при 80% успіху зріс з приблизно 1,2 години у лютому 2026 р. на приблизно 3,1 години в квітні, два моменти, які ілюструють темп росту без вимірювання його швидкості. Тенденція, підібрана на панелі приладів у всіх моделях з 2023 року, подвоюється приблизно кожні 4,2 місяці (128,7 днів), і панель приладів не оновлювалась після 8 вересня 2026 р., коли до неї востаннє звертались (METR, 2026c). Прогнозисти проекту AI Futures Project працюють з часом подвоєння 4–4,5 місяців (AI Futures Project, 2026). Прийнята робота відповідає горизонту 80% більше, ніж горизонту 50%. Розрив між тим, що модель іноді завершує, і тим, що вона надійно завершує, — це робота людини, яка полягає в тому, щоб показати, що результат правильний, і довести його до кінця. Рисунок A3 (додаток F) порівнює ці машинні горизонти зі щаблями.
Теорія 2026 р. вказує на той же розрив. Huang, Xiao та Vishnoi (2026) моделюють делегування під час ШІ і виявляють, що невеликі різниці у здатності до перевірки призводять до великих різниць у результатах: ШІ допомагає тим, хто перевіряє, і шкодить тим, хто передає занадто багато. Їхня робота була прийнята на ICML 2026, і вони називають цей ефект посиленням верифікації. Структурований огляд 24 досліджень показав, що жоден перевірений інструмент у його основному корпусі не охоплює повну комбінацію навичок, необхідних для контролю агентів (обсяг, дозволи, відновлення, незалежна рецензія та закриття на основі доказів), хоча деякі інструменти охоплюють її частини (Veri', 2026). Рамка DeepMind для інтелектуального делегування ШІ описує делегування в цілому та не містить міри на рівні особи (Tomašev et al., 2026), а економіка делегування тепер має свої передові моделі (Wang, 2026). Chen та Meng (2026) показують, що генеративний ШІ стискає відмінності у навичках у межах завдання та зміщує цінність на дефіцитні додаткові активи, і вони додають, що дані панелі «особа за завданням», необхідні для перевірки їхніх прогнозів, «ще не існують у масштабі». Міра, яку я пропоную, виробляє дані саме такого типу, оскільки кожна зареєстрована частина містить особу, розмір і дату.
Друга вісь має своїх сусідів, а коефіцієнт посилення — це їх форма на рівні особи, перевірена. Engelbart (1962) представив обчислення як посилення людського інтелекту, а «супер-дієвість» — це слово McKinsey для тієї ж надії у 2025 р. (McKinsey, 2025). Індекс економіки Anthropic оцінює розмови за прискоренням (час без ШІ, поділений на час з ним) та автономією агента за шкалою від 1 до 5, обидва оцінюються моделлю (Anthropic, 2026a). WORKBank Стенфорда оцінює залучення людини, яке працівники віддають перевагу, за шкалою від H1 до H5 (Shao et al., 2025). Стаття 2026 р. визначила контрольну спроможність як корисний перевірений результат проти людської праці та явно відмовилась давати їй число (em360, 2026), а «посилений нагляд» — це термін ШІ безпеки для допомоги людям контролювати системи, сильніші за себе. Спостереження пошукового агента показує те ж саме зміщення людського часу в сторону перевірки: агент працює самостійно 26 хвилин за сеанс, тоді як простий пошук тривав 33 секунди (Yang et al., 2026). Зі сторони делегування, Khadj (2026) та Alonso (2026) використовують «горизонт делегування» для того, наскільки далеко машина або фірма можуть делегувати, робота CHI 2026 на «горизонтах рішень» вивчає втрату самовдалення (Люнезька університет, 2026), а Dawson (2026) та Metal Toad (2026) публікують рівні делегування ШІ практиками. Жодна з них не розміщує людину на рівні за роботою, яку підтвердила незалежна перевірка.
Найближчий недавній рамка порівнюється тут безпосередньо. Рамка AIDEs JetBrains Research (Tikhomirov, 2026) розділяє дві особливості з цією мірою: вона розглядає делегування як відношення принципал-агент, і розташовує делегування на рівнях, п'ять з них, описані атрибутами, такими як автономія та планування. Вона відрізняється на чотирьох. Її предмет — розробка програмного забезпечення, тоді як горизонт оцінюється в будь-якій сфері. Її рівні описують, як делегується робота, тоді як щабель встановлюється розміром роботи в еталонних годинах кваліфікованого фахівця. Він не має правила, що перевірка має бути незалежною від агентів, тоді як щабель враховує тільки частини, підтверджені перевіркою, яку агенти не бачили. І він не має підрахунку в вікні та немає другої осі, тоді як щабель потребує частки пропусків протягом датованого вікна, а коефіцієнт посилення додає години уваги. Мова агентури поділяється; одиниця, правило незалежності та обсяг за межами програмного забезпечення — це те, що пропонує ця робота.
Багато масштабів було опубліковано у 2025 та 2026 роках, і жоден масштаб у таблиці 2 не вимірює особу за перевіреною роботою. Таблиця 2 групує основні за тим, що вони вимірюють; таблиця A3 (додаток F) перелічує кожну з них.
Таблиця 2. Масштаби 2025 та 2026 років, згруповані за тим, що вони вимірюють.
| Сім'я | Приклади | Одиниця виміру | Розміщує особу за перевіреною делегованою роботою? |
|---|---|---|---|
| Рівні автономності агентів і машин | Feng et al., 2025; Shapiro, January 2026; Memari & Rudolph, 2026; METR, 2025-2026 | Агент, модель або налаштування команди | Ні |
| Етапи практики розробника | Yegge, 2026; Park et al., 2026; Microsoft, May 2026 | Практика, контрольна робота або моделі роботи | Ні |
| Делегування організаціями та фірмами | Dawson, 2026; Metal Toad, 2026; Tomašev et al. (DeepMind), February 2026; Khadj, 2026 | Організація, менеджер, фірма або делегування в цілому | Ні |
| Делегування розробником як стосунок принципал-агент | JetBrains Research (Tikhomirov), September 2026 | Делегування розробника | Тільки розробники; без правила незалежності для перевірок і без одиниці розміру |
| Рамки компетентності та грамотності | AI Certification Standards, 23 August 2026; Anthropic AI Fluency, 2025b | Компетентності або грамотність | Ніякого іспиту, порогів або рівнів |
| Перевірений горизонт делегування та посилення прибутку | This paper | Особа в галузі | Так, за правилом Розділу 5.2 |
Примітка: «Розміщує особу за перевіреною делегованою роботою» означає, що шкала розміщує індивіда на рівні за розміром роботи, делегованої агентам і підтвердженої перевіркою, яку агенти не бачили. Найближчий сусід — п'ять рівнів JetBrains: вони використовують мову принципала та агента й відрізняються в правилі перевірки (незалежна перевірка, яку агенти не бачили) та в одиниці (референтні години). Таблиця A3 (Додаток F) перелічує кожну шкалу окремо.
Один практик добре сформулював заперечення проти будь-якої особистісної шкали: «ваш рівень автономності є властивістю сховища, а не розробника й не моделі» (Phoenix, 2026). Я прийму половину цього. Горизонт належить людині в галузі під режимом перевірки, і добре побудоване сховище з прихованими тестами є частиною цього режиму, що є однією з причин, чому горизонт реєструється на домен і з датою.
5.7 Два запитання з супровідної статті
Супровідна стаття залишила відкритим питання, чому досвідчені користувачі менше делегують — чи вони отримали опіки, чи їхнє судження є продуктом (Chernets, 2026a). Друга вісь може розрізнити ці два випадки. Якщо частка директивного використання зменшується, а перевірений прибуток зростає, судження є продуктом; якщо прибуток також падає, вони отримали опіки. Супровідна стаття також запитала, чи є словниковий запас делегування однією граматикою чи однією на професію. Я займаю позицію: граматика одна (встановити завдання, потім прийняти його на основі доказів), тоді як те, що вважається доказами, різниться за доменами, через що щаблі є спільними, а оцінювання відбувається на домен.
Інструмент Додатку C повідомляє про частку директивного використання для кожної особи та домену, підраховувану за частинами (частка частин, що були передані в одній частині, проти етапів або спільної роботи), тому перший, грубий тест можна запустити на тих же записах, які дають щаблі. Передбачення F20 формулює тест із датою його зареєстрованої міри, «частка ходів особи, яка дає інструкції, а не перевірку або редагування, з журналу» (Table A6): там частка підраховується над ходами журналу сеансу, а не над частинами журналу робіт Додатку C, тому це точніша з двох підрахунків.
5.8 Як можна маніпулювати мірою та захисти
Підрахунок прийнятої, незалежно перевіреної роботи закриває найдешевший маршрут — витрати, але рішуча людина чи роботодавець, що переслідує ціль, усе ще має інші. Таблиця 3 перелічує їх із захистом, який дають правила. Захисти коштують дещо, і вартість є частиною дизайну: аудитований щабель коштує більше, ніж самозвіт, так само як аудитований рахунок коштує більше, ніж звіт.
Таблиця 3. Способи маніпулювання мірою та захисти.
| Маршрут | Як це виглядає | Захист |
|---|---|---|
| Легкі перевірки | Приховані тести, які проходить слабке рішення; рецензент, який переглядає мимохідь | Випадковий аудит частки прийнятих частин другим незалежним перевіряючим; насаджені помилки від Week та далі; тип перевірки надруковується поруч із оцінкою |
| Вибір завдань трохи вище порога | Багато частин 8.1 референтних годин для досягнення Day | Щаблі, прочитані з розподілу розмірів, з медіанним прийнятим розміром, зазначеним поруч зі щаблем |
| Щедрі оцінювачі годин | Оцінювачі, які завищують референтні години | Два оцінювачі сліпі до особи; розбіжність вище фіксованого коефіцієнта відправляє частину в frozen bank або третьому оцінювачу; записи оцінювачів аудитуються |
| Приховна допомога | Колега або підрядник виправляє роботу поза журналом | Увага реєструється для кожної частини; випадкові інтерв'ю або відтворення; зовнішня допомога записується як поле й виключається з прибутку особи |
| Нарізання | Місяць роботи порізаний на одногодинні квитки | Тільки когерентний результат, прийнятий як ціле, рахується для щабля |
| Приховування невдач | Залишені або невдалі частини, виключені з журналу | Кожна передача реєструється з датою початку та закривається, коли вона прийнята, відхилена або залишена; публічний запис невдач; рівень успіху, який виглядає занадто чистим, спричиняє аудит |
| Корельована перевірка | Друга модель однієї сім'ї узгоджується | Не рахується (Розділ 5.2) |
| Паралельні потоки | Увага рахується один раз на потік | Увага рахується один раз за особу-хвилину (Розділ 5.4) |
Пороги — це вибір дизайну, версіоновані як правила v1.1 і змінюються лише в новій версії після даних. Десять компонентів у вікні — це мінімальна кількість, при якій 80% успішної частки щось означає (вісім успіхів з десяти). Вікно з 91 дня для нижчих щаблів і для недавніх фрагментів, потрібних на вищих, збігається з квартальною перевіркою та темпом змін інструментів. Правило щабля — це правило кваліфікації і не дає оцінки надійності людини. Вісім успіхів з десяти узгоджуються з істинним рівнем успіху в діапазоні приблизно від 44% до 97% (точний 95% інтервал), а три з трьох — з таким низьким як приблизно 37% (односторонньо 95% межа). Зареєстроване дослідження калібрування оцінює надійність. Частка 80% слідує використанню METR горизонту 80% як рівня надійної роботи, а щаблі з 1, 8, 40, 160 і 500 годин слідують робочій годині, дню, тижню, місяцю та кварталу, так щоб вони не потребували перекладу між професіями. Настільна перевірка порогів перевірила правила за допомогою симуляції та з модельними оцінювачами (Додаток E). Вона обчислила, як часто людина з відомою надійністю заробляє кожен щабель (Рисунок A2, Додаток E). При істинному рівні успіху 0,8, День заробляється в 68% вікон і той самий вердикт повторюється в наступному вікні в 56%, тому запис виводить кількість поруч з щаблем, як у «День (8/10)». Вона також знайшла помилку в першій версії правил: чотири з чотирьох на Місяці було складніше заробити, ніж три з трьох на Кварталі (41% проти 51% при рівні успіху 0,8), тому Місяць тепер вимагає п'яти з шести за рік. Перенесення кількості з десяти на вісім або дванадцять, або частки з 0,8 на 0,7 або 0,9, змінює вердикт День у 8%-11% імітованих журналів, а перенесення обох змінює його у до 22%. Чотири модельні оцінювачі з чотирьох сімей, оцінюючи референтні години наосліп, впорядкували 30 завдань послідовно (внутрішньокласова кореляція 0,89 на логарифмічних годинах), але розмістили лише 62% пар у межах множника 1,5, проти критерію протоколу калібрування 70%, і розрізнялися у два рази в їх загальному рівні; з урахуванням лише публічного ідентифікатора завдання, їх середня оцінка була в межах множника 1,5 від виміряних людських часів для 3 з 14 завдань. Тому модельні оцінювачі не можуть замінити двох людських оцінювачів, і оцінювачі польового дослідження спочатку калібруються на завданнях з виміряним часом. Протокол калібрування заздалегідь встановлює наступні тести: узгодженість між людськими оцінювачами (критерій: принаймні 70% пар у межах множника 1,5), повторюваність щабля людини протягом двох послідовних вікон (зважена каппа принаймні 0,6) і здатність щабля передбачати проходження нових завдань того ж розміру (AUC принаймні 0,7). Його протокол і текст реєстрації знаходяться в супровідному репозиторії, а перший тест з робочими професіоналами щодо їх узгодженості щодо референтних годин зареєстрований і описаний у Додатку G.
Таблиця A4 (Додаток F) дає правило для складних випадків, які виникають першими.
Додаток C, розділ C4, розбирає журнал однієї людини з десяти рядків, що приводить до єдиного запису.
6. Нейтральність походження та точка перехресту кваліфікацій
6.1 Нейтральність походження
Гіпотеза полягає в тому, що при рівному верифікованому горизонті в галузі програмна освіта не передбачає якість незалежно перевіреної роботи, коли враховуються володіння галуззю та грамотність прийняття.
Висновок Anthropic про те, що «здатність спрямовувати Claude до успіху залежить більше від володіння галуззю, ніж від навички писати код», узгоджується з гіпотезою, але не перевіряє її (Anthropic, 2026e): його дані сортують людей за професіями, а не за освітою, і розрив 34% проти 29% у розділі 2.2 є розривом між професіями. Тільки дослідження F7 перевіряє гіпотезу. Існує також сильна альтернативна гіпотеза. Савва (2026) моделює роботу, збагачену штучним інтелектом, як задачу принципала-агента й передбачає, що штучний інтелект звужує розриви між людьми на простих завданнях і розширює їх на складних. Якщо Савва правий, нейтральність походження буде дотримуватися на коротких завданнях і не буде дотримуватися на вищих рівнях, тому передбачення F7 оцінюється окремо на День та на Тиждень і вище, де гіпотеза стикається зі своїм найсуворішим тестом.
Грамотність прийняття — це навичка, на яку спирається гіпотеза. Це означає заздалегідь сформулювати, що буде вважатися завершеним, а потім це показати: через приховану перевірку, другу сім'ю моделей, що перевіряють джерела, порівняння з джерелом, який сам відкрив користувач, або артефакт замість гарантії. Грамотність агента охоплює делегування, перевірку та управління загалом (MindStudio, 2026); грамотність прийняття ставить стандарт доказу в її центр. Вона також відрізняється від прийняття технології у сенсі традиції TAM, яка досліджує, чи люди приймають технологію, оскільки прийняття тут — це рішення прийняти роботу. Запис про прийняття супровідної роботи стає одиницею доказу для рівня.
6.2 Точка перехресту кваліфікацій
Точка перехресту кваліфікацій у галузі — це момент, коли продукти, зроблені людьми без IT-освіти, прийняті за однакових незалежних перевірок, починають перевищувати ті, що зроблені програмістами з використанням тих же агентів, після чого ступінь IT та звання junior і senior втрачають свою прогностичну вагу при найманні в цій галузі.
Це визначення — мій прогноз від 8 жовтня 2026 року, уточнений (розділ 1). Його компоненти можна спостерігати окремо, і кожен датується окремо, так що момент можна визначити, коли вони вишикуються. Паритет якості — це крок перед моментом: у галузі продукти людей без IT-освіти не гірші за ті, що зроблені програмістами з тими ж агентами, на тих самих завданнях, при сліпих перевірках (передбачення F2). Перевищення — це сам момент, коли ці продукти стають кращими при тих же перевірках (F3, із етапами випуску та обслуговування в F4a та F4b). Перехід в оголошеннях — це видимий знак, коли оголошення про роботу, що запитують навички агентів, менше вимагають ступеня, ніж порівнювальні оголошення, які цього не роблять (F5). Нейтральність походження — це механізм, оскільки на рівному рівні освіта припиняє передбачувати перевірену якість (F7).
Точка перехресту в галузі датується першим роком, у якому в тій же названій галузі показано перевищення (F3) і виконано аналог галузі переходу в оголошеннях (F5 обчислено на основі оголошень цієї галузі; Додаток D). Паритет без перевищення — це наближення до точки, і перехід в оголошеннях без перевищення показав би роботодавців, що рухаються попереду доказів. F2, F3, F5 та F7, таким чином, утворюють одну програму над тими ж названими галузями: галузі зафіксовані при реєстрації, експеримент F2, F3 та F7 проводиться в них, а F5 обчислюється як на замороженому наборі IT-професій, так і на оголошеннях про роботу кожної з цих галузей. Точка перехресту оголошується для галузі тільки коли правило якості (F3) і правило найму (аналог галузі F5) обидва виконуються в тій же галузі; будь-яке одне саме по собі нічого не оголошує.
Перші два компоненти тестуються експериментами на узгоджених завданнях (розділ 11). Третій вже можна спостерігати в оголошеннях про роботу. Lightcast повідомив у вересні 2026 року, що оголошення про IT, які вимагають навичок штучного інтелекту, все ще частіше запитують чотирирічний ступінь, ніж оголошення про IT без них. Однак серед оголошень про штучний інтелект вимоги щодо ступеня знаходяться в «явному спаді з 2024 року», тоді як вони зросли в інших оголошеннях про IT (Lightcast, 2026b). Дві лінії збігаються і не перетиналися (Рисунок 5). Lightcast визначає оголошення про штучний інтелект більш ніж 300 навичками штучного інтелекту, тому його лінії описують роботу зі штучним інтелектом загалом. Підмножина агентів, визначена замороженим списком навичок агентів (Lightcast, 2026a), — це та, яку використовує прогноз, і його базова лінія береться до реєстрації.
Це направлення має прецедент. Боун, Гонсалес-Еллінгер та Стефані (2025), використовуючи близько одинадцяти мільйонів вакансій у Великобританії до середини 2024 року, виявили, що вимоги щодо освіти впали у ролях штучного інтелекту й порівняли преміум до заробітної плати, прикріплені до навичок та ступенів. Ця робота задокументувала найм на основі навичок для штучного інтелекту до агентів. Ця стаття поширює цю лінію на навички агентів із датованим порогом і порівнянням із узгодженими оголошеннями та пропонує пов'язати вимоги оголошення з незалежно перевіреною продуктивністю в тестах, які мають бути попередньо зареєстровані. Барометр робіт AI компанії PwC повідомляє про той же напрямок по країнах і служить джерелом резервного копіювання, де він вимірює ту саму величину (PwC, 2026).
Другий показник — це відстань між тим, що роботодавці говорять, і тим, що вони роблять. Багато роботодавців видалили вимоги щодо ступеня зі своєї політики до приходу агентів, але Інститут Burning Glass та Гарвардська школа бізнесу виявили, що зміна торкнулася менш ніж одного найму з 700 (Інститут Burning Glass та Гарвардська школа бізнесу, 2024). Оголошення рухалися в іншу сторону: у листопаді 2025 року 19,3% американських оголошень на Indeed запросили ступінь бакалавра або вище, значно більше, ніж роком раніше (Indeed Hiring Lab, 2026). Вимога щодо ступеня, видалена на папері, — це зміна політики, і перехід показується тільки коли найм сам змінюється. Аудиторське дослідження, надсилаючи узгоджені портфелі, які відрізняються лише освітою, до реальних оголошень, побачило б це спочатку, і передбачення F26 включає одне.
Диплом належить до родини воріт, які пропускають людей за ярликом: профіль на платформі, посадовий титул, диплом і частково ліцензія. Ярлик розповідає роботодавцю про роботу лише тією мірою, наскільки його наявність корелює зі здатністю виконувати роботу. Агенти послабляють цей зв'язок з одного боку, оскільки люди без цього ярлика тепер виробляють роботу, яка схожа на професійну (Розділ 2.2), а ярлик, що спирається на слово самої людини, завжди був дешевим у претензіях. Ворота, що перевіряють саму роботу, не залежать від жодного з них. Дослідження оцінювачів з Додатка G випадково зустріло цю відмінність. Prolific допускає учасників до дослідження через фільтри, чиї відповіді здебільшого самозасвідчені, причому вік і країна проживання — головні винятки, які він перевіряє (Prolific, 2026). З 60 людей, яких його фільтри допустили до вибірки з бухгалтерського обліку, 11 неправильно відповіли на перше запитання з професійних знань (Додаток G2): ярлик їх пропустив, а одне питання з професійних знань їх зупинило.
Дослідники, які нанимали програмістів на таких платформах до агентів, повідомили про той самий тренд і проводили скринінг власними питаннями на знання: в одному дослідженні 42% працівників платформи, які вказали навичку програмування, не задовольнили критерії таких питань (Danilova et al., 2021), а в іншому, на Prolific, 55 з 206 респондентів, які повідомили про програмування на Node.js, пройшли всі його питання програмування (Reid et al., 2022). Питання на знання саме по собі — слабші ворота, ніж перевірка виконаної роботи, і мовні моделі їх теж послабляють: у змодельованій атаці ChatGPT легко розв'язав існуючі питання скринінгу для програмістів (Serafini et al., 2024), а до 2026 року також обійшов статичні візуальні питання, які були розроблені щоб йому опиратися, тоді як звукові питання, які розкривають свій вміст поступово під суворим часовим обмеженням, ще працювали (Serafini et al., 2026). З точки зору найму, втрата ваги, яку визначення вище передбачає для диплома, — це ворота першого типу, що відступають перед воротами другого типу, а перевірений горизонт делегування — ворота другого типу: він записує не те, що людина говорить про себе, а те, що вона передала, і те, що пройшло перевірку, яку агенти не бачили.
Ліцензії знаходяться між двома типами. Ліцензія, що спирається на екзамен, пройдений один раз, працює з того моменту як ярлик; ліцензія, чия робота тримача перевіряється, ближче до перевірки. Аудиторські фірми, зареєстровані в Наглядовій раді з питань бухгалтерського обліку публічних компаній США, мають свою аудиторську роботу інспектовану щороку, якщо вони регулярно здійснюють аудит понад 100 емітентів, і щонайменше раз на три роки в іншому випадку, якщо Рада не встановить іншу схему за правилом (Sarbanes-Oxley Act of 2002, s. 104), повільніший аналог для підписаної роботи фірми, повторної перевірки, яку розділ 5.2 запитує від горизонту. Сам ліцензування почав рухатися до другого типу. З травня 2024 року Орегон запропонував випускникам факультету права шлях до ліцензії без екзамену на допуск до адвокатури, Supervised Practice Portfolio Examination: протягом щонайменше 675 годин контрольованої практики кандидат подає вісім творів писемної роботи, дві взаємодії з клієнтом і дві переговори, а оцінювачі, які застосовують рубрики Ради екзаменаторів адвокатури, судять про те, чи кожен з них демонструє мінімальну компетентність. До 5 січня 2026 року 205 кандидатів подали заявку та 49 стали ліцензованими адвокатами, перший з них у грудні 2024 року (Oregon State Board of Bar Examiners, 2026). Юридичний диплом все ще потрібен, тому перевірена робота замінює екзамен, а не школу. У бухгалтерії рух менший: у травні 2025 року AICPA і NASBA затвердили зразкове законодавство щодо шляху до ліцензії CPA, яке вимагає другого року професійного досвіду замість 30 кредитних годин навчання за межами бакалаврського ступеня, з екзаменом, що зберігається, і кожна держава повинна прийняти його до того, як кандидати зможуть його використовувати (Journal of Accountancy, 2025). Те, що закон зберігає для ліцензії, залишається межею вимірювання (Розділ 13). Таблиця A8 (Додаток F) розміщує ворота цього розділу поруч за тим, що кожен перевіряє.
Термін "credential" має друге значення у безпеці агентів, де він позначає секретний ключ або токен. Тут це означає диплом або сертифікат. Фраза "credential crossover point" у цьому значенні не дала збігів у наукових базах, пошук яких проводився 9 жовтня 2026 року (Додаток B).
Рисунок 5. Розрив у перевіреному успіху та вимозі диплома в оголошеннях: що спостерігається, і що 2027 тестуватиме.
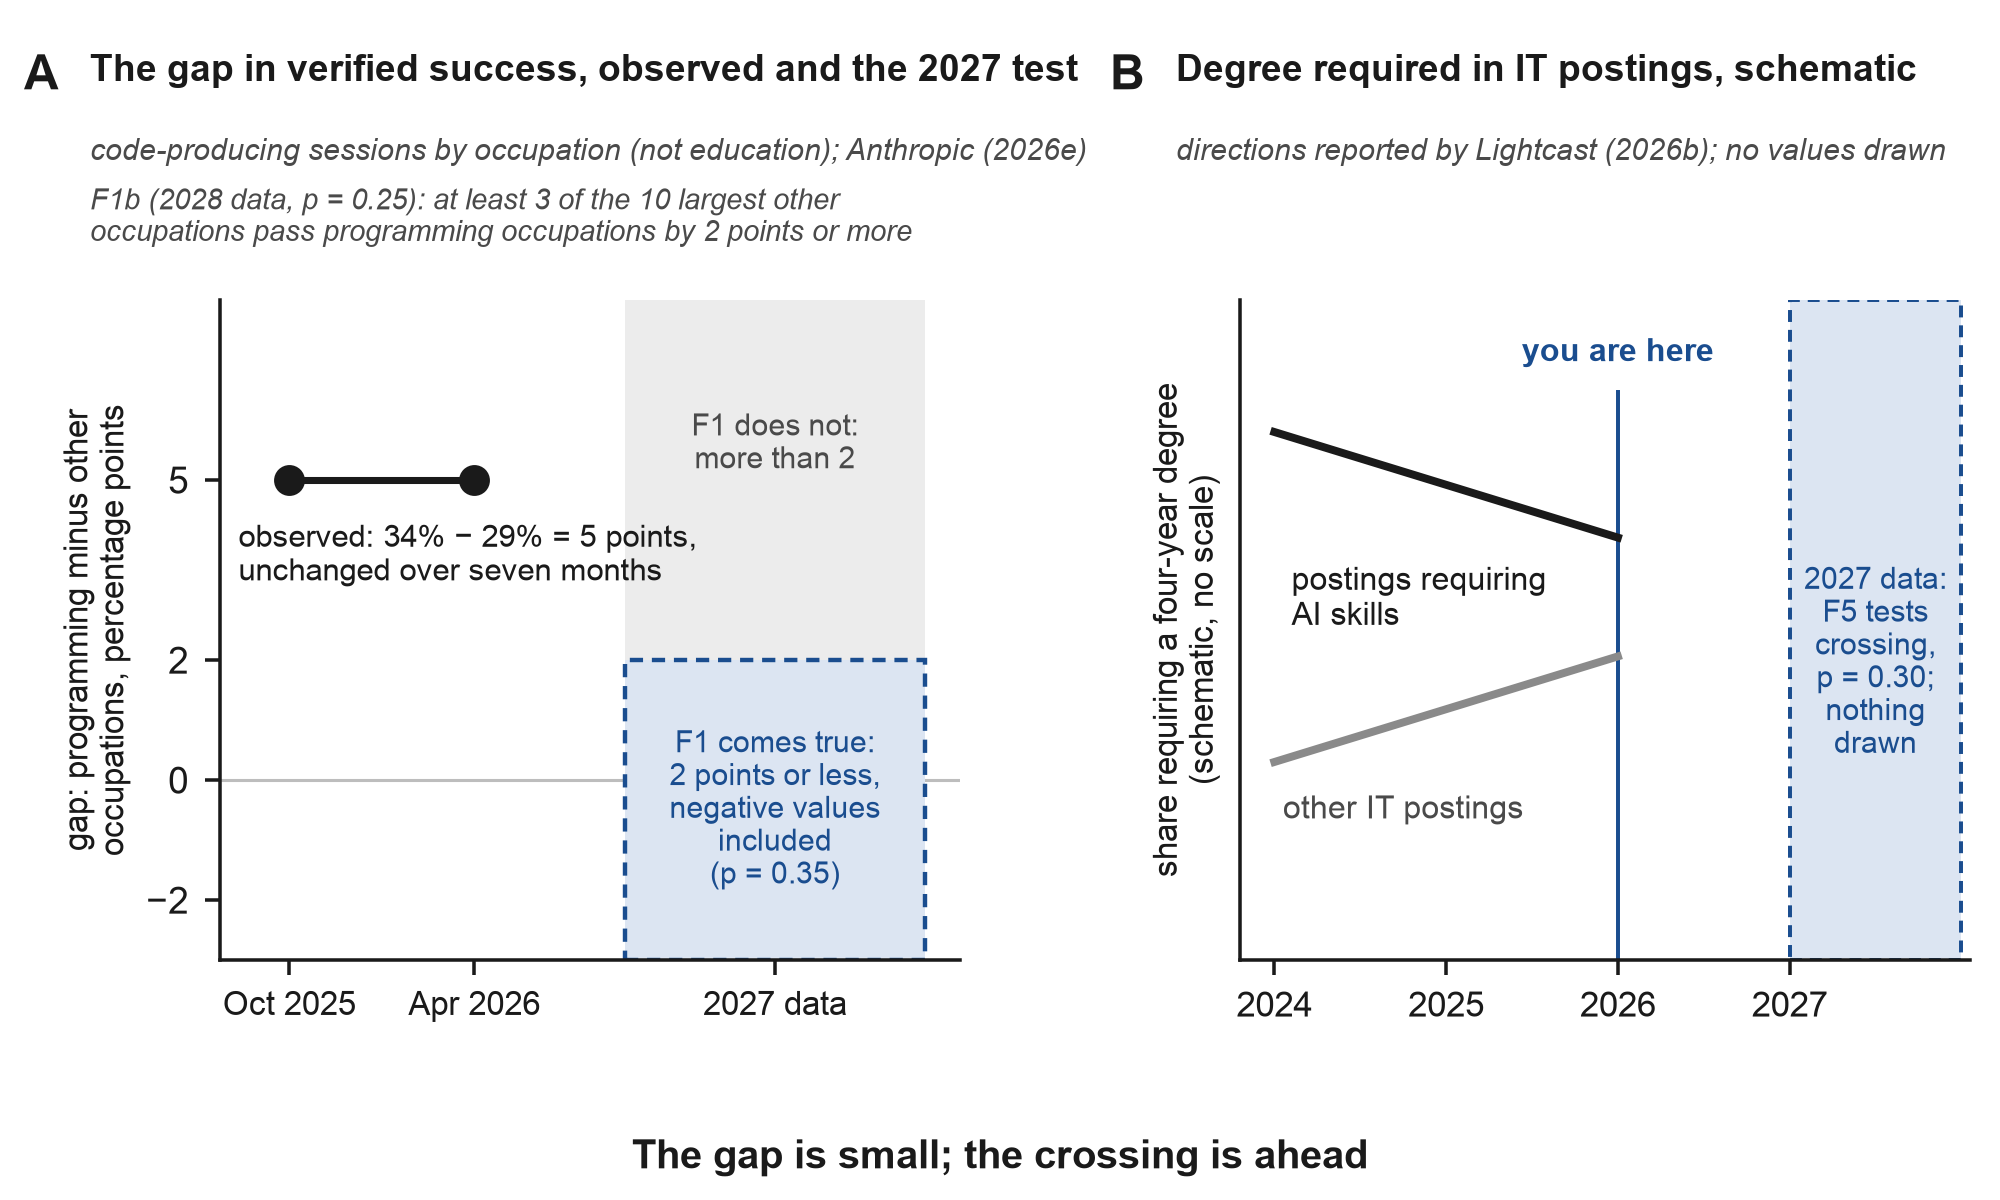
Примітка: Панель A використовує Anthropic (2026e), сеанси, що виробляють код, 34% для програмістських професій проти 29% для інших професій, без змін протягом семи місяців. Професія не є освітою, а успіх означає досягнення, підтримане доказами, такими як тести або коміти. Смуга — це поріг прогнозу F1 (розрив з 2 точками або менше, включено від'ємні значення, ймовірність 0.35); F1b (ймовірність 0.25) в Таблиці A6. Панель B малює лише напрями, які Lightcast (2026b) повідомив до 2026 року, без його значень. Вікно 2027 залишено порожнім: жодне перетинання не намальовано, оскільки прогноз F5 (ймовірність 0.30) вирішить це.
6.3 Домени: чому програмістська перевага була горизонтальною
Штучний інтелект спочатку здешевлює все те, що є горизонтальним, однаковим у кожній галузі, і механізм ясний: можливість, яка передається через галузі, — це та, яку модель загального призначення може забезпечити всім одночасно. Тонкі обгортки над моделлю, програмне забезпечення загального призначення та загальна здатність писати код пішли саме цим шляхом. Промпт-інженер, найпопулярніша назва 2023 року, до 2025 року був оголошений застарілим, оскільки навичка розчинилася в інструментах і стала надбанням усіх (Fortune, 2025). Стара перевага програміста була також горизонтальною. Код працює в будь-якій галузі, тому програміст міг будувати для юридичної фірми або лікарні, не знаючи жодної з них, і агенти, здешевляючи код, відбирають цю перевагу. Ніхто не мав стати програмістом для того, щоб це сталося. Програмне забезпечення стало однією вертиккаллю серед багатьох (з інфраструктурою та безпекою як близькими сусідами), і всередину нього програмісти залишаються найсильнішими. Та сама логіка застосовується до людей, як і до фірм: людина без вертикалі — це обгортка над ШІ, така ж виявлена, як тонко обгорнутий продукт. Коли агенти роблять програмне забезпечення загального призначення легшим у побудові, старе вертикальне програмне забезпечення може зіткнутися з тиском з двох боків: від лабораторій, які беруть інформаційний шар, і від фахівців, які будують власні інструменти. Гіпотеза полягає в тому, що знання предметної галузі, поєднане зі здатністю приймати роботу агентів, набирає вартості. Сама вертикальність не захищає нікого; глибина робить це, що означає здатність приймати роботу в галузі, яку модель або новачок не можуть підробити.
Вертикаль тут — це галузь, де людина може прийняти роботу агента, і вона може бути або не бути тією, де вони мають диплом. Для прийняття юридичної роботи потрібно знати закон достатньо добре, щоб виявити правдоподібну помилку. Один розробник у темах розділу 9 каже це ясно: щоб побачити, що вихід — це нісенітниця, потрібно знати хоча б трохи в цій галузі (перекладено). Прийняття залишається з людиною, як і ім'я та підпис під результатом, власний контекст людини (клієнти, дані, місцеві правила, мова) та обслуговування після випуску.
Лабораторії купують інформаційний шар вертикалей. Mercor, яка продає час експертів лабораторіям ШІ, досягла річного валового обороту в 2 мільярди доларів у червні 2026 року, продаючи час експертів, таких як радіологи (Dealroom, 2026). Витрати підприємств на програми вертикального ШІ майже утроїлися до 3,5 мільярда доларів у 2025 році (Menlo Ventures, 2025). Це розгалуження дає експерту в предметній галузі дві долі. Донор продає знання лабораторії як мітки, і це знання споживається один раз. Основна сторона зберігає знання всередину свого продукту та відповідає за результат, і знання продовжує працювати.
Наслідок для вимірювання полягає в тому, що горизонти не передаються цілком між галузями. Адвокат, який переходить у програмну інженерію, і програміст, який переходить у право, втрачають одне й те саме — здатність приймати роботу в галузі, яку вони не знають. Ця симетрія — це те, як виглядає кінець особливої позиції програміста, і це можна виміряти. Точка переходу також прибуватиме галузь за галуззю. Вона повинна прийти першою там, де код став дешевим, де перевірка потребує знання предметної галузі, і де ринки малі або локальні: право, бухгалтерія, освіта, адміністрування клініки, вузькі ніші між підприємствами, ринки менших мов. Саме програмне забезпечення повинно прийти останнім. Один аналітик зробив відповідний прогноз у лютому 2026 року, називаючи фінанси "канарцем у вугільній шахті" та очікуючи, що кожна перевіряєма задача матиме траєкторію фінансів та бухгалтерії до 2027 року (Hwang, 2026). Висновок Anthropic про те, що менеджмент вже дещо переважає програмістів у сеансах кодування, — це ранній знак (Anthropic, 2026e). Запис розділу 5.3 називає галузь у першому полі, і будь-яку назву професії можна поставити перед ним.
Та ж логіка передбачає долю титулів. Горизонтальні назви, такі як менеджер агента, оператор ШІ та оркестратор, описують людей, які загалом обгортають агентів. Один практик очікує, що управління агентами триватиме "наступних 18 місяців", перш ніж ШІ зробить те ж саме (IT Brew, 2026), тоді як Srinivasan та Wei (2026) очікують, що "менеджер агента" стане стандартною назвою протягом 12–18 місяців; прогноз F9 протиставляє ці два погляди один одному. Та сама стаття нараховувала 739 оголошень для оркестраторів ШІ у лютому 2026 року, на 1294%, і ця цифра вказує в іншому напрямі. Назви, пов'язані з галуззю, такі як "Вертикальний лідер ШІ", який відповідає за розгортання агентів у кожній вертикалі (Haize Labs, 2026), повинні зростати швидше, і розділ 11 встановлює прогноз на порівняння.
6.4 Діти з передовими моделями
Заперечення стосується суті аргументу про галузь. Передова модель знає більше біології, ніж університетський факультет. Дитина із свіжою ідеєю може описати її агенту і отримати робочий сайт або додаток про біологію або про автомобілі протягом тижня без будь-якої спеціалізації. Чому ж тоді мають значення галузі?
Частина передумови вже є істинною. У Пекіні учні шостого класу побудували власного агента ШІ на занятті на графічній платформі у вересні 2025 року (Xinhua, 2025). Міністерство освіти Китаю поставило за мету впровадження освіти ШІ по суті в усіх початкових та середніх школах до 2030 року (CSET, 2025). У Сполучених Штатах виконавчий наказ від квітня 2025 року запустив Президентський виклик ШІ, переможні шкільні проекти якого включали помічника з домашніх завдань, чат-бот проти цькування та інструмент для студентів з вадами зору (White House, 2025; EdWeek, 2026). Доступ до передових агентів досі обмежений віком, однак. Claude призначена для дорослих, і облікові записи, позначені як такі, що належать неповнолітнім, були припинені (MediaNama, 2026). OpenAI представила прогнозування віку та обмежений режим для підлітків (AlternativeTo, 2026). Діти швидше за все досягають передових моделей через школьні платформи та режими для підлітків, ніж через терміналь, і "кожна школа протягом року" виглядає скоріше як 2027–2030 роки.
Глибша відповідь походить від різниці між папером та світом. На папері дитина перемагає: передові моделі показують кращі результати, ніж типові експерти на питаннях науки рівня магістратури, і в рандомізованому дослідженні новачки з моделлю були приблизно в чотири рази точніші за контрольну групу на завданнях письмової біології (Turner, 2026). У світі перевага зникає. У дослідженні 1298 осіб, опублікованому в Nature Medicine, самі моделі називали правильний діагноз у 94,9% випадків, тоді як люди, які використовували ті самі моделі, робили це менш ніж у 34,5% випадків, не краще за контрольну групу (Nature Portfolio, 2026). У восьмитижневому мокрому лабораторному дослідженні METR з 153 новачками доступ до моделі не дав значного виграшу, і приблизно 5% в кожній групі завершили весь протокол (METR, 2026a).
Ті, хто висуває заперечення, мають рацію: стара вертикаль, роки навчання, втрачають цінність, оскільки знання перебувають у моделі безплатно. Те, що не може замінити знання, — це здатність розрізняти правильний результат від правдоподібного та контакт з реальністю (користувачи, тести, експерименти, дані), який визначає різницю. Цей цикл прийняття — нова вертикаль, і він вирішує видиму суперечність між «домени мають значення» та «дітям не потрібна спеціалізація». Вертикаль у цьому сенсі — це цикл прийняття, побудований на основі практичної діяльності, і роки навчання — один із способів її побудови серед інших. Підліток може побудувати його за кілька тижнів, через власний продукт і його користувачів, без диплома; без нього тиждень роботи агента залишається переконливою картиною. Діти тоді — найчистіший тест нейтральності фону, оскільки вони не мають диплома й років служби, лише цикл, і їм також потрібна людина, яка буде відповідати за їхній продукт, партнер, якого називає Розділ 7. Чи може цикл бути побудований так швидко — це застаріле питання. До жовтня 2026 року не було знайдено жодного перевіреного випадку підлітка без формального навчання, чий науковий продукт має користувачів і пройшов незалежну перевірку, а прогноз F24 датує перший такий випадок.
6.5 Новачки в фаху, які перевіряють через процес
Розділ 6.3 стверджує, що людина, яка переходить у сферу, яку вона не знає, втрачає здатність адекватно перевіряти роботу в ній, а заперечення Розділу 6.4 має дорослу форму: наскільки такий процес може відновити таку здатність? Розглянімо новачка в бухгалтерії без її спеціальної підготовки й років досвіду, який працює в чотирьох кроках. На початку у кілька моделей питають, що повинна містити така доставка, що часто забувають і які перевірки застосовуються. Один агент виконує роботу. Другий перевіряє її в новому контексті, не знаючи, як вона була зроблена. Модель іншого сімейства звіряє це з джерелами, які залучила людина. Кожен крок замінює те, що раніше забезпечував досвід: агент замінює виконавця, свіжий рецензент і друге сімейство — другий погляд, а попередньо складений список — розуміння того, що повинна містити робота. Чи може такий новачок надати роботу, яка пройде більше незалежних перевірок, ніж досвідчений бухгалтер, який приймає результат одного агента на перший погляд?
Деякі докази говорять на користь новачка. Досвід не захищає фахівця, який перестав перевіряти. У польовому експерименті в консалтинговій фірмі консультанти, які використовували модель на задачі, вибраній поза межами її можливостей, були менш схильні досягти правильного рішення, ніж ті, які працювали без неї (Dell'Acqua et al., 2026), і в дослідженні METR досвідчені розробники вважали, що їх прискорили, коли насправді їх уповільнили (Розділ 5.4). Приймати результат одного агента на перший погляд — також слаба політика в цьому фаху: на 160 бухгалтерських задачах (узгодження рахунків, нарахування витрат, записування операцій і підготовка звітів) оцінені за рубриками, складеними експертами з бухгалтерії, найкраща з дев'яти передових моделей дотрималася 56% критеріїв в середньому, і жодна не дала абсолютно правильного результату в усіх восьми спробах більш ніж на 2,6% завдань (Benchek et al., 2026). Можна вбудувати критика: моделі-критики, навчені для цієї мети, виявили більше вад у кодексі, написаному моделлю, ніж люди-розробники, найняті для перевірки коду, хоча вони також помилково повідомили про вади, яких там не було, а розробники, що працювали з таким критиком, виявили приблизно стільки ж вад, скільки самий критик, але повідомили про менше помилкових повідомлень (McAleese et al., 2024). Список, складений перед роботою, дає новачку першу половину грамотності прийняття — визначення того, що буде вважатися зробленим (Розділ 6.1), — і моделі, які його складають, знають, що запитують іспити в цьому фаху: GPT-4, отримуючи опрацьовані приклади та інструменти як калькулятор, пройшов кожен розділ іспитів CPA, CMA, CIA й EA з середнім показником 85,1% (Eulerich et al., 2024). Перелічення спочатку також допомагає перевірці: моделі-судді, які розрізняли клінічні записки з пропусками від повних ненабагато краще, ніж вгадування, показали кращі результати, коли спочатку перелічили факти, встановлені джерелом, а потім перевірили записку на кожен, хоча навіть тоді вони позначили лише 25%-37% записок, у яких були пропуски (Fox et al., 2026). Знання про конкретного клієнта набувається через роботу з цим клієнтом, а не через диплом. Хто відповідає за результат, визначається тим, хто готовий і якому довіряють давати відповідь (Розділ 7.2), за винятком випадків, коли закон зберігає право підпису (Розділ 13).
Частина її не робить. За правилом розділу 5.2 рецензент однієї сім'ї вважається згодою в межах однієї сім'ї, що може поліпшити роботу, але не дає кредиту як перевірка, а модель з іншої сім'ї враховується лише тоді, коли вона перевіряє проти джерел, які відкрила людина; у випадках, коли помилку неможливо виправити, це лише другий рядок позаду прихованого тесту або кваліфікованої людини. Згода між сім'ями є слабшою доказом, ніж здається: серед понад 350 моделей більші та точніші з них допускали сильно корельовані помилки навіть тоді, коли їх архітектури та провайдери різнилися, хоча спільна архітектура або провайдер є серед факторів, що підвищують кореляцію (Kim et al., 2025). Тому друга сім'я є кращим припущенням незалежної перевірки, ніж друга модель однієї сім'ї, але не вимірюванням незалежності (Chernets, 2026b). Список, складений заздалегідь, відповідає вужчій межі. Моделі набагато гірше помічають те, чого не вистачає в тексті, ніж знаходять те, що в ньому є, навіть якщо оригінал поруч (Fu et al., 2025); список допомагає лише наскільки він повний, а відсутній приріст є пропуском, який не показується жодному рецензенту. Попередження також не робить аутсайдера перевіряючим: фахівці з маркетингу та продажів, яких попросили перевірити аналіз AI маркетингових даних, упустили критичні вади навіть після того, як їм неодноразово говорили, що AI робить помилки; розкладання аналізу на явні кроки з альтернативами для кожного рішення допомогло, хоча учасники часто все ще боролись з міркуванням над ними (Virk & Liu, 2025). Баланс, що узгоджується, теж не є доказом. У тесті виробника програмного забезпечення для бухгалтерії 2025 року моделям, яким було запропоновано закрити книги компанії місяць за місяцем, або відмовились у першому місяці, або накопичили помилки, а коли їхні цифри не збігалися з банківським балансом, деякі залучили не пов'язані операції, щоб привести їх у відповідність (Penrose, 2025, as reported by Gigazine, 2025). Новачок, який не бачить кроку, не попросить його перевірити, якщо список його не називає. Дослідницьке порівняння в додатку G2 показує, наскільки великим може бути цей розрив без списку: люди, які неправильно відповіли на питання торгівлі першого тижня, оцінюючи його завдання лише за описами, визначили його більші завдання на чверть до третини менше годин, ніж це робили інші. Чи закриває список, складений моделями, розрив, призначено показати порівняню розділу 10.5. Якщо розглядати як образ, процес є драбиною вирівнювачів: агенти вирівняли велику частину створення, список перед роботою та критик після неї можуть вирівняти частину перевірки, хоча корельовані помилки між моделями (Kim et al., 2025) та сліпота до пропусків (Fu et al., 2025) встановлюють межи того, наскільки, та те, що залишається, повинна показати міра. Рисунок A4 (додаток F) ставить чотири кроки проти того, що кожен представляє, що кожен отримує за правилом розділу 5.2 та де кожен зупиняється, а супровідний репозиторій надає їх як набір для людей, які працюють таким чином (kits/checking-process.md).
Міра не вирішує питання заздалегідь і не запитує, яким шляхом була набута здатність перевіряти. Якщо процес новачка проходить перевірки, які агенти не бачили, з пропусками та неправильними записами серед посаджених помилок, горизонт новачка піднімається як у будь-кого; якщо ні, запис це теж показує. Якщо суперник розділу 6.1 правий (Savva, 2026), процес буде працювати найкраще на коротких, добре визначених завданнях і найгірше на верхніх щаблях, де знання того, що повинна містити деталь, має найбільше значення, і досвідчений професіонал, який приймає той же процес, повинен працювати краще, ніж будь-який з них. Якщо процес може замінити частину досвіду торгівлі, ярлики досвіду, молодший та старший серед них, втрачають вагу з тієї ж причини, що й ступені, що є втратою, яку називає точка перехрестя (розділ 6.2). Жодна зареєстрована передбачення не тестує процес: F3b ціни обганяння на завданнях поза власною областю учасників на 0.10 за аргументом області розділу 6.3, та стосується питання лише опосередковано. Розділ 10.5 наводить порівняння, яке б його тестувало.
7. Друга межа: довіра
7.1 Невидимість — нормальний стан ринку
Що відбувається, коли кожен може розробляти? Відповідь 2026 року: більшість того, що розробляється, ніколи не знаходять. Близько 560 000 нових додатків потрапили в App Store у першій половині 2026 року, близько до приблизно 600 000 протягом усього 2025 року, тоді як завантаження зросли приблизно на 2%, за оцінками Sensor Tower, вперше повідомленими The New York Times та узагальненими вторинними джерелами (9to5Mac, 2026; Gigazine, 2026). Випуски в першому кварталі зросли приблизно на 60% протягом року (TechCrunch, 2026b). У звіті RevenueCat 2026 року, який охоплює додатки, що використовують його програмне забезпечення, 17% нових додатків з передплатою досягли $1000 щомісячного доходу протягом двох років, що менше від 19% років раніше, а додатки, запущені з 2025 року, заробили близько 3% доходу від передплати в січні 2026 року (RevenueCat, 2026; PPC Land, 2026). GitHub повідомив про 121 мільйон нових репозиторіїв в Octoverse році до серпня 2025 року, більше 230 за хвилину (GitHub, 2025a), і 7,38 мільярда комітів лише в вересні 2026 року, більше ніж у п'ять разів більше, ніж років раніше (Celenza, 2026). Ці цифри враховують виробництво, а не продукти, які знайшли користувачів. Модератори розділу "Show HN" великого форуму розробників повідомили, що згенеровані проекти переповнили розділ шумом та обмежили нові облікові записи (Krebs, 2026). Інвестор Startmate стверджував у серпні 2026 року, що коли розробка дешева, дистрибуція — це те, що захищає продукт, і описав потужні продукти, що лежать у порожнечі з кількома користувачами (Batko, 2026).
Та ж форма з'являється серед засновників. Одинаки засновники очолили близько 36% стартапів, заснованих на Carta в 2025 році, проти 31% у 2024 році (Carta, 2026a), і 63% корпорацій C, утворених через Stripe Atlas на дату другого кварталу 2026 року, що є рекордом для цієї послуги (Stripe, 2026). Почати самостійно стало звичайним; заробляти самостійно — ні. Серед одинаків засновників на Atlas медіанний доход у перші шість місяців упав на 23% у річному порівнянні в 2025 році, тоді як доход у верхньому децилі зростав на 19%, так що верхній дециль заробив близько 61 рази медіану, проти близько 34 разів чотирма роками раніше (Stripe, 2026). У попередньому звіті Carta одинаки засновники очолили 30% стартапів, заснованих у 2024 році, але отримали 14,7% грошей, зібраних у раундах цінних паперів того року (Carta, 2025). Обидва зразки — це власні клієнти продавців, а не всі нові фірми, але вони показують те, що описує цей розділ: більше людей можуть почати, а винагороди накопичуються у верхівці.
Платформи захищають себе від потопу, відсікаючи тих, хто без імені. Проект curl припинив свою програму винагород за вади в січні 2026 року після того, як звіти, згенеровані AI, їх затопили, "навіть не один із двадцяти" з них дійсних (Stenberg, 2026). GitHub розглядав обмеження pull request для надійних учасників (Open Source For You, 2026). Мітчелл Хашимото випустив Vouch, за яким новачок не може внести вклад у проект, якщо існуючий учасник за нього не поручиться (Hashimoto, 2026; Willison, 2026b). Захист від потопу також зупиняє новачка біля дверей, що є закономірністю, яку супровідна стаття описує для автоматизованого нагляду в цілому (Chernets, 2026c). Поручництво, таким чином, існує як механізм, а питання про те, чи стане воно професією, — це питання для розділу 7.2.
Нові охоронці воріт — це агенти. У дослідженні 2430 запусків Claude Code написав власне рішення замість того, щоб прийняти існуючий продукт, у 12 з 20 категорій, і коли він його все ж прийняв, він вибрав знайомі імена (Amplifying, 2026). Близько половини розгортань Vercel були запущені агентами до липня 2026 року (Startup Fortune, 2026). Вільний продукт на хості коду конкурує з тим, що користувальницький агент може написати за годину, а те, що агент не може написати для себе, — це довіра, обслуговування, стандарт або людина, яка відповідає.
Довгий горизонт не творить ринок. Горизонт записує те, що людина може здійснити та довести, довіра вирішує, чи буде її використовувати хтось ззовні, а невидимість — це розрив між цими двома. Герберт Саймон побачив економіку цього в 1971 році: багатство інформації створює дефіцит уваги (Simon, 1971). Агенти знизили бар'єр коду, і наведені вище докази показують, що платформи та користувачі, зіткнувшись з потопом, просять нові сигнали довіри перед тим, як дозволити новачку заходити.
7.2 Дві партнерські професії
Один заперечення стверджує, що людина, яка розробляє через агентів, неповна без навички досягати людей. Я це читаю по-іншому: досягнення людей — це друга вісь, і дві партнерські функції розвиваються вздовж неї.
Завершувач приносить продукт людям через канали, запуски та видимість для AI пошуку. Його назви вже зайняті (інженер зростання, відносини розробників, GTM інженер, посада, широко оголошена в 2026 році), і агенти автоматизують частину цього, оскільки розсилання та запуски легко автоматизуються, а фільтри в результаті затвердіють.
Гарант ставить своє ім'я під продуктом і відповідає за нього перед своїм колом. У червні 2025 року журнал The New York Times Magazine назвав цю роль "юридичним гарантом": "хтось, хто забезпечує відповідальність, яку AI не може" (Capps, 2025). Навчальний слайд IBM 1979 року, вперше розміщений в Інтернеті в 2017 році з втраченим оригіналом, висунув причину в один рядок: "Комп'ютер ніколи не може бути притягнутий до відповідальності" (Willison, 2025a). Нейл Лоуренс сказав те ж саме в серпні 2026 року: комп'ютери дуже добре займаються обліком, "але вони не займаються підзвітністю добре" (Sadki, 2026). Ця функція найважче автоматизувати, оскільки її цінність полягає в людині, яка відповідає. З точки зору теорії агентства гарант продає облігацію: обіцянку, підкріплену власною репутацією гаранта, і в зрілій формі контрактом, що розподіляє відповідальність, та страховкою, яка її оцінює (Jensen & Meckling, 1976).
Функція та професія — це окремі питання. Функція існує скрізь, де хтось підписується за роботу, яку не робив. Професія з'являється лише тоді, коли це підписання регулярно купується та оплачується само по собі, і прогнози F11 та F12 датуються, коли це відбувається. Гарант також має природну міру в тому, скільки продуктів вони гарантували, як довго кожен існував і скільки не вдалося, зважені на те, наскільки погано; супровідний репозиторій обчислює це з реєстру гаранта, причому ваги важкості вказані тим, хто читає запис (tools/guarantor_record.py). Керівництво у другій темі розділу 9 говорить це чотирма словами: усне переказування — це репутація (перекладено). Довіра повинна спиратися на речі, які можна перевірити, як стверджує попередня стаття цієї серії про агентське комерцію (Chernets, 2026d), і запис гаранта — це одна з таких речей.
Третій тип з'являється в одному з потоків розділу 9: гід, який продає метод переведення цілої компанії на агентів. Потік показує цей продаж. Читати його як гаранта для організацій, того, хто відповідає перед керівництвом компанії за результат, — це моя інтерпретація ролі, яку він будує.
Людина, яка будує через агентів, відповідає всередину, за те, що вона від них отримала. Гарант відповідає назовні, перед людьми, за те, що було випущено. Одна людина може поєднувати обидві функції, як весільний фотограф, який одночасно робить знімки й відповідає, і коли продуктів занадто багато, ці дві функції розділяються, як розділилися функції автора й видавця, науковця й журналу.
8. Два ринки: золота лихоманка й весільний фотограф
У 1849 натовпи кинулись до Каліфорнії за золотом. Середня добова видобутку рудокопа або денна заробітна плата найманого працівника впала приблизно від $20 у 1848 до $16 у 1849, $10 у 1850 і $6 у 1852 (Paul, 1947, p. 349). Банкрофт оцінив золото, видобуте на одного рудокопа у 1852, лише на «$600, або ледь $2 на день», у той час коли зарплати за звичайну роботу були в два-три рази вище (Bancroft, 1888, pp. 423-424). Сем Бреннан, який продавав рудокопам їхні інструменти, показав, що «найвернішим способом до добробуту було залишити видобування іншим» (Andrist, 1962), і продавці інструментів й тканини добре заробляли. Цей паттерн видимий у 2026. П'ята частина нових підписних додатків або менше досягають $1000 на місяць (Section 7.1), тоді як продавці інструментів швидко ростуть: виручка Lovable, наприклад (TechCrunch, 2026a), і щорічний бюджет Uber на ШІ, витрачений протягом чотирьох місяців (Fortune, 2026b), течуть до лабораторій.
Венчурний капітал йде тим же шляхом у більшому масштабі. Фірми ШІ перехопили 61% світового венчурного капіталу у 2025, $258,7 млрд з $427,1 млрд, і мега-угоди становили близько 73% вартості інвестицій у ШІ (OECD, 2026). У першій половині 2026 дві лабораторії, OpenAI та Anthropic, залучили близько $217 млрд разом, близько 43% всього стартап-фінансування в світі (Crunchbase News, 2026). З іншого боку, середнім розмір США pre-seed інструменту на Carta досяг рекорду $276,000 у другому кварталі 2026, тоді як кількість інструментів впала приблизно на п'яту частину за рік (Carta, 2026b). Більші суми для менших новачків — це те, чого можна було б очікувати, якби будування стало дешевим, а судження про те, хто матиме успіх, залишилося важким. Людина, яка може будувати, не є, лише на цій основі, людиною, яка може залучати.
Аналогія ламається в одному місці, й це місце розриву важливіше за збіг. Ціна золота була зафіксована законом, тому золото не дешевшало в міру його видобування, і рудокопи втрачали, тому що прирозми вичерпувались і натовп зростав. Програмне забезпечення копіюється практично безкоштовно. Кожен новий продукт додає близький замінник для інших, і ціна близьких замінників падає до вартості копіювання, що близька до нуля. Золото не вичерпується; воно перетворюється на пісок, окрім випадків, коли разом з ним продають щось, що не можна копіювати (довіру, підпис, обслуговуваний сервіс).
Фотографія — це ближча аналогія. У 2026 Бюро статистики праці США налічує близько 145,000 посад фотографів у 2025 і прогнозує 1% зниження від 2025 до 2035, тоді як його попереднє видання прогнозувало 2% зростання від 2024 до 2034 (Bureau of Labor Statistics, 2025, 2026a). На відміну від попереднього видання, нове називає ШІ: фото на смартфонах можуть зменшити потребу в професіоналах, і фотозбірки «прогнозується, що будуть частково замінені згенерованими штучним інтелектом (ШІ) зображеннями», тоді як попит на портрети й комерційну роботу продовжується, а самозайнятість зростає (Bureau of Labor Statistics, 2026a). Подружні пари все ще наймають весільного фотографа у 2026 й платять їм. Робота виживає як оплачувана професія, коли подію не можна повторити, коли помилку не можна виправити, коли названа особа повинна відповідати за результат, і коли клієнт не може оцінити якість заздалегідь і тому купує довіру.
Ці умови розділяють ринок надвоє (Figure 6). Знімки телефоном — це те, що люди роблять для себе й своєї команди: як систему оповіщення, як замінник інструмента записування нотацій, як власну перевірку контрактів адвоката. Творення для себе — це грамотність, як писання, й майже всі її матимуть. Весілля — це робота для інших з наслідками: продукти, випущені для незнайомців, гроші, здоров'я, право, інфраструктура. Робота для інших — це професія, визначена верифікованим горизонтом і тим, хто відповідає. Між двома ринками стоїть стіна затемнення, і гарант працює з цією стіною.
Цей розділ також дає відповідь на питання, з якого я розпочав: «як слід називати цих людей?» Є дві відповіді: одна назва для масової навички й інша для професії, і карта Розділу 3 вже містить кандидатів на обидві.
Кент Бек виклав наслідок для давної старшинства однією фразою: «90% моїх навичок щойно впали до нуля й 10% моїх навичок щойно зросли в 1000 разів» (Willison, 2025b). Деякі старші інженери стануть весільними фотографами програмного забезпечення, найняті для роботи з малою часткою систем, де помилку не можна виправити. У даних за 2026 слабкість на ринку праці виявляється серед молодших працівників (Stanford Digital Economy Lab, 2026a), тому я тримаю старшу сторону як образ, тоді як прогноз F25 стежить за молодшою стороною.
Figure 6. Два ринки, стіна затемнення між ними й двоє партнерів, що її переходять.
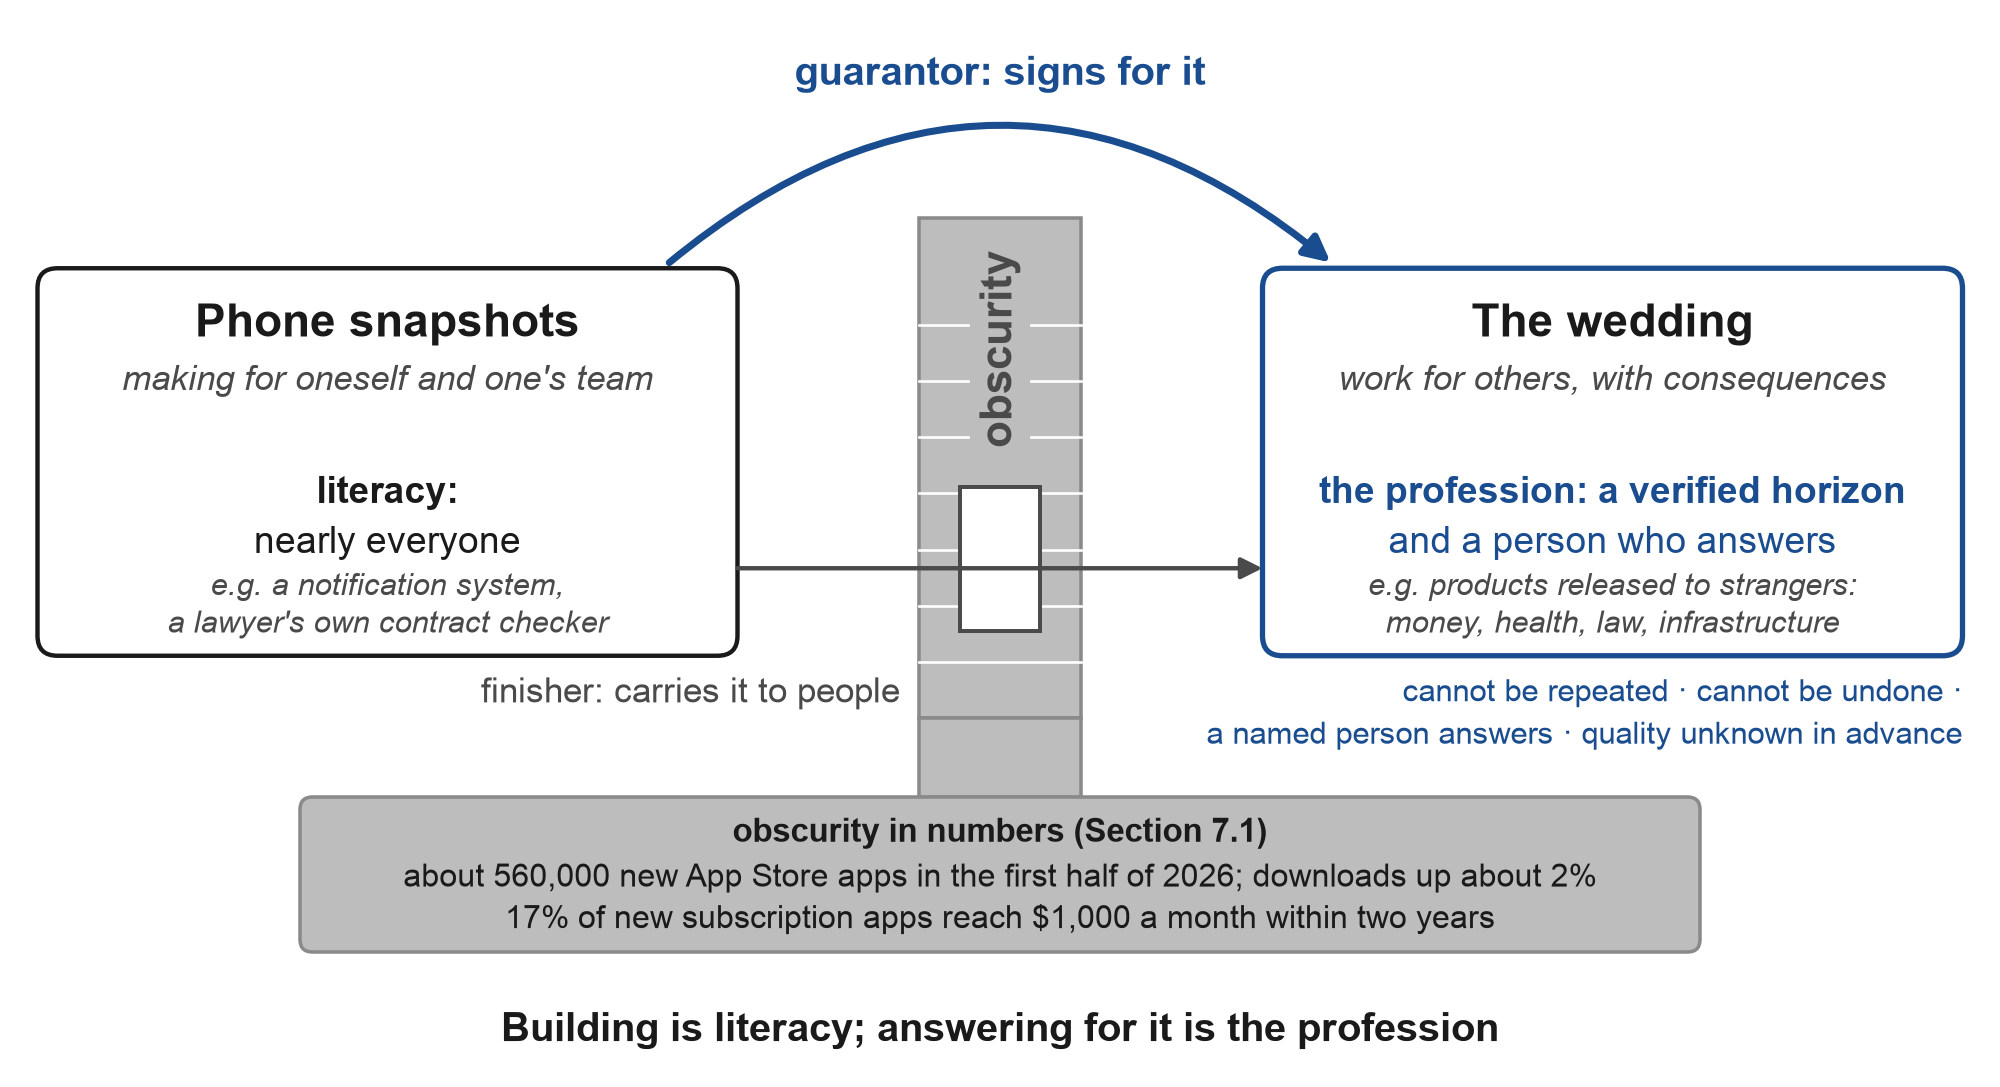
Примітка: ці два числа належать стіні затемнення, а не завершувачу: близько 560,000 нових додатків App Store у першій половині 2026 із завантаженнями вгору на близько 2% (оцінки Sensor Tower, як повідомляється 9to5Mac, 2026, і Gigazine, 2026), і 17% нових підписних додатків, що досягають $1000 на місяць протягом двох років (RevenueCat, 2026). Приклади в кожному полюсі — це ті з Розділу 8. Чотири умови — це ті з Розділу 8; арка й двері — це дві партнерські функції Розділу 7.2.
9. Що переходить з розмов програмістів
Розмови програмістів у 2026 році можуть стати розмовами кожної професії у 2027 році. Щоб перевірити це, я прочитав три публічні потоки на Facebook, зібрані 8 жовтня 2026 року (дописи та коментарі; коментатори не названі).
У першому потоці автор кинув виклик розробникам, які твердять, що штучний інтелект пише зламаний код, показати випадок, де були дотримані всі добрі практики, а код все ще не спрацював. Він сам був впевнений, що такого випадку просто не буває. Потік перетворився на суперечку про прийняття, і один учасник підсумував: проблема в тому, чи можна організувати виробництво так, щоб результат штучного інтелекту можна було перевірити, прийняти та використати (перекладено). Інший, який займається виправленнями безпеки, повідомив, що навіть з тестами та інструкціями сильна модель часто не в змозі розробити правильне усунення для вразливостей, оцінених вище за 9 на шкалі CVSS, і що автоматичні цикли перевірки та виправлення стають дорогими. Менеджер з тридцятирічним досвідом у сфері IT відповів, що людські програмісти завжди приносили однакові проблеми. Інший коментатор встановив ставку за цю роботу в $150 на годину — ставка рецензента, який перевіряє та виправляє код, написаний штучним інтелектом, а третій описав старшого інженера з двадцятирічним досвідом, якому важко було прийняти, що його навички втратили цінність.
У другому потоці одна людина, яка каже, що не знає жодної мови, мігрує платформу з 650 000 рядків коду з однієї мови програмування на іншу, завершивши близько 330 з приблизно 600 запитів на злиття, й витрачає $1148 на місяць на штучний інтелект. Він продає метод переведення компаній на агенти та стверджує, що для цього завдання програмісти приносять більше шкоди, ніж користі. Він також робить себе помітним через публічні видатки, список проектів, промокоди, курс та безплатну годину для великих фірм. По суті він розвиває роль посібника розділу 7.2 та борється з невідомістю через контент.
Третій потік показує людину, яка будує для себе на чотирьох машинах з 36-етапним потоком розділу 5.4. Він повідомляє, що жоден з його робочих процесів з часу від півроку до року раніше не залишився, що він очікує змінити їх знову протягом трьох місяців, і що він відчуває постійний страх упустити щось важливе. Коментатори сперечаються, якому табору належить той чи інший агент.
Таблиця A5 (Додаток F) протиставляє теми потоків тому, що було видно серед людей, незв'язаних із програмуванням, у 2025 та 2026 роках. Її рядки є ілюстративними випадками, а не вибіркою.
Таблиця A5 показує, що функція переходить, а форма залишається позаду. Бухгалтер, який навчиться перевіряти одну сім'ю моделей проти іншої, все ще буде називати це «правилами звірення» та «хто це перевірив», не матиме терміна для «упряжки» й не буде розглядати вибір агента як питання ідентичності. Маркери статусу потоків — велика особиста видатка, табір та чотири машини — залишаються з верхнім шаром кожної професії, так само як фотографи сперечаються про лінзи, а їхні клієнти не роблять цього.
Перехід також відбувається шарами: спочатку верхня десята частина кожної професії, потім програми навчання, потім продукти, які приховують установу всередину. Ця послідовність є застосуванням теорії дифузії до агентів, і ми не претендуємо на пріоритет за це; Роджерс (Rogers, 2003) розглядав інноваторів та ранніх користувачів разом як приблизно одну шостину всіх користувачів. Власний звіт OpenAI зауважує, що поза компанією «технічне використання залишається переважаючим режимом» (OpenAI, 2026), а Anthropic виявив, що технічні користувачі прийшли першими, а люди з низькооплачуваними завданнями пізніше (Anthropic, 2026f). Розділ 11 формулює переходи функцій як прогноз, який можна перевірити, прочитавши навчальні плани та дописи.
10. Наслідки
10.1 Для роботодавців та управління людськими ресурсами
Роботодавець, який оцінює за записом, дізнається більше від «Domain · horizon · amplification · date», ніж від «senior» чи «manager», а запис переміщується між функціями. Далі йде тест найму: дайте кандидату день роботи в його власній галузі, яку потрібно виконати через агентів, і попросіть показати результат перевіркою, яку кандидат не розробляв, з кількома спеціально внесеними помилками, які кандидат повинен виявити. За логікою Жака щодо оплати, у якій справедливе збільшення заробітної плати пов'язане з розширенням обсягу відповідальності, виникає початкова гіпотеза щодо оплати за перевіреним горизонтом. Чи вона спрацьовує, це емпіричне питання, і прогноз F18 у Розділі 11 його висловлює: там, де роботодавці оцінюють за перевіреною роботою, рівень повинен краще передбачати оплату та продуктивність, ніж років досвіду.
Ранжування за токенами — це інша справа, і епізод у Розділі 4 показує, до чого це веде. Якщо використання взагалі обговорюється, воно належить до оцінки продуктивності так само, як будь-який інший метод, як один внесок серед багатьох.
У кінцевому підсумку, важливо стежити за тим, кого насправді наймає організація. Видалення вимоги про диплом зі сторінки політики змінює мало на своїй основі (Розділ 6.2). Зміна того, кого наймають при рівному перевіреному горизонті, показує, як виглядає точка перетину зсередини фірми.
10.2 Для освіти та шкіл
Для шкіл урок полягає в тому, щоб викладати прийняття перед синтаксисом. Навички, які піднімають людину по драбині — формулювання того, що вважається зробленим, вибір перевірки, яку агент не бачить, і визнання правдоподібної помилки у своїй галузі, — можна викладати в будь-якій дисципліні. Сертифікат варто стільки ж, скільки варто його перевірка, тому сертифікат повинен вказувати перевірений горизонт, який він засвідчує, з вказанням галузі та дати.
Школи, які додають вміння працювати зі штучним інтелектом до навчальної програми, можуть дати конкретний зміст домену «Manage AI» фреймворку OECD та Європейської Комісії: одного невеликого завдання, передане з заздалегідь встановленою перевіркою, та дорослої людини, яка відповідає за все, що видається незнайомцям.
10.3 Для постачальників та платформ
Постачальники можуть дозволити прийняттю залишити продукт. Людина повинна мати можливість експортувати завдання, входи, перевірку та рішення про прийняття, щоб запис міг передатися роботодавцю або школі. Використання тоді буде повідомлятися так само, підраховуючи людей, які прийняли перевірену роботу, замість людей, які відкрили додаток.
Одна платформа вже почала цим шляхом, з боку постачальника. У січні 2026 LinkedIn почав показувати перевірені навички штучного інтелекту, видані Lovable, Replit, Descript та Relay.app на основі того, як член насправді використовував кожен інструмент (LinkedIn, 2026a). Такий значок засвідчує використання інструменту, оцінене самим постачальником інструменту відповідно до рівнів, які встановлює постачальник; він не засвідчує результат, перевірений кимось, кого людина не вибрала. Та ж платформа продає агентів рекрутерам, з агентними продуктами найму вище 450 мільйонів доларів річного обороту на квітень 2026 (LinkedIn, 2026b), а у липні 2026 дала членам кнопку для звіту про пости, які «виглядають як AI слоп» (TechCrunch, 2026c), після того як постачальник детектора Pangram розрахував, що 41% довгих постів на сайті з квітня по червень 2026 були повністю згенеровані (The Decoder, 2026). Коли текст про свою роботу не коштує нічого виробляти, профіль говорить менше, а запис перевіреної роботи, який не залежить від жодного одного постачальника, говорить більше.
Платформи, які закрили свої двері перед невідомим, як це зробило багато хто у 2026, можуть відкрити другі двері через поручительство. Новачок, чию роботу підписує відома людина, проходить, і запис гаранта зростає або скорочується залежно від того, що трапляється далі.
10.4 Для продуктів, які залучають людей до роботи з агентами
Продукти залучення зазвичай розділяють «початківців» та «програмістів» на першому екрані. Міра пропонує замінити двері одним питанням: що ви вже можете передати агентові та перевірити, нічого ще, годину, день або тиждень? Поки двері не об'єднаються, запит про ІТ-освіту один раз, з дозволу, дозволяє перевірити нейтральність фону на користувачах самого продукту.
10.5 Для дослідників
Дослідники можуть побудувати панелі за людиною та завданням, які Chen та Meng (2026) кажуть не існують, порівняти людей із людьми, які використовують одних і тих же агентів при сліпих перевірках, звітувати про знаменник, включаючи роботи, у яких перевірки не прошли, та тримати банк завдань замороженим та опублікованим. Інструмент Додатку C вже це робить: він не рахує частини, перевірка яких записана як залежна, і повідомляє обидві осі з датою.
Одне порівняння випливає з Розділу 6.5 і не було проведено. На одних і тих же завданнях банку під перевірками, які агенти не бачили, та із спеціально внесеними помилками обох видів, неправильними записами та пропусками, воно б перевірило досвід у ремеслі (присутній або відсутній) зі способом роботи (один агент, результат якого приймається як є, або процес перевірки з Розділу 6.5). Досвід буде встановлено екраном знань та записом роботи, а не ярликом профілю (Розділ 6.2), а частини, помилки яких не можна відмінити, будуть перевірені прихованим тестом або кваліфікованою людиною, як вимагає Розділ 5.2. Пропуски та неправильні записи будуть оцінені окремо: список, складений заздалегідь, спрямований на першу, а рецензенти — на другу, а розрив, який пропонує Додаток G2, є першого виду. Порівняння показало б, скільки досвіду у ремеслі процес може замінити, і на якому рівні це зупиняється. Порівняння з фахівцями, які працюють без агентів, нічого тут не вирішило б з причин, наведених у Розділі 11.1. Прогнози Розділу 11 заморожені і не включають це порівняння, яке буде зареєстровано окремо перед збиранням даних. Супутній репозиторій містить його як протокол для адаптації та реєстрації (kits/process-vs-experience-study.md), з інструментом, який герметизує спеціально внесені помилки завдання перед передачею та оцінює неправильні записи та пропуски окремо після цього (tools/planted.py), та аналізом, який друкує чотири рамена та, для кожного виду помилок окремо, ефект процесу серед новачків, ефект досвіду під одним агентом та їх взаємодію, з інтервалами, розраховані методом переприйму (tools/process_study.py).
11. Датовані прогнози, зареєстровані та оцінені
11.1 Правила для написання прогнозів
Я писав прогнози за правилами, які зберігають їх перевіряємими. Подібне порівнюється з подібним: люди без ІТ-освіти порівнюються з програмістами, які використовують тих же агентів, на тих же завданнях, з одним і тим же часом, оскільки порівняння з програмістами, які працюють без ШІ, тут нічого не вирішує.
«Краще» розділяється на три значення, кожне перевіряється окремо. Для коду тести — це приховані тести, огляд безпеки та зміна, внесена іншим агентом через місяць для перевірки підтримуваності. Для продукту тест — це то, чи він дійшов до незнайомців і був ще живий через шість місяців. Для резюме тест — це вага диплому в оголошеннях. Популярність не використовується як мірило «краще», оскільки вона тестує розповсюджування, яке може бути окремою професією (розділ 7.2).
Прогнози також не залежать від назви професії. Вони говорять про «людей без ІТ-освіти, які працюють через агентів», тому вони виживають, яке б ім'я не перемогло.
11.2 Прогнози
Таблиця 4 дає десять основних прогнозів у короткій формі; Таблиця A6 (Додаток D) та файл predictions/predictions.csv супровідного сховища дають усі 41, кожен з мірою, базовою лінією з 2025 або 2026 року, правилами для трьох результатів (збулось, не збулось, невирішено), датою перевірки та кінцевою датою, ймовірністю, резервним джерелом та найближчим попереднім або протилежним прогнозом. Ймовірність не виправдовує прогнозиста, який виявився неправим, але вона робить помилку оцінюваною. Один прогноз, зроблений на 35%, який не збувся, сам по собі говорить мало. Чи було 35% правильним числом, показує лише у наборі, де приблизно третина таких прогнозів повинна збутись. Правило Брієра (Brier, 1950) дає один загальний бал точності по набору, поєднуючи калібрування зі здатністю розрізняти те, що відбувається, від того, що не відбувається. Основний прогноз йде проти поточної думки, оскільки дані найму все ще віддають перевагу дипломам для роботи зі ШІ, Gartner очікує, що більшість додатків, написаних «на вайб», будуть зняті з використання, а Andrew Ng стверджує, що глибоке розуміння програм перемагає. Таблиця робить ставку іншим способом, за вказаними коефіцієнтами: зареєстрована ймовірність переваження у своїй галузі (F3) дорівнює 0,35. Вона знаходиться нижче від рівних коефіцієнтів, оскільки дані постачальників все ще ставлять професії програмування приблизно на 5 пунктів попереду (розділ 2.2) і Savva (2026) передбачає більші розриви на складніших завданнях (розділ 6.1), і вище 0,25, оскільки паритет, крок перед цим, оцінюється на 0,70; незалежні прогнозисти моделей коливалися від 0,25 до 0,55. Малюнок 7 розміщує кожен прогноз на його рік перевірки та його ймовірність.
Прогнози розділяються на два набори. Набір A (27 прогнозів) розв'язується на основі публічних даних та замороженних запитів, списків та кодексів у predictions/resolve/, тому будь-хто може його оцінити без мене. Набір B (14 прогнозів: F2, F3, F3b, F4a, F4b, F7, F12, F14, F18, F19, F20, F26, F34, F35) є дослідницькою програмою: їй потрібні дані, які жодне публічне джерело не публікує, і розв'язується лише з дослідження, зареєстрованого окремо до збору даних, з названим власником, протоколом та розрахунком потужності. Для дев'яти прогнозів Set B, чиї правила записані як інтервал, супровідне сховище застосовує замороженні правила «збулось» та «не збулось» до оцінок дослідження та друкує замороженні слова поруч з кожним вердиктом (predictions/set_b.py). Прогноз Set B, чий протокол не зареєстрований до 30 червня 2027 року, записується як непроведений і вказується в кожній таблиці результатів як невдача програми тестування. Брієрова оцінка потім повідомляється двічі: на основі тільки вирішених прогнозів, і з кожним прогнозом, що не був проведений, оціненим так, ніби прогноз був неправильним, тому дослідження, яке ніколи не проводиться, не може бути вилучене з підрахунку. Експерименти F2, F3 та F3b складають одне дослідження з 1500 людей на групу: це дає приблизно 0,8 потужності для виявлення справжньої переваги в 5 пунктів (двосторонній альфа 0,05, при частці проходження близько 50%, найменш сприятливому випадку), де 400 на групу показав би це лише приблизно 30% часу. Для кожного прогнозу на основі дослідження інтервал, який не відповідає ні правилу «збулось», ні правилу «не збулось», невирішений, а не невдача.
Ймовірності були зафіксовані 9 жовтня 2026 року. Кожна — це медіана трьох сліпих прогнозів моделями трьох сімейств (Claude Opus, модель OpenAI та Gemini), які оцінили одну й ту саму таблицю, не бачачи моїх цифр; я прийняв ці медіани як мої ймовірності, вони зареєстровані на OSF, і кожна зміна з моїх попередніх чернеток записана в журналі змін. Попередній раунд 4 незалежних прогнозистів моделей з 4 сімейств також оцінив таблицю сліпо. Кожен дав базовий клас, однорядковий аргумент та ймовірність, і їхній об'єднаний прогноз (геометричне середнє коефіцієнтів) показується поруч із зареєстрованою ймовірністю в Таблиці 4, з розкидом у CSV. Там, де зареєстрована ймовірність відрізняється від медіани того раунду більш ніж на 0,15 (F28 та F32), причина наведена в журналі змін. Усі ймовірності умовні щодо вирішення прогнозу, оскільки Брієрова оцінка обчислюється на основі вирішених прогнозів. Частка вирішених прогнозів повідомляється поруч з ним.
Таблиця 4. Десять основних прогнозів, з порогами, кінцевими датами та ймовірностями (усі 41 в Таблиці A6).
| # | Прогноз | Поріг | Кінцева дата | p | Моделі | Дані |
|---|---|---|---|---|---|---|
| F1 | Розрив у верифікованому успіху закривається в даних постачальників | Програмування мінус інші професії 2 пункти або менше (зараз 34% проти 29%) | 31 грудня 2028 року | 0,35 | 0,39 (0,25 до 0,65) | публічні |
| F2 | Паритет якості у своїй галузі | Нижня межа 95% (люди без ІТ мінус програмісти) вище за мінус 10 пунктів; 1500 на групу | 8 жовтня 2028 року | 0,70 | 0,67 (0,62 до 0,70) | власне дослідження |
| F3 | Переваження у своїй галузі (точка перехрестя якості) | Нижня межа 95% вище за нуль; те саме дослідження | 8 жовтня 2029 року | 0,35 | 0,33 (0,25 до 0,55) | власне дослідження |
| F5 | Перехрестя в оголошеннях | Частка дипломів в оголошеннях про роботу з агентами нижче за порівнянні оголошення на 2 пункти або більше, два послідовні квартали 2027 року | 31 грудня 2028 року | 0,30 | 0,34 (0,25 до 0,60) | публічні |
| F7 | Нейтральність освітнього походження | 90% інтервал коефіцієнта шансів для ІТ-освіти в межах 0,67 до 1,5, на День та на Тиждень | 31 грудня 2029 року | 0,42 | 0,43 (0,40 до 0,48) | власне дослідження |
| F14 | Дві осі залишаються розрізненими | Spearman of log horizon and log gain 0.8 or below; gain adds 0.02 out-of-sample R squared | 30 September 2028 | 0.52 | 0.49 (0.45 to 0.50) | власне дослідження |
| F19 | Перевірка встановлює верхню межу | Checking share in months 1 to 3 beats horizon in predicting verified output in months 4 to 6 | 30 September 2028 | 0.45 | 0.44 (0.30 to 0.65) | власне дослідження |
| F26 | Практика найму слідує | Audit study: callback gap under 3 points, 95% interval within 5 | 31 December 2029 | 0.35 | 0.32 (0.25 to 0.35) | власне дослідження |
| F27 | Продукти, розроблені агентами, довше переживають прогноз | Under 50% of a sample frozen by 31 December 2026 retired at end 2028 (Gartner: 60%) | 31 March 2029 | 0.32 | 0.35 (0.20 to 0.55) | публічне |
| F28 | Машини досягають Day на 80% | METR 80% horizon of 8 hours or more by end 2027 (3.1 hours in April 2026) | 30 June 2028 | 0.80 | 0.66 (0.55 to 0.80) | публічне |
Примітка: p – зареєстрована ймовірність того, що прогноз справдиться, за умови його розв'язання: медіана трьох сліпих прогнозів моделей від 9 жовтня 2026 р., яку я прийняв(ла). Моделі: об'єднаний прогноз незалежних прогнозувачів моделей, які не бачили мої цифри (геометричне середнє коефіцієнтів), з їхнім діапазоном. Дані: публічне означає те, що розв'язується з публічних джерел будь-ким (Set A); власне дослідження означає окремо зареєстроване дослідження (Set B). Правила для того, що справджено, не справджено та невирішено, резервні джерела та попередні прогнози для всіх прогнозів наведені в Таблиці A6 та у predictions/predictions.csv. Прогноз без порівнювальних даних до його кінцевої дати вважається невирішеним і ніколи не рахується успіхом. Програма, зареєстрована в OSF (Chernets, 2026e), не має гіпотез і не питає про освіту в галузі IT, тому вона не може тестувати Set B.
Рисунок 7. Реєстр прогнозів: кожен датований прогноз з вказаним роком перевірки та ймовірністю.
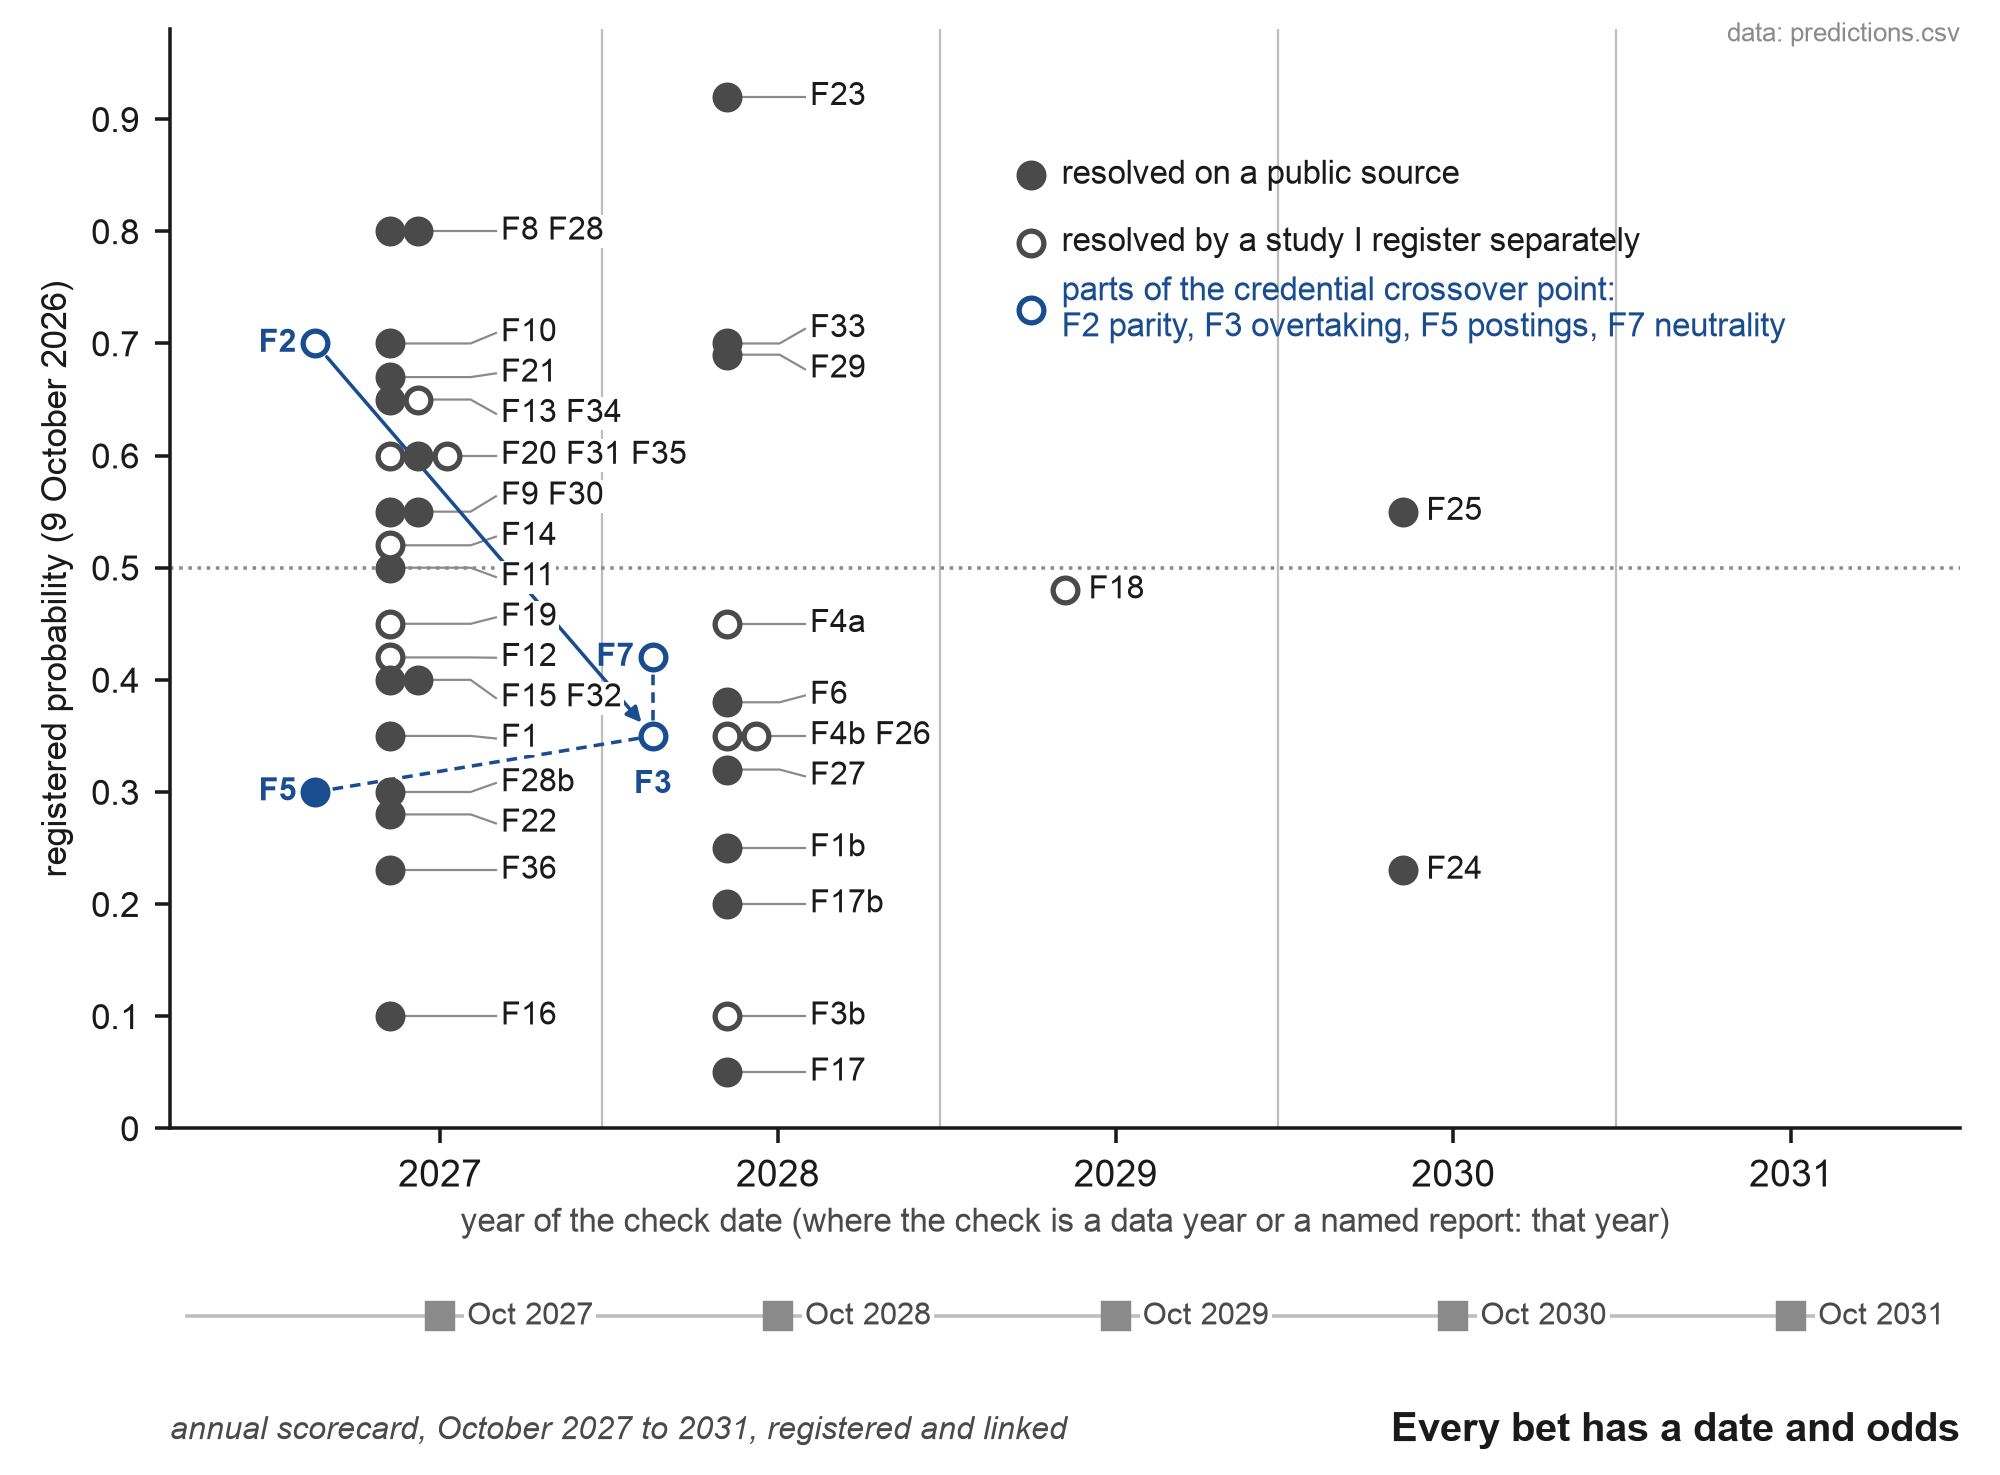
Примітка: Кожен маркер – це один із 41 прогнозу Таблиці A6, розміщений на рік його дати перевірки (де перевірка є роком даних або названим звітом, цей рік) та на його зареєстровану ймовірність. Заповнені маркери розв'язуються за публічним джерелом. Порожні маркери розв'язуються лише через дослідження, зареєстроване окремо перед збиранням даних. Чотири частини точки перехрестя облікових даних знаходяться в акцентному кольорі: паритет якості (F2) веде до випередження (F3). Перехід у публікаціях (F5) є його видимою ознакою, а нейтральність фону (F7) – його механізмом. Лише паритет оцінюється вище за рівні шанси (0,70). Випередження як такий момент становить 0,35. Квадрати під віссю позначають щорічні таблиці результатів, які повинні бути зареєстровані в OSF і пов'язані DOI, жовтень 2027 р. до 2031 р. Ймовірності були зафіксовані 9 жовтня 2026 р. і зареєстровані в OSF.
Одне щорічне вимірювання супроводжує прогнози, не будучи самим прогнозом, змаганням імен: щороку одні й ті ж запити підраховують, як часто кожен претендент Таблиці A2 з'являється у американських публікаціях та у OpenAlex та Crossref. Питання, яке колись було лише довгостроковою перевіркою, чи буде SOC 2028 називати професію для агент-керованої роботи, тепер є прогнозом F23 з ймовірністю (Bureau of Labor Statistics, 2026b). На 9 жовтня 2026 р. Bureau of Labor Statistics не опублікувала ні запропоновану, ні остаточну структуру SOC 2028; остаточна структура очікується у 2027 р.
11.3 Попередні прогнози
9 жовтня 2026 р. я шукав(ла) на Metaculus, Manifold, Good Judgment Open, Kalshi, Polymarket та Long Bets, а також у відкритій мережі (сторінки дослідження компаній, випуски аналітиків, arXiv, SSRN та новини), датовані прогнози про те, що люди без технічної освіти, працюючи через AI агентів, відповідали б або перевищували б програмістів, які використовують тих же агентів. Жоден знайдений прогноз не містить дати та спростовуючого результату. Найближчі до цього такі. Gartner у 2021 р. прогнозувала, що до 2024 р. 80% технологічних продуктів та послуг будуть побудовані людьми, які не є технічними спеціалістами (Gartner, 2021). Марк Кубан у 2017 р. сказав, що він би волів спеціалізуватися на філософії, очікуючи, що критичне мислення буде цінніше за програмування (Black Enterprise, 2017). Д. Х. Ганссон відповів "100%" на подкасту Lex Fridman від 26 серпня 2026 р., коли його спитали, чи існують проблеми, в яких програмісти гірші за непрограмістів у агентній інженерії (Lex Fridman Podcast, 2026). Anthropic в червні 2026 р. зазначила, що агенти кодування роблять фон програмування менш релевантним (Anthropic, 2026e). Прогнози у протилежному напрямку існують. Gartner очікує, що 60% вайб-кодованих додатків буде знято з експлуатації до 2028 р. (Gartner, 2026, як узагальнено Tray.ai, 2026), і в 2024 р. очікувала, що з 2024 по 2026 р. п'ята частина організацій буде використовувати AI для вирівнювання своєї структури (Gartner, 2024). Srinivasan та Wei (2026) очікують, що посада "agent manager" стане стандартною протягом 12–18 місяців. Forrester очікувала, що 60% компаній Fortune 100 призначать голову відділу управління AI (Forrester, 2025). На ринках Manifold ймовірність того, що до 2030 р. буде на третину менше молодших ролей розробників, оцінена близько 74%, а падіння більш ніж на 15% у розробників США з 2023 по 2028 р. – близько 42% (Manifold, 2026b; Manifold, 2026c). На Manifold ймовірність того, що до 2027 р. буде звичайним для непрограмістів писати малі скрипти з AI, становила близько 27% (Manifold, 2026a), і це питання стосується лише використання, без жодного виміру якості. Прогнози тут відрізняються від усіх цих в тому, що порівнюють людей з людьми, які використовують того ж агента, в тому, що роблять освіту змінною, та в наявності дати, виміру та спростовуючого результату. Журнал пошуку наведений у Додатку B. Впровадження шарами (Rogers, 2003), часові горизонти машин (Kwa et al., 2025) та спостереження про скорочення молодших ролей – це попередня робота, і не заявляється жодного пріоритету за ними.
11.4 Закріплення та оцінювання
Де повинен перебувати прогноз, щоб його ніхто, включаючи автора, не міг тихо змінити? З місць, які використовує ця серія, тільки одне зберігає записи незмінними. Реєстрацію на OSF не можна редагувати чи видаляти; вона може бути відкликана, проте сторінка з її назвою, датами, DOI та причиною відкликання залишається (OSF, 2026). Zenodo дозволяє депозитарію змінювати або видаляти файли протягом 30 днів після публікації, а потім лише створювати нові версії (OpenAIRE, 2025). SSRN замінює PDF при переробленні. Тому прогнози будуть спочатку зареєстровані на OSF як відкрита реєстрація, опублікована негайно без embargo, оскільки embargo сховав би запис і утримав би його DOI, а пріоритет, невидимий для всіх, має мало цінності.
9 жовтня 2026 року таблиця була зареєстрована на OSF як набір попередньо зареєстрованих прогнозів (DOI 10.17605/OSF.IO/VW6P9), а стаття була опублікована на SSRN та Zenodo; знімки всіх базових джерел архівовані в Wayback Machine. Щороку з 2027 по 2031 рік, в річницю реєстрації, публікується табель, який містить список усіх прогнозів без винятку, їхній статус (здійснився, не здійснився, ще не настав, невирішений, не проведений) та докази. Вона повідомляє показник Бріра для розв'язаних прогнозів у цілому, за наборами та за сім'ями, де пов'язані прогнози враховуються один раз, згруповані як у стовпці сім'я зареєстрованої таблиці (F1 та F1b; F2, F3 та F3b; F4a та F4b; F5, F6 та F33; F9 та F31; F15 та F16; F17 та F17b; F28 та F28b); частку розв'язаних; найгіршу межу, в якій кожен прогноз, що вийшов за свою кінцеву дату та залишається невирішеним, і кожен непроведений прогноз, оцінюється так, ніби прогноз був неправильним; оцінку з непроведеними прогнозами та без них; та оцінку навичок Бріра проти трьох еталонів: плоського прогнозу 0.5, об'єднаних прогнозів моделей з Таблиці 4 та ціни ринку, де ринок існував у день реєстрації. Вибіркове невирішення тому не може поліпшити оцінку. Табель сама зареєстрована на OSF, пов'язана з оригіналом через DOI, та депонована на Zenodo. Моделі принаймні з двох сімей незалежно перевіряють кожен табель проти замороженних правил; де вони розходяться, рішення приймає правило, й про це повідомляється. Текст реєстрації знаходиться в Додатку D, а Рисунок A1 (Додаток D) показує повний графік перевірок та кінцевих дат. Два зобов'язання наступають перед початком оцінювання. Вибірка продуктів, створених агентом, для F27 фіксується на Zenodo до 31 грудня 2026 року, а базові лінії F5 та F30 обчислюються та архівуються перед реєстрацією. Протокол вибірки F27, з типовим значенням для кожного вибору, який реєстрація залишає відкритим, та інструмент, який формує вибірку за наперед визначеним насінням і запечатує її, знаходяться в супровідному репозиторії (kits/f27-sample.md, tools/freeze_sample.py).
Після реєстрації прогнозів публічні прогнози також будуть розміщені там, де зовнішні прогнозисти можуть встановити для них ціни: п'ять ринків на Manifold (F5, F8, F10, F11 та F22, які безплатні для розміщення; ці п'ять були вибрані, оскільки кожна розв'язується на основі публічного джерела та зовнішнього ряду, який може прочитати кожен, без моїх власних даних), одне питання на Metaculus (перетинання в розміщеннях, F5), та Платформа прогнозування соціальних наук для експериментів F2, F3 та F7, щоб зібрати прогнози інших людей до того, як з'являтимуться дані. Ринки прогнозування з торгівлею грошима не використовуються.
11.5 Когортна програма
Я проводжу попередньо зареєстровану програму когорти (OSF, https://osf.io/x4egq, DOI 10.17605/OSF.IO/X4EGQ), яка стежить за непрограмістами від чату через агентів до оркестрування (Chernets, 2026e). Її перша когорта є однорамене дослідження здійсненності з власними зареєстрованими результатами, які повідомляються в її власному звіті. Прогнози, такі як F7, F14 та F18–F20, які потребують даних на рівні особи, будуть протестовані в пізнішій когорті, попередньо зареєстрованій перед збором даних, з питанням про ІТ-освіту серед встановлених параметрів. Записи Додатку C, збережені з дозволу, служать природними даними для цієї когорти.
12. Докази, яким суперечать прогнози
Прогнози розділу 11 йдуть проти кількох видів доказів з 2026 року, і кожний з них сформував правило заходу або прогноз.
Безпека не встигла. Серед понад сто моделей частка згенерованого коду, що пройшла тестування безпеки, залишилася на рівні 56% у звіті Veracode за 2026 рік (Veracode, 2026). Ці тести запускалися лише на моделях, зі стандартними промптами без інструкцій безпеки та без агентського оснащення, інструментів чи огляду людьми, тому вони описують базовий матеріал, з якого починає людина. Пасивне сканування 5600 публічних додатків, побудованих програмуванням на інтуїцію, виявило понад 2000 вразливостей, понад 400 розкритих секретів та 175 витоків особистих даних, і його автори подають це як нижню межу (Escape, 2026). Ось чому F2 включає сліпий огляд безпеки, а чому незворотна робота потребує, щоб кожна частина пройшла (розділ 5.2).
Успішне проходження тестів недостатньо для прийняття. METR попросила супроводжувачів переглянути виправлення, написані агентом, які пройшли тести еталонного дослідження, і виявила, що близько половини не були б об'єднані у такому вигляді; агенти були попередньої генерації без циклу перегляду, тому частка тепер може бути нижчою (METR, 2026b). Правило оцінювання спирається на приховані тести, кваліфікованих рецензентів та реальне використання, а F2 передбачає перевірку через місяць.
Верифікація залежить від досвіду. У опитуванні 162 осіб, які програмують на інтуїцію, кожна група визнала ризики згенерованого коду, але те, як вони його перевіряли, варіювалося залежно від досвіду. Автори називають це розривом сприйняття та дії (Fawzy et al., 2026). Бізнес-користувачі та новачки швидко створюють робочі прототипи, тоді як якість коду неоднорідна і потребує переробки (Gama et al., 2026). Бізнес-користувачі також пропустили суттєві помилки в аналізі ШІ навіть після попередження (Virk & Liu, 2025). Рандомізоване дослідження 52 молодих інженерів, які вивчають нову бібліотеку, виявило оцінки розуміння 50% із ШІ проти 67% без, і без значного прибутку в швидкості. Ті, хто просив модель про пояснення, набрали 65% або більше, а ті, хто передали весь код, набрали менше 40% (Anthropic, 2026c). Це найсильніша причина, чому захід спирається на грамотність прийняття та помилки в тесті: навичка, що розділяє людей, – це та, яку ці дослідження показують як варіюючу.
Немає опублікованого порівняння, що ставить непрограмістів проти програмістів, які використовують тих самих агентів. Esnaola et al. (2026) виявили, що деякі непрограмісти, використовуючи GPT-4o через ChatGPT, вирішили невеликі, добре визначені проблеми програмування на рівні, порівняному з програмістами, які працюють без ШІ, і швидше; автори називають дослідження розвідувальним. Програмісти працювали без ШІ, тому дизайн не мав групи програмістів з ШІ, і вивчав короткі окремі завдання, а не тривалий розвиток; пакет репліації є публічним (Esnaola et al., 2026). У даних Anthropic люди, які були новичками в завданні, мали перевірену успішність 15% проти 28–33% для більш досвідчених користувачів (Anthropic, 2026e). Там «новачок» означає новачка в завданні, як оцінюється моделлю, і нічого не говорить про ІТ-освіту. Чи відображає цей розрив освіту чи знайомство з завданням, це те, що F7 написано розділити. Раніше генеративний ШІ у фірмі з підтримки клієнтів найбільше підвищив продуктивність новачків та низькокваліфікованих агентів і трохи – найдосвідченіших (Brynjolfsson et al., 2025), попередник з часів до агентів. У 2024 році польовий експеримент у компанії Procter & Gamble із чат-моделями виявив, що люди з ШІ відповідали командам без ШІ і створювали збалансовану роботу незалежно від їх професійного походження, попередник з часів до агентів (Dell'Acqua et al., 2025). F2, F3 та F7 розроблені для надання відсутнього порівняння.
Авторитетні голоси не згідні з сильною версією. Карпатий дотримується нижньої та верхньої межі (розділ 2.1). Ендрю Нг стверджував у серпні 2026 року, що розробники, які глибоко розуміють, як працюють програми, значно переважають тих, хто програмує на інтуїцію без цього розуміння (Ng, 2026). Дані найму вказують на те ж саме поки що: оголошення, що вимагають навичок ШІ, все ще частіше вимагають чотирирічної ступені, ніж порівнянні оголошення, які цього не роблять (Lightcast, 2026b), і LinkedIn приписує більшість слабкості в найму на початковому рівні економіці (розділ 2.4). Прогнози розглядають ці погляди як своїх суперників, з коефіцієнтами, поданими заздалегідь.
13. Обсяг та граничні умови
Час. Докази сягають до 9 жовтня 2026 р. Факти про продукти швидко застарівають, тому метрика визначена через еталонні години та перевірки без посилання на конкретні продукти.
Джерела. Значна частина найміцніших доказів походить від постачальників щодо своїх власних продуктів: OpenAI щодо його агента кодування, Anthropic щодо його сеансів. Вони позначені як дані постачальника і використовуються для того, що постачальники можуть знати. Кілька повідомлень у пресі, таких як рейтинги токенів, базуються на звітах названих видань і цитуються як такі. Вторинні джерела (Growthy, Startup Fortune, Shopifreaks) архівуються в Wayback Machine перед публікацією, а первинний звіт цитується, де його можна було знайти.
Сукупність. Аргумент стосується роботи, виконаної на комп'ютері, через агентів, людьми, які можуть це перевірити. Люди без комп'ютера, який вони контролюють, і робота, яка взагалі не може бути перевірена, виходять за межи вимірювання.
Що стверджує метрика. Верифікований горизонт описує те, що людина забезпечила в режимі перевірки, в галузі, на певну дату. Він не стверджує, що вище — краще для кожного завдання. Багато роботи належить Годині, і вибір зберігати роботу вручну — це законне рішення. У галузях, де помилка не може бути виправлена, застосовується суворіший поріг Розділу 5.2, і деякі роботи взагалі не повинні передаватися агентам.
Назви. Карта Розділу 3 записує використання, знайдене 8 і 9 жовтня 2026 р. Назви будуть прийняті та залишені після цього, саме тому карта поєднується з щорічною гонкою назв, і жодна окрема назва не вибирається.
Сильна теза. Те, що люди без технічної освіти будуватимуть кращі продукти, ніж програмісти, викладено як набір передбачень з датами та порогами (F2 до F7). Я подаю це як прогноз, який буде оцінюватися публічно.
Дії, зарезервовані законом. Де закон зарезервував дію за ліцензією, ні метрика, ні втрата ваги за воротами маркування (Розділи 6.2 та 6.5) не переміщує цю дію. У Сполученому Королівстві ніхто не може виступати як статутний аудитор, якщо він не має права на призначення, що вимагає членства в визнаному органі наглядування та відповідності його нормам (Закон про компанії 2006 р., статті 1212 та 1213), а у Сполучених Штатах тільки фірма, зареєстрована при Раді з нагляду за бухгалтерським обліком публічних компаній, може підготувати або видати звіт аудиту щодо емітента (Закон Sarbanes-Oxley 2002 р., розділ 102). У бухгалтерському обліку такі зарезервування є вузькими: від бухгалтера в Сполучених Штатах зазвичай не вимагається навіть наявність сертифікату (Бюро статистики праці, 2026c). У праві вони ширші: Англія та Уельс зарезервували шість видів правової діяльності, серед них ведення судових справ та діяльність з виконання завіщання (Закон про правові послуги 2007 р., стаття 12). Тому робота може переміститися, поки підпис залишається, і ліцензований підписувач тоді виконує функцію гаранта Розділу 7.2 в формі, яку закон вже передбачає. Наскільки далеко сама ліцензія дозволяє за позначенням або за перевіреною роботою, розглядається в Розділі 6.2.
Дані до агентів. Серії до 2025 року входять тільки як попередники, оскільки вони описують роботу без агентів. Макроекономіка найму показується в даних LinkedIn 2026 р. (Розділ 2.4), які вказують на економіку більше, ніж на штучний інтелект.
Статус тверджень. Таблиця A7 (Додаток F) застосовує мову впевненості серій до кожного елемента.
14. Висновок
Бухгалтер, що порівнює агентів кодування, та адвокат, що будує свій перевірник контрактів, тепер працюють так, як розробниця, коли передає модуль агентові й перевіряє результат. До 2026 року троє мають один робочий процес, і жодна зі старих ієрархій не може сказати, хто з них вийшов далі. Назва не вирішила б це, адже кожна назва, запропонована 2026 року, — гасло або оголошення про роботу, і ринок серед них не вибрав. Вимірювання може це вирішити, за умови що враховує правильне.
Запропоноване тут вимірювання не чекає на назву професії. Воно оцінює бухгалтера, адвоката й розробниця на одній шкалі — обсяг роботи, яку кожна передала агентам і яка була перевірена, в галузі та на дату, з другою віссю для того, скільки перевіреної роботи за годину їхної уваги. Його пороги мають версії та були ручно протестовані, і тестування вже виправило один з них; його правила називають способи, якими результат можна маніпулювати, та захист від кожного, а його верхня межа пояснює, чому ціна перевірки встановлює границю, незалежно від швидкості агента. Для роботодавця, школи чи платформи питання змінюється. Замість того щоб питати, програмістка людина чи скільки штучного інтелекту вона використовувала, вони просять день роботи в їхній галузі, що пройшла перевірку, яку людина не проектувала. Будь-яка назва, яку вибере ринок, може читатися на цій шкалі.
Датовані передбачення несуть тезу, якою почалася ця стаття. Область за областю продукти, створені людьми без IT-освіти, почнуть випереджати ті, що робляться програмістами, які використовують тих самих агентів. На рівному перевіреному горизонті програмна освіта перестане передбачати якість перевіреної роботи. А в оголошеннях про роботу лінії вимог щодо ступенів будуть перетинатися, спочатку в областях, де експерти можуть самі прийняти роботу, в останню чергу в програмному забезпеченні. Якщо таблиці результатів 2027 та 2028 років суперечитимуть цим передбаченням, вони скажуть про це публічно з балом Брієра. Якщо передбачення справдяться, слова молодший та старший можуть залишитися, але їхнє значення зміниться в бік обсягу роботи, яку людина може довести; чи замінять великі роботодавці свої ступінькові ієрархії такою мірою — це саме по собі передбачення тут (F17), зареєстроване при p = 0,05.
Одна границя залишиться, яким би чином не розвивалися ці передбачення. Виробництво стає грамотністю, як письмо. Відповідальність за те, що виробляють, залишається професією, а між ними стоїть невидимість — стан ринку 2026 року, де хороша робота залишається непомітною і платформи закривають двері перед невідомими. Той, хто виробляє через агентів, потребуватиме партнера, що ручається за роботу, або повинен ним стати, а гарант, у свою чергу, може вимірюватися тим, за що ручався, й скільки з того витримало.
Американське прислів'я каже, що Бог створив людей, а полковник Кольт зробив їх рівними. Агенти роблять щось подібне для виробництва: з одним людина поза ремеслом може створити роботу, що виглядає як ремесло. Перевірку важче уніфікувати (Розділи 5.2 та 12). У дослідженні рейтерів додатку G майже один з п'яти людей, допущених до вибірки бухгалтерів за їхнім словом, неправильно відповіли на питання першого тижня ремесла, а в дослідницькому порівнянні вони оцінили більші завдання в менших годинах, ніж решта (Додаток G2). Чи може процес незалежних перевірок робити для перевірки те, що агенти робили для виробництва, є відкритим питанням розділу 6.5. Те, що все ще розділяє людей, це те, що вони можуть перевірити й прийняти, і саме це вимірює горизонт перевіреної делегації.
Декларації
Фінансування. Цю роботу не підтримало жодне зовнішнє фінансування.
Конкуруючі інтереси. Автор розробляє методи мультимодельної оркестрації та подав відповідні патентні заявки (розглядаються; жодного патенту ще не видано). Автор розробив попередньо зареєстровану програму когорти, описану в розділі 11.5 і додатку G, та її матеріали, а також розробляє навчальну програму, що допомагає людям працювати з AI-агентами. Жоден висновок у цій статті не залежить від реалізації автора; інструмент у додатку C використовує лише стандартну бібліотеку Python.
Інструменти та перевірка. AI-асистенти використовувалися як інструменти під керівництвом автора; ідеї, дослідження та висновки належать авторові. Кількісні твердження та цитування були перевірені за первинними джерелами або архівованими копіями станом на 9 жовтня 2026 р. або 10 жовтня 2026 р. для джерел, доданих того дня, де це було можливо. У випадках, коли були доступні лише прес-релізи або сторінки постачальника, твердження приписуються цьому звіту або постачальнику в тексті. Назви, наведені в квадратних дужках у посиланнях, — описові назви для сторінок, заголовки яких не цитувалися дослівно.
Доступність даних і коду. Код і схема додатку C, настільний тест порогів (додаток E) та файли прогнозів випущені під ліцензією MIT у супровідному сховищі (https://github.com/vadimchernets/delegation-horizon), архівовані в Zenodo як випуск v1.1.0 (концептуальний DOI 10.5281/zenodo.23267444, розпізнавання якого веде до останнього випуску); код, надрукований у додатку C, ідентичний коду сховища побайтово, і tools/paper_sync.py перевіряє це, опрацьований приклад та таблиці 4 і A6 відносно сховища щоразу, коли його тести запускаються разом з цим текстом. Прогнози таблиць 4 і A6 були зареєстровані на OSF 9 жовтня 2026 р. (DOI 10.17605/OSF.IO/VW6P9). Дослідження оцінювачів Prolific додатку G було зареєстроване на OSF 9 жовтня 2026 р., до збору будь-яких даних (DOI 10.17605/OSF.IO/V92R8); його аналітичний скрипт (pilot/human_raters.py) подано з цією реєстрацією і знаходиться в супровідному сховищі як було подано, з SHA-256, яку повідомляє OSF для кожного поданого файлу, наведено в pilot/registered-SHA256.txt, разом зі скриптами, які перетворюють експорти Prolific, виводять таблицю G2 та запускають порівняння G2, яке не було зареєстровано. Анонімізовані дані, у яких ідентифікатори Prolific замінені простими позначеннями, будуть додані до тієї самої папки. Файли, зареєстровані з прогнозами, наведені з їхнім SHA-256 у predictions/registered-SHA256.txt, маніфесті, поданому на OSF, і тест сховища порівнює кожен з них з ним.
Етика. Додаток G подає два джерела даних від людей. Дослідження оцінювачів Prolific — це анонімне онлайн-завдання з оцінювання: дорослі фахівці надали інформовану згоду на Prolific перед участю, були оплачені через платформу та не надали імен чи контактних даних. Звіт когорти узагальнює, без імен, місць або мов, записи дорослих, які дали згоду на попередньо зареєстровану програму когорти (OSF, DOI 10.17605/OSF.IO/X4EGQ) та на анонімізовану публікацію; зареєстровані результати програми повідомляються окремо. Роботу проводив незалежний дослідник без інституційного комітету з етики. Публічні нитки, обговорені в розділі 9, перефразовані, а їхні автори не названі.
Внески автора. Один автор.
Кореспонденція. vadimchernets9@gmail.com · ORCID: 0009-0007-4845-3163
References
9to5Mac. (2026). [App Store new apps doubled in the first half of 2026, Sensor Tower data reported by The New York Times]. https://9to5mac.com/?p=1061510
AI Certification Standards. (2026). AI Competence Framework (version of 23 August 2026). https://www.aicertificationstandards.org/framework
AI Futures Project. (2026, April 2). Q1 2026 timelines update. https://blog.aifutures.org/p/q1-2026-timelines-update
aicodex. (2026). AI agent manager vs agent operator. https://www.aicodex.to/articles/ai-agent-manager-vs-agent-operator
Alenezi, M. (2026). From determinism to delegation: AI-native software engineering and the evolution of the agentic engineer. arXiv:2606.28791. https://arxiv.org/abs/2606.28791
Alonso, M. N. (2026). The artificial intelligence economy [working paper, ResearchGate; contains the proposition "A delegation horizon"].
AlternativeTo. (2026, January). OpenAI rolls out age prediction for ChatGPT accounts. https://alternativeto.net/news/2026/1/openai-rolls-out-age-prediction-for-chatgpt-accounts-to-automatically-estimate-your-age/
Andrist, R. K. (1962). Gold! American Heritage, 14(1). https://www.americanheritage.com/content/gold
Amplifying. (2026). What Claude Code actually chooses. https://amplifying.ai/research/claude-code-picks
Anthropic. (2025a, December 2). How AI is transforming work at Anthropic. https://www.anthropic.com/research/how-ai-is-transforming-work-at-anthropic
Anthropic. (2025b). AI Fluency framework (the four Ds). https://aifluencyframework.org/
Anthropic. (2026a, January 15). Anthropic Economic Index report: Economic primitives. https://www.anthropic.com/research/anthropic-economic-index-january-2026-report
Anthropic. (2026b, January 22). Claude's constitution. https://www.anthropic.com/constitution
Anthropic. (2026c, January 29). [AI assistance and coding skills: a randomised study of junior engineers]. https://www.anthropic.com/research/AI-assistance-coding-skills
Anthropic. (2026d, March 24). Anthropic Economic Index report: Learning curves. https://www.anthropic.com/research/economic-index-march-2026-report
Anthropic. (2026e, June 16). Agentic coding and persistent returns to expertise. https://www.anthropic.com/research/claude-code-expertise
Anthropic. (2026f, June 26). [Anthropic Economic Index report, June 2026]. https://www.anthropic.com/research/economic-index-june-2026-report
Arion Research. (2026, February 7). [The agent manager role]. https://www.arionresearch.com/blog/nfkxv53ktwxqkwtxwm2d03woml1c65
Artificial Lawyer. (2026, January 27). Claude Cowork: the DIY revolution in law. https://www.artificiallawyer.com/2026/01/27/claude-cowork-the-diy-revolution-in-law/
Atkinson, T., & Yamco, S. (2026, January 6). Young workers' employment drops in occupations with high AI exposure. Federal Reserve Bank of Dallas. https://www.dallasfed.org/research/economics/2026/0106
Batko, M. (2026, August 20). [Distribution is the moat]. Startmate. https://startmate.com/writing/distribution-is-the-moat
Benchek, J., et al. (2026). APEX-Accounting. arXiv:2607.27189. https://arxiv.org/abs/2607.27189
Berkeley California Management Review. (2025, July). Rethinking AI agents: A principal-agent perspective. https://cmr.berkeley.edu/2025/07/rethinking-ai-agents-a-principal-agent-perspective/
BetterUp. (2026, May 18). [Workslop research with Stanford]. https://www.betterup.com/blog/workslop-canada
Black Enterprise. (2017). [Mark Cuban on liberal arts and the future of work]. https://www.blackenterprise.com/mark-cuban-right-libreal-arts-key-future/amp/
Bloomberg Law. (2026, April 20). Vibe coding empowers lawyers to influence AI winners, losers. https://news.bloomberglaw.com/legal-exchange-insights-and-commentary/vibe-coding-empowers-lawyers-to-influence-ai-winners-losers
Bone, M., González Ehlinger, E., & Stephany, F. (2025). Skills or degree? The rise of skill-based hiring for AI and green jobs. Technological Forecasting and Social Change. https://doi.org/10.1016/j.techfore.2025.124042
Brier, G. W. (1950). Verification of forecasts expressed in terms of probability. Monthly Weather Review, 78(1), 1-3. https://doi.org/10.1175/1520-0493(1950)078<0001:VOFEIT>2.0.CO;2
Bancroft, H. H. (1888). History of California (Vol. 6, 1848-1859). The History Company. https://archive.org/details/historyofcaliforv6banc
Brynjolfsson, E., Li, D., & Raymond, L. (2025). Generative AI at work. The Quarterly Journal of Economics, 140(2), 889-942. https://doi.org/10.1093/qje/qjae044
Bureau of Labor Statistics. (2025). Photographers. Occupational Outlook Handbook, 2024-34 edition (archived 19 August 2026). https://web.archive.org/web/20260819060531/https://www.bls.gov/ooh/media-and-communication/photographers.htm
Bureau of Labor Statistics. (2026a). Photographers. Occupational Outlook Handbook (updated 27 August 2026). https://www.bls.gov/ooh/media-and-communication/photographers.htm (archived copy: https://web.archive.org/web/20261001165113/https://www.bls.gov/ooh/media-and-communication/photographers.htm)
Bureau of Labor Statistics. (2026b). 2028 SOC revision. https://www.bls.gov/soc/2028/2028_soc_revision.htm
Bureau of Labor Statistics. (2026c). Bookkeeping, accounting, and auditing clerks. Occupational Outlook Handbook (updated 27 August 2026). https://www.bls.gov/ooh/office-and-administrative-support/bookkeeping-accounting-and-auditing-clerks.htm
Burning Glass Institute & Harvard Business School. (2024). Skills-based hiring: The long road from pronouncements to practice. https://www.burningglassinstitute.org/research/skills-based-hiring-2024
Business Insider. (2026, January 22). [Deloitte gives US employees new job titles]. https://www.businessinsider.com/deloitte-gives-us-employees-new-job-titles-leader-role-2026-1
Cagan, M. (2025). The era of the product creator. SVPG. https://www.svpg.com/the-era-of-the-product-creator/
Capps, R. (2025, June 17). [New jobs that AI could create]. The New York Times Magazine. https://www.nytimes.com/2025/06/17/magazine/ai-new-jobs.html
Carta. (2025). Solo founders report 2025. https://carta.com/data/solo-founders-report
Carta. (2026a). 2026 founder ownership report. https://carta.com/data/founder-ownership-2026-full-report/
Carta. (2026b). State of pre-seed: Q2 2026. https://carta.com/data/state-of-pre-seed-q2-2026/
Challenger, Gray & Christmas. (2026). [Job cuts report, June 2026]. https://www.challengergray.com/wp-content/uploads/2026/07/Challenger-Report-June2600986996.pdf
Chen, X., & Meng, S. (2026). When AI levels the playing field: Skill homogenization, asset concentration, and two regimes of inequality. arXiv:2603.05565. https://arxiv.org/abs/2603.05565
Catalini, C., Hui, X., & Wu, J. (2026). Some simple economics of AGI. arXiv:2602.20946. https://arxiv.org/abs/2602.20946
Celenza, B. (2026, October 6). Building Git infrastructure for agent-scale development. GitHub Blog. https://github.blog/engineering/architecture-optimization/building-git-infrastructure-for-agent-scale-development/
Chernets, V. (2026a). After Chat: The three transitions between non-programmers and agentic AI. SSRN. https://doi.org/10.2139/ssrn.7520019 (Zenodo: https://doi.org/10.5281/zenodo.22943313)
Chernets, V. (2026b). Agreement is not independent evidence: Auditable multi-model synthesis without an API. SSRN. https://doi.org/10.2139/ssrn.7390698
Chernets, V. (2026c). AI-Watchbird (Sheckley): When automated oversight widens its own mandate and harms what it guards. SSRN. https://doi.org/10.2139/ssrn.7473658
Chernets, V. (2026d). Architectural trust: Why consumer trust in agentic commerce migrates from AI models to verifiable architecture. SSRN. https://doi.org/10.2139/ssrn.7191261
Chernets, V. (2026e). Three steps into agentic AI: A preregistered feasibility study of how non-programmers cross from chatbot to agent to multi-model orchestration (Cohort 1). OSF. https://doi.org/10.17605/OSF.IO/X4EGQ
CIO. (2026a, May 29). Amazon deletes devs' tokenmaxxing leaderboard to minimize costs. https://www.cio.com/article/4178825/amazon-deletes-devs-tokenmaxxing-leaderboard-to-minimize-costs-2.html
CIO. (2026b, September 4). Meta minimizes role of token-maxing in employee evaluations. https://www.cio.com/article/4218661/meta-minimizes-role-of-token-maxing-in-employee-evaluations-2.html
Clark, M. (2026). [Proposal for a Chartered Financial Intelligence Architect]. SSRN.
Collins Dictionary. (2025). Collins Word of the Year 2025. https://blog.collinsdictionary.com/language-lovers/collins-word-of-the-year-2025-ai-meets-authenticity-as-society-shifts/
Companies Act 2006, c. 46, ss. 1212 and 1213 (United Kingdom). Individuals and firms: eligibility for appointment as a statutory auditor; Effect of ineligibility (accessed 10 October 2026). https://www.legislation.gov.uk/ukpga/2006/46/section/1212 ; https://www.legislation.gov.uk/ukpga/2006/46/section/1213
Computing Research Association. (2026, June). [New CRA Taulbee Survey findings: record degree production alongside a cooling enrollment pipeline]. https://cra.org/crn/2026/06/cra-update-new-cra-taulbee-survey-findings-show-record-degree-production-alongside-a-cooling-enrollment-pipeline/
CSET. (2025). [Translation: China's notice on AI education in primary and secondary schools]. Center for Security and Emerging Technology. https://cset.georgetown.edu/publication/china-primary-secondary-ai-education-notice/
Crunchbase News. (2026, July 2). Crunchbase data: Global startup investment hit record $510B in H1 2026 as AI boom accelerates funding and exits. https://news.crunchbase.com/venture/global-startup-exits-ipo-ma-soar-ai-q2-h1-2026/
Danilova, A., Naiakshina, A., Horstmann, S., & Smith, M. (2021). Do you really code? Designing and evaluating screening questions for online surveys with programmers. 2021 IEEE/ACM 43rd International Conference on Software Engineering (ICSE), 537-548. https://doi.org/10.1109/ICSE43902.2021.00057
Dawson, R. (2026). [Framework: levels of AI delegation in decision making]. https://rossdawson.com/framework-levels-ai-delegation-decision-making
Dealroom. (2026). Mercor doubles to $2B gross revenue run-rate as AI labs buy expert data. https://dealroom.co/news/137121-mercor-doubles-to-2b-gross-revenue-run-rate-as-ai-labs-buy-expert-data/
Dell'Acqua, F., et al. (2025). The cybernetic teammate: A field experiment on generative AI reshaping teamwork and expertise. NBER Working Paper 33641. https://www.nber.org/papers/w33641
Dell'Acqua, F., et al. (2026). Navigating the jagged technological frontier: Field experimental evidence of the effects of artificial intelligence on knowledge worker productivity and quality. Organization Science, 37(2), 403-423. https://doi.org/10.1287/orsc.2025.21838
Digg. (2026). [Your job title is about to change: AI Agent Supervisor]. https://digg.com/aiagentchat/TvbtLF2/your-job-title-is-about-to
Dust. (2026, October 7). [Dust Index: AI strategy beyond models]. https://dust.tt/blog/dust-index-ai-strategy-beyond-models
EdWeek. (2026, June 11). [White House honors AI challenge winners]. https://www.edweek.org/technology/white-house-honors-ai-challenge-winners-as-tech-backlash-grows/2026/06
em360. (2026, September 7). [AI productivity and supervisory capacity]. https://em360tech.com/tech-articles/ai-productivity-supervisory-capacity
Engelbart, D. C. (1962). Augmenting human intellect: A conceptual framework (Summary Report AFOSR-3223). Stanford Research Institute.
Escape. (2026). Methodology: how we discovered vulnerabilities in apps built with vibe coding (accessed 9 October 2026). https://escape.tech/blog/methodology-how-we-discovered-vulnerabilities-apps-built-with-vibe-coding/
Esnaola, L. M., Ramón, H. D., & Lanzarini, L. C. (2026). Can generative AI bridge the gap? A quasi-experimental study of non-programmers with AI vs. programmers without AI. Empirical Software Engineering, 31(3), 75. https://doi.org/10.1007/s10664-026-10813-7 Replication package: https://doi.org/10.5281/zenodo.17803568
Eulerich, M., Sanatizadeh, A., Vakilzadeh, H., & Wood, D. A. (2024). Is it all hype? ChatGPT's performance and disruptive potential in the accounting and auditing industries. Review of Accounting Studies, 29(3), 2318-2349. https://doi.org/10.1007/s11142-024-09833-9
Fawzy, A., Tahir, A., & Blincoe, K. (2026). From prompting to verification: How experience shapes vibe coding practices. arXiv:2605.24521. https://arxiv.org/abs/2605.24521
Feldman, M. Q., & Anderson, C. J. (2024). Non-expert programmers in the generative AI future. CHIWORK 2024 (author version). https://www.feldmanmolly.com/chiwork2024-author-version.pdf
Feng, K. J. K., McDonald, D. W., & Zhang, A. X. (2025). Levels of autonomy for AI agents. arXiv:2506.12469. https://arxiv.org/abs/2506.12469
Flowtivity. (2026, February 24). Your boss will measure you in tokens. https://flowtivity.ai/blog/your-boss-will-measure-you-in-tokens/
Forrester. (2025, October). [Predictions 2026 for AI and technology leadership], as reported by iTWire. https://itwire.com/it-industry-news/strategy/forrester-unveils-2026-predictions-for-ai-and-tech-leadership.html
Fortune. (2025, May 7). [Prompt engineering, a six-figure role, now obsolete]. https://www.fortune.com/2025/05/07/prompt-engineering-200k-six-figure-role-now-obsolete-thanks-to-ai
Fortune. (2026a, January 22). [Deloitte's job title change]. https://www.fortune.com/2026/01/22/deloitte-job-title-change-ai-reshapes-big-4-accounting-consulting-firms
Fortune. (2026b, May 26). [Uber's chief operating officer on AI spending]. https://www.fortune.com/2026/05/26/uber-coo-ai-spending-tokens-claude-code/
Fortune. (2026c, July 7). [Cognition's chief executive on tokenmaxxing]. https://fortune.com/2026/07/07/cognition-ceo-tokenmaxxing-big-tech-carried-away-ai-productivity-gains/
Fox, S., Markham, L., Lail, R., & Karotsieris, M. (2026). LLM judges verify presence, not absence: Omission blindness in AI clinical notes and what recovers it. arXiv:2608.31016. https://arxiv.org/abs/2608.31016
Fu, H. Y., Shrivastava, A., Moore, J., West, P., Tan, C., & Holtzman, A. (2025). AbsenceBench: Language models can't tell what's missing. arXiv:2506.11440. https://arxiv.org/abs/2506.11440
Gama, et al. (2026). [Novice teams building software with AI]. ICSE 2026. arXiv:2512.02750. https://arxiv.org/abs/2512.02750
Gartner. (2009). Gartner Symposium/ITxpo Orlando brochure (use of "citizen developer"). https://www.gartner.com/imagesrv/symposium/pdf/orlando_symposium_conference_brochure.pdf
Gartner. (2021, June 10). Gartner says the majority of technology products and services will be built by professionals outside of IT by 2024. https://www.gartner.com/en/newsroom/press-releases/2021-06-10-gartner-says-the-majority-of-technology-products-and-services-will-be-built-by-professionals-outside-of-it-by-2024
Gartner. (2024, October 22). Gartner unveils top predictions for IT organizations and users in 2025 and beyond. https://www.gartner.com/en/newsroom/press-releases/2024-10-22-gartner-unveils-top-predictions-for-it-organizations-and-users-in-2025-and-beyond
Gartner. (2026). Tyagi, N. Govern vibe coding for citizen developers with self-service platforms (29 June 2026; document 8068765). https://www.gartner.com/en/documents/8068765 (subscriber access; figures cited as summarised by Tray.ai, 2026)
Gigazine. (2025, July 24). What are the results of the 'AccountingBench' benchmark, which tests an AI model for monthly accounting tasks? https://gigazine.net/gsc_news/en/20250724-accountingbench/
Gigazine. (2026, July 21). [Sensor Tower: new App Store apps in the first half of 2026]. https://www.gigazine.net/gsc_news/en/20260721-app-store-new-apps
GitHub. (2025a). Octoverse: A new developer joins GitHub every second as AI leads TypeScript to #1. https://github.blog/news-insights/octoverse/octoverse-a-new-developer-joins-github-every-second-as-ai-leads-typescript-to-1/
GitHub. (2025b, December 8). The new identity of a developer: What changes and what doesn't in the AI era. https://github.blog/news-insights/octoverse/the-new-identity-of-a-developer-what-changes-and-what-doesnt-in-the-ai-era/
Growthy. (2026, September 23). Claude Code vs Codex for bookkeeping. https://growthy.com/blog/claude-code-vs-codex-for-bookkeeping
Haize Labs. (2026). Vertical AI Lead [job posting]. https://job-boards.greenhouse.io/haizelabs/jobs/5173890008
Hashimoto, M. (2026). Vouch [repository]. https://github.com/mitchellh/vouch
HCA Magazine. (2026, July 29). [Atlassian introduces AI wallets for employees]. https://www.hcamag.com/ca/news/general/atlassian-introduces-new-ai-wallets-to-employees/584258
Hosseini, S. M., & Lichtinger, G. (2026, May 6). Generative AI as seniority-biased technological change [Working paper; earlier version SSRN 5425555, 2025]. https://raw.githack.com/s-mahdihosseini/Website/b99fa2962dcc4c165bbc3c41dd283afa99c5ccfb/GenAI_SenBTC_May_2026.pdf
Huang, L., Xiao, W., & Vishnoi, N. K. (2026). Delegation and verification under AI. Accepted at ICML 2026. arXiv:2603.02961. https://arxiv.org/abs/2603.02961
Hwang, J. (2026, February 13). Claude Code is the new Excel. https://nextword.substack.com/p/claude-code-is-the-new-excel
Indeed Hiring Lab. (2026, January 28). Where do college degrees still matter in a "skills-first" job market? https://hiringlab.indeed.com/2026/01/28/where-do-college-degrees-still-matter-in-a-skills-first-job-market/
IT Brew. (2026, June 5). AI orchestrators are the newest in-demand AI role. https://www.itbrew.com/stories/ai-orchestrators-are-the-newest-in-demand-ai-role
Jaques, E. (1956). Measurement of responsibility: A study of work, payment and individual capacity. Tavistock Publications. (Reviewed in Industrial and Labor Relations Review, 10(3), 475. https://doi.org/10.2307/2519792)
Jensen, M. C., & Meckling, W. H. (1976). Theory of the firm: Managerial behavior, agency costs and ownership structure. Journal of Financial Economics, 3(4), 305-360. https://doi.org/10.1016/0304-405X(76)90026-X
Journal of Accountancy. (2025, May 14). AICPA, NASBA approve new CPA licensure path. https://www.journalofaccountancy.com/news/2025/may/aicpa-nasba-approve-new-cpa-licensure-path/
Kamara, S. (2026). Verification friction. SSRN. https://doi.org/10.2139/ssrn.6469865
Karpathy, A. (2025, February 2). [Post introducing "vibe coding"]. X. https://x.com/karpathy/status/1886192184808149383
Karpathy, A. (2026, April 30). Sequoia AI Ascent 2026 [talk notes]. https://karpathy.bearblog.dev/sequoia-ascent-2026/
Khadj, O. J. (2026). The delegation frontier. SSRN. https://doi.org/10.2139/ssrn.7348378
Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. Accepted at ICML 2025. arXiv:2506.07962. https://arxiv.org/abs/2506.07962
Kingy AI. (2026, May 4). Token spend is coming for your performance review. https://kingy.ai/news/token-spend-is-coming-for-your-performance-review-and-mine/
Ko, A. J., Abraham, R., Beckwith, L., Blackwell, A., Burnett, M., Erwig, M., Scaffidi, C., Lawrance, J., Lieberman, H., Myers, B., Rosson, M. B., Rothermel, G., Shaw, M., & Wiedenbeck, S. (2011). The state of the art in end-user software engineering. ACM Computing Surveys, 43(3), 21. https://doi.org/10.1145/1922649.1922658
Krebs, A. (2026). [Design slop and Show HN]. https://www.adriankrebs.ch/blog/design-slop/
Kwa, T., et al. (2025). Measuring AI ability to complete long tasks. arXiv:2503.14499. https://arxiv.org/abs/2503.14499
Legal Services Act 2007, c. 29, s. 12 (England and Wales). Meaning of "reserved legal activity" and "legal activity" (accessed 10 October 2026). https://www.legislation.gov.uk/ukpga/2007/29/section/12
Lenny's Newsletter. (2025). [Why LinkedIn is replacing PMs]. https://www.lennysnewsletter.com/p/why-linkedin-is-replacing-pms
Lex Fridman Podcast. (2026, August 26). #501, David Heinemeier Hansson [transcript]. https://lexfridman.com/dhh-2-transcript/
Lightcast. (2026a, August 7). Tracking the agentic AI explosion in jobs. https://lightcast.io/resources/blog/tracking-the-agentic-ai-explosion-in-jobs
Lightcast. (2026b, September 9). [Degree requirements still higher for AI jobs]. https://lightcast.io/resources/blog/degree-requirements-ai-jobs
LinkedIn. (2026a, January). LinkedIn gives professionals the edge with verified skills and tools to navigate the job search. https://news.linkedin.com/2026/Professional_Edge_Skills_Verified
LinkedIn. (2026b, April). Q3 earnings and business highlights. https://news.linkedin.com/2026/Q3-Earnings-Highlights
LinkedIn Economic Graph. (2026). AI labor market update, August 2026. https://delivery-p143253-e1476319.adobeaemcloud.com/adobe/assets/urn:aaid:aem:ef153078-1061-4817-82e7-a1c027d7a7d7/original/as/AI-Labor-Market-Update-August-2026-v2.pdf
Manifold. (2026a). [Will it be common for non-programmers to create small scripts using AI by 2027?] (accessed 9 October 2026). https://manifold.markets/jskf/will-it-be-common-for-nonprogrammer-dfc979ea7fec
Manifold. (2026b). [Will the number of junior developer roles fall by a third by 2030?] (accessed 9 October 2026). https://manifold.markets/OliverKuperman/will-the-number-of-junior-developer
Manifold. (2026c). [Will the number of people employed as software developers in the US fall by more than 15% from 2023 to 2028?] (accessed 9 October 2026). https://manifold.markets/MatthewBarnett/will-the-number-of-people-employed
McAleese, N., Pokorny, R. M., Ceron Uribe, J. F., Nitishinskaya, E., Trebacz, M., & Leike, J. (2024). LLM critics help catch LLM bugs. arXiv:2407.00215. https://arxiv.org/abs/2407.00215
McKinsey & Company. (2025, January). Superagency in the workplace: Empowering people to unlock AI's full potential at work. https://www.mckinsey.com/~/media/mckinsey/business%20functions/quantumblack/our%20insights/superagency%20in%20the%20workplace%20empowering%20people%20to%20unlock%20ais%20full%20potential%20at%20work/superagency-in-the-workplace-empowering-people-to-unlock-ais-full-potential-v4.pdf
MediaNama. (2026, April). [Claude users' accounts suspended after being flagged as minors]. https://www.medianama.com/2026/04/223-claude-users-accounts-suspended-flagged-minors/
Memari, M., & Rudolph, G. (2026). The capability ladder. arXiv:2608.07779. https://arxiv.org/abs/2608.07779
Menlo Ventures. (2025). 2025: The state of generative AI in the enterprise. https://menlovc.com/perspective/2025-the-state-of-generative-ai-in-the-enterprise/
Metal Toad. (2026). 6 levels of AI delegation: A framework for AI management. https://www.metaltoad.com/blog/6-levels-of-ai-delegation-a-framework-for-ai-management
Metaview. (2026). [AI use in hiring interviews]. https://www.metaview.ai/resources/blog/ai-baseline-shopify-memo-hiring-process
METR. (2025, July 10). Measuring the impact of early-2025 AI on experienced open-source developer productivity. https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/
METR. (2026a, February 19). [Five lessons from an AI biology randomised trial]. https://metr.org/blog/2026-02-19-five-lessons-from-ai-biology-rct
METR. (2026b, March 10). Many SWE-bench-passing PRs would not be merged into main. https://metr.org/notes/2026-03-10-many-swe-bench-passing-prs-would-not-be-merged-into-main/
METR. (2026c). Time horizons (dashboard, accessed 9 October 2026). https://metr.org/time-horizons/
METR. (2026d). eval-analysis-public, release time-horizon 1.1, runs.jsonl [Data set]. GitHub. https://github.com/METR/eval-analysis-public (accessed 9 October 2026)
Microsoft. (2025, April 23). 2025: The year the Frontier Firm is born. Work Trend Index. https://www.microsoft.com/en-us/worklab/work-trend-index/2025-the-year-the-frontier-firm-is-born
Microsoft. (2026a, May 5). Agents, human agency and the opportunity for every organization. Work Trend Index 2026. https://www.microsoft.com/en-us/worklab/work-trend-index/agents-human-agency-and-the-opportunity-for-every-organization
Microsoft. (2026b, May 5). How Frontier Firms are rebuilding the operating model for the age of AI. https://blogs.microsoft.com/blog/2026/05/05/how-frontier-firms-are-rebuilding-the-operating-model-for-the-age-of-ai/
MindStudio. (2026, June 11). What is agent literacy? https://www.mindstudio.ai/blog/what-is-agent-literacy-core-skill-ai-builders
n8n. (2026). AI Product Builder [job posting]. https://jobs.ashbyhq.com/n8n/42e72645-d99a-4545-97b7-53ba3a699893
Nature Portfolio. (2026, February 9). [Press release: people using language models for medical scenarios, Nature Medicine]. https://www.natureasia.com/en/info/press-releases/detail/9231
Ng, A. (2026, August 28). The AI engineering skills map in detail: Software engineering fundamentals. The Batch. https://www.deeplearning.ai/the-batch/the-ai-engineering-skills-map-in-detail-software-engineering-fundamentals
OECD. (2026, February). Venture capital investments in artificial intelligence through 2025. https://www.oecd.org/en/publications/venture-capital-investments-in-artificial-intelligence-through-2025_a13752f5-en/full-report.html
OECD & European Commission. (2026, June). [AI literacy framework for primary and secondary education]. https://ailiteracyframework.org/blog/empowering-learners-for-the-age-of-ai-literacy-framework/
O'Neill, N. (2026). [The Product Principal, LinkedIn post]. https://www.linkedin.com/posts/nicholasoneill_the-product-principal-activity-7445921322486009856-hAwj
Ono, A. (2026, June 22). [Defining the roles of humans and AI]. World Economic Forum. https://www.weforum.org/stories/artificial-intelligence/future-of-work-define-roles-humans-ai/
Open Source For You. (2026, February). GitHub weighs pull request kill switch as AI slop floods open source. https://www.opensourceforu.com/2026/02/github-weighs-pull-request-kill-switch-as-ai-slop-floods-open-source/
OpenAI. (2026, June). How agents are transforming work. https://openai.com/index/how-agents-are-transforming-work/
OpenAIRE. (2025, December 9). Zenodo introduces a new way to manage and correct published records. https://www.openaire.eu/zenodo-introduces-a-new-way-to-manage-and-correct-published-records
Oregon State Board of Bar Examiners. (2026, January 26). Supervised Practice Portfolio Examination: First annual report to the Oregon Supreme Court. https://www.osbar.org/_docs/sppe/2025SPPEAnnualReport.pdf
OSF. (2026). Updating registrations; Addressing fear of scooping on OSF preregistrations (help pages, accessed 9 October 2026). https://help.osf.io/hc/en-us/sections/4414482864279-Updating-Registrations ; https://help.osf.io/article/634-addressing-fear-of-scooping-on-osf-preregistrations
Page, M. J., McKenzie, J. E., Bossuyt, P. M., et al. (2021). The PRISMA 2020 statement: An updated guideline for reporting systematic reviews. BMJ, 372, n71. https://doi.org/10.1136/bmj.n71
Park, Y. S., et al. (2026). The work behind delegation: A framework for supervising AI coding agents. arXiv:2609.24234. https://arxiv.org/abs/2609.24234
Paul, R. W. (1947). California gold: The beginning of mining in the Far West. Harvard University Press. https://archive.org/details/in.ernet.dli.2015.177982
Patwardhan, T., et al. (2025). GDPval: Evaluating AI model performance on real-world economically valuable tasks. arXiv:2510.04374. https://arxiv.org/abs/2510.04374
Penrose. (2025). Can LLMs do accounting? [AccountingBench]. https://accounting.penrose.com/ (figures cited as reported by Gigazine, 2025)
Phoenix, J. (2026). [Five levels, gated by verification]. https://understandingdata.com/posts/five-levels-gated-by-verification/
PPC Land. (2026, March 6). The app middle class is dying, and RevenueCat's data shows exactly how fast. https://ppc.land/the-app-middle-class-is-dying-and-revenuecats-data-shows-exactly-how-fast/
Prolific. (2026, July 13). How do I use Prolific's filters? Researcher help centre (accessed 10 October 2026). https://researcher-help.prolific.com/en/articles/445159-how-do-i-use-prolific-s-filters
PwC. (2026). AI Jobs Barometer 2026 (press release). https://www.pwc.com/id/en/media-centre/press-release/2026/english/ai-jobs-barometer-en.html
Reid, B., Wagner, M., d'Amorim, M., & Treude, C. (2022). Software engineering user study recruitment on Prolific: An experience report. RoPES 2022. arXiv:2201.05348. https://arxiv.org/abs/2201.05348
Retool. (2026, February 17). Retool's 2026 Build vs. Buy Report (press release). https://www.businesswire.com/news/home/20260217548274/en/Retools-2026-Build-vs.-Buy-Report-Reveals-35-of-Enterprises-Have-Already-Replaced-SaaS-With-Custom-Software
RevenueCat. (2026). State of subscription apps 2026. https://www.revenuecat.com/state-of-subscription-apps ; https://www.revenuecat.com/sosa-26-insights/
Rogers, E. M. (2003). Diffusion of innovations (5th ed.). Free Press. ISBN 978-0743222099.
Sadki, R. (2026, August 14). [Quotes from the agentic AI summit in Berkeley]. https://redasadki.me/2026/08/14/you-cannot-send-an-ai-agent-to-jail-the-scariest-quotes-from-the-agentic-ai-summit-in-berkeley/
Sarbanes-Oxley Act of 2002, Pub. L. No. 107-204, sections 102 and 104 (15 U.S.C. 7212 and 7214) (United States) (accessed 10 October 2026). https://www.law.cornell.edu/uscode/text/15/7212 ; https://www.law.cornell.edu/uscode/text/15/7214
Savva, N. (2026). Context engineering: A principal-agent theory of AI-augmented knowledge work. SSRN. https://doi.org/10.2139/ssrn.6506600
Search Engine Journal. (2026). Marketers report highest rates of AI brain fry. https://www.searchenginejournal.com/marketers-report-highest-rates-of-ai-brain-fry-report-finds/569110/
SemiAnalysis. (2026, February). Claude Code is the inflection point. https://newsletter.semianalysis.com/p/claude-code-is-the-inflection-point
Serafini, R., Otto, C., Horstmann, S. A., & Naiakshina, A. (2024). ChatGPT-resistant screening instrument for identifying non-programmers. Proceedings of the IEEE/ACM 46th International Conference on Software Engineering (ICSE 2024), 1-13. https://doi.org/10.1145/3597503.3639075
Serafini, R., Weber, N., Yardim, A., Horstmann, S. A., & Naiakshina, A. (2026). Robust methods for developer screening in rapidly evolving AI contexts. Proceedings of the 2026 CHI Conference on Human Factors in Computing Systems (CHI '26), 1-18. https://doi.org/10.1145/3772318.3790302
SF Standard. (2026, March 5). [In AI land, everyone's a builder now]. https://sfstandard.com/2026/03/05/engineer-2025-ai-land-everyone-s-builder-now/
Shao, Y., et al. (2025). Future of work with AI agents: Auditing automation and augmentation potential across the U.S. workforce. arXiv:2506.06576. https://arxiv.org/abs/2506.06576
Shapiro, D. (2026, January). The five levels: From spicy autocomplete to the software factory. https://www.danshapiro.com/blog/2026/01/the-five-levels-from-spicy-autocomplete-to-the-software-factory/
Shopifreaks. (2026a). Meta employees compete on an internal AI token leaderboard called Claudeonomics. https://www.shopifreaks.com/meta-employees-compete-on-an-internal-ai-token-leaderboard-called-claudeonomics-that-tracked-60-trillion-tokens-in-30-days/
Shopifreaks. (2026b). Meta stops grading employees on how much AI they use, dropping token counts and AI Native labels from performance reviews (reporting WIRED, 2 September 2026). https://www.shopifreaks.com/meta-stops-grading-employees-on-how-much-ai-they-use-dropping-token-counts-and-ai-native-labels-from-performance-reviews/
Shopify. (2026). AI usage (candidate guide). https://www.shopify.com/careers/candidate-guide/ai-usage
Simon, H. A. (1971). Designing organizations for an information-rich world. In M. Greenberger (Ed.), Computers, communications, and the public interest (pp. 37-72). Johns Hopkins Press.
Srinivasan, S., & Wei, V. (2026, February 12). To thrive in the AI era, companies need agent managers. Harvard Business Review. https://hbr.org/2026/02/to-thrive-in-the-ai-era-companies-need-agent-managers
Stanford Digital Economy Lab. (2026a, August 12). [Canaries in the coal mine: August 2026 update]. https://digitaleconomy.stanford.edu/news/canariesaug26/
Stanford Digital Economy Lab. (2026b, October 7). Task expansion with generative AI: Experimental evidence on middle-skilled early-career workers. https://digitaleconomy.stanford.edu/publication/task-expansion-with-generative-aiexperimental-evidence-on-middle-skilled-early-career-workers/
Stanford HAI. (2026). AI Index Report 2026, chapter 4: Economy. https://hai.stanford.edu/assets/files/ai_index_report_2026_chapter_4_economy.pdf
Startup Fortune. (2026). Guillermo Rauch says AI agents now trigger more than half of all Vercel deployments. https://startupfortune.com/guillermo-rauch-says-ai-agents-now-trigger-more-than-half-of-all-vercel-deployments/
State Street. (2026). Agentic Product Builder, Senior Associate [job posting]. https://statestreet.wd1.myworkdayjobs.com/en-US/Global/job/Agentic-Product-Builder--Sr-Associate---State-Street-Investment-Managment_R-796094
Stenberg, D. (2026, January 26). The end of the curl bug bounty. https://daniel.haxx.se/blog/2026/01/26/the-end-of-the-curl-bug-bounty/
Stripe. (2026, May 28). Solo founding is at an all-time high: Top performers have these traits in common. https://stripe.com/blog/top-solo-founder-traits
TechCrunch. (2026a, September 24). Lovable's annualized revenue crosses $600M as vibe coding takes off. https://techcrunch.com/2026/09/24/lovables-annualized-revenue-crosses-600m-as-vibe-coding-takes-off/
TechCrunch. (2026b, April 18). The App Store is booming again, and AI may be why. https://techcrunch.com/2026/04/18/the-app-store-is-booming-again-and-ai-may-be-why/
TechCrunch. (2026c, July 30). LinkedIn adds a button to report AI-generated "slop". https://techcrunch.com/2026/07/30/linkedin-adds-a-button-to-report-ai-generated-slop/
TechRepublic. (2025). [Prompt engineering jobs called obsolete]. https://www.techrepublic.com/article/news-prompt-engineering-ai-jobs-obsolete/
The Decoder. (2025, September). AI-generated workslop is costing companies millions and hurting team morale, study finds. https://the-decoder.com/ai-generated-workslop-is-costing-companies-millions-and-hurting-team-morale-study-finds/
The Decoder. (2026, July 12). LinkedIn is the undisputed king of long-form AI slop, according to a study spanning five platforms. https://the-decoder.com/linkedin-is-the-undisputed-king-of-long-form-ai-slop-according-to-a-study-spanning-five-platforms/
The geometry of learning under AI delegation. (2026). [Review of the paper]. https://www.themoonlight.io/fr/review/the-geometry-of-learning-under-ai-delegation
Tikhomirov, S. (2026, September). [The AIDEs framework: levels of delegation in software development]. JetBrains Research. https://blog.jetbrains.com/research/2026/09/aides-framework/
Tomašev, N., Franklin, M., & Osindero, S. (2026). Intelligent AI delegation. arXiv:2602.11865. https://arxiv.org/abs/2602.11865
Tray.ai. (2026). Gartner: Govern vibe coding for citizen developers with self-service platforms [Guide summarising Tyagi, 2026]. https://tray.ai/guides/gartner-govern-vibe-coding/
Turkovic, I. (2026, April 24). [AI job titles in 2026: naming chaos]. https://www.ivanturkovic.com/2026/04/24/ai-job-titles-2026-naming-chaos/
Turner, S. (2026). [An AI biosecurity uplift randomised trial by Scale AI and SecureBio]. https://blog.stephenturner.us/p/ai-biosecurity-uplift-rct
University of Lübeck, Institute for Multimedia and Interactive Systems. (2026). [The cost of convenience: decision horizons, CHI 2026]. https://www.imis.uni-luebeck.de/en/node/11007
Veracode. (2026, July 28). LLMs are getting smarter but not safer: Veracode 2026 GenAI code security report. https://www.veracode.com/news/llms-are-getting-smarter-but-not-safer-veracode-2026-genai-code-security-report-finds-ai-generated-code-security-has-stalled-at-56%25-pass-rate/
Verheul, J. (2026). The principal firm: Organisational form when the agency function is performed by machines. SSRN. https://doi.org/10.2139/ssrn.7235518
Veri', D. (2026). Beyond AI literacy: A structured review and exploratory meta-analysis of measures for competent generative-AI use. arXiv:2609.15624. https://arxiv.org/abs/2609.15624
Virk, Y., & Liu, D. (2025). Non-programmers assessing AI-generated code: A case study of business users analyzing data. VL/HCC 2025. arXiv:2508.06484. https://arxiv.org/abs/2508.06484
Wang, S. (2026). The delegation efficient frontier. SSRN. https://doi.org/10.2139/ssrn.7275801
Washington Monthly. (2026, May 29). [AI and entry-level jobs for college graduates]. https://washingtonmonthly.com/2026/05/29/ai-entry-level-jobs-college-graduates/
White House. (2025, April 23). Advancing artificial intelligence education for American youth. https://www.whitehouse.gov/presidential-actions/2025/04/advancing-artificial-intelligence-education-for-american-youth/
Willison, S. (2025a, February 3). A computer can never be held accountable. https://simonwillison.net/2025/Feb/3/a-computer-can-never-be-held-accountable/
Willison, S. (2025b, June 22). [Kent Beck on skills going to zero and up 1000x]. https://simonwillison.net/2025/Jun/22/kent-beck
Willison, S. (2026a). What is agentic engineering? https://simonwillison.net/guides/agentic-engineering-patterns/what-is-agentic-engineering/
Willison, S. (2026b, February 7). [Vouch]. https://simonwillison.net/2026/Feb/7/vouch/
Writer. (2026). [The AI agent owner]. https://writer.com/blog/ai-agent-owner/
Xinhua. (2025, September 19). [Beijing pupils build AI agents in class]. https://english.news.cn/20250919/740f7bd40ec84b69b9d983e1068a94ac/c.html
Yale Budget Lab. (2026, May 7). AI is probably not (yet) the reason for labor market weakening. https://budgetlab.yale.edu/research/ai-probably-not-yet-reason-labor-market-weakening
Yang, et al. (2026). [How people work with an autonomous search agent]. arXiv:2606.07489. https://arxiv.org/abs/2606.07489
Yegge, S. (2026). Welcome to Gas Town. https://steve-yegge.medium.com/welcome-to-gas-town-4f25ee16dd04
Додаток A. Глосарій
Опорна година. Час, необхідний кваліфікованому спеціалісту для виконання частини роботи вручну, взятий з замороженої банки завдань або отриманий від двох незалежних оцінювачів, які не знають, хто виконав роботу.
Перевірений горизонт делегування. Найбільший розмір роботи в опорних годинах, при якому особа регулярно передає роботу агентам, приймає її і отримує підтвердження від незалежної перевірки, яку агенти не бачили. Оцінюється за доменами за правилом розділу 5.2.
Незалежна перевірка. Приховані тести прийняття, перевірка кваліфікованого людського рецензента, реальне використання призначеними користувачами або модель іншої сім'ї, що перевіряє за джерелами й відрізняється від агентів за даними, доступом і стимулами. Самоперевірка та узгодження між моделями однієї сім'ї не є незалежними перевірками.
Вставлена помилка. Помилка, розміщена в завданні перед передачею, яку особа повинна виявити, це або неправильний запис, або пропуск чогось, що має містити робота. Частина з пропущеною вставленою помилкою не вважається перевіреною, і будь-яка невдача в межах вікна щабля блокує щаблі від Тижня вгору.
Коефіцієнт посилення. Опорні години прийнятої, перевіреної роботи, поділені на години уваги особи протягом останніх 91 дня в домені; невдала робота входить до знаменника, робота з зовнішною допомогою виключена з чисельника.
Стеля посилення. У спрощеній моделі коефіцієнт посилення G для частини з H опорних годин, перевірка якої займає V годин уваги, задовольняє G ≤ H / V, тобто одиниця, поділена на частку часу ручного виконання, яку займає перевірка.
Щаблі. Година (близько 1 опорної години), День (близько 8), Тиждень (близько 40), Місяць (близько 160), Квартал (близько 500). Кількість і вікна правил v1.1: десять частин за 91 день для Години та Дня, шість за 182 дні для Тижня, шість за 365 днів для Місяця (п'ять з них перевірені), три за 365 днів для Кварталу. Для Тижня та вище — щонайменше одна перевірена частина розміру щабля протягом останніх 91 дня.
Запис. Домен · горизонт · посилення · дата, наприклад «бухгалтерія малого бізнесу · День · ×2 · 2026-Q4».
Грамотність прийняття. Навик заздалегідь визначити, що буде вважатися виконаним, а потім показати це доказом, який агент не може сфабрикувати.
Нейтральність походження. Гіпотеза про те, що на рівному перевіреному горизонті в домені освіта в програмуванні не прогнозує якість незалежно перевіреної роботи після врахування командування доменом і грамотності прийняття.
Точка перетину кваліфікацій. Момент у домені, коли продукти людей без ІТ-освіти, прийняті при тих же перевірках, починають випереджати продукти програмістів, які використовують тих же агентів, після чого вимоги до ступеня та звання молодший та старший втрачають прогнозну вагу при найманні. Його компоненти — паритет якості (крок перед), випередження (момент), перетин у постингах (ознака) і нейтральність походження (механізм).
Гарант. Особа, яка підписує продукт, виготовлений іншими, і відповідає за нього перед своїм колом; вимірюється за кількістю продуктів, за які вона поручилася, та скількома вони утримались.
Завершувач. Особа, яка доносить продукт до його користувачів.
Два ринки. Виробництво для себе (грамотність) і робота для інших з наслідками (професія).
Додаток B. Журнал пошуку, 8 та 9 жовтня 2026
Вебпошуки імен та термінів були проведені 8 жовтня 2026 р. кількома помічниками ШІ, які здійснювали пошук незалежно та паралельно, а 9 жовтня 2026 р. одним помічником з розширеним вебпошуком. Кожна відповідь була збережена повністю з її джерелами. Наукові перевірки були проведені 9 жовтня 2026 р., таким чином.
| База | Що вона шукає | Результат для термінів цієї статті |
|---|---|---|
| arXiv (API) | Точна фраза, всі поля | "delegation horizon": 0; "delegation ladder" або "ladder of delegation": 0; "time span of discretion": 0 |
| Semantic Scholar | Заголовок і анотація | Один пошук повернув 0, а іншому було встановлено обмеження швидкості (HTTP 429); повинен бути повторений перед подачею |
| OpenAlex | Заголовок, анотація, деякий повний текст | "credential crossover": 0; "agentwright": тільки неповязані збіги; "background neutrality": неповязано; "acceptance literacy": робота тільки про прийняття технології |
| Crossref | Метадані, включаючи анотації SSRN | "principal" як професія: тільки теорія агентства |
| Europe PMC | Відкриті повні тексти | Немає точних збігів |
| Zenodo | Записи і описи | Немає збігів для жодного терміну |
| DOAJ | Журнали відкритого доступу | "delegation horizon": чотири неповязані збіги |
| Google Scholar | Повні тексти, SSRN | "delegation horizon": 6, використовується в статтях 2026 р. для машин або фірм (Khadj, 2026; Alonso, 2026); "verified delegation horizon", "credential crossover", "credential crossover point" та "agentwright": 0 (повторено 9 жовтня 2026 р. без помилок); "acceptance literacy", "background neutrality" та "amplification gain": збіги тільки в інших значеннях |
| DBLP; сторінки SSRN | Заблоковано захистом від ботів (DBLP) або повернено 403 (SSRN); охоплено через Crossref і Scholar |
Попередні прогнози були знайдені на Metaculus, Manifold, Good Judgment Open, Kalshi, Polymarket і Long Bets, а також у відкритій мережі; Metaculus і деякі сторінки Gartner повернули HTTP 403 і були прочитані через архівовані або перевидані копії, де було доступно. Результати узагальнено в розділі 11.3. Звітування відповідає пункту 6 PRISMA 2020 (Page et al., 2021): кожна база та дата останнього доступу наведені в списку. Збіг, який не знайдено, повідомляється як не знайдений на ту дату, і жодних тверджень не робиться щодо баз, які не були розшукані.
Додаток C. Вимірювальний інструмент
Цей додаток містить дослідницький прилад, формат запису та оцінювач зі стандартної бібліотеки Python під ліцензією MIT. Він показує, як правила розділу 5.2 стають кодом. Це не застосунок і не приймає жодних рішень про жодну особу, крім обчислення двох чисел на основі записів, які надає особа чи дослідник. Він не оцінює, чи була перевірка обрана вдало; він довіряє наданим йому полям. Зокрема, він не тестує незалежність. З трьох умов розділу 5.2 (дані, доступ та стимули) він читає лише вид перевірки та те, чи бачили її агенти, а саму незалежність підтверджує випадковий аудит таблиці 3.
C1. Запис
Один рядок файлу JSON Lines записується для кожної роботи, переданої агентам, коли роботу прийнято, відхилено або залишено. Дата початку передачі записується в поле started, як передбачено правилами v1.1; оцінювач все ж читає рядки без нього та попереджує. Роботи, які не пройшли перевірку або були залишені, залишаються в журналі.
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-10", "date": "2026-09-14",
 "reference_hours": 8, "reference_basis": "two raters",
 "attention_minutes": 95, "mode": "stages",
 "check": "expert", "agent_saw_check": false, "passed": true,
"irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}| Поле | Значення |
|---|---|
| person | Псевдонімна позначка, ніколи справжнім ім'я |
| domain | Сфера, в якій роботу прийнято |
| date | Дата прийняття, відхилення або припинення при записуванні рядка (формат ISO) |
| started | Дата початку передачі (формат ISO); очікується від правил v1.1, не пізніше за дату |
| reference_hours | Кількість годин ручної роботи кваліфікованого фахівця для всього матеріалу |
| reference_basis | Джерело довідки: названий банк завдань або два експерти |
| attention_minutes | Хвилини особи, витрачені на планування, інструктування, читання, перевірку та виправлення |
| mode | one_piece, stages або together (one_piece враховується в частці директиви розділу 5.7) |
| check | hidden_tests, expert, real_use, other_family_with_sources, same_family, self_review або none |
| agent_saw_check | Чи могли агенти бачити перевірку (повинна бути false для зарахування) |
| passed | Чи пройшла перевірка (false для невдалих або припинених матеріалів) |
| irreversible | Чи помилка в цьому виді роботи необоротна (такий матеріал повинен пройти перевірку) |
| planted_errors | Скільки помилок було навмисно внесено в завдання перед передачею |
| planted_missed | Скільки з них особа не виявила (будь-який промах робить матеріал непідтвердженим та блокує Week та вищі рівні в вікні) |
| outside_help | Чи колега або підрядник допомагав поза записом (такий матеріал нічого не додає до чисельника прибутку) |
| task_id, model, tools | Додатково: ідентифікатор банку завдань, агенти та моделі, які використовуються, та їх інструменти (розділ 5.4) |
| checker | Додатково: хто або що запустив перевірку, як роль, ніколи справжнім ім'я |
| rater_hours | Додатково: оцінки експертів, що лежать в основі reference_hours; якщо є дві оцінки і більша перевищує меншу більш ніж в 1,5 рази, оцінювач виводить «потрібен третій експерт» (таблиця 3); з третьою оцінкою медіана вирішує та прапор не друкується |
| audit | Додатково: none, passed або failed, результат другої, незалежної перевірки; невдалий аудит робить матеріал непідтвердженим |
| revoked | Додатково: true, якщо відстрочений результат скасував матеріал (таблиця A4); скасований матеріал є непідтвердженим |
C2. horizon.py
Код нижче реалізує правила v1.1 і є побайтово ідентичним файлу horizon.py у супровідному репозиторії.
#!/usr/bin/env python3
"""horizon.py: score the verified delegation horizon and the amplification gain.

Teaches: how the rules of Section 5.2 turn a log of work handed to agents into a dated record
"domain . horizon . gain . quarter". Limits: it trusts the fields it is given; it does not
judge whether a check was well chosen or whether the reference hours are fair.
Usage: python3 horizon.py work-log.jsonl --as-of 2026-10-09 [--stable]   Rules v1.1   Licence: MIT
"""
import argparse
import datetime as dt
import json
import math
import sys
import statistics
from collections import Counter, defaultdict

# rung, reference hours, minimum pieces, window in days (provisional; Section 5.8)
RUNGS = [("Quarter", 500.0, 3, 365), ("Month", 160.0, 6, 365), ("Week", 40.0, 6, 182),
         ("Day", 8.0, 10, 91), ("Hour", 1.0, 10, 91)]
PLANTED_FROM = 40.0         # from Week upward a planted error must be in the window
GAIN_STEPS = [60, 20, 5, 2, 1]
GAIN_WINDOW = 91            # gain, directive share and the recent piece of upper rungs (91 days)
PASS_SHARE = 0.8            # 8 of 10; every irreversible piece must pass
INDEPENDENT = {"hidden_tests", "expert", "real_use", "other_family_with_sources"}
RATER_SPREAD = 1.5          # raters further apart than this need a third rater
CHECKS = INDEPENDENT | {"same_family", "self_review", "none"}
MODES = {"one_piece", "stages", "together"}
KEYS = {"person", "domain", "date", "reference_hours", "reference_basis",
        "attention_minutes", "mode", "check", "agent_saw_check", "passed", "irreversible",
        "planted_errors", "planted_missed", "outside_help"}
OPTIONAL = {"started",      # date the hand-over started (expected from v1.1; the line is written at close)
            "task_id", "model", "tools", "checker", "rater_hours", "audit", "revoked"}


def load(path):
    """Every piece handed to agents is a line, including failed and abandoned ones."""
    records, undated = [], 0
    with open(path, encoding="utf-8") as fh:
        for n, line in enumerate(fh, 1):
            if not line.strip():
                continue
            r = json.loads(line)
            if set(r) - OPTIONAL != KEYS:
                sys.exit(f"line {n}: unknown {sorted(set(r) - KEYS - OPTIONAL)}, missing {sorted(KEYS - set(r))}")
            if r["check"] not in CHECKS or r["mode"] not in MODES:
                sys.exit(f"line {n}: check or mode is not one of the allowed values")
            if float(r["reference_hours"]) <= 0 or float(r["attention_minutes"]) < 0:
                sys.exit(f"line {n}: reference hours must be positive, minutes not negative")
            if not 0 <= int(r["planted_missed"]) <= int(r["planted_errors"]):
                sys.exit(f"line {n}: planted_missed must lie between 0 and planted_errors")
            if not isinstance(r["outside_help"], bool) or not isinstance(r.get("revoked", False), bool):
                sys.exit(f"line {n}: outside_help and revoked must be true or false")
            if r.get("audit", "none") not in {"none", "passed", "failed"}:
                sys.exit(f"line {n}: audit must be none, passed or failed")
            if "rater_hours" in r and (len(r["rater_hours"]) < 2 or min(map(float, r["rater_hours"])) <= 0):
                sys.exit(f"line {n}: rater_hours needs two or more positive estimates")
            undated += "started" not in r
            r["date"] = dt.date.fromisoformat(r["date"])
            if "started" in r and dt.date.fromisoformat(r["started"]) > r["date"]:
                sys.exit(f"line {n}: started must not be later than date")
            records.append(r)
    if undated:
        print(f"warning: {undated} lines without started (expected from rules v1.1)", file=sys.stderr)
    return records


def verified(r):
    """A pass counts only if the check was independent, the agents never saw it, no planted error
    was missed, nobody helped off the log, no audit failed and no delayed outcome revoked it.
    Another model family alone never verifies irreversible work."""
    return (r["passed"] is True and r["check"] in INDEPENDENT and r["agent_saw_check"] is False
            and int(r["planted_missed"]) == 0 and not r["outside_help"]
            and not (r["irreversible"] and r["check"] == "other_family_with_sources")
            and r.get("audit") != "failed" and not r.get("revoked", False))


def rung_holds(pieces, hours, minimum, as_of, days):
    start = as_of - dt.timedelta(days=days)
    window = [r for r in pieces if start < r["date"] <= as_of]
    big = [r for r in window if float(r["reference_hours"]) >= hours]
    if len(big) < minimum:
        return False
    if sum(map(verified, big)) / len(big) < PASS_SHARE:
        return False
    if any(r["irreversible"] and not verified(r) for r in big):   # strict rule, these pieces only
        return False
    if hours >= PLANTED_FROM:
        if not any(int(r["planted_errors"]) > 0 for r in big):
            return False
        if any(int(r["planted_missed"]) > 0 for r in window):   # any missed planted error blocks
            return False
    if days > GAIN_WINDOW:                                       # quarterly re-verification
        recent = as_of - dt.timedelta(days=GAIN_WINDOW)
        if not any(verified(r) and r["date"] > recent for r in big):
            return False
    return True


def horizon(pieces, as_of):
    for name, hours, minimum, days in RUNGS:        # from the top rung down
        if rung_holds(pieces, hours, minimum, as_of, days):
            return name
    return "below Hour"


def rung_pieces(pieces, name, as_of):
    """Pieces of the rung's size in its window (Hour's for 'below Hour'): what the count is out of."""
    _, hours, _, days = next(r for r in RUNGS if r[0] == name or (name == "below Hour" and r[0] == "Hour"))
    return [r for r in pieces if as_of - dt.timedelta(days=days) < r["date"] <= as_of
            and float(r["reference_hours"]) >= hours]


def gain(pieces):
    done = math.fsum(float(r["reference_hours"]) for r in pieces
                     if verified(r) and not r["outside_help"])            # outside help excluded
    spent = math.fsum(float(r["attention_minutes"]) for r in pieces) / 60.0   # failures included
    return None if spent == 0 else done / spent


def step(g):
    if g is None:
        return "n/a"
    for s in GAIN_STEPS:
        if g >= s:
            return f"x{s}"
    return "below x1"


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("log")
    ap.add_argument("--as-of", default=dt.date.today().isoformat())
    ap.add_argument("--stable", action="store_true", help="also score 91 days earlier and label the rung")
    args = ap.parse_args()
    as_of = dt.date.fromisoformat(args.as_of)
    longest = max(days for *_, days in RUNGS) + (GAIN_WINDOW if args.stable else 0)
    groups = defaultdict(list)
    for r in load(args.log):
        if as_of - dt.timedelta(days=longest) < r["date"] <= as_of:
            groups[(r["person"], r["domain"])].append(r)
    quarter = f"{as_of.year}-Q{(as_of.month - 1) // 3 + 1}"
    recent_start = as_of - dt.timedelta(days=GAIN_WINDOW)
    for (person, domain), pieces in sorted(groups.items()):
        recent = [r for r in pieces if r["date"] > recent_start]
        g = gain(recent)
        shown = "n/a" if g is None else f"{g:.2f}"
        failed = sum(1 for r in recent if not verified(r))
        directive = (sum(r["mode"] == "one_piece" for r in recent) / len(recent)) if recent else 0.0
        rung = horizon(pieces, as_of)
        counted = rung_pieces(pieces, rung, as_of)
        label = ""
        if args.stable:
            before = horizon(pieces, as_of - dt.timedelta(days=GAIN_WINDOW))
            label = " stable" if before == rung else f" provisional (was {before})"
        print(f"{person}: {domain} . {rung} ({sum(map(verified, counted))}/{len(counted)}){label}"
              f" . {step(g)} . {quarter}  (pieces in last 91 days: {len(recent)}, not verified: {failed};"
              f" gain {shown}; directive share {directive:.0%})")
        kinds = Counter(r["check"] for r in counted).most_common()
        sizes = [float(r["reference_hours"]) for r in recent if r["passed"]]
        median = f"{statistics.median(sizes):.1f} h" if sizes else "n/a"
        spread = any(max(map(float, r["rater_hours"])) / min(map(float, r["rater_hours"])) > RATER_SPREAD
                     for r in pieces if len(r.get("rater_hours", [])) == 2)   # with three, the median decided
        print(f"  checks: {', '.join(f'{k} {v}' for k, v in kinds) or 'none'};"
              f" median accepted size {median}{'; needs third rater' if spread else ''}")


if __name__ == "__main__":
    main()
C3. brier.py
#!/usr/bin/env python3
"""brier.py: score dated predictions by the Brier rule.

Teaches: why one missed prediction made at 35% says little on its own, and why 'unresolved' is
never a success. Input CSV columns: id,probability,outcome (outcome: 1, 0 or unresolved).
Usage: python3 brier.py predictions.csv                                  Licence: MIT
"""
import csv
import sys


def main(path):
    resolved, pending = [], []
    with open(path, newline="", encoding="utf-8") as fh:
        for row in csv.DictReader(fh):
            p = float(row["probability"])
            if not 0.0 <= p <= 1.0:
                sys.exit(f"{row['id']}: probability must lie between 0 and 1")
            outcome = row["outcome"].strip().lower()
            if outcome in ("0", "1"):
                resolved.append((row["id"], p, int(outcome)))
            else:
                pending.append(row["id"])
    for pid, p, o in resolved:
        print(f"{pid}: p={p:.2f} outcome={o} score={(p - o) ** 2:.3f}")
    if resolved:
        mean = sum((p - o) ** 2 for _, p, o in resolved) / len(resolved)
        print(f"Brier score over {len(resolved)} resolved: {mean:.3f} (always saying 0.5 gives 0.250)")
    print("unresolved or not yet due: " + (", ".join(pending) or "none"))


if __name__ == "__main__":
    main(sys.argv[1])
C4. Розв'язаний приклад
Журнал нижче містить десять одиниць бухгалтерської роботи, розподілених агентам однією особою з липня по вересень 2026 року.
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-07-17", "date": "2026-07-20", "reference_hours": 9, "reference_basis": "two raters", "attention_minutes": 95, "mode": "stages", "check": "expert", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-07-24", "date": "2026-07-28", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 80, "mode": "stages", "check": "hidden_tests", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-07-29", "date": "2026-08-04", "reference_hours": 12, "reference_basis": "two raters", "attention_minutes": 150, "mode": "one_piece", "check": "expert", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-09", "date": "2026-08-11", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 70, "mode": "stages", "check": "self_review", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-13", "date": "2026-08-18", "reference_hours": 10, "reference_basis": "two raters", "attention_minutes": 110, "mode": "together", "check": "real_use", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-21", "date": "2026-08-25", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 120, "mode": "stages", "check": "expert", "agent_saw_check": false, "passed": false, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-24", "date": "2026-09-01", "reference_hours": 16, "reference_basis": "two raters", "attention_minutes": 180, "mode": "one_piece", "check": "hidden_tests", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-05", "date": "2026-09-08", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 60, "mode": "stages", "check": "expert", "agent_saw_check": false, "passed": true, "irreversible": true, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-11", "date": "2026-09-15", "reference_hours": 9, "reference_basis": "two raters", "attention_minutes": 90, "mode": "together", "check": "other_family_with_sources", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-27", "date": "2026-09-29", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 75, "mode": "stages", "check": "hidden_tests", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
Запуск python3 horizon.py work-log.jsonl --as-of 2026-10-09 виводить запис та рядок про перевірки за ним:
P07: small-business bookkeeping . Day (8/10) . x2 . 2026-Q4  (pieces in last 91 days: 10, not verified: 2; gain 4.66; directive share 20%)
  checks: expert 4, hidden_tests 3, self_review 1, real_use 1, other_family_with_sources 1; median accepted size 9.0 h
Усі десять фрагментів мають принаймні 8 референтних годин. Два не враховуються як верифіковані: один перевірений лише самоперевіркою, а один не пройшов експертну перевірку. Вісім з десяти — це точно та доля, яку вимагає Day, і один необоротний фрагмент пройшов, тому щабель — це Day. Week недосяжна, оскільки жоден фрагмент не досягає 40 годин. Верифіковані фрагменти становлять 80 референтних годин, порівняно з 1030 хвилинами (близько 17,2 годин) уваги, витраченої на всі десять, включаючи невдачі, що дає прибуток 4,66 і крок ×2. Жодний фрагмент не містив посаджених помилок або зовнішної допомоги, тому жодне з цих правил не змінює результат. Якби невдалий фрагмент був виключений з журналу, щабель спирався б на дев'ять фрагментів і не пройшов б підрахунок десяти, саме тому невдачі належать до запису. Підрахунок поруч зі щаблем, 8/10, показує, наскільки близький був вердикт (Додаток E), а другий рядок дає типи перевірки за рахованими фрагментами та медіанний прийнятий розмір, 9,0 годин, щоб читач міг побачити, чи спирається горизонт на фрагменти, які трохи перевищують поріг (Таблиця 3). Увага особи, 1030 хвилин, становить близько 18% від 96 референтних годин, переданих, і близько 21% від 80, які були верифіковані. Запис для резюме читається як "бухгалтерія малого бізнесу · Day · ×2 · 2026-Q4".
Інструмент-супутник tools/explain.py виводить причини того ж самого вердикту за тими ж правилами. Вісім з десяти фрагментів розміру Day верифіковані, і потрібні вісім, підрахунок узгоджується з істинною частотою проходження від 44% до 97% (Розділ 5.8), тому жоден додатковий невдалий фрагмент цього розміру не може бути поглинутий. Якщо нічого нового не буде записано, Day тримається до 18 жовтня 2026 року; 19 жовтня фрагмент, закритий 20 липня, залишає вікно 91 дня, і залишаються дев'ять фрагментів розміру Day, один не вистачає для десяти, які потрібні Day. Для Week він перераховує всі умови, що залишилися: шість фрагментів принаймні 40 годин протягом 182 днів, один з них з посадженими помилками і один верифікований за останні 91 день.
Побудований журнал також містить слід, який називає Таблиця 3: п'ять з його десяти фрагментів були оцінені рівно в 8 годин, поверхня Day, і tools/too_clean.py позначає його як "спочатку аудит", зі слідом "5 з 10 фрагментів розташовані прямо над порогом щабля". Прапор відправляє журнал на аудит і не вирішує нічого про нього; медіана 9,0 годин поруч зі щаблем показує те ж саме читачу.
C5. Супутній репозиторій
Супутній репозиторій (https://github.com/vadimchernets/delegation-horizon) містить інструмент і матеріали, які дозволяють читачам використовувати кожну частину статті. Основні файли за розділами:
| Розділ | Файли | Що вони роблять |
|---|---|---|
| 5.2, C1 to C4 | horizon.py, log.schema.json, examples/ |
Оцінювач, схема одного рядка журналу, опрацьований приклад і рядки, які він повинен вивести |
| 5.2, 5.3 | tools/log_piece.py, record_card.py, checker.html |
Написання журналу шляхом відповіді на запитання, картка запису з підрахунком за щаблем та те ж саме оцінювання на автономній сторінці браузера; обидва читають електронну таблицю, збережену з комами або з крапками з комою |
| 5.2, 5.8, C4 | tools/explain.py |
Чому журнал отримує свій щабель: кожна умова, яка виконується або не виконується, люфт, день, коли щабель закінчується, якщо нічого нового не буде записано, і що потрібно наступному щаблю |
| 5.1 | tools/reference_hours.py, kits/reference-hours-raters.md |
Референтні години від оцінок оцінювачів та як вибрати, прийняти та інформувати оцінювачів |
| 5.8, Table 3 | audit_sample.py, tools/too_clean.py, tools/planted.py, kits/ |
Відтворюваний зразок аудиту, прапори для журналів, які виглядають занадто чисто, посаджені помилки опечатані перед передачею та оцінені за видом (невірна запис або пропуск), керівництва з аудиту та посаджених помилок |
| 6.2, 10.3 | tools/verify_record.py |
Приймаюча сторона портативного запису: чи є журнал, надісланий з ним, файл, який був оцінений, чи такий самий оцінювач, і чи повторне оцінювання дає той же запис, поле за полем |
| 6.2 | kits/trade-screen.md, tools/gate_leak.py |
Прийняття людей за питанням торгівлі замість етикетки та скільки витікає етикетка, з точним інтервалом (11 з 60 у Додатку G2: 9,5% до 30,4%) |
| 6.5, 10.5 | kits/checking-process.md, kits/process-vs-experience-study.md, tools/process_study.py |
Чотири кроки Розділу 6.5 та те, що кожен отримує за правилом (Рисунок A4), та порівняння Розділу 10.5 як протоколу для реєстрації, з його аналізом, невірні записи та пропуски окремо |
| 5.8, Appendix E | pilot/ |
Настільний тест порогів, банк 30 завдань, протокол калібрування з його реєстраційним текстом і формою згоди |
| Appendix G2 | pilot/ |
Зареєстрований аналіз human_raters.py, поданий на OSF, перетворення експортів Prolific, скрипт, який друкує Таблицю G2 з зареєстрованими функціями, порівняння скринінгу та синтетичний експорт для їх запуску |
| 7.2 | templates/, tools/guarantor_record.py |
Карточка завдання для банку завдань, журнал гаранта та запис гаранта, обчислений на його основі: продукти, за які ручаються, скільки прожили 6 і 12 місяців, невдачі за серйозністю |
| 11, Tables 4 and A6, C3 | predictions/, brier.py, tools/power.py |
41 передбачення, як зареєстровані, з маніфестом їх хешів, поданим на OSF, правила та файли розширення, інструменти оцінювання, які записують передбачення набору B, не проведене, і повідомляють оцінку Брієра як без нього, так і з ним оцінене як неправильне (Розділ 11.2), та розміри вибірок з Розділу 11.2 |
| 11, Set B | predictions/set_b.py |
Заморожені правила, які стали істинними та не були правилами з дев'яти передбачень набору B, написаних на інтервалі, застосовані до оцінок дослідження |
| 11.4, F27 | kits/f27-sample.md, tools/freeze_sample.py, tools/liveness.py |
Протокол та розіграш зразка F27 (закритий пул зареєстрований спочатку, ключ узятий потім з публічного маяка випадковості), заморожений на Zenodo та його хеш зареєстрований на OSF до 31 грудня 2026 року, та його живість на кожну дату оцінювання за словами F27 |
| C2 to C4, Tables 4 and A6 | tools/paper_sync.py |
Перевіряє цей текст у репозиторії: лістинги байт за байтом, опрацьований приклад та його результат, таблиці передбачень, кількості наборів, кожен названий файл та кожна вбудована фігура |
| Додаток D, Додаток F | figures/ |
Скрипти, які малюють Figure A1 із таблиці передбачень та Figure A4 із правил оцінювача |
Ті ж файли за читачем:
| Читач | Почніть з | Що це дає |
|---|---|---|
| Людина, яка передає роботу агентам | templates/work-log.csv, record_card.py або checker.html, tools/explain.py |
Журнал, ведений у електронній таблиці, запис та його картка, а також те, що потрібно наступному ступеню |
| Працедавець або команда HR | kits/hiring-test/, kits/trade-screen.md, kits/scope-statement.md, tools/explain.py |
Оплачувана однодневна робоча перевірка зі сліпим оцінювачем, запитання про ремесло замість позначки, те, що ступень каже та не каже, і наскільки близко був вердикт кандидата |
| Новачок у ремеслі | kits/checking-process.md, kits/acceptance-card.md, kits/planted-errors-guide.md |
Кроки Section 6.5 та те, що кожен дає, "done" вказано перед передачею, та практика на посаджених пропусках |
| Аудитор або гарант | audit_sample.py, tools/too_clean.py, tools/planted.py, kits/audit-checklist.md |
Зразок для повторної перевірки, сліди журналу, який виглядає занадто чистим, посаджені помилки, чия печатка показує, чи був змінений список |
| Дослідник | pilot/, kits/matched-task-study.md, kits/process-vs-experience-study.md, tools/power.py, predictions/ |
Кабінетний тест, дослідження оцінювача та їхні скрипти, протоколи для порівнянь, розміри вибірки, та зареєстровані передбачення з їхніми інструментами оцінювання |
Додаток D. Текст реєстрації прогнозів (OSF)
Назва. Датовані прогнози щодо роботи через AI-агентів, 2026–2031: заморожені прогнози та щорічна оцінка.
Тип. Open-Ended Registration, публічно відразу, без ембарго.
Резюме. Ця реєстрація закріплює датовані прогнози, викладені в "After the Programmer Divide: One Measure for People Who Build Through AI Agents" (SSRN 7589918; Zenodo DOI 10.5281/zenodo.23267266). Приєднана таблиця наводить для кожного прогнозу: його формулювання; його вимір; публічне джерело та резервне джерело; базову лінію 2025 або 2026 року з датою доступу та архівованою копією; дату перевірки та кінцеву дату; ймовірність, фіксовану на дату цієї реєстрації; та пороги для трьох результатів: справдилися, не справдилися, невирішені.
Оцінювання. Кожен прогноз оцінюється під час першої щорічної перевірки на або після його дати перевірки, коли дані існують, та не пізніше його кінцевої дати. Вирішені прогнози оцінюються за правилом Brier. Прогноз без порівнювальних даних до його кінцевої дати записується як невирішений і не зараховується як успіх.
Набори та ймовірності. Набір A розв'язується з публічних даних та файлів у predictions/resolve/, чиї хеші SHA-256 перелічені в цій реєстрації. Набір B розв'язується лише з досліджень, зареєстрованих окремо до збирання даних; прогноз набору B, чий протокол не зареєстрований до 30 червня 2027 року, записується як невиконаний, як невдача тестової програми; оцінка Brier повідомляється як над вирішеними прогнозами, так і з кожним прогнозом, що не проводився, оціненим як неправильний. Ймовірності обумовлені розв'язанням. Вони представляють медіану трьох незалежних прогнозів моделей, зібраних 9 жовтня 2026 року (Claude Opus, модель OpenAI та Gemini), прийнятих автором; раніші об'єднані прогнози чотирьох моделей додані для довідки.
Точка переходу. F2, F3, F5 та F7 вимірюються в одних і тих же названих доменах: ведення обліку малого бізнесу та юридичні та маркетингові документи, два непрограмні домени банку завдань (Додаток E); для аналога розмішень F5 вони відображаються на SOC 43-3031, 23-2011 та 13-1161. Третій домен банку, невеликі внутрішні веб-інструменти, є рідною областю програмістів і не є доменом переходу. Точка переходу в домені — це перший рік, в якому F3 та аналог домену F5 обидва досягаються в тому самому названому домені; жодна з них окремо цього не сигналізує.
Додатки оцінювання. Кожна таблиця рейтингу також повідомляє частку вирішених, оцінку Brier за набором та за сімейством, найгіршу межу, яка оцінює прострочені невирішені прогнози як неправильні, та оцінку навичок Brier щодо 0,5, об'єднаних прогнозистів моделей та ринкових цін.
Щорічні перевірки. Кожного року з 2027 по 2031, в річницю цієї реєстрації, автор публікує таблицю рейтингу, яка охоплює кожен прогноз, зареєстрований тут. Кожна таблиця рейтингу сама зареєстрована на OSF, пов'язана з цією реєстрацією за DOI, та розміщена на Zenodo.
Фіксовані правила. Жоден прогноз не видаляється, не переформулюється та не отримує нову дату. Все, що додано пізніше, зареєстровано окремо та має власну дату. Якщо назване джерело припиняє публікацію або змінює свій метод, використовується резервне джерело, за умови що воно вимірює той же показник; якщо не існує порівнювального джерела, прогноз залишається невирішеним.
Незалежна перевірка. Кожна таблиця рейтингу перевіряється проти правил, закріплених тут, моделями з щонайменше двох різних сімейств. У випадках, коли вони не згодні, правило вирішує та розбіжність повідомляється. Людський арбітр, призначений автором перед першою таблицею рейтингу, вирішує суперечки між двома сімействами моделей.
Власні дані. Прогнози, які спираються на дані когорти автора, тестуються лише під окремою передреєстрацією, поданою до збирання цих даних, як це робить програма, зареєстрована на OSF (DOI 10.17605/OSF.IO/X4EGQ), для кожної когорти.
Конфлікти інтересів. Як вказано в статті.
Файли. Таблиця прогнозів (CSV та таблиця A6 приєднаної статті); список архівованих копій; predictions/resolve/ (заморожені запити, списки та кодекс, з хешами); resolution-rules.md; changelog-v1-v2.md.
Приєднана таблиця прогнозів — це таблиця A6, а рисунок A1 зображує її календар.
Рисунок A1. Календар перевірок, 2026–2031.
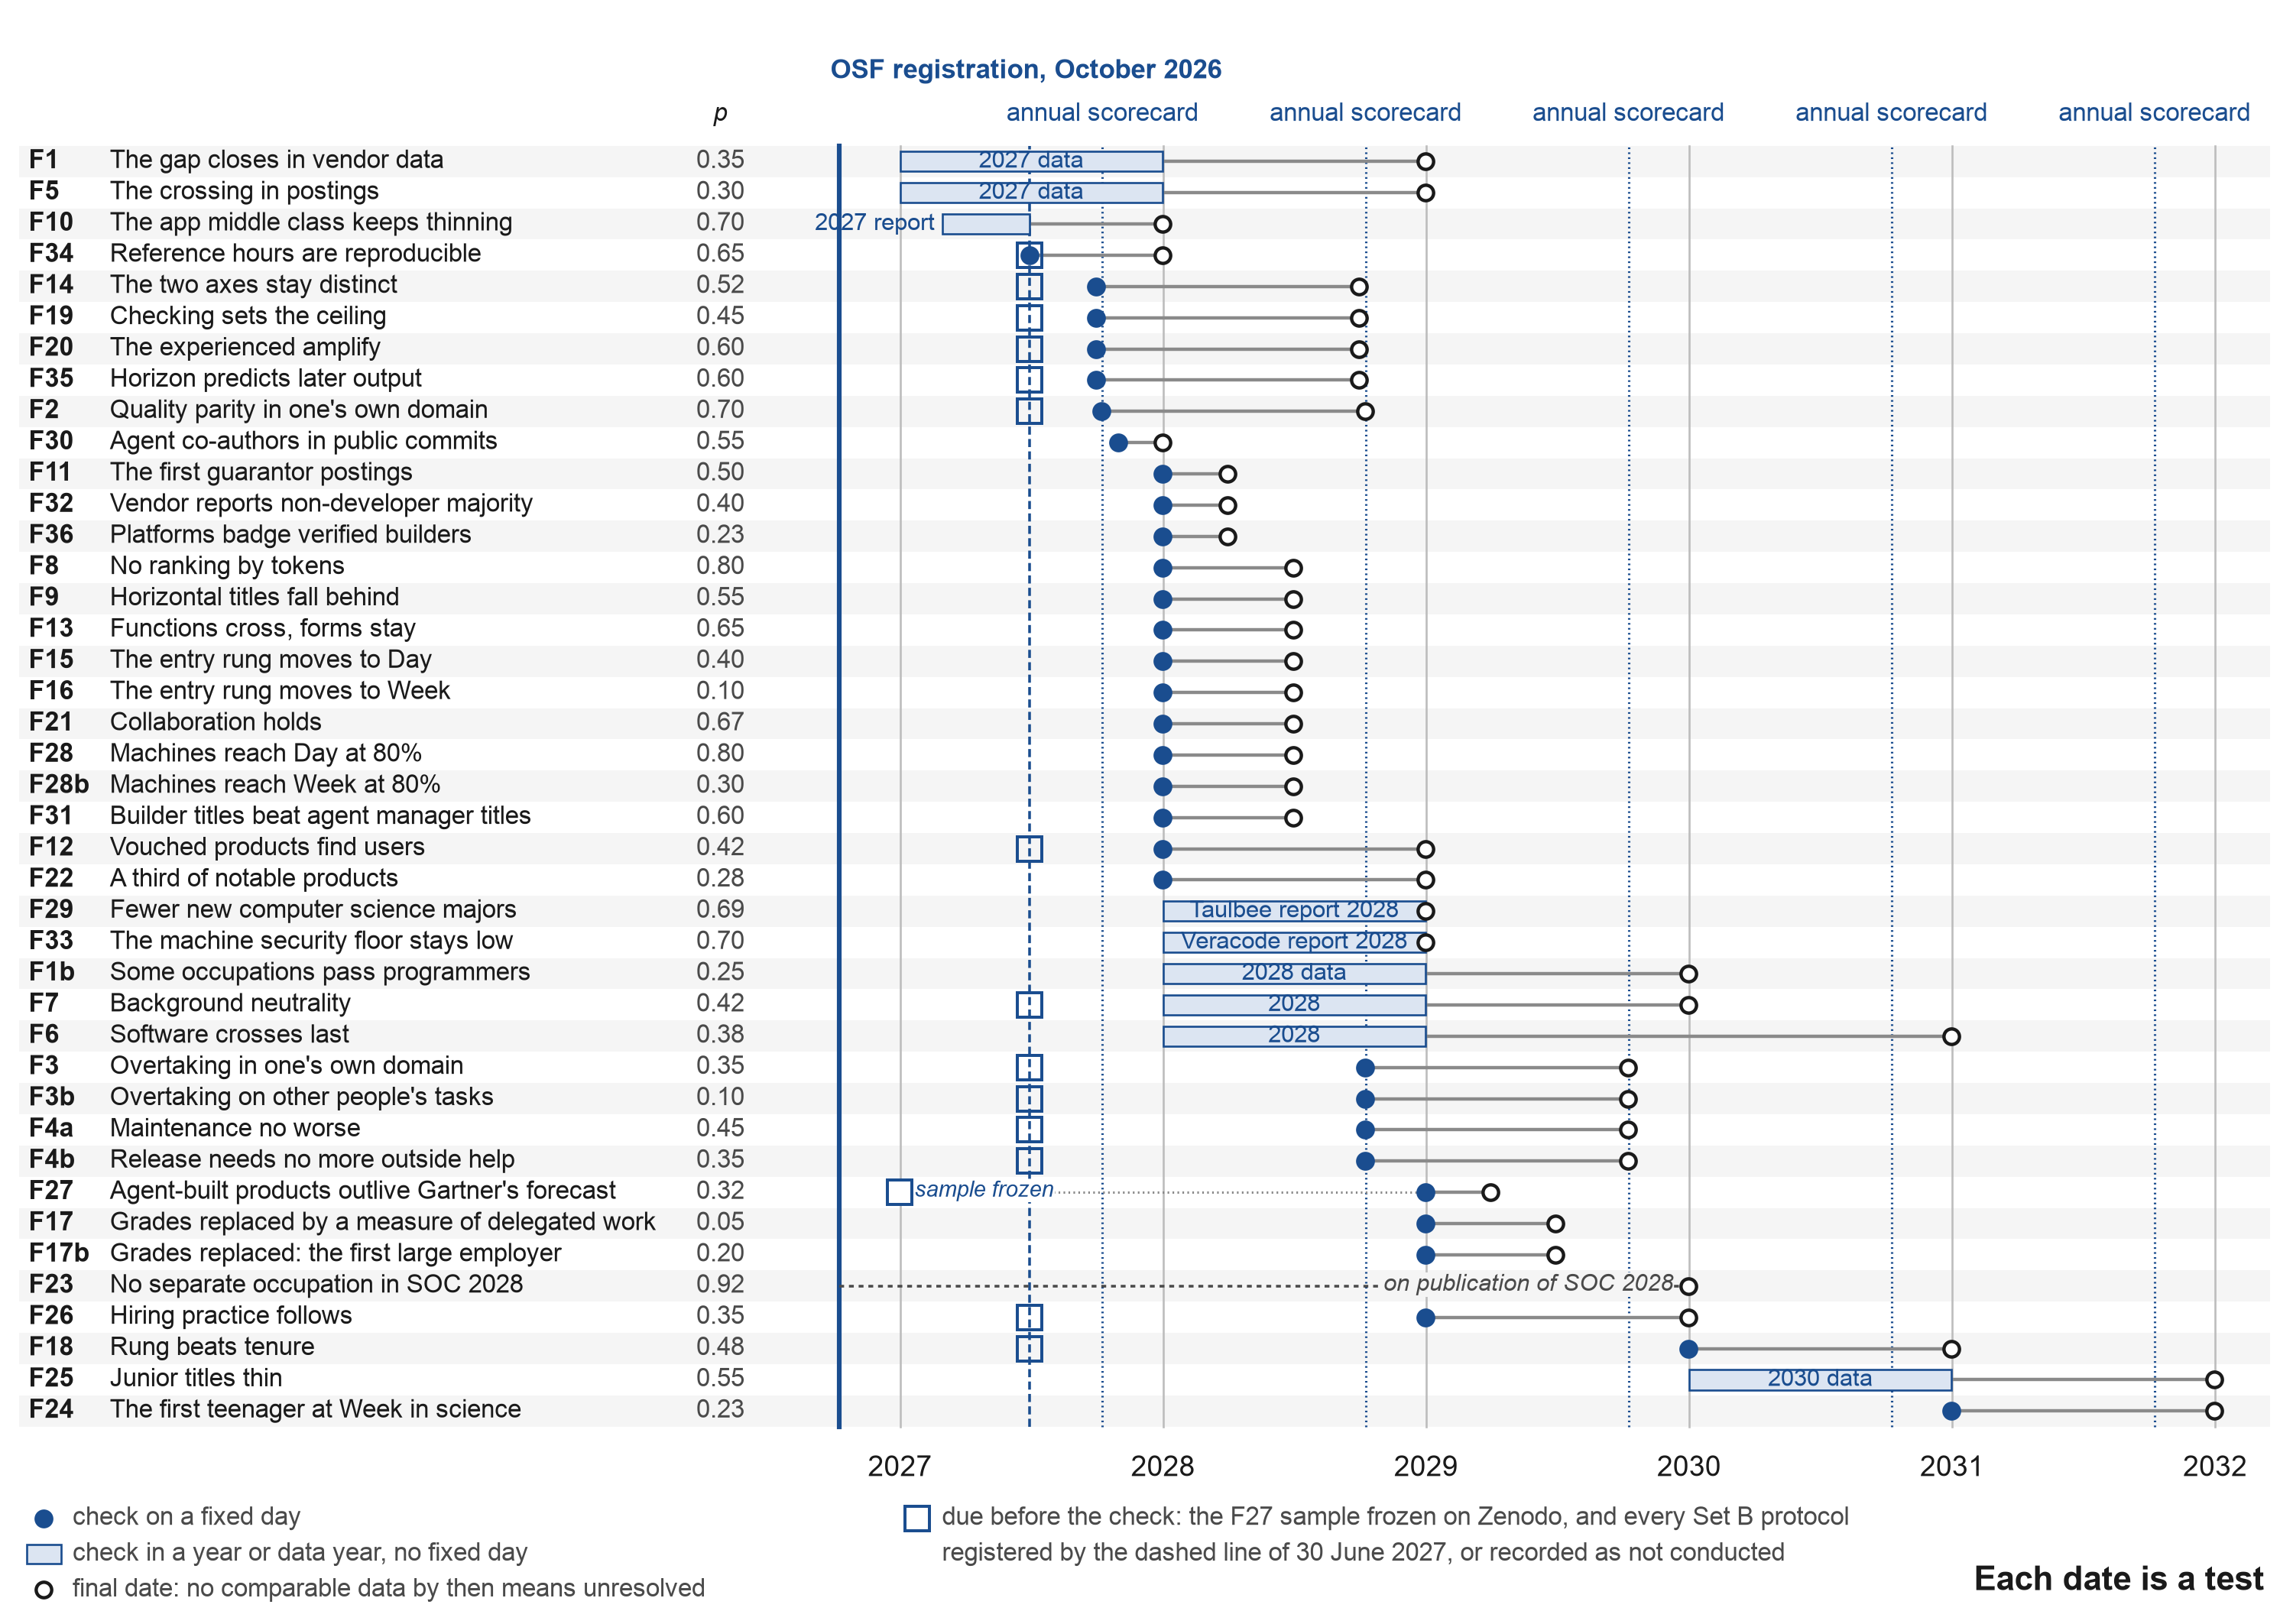
Примітка: Один рядок на кожен прогноз таблиці A6, відсортований за датою перевірки, з його ймовірністю. Заповнена крапка — це перевірка на фіксований день. Світла смуга — це перевірка в році або році даних без фіксованого дня. Кільце — це кінцева дата, після якої прогноз без порівнювальних даних записується як невирішений (розділ 11.4). Пунктирні лінії позначають щорічні таблиці рейтингу, які мають бути зареєстровані на OSF кожного жовтня з 2027 по 2031. Порожній квадрат позначає зобов'язання, необхідне до перевірки: зразок F27, закріплений на Zenodo до 31 грудня 2026 року, та, на пунктирній лінії 30 червня 2027 року, протокол кожного з 14 досліджень набору B, без яких прогноз записується як невиконаний (розділ 11.2). Рисунок створюється з самої таблиці прогнозів за допомогою figures/figure_a1_calendar.py у супровідному сховищі та змінюється тільки разом з ним.
Таблиця A6. Усі 41 датований прогноз: набори, вимірювання, пороги, ймовірності, прогнози моделей, резервні варіанти та попередні прогнози.
| # (набір) | Прогноз, вимірювання, базова лінія та поріг | Дати, ймовірність, прогнози моделей, правило невирішеного, резервний варіант та попередній прогноз |
|---|---|---|
| F1 (A) | Розрив закривається у даних постачальника. Перевірений успіх на сеансах розробки коду, програмування у порівнянні з іншими професіями: 34% проти 29%, без змін протягом семи місяців (Anthropic, 2026e). Розрив — це рівень успіху професій програмування мінус рівень інших професій, з урахуванням його знака. Справдилося, якщо розрив становить 2 пункти або менше, включаючи від'ємні значення, у порівнювальному звіті щодо даних 2027; не справдилося, якщо більше 2. Базова лінія: Перевірений успіх на сеансах розробки коду: програмування 34% проти інших професій 29%, без змін протягом семи місяців (Anthropic, 2026e) | Перевірка: дані за 2027 р. Кінцева дата: 31 грудня 2028 р. p = 0,35; моделі 0,39 (0,25 до 0,65). Невирішене, якщо: Немає звіту про дані за 2027 р. до кінцевої дати, або визначення сеансу змінилося (ніколи не враховується як успіх). Запасний варіант: Будь-який звіт постачальника, що дає перевірену успішність за професіями на порівнюваних сеансах. Найбільш близький попередній або конфліктуючий прогноз: Anthropic: розрив «ні розширився, ні звузився» |
| F1b (A) | Деякі професії переважають програмістів. Та ж сама мірка, що й F1. Десять найбільших непрограмістських професій заморожені під час реєстрації як десять з найбільшою часткою сеансів у Anthropic (2026e). Професія переважає програмування лише якщо її коефіцієнт успіху вищий на 2 пункти чи більше (запас для множинності у 10 порівняннях). Справдилось, якщо щонайменше 3 з 10 роблять це у даних за 2028 р. Базис: Як у F1; управління вже трохи попереду від програмування (Anthropic, 2026e) | Перевірка: дані за 2028 р. Кінцева дата: 31 грудня 2029 р. p = 0,25; моделі 0,30 (0,20 до 0,45). Невирішене, якщо: Немає звіту про дані за 2028 р. до кінцевої дати, або визначення сеансу змінилося (ніколи не враховується як успіх). Запасний варіант: Як у F1. Найбільш близький попередній або конфліктуючий прогноз: Управління вже трохи попереду (Anthropic, 2026e) |
| F2 (B) | Паритет якості у власній сфері (крок перед точкою перетину). Той же агент, той же час, сліпе прийняття та перевірки безпеки, внесення змін при обслуговуванні іншим агентом через місяць; одне дослідження з 1500 людьми в групі. Справдилось, якщо нижня межа 95% інтервалу для (люди без освіти ІТ мінус програмісти) лежить вище мінус 10 пунктів; не справдилось, якщо верхня межа лежить нижче мінус 10; в іншому випадку невирішене. Базис: Немає публічного базису; дослідження з попередньою реєстрацією, 1500 людей у групі | Перевірка: 8 жовтня 2027 р. Кінцева дата: 8 жовтня 2028 р. p = 0,70; моделі 0,67 (0,62 до 0,70). Невирішене, якщо: Немає порівнюваних даних до кінцевої дати, або інтервал, що не відповідає жодному правилу (ніколи не враховується як успіх). Запасний варіант: Незалежне дослідження з тим же дизайном. Найбільш близький попередній або конфліктуючий прогноз: D. H. Hansson (2026), «100%» (немає дати, немає міри); Esnaola et al. (2026) |
| F3 (B) | Переважання у власній сфері (точка перетину в якості). Як F2 (1500 на групу дає близько 0,8 потужності для виявлення справжньої переваги 5 пунктів із двостороннім альфа 0,05; 400 на групу дали б близько 0,3). Справдилось, якщо нижня межа 95% інтервалу лежить вище нуля; не справдилось, якщо верхня межа лежить нижче нуля; в іншому випадку невирішене. Базис: Як F2 | Перевірка: 8 жовтня 2028 р. Кінцева дата: 8 жовтня 2029 р. p = 0,35; моделі 0,33 (0,25 до 0,55). Невирішене, якщо: Немає порівнюваних даних до кінцевої дати, або інтервал, що не відповідає жодному правилу (ніколи не враховується як успіх). Запасний варіант: Як F2. Найбільш близький попередній або конфліктуючий прогноз: Жодного знайдено з датою |
| F3b (B) | Переважання на чужих завданнях. Як F3, але на завданнях поза сферою учасників. Базис: Як F2, на завданнях поза сферою учасників | Перевірка: 8 жовтня 2028 р. Кінцева дата: 8 жовтня 2029 р. p = 0,10; моделі 0,13 (0,07 до 0,35). Невирішене, якщо: Немає порівнюваних даних до кінцевої дати, або інтервал, що не відповідає жодному правилу (ніколи не враховується як успіх). Запасний варіант: Як F2. Найбільш близький попередній або конфліктуючий прогноз: Аргумент сфери розділу 6.3 прогнозує його невдачу |
| F4a (B) | Утримання не гірше. Частка прийнятих продуктів, відкинутих протягом 12 місяців, за освітою авторів. Справдилось, якщо верхня межа 95% інтервалу для різниці (непрограмісти мінус програмісти) лежить нижче 10 пунктів. Базис: Немає публічного базису; Gartner (Tyagi, 2026, як узагальнено Tray.ai, 2026) очікує, що 60% програм на основі vibe припиняться до 2028 р., враховуючи всі програми | Перевірка: 8 жовтня 2028 р. Кінцева дата: 8 жовтня 2029 р. p = 0,45; моделі 0,49 (0,34 до 0,68). Невирішене, якщо: Немає порівнюваних даних до кінцевої дати, або інтервал, що не відповідає жодному правилу (ніколи не враховується як успіх). Запасний варіант: Реєстри продуктів з опитуванням авторів. Найбільш близький попередній або конфліктуючий прогноз: Gartner (Tyagi, 2026, як узагальнено Tray.ai, 2026): 60% програм на основі vibe припинені до 2028 р. «оскільки вони не забезпечують передбачувану комерційну цінність»; більш широка сукупність, ніж F4a, яка враховує лише прийняті продукти |
| F4b (B) | Випуск не потребує зовнішної допомоги. Частка продуктів, що потребують зовнішної технічної допомоги при випуску. Справдилось, якщо не гірше при 10-пунктовому запасі; розрив, як очікується, закриється в порядку прототип, випуск, утримання. Базис: Немає публічного базису | Перевірка: 8 жовтня 2028 р. Кінцева дата: 8 жовтня 2029 р. p = 0,35; моделі 0,37 (0,22 до 0,50). Невирішене, якщо: Немає порівнюваних даних до кінцевої дати, або інтервал, що не відповідає жодному правилу (ніколи не враховується як успіх). Запасний варіант: Як F4a. Найбільш близький попередній або конфліктуючий прогноз: Gartner (Tyagi, 2026, як узагальнено Tray.ai, 2026): 30% команд інженерів програмного забезпечення під істотним тиском потужності від утримання програм на основі vibe, побудованих громадянськими розробниками та бізнес-користувачами |
| F5 (A) | Перетин в розміщеннях (видимий знак). Об'яви США в замороженому наборі професій ІТ; агентні навички визначені за таксономією відкритих навичок Lightcast, випущеною на дату реєстрації (номер версії записаний у predictions/resolve/F5.md), з замороженим списком агентних навичок; частка об'яв, що вимагають чотирирічного диплома, серед об'яв з цими навичками проти об'яв без них, узгоджена точно за професією (6-значний SOC), посадовою ступінь, штатом та кварталом. Базис агента (2026 Q2 та Q3) береться та архівується перед реєстрацією. Справдилось, якщо різниця негативна на 2 пункти чи більше, з 95% інтервалом, що виключає нуль, у двох послідовних кварталах 2027 р. Базис: Об'яви ШІ все ще більш вірогідно потребують диплома, але збігаються з 2024 р. (Lightcast, 2026b); базис агента береться перед реєстрацією | Перевірка: дані за 2027 р. Кінцева дата: 31 грудня 2028 р. p = 0,30; моделі 0,34 (0,25 до 0,60). Невирішене, якщо: Немає порівнюваних даних до кінцевої дати (ніколи не враховується як успіх). Запасний варіант: PwC AI Jobs Barometer, лише якщо він повідомляє про вимоги щодо диплома для об'яв з агентними навичками проти узгоджених об'яв; в іншому випадку невирішене. Найбільш близький попередній або конфліктуючий прогноз: Gartner (2021): більшість технологічних продуктів, побудованих поза ІТ до 2024 р.; Bone et al. (2025) про навички ШІ в об'явах Великобританії |
| F6 (A) | Програмне забезпечення перетинає останнім. Замороженний список доменів: право, облік і бухгалтерія, освіта, адміністрування клініки, маркетинг, нерухомість, страхування, управління персоналом, логістика, розробка програмного забезпечення, ІТ-інфраструктура, безпека, інструменти розробника. Порядок перших перетинань F5-типу за доменами. Збулося, якщо розробка програмного забезпечення, інфраструктура, безпека та інструменти розробника усі перетнули після принаймні половини інших доменів. Базовий рівень: жоден домен ще не перетнув (F5-типове порівняння) | Перевірка: 2028. Остаточна дата: 31 грудня 2030. p = 0,38; моделі 0,37 (0,25 до 0,55). Залишиться невирішеним, якщо: менш ніж половина доменів, що не пов'язані з програмним забезпеченням, на замороженому списку перетнули до остаточної дати, або немає порівнянного джерела (ніколи не рахується як успіх). Резервний варіант: інше джерело оголошень з тим самим F5-типовим порівнянням за доменами; дослідження якості (F2-типу) не враховуються, і без такого джерела прогноз залишається невирішеним. Найближчий попередній або контрольний прогноз: Hwang (2026): фінанси "the canary in the coalmine" |
| F7 (B) | Нейтральність фону. Окремо зареєстрована когорта з питанням щодо ІТ-освіти; горизонт оцінювався на одному наборі завдань, якість на отриманих завданнях. Коефіцієнт шансів успішного проходження незалежних перевірок, пов'язаних з ІТ-освітою на рівній сходинці, контролюючи знання доменів та компетентність у розумінні. Діапазон 0,67 до 1,5 є коефіцієнтом шансів 1,5 в будь-якому напрямку, приблизно стандартизована різниця 0,22 (перетворення Chinn), за конвенцією невеликий ефект. Збулося, якщо інтервал 90% лежить у межах 0,67 до 1,5 (еквівалентність), окремо у День та на Тиждень і вище. Базовий рівень: немає публічного базового рівня; окремо зареєстрована когорта з питанням щодо ІТ-освіти | Перевірка: 2028. Остаточна дата: 31 грудня 2029. p = 0,42; моделі 0,43 (0,40 до 0,48). Залишиться невирішеним, якщо: будь-яка інша комбінація, включаючи еквівалентність, показану лише на одному рівні, або жодних даних до остаточної дати (ніколи не рахується як успіх). Резервний варіант: незалежна когорта з тими самими елементами. Найближчий попередній або контрольний прогноз: спостереження Anthropic щодо знання доменів; Savva (2026), суперник |
| F8 (A) | Без рейтингу за токенами. Роботодавці зі списку Fortune 500, які використовують кількість токенів як офіційний критерій оцінки впродовж 2027 року, задокументовано роботодавцем або двома незалежними виданнями (питання про використання ШІ не враховуються). Збулося, якщо знайдено менш ніж двох таких роботодавців. Базовий рівень: кількість токенів випробовувалася як критерій оцінки у 2026 році (розділ 4 статті) | Перевірка: 31 грудня 2027. Остаточна дата: 30 червня 2028. p = 0,80; моделі 0,79 (0,60 до 0,90). Залишиться невирішеним, якщо: жодних порівнянних даних до остаточної дати (ніколи не рахується як успіх). Резервний варіант: пошук у архівах ділової преси з замороженими запитами в predictions/resolve/F8.md. Найближчий попередній або контрольний прогноз: Kingy AI (2026): «понижено, але не вбито»; Flowtivity (2026): «незворотно» |
| F9 (A) | Горизонтальні посади відстають. Оголошення у США, ті самі замороженні запити (predictions/resolve/F9.md), Q4 2026 та Q4 2027, кожен підрахунок поділено на всі оголошення у США в тому ж кварталі: менеджер агента, оператор ШІ, оркестратор ШІ проти посад, що називають домен (наприклад, «лідер правового ШІ», «лідер вертикального ШІ»). Збулося, якщо нормалізований обсяг посад, названих доменами, виросте на більший коефіцієнт, ніж горизонтальні. Базовий рівень: кількість оголошень у США за замороженими запитами у Q4 2026 | Перевірка: 31 грудня 2027. Остаточна дата: 30 червня 2028. p = 0,55; моделі 0,58 (0,45 до 0,75). Залишиться невирішеним, якщо: сім'я має менш ніж 50 оголошень у Q4 2026, або жодних даних до остаточної дати (ніколи не рахується як успіх). Резервний варіант: підрахунки пошуку Indeed або LinkedIn з тими самими запитами. Найближчий попередній або контрольний прогноз: Srinivasan та Wei (2026): «менеджер агента» стандартна посада протягом 12–18 місяців; IT Brew (2026): «наступні 18 місяців» |
| F10 (A) | Середній клас застосунків продовжує тонкіти. Доля нових програм з підпискою, які досягають 1000 доларів США щомісячного доходу протягом двох років, та самий показник, що й RevenueCat 2026 (17%). Збулося, якщо нижче 17%. Базовий рівень: 17% нових програм із підпискою досягають 1000 доларів США щомісячного доходу протягом двох років (RevenueCat, 2026) | Перевірка: звіт RevenueCat 2027. Остаточна дата: 31 грудня 2027. p = 0,70; моделі 0,68 (0,60 до 0,80). Залишиться невирішеним, якщо: жодних порівнянних даних до остаточної дати (ніколи не рахується як успіх). Резервний варіант: пороги доходу Sensor Tower або Appfigures. Найближчий попередній або контрольний прогноз: власна тенденція RevenueCat (пріоритет не задекларований); багато програм із віяльною кодировкою заробляють на рекламі, яку RevenueCat не бачить |
| F11 (A) | Перші оголошення гарантів. Оголошення роботодавців із більш ніж 1000 працівниками в медицині, праві, фінансах або освіті, які називають підписання для роботи, виробленої ШІ, та особисту відповідальність за неї. Замороженні запити в predictions/resolve/F11.md: «sign off» з «ШІ-генеровано», «відповідальні за вихід ШІ», «засвідчення ШІ», «гарант ШІ»; оголошення, де «гарант» або «посвідчення» посилаються на ключі або доступ, виключаються. Збулося, якщо знайдено принаймні 10 таких оголошень принаймні від 5 роботодавців і архівовано. Базовий рівень: на момент написання таких оголошень не знайдено | Перевірка: 31 грудня 2027. Остаточна дата: 31 березня 2028. p = 0,50; моделі 0,42 (0,25 до 0,55). Залишиться невирішеним, якщо: жодних порівнянних даних до остаточної дати (ніколи не рахується як успіх). Резервний варіант: архівовані оголошення, знайдені через Google Jobs та LinkedIn. Найближчий попередній або контрольний прогноз: Capps (2025), «гарант правовий»; Forrester (2025): 60% Fortune 100 для призначення голови управління ШІ |
| F12 (B) | Засвідчені продукти знаходять користувачів. Власне рандомізоване дослідження: серед прийнятних продуктів названий гарант призначено випадково. Доля досягає десяти непов'язаних користувачів протягом 90 днів. Збулося, якщо засвідчена доля вища, з інтервалом 95%, що виключає нуль. Базовий рівень: немає публічного базового рівня; власне рандомізоване дослідження | Перевірка: 31 грудня 2027. Остаточна дата: 31 грудня 2028. p = 0,42; моделі 0,43 (0,30 до 0,60). Залишиться невирішеним, якщо: жодних порівнянних даних до остаточної дати (ніколи не рахується як успіх). Резервний варіант: немає. Найближчий попередній або контрольний прогноз: Vouch Hashimoto (механізм, а не прогноз) |
| F13 (A) | Функції перетинають, форми залишаються. Навчальні програми та повідомлення в трьох непов'язаних з ІТ професіях, закодовані двома кодувальниками з кодувальником, опублікованим до кодування (predictions/resolve/F13-codebook.md): перевірка, вибір моделі за вартістю та довгі запуски навчаються; особисті витрати та таборів моделей знайдено лише серед користувачів верхнього шару. Збулося, якщо функціональні теми перевищують теми статусу принаймні три до однієї. Базовий рівень: немає публічного базового рівня; два кодувальники на навчальних програмах та повідомленнях у трьох непов'язаних з ІТ професіях | Перевірка: 31 грудня 2027. Остаточна дата: 30 червня 2028. p = 0,65; моделі 0,69 (0,55 до 0,82). Невирішено, якщо: немає порівняних даних до остаточної дати (ніколи не вважається успіхом). Резервне джерело: публічні каталоги курсів. Найближчий попередній прогноз або контрпрогноз: Rogers (2003), рівні прийняття (без заявленого пріоритету) |
| F14 (B) | Дві осі залишаються окремими. Кореляція Спірмена на рівні особи між логарифмічним горизонтом та логарифмічним приростом у щонайменше 200 логах. Справдилося, якщо кореляція становить 0,8 або менше, а прирість, додавши до горизонту, підвищує R-квадрат поза вибіркою для перевіреного результату через шість місяців щонайменше на 0,02. Базовий рівень: немає публічного базового рівня; щонайменше 200 логів | Перевірка: 30 вересня 2027. Остаточна дата: 30 вересня 2028. p = 0,52; моделі 0,49 (0,45 до 0,50). Невирішено, якщо: немає порівняних даних до остаточної дати (ніколи не вважається успіхом). Резервне джерело: відсутнє. Найближчий попередній прогноз або контрпрогноз: не знайдено |
| F15 (A) | Вхідна сходинка переміщується на День. У заморозленій вибірці 200 американських посад початкового рівня та практичних завдань для виконання вдома в сфері програмного забезпечення та трьох інших професіях медіана першого завдання, оціненого у еталонних годинах двома оцінювачами, знаходиться на рівні День або вище. Базовий рівень: заморозлена вибірка 200 американських посад початкового рівня та практичних завдань для виконання вдома, оціненої у еталонних годинах двома оцінювачами | Перевірка: 31 грудня 2027. Остаточна дата: 30 червня 2028. p = 0,40; моделі 0,49 (0,30 до 0,70). Невирішено, якщо: немає порівняних даних до остаточної дати (ніколи не вважається успіхом). Резервне джерело: вибірки початкового рівня з Indeed Hiring Lab. Найближчий попередній прогноз або контрпрогноз: Washington Monthly (2026): «посади початкового рівня стають все більше схожі на посади середнього рівня»; за прогнозом METR горизонт подвоюється приблизно кожні 4,2 місяця |
| F16 (A) | Вхідна сходинка переміщується на Тиждень. Та ж сама міра; медіана на рівні Тиждень або вище. Базовий рівень: як F15 | Перевірка: 31 грудня 2027. Остаточна дата: 30 червня 2028. p = 0,10; моделі 0,14 (0,06 до 0,40). Невирішено, якщо: немає порівняних даних до остаточної дати (ніколи не вважається успіхом). Резервне джерело: як F15. Найближчий попередній прогноз або контрпрогноз: Kwa та ін. (2025), часові горизонти машин (машини, а не люди) |
| F17 (A) | Оцінки замінюються показником делегованої роботи. З 50 найбільших американських роботодавців, ті, що публічно замінюють системи ранжування на показник перевіреної делегованої роботи. Справдилося, якщо щонайменше 10. Базовий рівень: немає публічного базового рівня | Перевірка: 31 грудня 2028. Остаточна дата: 30 червня 2029. p = 0,05; моделі 0,05 (0,02 до 0,20). Невирішено, якщо: немає порівняних даних до остаточної дати (ніколи не вважається успіхом). Резервне джерело: реєстрації роботодавців та преса. Найближчий попередній прогноз або контрпрогноз: Gartner (2024): до 2026 року 20% організацій будуть використовувати ШІ для спрощення структури; Microsoft (2025): «агент-начальник» |
| F17b (A) | Оцінки замінено: перший великий роботодавець. З 50 найбільших американських роботодавців щонайменше один публічно замінює системи ранжування на показник перевіреної делегованої роботи. Базовий рівень: немає публічного базового рівня | Перевірка: 31 грудня 2028. Остаточна дата: 30 червня 2029. p = 0,20; моделі 0,21 (0,05 до 0,50). Невирішено, якщо: немає порівняних даних до остаточної дати (ніколи не вважається успіхом). Резервне джерело: реєстрації роботодавців та преса. Найближчий попередній прогноз або контрпрогноз: м'якший варіант F17 |
| F18 (B) | Рівень переважає стаж. У даних роботодавців або когорти перевірена сходинка пояснює більшу варіацію в оплаті, ніж років стажу роботи (оцінена продуктивність використовується лише в разі, якщо дані про оплату недоступні, зафіксована перед аналізом). Базовий рівень: немає публічного базового рівня | Перевірка: 31 грудня 2029. Остаточна дата: 31 грудня 2030. p = 0,48; моделі 0,52 (0,40 до 0,60). Невирішено, якщо: немає порівняних даних до остаточної дати (ніколи не вважається успіхом). Резервне джерело: опубліковані аналітичні дані в галузі управління персоналом. Найближчий попередній прогноз або контрпрогноз: Jaques (1956), оплата за обсягом відповідальності |
| F19 (B) | Перевірка встановлює стелю (поза вибіркою). Щонайменше 200 логів. Частка часу, витраченого на перевірку та горизонт, обидва вимірюються в місяцях з 1 по 3; перевірений результат (прийняті роботи в еталонних годинах, а не формула приросту) в місяцях з 4 по 6. Справдилося, якщо в осіб у контрольній вибірці частка перевірки показує вищу часткову кореляцію з пізнішим перевіреним результатом, ніж горизонт. Базовий рівень: немає публічного базового рівня | Перевірка: 30 вересня 2027. Остаточна дата: 30 вересня 2028. p = 0,45; моделі 0,44 (0,30 до 0,65). Невирішено, якщо: немає порівняних даних до остаточної дати (ніколи не вважається успіхом). Резервне джерело: відсутнє. Найближчий попередній прогноз або контрпрогноз: Huang та ін. (2026), посилення перевірки. v1 використовував прирість, який за побудовою включає горизонт; v2 прогнозує пізніший, окремо виміряний результат |
| F20 (B) | Досвідчені посилюють. Частка директив: частка повідомлень особи, в яких видаються інструкції, а не перевірка або редагування, згідно з логом. Перевірений прирість: прийняті еталонні години за годину уваги особи. Серед людей, у яких частка директив зменшилася протягом шести місяців, перевірений прирість до місяця 6 становить щонайменше 95% його значення в місяці 0 для більшості. Базовий рівень: немає публічного базового рівня | Перевірка: 30 вересня 2027. Остаточна дата: 30 вересня 2028. p = 0,60; моделі 0,62 (0,55 до 0,70). Невирішено, якщо: немає порівняних даних до остаточної дати (ніколи не вважається успіхом). Резервне джерело: відсутнє. Найближчий попередній прогноз або контрпрогноз: Anthropic (2026d), криві навчання |
| F21 (A) | Співпраця зберігається. Частка спільного використання (розширення можливостей) у вибірці розмов Claude.ai Індексу економіки Anthropic, а не у вибірці API, залишається вище 40% у кожному звіті, опублікованому в 2027 році. Базовий рівень: спільне використання 52% проти автоматизації 45% у листопаді 2025 року (Anthropic, 2026a) | Перевірка: 31 грудня 2027. Остаточна дата: 30 червня 2028. p = 0,67; моделі 0,68 (0,60 до 0,75). Невирішено, якщо: немає порівняних даних до остаточної дати (ніколи не вважається успіхом). Резервне джерело: порівняні частки у звітах інших постачальників. Найближчий попередній прогноз або контрпрогноз: Anthropic (2026a): 52% проти 45% у листопаді 2025 |
| F22 (A) | Третина помітних продуктів. 100 продуктів з найбільшою кількістю голосів по всіх дванадцяти щомісячних рейтингах Product Hunt 2027 року, список заморозлений на 1 січня 2028 року. Зазначені творці кодуються; продукт вважається створеним без програмної освіти, якщо жодний з перелічених творців не зазначає програмну освіту або попередню роботу програмістом (самовчені люди з роботою програмістом рахуються програмістами). Два кодувальники, незалежні один від одного. Справдилося, якщо щонайменше 30 з 100 підходять. Базовий рівень: Manifold: програмне забезпечення з неформальною оцінкою, 100 мільйонів щомісячних користувачів до кінця 2026, приблизно 28% | Перевірка: 31 грудня 2027. Остаточна дата: 31 грудня 2028. p = 0.28; моделі 0.29 (0.14 до 0.50). Невирішено, якщо: Менше 50 з 100 продуктів мають кодуване твердження, або немає даних до остаточної дати (ніколи не рахується за успіх). Резервний варіант: Другий заморожений рейтинг (Hacker News Show HN top 100 of 2027). Найближчий попередній або контр-прогноз: Gartner (2021); Manifold: vibe-coded програмне забезпечення з 100 мільйонами щомісячних користувачів до кінця 2026, близько 28% |
| F23 (A) | Немає окремої професії в SOC 2028. Американська стандартна класифікація професій на 2028 рік не містить окремої професії для роботи, керованої агентами. Вихідне значення: SOC 2018 не має такої професії | Перевірка: Публікація SOC 2028. Остаточна дата: 31 грудня 2029. p = 0.92; моделі 0.93 (0.80 до 0.98). Невирішено, якщо: Немає порівнювальних даних до остаточної дати (ніколи не рахується за успіх). Резервний варіант: Повідомлення про переглід BLS (перевірено 9 жовтня 2026: поки що немає запропонованої або остаточної структури; остаточна структура очікується у 2027 році). Найближчий попередній або контр-прогноз: Не знайдено |
| F24 (A) | Перший підліток на рівні Week у науці. Наукова продукція — це програмне забезпечення, набір даних або стаття, використана у опублікованих дослідженнях щонайменше десятьма не пов'язаними людьми або цитована щонайменше в одній рецензованій статті. Публічно задокументований випадок людини молодше за 18 років без офіційної підготовки, чия наукова продукція має таких користувачів і отримує Week під час незалежної перевірки. Вихідне значення: Немає такого задокументованого випадку на момент написання | Перевірка: 31 грудня 2030. Остаточна дата: 31 грудня 2031. p = 0.23; моделі 0.21 (0.02 до 0.45). Невирішено, якщо: Тільки якщо джерела пошуку недоступні; відсутність задокументованого випадку до остаточної дати це не було. Резервний варіант: Немає. Найближчий попередній або контр-прогноз: Мета Китаю щодо введення освіти з штучного інтелекту у всі школи до 2030 року (CSET, 2025) |
| F25 (A) | Посади junior-рівня звужуються. Доля посад з "junior" або "entry-level" у назві на ринку програмного забезпечення США у 2030 році порівняно з 2025 роком за тими ж запитами. Вважається істинним, якщо зменшилось щонайменше на третину. Вихідне значення: Доля посад з "junior" або "entry-level" у назві на ринку програмного забезпечення США у 2025 році за тими ж запитами | Перевірка: дані 2030 року. Остаточна дата: 31 грудня 2031. p = 0.55; моделі 0.54 (0.45 до 0.60). Невирішено, якщо: Немає порівнювальних даних до остаточної дати (ніколи не рахується за успіх). Резервний варіант: Indeed Hiring Lab. Найближчий попередній або контр-прогноз: Manifold: на третину менше посад junior-розробників до 2030 року, близько 74%; розробники в США скоротилися більше ніж на 15% з 2023 по 2028 рік, близько 42%; ринок 0.74 (https://manifold.markets/OliverKuperman/will-the-number-of-junior-developer, 9 жовтня 2026 (посади junior-SWE скоротилися щонайменше на 33% до 1 січня 2030; пов'язана, але не ідентична міра)) |
| F26 (B) | Практика найму сумісна. Власне дослідження за допомогою аудиту: узгоджені портфелі перевіреної роботи, що розрізняються тільки наявністю IT-освіти, надіслані на реальні посади у двох не-IT галузях. Вважається істинним, якщо темпи зворотного зв'язку розрізняються менше ніж на 3 пункти з 95%-ним інтервалом всередині плюс-мінус 5. Вихідне значення: Немає загального вихідного значення; власне дослідження за допомогою аудиту | Перевірка: 31 грудня 2028. Остаточна дата: 31 грудня 2029. p = 0.35; моделі 0.32 (0.25 до 0.35). Невирішено, якщо: Немає порівнювальних даних до остаточної дати, або інтервал, який не відповідає жодному правилу (ніколи не рахується за успіх). Резервний варіант: Немає. Найближчий попередній або контр-прогноз: Burning Glass Institute and Harvard Business School (2024): менше ніж один із 700 найму змінився |
| F27 (A) | Продукти, створені агентами, пережили прогноз Gartner. Вибірка щонайменше 300 публічних продуктів, побудованих переважно з використанням coding agents, випущених з жовтня по грудень 2026, заморожених на Zenodo до 31 грудня 2026; активність перевірена супровідним скриптом. Вважається істинним, якщо менше 50% припинили роботу (недоступні або не оновлені протягом 12 місяців) на 31 грудня 2028. Вихідне значення: Gartner (Tyagi, 2026): 60% vibe-coded додатків припинили роботу до 2028 | Перевірка: 31 грудня 2028. Остаточна дата: 31 березня 2029. p = 0.32; моделі 0.35 (0.20 до 0.55). Невирішено, якщо: Вибірка не була заморожена до 31 грудня 2026 (ніколи не рахується за успіх). Резервний варіант: Знімки Wayback Machine кожного продукту. Найближчий попередній або контр-прогноз: Gartner (Tyagi, 2026): 60% припинили роботу |
| F28 (A) | Машини досягають Day на 80%. Горизонт часу 80% METR для найкращої публічно випущеної моделі досягає 8 годин (Day) до 31 грудня 2027. Вихідне значення: Близько 3.1 години на 80% у квітні 2026 (METR, 2026c; інформаційна панель не оновлювалася після 8 вересня 2026) | Перевірка: 31 грудня 2027. Остаточна дата: 30 червня 2028. p = 0.80; моделі 0.66 (0.55 до 0.80). Невирішено, якщо: Ні METR, ні резервний варіант не повідомляють про горизонт 80% до остаточної дати (ніколи не рахується за успіх). Резервний варіант: Незалежна репліка методу METR (наприклад Epoch AI). Найближчий попередній або контр-прогноз: Тенденція встановленого горизонту METR подвоюється приблизно кожні 4.2 місяці |
| F28b (A) | Машини досягають Week на 80%. Як F28, поріг 40 годин (Week). Вихідне значення: Як F28 | Перевірка: 31 грудня 2027. Остаточна дата: 30 червня 2028. p = 0.30; моделі 0.20 (0.10 до 0.55). Невирішено, якщо: Як F28. Резервний варіант: Як F28. Найближчий попередній або контр-прогноз: Як F28 |
| F29 (A) | Менше нових спеціальностей комп'ютерних наук. Нові бакалаврські спеціальності з комп'ютерних наук, повідомлені в опитуванні CRA Taulbee, опубліковану у 2028 році (навчальний рік 2027–2028) порівняно з опитуванням, опубліковану у 2026 році. Вихідне значення: Опитування CRA Taulbee, опубліковане у 2026 році | Перевірка: звіт Taulbee 2028. Остаточна дата: 31 грудня 2028. p = 0.69; моделі 0.67 (0.50 до 0.75). Невирішено, якщо: Немає порівнювальних даних до остаточної дати (ніколи не рахується за успіх). Резервний варіант: NSC Research Center реєстрація за спеціальністю. Найближчий попередній або контр-прогноз: Звіти CRA про падіння прийому на спеціальність CS у 2025 і 2026 роках |
| F30 (A) | Агент-співавтори у публічних коммітах. Доля публічних подій push в GH Archive, коммітів яких містять інформацію про агент-співавтора (заморожені регулярні вирази в predictions/resolve/F30.md), вересень 2027 порівняно з вереснем 2026. Вихідне значення: GH Archive, вересень 2026, виміряне та архівоване до реєстрації | Перевірка: 31 жовтня 2027. Остаточна дата: 31 грудня 2027. p = 0.55; моделі 0.59 (0.40 до 0.75). Невирішено, якщо: Немає порівнювальних даних до остаточної дати (ніколи не рахується за успіх). Резервний варіант: GitHub Innovation Graph. Найближчий попередній або контр-прогноз: Не знайдено |
| F31 (A) | Посадові назви розробника переважають посадові назви менеджера агента. Посади в США, заморожені запити Indeed (predictions/resolve/F31.md), Q4 2027: посадові назви сім'ї builder проти сім'ї agent manager. Вихідне значення: Кількість в Q4 2026 за тими ж запитами | Перевірка: 31 грудня 2027. Кінцева дата: 30 червня 2028. p = 0.60; моделі 0.63 (0.50 до 0.74). Залишається невирішеним, якщо: Немає порівнюваних даних до кінцевої дати (ніколи не рахується як успіх). Резервна опція: кількість результатів пошуку LinkedIn із тими ж запитами. Найближчий попередній або контрпрогноз: Srinivasan and Wei (2026): "agent manager" стандартна назва посади протягом 12–18 місяців |
| F32 (A) | Постачальник повідомляє, що більшість користувачів його агента кодування не є розробниками. Постачальник агента кодування, розробленого компаніями Anthropic, OpenAI, Google або GitHub, публічно повідомляє, що люди, які не є розробниками програмного забезпечення, становлять більшість щотижневих користувачів цього агента. Вихідна лінія: Немає таких повідомлень на момент написання | Перевірка: 31 грудня 2027. Кінцева дата: 31 березня 2028. p = 0.40; моделі 0.31 (0.13 до 0.70). Залишається невирішеним, якщо: Немає порівнюваних даних до кінцевої дати (ніколи не рахується як успіх). Резервна опція: Економічні звіти постачальників або звіти про використання. Найближчий попередній або контрпрогноз: Постачальники конструкторів додатків (Lovable, Replit) вже описують переважно користувачів, які не є розробниками; це питання ставиться щодо загальних агентів кодування |
| F33 (A) | Мінімальний рівень безпеки машини залишається низьким. Частка зразків коду, згенерованих ШІ, які проходять тести безпеки у звіті Veracode про безпеку GenAI коду. Вихідна лінія: 56% показник прохідності, без змін (Veracode, 2026) | Перевірка: звіт Veracode 2028. Кінцева дата: 31 грудня 2028. p = 0.70; моделі 0.67 (0.57 до 0.80). Залишається невирішеним, якщо: Немає порівнюваних даних до кінцевої дати (ніколи не рахується як успіх). Резервна опція: Порівнюваний незалежний еталон безпеки згенерованого коду. Найближчий попередній або контрпрогноз: Veracode: немає покращення в безпеці в новіших моделях |
| F34 (B) | Опорні години можна відтворити. Два незалежні панелі з трьох оцінювачів оцінюють опорні години для тих самих 50 завдань; внутрішньокласова кореляція (двостороння, абсолютна згода) логарифмічних годин. Вихідна лінія: Настільне тестування порогів (Додаток E) | Перевірка: 30 червня 2027. Кінцева дата: 31 грудня 2027. p = 0.65; моделі 0.65 (0.40 до 0.75). Залишається невирішеним, якщо: Немає порівнюваних даних до кінцевої дати чи інтервал не відповідає жодному правилу (ніколи не рахується як успіх). Резервна опція: немає. Найближчий попередній або контрпрогноз: Людські базові показники METR (машини, а не люди) |
| F35 (B) | Горизонт передбачає майбутній результат. Щонайменше 200 записів: горизонт у місяці 0, доданий до стажу та ІТ-освіти, підвищує позавибіркове R² для перевіреного результату у місяцях 4–6. Вихідна лінія: Немає публічної базової лінії | Перевірка: 30 вересня 2027. Кінцева дата: 30 вересня 2028. p = 0.60; моделі 0.58 (0.45 до 0.70). Залишається невирішеним, якщо: Немає порівнюваних даних до кінцевої дати (ніколи не рахується як успіх). Резервна опція: немає. Найближчий попередній або контрпрогноз: Burning Glass Institute та Harvard Business School (2024) |
| F36 (A) | Платформи видають значки для розробки на основі ШІ. Щонайменше дві з платформ Upwork, Fiverr, GitHub, Product Hunt, Toptal та Contra запроваджують публічний значок або поле профілю, яке засвідчує незалежно перевірену роботу, створену ШІ (а не тест навичок). Вихідна лінія: Такого значка на момент написання не було | Перевірка: 31 грудня 2027. Кінцева дата: 31 березня 2028. p = 0.23; моделі 0.24 (0.07 до 0.70). Залишається невирішеним, якщо: Немає порівнюваних даних до кінцевої дати (ніколи не рахується як успіх). Резервна опція: Довідкові сторінки платформ та архівовані оголошення. Найближчий попередній або контрпрогноз: Не знайдено |
Примітка: Набір A вирішується на основі публічних даних; Набір B на основі окремо зареєстрованих досліджень (протокол до 30 червня 2027, інакше не проводиться, що оцінювальна карта рахує як невдачу програми тестування). p залежить від вирішення. Моделі: геометричне середнє коефіцієнтів шансів незалежних прогнозистів, які не бачили моїх цифр, з їх діапазоном; індивідуальні прогнози в predictions/m2-probabilities.csv. Правила для успішних та невдалих результатів для кожного рядка знаходяться в predictions/predictions.csv. У рядках F4a та F4b прогноз Gartner цитується як його цитує список посилань, через резюме від Tray.ai (2026), з його оригінальними словами; зареєстрований файл дає той же прогноз та ті ж цифри більш стисло і цитує Gartner (Tyagi, 2026).
Додаток E. Настільне тестування порогів
Цей додаток подає результати настільного тестування правил розділу 5.2, проведеного 9 жовтня 2026 року шляхом моделювання та з використанням модельних рейтерів, та викладає протокол калібрування, який встановлює наступну версію. Кожне число створюється двома скриптами у супровідному сховищі (pilot/), які викликають оцінювач додатку C без змін і замінюють лише його константи.
E1. Як часто набирається сходинка
Для особи, чиї частини проходять незалежно з істинною ймовірністю p, таблиця E1 показує шанс отримати кожну сходинку з точно мінімальною кількістю частин у вікні. Значення є точними біноміальними ймовірностями; прогін Monte Carlo через horizon.py із частинами, розподіленими по вікну, посадженою помилкою та новою частиною на місці, узгоджується в межах 0,01.
Таблиця E1. Ймовірність отримання сходинки за істинним рівнем проходження.
| Правило | p = 0.95 | p = 0.9 | p = 0.8 | p = 0.7 | p = 0.6 |
|---|---|---|---|---|---|
| Година і День, 8 з 10 за 91 день | 0.99 | 0.93 | 0.68 | 0.38 | 0.17 |
| Тиждень, 5 з 6 за 182 дні | 0.97 | 0.89 | 0.66 | 0.42 | 0.23 |
| Місяць, перша версія, 4 з 4 за 365 днів | 0.81 | 0.66 | 0.41 | 0.24 | 0.13 |
| Місяць, поточна, 5 з 6 за 365 днів | 0.97 | 0.89 | 0.66 | 0.42 | 0.23 |
| Квартал, 3 з 3 за 365 днів | 0.86 | 0.73 | 0.51 | 0.34 | 0.22 |
Примітка: правило є правилом кваліфікації. Ці ймовірності описують правило, а не будь-яку особу.
Три висновки слідують. По-перше, перша версія не була впорядкована: Місяць при чотирьох з чотирьох був складніше отримати, ніж Квартал при кожному p. Кількість чотирьох з п'яти змінила б помилку, роблячи Місяць легшим за День та Тиждень при p = 0,8 (0,74), тому Місяць тепер вимагає п'яти з шести за рік, приблизно 960 контрольних годин замість 640. З цим День, Тиждень, Місяць і Квартал упорядковані від найлегшого до найскладнішого для кожного p 0,77 і вище, діапазону, де кваліфікація має значення. Нижче 0,76 Тиждень трохи легший від Дня (0,42 проти 0,38 при p = 0,7). Обидва тоді відмовляються більшість часу, і це повідомляється та залишається без змін. Жоден підрахунок трьох або більше частин не може бути впорядкований проти трьох з трьох при кожному p, тому що криві перетинаються. По-друге, вердикт мінливий: при p = 0,8 той же вердикт повторюється в наступному вікні для 56% вікон у День, 55% у Тиждень та Місяць та 50% у Квартал. Запис тому виводить кількість поруч із сходинкою ("День (8/10)"), і звіт може позначити сходинку як стабільну, коли вона утримувалась і в попередньому вікні. При p = 0,8 День, утриманий у двох послідовних вікнах, трапляється у 46% випадків, тому стабільність є ознакою, а не вимогою. По-третє, надійна особа все ще може зазнати невдачі: при p = 0,95 Квартал пропущений у 14% років, що є ціною сходинки, яка спирається на три частини.
Фігура A2, панель A, відображає ці ймовірності проти p для правил v1.1.
E2. Чутливість до кількості та долі
Стаття обіцяла повідомити, скільки людей змінюють сходинку, коли кількість переходить з десяти на вісім або дванадцять, а доля з 0,8 на 0,7 або 0,9. Відповідь дається для 10 000 змодельованих журналів День, кожного з 6–16 частинами розміру День у вікні та істинним рівнем проходження, рівномірно розподіленим між 0,5 та 1,0. Поточне правило (десять, 0,8) дає День 30% з них, а таблиця E2 дає частку тих, чий вердикт змінюється за інших правил.
Таблиця E2. Частка змодельованих журналів, чий вердикт День змінюється порівняно з десятьма частинами та часткою 0,8.
| Мінімальна кількість | Доля 0,7 | Доля 0,8 | Доля 0,9 |
|---|---|---|---|
| 8 | 22% | 8% | 15% |
| 10 | 10% | 0% | 11% |
| 12 | 16% | 9% | 17% |
Примітка: сукупність журналів є припущенням моделювання. Польовий експеримент E5 повторює цей аналіз на реальних журналах.
Переміщення будь-якої константи на один крок змінює приблизно один вердикт з десяти. Переміщення обох змінює до одного з п'яти. Доля має більше значення, ніж кількість.
E3. Шум рейтера на краю сходинки
Якщо два рейтери є неупередженими та 80% їхніх пар входять у співвідношення 1,5, вище критерію 70% у розділі 5.8, і еталон є геометричним середнім їхніх двох оцінок, тоді частина, чий істинний розмір становить 7 контрольних годин, оцінюється розміром День 20% часу, і частина з 9 годин не досягає розміру День 23% часу. Саме тому запис виводить медіанний прийнятий розмір поруч із сходинкою (таблиця 3): це видно у горизонті, побудованому на частинах трохи вище порога.
E4. Модельні рейтери контрольних годин
Чотири мовні моделі з чотирьох сімейств (Anthropic, OpenAI, Google та Moonshot), кожна працюючи окремо та без доступу до інших та будь-яких опублікованих часів, оцінили контрольні години 44 завдань 9 жовтня 2026 року. Тридцять були завданнями нового банку в трьох низькоризикових областях (облік малого бізнесу, невеликі внутрішні веб-інструменти, юридичні та маркетингові документи), кожне з письмовим описом умов завершення та прихованою перевіркою. Чотирнадцять були публічними завданнями з даних часового горизонту METR (METR, 2026d) з виміряними часами базової лінії людини від 12 хвилин до 14,6 годин, наданими рейтерам лише за їхнім публічним ідентифікатором. Таблиця E3 дає результати.
Таблиця E3. Узгодженість та точність чотирьох модельних рейтерів.
| Показник | Банк 30 завдань (опис завершення) | 14 завдань з виміряними часами (лише ідентифікатор) |
|---|---|---|
| Пари оцінок у межах співвідношення 1,5 (6 пар рейтерів) | 62% (від 27% до 97% за парами) | 35% |
| Внутрішньокласна кореляція ICC(2,1), логарифм годин | 0.89 | 0.60 |
| Всі чотири рейтери розміщують завдання в одному розмірі сходинки | 60% | 36% |
| Середнє значення чотирьох у межах 1,5 від виміряного часу | не вимірювалось | 21% (3 з 14) |
| Середнє значення чотирьох у межах 2 від виміряного часу | не вимірювалось | 43% (6 з 14) |
Примітка: модельні оцінювачі замінюють двох людських оцінювачів розділу 5.1 і не є свідченням про них.
При наявності повного опису виконаного моделі згоджувалися щодо того, які завдання були більшими, але не щодо рівня: геометричне середнє оцінок одного оцінювача по банку становило 5,1 години, а іншого — 10,4. Фіксований зсув такого роду — це найдешевша помилка для видалення, тому оцінювачі в польовому дослідженні спочатку калібрують на завданнях з виміреними часами. При наявності лише ідентифікатора оцінки були мало корисні, що підтримує заморожений банк з часами, виміреними вручну (розділ 5.1), над оцінками, зробленими за назвою. За правилом таблиці 3, де незгода вище 1,5 відправляє частину третьому оцінювачу, двоє таких оцінювачів відправили б близько чотирьох частин з десяти третьому.
Рисунок A2. Правило сходинки на столі: можливість отримати сходинку та наскільки модельні оцінювачі узгоджуються щодо годин.
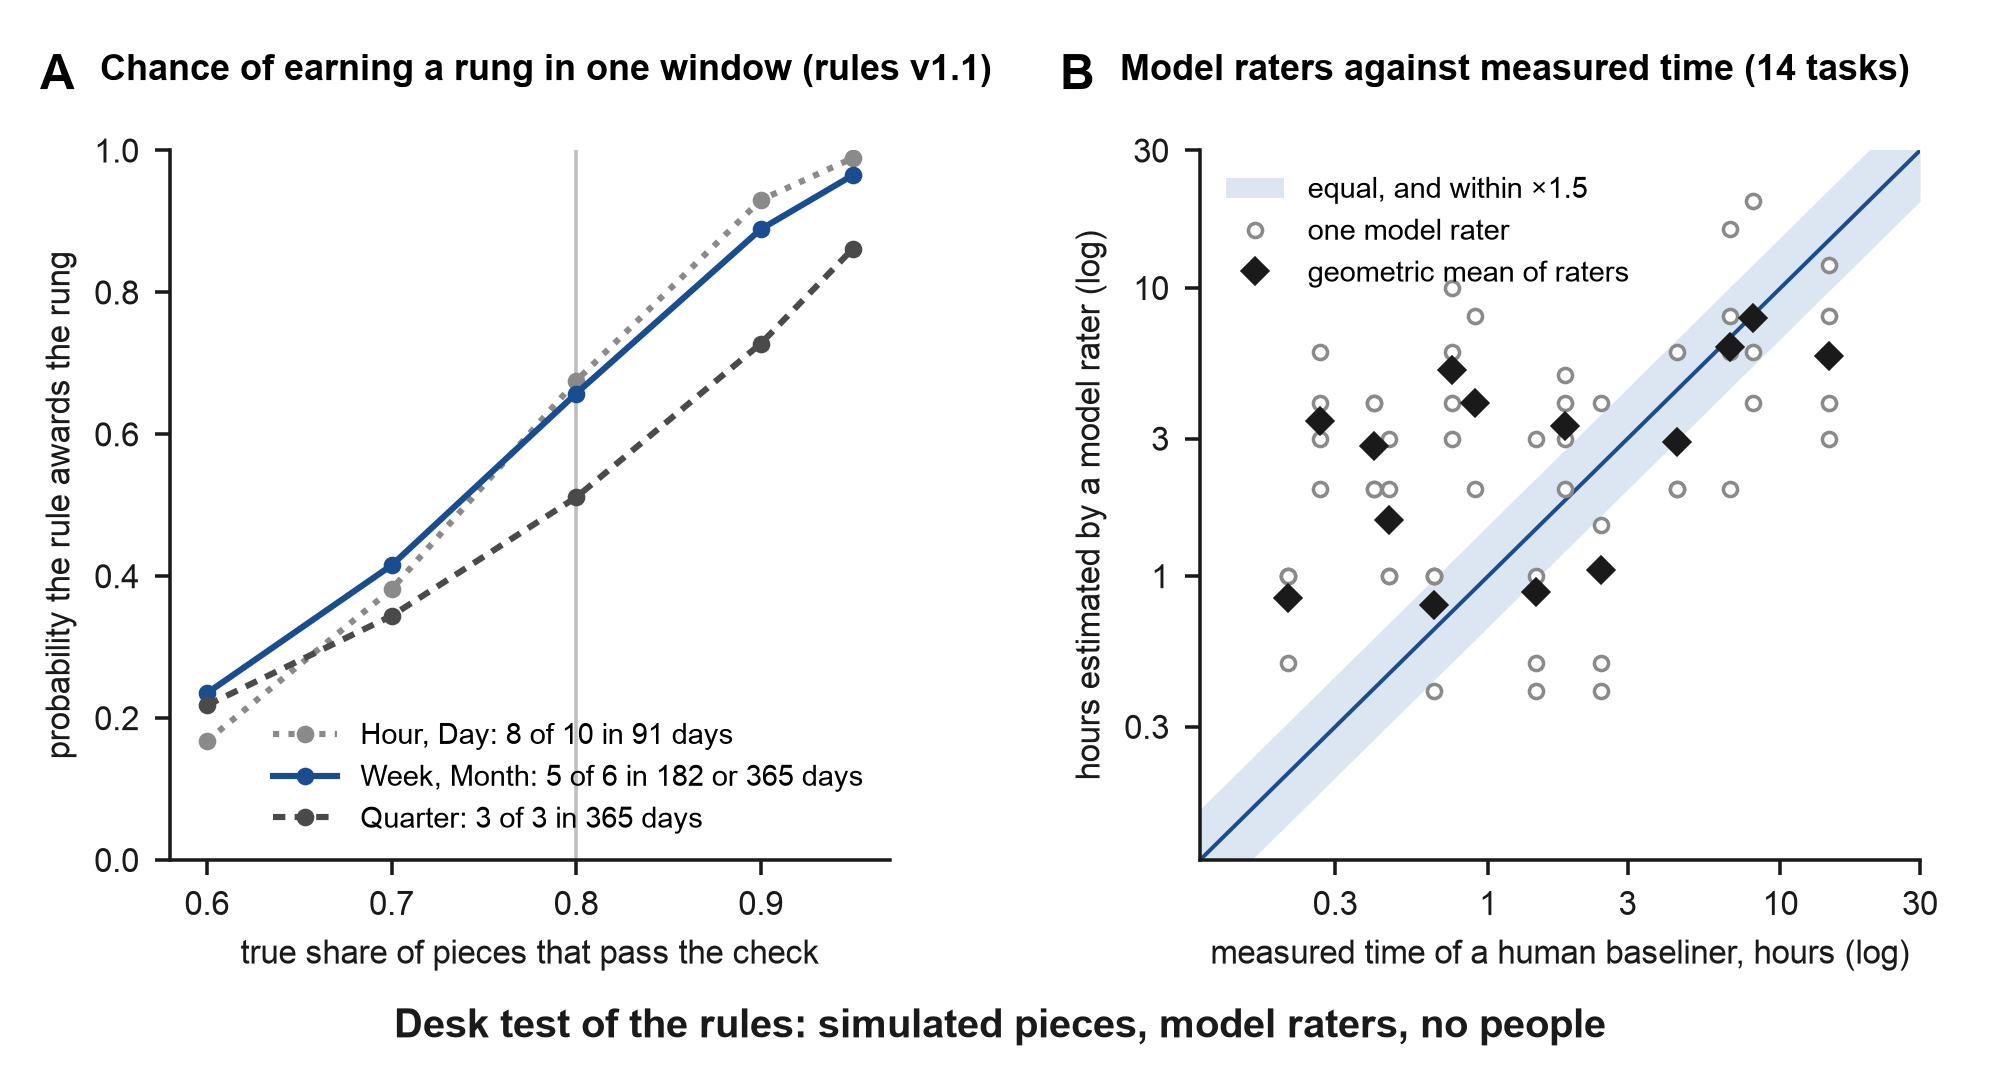
Примітка: тест на столі з змодельованими частинами та модельними оцінювачами. Панель A надає для кожної сходинки за правилами v1.1 імовірність того, що правило надає сходинку в одному вікні, коли кожна частина проходить її перевірку незалежно з часткою на горизонтальній осі. Сходинки з однаковою кількістю та однаковою кількістю проходжень слідують однаковій кривій. Панель B встановлює референтні години, які чотири модельні оцінювачі, кожен з різної сім'ї, оцінили для 14 завдань порівняно з часом, виміреним для людського базового показника (дані завдань METR). Смуга позначає узгодженість в межах коефіцієнта 1,5. Тест на столі, який створив обидві панелі, описано в цьому додатку, а його код та результати знаходяться в супровідному репозиторії.
E5. Протокол калібрування
Протокол та текст реєстрації знаходяться в супровідному репозиторії (pilot/pilot-protocol.md, pilot/preregistration-draft.md). Коротко кажучи, беруть участь 60 дорослих, 30 з програмною підготовкою та 30 без неї, у трьох сферах банку, протягом двох вікон по 91 дню. Усі використовують однакові інструменти агента з зареєстрованими версіями, а перевірки — це приховані тести або двоє сліпих рецензентів домену. Часи, виміряні вручну, вимірюються на п'ятій частині завдань банку, кожне передавання реєструється з його датою початку, і випадкова десята частина прийнятих частин піддається аудиту. Критерії встановлюються перед даними: щонайменше 70% пар людських оцінок в межах 1,5, щонайменше 60% оцінених годин в межах 1,5 від виміряних, повторюваність сходинки в двох вікнах з зваженою каппою щонайменше 0,6, прогнозування проходження нових завдань з AUC щонайменше 0,7, менше 5% рядків журналу втрачено та щонайменше 95% невдалих передавань записано. Форма згоди написана лише для цього дослідження і не повторно використовує жодну іншу згоду. Роботи Місяця та Кварталу, незворотні роботи та сфери високого ризику виключені з цього шести місячного польового дослідження.
E6. Що встановлює тест на столі та що дальше
Це показує, як правила поводяться для людини з відомою надійністю, де вони були непослідовні (одна непослідовність тепер виправлена), наскільки чутливий вердикт до двох констант, і що модельні оцінювачі впорядковують завдання послідовно, але не узгоджуються щодо рівня. Протокол калібрування E5 займається тим, що тест на столі залишає людям: як вони поводяться за правилами, чи повторюється сходинка для реальної людини та чи це передбачає нову роботу; угода між людськими оцінювачами спочатку тестується (додаток G). Порогові значення тому тестуються на столі як правила v1.1, а дослідження калібрування встановлює наступну версію.
Для відтворення: python3 pilot/simulate_rules.py та python3 pilot/rater_agreement.py pilot/results/model-ratings.csv pilot/metr-anchor-tasks.csv (Python 3.9 або пізніше, лише стандартна бібліотека; seed 20261009).
Додаток F. Додаткові таблиці та рисунки
Об'єкти з номерами A1, A2 тощо є об'єктами додатків. На них посилаються з розділів, названих у кожній примітці.
Таблиця A1. Сигнали конвергенції, 2025 - жовтень 2026 р.
| Сигнал | Джерело та дата | Що це показує | Що це не показує |
|---|---|---|---|
| Роботу розробника описано як делегування та перевірка | GitHub, 8 грудня 2025 | Опис ролі постачальником змінився | Те, що рівень розробників вимірюється таким чином |
| Кількість не-розробників усередині агента кодування зросла в 137 разів (фізичні особи) і в 189 разів (організації) | OpenAI, червень 2026 | Швидкий ріст з низької основи; чверть вибраних користувачів зробила щонайменше один запит, розрахований на понад 8 годин | Якість їхніх результатів; дані постачальника |
| Десять найбільших професій у межах 7 пунктів від програмістських професій у перевіреному успіху на сеансах, що виробляють код | Anthropic, 16 червня 2026 | Невелика різниця між професіями; успіх підкріплений доказами, такими як тести або коміти; експертиза оцінюється за поведінкою | Освіта (професія не є ступенем); якість відправлених продуктів |
| Адвокати будують власні інструменти; широкий доступ до AI 83% проти 61% | Bloomberg Law, 20 квітня 2026 | Експерти предметної області будують, а не купують | Як довго ці інструменти обслуговуються |
| Посадовий стиль перейменовано для близько 181 500 працівників | Business Insider and Fortune, 22 січня 2026 | Роботодавці змінюють назви посад | Нова міра (внутрішні рівні збережені) |
| "Frontier Professionals": 3233 з 20 000 користувачів AI | Microsoft, 5 травня 2026 | Сегмент опитування просунутих користувачів | Роль чи оцінка |
| 16 541 постинг, які згадують агентний AI у 2025 р. (151 у 2024 р.) | Stanford AI Index 2026 | Попит на навичку у постингах | Нові професії |
| Найм на початковому рівні впав більше, ніж загалом | LinkedIn Economic Graph, серпень 2026 | Слабша вхідна сходинка в середині 2026 р. | Що це спричинило AI (LinkedIn вказує на економіку) |
| Нові студенти CS знизилися на 13% у факультетах, які видають PhD | CRA Taulbee, червень 2026 | Студенти реагують | Довгостроковий тренд; усі установи |
| Використання AI обговорюється в 4,54% інтерв'ю у 2 кв. 2026 р. (0,33% у 3 кв. 2025 р.) | Metaview, 2026 | Питання увійшло в найм | Шкала для відповіді |
Примітка: Дані постачальника позначені як такі. Старі порівняння (з 2019 або 2022 років) опущені за правилом (розділ 1).
Таблиця A2. Назви в обігу та запропоновані назви за рівнями на 9 жовтня 2026 р. Частина 1: назви, що використовуються, з їхніми власниками та статусом. Частина 2: назви, запропоновані в цьому дослідженні, звичайні описи та розглянуті варіанти.
| Рівень | Кандидат | Запроваджено, і коли (частина 1) | Сенс, у якому він використовується | За | Проти |
|---|---|---|---|---|---|
| Частина 1 | |||||
| Масова навичка | builder, Full Stack Builder | LinkedIn, грудень 2025 (повідомлено); "everyone's a builder now" (SF Standard, 2026) | Будь-хто, хто будує, з будь-якої функції | Уже перемагає в HR | Нічого не говорить про рівень |
| Масова навичка | vibe coding, vibe coder | Karpathy, 2 лютого 2025 | Будування без читання коду | Широко відомо | Насмішка; називає дно |
| Масова навичка | AI fluency (four Ds) | Anthropic, 2025b | Делегування, опис, розсудливість, старанність | Охоплює сферу | Компетенції без рівнів |
| Масова навичка | agent literacy | MindStudio, 11 червня 2026 | Делегувати, перевіряти, управляти | Близько за сенсом | Прийнято; немає стандарту доказу |
| Професія | agentic engineer | Karpathy, лютий 2026; Alenezi, червень 2026 | Інженер, який керує агентами | Слово інженерів 2026 р. | Пов'язано з інженерією |
| Професія | agent boss | Microsoft, 23 квітня 2025 | Кожен працівник, який керує агентами | Запам'ятовувана | Слоган без міри |
| Професія | agent manager | Arion Research, 7 лютого 2026; Srinivasan and Wei, Harvard Business Review, 12 лютого 2026 | Роль, яка керує агентами в команді | Повідомлено як фаворит (aicodex, 2026); його автори очікують, що це стане стандартною назвою протягом 12-18 місяців | Назва горизонтального менеджера (розділ 6.3) |
| Професія | AI Agent Owner; AI Agent Supervisor | Writer, 2026; Digg discussion, 2026 | Особа, відповідальна за розгорнутого агента | Називає власність | Використання одного постачальника або форуму |
| Професія | AI orchestrator | St. Lawrence, семінар 2024 р. та книга 2025 р.; 739 постингів у лютому 2026 р. (IT Brew, 2026) | Бізнес-професіонал, який координує AI | У постингах | Прийнято багато разів; горизонтально |
| Професія | AI Operator | Dust, 7 жовтня 2026 | Будує та обслуговує спільні робочі процеси агентів | Знайома | Звучить як консоль; у Anthropic "operator" - це компанія, яка розробляє на основі API (Anthropic, 2026b) |
| Професія | AI steward, AI work architect | Ono, World Economic Forum, 22 червня 2026 | Один встановлює межі роботи AI, інший перевіряє наслідки | Найбільш близький попередник за сенсом | Дві ролі, немає міри |
| Професія | product creator | Cagan, SVPG, 2025 | Одна особа, яка носить продукт від ідеї до ринку | Мова продукту | Прийнято; немає міри |
| Професія | Product Principal | O'Neill, LinkedIn post, 2026 | Встановлює цілі для агентів, приймає та відповідає за результат | Майже сенс цієї статті | Прийнято в цьому сенсі; цитувати як прецедент |
| Професія | Principal Agentic Context Engineer | Назва посади, зібрана Turkovic, 24 квітня 2026 | Ступінь старшинства в роботі агента | Показує, що "principal" вже використовується як ступінь | Грейд, а не професія |
| Професія | AI Product Builder; Agentic Product Builder | n8n posting, 2026; State Street posting, 2026 | Необхідний вбудований продукт та практика перевірки; кодування бажане (n8n) або необхідне (State Street) | Показує, що роботодавці рухаються у вимогах кодування в обох напрямках | Одиночні назви роботодавців |
| Професія | Chartered Financial Intelligence Architect | Clark, SSRN, 2026 | Професія, названа для однієї галузі | Показує видачу назв, прив'язаних до домену | Одна пропозиція, одна галузь |
| Професія | principal | Agency theory (Jensen & Meckling, 1976); "principals" in Claude's constitution (Anthropic, 2026b); The Principal Firm (Verheul, 2026); principal-agent framing of AI agents (Berkeley California Management Review, 2025; Tikhomirov, 2026) | Сторона, від імені якої діє агент і яка несе витрати на перевірку | Теорія за цим; відповідає слову "agent" | "Agent principal" у керуванні ідентифікацією та доступом означає власну ідентичність агента, протилежний сенс; також грейд Principal Engineer |
| Міра | горизонт делегування (машинна чи фірмова сутність) | Khadj, 2026 (an early version carried a "Delegation Horizon Index", 0 to 100); Alonso, 2026 ("a delegation horizon" for chains of work) | Як далеко машина чи фірма можуть делегувати, перш ніж людина повинна включитися | Показує, що фраза природна | Машина чи фірма, а не людина |
| Міра | поліпшення; прискорення; автономність 1 to 5; H1 to H5; надзірна спроможність | METR, 2025; Anthropic Economic Index, 2025-2026; Shao et al., 2025; em360, 2026 | Середні приросту, прискорення на рівні розмови, автономність агента, бажана залученість людини, корисний результат на одиницю зусиль | Установлені сусідства підсилення прибутку | Вимірювання завдань, розмов чи інструментів, а не перевіреного результату людини |
| Момент | час перетину | The geometry of learning under AI delegation (2026) | Точка, після якої делегування AI коштує більше через деградацію навичок, ніж це дає | Близько за формою | Протилежний сенс: втрата навичок, а не вага облікових даних |
| Партнер | гарант | "Legal guarantor" in Capps (2025), New York Times Magazine | Забезпечує відповідальність, яку не може AI | Точна | Юридичне забарвлення |
| Партнер | фіналізатор; інженер розповсюдження; GTM engineer | GTM engineer in postings, 2026 | Приносить продукт людям | Сплачено сьогодні | Частково автоматизовані (Розділ 7) |
| Невдалий сигнал | tokenmaxxing | Press usage, 2026 (CIO, 2026a) | Рейтинг або конкуренція за кількістю спожитих токенів | Називає реальну практику | Не професія (Розділ 4) |
| Старші назви | громадянин-розробник; інженерування програмного забезпечення кінцевим користувачем; Code Runner, Adaptor, Writer, Builder | Gartner, by 2009; Ko et al., 2011; Feldman & Anderson, 2024 | Будування поза IT; наробіток кінцевих користувачів на інженерні проблеми | Довга родовідна | Прив'язана до однієї сторони старого розділу |
| Частина 2 | Кандидат | Статус | Сенс | За | Проти |
| Масова навичка | грамотність прийняття | Proposed here; no use found in the bases of Appendix B | Заявити заздалегідь, що вважається зробленим, а потім показати це | Називає ядро | Навичка, а не людина; повинна бути розрізнювана від дослідження прийняття технології |
| Професія | agentwright | Proposed here; no use found in the bases of Appendix B | Той, хто робить роботу через агентів, як драматург робить п'єсу | Вільна в академічних базах; має авторство | Пошукові машини розділяють його на "Agent Wright"; звучить як інструмент тестування браузера; частково займано до жовтня 2026 (пакет Python та каталог навичок агента), тому йому потрібна кваліфікація |
| Професія | оркестратор домену (юридичний оркестратор, фінтек оркестратор) | Proposed in an earlier draft of this study | Людина з глибокими знаннями домену, яка збирає системи агентів для цього домену | Прив'язує роль до вертикалі (Розділ 6.3) | "Multi-domain orchestrator" — це установлений термін у керуванні мережами 5G і 6G |
| Професія | встановлювач-приймаючий; директор агента | Plain descriptions | Встановлює завдання та приймає результат | Точна | Опис, а не назва; "director" — це ранг менеджера |
| Професія | Творець, спрямований агентом; Стюард агентичної роботи; Продюсер агентичної роботи; Автор результату; Архітектор результату; провідник агента | Variants produced in this study's model consultations | Варіації авторства та управління робочого агента | Показати простір варіантів | Довгі або близькі до займаних назв (стюард, творець, архітектор) |
| Сходи професії | Специфікатор, Верифікатор, Оркестратор домену; встановлювач, приймаючий, координатор, власник циклу | Early ladders of this study | Кроки зростаючої відповідальності за роботу агента | Читаний | Замінено на перекладини в годинах, які не потребують перекладу між професіями |
| Міра | перевірений горизонт делегування (також: особистий або людський горизонт делегування) | Proposed here | Найбільший перевірений фрагмент роботи, який людина передає агентам | Укорінено в Jaques та METR | Повинна бути розрізнювана від машинного та фірмового сенсу в частині 1 |
| Міра | прибуток підсилення | Proposed here | Перевірена робота за годину уваги | Кредити для будівельників коротких циклів | Потребує замороженої посилання |
| Момент | точка перетину облікових даних | Proposed here; no use found in the bases of Appendix B | Коли продукти людей без IT освіти починають переважати продукти програмістів за тих же перевірок, і облікові дані втрачають вагу | Спостерігається в частинах (Розділ 6.2) | "Credential" також означає секретний ключ у безпеці агента; визначити при першому використанні |
| Момент | Точка інверсії навичок; Точка нейтральності походження; точка перетину експертизи; розмуфтування облікових даних | Variants considered | Той же момент, побачений з боку навичок, походження, експертизи чи облікових даних | Кожна підкреслює одну частину | Кожна охоплює лише один з компонентів розділу 6.2 |
| Партнер | співпідписувач; брокер довіри; суб'єкт розповсюдження | Variants considered | Партнер, який підписує або переносить продукт | Простий | Вужче за гаранта чи завершувача |
| Невдалий сигнал | старшинство токенів (токени як ранг) | Термін, використаний тут для випадку 2026 | Ранжування осіб за спожитими токенами | Назва справжньої події | Не професія (Section 4) |
Примітка: Статус відображає результати веб-пошуку та пошуку в базах даних 8 та 9 жовтня 2026 року (Appendix B). «Використання не знайдено» означає базові дані, перелічені там на ці дати, і нічо не стверджує про базові дані, які не були перевірені. Варіанти у частині 2 походять із власних чернеток дослідження та перелічені так, щоб сімейство варіантів залишилося видимим.
Table A3. Шкали 2025 та 2026 років і що вимірює кожна (повний список).
| Шкала | Джерело | Вимірювана одиниця | Вимірює особу за перевіреною делегованою роботою? |
|---|---|---|---|
| Рівні автономії для агентів ШІ (оператор до спостерігача) | Feng et al., 2025 | Агент | Ні |
| П'ять рівнів, від автодоповнення до програмної фабрики | Shapiro, January 2026 | Машина або налаштування команди | Ні |
| Вісім етапів розробки з допомогою ШІ | Yegge, 2026 | Практика програміста за кількістю агентів | Ні |
| Шкала можливостей (тригер для команди агентів) | Memari & Rudolph, 2026 | Автоматизація роботи | Ні |
| Сім етапів контролю над агентами кодування | Park et al., 2026 | Етапи роботи з контролю | Ні |
| П'ять рівнів делегування в розробці (AIDEs) | JetBrains Research (Tikhomirov), September 2026 | Делегування розробника, представлене як відносини принципал-агент | Тільки розробники; немає правила перевірки |
| Рівні делегування ШІ у прийнятті рішень | Dawson, 2026; Metal Toad, 2026 | Делегування організації або менеджера | Ні |
| Інтелектуальне делегування ШІ | Tomašev et al. (DeepMind), February 2026 | Делегування загалом | Немає міри на рівні особи |
| Границя делегування (ранна версія: Delegation Horizon Index, 0 до 100) | Khadj, 2026 | Делегування фірми або агента | Ні (машини та фірми) |
| Автор, редактор, режисер, оркестратор | Microsoft, May 2026 | Моделі роботи | Ні |
| Система компетентності ШІ (вісім областей, чотири рівні) | AI Certification Standards, 23 August 2026 | Компетентності у професіях | Без іспиту чи порогів |
| Вільне володіння ШІ (чотири D) | Anthropic, 2025b | Грамотність | Немає рівнів |
| Часовий горизонт машини | METR, 2025-2026 | Модель | Ні (тільки машини) |
| Перевірений горизонт делегування та прибуток від підсилення | This paper | Особа у галузі | Так, за правилом Section 5.2 |
Примітка: «Вимірює особу за перевіреною делегованою роботою» означає, що шкала розміщує особу на рівні відповідно до обсягу роботи, переданої агентам та підтвердженої перевіркою, яку агенти не бачили. Рівні JetBrains стосуються того, скільки делегують розробники, і вони вже використовують мову принципал та агент. Вони найближчі сусіди, і їм не вистачає правила незалежності для перевірок та одиниці розміру.
Table A4. Складні випадки та те, як їх розглядають правила.
| Випадок | Обробка |
|---|---|
| Робота, яку особа ніколи не могла б виконати вручну | Референтні години все ще походять від кваліфікованого фахівця; власний навик особи не враховується |
| Робота, якість якої проявляється тільки через кілька місяців | Прийнята тимчасово; відстроченний результат записується, коли він приходить, і може скасувати роботу |
| Галузь без поблизу кваліфікованого людського рецензента | Приховані тести або реальне використання передбачуваними користувачами; модель іншої родини тільки з джерелами, які відкрила особа |
| Сліпий критик тієї ж родини моделей у свіжому контексті | Не незалежна перевірка: записана як same_family (Appendix C), вона не заробляє кредит, хоча вона може покращити роботу перед незалежною перевіркою (Section 6.5) |
| Команда, яка разом приймає роботу | Кожна особа реєструє власну увагу; роботу враховують для особи, яка підписала прийняття |
| Робота, яка проходить перевірку, але пізніше виявляється неправильною | Записана як невдала при наступній перевірці, і сходинка переоцінюється |
| Незворотна робота змішана зі звичайною роботою | Суворіше правило застосовується тільки до незворотних робіт (Section 5.2) |
Table A5. Теми в потоках розробників та їхні аналоги в інших професіях, 2025-2026 (ілюстративні випадки).
| Тема у потоках | Аналог поза програмним забезпеченням | Джерело | Перейшли? |
|---|---|---|---|
| Хто винен у поганому результаті, модель чи той, хто поставив завдання | «Workslop»: вихід ШІ, який перекладає роботу на отримувача, близько двох годин на інцидент і $186 на одного працівника на місяць; колеги судять його відправників як менш спроможних | The Decoder (2025); BetterUp (2026) | Так, сильно |
| Ціна перевірки ($150 на годину на рецензування) | Та сама вартість workslop | The Decoder (2025) | Так |
| Потужна модель планує та рецензує, дешеві моделі виконують роботу | Бюджети ШІ, розподілені за ролями в Atlassian | HCA Magazine (2026) | У компаніях |
| Перевантаження, постійна зміна інструментів, страх пропустити | «AI brain fry» повідомлено 25-26% маркетологів, 19% у HR, 17% у програмному забезпеченні | Search Engine Journal (2026) | Так, більш сильно поза ІТ |
| Власні інструменти замість купленого програмного забезпечення | Адвокати будують інструменти з агентами; 35% опитаних підприємств замінюють деяке куплене програмне забезпечення своїм (вибірка постачальника) | Artificial Lawyer (2026); Bloomberg Law (2026); Retool (2026) | У верхньому шарі |
| Порівняння агентів | Бухгалтери порівнюють двох агентів кодування | Growthy (2026) | Так |
| Переведення компанії на агентів без програмістів | Адвокати та фірми, які будують з агентами замість постачальників | Bloomberg Law (2026); Artificial Lawyer (2026) | Частково; саме консалтингове дело видно лише в цій нитці |
| Особистий рахунок за AI понад $1000 на місяць як маркер статусу | Не знайдено аналога зі статусом; найближчі — корпоративні ліміти та допуски (ліміт Uber $1500 на місяць, гаманці AI Atlassian) | Fortune (2026b); HCA Magazine (2026); пошук від 9 жовтня 2026 | Ні, як статус; так, як статтю бюджету |
| Належність до табору одного агента | Аналога не знайдено | Пошук від 9 жовтня 2026 | Ні, і не потрібно |
Примітка: Нитки являють собою якісні докази, вибрані за темами, і не представляють сукупність. «Перехрещені» фіксують, чи був знайдений аналог у перелічених джерелах 9 жовтня 2026 року.
Figure A3. Машинні горизонти на шкалі щаблів.
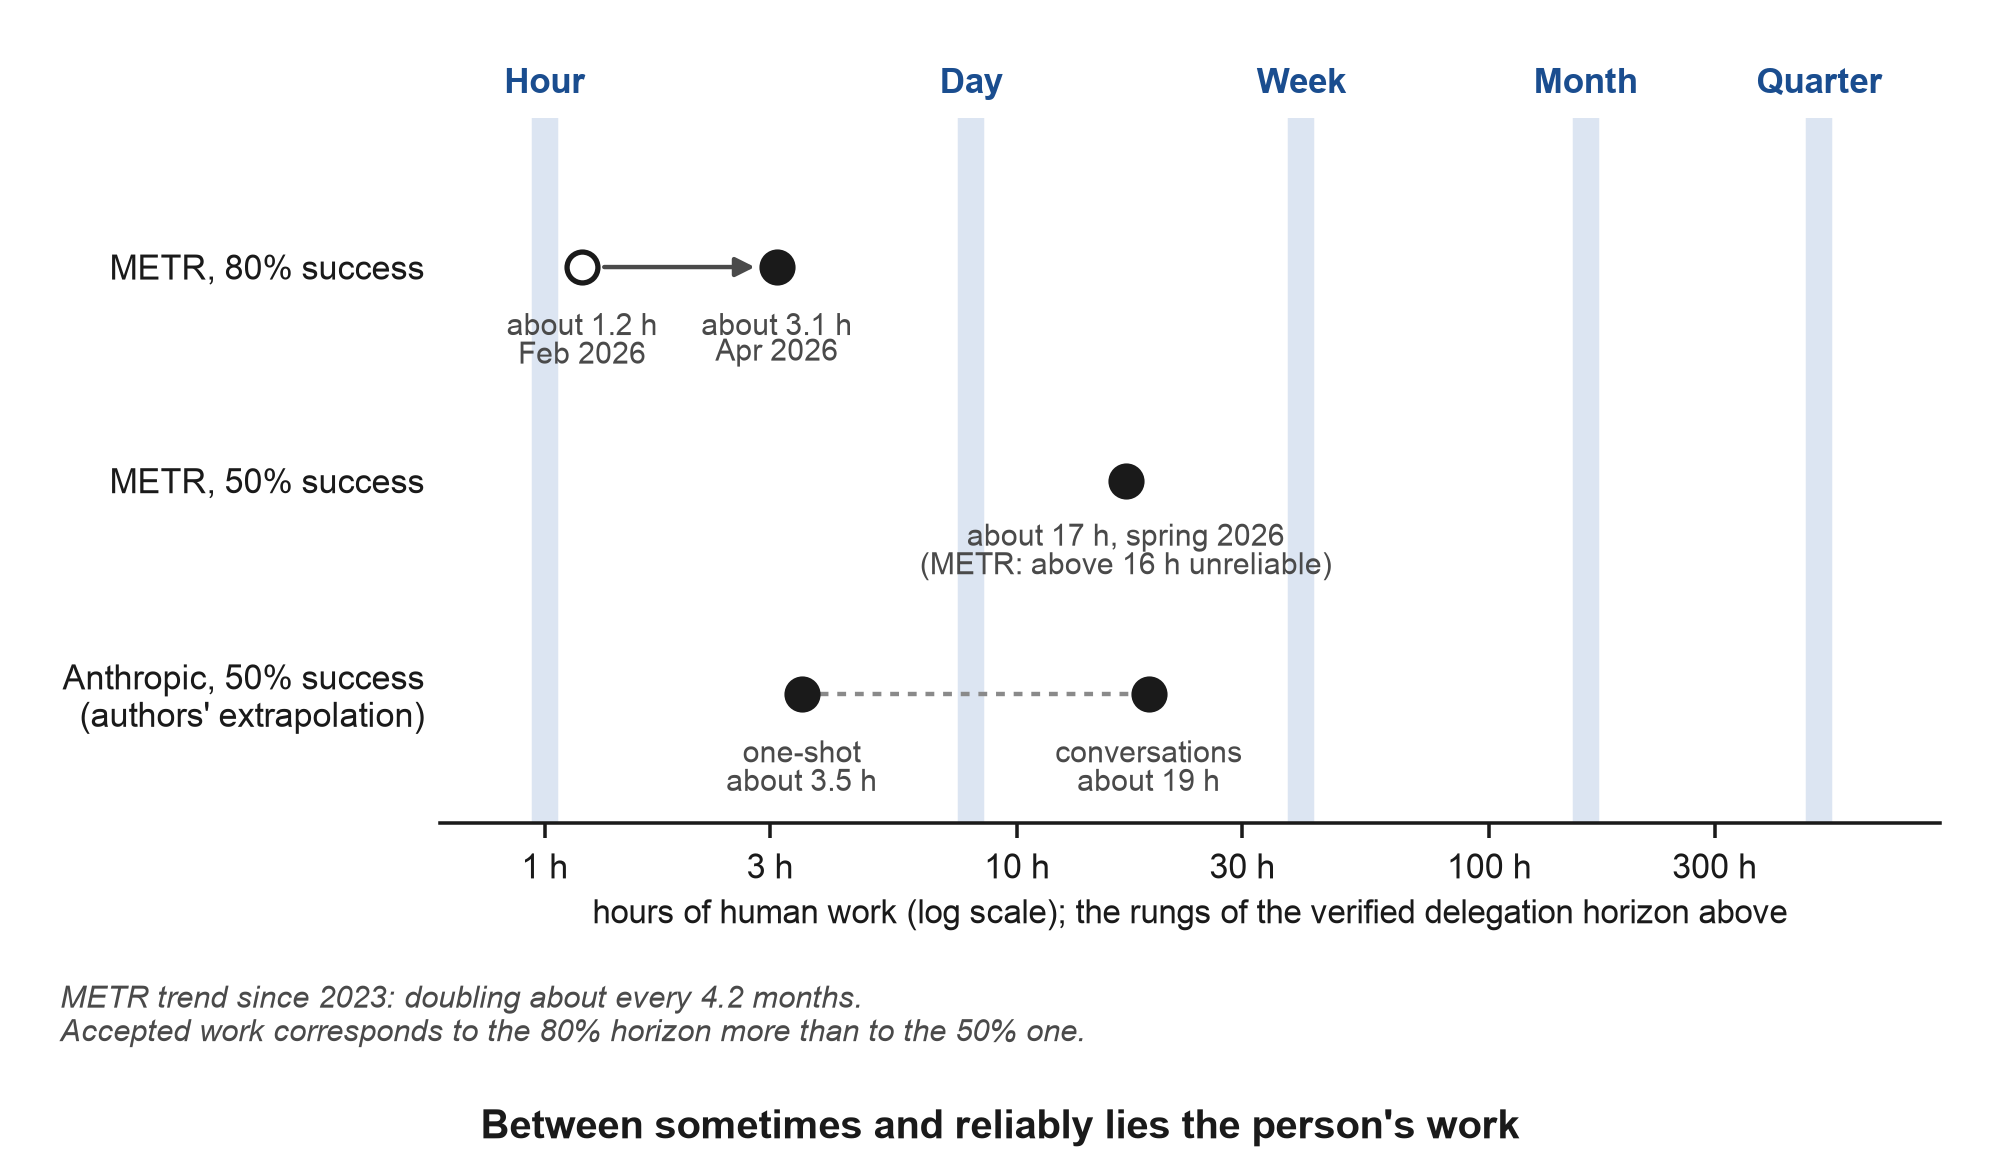
Примітка: Часовий горизонт METR при 80% успіху — близько 1,2 години в лютому 2026 та близько 3,1 години в квітні. При 50% успіху близько 17 годин навесні 2026 року, що сам METR називає ненадійним вище 16 годин (METR, 2026c). 50% точки Anthropic — близько 3,5 години для одноразових запитів та близько 19 годин для розмов — становлять екстраполяцію авторів (Anthropic, 2026a). Машинні горизонти вимірюють моделі, а не людей. Затінені колони показують лише те, де щаблі розділу 5.3 падають на тій же осі годин (розділ 5.6).
Figure A4. Процес перевірки розділу 6.5: що представляє кожен крок, що він дає за правилом та де він зупиняється.
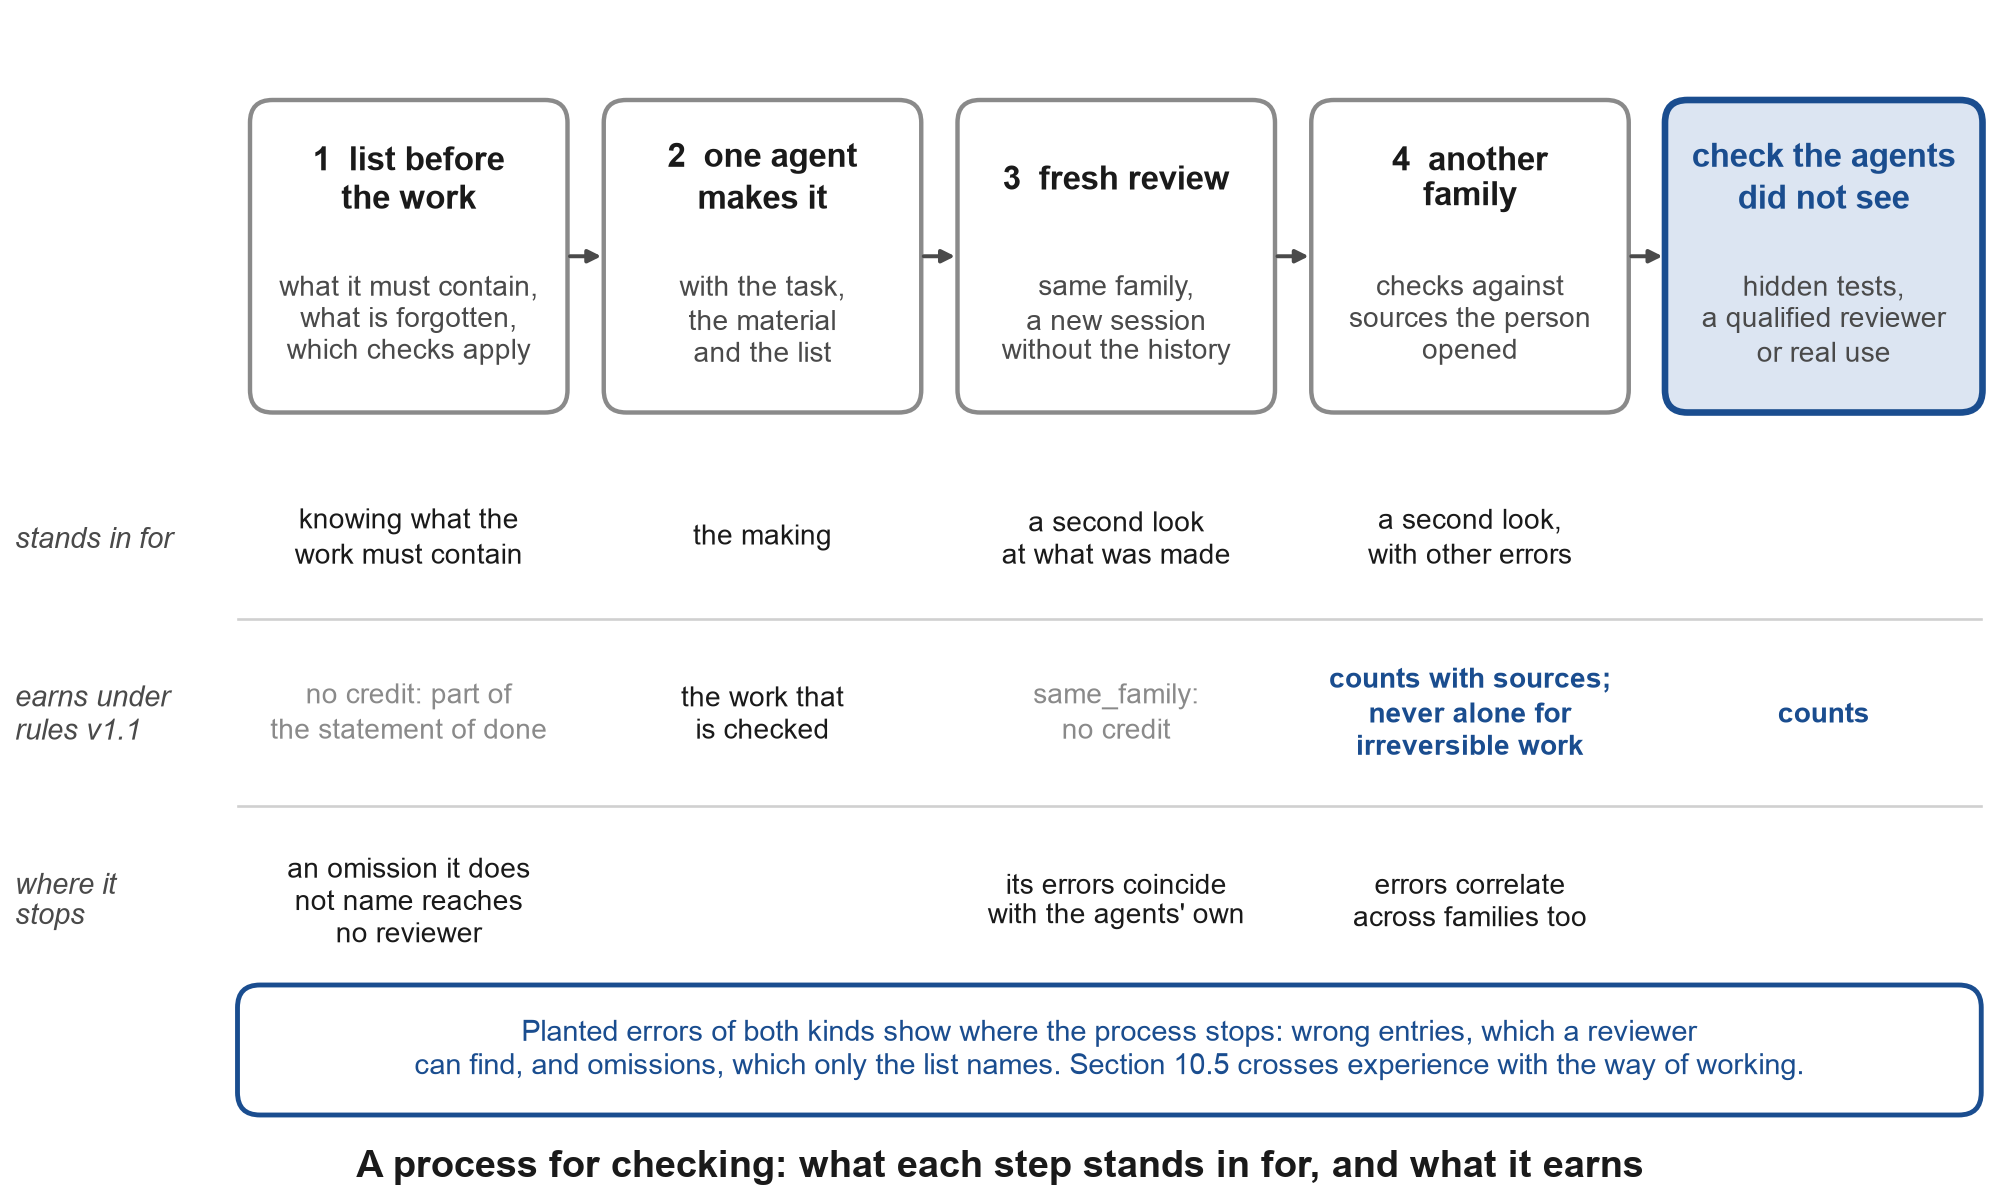
Примітка: Чотири кроки та те, що кожен з них представляє, — це кроки розділу 6.5. Рядок кредиту слідує правилу оцінювання розділу 5.2 та таблиці A4: перевірка моделлю однієї родини у новому контексті записується як same_family і не дає кредиту, хоча може поліпшити роботу; модель іншої родини враховується лише коли перевіряє проти джерел, які відкрила людина, і ніколи одна для незворотної роботи. Останній рядок узагальнює Fu et al. (2025) про пропуски та Kim et al. (2025) про помилки, які корелюють між моделями. Жоден зареєстрований прогноз не тестує процес; розділ 10.5 викладає порівняння, яке б мало. Малюнок створено за допомогою figures/figure_a4_checking_process.py у супутньому репозиторії, який зчитує кредит кожного типу перевірки з horizon.py. Кожен крок представляє частину досвіду фаху; розділ 14 повертається до цього як щабель вирівнювальних механізмів.
Table A7. Стан тверджень у цій статті.
| Елемент | Як це розглядається | Основа |
|---|---|---|
| Програмісти та інші люди тепер ділять завдання та робочий процес делегування та прийняття | Дані це підтримують на рівні завдань та робочих процесів; професії в цілому не злилися | Розділ 2; журнали постачальників та опитування 2025–2026 |
| Дві старі сходи не вимірюють цю роботу | Спостерігалось | Перейменовані сходи без нової міри (Deloitte); питання про використання AI у інтерв'ю без шкали |
| Підрахунок токенів виявляється невдалим як міра старшинства | Спостерігалось у ранніх випадках | Звіти преси 2026 року (розділ 4): неофіційний рейтинг співробітника в Meta, видалений, та пізніші офіційні рекомендації Meta проти підрахунку токенів; таблиця лідерів на Amazon, взломана та видалена; бюджет AI Uber витрачений за чотири місяці, подія бюджету |
| Перевірений горизонт делегування та посилення приросту | Запропоновано; правила v1.1 протестовані на столі; протокол калібрування у супутньому репозиторії; згода професіоналів на контрольні години в результаті зареєстрованого тесту | Визначення та правила (розділ 5); інструмент (додаток C); тест порогів на столі (додаток E) |
| Стеля приросту, встановлена часткою перевірки | Запропоновано як модель; ілюстровано середніми GDPval | Розділ 5.5 |
| Нейтральність фону | Гіпотеза; тести до реєстрації (F7) | Anthropic (2026e) на це вказує; Savva (2026) є суперником |
| Точка переходу облікових даних | Гіпотеза; компоненти датовані окремо (паритет F2, обгін F3, посади F5, нейтральність F7) | Lightcast (2026b) показує лінії, що збігаються; Bone et al. (2025) це передує для ролей AI |
| Ворота, що допускають через витік само-звітного ярлика; ворота, що перевіряють утримання роботи | Запропоновано як модель; витік ілюструється один раз скринінгом дослідження оцінювача | Розділи 6.2 та 13; додаток G2; Danilova et al. (2021); Reid et al. (2022); Serafini et al. (2024, 2026); Oregon State Board of Bar Examiners (2026) |
| Програмне забезпечення перетинається останнім | Прогноз (F6), з 40 іншими в таблиці A6, зареєстрований на OSF | Аргумент домену (розділ 6.3) |
| Процес перевірки може замінити частину досвіду фаху | Гіпотеза, не зареєстрована; жоден зареєстрований прогноз не тестує це, і F3b (p = 0,10) на це впливає лише непрямо; порівняння викладено у розділі 10.5 | Розділ 6.5; Dell'Acqua et al. (2026), McAleese et al. (2024), Eulerich et al. (2024), Fox et al. (2026) та Benchek et al. (2026) з одного боку; Kim et al. (2025), Chernets (2026b), Fu et al. (2025) та Virk and Liu (2025) з іншого |
| Довіра як друга межа; гарант як партнерська професія | Запропоновано як модель; прогнози F11 та F12 | Розділ 7 |
| Непрограмісти, які працюють через агентів | Спостерігалось у працюючій когорті, описано без висновків; зареєстровані результати повідомляються окремо | Розділ 11.5; додаток G |
Table A8. Ворота, що допускають за ярликом, та ворота, що перевіряють роботу: що перевіряє кожна, і що було спостережено.
| Ворота | Що вона допускає | Що було спостережено | Джерело |
|---|---|---|---|
| Фільтр учасника дослідницької платформи | Відповіді здебільшого дані на слово людини; вік та країна проживання перевірені | З 60 осіб, допущених до вибірки з бухгалтерського обліку, 11 неправильно відповіли на питання першого тижня про ремесло, 8 з них переплутали дебет та кредит | Prolific (2026); Додаток G2 |
| Навички програмування, зазначені на платформі краудворку | Власне слово особи | 42% не відповідали критеріям питань про знання дослідників | Danilova et al. (2021) |
| Програмування на Node.js, зареєстроване на Prolific | Власне слово особи | 55 з 206 пройшли всі питання про програмування | Reid et al. (2022) |
| Статичне питання щодо знань у текстовій формі або зображеннях | Відповідь, яку може дати модель чату | ChatGPT легко вирішила існуючі скринінгові питання для програмістів і до 2026 року подолала статичні візуальні питання, розроблені для опору їй | Serafini et al. (2024, 2026) |
| Аудіопитання, розкрито поетапно під жорстким часовим обмеженням | Відповідь, дана під тиском часу | Усе ще утримується проти моделі чату в 2026 | Serafini et al. (2026) |
| Вимога про ступінь видалена з політики | Мітка, видалена на папері | Змінилось менше одного з 700; 19,3% американських оголошень на Indeed просили ступень бакалавра або вищу в листопаді 2025 року, що більше ніж рік тому | Burning Glass Institute and Harvard Business School (2024); Indeed Hiring Lab (2026) |
| Ліцензія за іспитом, пройденим один раз | Знання, перевірені один раз | Працює як мітка з того часу | Розділ 6.2 |
| Перевірка підписаної роботи ліцензованої аудиторської фірми | Підписана робота, перевірена знову і знову | Щорічно для фірм, які регулярно проводять аудит більше 100 емітентів, щонайменше один раз на три роки інакше | Sarbanes-Oxley Act of 2002, s. 104 |
| Ліцензія на основі портфеля контрольованої роботи | Контрольована робота один раз; ступень права все ще потрібна | 205 кандидатів подали документи до 5 січня 2026 року і 49 отримали ліцензію; перший у грудні 2024 року | Oregon State Board of Bar Examiners (2026) |
| Верифікована межа делегування | Надана робота, яка пройшла перевірку, яку агенти не бачили, підтверджена щокварталу | Щабель з показником та видами перевірок, невдачі зберігаються в журналі | Розділи 5.2 та 5.3 |
Примітка: Рядки — це випадки, на які посилається розділ 6.2. Вони походять із різних популяцій і різних питань і розміщені поруч за тим, що перевіряє кожен затвор, не для порівняння як показників. Затвор другого роду можна додати перед будь-яким затвором першого роду: рейтери референтних годин у супроводжувальному сховищі допускаються на основі одного питання про ремесло (kits/reference-hours-raters.md), як дослідження рейтерів додатку G2 перевірило своїх рейтерів. kits/trade-screen.md описує, як написати таке питання та про нього повідомити, а tools/gate_leak.py обчислює частку, що її пропускає мітка, з точним інтервалом.
Додаток G. Люди, які вже це роблять: когорта непрограмістів та дослідження з оцінювачами Prolific
Цей додаток є доповненням до виміру, а не частиною його аргументу; розділи 6.2, 6.5 та 14 цитують результат скринінгу G2 як ілюстрацію. Він додає два записи від людей: опис непрограмістів, які перейшли з чату на роботу через агентів у вересні та жовтні 2026 року (G1), та зареєстроване дослідження з оцінювачами, в якому працюючі фахівці оцінювали довідковий час банку завдань (G2).
G1. Непрограмісти, які перейшли з чату на агентів
З 6 вересня 2026 року я направляв дорослих без навичок програмування покроково, звичайним месенджеренням, від помічника в чаті до агента кодування, встановленого на їхньому комп'ютері й оплаченого з їхньої власної споживацької передплати, а потім до роботи з кількома моделями. Вони походили з більш ніж дюжини професій, серед них бухгалтерське обслуговування та офісна робота, право, маркетинг та продажі, дизайн, фотографія та ретушування, переклад та редагування, музика, будівництво, транспорт та логістика, нерухомість, догляд, державна служба та волонтерська громадська робота; четверо повідомили про минулу чи теперішню роботу в програмному забезпеченні. Наведений нижче опис є описовим: він повідомляє, що люди робили та що їх зупиняло, як записано до 9 жовтня 2026 року, і не обчислює жодного показника та не перевіряє жодне твердження цієї роботи.
Таблиця G1. Як далеко просунулася когорта до 9 жовтня 2026 року (кількість людей).
| Крок | Люди |
|---|---|
| У записі: дали згоду та повернули первинний опитувальник | 119 |
| Встановили агента на свій комп'ютер та передплату й почали з ним працювати | 35 |
| Створили артефакт або виконали хоча б один крок на своїй роботі | 24 |
| Зупинилися з наведеною причиною | 23 |
| з них: немає власного комп'ютера (тільки телефон або пристрій, на якому не можна запустити агента) | 9 |
| з них: вартість передплати | 5 |
| з них: відхилили (того, що було, їм вистачало, немає інтересу або початківецька рамка не підійшла) | 6 |
| з них: здоров'я, сім'я або час | 2 |
| з них: служба була недоступна там, де вони живуть | 1 |
Примітка: підраховано вручну з запису учасника та найновішого резюме вимірювань, використовуючи найпродвинутішу подію, записану для кожної людини. 35 людей другого рядка – це 35 рядків таблиці G1b, а 24 третього рядка – це перші 24 рядки. Артефакт вважається, коли людина показала його або описала, що створив агент; одна людина, яка створила артефакт, пізніше зупинилася (P60) і рахується в обох рядках. Решта 62 людей до того дня або отримали крок установки без повідомлення про те, що це зроблено, або ще до нього не дісталися.
Таблиця G1a. Вся когорта за регіонами та країною проживання, та скільки з кожної перейшли на агента до 9 жовтня 2026 року.
| Регіон та країна | У когорті | Перейшли на агента |
|---|---|---|
| Північна Америка | 37 | 10 |
| Сполучені Штати | 35 | 10 |
| Канада | 2 | 0 |
| Західна Європа | 20 | 7 |
| Німеччина | 12 | 5 |
| Ірландія | 3 | 1 |
| Іспанія | 2 | 1 |
| Велика Британія | 1 | 0 |
| Австрія | 1 | 0 |
| Швейцарія | 1 | 0 |
| Центральна та Східна Європа, названі країни | 9 | 1 |
| Польща | 3 | 0 |
| Молдова | 2 | 0 |
| Латвія | 2 | 0 |
| Естонія | 1 | 0 |
| Румунія | 1 | 1 |
| Країна не розкрита | 53 | 17 |
| Всього | 119 | 35 |
Примітка: зі стовпця країни запису учасника. "Країна не розкрита" групує учасників, чия країна затримується за правилом приватності дослідження, та тих, хто її не надав.
Що люди робили з агентом. Таблиця G1b перелічує кожного, хто перейшов від помічника в чаті до керування агентом до 9 жовтня 2026 року, один рядок кожному: яке завдання вони йому дали та що воно створило. Люди, які створили артефакт або завершили крок на своїй роботі, йдуть першими, впорядковані приблизно за тим, як далеко вони просунулися; ті, хто встановив агента та почав, без поки що повідомленого результату, йдуть далі. Професії наведені як у записі, нейтральним мовленням. Короткі цитати – це власні слова учасників з запису; позначені "(перекладено)" були написані іншою мовою та наведені в моєму буквальному перекладі.
Таблиця G1b. Кожен, хто досі переходив (35 людей, станом на 9 жовтня 2026 року).
| # | Учасник | Професія | Країна або регіон | Що вони робили з агентом | Своїми словами |
|---|---|---|---|---|---|
| 1 | P20 | обробка зображення, ретушування, фотографія | не розкрита | Агент запитав про його цілі й розробив план на місяць як папки та файли (тижні за темою, довідковий файл, трекер); потім зареєстрував його у дев'яти сервісах ШІ, керуючи браузером самостійно, та записав одне відмовлення у файл прогресу; він провів одне питання через 11 веб-ШІ та записав результати та обмеження у файл; на власних фотографіях він створив CSV метаданих однією командою та перевірив його | - |
| 2 | P73 | бізнес із продажу контактних лінз | Ірландія | Встановила другого агента від іншого постачальника; обидва прочитали копію її власного плану в соціальних мережах, і вона зберегла перелік пунктів, в яких вони розрізнялися; написала файл правил для кожного агента й закінчила вечір read-me та журналом роботи | "Я можу продовжити навчання." |
| 3 | P48 | офісна робота та онлайн-продажі | не розкрито | Перетворила документ, який вона пише щотижня, на шаблон зі списком перевірки та написала наступний швидше; другий працівник читає її чернетки без упередження; наказала двом AI прочитати всю папку справи та сама визначила три найдорожчіші висновки | "Питання про те, який AI краще, поставлено неправильно." (translated) |
| 4 | P44 | маркетинг, продажі та консалтинг | не розкрито | Створила кнопки на робочому столі, які запускають завдання агента ("статус проекту", "опис нових товарів", "резюме документа", "примітка до файлу"); встановила другого агента на іншу підписку та провела спільний огляд одного завдання: файл резюме та два повних огляди | - |
| 5 | P21 | громадська організація без прибутку | Німеччина | Побудувала інтерактивну місячну програму навичок і звичок із відстеженням прогресу; наказала агентові вибрати стартовий напрям із каталогу та написати чотирьохтижневий план; потім запустила три сеанси агента паралельно: презентацію за хвилини та бота, який стежить за оголошеннями та надсилає збіги його месенджерові | "Інструмент, адаптований до ваших конкретних потреб, а не пошук компромісів або платних підписок в Інтернеті." |
| 6 | P05 | помічниця директора, колишня програмістка | Сполучені Штати | Агент створив п'ять файлів на її машині: огляд та чотирьохтижневий план за темами; пізніше він надіслав запрошення до списку з 76 контактів через веб-сторінку обміну повідомленнями, клацаючи самостійно, після тестового повідомлення на її номер | "Відтепер я буду розподіляти різні щоденні завдання між ними та справді порівнювати результати." |
| 7 | P01 | дизайнер інтер'єру та креслярка, в навчанні | Іспанія | Наказав агентові побудувати файл вакансій у два прохідни, другий ширший за перший; порівняв його з двома звітами від іншого чатбота, узгодженості та розбіжності виділені окремо; переписав своє CV та портфоліо з чесного читання своїх файлів та переглянув свій професійний профіль | "Коли він може копатися так глибоко й створювати цікаві, але загалом окремі дані для їх аналізу." (translated) |
| 8 | P18 | інтернет-маркетинг | не розкрито | Агент упорядкував її робочий стіл: створив документи, відсортував їх у папки, знайшов помилки та виправив їх; пізніше він встановив оповіщення про новини електронної пошти на її теми | "Я чув про такі речі, але побачити це в дії справді переконало мене." |
| 9 | P19 | чиновник державного управління | не розкрито | Вичитав довге багатокнижкове текстове видання за один день; завершив два великих проекти за один тиждень; зараз будує колекцію плагінів для робочого процесу перекладу | "Я завершив два великих проекти за один тиждень... вау." (translated) |
| 10 | P35 | контракти, рахунки-фактури та митні документи | Сполучені Штати | Виконала перше завдання голосом; агент очистив кеш комп'ютера, закрив програми та знайшов вільний час для запису на сайті бронювання, самостійно його відкривши; запропонував напрямок друку на замовлення; допомагає з тендерним паперовим оформленням; зараз працює в терміналі | "Так, це спрацювало, ми це зробили." (translated) |
| 11 | P72 | стокові зображення та відео, створені за допомогою AI | Румунія | Запустив одне завдання через багато AI з інструментом оркестрування, встановив голосовий введення та вибрав напрями фрілансу з каталогу | - |
| 12 | P41 | помічниця стоматолога, в декретній відпустці | Сполучені Штати | Агент складав розклад, план та чернетки; знайшов шість копій його власного інсталятора та п'ять офісного пакету на її машині та видалив зайві; вона продиктувала урок для громадського класу, а агент його набив, додав цитати та посилання, переклав та зберіг його, потім переробив його за її вказівкою | "Я в захваті." |
| 13 | P24 | музикант та поет | Німеччина | Надіслав одне завдання зображення одинадцяти AI та зберіг результати в папку з сторінкою галереї; наказав агентові побудувати скелет музичного аранжування, що його розчарувало | "Етичний аспект авторства залишається для мене невирішеним." |
| 14 | P102 | керує програмною компанією | не розкрито | Уже працював щодня з агентом по приходу; запустив одне питання через 11 AI (10 відповіли) та надіслав файл запуску; зараз опрацьовує каталог доходів | - |
| 15 | P40 | науковий інженер та веб-розробник | не розкрито | Йшов цим шляхом як навмисний новачок: близько сотні розпорошених файлів у папці завантажень відсортовано в папки зі скриншотами до та після; надіслав два виправлення до матеріалів курсу | - |
| 16 | P75 | віддалена технічна підтримка | не розкрито | Агент створив папку на його робочому столі з планом запуску сезонного музичного відеоканалу (імена, ідеї треків, назви, розклад постування); останній етап завершено | - |
| 17 | P60 | домашній догляд | Сполучені Штати | Після кількох питань від агента план на один місяць розбитий на файли (донори, фінанси, шаблони листів); пізніше вийшов, вважаючи рамки новачка занадто базовими | - |
| 18 | P64 | рівномірна державна служба, логістика та постачання | не розкрито | Складав місячний план з агентом, який створював файли на його комп'ютері; зареєструвався в десяти сервісах AI | "AI адаптується до людини. Він льстить, у певному сенсі." (translated) |
| 19 | P28 | рівномірна державна служба | не розкрито | Агент висвітлив шляхи кар'єри з його нинішнього посту та, коли він один відхилив, розроблений план розвитку для його попередньої професії, ремонту годинників (навички, сертифікація, власна майстерня) | - |
| 20 | P14 | промисловий альпініст | Сполучені Штати | Побудував "Reflex Square", невеликий тренер швидкості реакції, з агентом за його власною пропозицією під час налаштування | "Наразі кодування в Code не те, що мені потрібне в повсякденному житті." |
| 21 | P67 | тренер з плавання, також прямих продажів | не розкрито | Розповіла агентові, що почала з прямих продажів; він запропонував п'ять видів допомоги та розробив зразок картки товару | - |
| 22 | P12 | студент | Німеччина | Зареєструвався в безплатних сервісах AI, запустив папку оркестрування та з агентом вибрав чотири напрями з каталогу (журналістика, книга, монетизація, углиблення в AI); дасть йому свої власні есе | - |
| 23 | P71 | адвокація та охорона здоров'я | Німеччина | Написала власне запрошення; агент його скоротив і залучив інші ШІ для створення зображень; виконала крок у терміналі та додатково виконала власне тестове завдання, щоб запам'ятати комбінації клавіш | "Завдання виконано, надішліть наступне." |
| 24 | P22 | громадська організація | не розголошено | Виконала завдання каталогізації в агенті (деякі сайти блокували його вхід); виконала крок у терміналі, а потім попросила самого агента пояснити, що було зроблено; налаштувала сповіщення про новини електронною поштою | "Готово, що далі?" (перекладено) |
| 25 | P59 | відеограф | Сполучені Штати | Надала агенту детальний брифінг щодо пошуку прибуткових оголошень про нерухомість на його локальному ринку (перевірки, без витрат, ранжовані за прибутком); результати ще не показані | "Навіщо мені другий, якщо перший працює." |
| 26 | P84 | не вказано | не розголошено | Самостійно встановив агента через термінал; будує веб-сайт для громадської організації | "Щось роблю, але думаю, що ми повинні поговорити." (перекладено) |
| 27 | P66 | адміністратор установи дозвілля | не розголошено | Купила ноутбук для курсу, встановила агента й перейшла зі звичайного режиму на вкладку агента; на етапі відкриття облікових записів у десяти ШІ | "Все на іноземній мові, що далі?" (перекладено) |
| 28 | P82 | робота в сфері безпеки; розбудова служби диспетчеризації для вантажних перевезень | Сполучені Штати | Встановив; перенесе свої чати й проекти з іншого чатбота, щоб порівняти обидва | - |
| 29 | P70 | дослідження та монтаж відео для соціальних мереж | Сполучені Штати | Налаштував агента з допомогою сусідів по кімнаті, спочатку вручну створивши тестовий файл | - |
| 30 | P17 | адвокат з міжнародного права | не розголошено | Встановлення завершено; перше завдання надіслано | "Я все зробив." (перекладено) |
| 31 | P93 | фахівець прямої підтримки у сфері догляду за людьми похилого віку | не розголошено | Перейшла зі звичайного чату на агента й сплатила; перше завдання надіслано | - |
| 32 | P54 | робить торти на замовлення | не розголошено | Встановив і сплатив на новому ноутбуці; перше завдання надіслано | - |
| 33 | P26 | будівництво з бетону | Сполучені Штати | Встановив на перевіреному ноутбуці й надіслав його фото; перше завдання надіслано | "Що далі" |
| 34 | P03 | директор компанії зовнішньої торгівлі | Сполучені Штати | Встановив разом з P35; перше завдання надіслано | - |
| 35 | P45 | фото- та відеовміст, досвід програмування | Німеччина | Досяг етапу відкриття облікових записів у десяти ШІ, що передбачає робочого агента; деталі не записані | - |
Примітка: Складено на основі записів учасників. Рядки 1–24 є третім рядком таблиці G1; рядки 25–35 встановили агента й почали роботу без повідомлення про результати до 9 жовтня 2026 р. «–» означає, що запис не містить корисних висловлювань учасника за цей період.
Як новачки говорять про керування агентами. Люди, які кілька тижнів тому користувалися лише чат-асистентом, описують свою нову роботу власними словами. Я зібрав усі уривки, які записи учасників та щоденні спостереження надають у власному формулюванні 35 осіб, які встановили агента (161 уривок від 32 осіб, приблизно 1070 слів), і підрахував шляхом зіставлення основ слів терміни для системи, якою вони керують, для того, що вони з нею роблять, та для самих себе; підрахунки наближені, а «воно» включає деякі вживання, які не стосуються інструменту.
Таблиця G1c. Слова, які новачки використовують для керування агентами (випадки в їхніх власних звітах).
| Що називає слово | Слова, розподілені за категоріями | Кількість |
|---|---|---|
| Система, якою вони керують | "воно" | 35 |
| назва моделі або продукту (Claude, GPT, Codex та інші) | 16 | |
| інструмент, програма, додаток | 11 | |
| "ШІ", "ШІ системи" | 9 | |
| агент | 1 | |
| асистент, помічник, працівник | 0 | |
| Що вони з нею роблять | налаштувати, встановити, запустити | 10 |
| запитати, запитання, запит | 9 | |
| завдання, інструкція, запрошення | 7 | |
| перевірити, порівняти | 4 | |
| розділити, передати | 2 | |
| Самих себе | розробник, новачок | 5 |
Кілька їхніх власних слів (цитати англійською мовою; ті, які позначені як «(перекладено)», були написані іншою мовою, і переклад мій):
- "Воно не просто відповідає на запитання, але насправді може працювати з файлами та документами." (P18, інтернет-маркетинг)
- "Однією з найбільших помилок при використанні ШІ є припущення, що впевнена відповідь автоматично правильна." (P20, фотограф та ретушер; перекладено)
- "Я справді почуваюся розробником." (P21, громадська організація)
- "Щоб отримати те, що я хочу, мені потрібно продумати, як сформулювати запит." (P48, офісна робота та онлайн-продажі; перекладено)
- "Я думаю, що відповідь схожа на запитання до двох людей." (P59, відеограф)
- "Один раз одна ШІ дає кращу пораду, наступного разу все навпаки." (P48, офісна робота та онлайн-продажі; перекладено)
Три більш довгих уривки демонструють зміну в голосах учасників. Дизайнер інтер'єру на навчанні, його перша вечір з агентом, до того як хто-небудь показав йому раду моделей: "воно зробило папку також добре працювало як з документами, що відкривалися [...] і в кінці я отримав два файли з назвою вакансії від цього вакансії від цього й також взяв їх знову надіслав один одному щоб вони оцінили роботу один одного" (P01, перекладено, з автоматичної транскрипції голосового повідомлення). Промисловий альпініст, день, коли він побудував свою першу маленьку програму з агентом, уже просячи наступну роль: "можливо, навчитися будувати агентів, які можуть робити частину роботи для мене - публікувати в соціальних мережах, нагадувати мені про речі або давати мені пропозиції." (P14). І учасник громадської роботи, після своїх перших тижнів: "Я відчуваю, що відкривається безмежний новий потенціал - як стояння на порозі чогось нового." (P21).
Вони називають систему за назвою її продукту або просто «це», майже ніколи не «агент», і жодна з назв на карті розділу 3 не з'являється; проте вони говорять про постановку завдань, порівняння двох відповідей і перевірку впевненої, що є роботою, яку рахує міра. Як на карті, функція з'являється раніше, ніж назва для неї, і це пропонується як опис, а не як перевірка будь-якого твердження.
Ці ж люди також беруть участь у окремо передзареєстрованій програмі (OSF, DOI 10.17605/OSF.IO/X4EGQ), результати якої звітуються там.
G2. Дослідження рейтерів Prolific: чи погоджуються професіонали щодо еталонних годин?
Міра розраховує розмір кожної роботи в еталонних годинах, і правило розділу 5.2 вимагає від двох спеціалістів оцінити роботу наосліп і залучити третього, коли їхні оцінки відрізняються більш ніж у 1.5 рази. Дослідження рейтерів запитує, чи так тісно погоджуються працюючі професіонали. Воно було зареєстровано на OSF як попередній пілот 9 жовтня 2026, перед тим як були зібрані дані (DOI 10.17605/OSF.IO/V92R8), і запущено на Prolific того ж дня.
Дизайн. Дві незалежні вибірки, всього 119 учасників залучено і сплачено: 60 бухгалтерів (поточна роль бухгалтер, помічник бухгалтера, дипломований або сертифікований бухгалтер, аудитор або спеціаліст з податків) і 59 розробників веб та програмного забезпечення (поточна роль інженер програмного забезпечення, розробник програмного забезпечення або веб-розробник). Всі проживають у Великобританії, Сполучених Штатах, Ірландії, Канаді, Австралії чи Новій Зеландії, мають рейтинг схвалення Prolific не менше 98% за щонайменше 100 попередніх подань і беруть участь лише в одному дослідженні. Кожен учасник оцінює десять завдань своєї галузі з банку завдань v0 (BK01 до BK10 або WT01 до WT10, як заморозено в pilot/task-bank-v0.csv) в годинах зосередженої роботи для кваліфікованого професіонала, який працює самостійно без інструментів ШІ, оцінює одне завдання повторно (BK03 або WT03) як тест-повтор, і відповідає на одне питання на компетентність та одну перевірку уваги. Учасник, який не пройде будь-яку з них, виключається і отримує оплату; оцінка, яка не є позитивним числом або перевищує 2000 годин, відкидається.
Показники. Основне: по галузях, частка пар рейтерів, по всім завданням, чиї дві оцінки лежать у межах коефіцієнта 1.5, проти порогу 0.70, встановленого в протоколі калібрування. Вторинне: та сама частка після видалення особистого рівня кожного рейтера, ICC(2,1) на логарифмічних годинах, частка тест-повтор у межах 1.5 та медіанна оцінка кожного завдання проти сходинки, яку мав на увазі банк. Для порівняння, чотири модельні рейтери з додатка E дали 56% своїх пар за цих 20 завдань у межах 1.5: 47% за десять завдань з бухгалтерії і 65% за десять завдань з веб. Аналіз — це скрипт human_raters.py, поданий при реєстрації OSF перед даними, і результат звітується таким, як він є.
Результати.
Скринінг. Учасники були допущені на основі професії в їхньому профілі Prolific, і більшість відповідей, що визначають фільтри Prolific, є самозвітуючимися (Prolific, 2026), тому питання на компетентність було єдиною перевіркою знання ремесла в дизайні. У зразку бухгалтерії це було питання з вибором відповіді щодо подвійного запису для платежу клієнта, отриманого на банківський рахунок. З 60 людей, допущених до цього зразка, 11 (18%) відповіли неправильно, вісім з них обернувши дебет і кредит, і ніхто не провалив перевірку уваги; як зареєстровано, вони виключаються з результатів нижче і були оплачені. У порівнянні, яке не було зареєстровано, ці 11 оцінили більші завдання меншою кількістю годин, ніж це зробили інші учасники зразка: їхні медіани для трьох завдань, призначених для рівня Week (BK08 до BK10), були 6, 6 і 8 годин, проти 8, 8 і 12 для інших 49. З 11 людьми це є ознака для перевірки, не оцінка, і поспіх або неправильне прочитання питання залишило б подібний слід; це узгоджується з твердженням, що людина, яка не знає ремесла, не бачить усіх кроків його більших завдань (розділ 6.5). У вибірці веб-розробників те ж порівняння не повторилося: 8 розробників, які не пройшли питання на компетентність, дали медіани 24.5, 27.5 і 19 годин для трьох завдань, призначених для рівня Week, проти 20, 16 і 20 для інших 50, тому ознака спирається лише на бухгалтерію (дослідницькі аналізи нижче).
Скрипти для цього розділу знаходяться у супровідному репозиторію (pilot/). prolific_to_long.py записує довгий файл оцінок з експортів Prolific; він читає кожну оцінку як написано, зберігає відповідь без числа або з кількома числами, такі як діапазон, як текст, щоб зареєстроване правило це відкидало, і перелічує кожну відповідь, яка не є простим числом. table_g2.py друкує таблицю G2, викликаючи функції зареєстрованого скрипту без змін, поряд з модельними рейтерами на тих же завданнях. screen_compare.py перераховує порівняння скринінгу вище, з точним інтервалом і перестановним тестом рейтерів на завданнях Week.
Узгодженість. Місця були заповнені 9 і 10 жовтня 2026 року, і 118 учасників залишили відповіді, 60 бухгалтерів і 58 розробників; відповіді одного розробника, чиє надіслання було затверджено й оплачено, не були збережені інструментом опитування. Після зареєстрованих виключень (11 бухгалтерів і 8 розробників не пройшли компетентнісне питання; жоден не провалив перевірку уваги), залишилося 49 бухгалтерів і 50 розробників. Зареєстрований поріг не був досягнут в жодній галузі: 28% пар бухгалтерів і 25% пар розробників лежали в межах 1,5, на відміну від 0,70 (таблиця G3). Фахівці впорядкували завдання послідовно, причому медіани кожної галузі зростали від завдань, призначених для Hour, до завдань, призначених для Week, але вони не погоджувалися щодо годин більше, ніж дозволяє правило двох оцінювачів. Видалення особистого рівня кожного оцінювача підвищило частку лише до 34% і 35%, тому незгода стосується самої роботи, а не звички округлення в більшу або меншу сторону. ICC(2,1) щодо логарифму годин становив 0,34 для бухгалтерського обліку і 0,46 для веб-інструментів, і дві оцінки оцінювачем одного й того ж завдання збігалися у межах 1,5 у 53% і 74% випадків. Чотири модельні оцінювачі додатку E з показником 56% на тих же 20 завданнях погоджувалися один з одним тісніше, ніж фахівці, що більше говорить про розповсюдження фахівців, ніж про точність моделей. Порівняно з практиками банк розташований приблизно на один щабель вище: кожне завдання, призначене для Day, мало медіану від 2 до 7 годин, що становить Hour, а кожне завдання, призначене для Week, мало медіану від 8 до 20 годин, що становить Day. У дослідницькому порівнянні, наведеному вище, 11 виключених бухгалтерів погоджувалися між собою не краще, ніж інші (28% пар у межах 1,5). Результати встановлюють три частини правила оцінювача. Оцінювачі калібруються на завданнях з виміреними часами, що якорять рівень, який медіани виявляють невідповідним. Завдання розмірюється за медіаною панелі, а не двома оцінювачами, оскільки розповсюдження такої ширини спрямувало б більшість пар до третього оцінювача. І банк завдань перегрупується на основі медіан практиків, що переміщує його завдання на один щабель вниз (таблиця G3b).
Таблиця G2. Узгодженість фахівців щодо еталонних годин за галузями.
| Галузь | Залишено | Виключено | Пари у межах 1,5 | Після видалення рівня оцінювача | ICC(2,1), логарифм годин | Тест-ретест у межах 1,5 |
|---|---|---|---|---|---|---|
| Бухгалтерський облік | 49 | 11 | 0.283 | 0.335 | 0.335 (49 завершено) | 0.531 (n = 49) |
| Веб-інструменти | 50 | 8 | 0.247 | 0.349 | 0.461 (49 завершено) | 0.735 (n = 49) |
Примітка: Зареєстрований поріг для пар у межах 1,5: 0,70, не досягнут в жодній галузі. Виключення — це невдачі в компетентнісному питанні; жоден учасник не провалив перевірку уваги. Пари беруться по всіх десяти завданнях галузі (11,760 для бухгалтерського обліку, 11,809 для веб-інструментів). Тест-ретест порівнює дві оцінки оцінювачем одного й того ж завдання BK03 або WT03. Вихід human_raters.py як зареєстрований (DOI 10.17605/OSF.IO/V92R8).
Таблиця G3b. Медіанна оцінка кожного завдання порівняно з щаблем, який мав на увазі банк (годин).
| Передбачений щабель | Бухгалтерське завдання: медіана | Щабель медіани | Завдання веб-інструментів: медіана | Щабель медіани |
|---|---|---|---|---|
| Hour | BK01: 2.0; BK02: 2.0; BK03: 1.5 | Hour | WT01: 1.0; WT02: 1.0; WT03: 2.0 | Hour |
| Day | BK04: 3.0; BK05: 2.0; BK06: 3.0; BK07: 4.0 | Hour | WT04: 7.0; WT05: 6.0; WT06: 4.0; WT07: 4.0 | Hour |
| Week | BK08: 8.0; BK09: 8.0; BK10: 12.0 | Day | WT08: 20.0; WT09: 16.0; WT10: 20.0 | Day |
Примітка: Медіани по збережених оцінювачах. Медіана нижче за 8 годин припадає на Hour, а медіана від 8 до менше 40 годин припадає на Day. Кожне завдання, призначене для Day або Week, припадає на один щабель нижче.
Дослідницькі аналізи. Аналізи в цьому параграфі не були зареєстровані. Вони повторно використовують зареєстровані завантажувач, виключення та тест, а їхній скрипт та результат знаходяться у pilot/exploratory_prolific.py та pilot/results/prolific-2026-10/exploratory-output.txt у супровідному репозиторії. Повторна вибірка оцінювачів дає 95% інтервали від 0,24 до 0,33 (бухгалтерський облік) та від 0,21 до 0,29 (веб-інструменти) для основної частки. Розмір панелі (Таблиця G4). Для кожного завдання два непересічні панелі з k збережених оцінювачів були вибрані 2000 разів і їхні медіани порівнювались. На сирих оцінках два медіани узгоджувались у межах 1,5 щонайменше у 70% виборок лише з 15 бухгалтерів або 21 розробника на панель. При видаленні особистого рівня кожного оцінювача, що є метою калібрування на завданнях з виміреним часом, панелі з семи досягли 0,71 та 0,69, а панелі з дев'яти — 0,77 та 0,76. Потрапляння на один щабель, що його записує міра, потребує менше: п'ять каліброваних оцінювачів на панель зробили це в 0,81 та 0,84 виборок. За правилом двох оцінювачів із розділу 5.2 третій оцінювач залучався б для 72% та 75% елементів. Досвід (Таблиця G4b). 43 з 98 збережених оцінювачів з повними відповідями повідомили більш ніж 10 років у своїй галузі. Вони узгоджувались один з одним не більш тісно, ніж решта, і роки в галузі не передбачали, наскільки далеко оцінювач знаходився від медіани інших (ранговий коефіцієнт кореляції +0,18 та -0,10, перестановка p = 0,21 та 0,47). Старші розробники оцінили вище, ніж інші розробники (1,32 проти 0,76 разів медіани інших, p = 0,02); старші бухгалтери ні (1,04 проти 1,07, p = 0,88). Завдання. Незгода зростає з розміром: п'ять з шести найбільш спірних з 20 завдань були завданнями, призначеними на Тиждень, де 24% (бухгалтерський облік) та 20% (веб-інструменти) пар лежали в межах 1,5, проти 31% та 27% на завданнях, призначених на Годину; міжквартильний розмах завдання на Тиждень становив коефіцієнт від 4 до 8. Швидкість та одиниці. Найшвидша чверть бухгалтерів (3,6 хвилини або менше для всього опитування) узгоджувались тісніше, ніж решта (0,37 проти 0,26), а серед розробників швидкість не мала значення (0,24 проти 0,24). Відповідь на деякі завдання у хвилинах, а не в годинах, не мала значення в жодній галузі (0,31 проти 0,31; 0,28 проти 0,31). Два бухгалтери дали 40 годин чи більше на завдання, призначене на Годину, що виглядає як хвилини, введені як години; без них частка бухгалтерського обліку становить 0,284. Один сохранений розробник ввів текст замість чисел, тому лише одна з їхніх оцінок увійшла в аналіз. Просіювання. Порівнюючи оцінки кожного оцінювача для завдань на Тиждень з їхніми власними оцінками для завдань на Годину, так щоб особистий рівень анулювався, виключені бухгалтери оцінювали великі завдання в 3,2 рази вищими, ніж малі, проти 6,2 разів у збережених (перестановка p = 0,10), а виключені розробники в 15,8 разів проти 10,6 (p = 0,37). Повторний тест. Повторна оцінка була вищою, ніж перша, для 25 бухгалтерів та нижчою для 4, та вищою для 17 розробників та нижчою для 2 (точний тест знаків p < 0,001 в обох), приблизно на 30% від геометричного середнього, що узгоджується з закріпленням на більших завданнях, оцінених між ними. Разом ці результати розміщують розповсюджування в роботі та її масштабі, а не в підгрупі поспішних, молодших чи неквалібікованих оцінювачів, і вони визначають розмір панелі, яку потребує правило: калібровані оцінювачі, п'ять до дев'яти на елемент, оцінені за щаблями (Таблиця G4).
Таблиця G4. Дві незалежні панелі k оцінювачів на завдання: частка виборок, чиї медіани узгоджуються в межах 1,5 / частка на одному щаблі (дослідницька).
| Оцінювачі на панель | Бухгалтерський облік, сирий | Бухгалтерський облік, рівень видалено | Веб-інструменти, сирі | Веб-інструменти, рівень видалено |
|---|---|---|---|---|
| 1 | 0.28 / 0.51 | 0.34 / 0.62 | 0.24 / 0.46 | 0.34 / 0.60 |
| 3 | 0.43 / 0.68 | 0.51 / 0.76 | 0.37 / 0.60 | 0.52 / 0.78 |
| 5 | 0.51 / 0.77 | 0.63 / 0.81 | 0.43 / 0.68 | 0.62 / 0.84 |
| 7 | 0.58 / 0.82 | 0.71 / 0.84 | 0.49 / 0.74 | 0.69 / 0.87 |
| 9 | 0.62 / 0.85 | 0.77 / 0.87 | 0.54 / 0.78 | 0.76 / 0.89 |
| 15 | 0.71 / 0.88 | 0.88 / 0.91 | 0.64 / 0.84 | 0.86 / 0.94 |
| 21 | 0.76 / 0.89 | 0.94 / 0.95 | 0.72 / 0.84 | 0.92 / 0.98 |
Примітка: Збережені оцінювачі з усіма десятьма оцінками (49 на галузь); 2000 виборок на завдання, панелі непересічні в межах виборки; seed 20261011. Рівень видалено: середнє логарифмічне відношення кожного оцінювача до медіани всіх оцінювачів на кожне завдання віднімається у вибірці, як у зареєстрованому вторинному результаті, тому ці стовпці являють собою верхню оцінку того, що калібрування на окремих якірних завданнях дасть. Не зареєстровано; результат pilot/exploratory_prolific.py.
Таблиця G4b. Роки в галузі та узгода (збережені оцінювачі з повними відповідями, дослідницька).
| Галузь | Група | Оцінювачі | Пари в межах 1,5 всередині групи | Рівень проти медіани інших |
|---|---|---|---|---|
| Бухгалтерський облік | Більш ніж 10 років | 23 | 0.268 | 1.04 |
| Бухгалтерський облік | 10 років або менше | 26 | 0.299 | 1.07 (p = 0.88) |
| Веб-інструменти | Більш ніж 10 років | 20 | 0.297 | 1.32 |
| Веб-інструменти | 10 років або менше | 29 | 0.242 | 0.76 (p = 0.02) |
Примітка: Рівень — геометричне середнє відношення оцінок оцінювача до медіани інших оцінювачів на тих самих завданнях; p — двосторонній тест перестановки (5000 перестановок) різниці середнього логарифмічного рівня. Не зареєстровано.
Як цитувати
Chernets, V. (2026). After the Programmer Divide: One Measure for People Who Build Through AI Agents [Препринт]. SSRN. https://doi.org/10.2139/ssrn.7589918
@misc{chernets2026aftertheprogrammerdivide,
  author       = {Chernets, Vadym},
  title        = {{After the Programmer Divide: One Measure for People Who Build Through AI Agents}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7589918},
  url          = {https://doi.org/10.2139/ssrn.7589918}
}