После раздела программистов: одна мера для людей, которые создают через ИИ агентов
Это перевод. Основная версия — оригинал на английском; ссылайтесь на него.
Проверенный горизонт делегирования, коэффициент усиления, датированная карта названий ролей и 41 зарегистрированный прогноз, оцениваемые каждый год до 2031 года
Vadym Chernets, PhD, архитектор систем ИИ · ORCID 0009-0007-4845-3163
SSRN 7589918 · DOI 10.2139/ssrn.7589918 · Zenodo 10.5281/zenodo.23267267 · GitHub
Скачать эту статью
- SSRN (официально опубликованная версия): ssrn.com/abstract=7589918 · DOI 10.2139/ssrn.7589918
- Zenodo (архивировано, открытый доступ): doi.org/10.5281/zenodo.23267266
- OSF (41 прогноз, зарегистрирован 9 октября 2026): doi.org/10.17605/OSF.IO/VW6P9
- GitHub (полный текст в формате Markdown): github.com/vadimchernets/papers/tree/main/after-the-programmer-divide; код Приложения C: github.com/vadimchernets/delegation-horizon
SSRN содержит официально опубликованную версию; ссылайтесь на нее.
Ключевые слова: ИИ агенты; агентный ИИ; непрограммисты; кодирующие агенты; названия должностей; найм на основе навыков; теория принципала-агента; разработка программного обеспечения конечными пользователями; грамотность в области ИИ; проверенный горизонт делегирования; точка пересечения учетных данных; предварительно зарегистрированные прогнозы
Аннотация
Бухгалтер просит агента о средстве выверки счетов; разработчик просит его изменить систему выставления счетов. Каждый должен принять дневную работу и показать, что она работает. К октябрю 2026 года юристы также ставили задачи перед теми же агентами. Примерно в 400 000 сеансах проверенный поставщиком успех при работе, производящей код, составил 34% для профессий программирования и 29% для других, хотя профессия — это не образование. Ни одна карьерная лестница не говорит, что может быть надежно доставлено тем, кто работает через агентов. Я предлагаю метрику вместо должности. Проверенный горизонт делегирования — это наибольший связный кусок работы, выраженный в эталонных часах квалифицированного специалиста, который человек регулярно передает агентам и принимает после независимой проверки, которую агенты не видели. Коэффициент усиления, принятые эталонные часы на час внимания, — это проверенная пропускная способность, а не причинная оценка ускорения. Оба оцениваются по доменам, от часа к кварталу; тестирование за столом скорректировало один порог. Три крупных работодателя пробовали учет токенов и отказались от него в 2026 году: рейтинг удален, лидерборд скомпрометирован, бюджет потрачен. Проверенную работу сложнее манипулировать затратами, и каждый оставшийся путь соответствует установленной защите. Датированная карта записывает конкурирующие названия (строитель, менеджер агентов, принципал и другие) без выбора. Фоновая нейтральность — это гипотеза о том, что при равном горизонте образование в области программирования перестает предсказывать проверенное качество. Точка пересечения квалификаций — это момент, по доменам, когда продукты людей без IT-образования начинают превосходить продукты программистов при одинаковых проверках, после чего степени и ярлыки старшинства теряют вес. Сорок одно датированное предсказание, оцененное 9 октября 2026 года по медиане трех слепых прогнозов модели, зарегистрировано на OSF и оценивается ежегодно до 2031 года; исследование, которое никогда не проводилось, считается неудачей, и превосходство в своем домене составляет 0,35.
Резюме
К 2026 году бухгалтеры сравнивали агентов кодирования так же, как программисты это делали годом раньше, юристы создавали с ними свои собственные инструменты, а люди, работающие вне сферы программного обеспечения, стали быстрорастущей частью пользователей агентов кодирования одного поставщика; в записях другого поставщика, примерно 400 000 сеансов, профессии, которые не занимаются программированием, отставали от программистов на несколько процентных пункта в проверенном успехе работы по кодированию (34% против 29%). Там, где выполняется работа, граница между программистами и всеми остальными размылась. В названиях должностей, уровнях оплаты и резюме она стоит там, где стояла.
Некоторые программисты и некоторые специалисты предметной области теперь разделяют рабочий процесс: они передают работу агентам и решают, принимать ли её. Задачи и рабочие процессы объединились раньше целых профессий, поэтому информативный вопрос о человеке состоит в том, какой размер работы он может передать и доказать, независимо от того, с какой стороны старой границы он пришёл. Мера, которую я предлагаю для этого вопроса, — проверенный горизонт делегирования — основана на нескольких проектных решениях, и это резюме даёт обоснование каждого из них. Единица — это время, которое потребовалось бы квалифицированному специалисту (час, день, неделю, месяц, квартал), потому что обе старые лестницы могут это прочитать, и перевод между профессиями не требуется. Инструмент выверки бухгалтера и изменение биллинга разработчика подчиняются одному и тому же правилу. Учитывается только работа, прошедшая проверку, которую агенты не видели, и согласие между моделями одного семейства не считается такой проверкой, потому что их ошибки коррелированы. Второе число — коэффициент усиления — записывает, сколько проверенной работы каждый час внимания человека даёт (неудачная работа всё ещё требует внимания, а неконтролируемое время агентов — нет), так чтобы тот, кто работает рядом с агентом в коротких циклах, получал кредит в полной мере, как и тот, кто передаёт большие объёмы. Оба числа сохраняются в разбивке по областям, по симметричной причине: юрист, переходящий в область программного обеспечения, и программист, переходящий в право, теряют одно и то же — способность принимать работу в области, которую они не знают. Пороги версионированы как правила v1.1 и пройдены настольными тестами, и эта проверка уже исправила один из них (Приложение E).
Названия не установлены. Создатель, инженер агентов, менеджер агентов, оператор ИИ, оркестратор и принципал — все используются в октябре 2026, каждый со своим владельцем и датой. Я их картирую без выбора, так чтобы любая из них, которая победит, могла быть прочитана на одной шкале: создатель на неделе, менеджер агентов на день.
Рынок уже пробовал ярлык. В 2026 году подсчёты токенов были попробованы в качестве меры персонала крупных работодателей и потерпели неудачу в течение месяцев: неофициальный рейтинг сотрудника в Meta был снят, а официальное руководство компании позже исключило подсчёты токенов, таблица лидеров в Amazon была подделана пустыми задачами и удалена, а Uber потратил свой годовой бюджет ИИ в течение четырёх месяцев. Подсчёт входных данных вознаграждает расходы. Подсчёт принятой работы, проверенной независимо, сложнее раздувать таким образом по конструкции. Оставшиеся маршруты (лёгкие проверки, щедрые оценивающие, скрытая помощь и работа, нарезанная на куски) каждый встречают защиту в разделе 5.8: случайные аудиты, независимые оценки часов, публичный учёт сбоев, согласованная единица работы и посаженные ошибки.
Два предсказания поддерживают мой датированный тезис. Нейтральность происхождения гласит, что на одном и том же уровне образование в области программирования перестаёт быть показателем проверённого качества. Точка пересечения квалификационных требований — это момент в области, когда продукты, созданные людьми без образования в области ИТ, начинают превосходить продукты программистов, использующих одних и тех же агентов, после чего диплом и ярлыки младший и старший теряют вес. Паритет качества приходит перед этим моментом, пересечение требований к степени в объявлениях о вакансиях является его видимым признаком, и каждая часть датирована и протестирована самостоятельно. Основное предсказание противоречит современному мнению, и работа говорит об этом там, где оно формулируется. Каждое предсказание также называет результат, который его бы опроверг, так чтобы читатель мог заранее увидеть, как выглядел бы отказ. Все 41 появляются в таблице с вероятностями, пороги, резервные источники и конечные даты, зарегистрированные на OSF 9 октября 2026 г. (DOI 10.17605/OSF.IO/VW6P9) и оценённые по правилу Brier каждый год до 2031 г. Двадцать семь разрешаются из открытых данных. Четырнадцать нуждаются в исследованиях, зарегистрированных отдельно перед сбором данных, и отсутствующие или неубедительные доказательства записываются как неразрешённые и не считаются успехом; исследование, которое никогда не проводится, является отказом программы тестирования и остаётся в протоколе оценок. Вероятности были зафиксированы 9 октября 2026 г. как медиана трёх слепых прогнозов моделей, которые я принял, и зарегистрированы на OSF; вероятность превосхождения в собственной области равна 0,35.
Когда создание стоит дёшево, доверие становится редким фильтром. Магазины приложений и хосты кода переполнены, платформы закрывают двери неизвестным авторам, а агенты всё чаще пишут решение вместо того, чтобы принять чужое. Рядом с человеком, который создаёт, видны две партнёрские функции: тот, кто завершает, доводит продукт до людей, а гарант подписывает за него. Второе название происходит из описания роли 2025 года, и я также предлагаю меру для гаранта.
1. Введение
23 сентября 2026 г. один блог для бухгалтеров сравнил двух кодирующих агентов — Claude Code и Codex — для категоризации транзакций и выверки счетов (Growthy, 2026). Годом раньше такое сравнение принадлежало программистам, и в потоках программистов оно по-прежнему принадлежит — со всеми расколами и лояльностью. Изменился читатель. Люди, теперь выбирающие между агентами, ведут бухгалтерию, пишут контракты и проводят кампании, а агентов, между которыми они выбирают, используют разработчики программного обеспечения.
Десятилетиями экономика поддерживала две лестницы. В программном обеспечении ступени были: младший, среднего уровня, старший, ведущий и главный — оценивались по годам опыта и по количеству инженеров, которых требовал проект. Повсюду остальное ступени были: аналитик, консультант, менеджер, директор и партнер. Лестницы встречались у входа в ИТ-отдел в том смысле, что профессионал на второй лестнице получал программное обеспечение, заказывая его у кого-то с первой. В 2025 и 2026 годах обе лестницы начали описывать одну и ту же работу. Разработчикам говорили, что их основная деятельность стала делегированием и проверкой (GitHub, 2025b). Профессионалы вне программного обеспечения, имея агента в терминале или окне рабочего стола, начали создавать инструменты, сайты и небольшие приложения, которые раньше заказывали (Bloomberg Law, 2026; OpenAI, 2026). Ни одна лестница не говорит, что такой человек может надежно доставить, и ни одна не говорит, как сравнить бывшего разработчика с бывшим аналитиком, которые теперь делают одну и ту же работу.
Вопросы, которые следуют далее, это как называть людей на объединенной стороне той границы, как измерять их уровень, когда диплом и годы службы перестают говорить работодателю, что они могут доставить, и когда граница может исчезнуть. Последний из них получает ответ в виде датированных прогнозов.
У этого вопроса также датированное происхождение. 8 октября 2026 г. я высказал прогноз: в течение одного-двух лет возможность агентов будет расти настолько, что техническое образование больше не потребуется, и люди без него будут создавать лучшие приложения, сайты и продукты — с кодом лучше, чем у программистов. Позже в тот же вечер я добавил следствие. Когда продукты, сделанные людьми без ИТ-образования, начнут опережать те, что сделаны ИТ-профессионалами, ИТ-степени и ярлыки junior и senior быстро потеряют значимость в резюме. (Оба утверждения переведены из моих заметок того дня.) Разделы 6 и 11 превращают оба в прогнозы с датами, мерами, пороговыми значениями и результатами, которые их опровергали бы. Второе утверждение называет момент, который остальная часть статьи называет точкой пересечения полномочий.
Сопровождающая работа в этой серии следила за непрограммистами от чата к агентам и определила четыре уровня по месту работы агента и тому, что должен иметь человек (Chernets, 2026a). Она считала переход только тогда, когда агент произвел артефакт, и отказалась делать менеджера агентов должностью, используя термин для модели поведения, а не для должности, в соответствии с которой следует нанимать, потому что поведение оставляет свидетельства, а должность нет (Chernets, 2026a, раздел 8.4). Настоящая статья исходит из этого условия: уровень присуждается, и любое название может к нему прикрепиться, только на основе доказательств, означающих работу, переданную агентам, принятую человеком и подтвержденную проверкой, которую агенты не видели.
Раздел 3 дает датированную карту названий в обращении в октябре 2026 г. Раздел 5 дает масштаб, по которому любое из этих названий можно прочитать — проверенный горизонт делегирования и его вторую ось, коэффициент усиления. Раздел 6 формулирует две гипотезы — нейтральность происхождения и точку пересечения полномочий — и спрашивает, сколько опыта ремесла может заменить процесс проверок. Разделы 7 и 8 рассматривают доверие — границу, которая не растворяется, — и две партнерские функции рядом с человеком, который создает. Раздел 11 излагает датированные прогнозы с вероятностями, пороговыми значениями и запасными источниками, зарегистрированные на OSF и оценивающиеся публично каждый год до 2031 г.
Я не выбираю между названиями. Рынок выберет, вероятно в течение месяцев, и статья, которая ставит на одно слово, будет ошибаться в день, когда победит другое слово. Что может сделать статья — это исправить масштаб. Раздел 5 определяет его полностью; вкратце, проверенный горизонт делегирования спрашивает, какой размер работы, в часах, которые потребовались бы квалифицированному специалисту, человек регулярно передает агентам и принимает с независимой проверкой позади принятия, и коэффициент усиления спрашивает, сколько таких часов каждый час собственного внимания человека дает. Оба ведутся по доменам, датируются и размещаются на пяти ступенях от Часа до Квартала. Рисунок 1 ставит две старые лестницы рядом с этой.
Одно определение точки пересечения полномочий служит всей статье. В доменe это момент, когда продукты, сделанные людьми без ИТ-образования, принятые под такими же независимыми проверками, начинают опережать те, что сделаны программистами, использующими тех же агентов, после чего степень и ярлыки junior и senior теряют значимость при найме. Паритет качества — это шаг перед тем моментом, а пересечение требований к степени в объявлениях о работе — его видимый знак. Нейтральность происхождения — гипотеза о том, что образование прекращает предсказывать проверяемое качество на равной ступени — это механизм, который это объяснял бы. Каждая из этих четырех частей несет свой датированный прогноз (раздел 6.2).
Доказательства исходят из 2025 и 2026 годов, периода, в котором месяц развития агентов меняет то, что нужно считать. Широко цитируемая цифра ставит найм молодых выпускников в крупные технологические фирмы намного ниже уровня 2019 г. Она опущена, как и сравнения с пиком найма 2022 г., потому что они измеряют мир до агентов. Данные, предшествовавшие агентам, входят только как предшественники, и макроэкономика найма переносится противопоставлением LinkedIn раздела 2.4. Более ранние работы входят также как теория, прецедент или аналогия: Jaques о временном горизонте ответственности, Jensen и Meckling о стоимости делегирования, золотая лихорадка и фотограф.
Рисунок 1. Две лестницы и один масштаб.
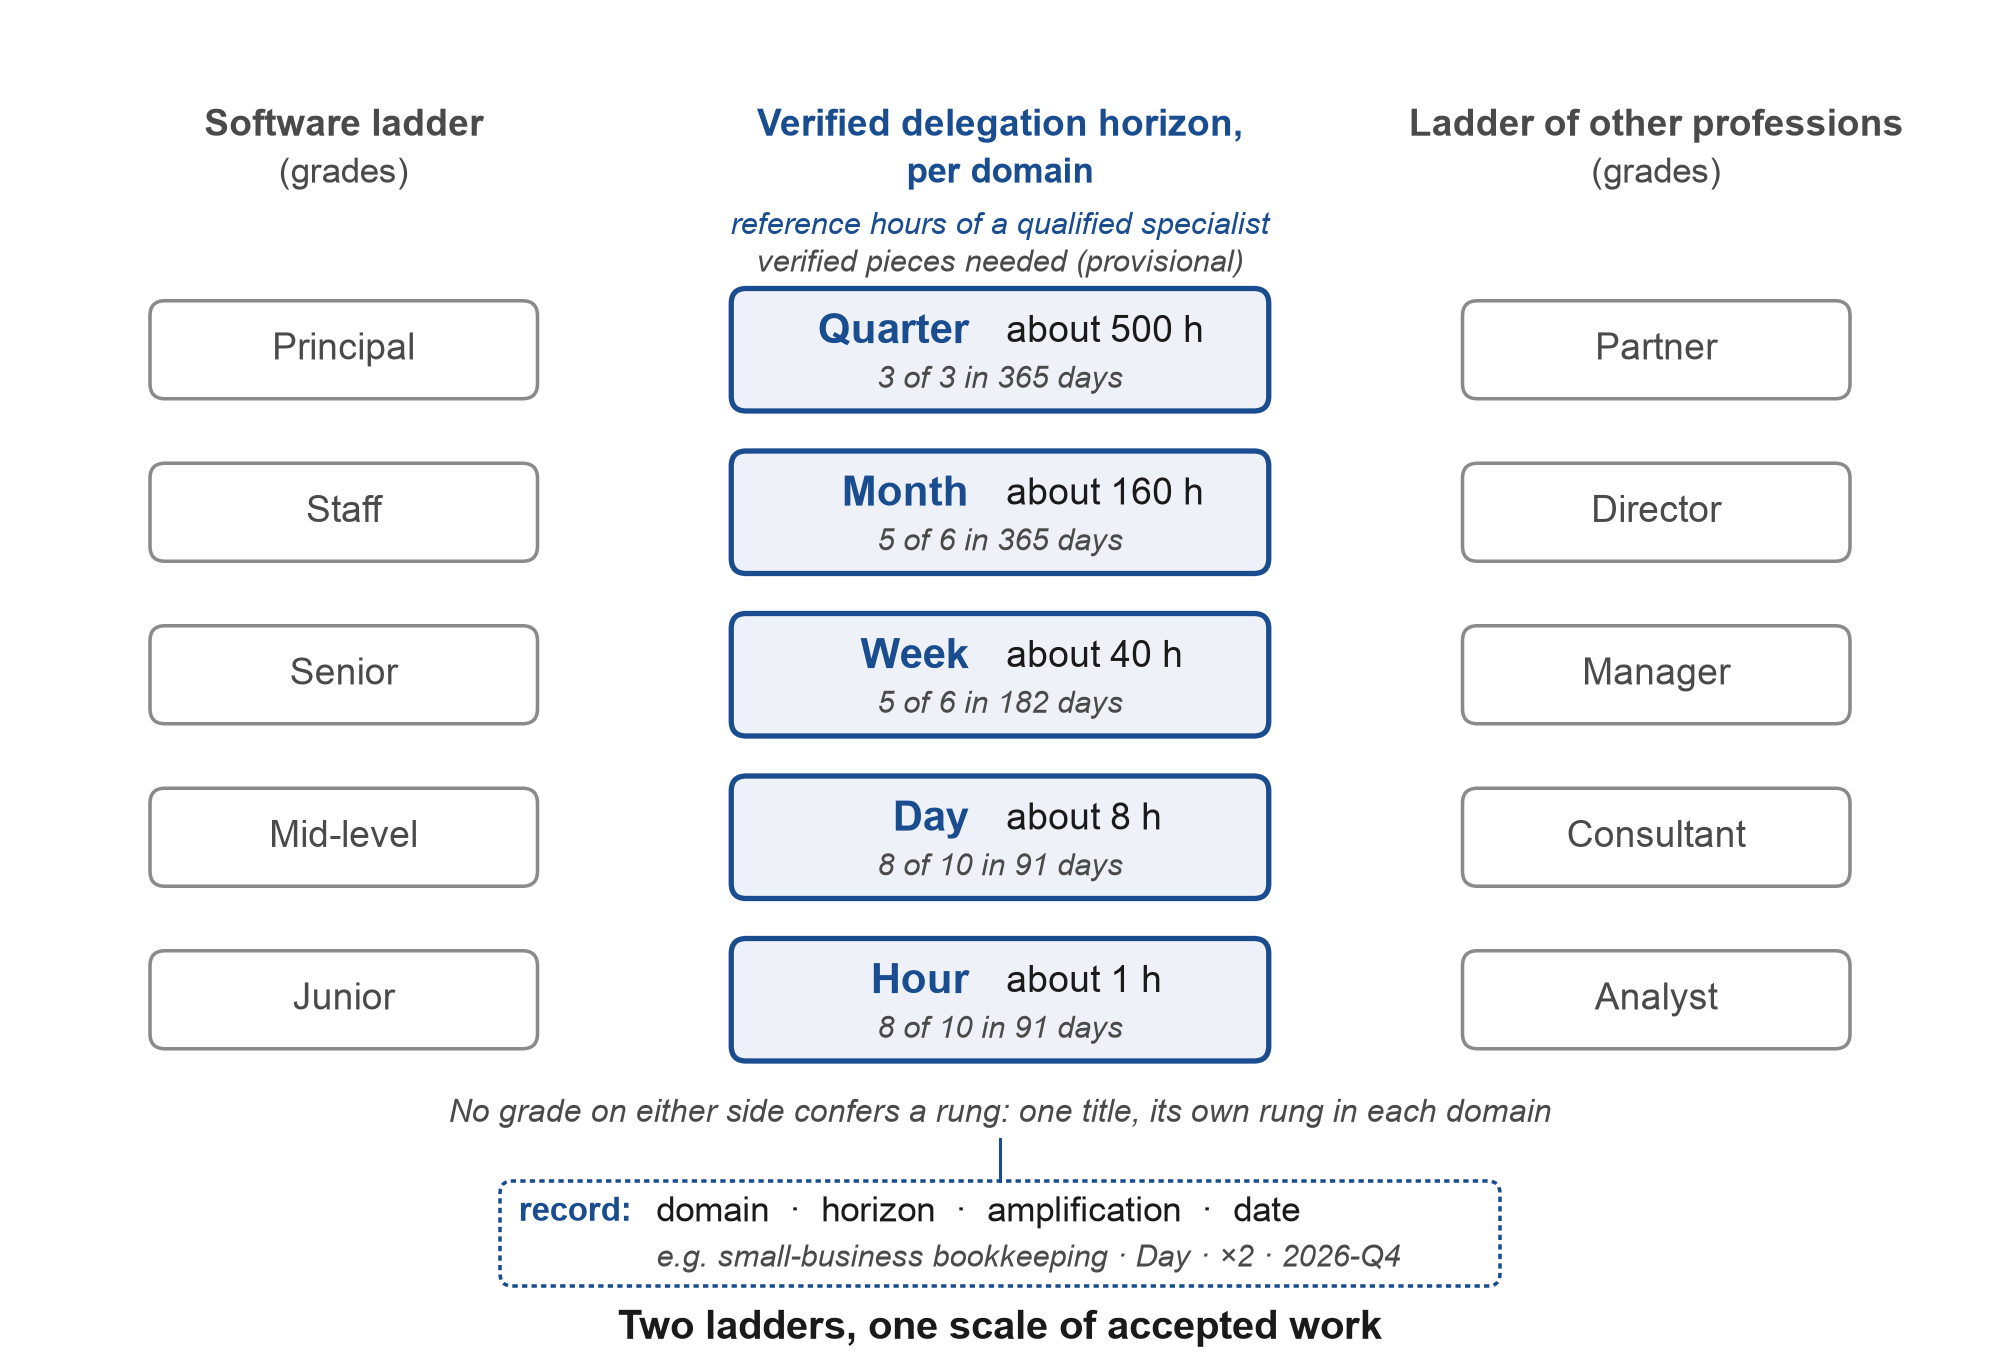
Примечание: Старые лестницы нарисованы рядом с пятью ступенями и намеренно не связаны: ни один уровень на любой лестнице не дает ступень, и один и тот же человек держит отдельную ступень в каждом домене (раздел 5.2). Ступени считаются в справочных часах квалифицированного специалиста с подсчетами и окнами раздела 5.2 (правила v1.1). Представленная запись — это та, что выведена примером с решением приложения C4.
В этих разделах Раздел 2 излагает доказательства конвергенции, а Раздел 4 описывает, как первая мера рынка провалилась, что типично для мер такого рода. Раздел 9 исследует, какие темы разговоров программистов переходят в другие профессии, а Раздел 10 выводит следствия. Раздел 12 собирает доказательства против тезиса, Раздел 13 излагает его граничные условия, и Раздел 14 подводит итоги.
2. Два мира сходятся: свидетельства 2025 и 2026 года
2.1 Профессия программиста переосмыслена
Компании-поставщики, работающие с разработчиками, теперь описывают их работу как управление агентами. В описании GitHub «новой идентичности разработчика» делегирование и проверка занимают центральное место в этой работе (GitHub, 2025b). Компания Anthropic провела опрос 132 своих инженеров и исследователей в августе 2025 года. Они сообщили об использовании ИИ примерно в 60% своей работы, о самооцененном приросте производительности примерно на 50% и описали себя как становящихся более полнофункциональными. Большинство сказали, что они могут полностью делегировать только до одной пятой своей работы, и 27% работы с поддержкой ИИ состояли из задач, которые вообще не были бы выполнены без ИИ (Anthropic, 2025a). Мера, построенная только на полной делегации, поэтому увидела бы максимум одну пятую того, что делают самые продвинутые пользователи ИИ в мире, поэтому раздел 5 добавляет вторую ось. Тот же отчет назвал это «парадоксом надзора»: надзор за моделью требует навыков кодирования, которые атрофируются, когда все ей передается.
Слова пошли вслед за работой. Анджей Карпатя ввел термин vibe coding 2 февраля 2025 года (Karpathy, 2025), Collins Dictionary назвал его словом года (Collins Dictionary, 2025), а год спустя Карпатя перешел к понятию agentic engineering. На конференции Sequoia AI Ascent 30 апреля 2026 года он сформулировал различие так: «vibe coding поднимает нижний уровень, agentic engineering экстраполирует потолок» (Karpathy, 2026; Willison, 2026a). В научной статье агентический инженер был описан как новый профессиональный архетип, при котором ответственность смещается от авторства кода к владению результатами (Alenezi, 2026), а Microsoft описал паттерны работы своих клиентов как роли: автор, редактор, директор и оркестратор (Microsoft, 2026b).
2.2 Все остальные внутри тех же агентов
Два поставщика сообщают о широком использовании агентов кодирования людьми, не занимающимися разработкой программного обеспечения, с различными ограничениями по выбору и измерению. OpenAI сообщила в июне 2026 года, что количество еженедельных пользователей своего агента кодирования, которые не являются разработчиками, возросло в 137 раз среди отдельных пользователей и в 189 раз среди организаций с августа 2025 года (OpenAI, 2026). База была невысокой, и данные принадлежат поставщику. Тот же отчет приводит распределение, которое имеет значение для раздела 5. В выборке примерно 0,1% отдельных пользователей агента в мае 2026 года 80,6% совершили по крайней мере один запрос, время выполнения которого в ручном режиме, по оценке модели, превышало 30 минут, 70,2% — по крайней мере один, превышающий час, и 25,6% — по крайней мере один, превышающий восемь часов. Это доли пользователей, выполнявших длительные запросы с оцененной моделью продолжительностью, что отличается от коэффициента завершения или проверенного горизонта, и раздел 5 объясняет, почему это различие важно. Более четверти работы агента в бизнес-функциях была инженерной работой.
Исследование Claude Code компании Anthropic, опубликованное 16 июня 2026 года, — это ближайшие к тезису общедоступные данные (Anthropic, 2026e). В нём проанализировано примерно 400 000 сеансов примерно 235 000 человек между октябрем 2025 и апрелем 2026 года. Уровень компетентности определяли по поведению на основе трех показателей: насколько точно человек сформулировал задачу, что он попросил проверить и кто кого исправлял. Бухгалтер без знания Python, который написал точные правила сверки и поймал граничные случаи, был оценен как эксперт. В сеансах, в которых был создан код, каждая из десяти крупнейших профессий отличалась от профессии программиста не более чем на семь процентных пункта по проверенному показателю успешности, где успех означает достижение, подкрепленное доказательствами, такими как прохождение тестов или выполненная работа. Классификация поставщика отчасти основана на сигналах в стенограмме сеанса, таких как явное подтверждение пользователя, и отчет отмечает, что немного более высокий показатель менеджеров может отчасти отражать то, как они оценивают успех, поэтому «проверенный» здесь — термин поставщика, а не независимая проверка. В среднем по сеансам, в которых был создан код, он составил 34% против 29% (около 30% против 26% во всех сеансах), и менеджеры показали немного лучше результаты, чем программисты. Эти данные сортируют людей по профессии и ничего не говорят об образовании: бухгалтер может иметь степень в области компьютерных наук, а программист может ее не иметь. Отчет пришел к выводу, что «агенты кодирования делают опыт программирования менее необходимым для успешного программирования». Люди принимали около 70% решений о том, что делать, а агент — около 80% решений о том, как это делать. Набор инструкций эксперта запускал примерно двенадцать действий агента, новичка — примерно пять.
Тот же сдвиг видно в источниках от компаний, не занимающихся продажей агентов. Адвокаты, от младших до партнеров, создавали рабочие прототипы своих инструментов с использованием Claude Code вместо ожидания решений от поставщиков, и доля адвокатов с широким доступом к ИИ выросла с 61% в 2025 году до 83% в 2026 году (Bloomberg Law, 2026; Artificial Lawyer, 2026). Бухгалтеры сравнивают агентов (Growthy, 2026). Lovable, конструктор приложений на основе браузера, превысил в сентябре 2026 года отметку в 600 миллионов долларов годового дохода (TechCrunch, 2026a). По одной оценке, Claude Code создал около 4% открытых коммитов на GitHub в начале февраля 2026 года (SemiAnalysis, 2026).
2.3 Лестницы под давлением
Работодатели начали переименовывать свои лестницы карьерного развития, не сказав еще, чем их заменить. С 1 июня 2026 года Deloitte дал своим примерно 181 500 сотрудникам в США новые титулы, организованные по семействам должностей, и добавил уровень лидерства (Business Insider, 2026). Его внутренние уровни и принципы оплаты остались без изменений (Fortune, 2026a), поэтому это было простое переименование без изменения критериев оценки. LinkedIn, как сообщается, заменил программу старшего менеджера продукта программой «Associate Product Builder» и открыл должность «Full Stack Builder» для людей из любого отдела (Lenny's Newsletter, 2025). Microsoft подсчитала 3 233 из 20 000 обследованных пользователей ИИ, около 16%, в качестве «Frontier Professionals», которые запускают многошаговых агентов и переделывают свои рабочие процессы (Microsoft, 2026a). Сринивасан и Вэй утверждали в Harvard Business Review в феврале 2026 года, что компаниям нужны менеджеры агентов, и ожидали, что эта должность станет стандартной в течение 12–18 месяцев (Srinivasan & Wei, 2026). Некоторые работодатели идут еще дальше и включают новую должность в объявления о вакансиях: State Street объявил о должности «Agentic Product Builder», которая по-прежнему требует навыков программирования (State Street, 2026). 7 октября 2026 года Dust представил должность «AI Operator» — человека, который создает и поддерживает общие рабочие процессы агентов (Dust, 2026).
Это заметили в найме. Доля собеседований при приеме на работу, на которых обсуждалось использование кандидатами ИИ, выросла с 0,33% в третьем квартале 2025 года до 4,54% во втором квартале 2026 года (Metaview, 2026). Вопрос появился в процессе найма до того, как была разработана система оценки ответов.
2.4 Объявления о вакансиях, найм на должности начального уровня и образование
Объявления о вакансиях в США, упоминающие «agentic AI», возросли со 151 в 2024 году до 16 541 в 2025 году (Stanford HAI, 2026). Другой подсчет, проведенный Lightcast, обнаружил более 86 000 объявлений в 2025 году, упоминающих навыки agentic AI, что составило 280% годовой рост упоминаний этих навыков и медианную объявленную зарплату $153 000; эти навыки в основном добавлялись к существующим названиям должностей (Lightcast, 2026a). The AI Index подсчитывает объявления, содержащие фразу «agentic AI», в то время как блог Lightcast подсчитывает объявления, содержащие навыки agentic в собственной таксономии, что объясняет большую часть разницы между 16 541 и примерно 86 000. Эти цифры измеряют разные вещи и здесь разделены.
Набор на начальном уровне ослабел, и причина этого спорна. LinkedIn обнаружил, что набор на начальном уровне в США в апреле–июне 2026 г. снизился на 7,6% в годовом исчислении при 6,9% для всех уровней, и в профессиях, которые дополняет ИИ, набор на начальном уровне упал на 9,6% при 6,5% для всех уровней в этих профессиях (LinkedIn Economic Graph, 2026). LinkedIn сам приписывает большую часть спада экономической неопределенности, а не ИИ, и отмечает, что среди должностей начального уровня те, которые защищены от ИИ, упали больше всего во Франции, Соединенном Королевстве и Соединенных Штатах. Обновление августа 2026 года исследования Stanford «canaries» обнаружило занятость 22–25-летних в профессиях, подверженных воздействию ИИ, примерно на 19% ниже ожидаемого, без сравнимого разрыва для опытных работников, и описывает результат как описательный (Stanford Digital Economy Lab, 2026a). Два других источника обнаруживают тот же механизм. Экономисты Федерального резервного банка Далласа, используя микроданные Обследования текущего населения, обнаружили снижение занятости, связанное с воздействием ИИ, только среди молодых работников, вызванное главным образом тем, что меньше людей переходит на работу из числа лиц, не входящих в рабочую силу, чем происходит сокращение должностей (Atkinson & Yamco, 2026). В данных резюме, охватывающих примерно 65 миллионов работников, занятость молодых специалистов в компаниях, внедривших генеративный ИИ, была примерно на 9% ниже, чем в компаниях-неадаптерах через шесть кварталов после внедрения, опять же из-за более медленного найма, нежели увольнений (Hosseini & Lichtinger, 2026). Во всей экономике Yale Budget Lab по-прежнему не находит явных признаков того, что профессии, подверженные ИИ, работают хуже, чем сравнимые неподверженные (Yale Budget Lab, 2026), поэтому давление сосредоточено на начальной ступени, а не на профессии в целом. Работодатели ссылались на ИИ в 101 743 объявленных сокращениях рабочих мест в первой половине 2026 года, примерно 23% всех объявленных сокращений (Challenger, Gray & Christmas, 2026).
Образование тоже меняется. Новые студенты бакалавриата по информатике снизились на 13% в отделениях, охваченных обследованием Taulbee 2026, которое охватывает факультеты, предоставляющие докторские степени, в Северной Америке; авторы описывают это как первые явные признаки сокращения конвейера поступлений, наряду с рекордным производством дипломов (Computing Research Association, 2026). Полевой эксперимент с 673 немецкими IT-стажерами обнаружил прирост в 26–31 процентный пункт по задачам вне их формального обучения при наличии ИИ (Stanford Digital Economy Lab, 2026b). Совместная рамочная программа OECD и Европейской комиссии от июня 2026 года включает область, названную «Manage AI» (OECD & European Commission, 2026).
Таблица A1 (Приложение F) содержит список десяти сигналов этой конвергенции с их источниками, и для каждого показывает, что он демонстрирует и что не демонстрирует. Прочитанные вместе, они также показывают, где отсутствуют измерения: данные поставщиков об использовании агентов кодирования не-разработчиками показывают рост, но не качество их результатов. Близость профессий с проверенным успехом касается самой профессии, а не уровня квалификации. Переименованные карьерные лестницы и сегменты обследения — это названия, а не измерения. И более слабая начальная ступень не показана как вызванная ИИ.
Эти сигналы показывают, с известной степенью уверенности, что внедрение и признание работы с агентами теперь происходит по обе стороны от старой границы, и что работодатели, школы и поставщики начали переименовывать вещи. Могут ли люди вне сферы разработки программного обеспечения выполнять эту работу так же хорошо, как программисты? Сигналы оставляют это открытым, и они также не предоставляют для этого меру. Раздел 5 предлагает меру, Раздел 11 указывает даты для вопроса о качестве, и Раздел 12 излагает доказательства, которые прогнозы должны преодолеть.
Свидетельства 2026 года разделяют людей, которые могут показать, что результат верен, от людей, которые не могут. Образование в области программирования — один путь к этой способности. Владение дисциплиной, привычка проверки и инструменты для проверки — другие, и данные из Раздела 2.2 предполагают, что они могут служить заменой первому чаще, чем предполагают старые лестницы, хотя еще не то, что они всегда могут. Мера из Раздела 5 разработана для проверки этого утверждения.
3. Имена в обращении: датированная карта
3.1 Почему я не выбираю имя
Каждые несколько недель в 2026 году компания или консультант, иногда журнал, предлагали имя для людей, описанных здесь, и некоторые из этих имён утвердятся. Поскольку использование остаётся неустановившимся, я делаю две вещи вместо того, чтобы рекомендовать одно: составляю карту имён, уже находящихся в обращении, включая те, которые заняты, с указанием того, кто ввёл каждое, когда и в каком смысле, и предлагаю меру, по которой любое из них можно читать. Если побеждает «строитель», запись читается как «строитель на неделю»; если побеждает «менеджер агентов», она читается как «менеджер агентов на день». Приоритет отдаётся мере, лестнице, определениям и предсказаниям, включая термины, которые их называют (проверённый горизонт делегирования, прирост усиления, точка пересечения полномочий), а не названиям ролей; названия ролей, добавленные в разделе 3.3, предлагаются как кандидаты без приоритета.
3.2 Шесть слоёв
Кандидаты конкурируют не за одно место. Одни называют навык, который будет иметь почти каждый, другие — профессию, меру, момент, партнёра или сигнал, который не сработал. Таблица A2 (Приложение F) перечисляет уже используемые имена с указанием их авторов, а во второй части — имена, предложенные в этом исследовании или используемые здесь только как простые описания, вместе с вариантами, которые рассматривались и были отложены в сторону, чтобы читатель мог увидеть всю семью. На рисунке 2 имена расположены по слоям и по датам их введения.
Рисунок 2. Имена в обращении, по слоям и по датам их введения.
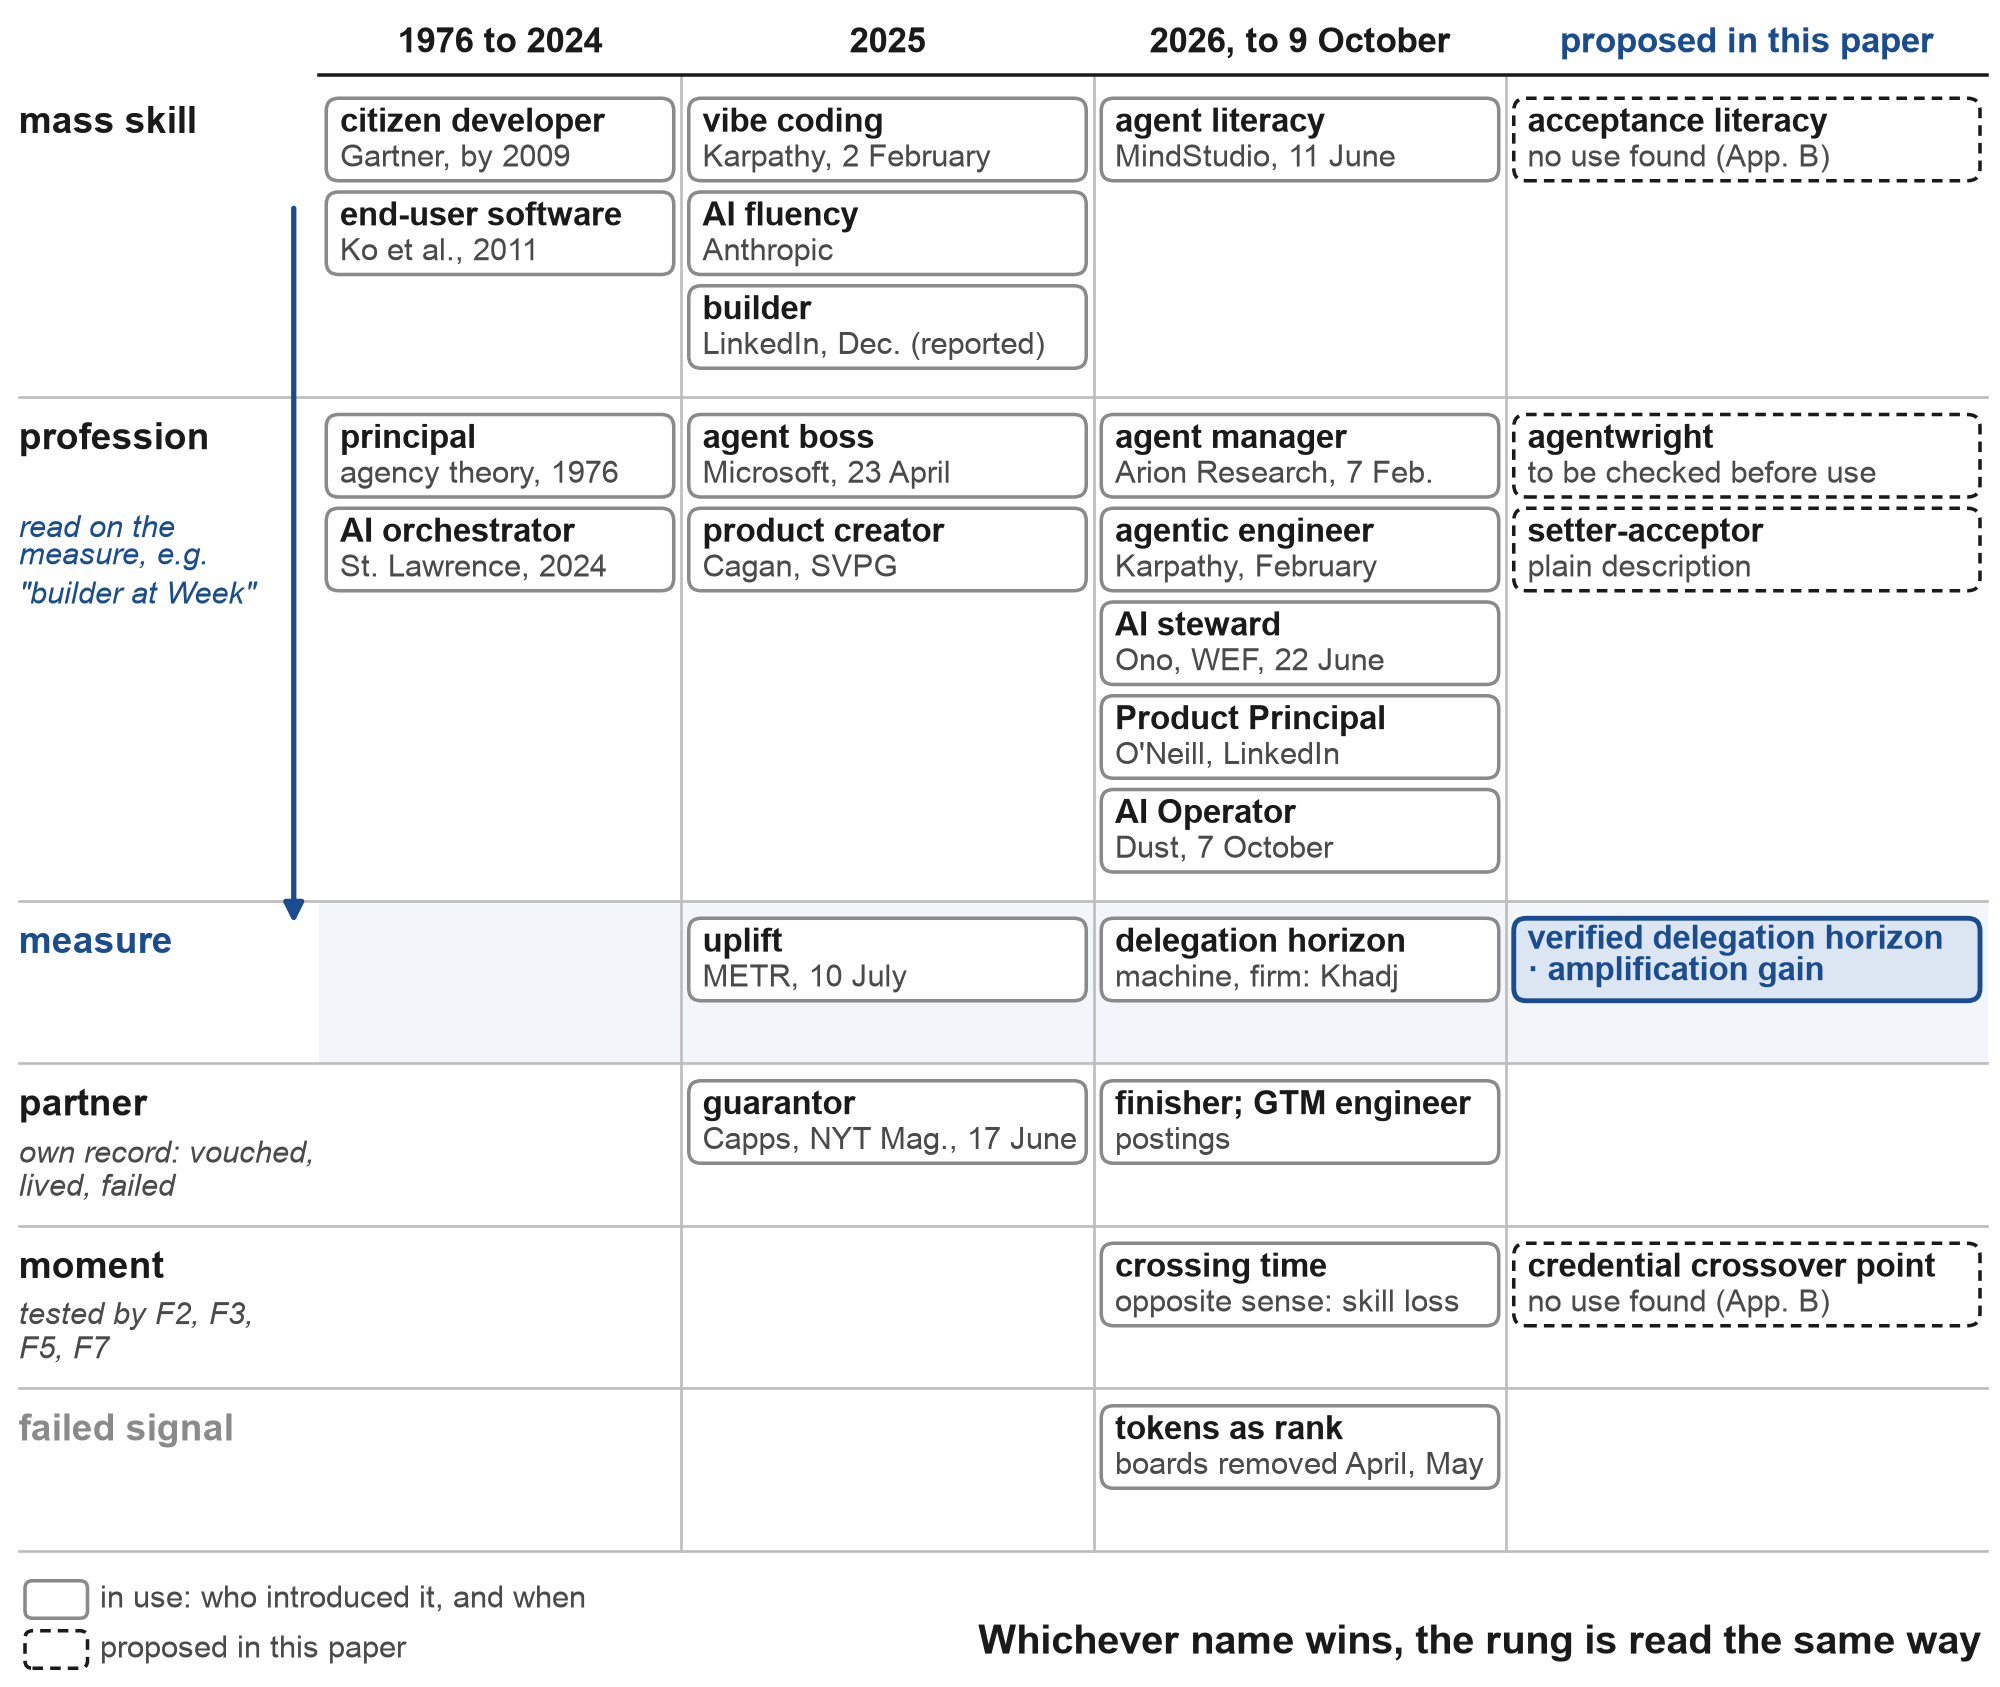
Примечание: авторы и даты соответствуют таблице A2. Имя, источник которого указывает только год, месяца не указывает. Рисунок представляет выборку; таблица A2 перечисляет каждого кандидата. Только слои массового навыка и профессии читаются по мере («строитель на неделю», «менеджер агентов на день», раздел 3.1). У партнёра есть собственный учёт — сколько продуктов было одобрено, как долго каждый функционировал и сколько потерпело неудачу (раздел 7.2), а момент не является ступенькой, а проверяется датированными предсказаниями F2, F3, F5 и F7 (раздел 11.2). «Горизонт делегирования» в строке мер — это смысл машины или фирмы (Khadj, 2026; Alonso, 2026), а не личная мера раздела 5. Рисунок не выносит суждения о том, какое имя будет преобладать.
3.3 Замечания по карте
«Строитель» вероятно побеждает в массовой HR: LinkedIn приняла это слово, и журналисты писали в 2026 году, что теперь каждый в Bay Area — строитель (SF Standard, 2026). Нет причины сопротивляться слову, поскольку оно ничего не говорит об уровне, а уровень — это то, что даёт мера.
Управленческие имена (менеджер агентов, оператор ИИ, оркестратор) являются горизонтальными: они описывают управление агентами в целом, ни в одной конкретной области. Раздел 6.3 даёт причину ожидать, что они последуют за инженером промптов, должностью, которая была везде в 2023 году и была названа устаревшей в 2025 году (Fortune, 2025; TechRepublic, 2025).
«Принципал» имеет самую сильную теорию позади и наихудшие столкновения. В теории агентства принципал — это сторона, которая делегирует и оплачивает издержки мониторинга (Jensen & Meckling, 1976), и конституция Anthropic для своих моделей называет «принципалами» тех, в интересах которых действует модель (Anthropic, 2026b). Verheul (2026) утверждает, что когда машины выполняют функцию агентства, люди в фирме занимают только должности принципала, и карьерная лестница исчезает. Я принимаю этот диагноз и предлагаю взамен новую лестницу. Однако в управлении идентификацией и доступом «agent principal» называет собственную идентичность агента, что является обратным смыслом, поэтому английская фраза «Agent Principal» не должна использоваться для человека. «Product Principal» O'Neill является прецедентом почти в этом смысле и цитируется как таковой, и фреймворк AIDEs компании JetBrains уже описывает уровни разработчиков как свойства отношения principal-agent (Tikhomirov, 2026).
Предложенные здесь имена (agentwright, setter-acceptor, agent director) присоединяются к семейству как кандидаты, и ни одно из них не является фаворитом. Agentwright свободен в поисковых базах, которые были просмотрены, но поисковые системы разбивают его на «Agent Wright», это звучит как инструмент тестирования браузера, который знают разработчики, и к октябрю 2026 года слово уже использовалось для пакета Python и каталога навыков агентов, поэтому оно остаётся вариантом, требующим дополнительного уточнения.
Одно наблюдение о значении можно записать, не отнимая выбор у рынка. По смыслу «принципал» находится ближайшим образом к профессии раздела 8, работе, выполняемой для других с ответственностью за результат, а «строитель» ближайшим образом к массовому навыку, работе, выполняемой для себя.
4. Зачем нужна мера: год, когда токены попробовали в качестве показателя старшинства
Рынок не дождался единой шкалы. В 2026 году он попробовал несколько, и поскольку эпизоды различаются по характеру, они здесь разделены в порядке их возникновения.
В Meta сотрудник создал внутреннюю панель под прозвищем "Claudeonomics", которая ранжировала примерно 85 000 коллег по потребленным токенам, более 60 триллионов из них за тридцать дней (Shopifreaks, 2026a). Это был проект одного сотрудника, не имевший официального статуса, и он был отключен в апреле после того, как был опубликован вне компании. Официальная позиция Meta развивалась отдельно. С февраля использование ИИ стало формальной частью оценки сотрудников, а в начале сентября WIRED и CIO сообщили о новом руководстве, в соответствии с которым Meta «не будет использовать панели внедрения ИИ или подсчет токенов для оценки влияния» и исключила метку «AI Native» в качестве критерия (CIO, 2026b; Shopifreaks, 2026b). В Amazon таблица лидеров по использованию токенов была сфальсифицирована пустыми задачами и удалена в мае (CIO, 2026a), что является законом Гудхарта в его чистейшей форме: как только мера стала целью, она перестала измерять. Случай Uber — это бюджетный инцидент. Компания потратила свой годовой бюджет на ИИ за четыре месяца и ограничила расходы сотрудников суммой $1 500 в месяц (Fortune, 2026b). В июле генеральный директор Cognition сказал, что компании должны измерять производительность, а не использование ИИ (Fortune, 2026c).
Контрпримеры имеют не меньшее значение. Shopify добавляет вопросы об использовании ИИ в свои оценки производительности и взаимные оценки коллег (Shopify, 2026), и один комментатор ожидает, что метрики токенов будут «понижены в рейтинге, но не убраны» (Kingy AI, 2026). Вопросы о том, как человек использует ИИ, отличаются от ранжирования по объему, и прогноз F8 в разделе 11 их различает.
Обсуждения разработчиков, рассмотренные в разделе 9, показывают такой же инстинкт у отдельных людей. Они представляют себя входными данными: ежемесячным счетом за ИИ в размере $1 148, скриншотом подписки, примерно 330 из 600 выполненных запросов на включение (единица, описанная в обсуждении как очень приблизительная), 36 этапами, построенными за три дня. Один из них опубликовал сбережения, которые его агент рассчитал для него без проверки расчета, что является повторением эпизода с токенами одним человеком. Каждый из них учитывает то, что было потрачено или произведено; то, что было принято, кем и после какой проверки, остается незафиксированным.
Я делаю один прямой вывод для этой меры: считайте работу, и только работу, которая прошла проверку, которую не проводили агенты. Согласие между моделями одного семейства не может быть такой проверкой, потому что их ошибки коррелируют и их согласие несет меньше независимых свидетельств, чем кажется (Chernets, 2026b). Трата большего количества токенов не может завысить меру, построенную таким образом, поскольку неподтвержденная работа ничего к ней не добавляет. Остаются другие способы ее завышения, и раздел 5.8 перечисляет их с их защитами.
5. Метрика: верифицированный горизонт делегирования и коэффициент усиления
5.1 Контрольные часы
Обе оси используют одну единицу — контрольный час: время, которое потребовалось бы квалифицированному специалисту для выполнения того же объёма работы вручную. Контрольная база выбрана сознательно. Способность самого человека выполнить работу не учитывается при измерении, равно как и его подготовка. И инструмент по сверке счётов бухгалтера, и модуль выставления счётов разработчика измеряются по тому, сколько времени потратил бы на них компетентный специалист.
Контрольные часы берут из одного из двух источников. Один — это замороженный банк задач, на выполнение которых вручную потребовалось время, измеренное в 2025–2026 годах; GDPval, составленный из задач 44 профессий и времени работы их экспертов, показывает, что такой банк можно построить (Patwardhan et al., 2025). Другой — два независимых эксперта, которые оценивают затраченное время, не зная, кто выполнял работу; если мнения экспертов в области расходятся слишком сильно, контрольное значение может быть вместо этого медианой откалиброванной панели из пяти-девяти экспертов, оценённых по рангам (Приложение G2). Я намеренно замораживаю банк так же, как когда-то метр хранился в хранилище близ Парижа, потому что через несколько лет мало кто будет выполнять эти задачи вручную, и не останется ничего, с чем можно было бы сравнивать. Банк должен содержать, для каждой области, задачи всех рангов, каждую с письменным описанием того, что считается выполненной работой, измеренным вручную временем, скрытыми проверками и несколькими подставленными ошибками, обнаружение которых является частью процесса принятия. Время выполнения задач GDPval вручную — это проверенные самоотчёты экспертов, а время проверки было измерено, что является стандартом, которому должен соответствовать или превосходить банк. Чтобы метрика не судила сама себя, горизонт оценивается на одном наборе задач, а качество, используемое для проверки гипотез об этом (Раздел 6), — на другом.
5.2 Верифицированный горизонт делегирования
Определение. Верифицированный горизонт делегирования человека в той или иной области — это наибольший объём работы в контрольных часах, при котором человек регулярно передаёт работу агентам, принимает её и подтверждает независимой проверкой, которую агенты не видели.
Правило одним абзацем. Делегированная работа считается верифицированной и попадает в горизонт только в том случае, если выполняются все следующие условия. Она должна быть задана с письменным описанием того, что считается выполненной работой, и её контрольные часы должны поступать из банка или от двух экспертов. Человек должен принять её как единый согласованный результат: месяц работы, разбитый на 160 билетов по одному часу, считается 160 часами, тогда как работа, выполненная в несколько этапов и принятая как единое целое, считается целиком по контрольным часам этого целого. Независимая проверка должна была её подтвердить, и проверка является независимой, когда она отличается от работы агентов по данным (входные данные, которые агенты не производили), по доступу (агенты не могли их видеть или редактировать) и по стимулам (тот, кто её проводит, не получит выгоды от положительного результата). Четыре типа проверок приемлемы: скрытые приёмные тесты, проверка квалифицированным человеком, реальное использование целевыми пользователями или модель другого семейства, которая проверяет доступные источники и выносит проверяемое решение. Самопроверка и согласие между моделями одного семейства не учитываются, потому что их слепые пятна совпадают со слепыми пятнами самих агентов. В пределах временного окна ранга (91 день на уровне Hour и Day, 182 дня на Week, 365 дней на Month и Quarter) человек должен был принять требуемое количество работ размером не менее установленного: десять на уровне Hour и Day, шесть на Week и Month и три на Quarter, и по крайней мере восемь из десяти должны были пройти проверку, что означает пять из шести на Week и Month и все три на Quarter. Начиная с уровня Week, по крайней мере одна из этих работ должна содержать подставленные ошибки. Пропуск одной подставленной ошибки любого рода блокирует ранги от Week и выше на данное временное окно, и работа с такой ошибкой не считается ни по рангу, ни по коэффициенту усиления. Если ошибку нельзя исправить (деньги переведены, медицинская запись пациента, документ, который нельзя отозвать), каждая такая работа должна пройти проверку, при этом скрытый тест или проверка квалифицированным человеком служит первой линией, а модель другого семейства — второй линией, и более строгое правило применяется только к этим работам. Каждая передача работы регистрируется, включая неудачи и заброшенные работы, с указанием затраченного на них внимания. Ранг подтверждается снова каждый квартал: на уровне Week и выше по крайней мере одна верифицированная работа размера ранга должна приходиться на последние 91 день, поэтому горизонт не может опираться на работу, выполненную близко год назад. Приведённые ниже абзацы дают обоснование каждой части.
Правило оценки. В пределах временного окна, установленного для каждого ранга (91 день для Hour и Day, 182 для Week, 365 для Month и Quarter), ранг учитывается, если человек принял требуемое количество работ размером не менее установленного в области (десять для Hour и Day, меньше выше, как указано ниже), и по крайней мере восемь из десяти прошли проверку одного из этих типов: скрытые приёмные тесты, проверка квалифицированным человеком, реальное использование целевыми пользователями или модель другого семейства, которая проверила доступные источники. Самопроверка и согласие между моделями одного семейства не учитываются. Если ошибку нельзя исправить (деньги переведены, медицинская запись пациента, документ, который нельзя отозвать), каждая такая работа должна пройти проверку, и более строгий порог применяется только к этим работам. Для этих работ проверка по умолчанию — скрытый тест или квалифицированный человек, с моделью другого семейства в качестве второй линии.
Верхние ранги. Требование в десять работ было бы недостижимо для верхних рангов, поскольку десять работ по 40 контрольных часов за три месяца составляют 400 часов специалиста, а десять работ по 500 часов — 5000 часов. Правило поэтому расширяет окно и снижает требуемое количество по мере возрастания ранга: десять работ за 91 день для Hour и Day, шесть за 182 дня для Week, шесть за 365 дней для Month и три за 365 дней для Quarter, с одинаковой долей восемь из десяти (что означает пять из шести для Week и Month и все три для Quarter). Более ранняя версия требовала четырёх из четырёх для Month; проверка, описанная в Приложении E, показала, что это делало Month более трудным для получения, чем Quarter для человека любой надёжности, и количество было изменено. Начиная с уровня Week, по крайней мере одна работа размера ранга в пределах окна должна содержать подставленные ошибки. Любую подставленную ошибку, которую человек пропустит, независимо от её типа, блокирует ранги от Week и выше на данное временное окно, и работа с пропущенной подставленной ошибкой не считается верифицированной, ни по рангу, ни по коэффициенту усиления. Quarter предназначена оставаться редким рангом, и приведённые выше количества установлены таким образом, чтобы это было так.
Каждая передача фиксируется в журнале. Журнал записывает каждый фрагмент работы, переданный агентам, включая те, которые не прошли проверку и те, что были брошены до её завершения, и только фрагмент, принятый как один целостный результат, засчитывается в ступень. Месяц работы, разбитый на 160 часовых задач, составляет 160 часов, а не месяц: опорные часы оцениваются для результата, который пользователь, клиент или рецензент принимает как целое, в духе связанных задач METR. Верно и обратное: работа, выполняемая этапами и принятая как один целостный результат, засчитывается полностью по опорным часам этого результата, независимо от того, сколько этапов потребовалось.
Независимость. Проверка является независимой, если она отличается от агентов по данным (использует входные данные, которые агенты не производили), по доступу (агенты не могли её видеть или редактировать) и по стимулам (тот, кто её проводит, не получает выгоды от положительного результата). Модель другого семейства добавляет разнообразие ошибок. Она считается действительной только если проверяет источники, которые открыл человек, и её заключение служит одним из входных данных, которые можно проверить.
Один фрагмент работы проходит этот путь (рис. 3). Задача ставится с письменным описанием того, что будет считаться выполненным. Её опорные часы берутся из банка или от двух рейтеров. Агенты выполняют работу, пока человек уделяет внимание, что фиксируется. Человек принимает, отклоняет или бросает фрагмент, независимая проверка подтверждает или опровергает, и строка журнала записывается в этот момент с датой начала в отдельном поле, где это имеет значение. Если существует отложенный результат (принятый документ, выпуск, всё ещё работающий спустя месяц), он записывается при его поступлении. Горизонт и коэффициент вычисляются из этих записей с указанием даты.
Рис. 3. Один фрагмент работы, одна запись.
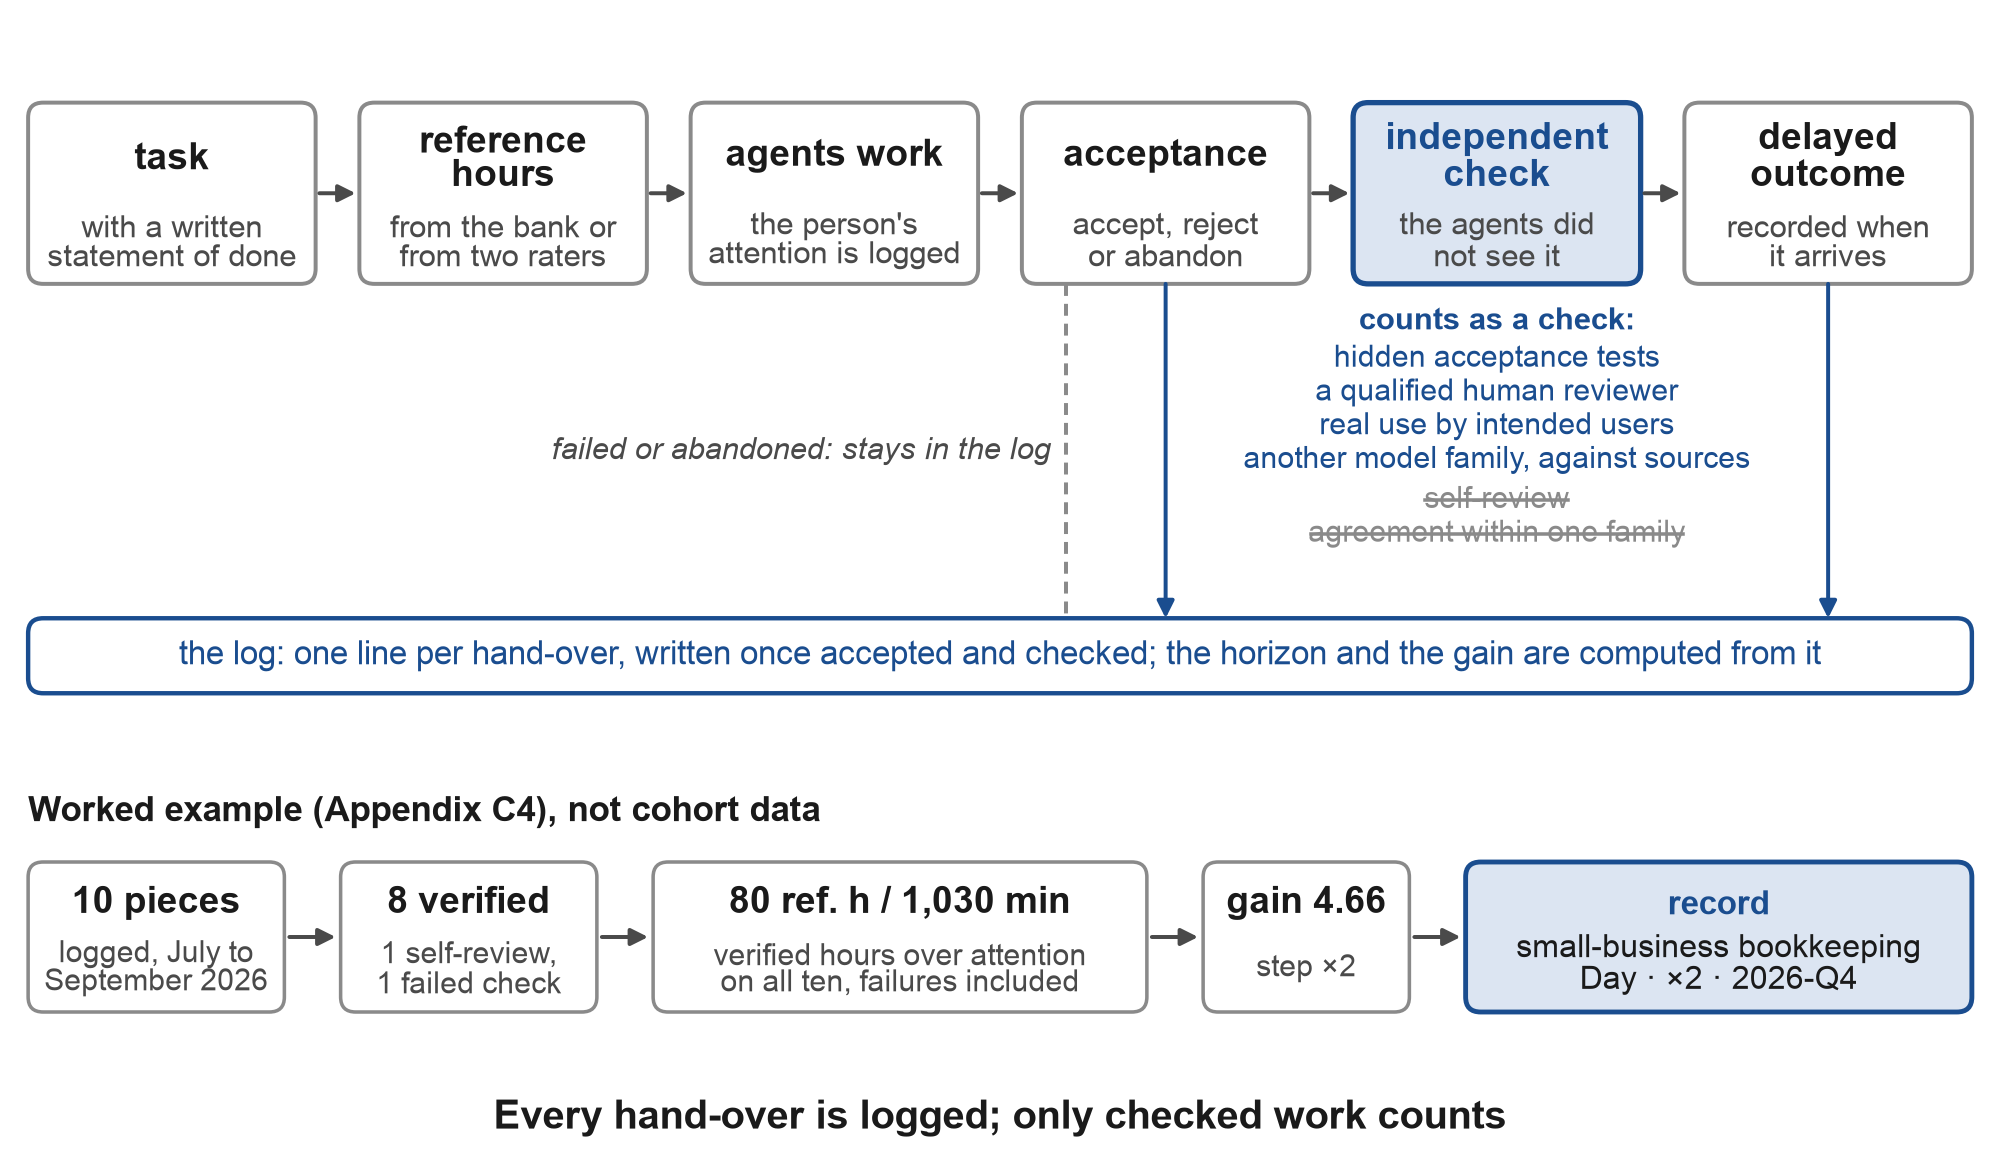
Примечание: верхний ряд — путь раздела 5.2. Четыре типа независимой проверки — это четыре типа правила оценки. Самопроверка и согласие между моделями одного семейства не считаются. Не прошедшие и брошенные фрагменты остаются в журнале и добавляют свои минуты к знаменателю коэффициента усиления. Нижний ряд — проработанный пример из приложения C4, конструируемый журнал, а не данные когорты: десять фрагментов, восемь проверено, 80 опорных часов против 1030 минут внимания, коэффициент усиления 4,66 (шаг ×2) и запись "малый бизнес · бухгалтерия · день · ×2 · 2026-Q4".
Переверификация. Горизонт подтверждается снова каждый квартал. Парадокс надзора Anthropic (раздел 2.1) объясняет почему: горизонт, заработанный при одновременном снижении навыков проверки, заимствуется, и ежеквартальная проверка показывает, остаётся ли он действительным. Для ступеней, чьи временные окна превышают квартал (неделя, месяц и квартал), проверка имеет конкретную форму: хотя бы один проверенный фрагмент размером в ступень должен попадать в последние 91 день, чтобы ступень не опиралась на фрагменты, близкие к году давности.
5.3 Лестница
Я называю пять ступеней в единицах времени, потому что единицы времени не требуют перевода между профессиями, могут быть прочитаны из журналов и растут с технологией без переименования. Таблица 1 приводит их с примерами и необходимое количество для каждой.
Таблица 1. Лестница проверенного горизонта делегирования.
| Ступень | Размер переданной и проверенной работы | Пример в программном обеспечении | Пример в других областях | Требуется проверенных фрагментов, окно |
|---|---|---|---|---|
| Час | Около 1 опорного часа | Скрипт, небольшое исправление | Ответы из стека документов | 8 из 10 в 91 день |
| День | Около 8 | Функция, небольшой внутренний инструмент | Месячный отчет с его проверками | 8 из 10 в 91 день |
| Неделя | Около 40 | Сайт или внутренний инструмент по спецификации с ночными запусками | Полный пакет проверки надлежащей осмотрительности, система кампании | 5 из 6 в 182 дня |
| Месяц | Около 160, обычно в нескольких потоках | Выпуск продукта; правила приёма, по которым работают другие | Инструментарий практики с правилами, по которым работают коллеги | 5 из 6 в 365 дней |
| Квартал | Около 500 | Линия продукции с живыми пользователями | Линия услуг, работающая через агентов | 3 из 3 в 365 дней |
Примечание: ступень заработана только по правилу оценки раздела 5.2, отдельно в каждой области, с подсчётом правил v1.1 (приложение E). Никакая оценка по старой лестнице не даёт ступень, и человек может быть на уровне "неделя" в финансовых инструментах и на уровне "день" в веб-приложениях.
Запись для резюме или файла HR содержит область, горизонт, коэффициент усиления и дату, например "малый бизнес · бухгалтерия · день · ×2 · 2026-Q4". Дата присутствует в записи, потому что одна и та же ступень будет означать нечто иное год спустя, по мере развития технологии.
5.4 Коэффициент усиления
Не каждый, кто хорошо работает с агентами, передаёт им большие фрагменты. Один из разработчиков из раздела 9, который строит на четырёх машинах, описывает три из них как "усиление личной эффективности" без автономного агента на них. Автономные агенты, которых он также использует, "не прижились" для ежедневной работы, пишет он, и он предпочитает "усиление, а не делегирование" (в переводе). Его самый длинный поток включал 36 этапов за три дня, каждый этап передавался и коммитился, затем агента просили подтвердить, что всё было развёрнуто. По правилу раздела 5.2, это подтверждение является самопроверкой, поэтому его запись, как она опубликована, не показывает никаких проверенных ступеней, и тема не даёт цифр для его коэффициента. Где он стоял бы при независимой проверке, зависит от того, что было принято. Если 36 этапов были приняты как один целостный результат, поток считается полностью, по его опорным часам, как этапированная работа из приложения C, раздел C4. Если каждый этап был принят отдельно, каждый является небольшим фрагментом и он стоит на уровне "час" по первой оси. Пост не уточняет, какой сценарий был применён. Однако он строит инструменты, которые заменяют программное обеспечение, которое он раньше покупал, и он называет время единственным узким местом, сам обозначая знаменатель второй оси.
Он не исключение. Anthropic сообщила, что пользователи с опытом шести месяцев и более были «намного менее склонны делегировать большую ответственность через директивные модели использования», работали с моделью более итеративно и приносили более сложные задачи с успехом на три–пять пунктов выше после контроля (Anthropic, 2026d). В Claude.ai совместное использование опередило автоматизацию 52% против 45% в ноябре 2025 года, а разговоры имели успех чаще, чем одноразовые программные запросы, 67% против 49% (Anthropic, 2026a). Люди в более высокооплачиваемых профессиях делали примерно в 1,5 раза больше ходов, а женщины автоматизировали на 7,3 пункта меньше, чем мужчины в той же профессии (Anthropic, 2026f). В опросе Stanford среди 1500 работников наиболее предпочтительный вариант в 47 из 104 профессий было равноправное партнерство между человеком и агентом (Shao et al., 2025). Мера, основанная только на делегировании, поэтому недооценила бы наиболее опытных пользователей, наиболее высокооплачиваемых и женщин, хотя ничто в этих данных не указывает, что их работа хуже.
Определение. Коэффициент усиления производительности — это справочные часы принятой, проверенной работы, разделённые на часы внимания, затраченные на неё человеком, за последние 91 день в области, независимо от временного окна ранга человека. Работа, выполненная с внешней помощью (коллега или подрядчик, исправляющий её вне журнала), записывается как таковая и ничего не добавляет в числитель, в то время как минуты человека на её выполнение остаются в знаменателе. Внимание включает планирование, инструктаж, чтение, проверку и исправление. Время, в течение которого агент работает, пока человек занимается чем-то другим, не считается.
Коэффициент усиления производительности — это проверенная пропускная способность: принятые, проверенные результаты в час внимания. Это не причинная оценка того, насколько быстрее одна и та же личность работает с агентами, чем без них. Усиление в этом сравнительном смысле требует базового уровня — того же человека или подобранных людей, выполняющих один и тот же вид работы без агентов, и только сравнительное исследование может его предоставить.
Невыполненная работа ничего не добавляет в числитель и все её минуты в знаменатель, что делает самообман видимым. В испытании METR 2025 года опытные разработчики полагали, что ИИ их ускорил, в то время как измерения показали, что они работали на 19% медленнее (METR, 2025).
Шаги второй оси — это ×1 («день за день»), ×2, ×5 («неделя за день»), ×20 («месяц за день») и ×60 («квартал за день»). Две шкалы независимы, поэтому шаг на одной не равен ступени на другой. Когда человек запускает несколько агентов параллельно, внимание всё ещё считается один раз, в собственных минутах человека: час, потраченный на наблюдение трёх потоков, — это один час в знаменателе, разделённый между фрагментами пропорционально минутам, записанным для каждого. Оценка сообщается вместе с установкой, которая её произвела (модель и инструменты, вид проверки и ранг задач), потому что один и тот же человек будет иметь разные оценки под более строгой проверкой.
5.5 Две оси, четыре профиля и потолок
Расположение людей по обеим осям дает четыре профиля (Рисунок 4). Ученик имеет короткий горизонт и низкое усиление. Усилитель имеет короткий горизонт и высокое усиление, как строитель 36 этапов, если бы его этапы принимались один за другим. Делегатор имеет длинный горизонт и высокое усиление. Четвёртый профиль, который я называю надзирателем, — это длинный горизонт с низким усилением: агенты работают долгое время, а проверка и переделка сводят на нет выгоду, поэтому это скорее предупредительный знак, чем ранг.
Две оси связаны потолком. Внимание уходит на подготовку работы и на её проверку. Обозначим H справочные часы работы, V часы внимания, затраченные на её проверку, и S часы, потраченные на подготовку. Тогда коэффициент усиления G = H / (S + V + переделка), и поэтому G ≤ H / V. Если только проверка занимает четверть времени ручной работы, коэффициент усиления не может превышать ×4, независимо от того, как долго агент работает без присмотра. По тому же ограничению, шаги ×2, ×5, ×20 и ×60 доступны только когда проверка занимает не более чем 50%, 20%, 5% и около 1,7% времени ручной работы (Рисунок 4). Это упрощённая модель с заявленными пределами учёта: она игнорирует ценность работы, которую человек вообще не мог бы выполнить, она предполагает, что время проверки зависит от объёма работы, и она применяется к отдельной работе, поэтому человек, который дёшево проверяет малые работы, может превзойти потолок, вычисленный для больших работ. На уровне экономики Catalini et al. (2026) делают то же самое: связывающим ограничением становится «человеческая пропускная способность верификации», и открывается «Пробел в измеримости» между тем, что агенты могут выполнить, и тем, что люди могут позволить себе проверить.
GDPval показывает, что означает это ограничение на практике. На его 220-задачном золотом подмножестве его эксперты сообщили (и авторы проверили), что в среднем 404 минуты на задачу вручную, а проверка результата работы заняла измеренные 109 минут, около 27%, что ставит потолок около ×3,7 для задач такого вида. Модели создавали свои черновики в 90–327 раз быстрее, чем эксперты. Однако в сценарии, когда человек пробует модель, а затем исправляет её работу, расчёт авторов (не измерение) дал GPT-5 ускорение 1,12 при одной попытке модели и 1,39 при нескольких попытках, два отдельных столбца одной таблицы (Patwardhan et al., 2025). Независимо от скорости агента, цена проверки устанавливает потолок, и эта цена растёт с рангом, так как более крупная работа стоит больше проверять. Kamara (2026) называет эту стоимость friction верификации. Практики в обсуждениях раздела 9 выражают это своими словами: после определённого момента, проверка кода агента «всё меньше и меньше отличается от переписывания его вручную», и может занять больше времени, чем писать его самому (переведено).
Один и тот же коэффициент усиления можно достичь двумя путями. Длинный поводок передаёт большую работу и проверяет её в конце; короткие, быстрые циклы передают малые работы и проверяют каждую по мере её поступления. Моя гипотеза состоит в том, что проверка малых работ по ходу дела часто дешевле, чем проверка большого результата в конце, и данные Anthropic указывают в этом направлении. Разговоры имели успех чаще, чем одноразовые запросы, и согласно экстраполяции самих авторов одноразовые запросы достигают 50% успеха на задачах около 3,5 часов, в то время как разговоры достигали бы этого на задачах около 19 часов (Anthropic, 2026a). Доля совместного использования упала ниже автоматизации в августе 2025 года и вернулась в лидерство, 52% против 45%, к ноябрю. Путь с короткими циклами близок к тому, что изучает литература о сотрудничестве человека и ИИ, и коэффициент усиления производительности это учитывает так же, как длительное делегирование. Прогнозы F19–F21 в разделе 11 тестируют путь с короткими циклами.
Рисунок 4. Две оси, четыре профиля и потолки, которые устанавливает проверка.
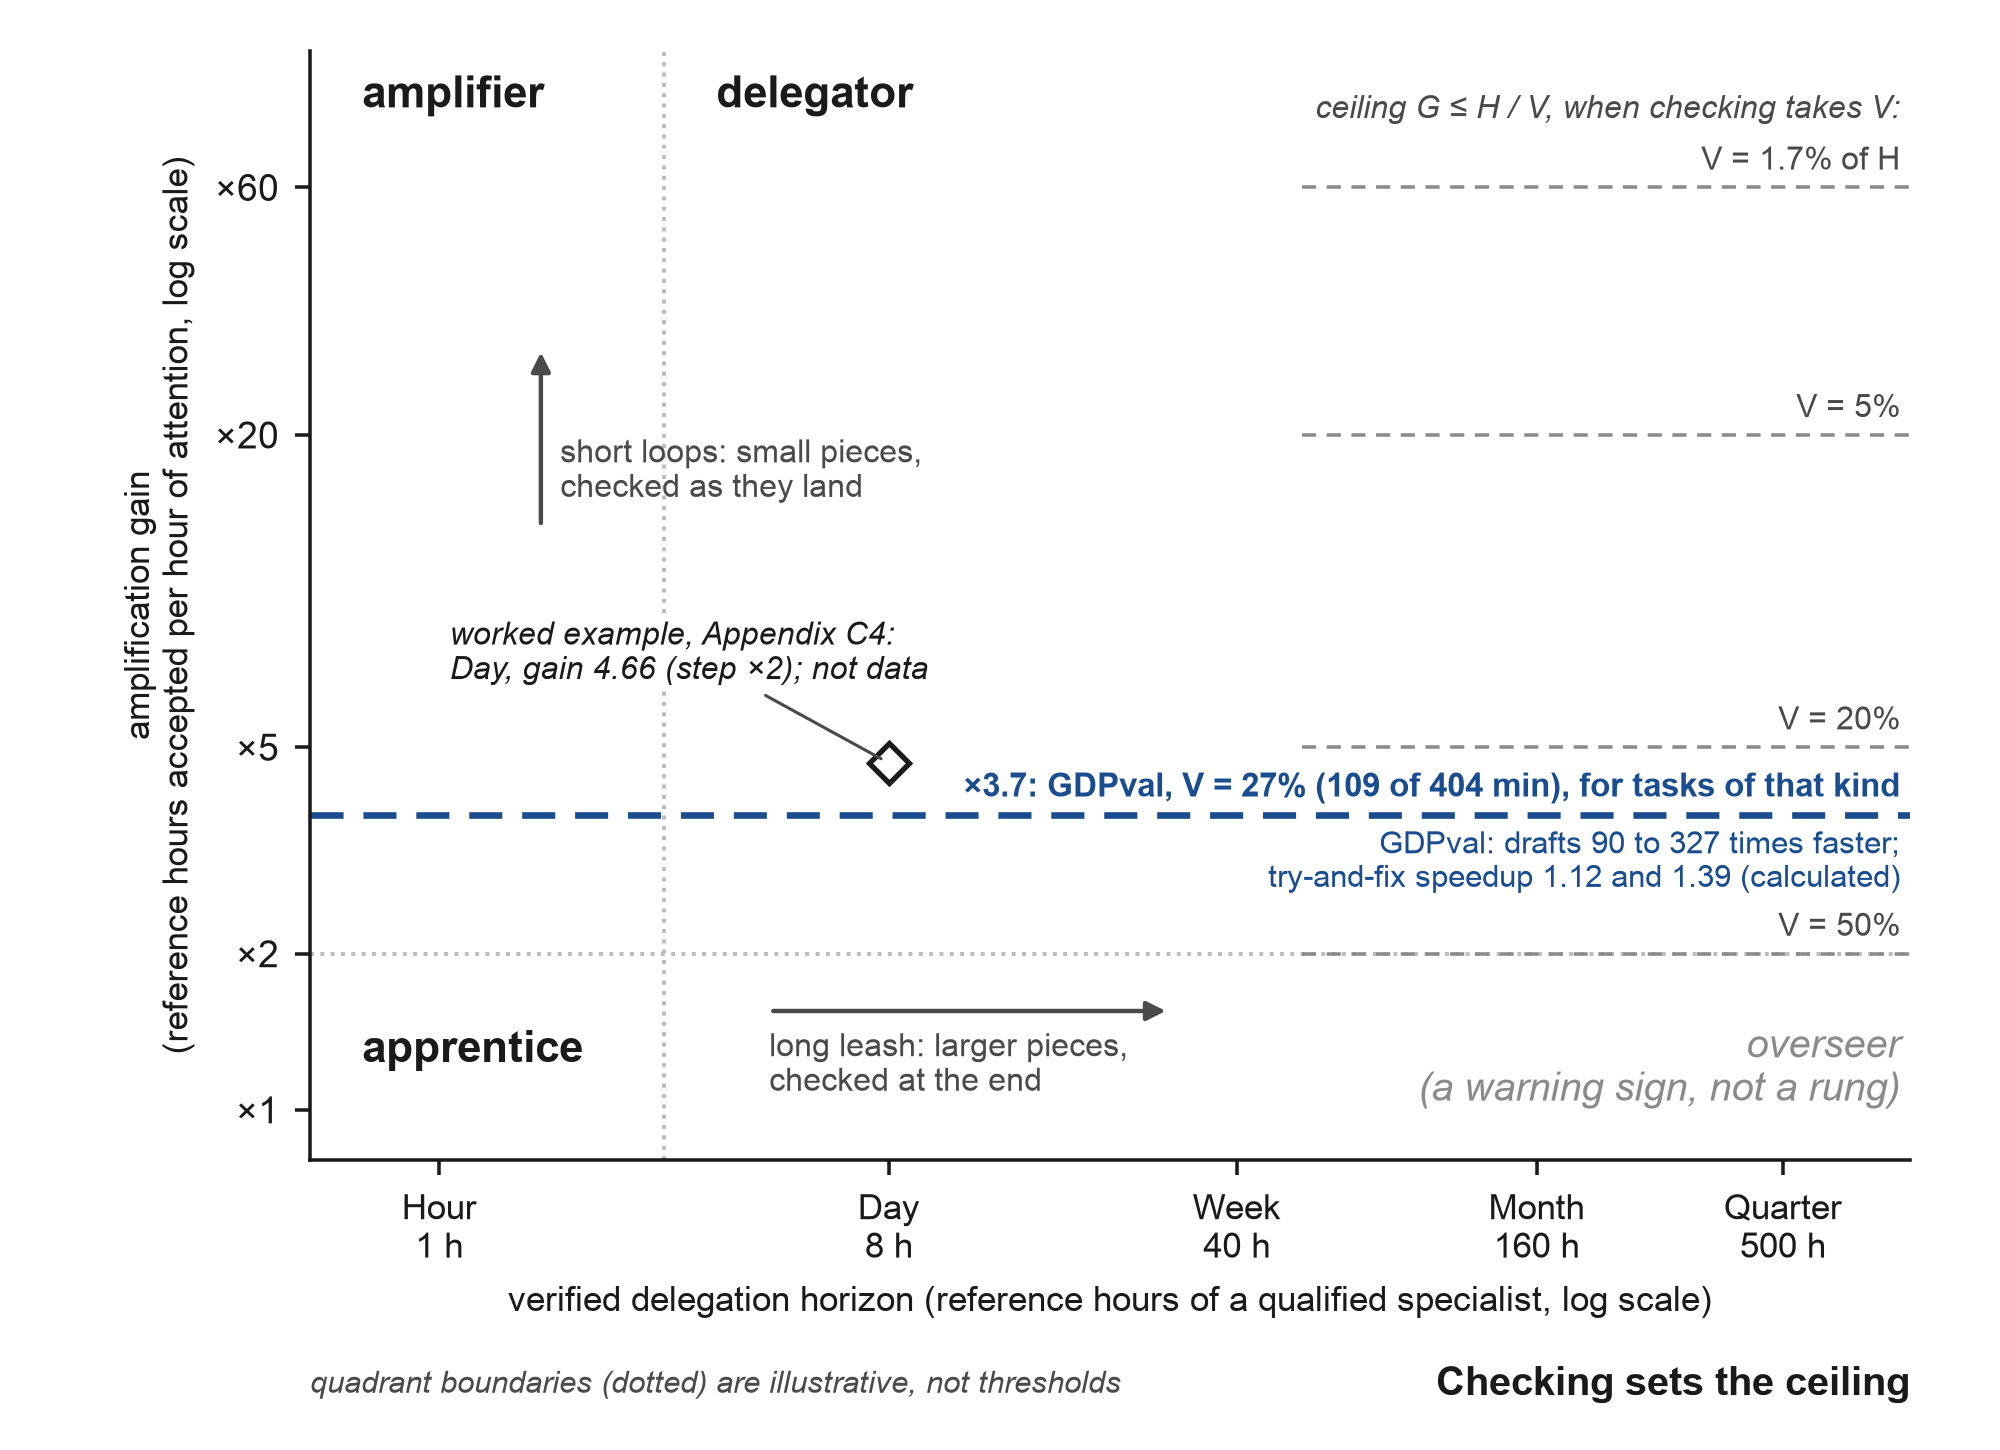
Примечание: квадранты — это профили, а не ступени, и их границы иллюстративны. Каждая серая линия — это граница G ≤ H / V раздела 5.5 для заданной доли времени проверки V в ручном времени H. Линия акцента использует средние значения GDPval на его подмножестве из 220 задач, 404 минут вручную и 109 минут экспертной проверки выходных данных модели (Patwardhan et al., 2025), и применяется к задачам такого рода. Ускорения 1.12 и 1.39 — это расчёт авторов, а не измерение. Ромб — это проработанный пример приложения C4, а не данные. Он находится выше линии GDPval, потому что потолок рассчитывается для каждого вида задачи, и небольшие куски, проверенные дёшево, могут оказаться выше потолка, рассчитанного для больших (раздел 5.5). Случай 36 этапов в разделе 5.4 не нанесён на график: нет выигрыша и нет независимой проверки.
5.6 Откуда берётся мера и что в ней ново
Мера имеет предков, и самый старый — Elliott Jaques, который измерял уровень любой работы в любой функции по его диапазону дискреции: самому долгому времени, в течение которого человек работает по собственному суждению, прежде чем кто-либо проверит результат. Он утверждал, что справедливая оплата возрастает с этим диапазоном (Jaques, 1956). Проверенный горизонт делегирования переносит эту идею в эпоху агентов с одним изменением. Jaques измерял, как долго человек работает без проверки, тогда как эта мера считает, сколько работы человек передаёт агентам, принимает и подвергает проверке. Эти два могут расходиться, и его слои, считанные в месяцах и годах, не отображаются на эти ступени.
Теория принципала и агента — второй предок. Jensen and Meckling (1976) оценили делегирование как мониторинг, обеспечение верности и остаточные потери. Проверка — это стоимость мониторинга передачи работы агенту, и горизонт отмечает точку, в которой проверка большего куска больше не окупается.
METR измеряет машины по той же оси. Его временной горизонт — это длительность задачи в человеко-часах, которую модель выполняет с заданной вероятностью успеха (Kwa et al., 2025). Весной 2026 года пограничная модель на его панели инструментов достигла примерно 17 часов при 50% успехе, хотя само METR предостерегает, что измерения выше 16 часов ненадёжны с его текущими задачами. Горизонт при 80% успехе вырос с примерно 1,2 часа в феврале 2026 года до примерно 3,1 часа в апреле, две точки, которые иллюстрируют темп роста, не измеряя его скорость. Тренд, подогнанный на панели инструментов по моделям с 2023 года, удваивается примерно каждые 4,2 месяца (128,7 дня), и панель инструментов не обновлялась после 8 сентября 2026 года, когда она была в последний раз доступна (METR, 2026c). Прогнозисты проекта AI Futures Project работают с временем удвоения от 4 до 4,5 месяцев (AI Futures Project, 2026). Принятая работа соответствует горизонту 80% больше, чем горизонту 50%. Разница между тем, что модель иногда завершает, и тем, что она надёжно завершает, — это работа человека, которая заключается в том, чтобы показать, что результат правильный, и довести его до конца. Рисунок A3 (Приложение F) сопоставляет эти машинные горизонты с ступенями.
Теория 2026 года указывает на тот же разрыв. Huang, Xiao and Vishnoi (2026) моделируют делегирование под ИИ и обнаруживают, что небольшие различия в способности проверять приводят к большим различиям в результатах: ИИ помогает тем, кто проверяет, и вредит тем, кто передаёт слишком много. Их статья была принята на ICML 2026, и они называют этот эффект усилением проверки. Структурированный обзор 24 исследований обнаружил, что ни один валидированный инструмент в его основном корпусе не охватывает полную комбинацию навыков, необходимых для надзора за агентами (масштаб, разрешения, восстановление, независимая проверка и закрытие на основе доказательств), хотя некоторые инструменты охватывают его части (Veri', 2026). Фреймворк DeepMind для интеллектуального делегирования ИИ описывает делегирование в целом и не содержит меры на уровне человека (Tomašev et al., 2026), и экономика делегирования теперь имеет свои собственные пограничные модели (Wang, 2026). Chen and Meng (2026) показывают, что генеративный ИИ сжимает различия в навыках в рамках задачи и сдвигает ценность на редкие дополнительные активы, и они добавляют, что панельные данные человека по задачам, необходимые для проверки их прогнозов, «do not yet exist at scale». Предложенная мною мера производит данные именно такого рода, поскольку каждый записанный фрагмент несёт человека, размер и дату.
Вторая ось имеет своих соседей, и выигрыш от усиления — это их форма на уровне человека, проверенная. Engelbart (1962) представил вычисления как расширение человеческого интеллекта, и «superagency» — это слово McKinsey для той же надежды в 2025 году (McKinsey, 2025). Anthropic Economic Index оценивает разговоры по ускорению (время без ИИ, разделённое на время с ним) и автономии агента по шкале от 1 до 5, обе оцениваются моделью (Anthropic, 2026a). WORKBank Стэнфорда оценивает уровень участия человека, который предпочитают работники, по шкале от H1 до H5 (Shao et al., 2025). Эссе 2026 года определило надзорную способность как полезный проверенный результат в соотношении с человеческой работой и явно отказалось давать ей число (em360, 2026), и «amplified oversight» — это термин безопасности ИИ для помощи людям в надзоре за системами, сильнее их самих. Наблюдение поискового агента показывает тот же сдвиг человеческого времени в сторону проверки: агент работает один в течение 26 минут за сеанс, где обычный поиск занял 33 секунды (Yang et al., 2026). Со стороны делегирования Khadj (2026) и Alonso (2026) используют «delegation horizon» для обозначения того, как далеко машина или фирма могут делегировать, работа CHI 2026 по «decision horizons» изучает потерю самостоятельности (University of Lübeck, 2026), и Dawson (2026) и Metal Toad (2026) публикуют уровни делегирования ИИ практиками. Ни один из них не ставит человека на уровень, определённый работой, подтверждённой независимой проверкой.
Наиболее близкий недавний фреймворк сравнивается здесь напрямую. Фреймворк AIDEs от JetBrains Research (Tikhomirov, 2026) имеет две общие с мерой особенности: он рассматривает делегирование как отношение принципала и агента, и упорядочивает делегирование в пять уровней, описанные атрибутами, такими как автономия и планирование. Он отличается в четырех аспектах. Его область — разработка программного обеспечения, тогда как горизонт оценивается в любой области. Его уровни описывают, как работа делегируется, тогда как ступень определяется размером работы в эталонных часах квалифицированного специалиста. Он не имеет правила о независимости проверки от агентов, тогда как ступень считает только куски, подтверждённые проверкой, которую агенты не видели. И он не ведёт подсчёт в рамках временного окна и не имеет второй оси, тогда как ступень требует доли успешных в рамках датированного окна, и выигрыш от усиления добавляет часы внимания. Язык агентства один и тот же; единица, правило независимости и масштаб за пределами программного обеспечения — это то, что предлагает данная работа.
Много шкал было опубликовано в 2025 и 2026 годах, и ни одна из шкал в таблице 2 не измеряет человека по проверенной работе. Таблица 2 группирует основные по тому, что они измеряют; таблица A3 (Приложение F) перечисляет каждую из них.
Таблица 2. Шкалы 2025 и 2026 годов, сгруппированные по тому, что они измеряют.
| Семейство | Примеры | Измеренная единица | Размещает ли человека по проверенной делегированной работе? |
|---|---|---|---|
| Уровни автономии агентов и машин | Feng et al., 2025; Shapiro, January 2026; Memari & Rudolph, 2026; METR, 2025-2026 | Агент, модель или конфигурация команды | Нет |
| Этапы практики разработчика | Yegge, 2026; Park et al., 2026; Microsoft, May 2026 | Практика, надзорная работа или рабочие паттерны | Нет |
| Делегирование организациями и фирмами | Dawson, 2026; Metal Toad, 2026; Tomašev et al. (DeepMind), February 2026; Khadj, 2026 | Организация, менеджер, фирма или делегирование в целом | Нет |
| Делегирование разработчиком как отношение принципала и агента | JetBrains Research (Tikhomirov), September 2026 | Делегирование разработчика | Только разработчики; отсутствие правила независимости проверок и отсутствие единицы размера |
| Фреймворки компетентности и грамотности | AI Certification Standards, 23 August 2026; Anthropic AI Fluency, 2025b | Компетентности или грамотность | Нет экзамена, пороговых значений или уровней |
| Проверенный горизонт делегирования и выигрыш усиления | Данная работа | Человек в области | Да, по правилу Раздела 5.2 |
Примечание: «Размещает ли человека по проверенной делегированной работе» означает, что шкала определяет положение отдельного человека на уровне в зависимости от объема работы, переданной агентам и подтвержденной проверкой, которую агенты не видели. Ближайший аналог — пять уровней JetBrains: они используют язык принципала и агента, но отличаются в правиле проверки (независимая проверка, которую агенты не видели) и в единице (эталонные часы). Таблица A3 (Приложение F) перечисляет каждую шкалу отдельно.
Один практик хорошо выразил возражение против любой личной шкалы: «ваш уровень автономии — это свойство репозитория, а не разработчика и не модели» (Phoenix, 2026). Я согласен с половиной этого. Горизонт принадлежит человеку в области под режимом проверки, и хорошо построенный репозиторий со скрытыми тестами является частью этого режима, что объясняет, почему горизонт записывается для каждой области и с датой.
5.7 Два вопроса из сопутствующей статьи
Сопутствующая статья оставила открытым вопрос о том, почему опытные пользователи делегируют меньше: имели ли они неудачный опыт или их суждение верно (Chernets, 2026a). Вторая ось может различить эти два варианта. Если доля директивного использования падает, а проверенная прибыль растет, то их суждение верно; если прибыль также падает, то они имели неудачный опыт. Сопутствующая статья также спрашивала, является ли словарь делегирования одной грамматикой или разной для каждой профессии. Я придерживаюсь позиции: грамматика одна (установить задачу, затем принять ее на основе доказательств), в то время как то, что считается доказательством, различается по областям, что объясняет, почему ступени общие, а оценка происходит для каждой области.
Инструмент Приложения C сообщает долю директивного использования для каждого человека и области, подсчитанную по элементам (доля элементов, переданных целиком, в сравнении с этапами или совместной работой), так что первый грубый тест может быть запущен на тех же записях, которые дают ступени. Прогноз F20 определяет тест с датой на его зарегистрированной мере, «доля операций человека, в которых даются инструкции, а не проверяется или редактируется, из журнала» (Таблица A6): там доля подсчитывается по операциям журнала сессии, а не по элементам журнала работы Приложения C, так что это более мелкий из двух подсчетов.
5.8 Как можно манипулировать измерением и меры противодействия
Подсчет принятой, независимо проверенной работы закрывает самый простой способ манипуляции — завышение трат, но целеустремленный человек или работодатель, преследующий цель, все еще имеет другие варианты. Таблица 3 перечисляет их с защитой, которую обеспечивают правила. Защита что-то стоит, и стоимость — часть дизайна: проверенная ступень ценнее, чем самостоятельно сообщаемая, так же, как проверенный счет ценнее, чем утверждение.
Таблица 3. Способы манипулировать измерением и меры противодействия.
| Способ | Как это проявляется | Защита |
|---|---|---|
| Легкие проверки | Скрытые тесты, которые проходит слабое решение; рецензент, который просматривает поверхностно | Случайная проверка доли принятых элементов вторым независимым проверяющим; внедренные ошибки от уровня недели и выше; тип проверки указывается рядом с оценкой |
| Выбор задач чуть выше порога | Много элементов по 8,1 эталонных часов для достижения уровня День | Ступени читаются из распределения размеров, с медианным размером принятых элементов, указанным рядом со ступенью |
| Щедрые оценщики часов | Оценщики, которые завышают эталонные часы | Два оценщика, не знающие личность человека; разногласие выше установленного соотношения отправляет элемент либо в замороженный банк, либо третьему оценщику; записи оценщиков проверяются |
| Скрытая помощь | Коллега или подрядчик исправляет работу вне журнала | Внимание зарегистрировано по элементам; случайные интервью или повторные просмотры; внешняя помощь записывается отдельно и исключается из прибыли человека |
| Разделение | Месяц работы разбит на одночасовые задачи | Только связный результат, принятый целиком, учитывается для ступени |
| Скрытие отказов | Брошенные или неудачные элементы остаются вне журнала | Каждая передача зарегистрирована, с датой начала, и закрывается при принятии, отклонении или отказе; общественный учет отказов; коэффициент прохождения, который выглядит слишком идеальным, запускает проверку |
| Скоординированная проверка | Вторая модель из того же семейства, дающая тот же результат | Не учитывается (Раздел 5.2) |
| Параллельные потоки | Внимание учитывается один раз за поток | Внимание учитывается один раз за человеко-минуту (Раздел 5.4) |
Пороги — это проектные решения, версионированные как правила v1.1 и изменяются только в новой версии после накопления данных. Десять элементов в окне — это наименьшее количество, при котором доля успеха 80% имеет смысл (восемь успехов из десяти). Окно в 91 день для нижних уровней и необходимый недавний элемент для верхних соответствуют ежеквартальной переверификации и темпу изменения инструментов. Правило уровня — это правило квалификации и не дает оценку надежности человека. Восемь успехов из десяти совместимы с истинной долей успеха от примерно 44% до 97% (точный 95% интервал), и три из трех — с истинной долей успеха, низкой до примерно 37% (односторонняя 95% граница). Зарегистрированное исследование калибровки позволяет оценить надежность. Доля 80% следует использованию METR горизонта 80% как уровня надежной работы, а уровни в 1, 8, 40, 160 и 500 часов соответствуют рабочему часу, дню, неделе, месяцу и кварталу, поэтому они не требуют перевода между профессиями. Настольное тестирование порогов проверило правила посредством моделирования и модельных оценивателей (Приложение E). Оно вычислило, как часто человек известной надежности получает каждый уровень (Рисунок A2, Приложение E). При истинной доле успеха 0.8 уровень Day получается в 68% окон, и тот же вердикт повторяется в следующем окне в 56%, поэтому запись выводит количество рядом с уровнем, как в «Day (8/10)». Оно также обнаружило ошибку в первой версии правил: четыре из четырех на Month было труднее получить, чем три из трех на Quarter (41% против 51% при доле успеха 0.8), поэтому Month теперь требует пять из шести в год. Изменение количества с десяти на восемь или двенадцать, или доли с 0.8 на 0.7 или 0.9, изменяет вердикт Day в 8%-11% смоделированных логов, а изменение обоих изменяет его до 22%. Четыре модельных оценивателя из четырех семейств, оценивающие контрольные часы вслепую, согласованно ранжировали 30 задач (внутриклассовая корреляция 0.89 на логарифмических часах), но лишь 62% пар попадали в пределы коэффициента 1.5, против критерия 70% протокола калибровки, и различались в два раза по общему уровню; учитывая только открытый идентификатор задачи, их средняя оценка попадала в пределы 1.5 от измеренного человеческого времени для 3 из 14 задач. Модельные оцениватели поэтому не могут заменить двух человеческих оценивателей, и оценивателей полевого исследования калибруют на задачах с измеренным временем в первую очередь. Протокол калибровки фиксирует следующие тесты заранее: согласие между человеческими оценивателями (критерий: по крайней мере 70% пар в пределах 1.5), повторяемость уровня человека в двух последовательных окнах (взвешенная каппа по крайней мере 0.6) и способность уровня предсказать успешное выполнение новых задач того же размера (AUC по крайней мере 0.7). Его протокол и текст регистрации находятся в сопутствующем репозитории, и первый тест работающих профессионалов по согласованности их оценок контрольных часов зарегистрирован и описан в Приложении G.
Таблица A4 (Приложение F) приводит правило для сложных случаев, которые возникают в первую очередь.
Приложение C, раздел C4, прорабатывает журнал одного человека из десяти строк и показывает единую запись, которую он производит.
6. Нейтральность происхождения и точка кроссовера квалификаций
6.1 Нейтральность происхождения
Гипотеза состоит в том, что при равном проверенном горизонте в предметной области образование в программировании не предсказывает качество независимо проверенной работы, если учитываются владение предметной областью и компетентность в принятии.
Вывод Anthropic о том, что «способность направлять Claude к успеху зависит в большей мере от владения предметной областью, нежели от умения писать код», соответствует гипотезе, но не проверяет ее (Anthropic, 2026e): его данные сортируют людей по профессии, а не по образованию, и разница 34% против 29% из раздела 2.2 — это разница между профессиями. Гипотезу проверяет только исследование F7. Также существует сильная альтернатива. Savva (2026) моделирует работу, расширенную AI, как проблему основного агента и прогнозирует, что AI сужает разрывы между людьми в простых задачах и расширяет их в сложных. Если Savva прав, нейтральность происхождения будет сохраняться на простых задачах и нарушаться на более высоких ступенях, поэтому предсказание F7 оценивается отдельно на День и на Неделю и выше, где гипотеза встречает самую суровую проверку.
Компетентность в принятии — это навык, на который полагается гипотеза. Это означает заранее указать, что будет считаться выполненным, а затем это продемонстрировать: через скрытый тест, вторую семью моделей, проверяющих источники, сравнение с источником, который человек открыл сам, или артефакт вместо уверения. Компетентность в работе с агентами охватывает делегирование, проверку и управление в целом (MindStudio, 2026); компетентность в принятии ставит стандарт доказательства в центр. Она также отличается от принятия технологии в смысле традиции TAM, которая изучает, принимают ли люди технологию, поскольку здесь принятие — это решение принять работу. Запись принятия сопутствующей статьи становится единицей доказательства для ступени.
6.2 Точка кроссовера квалификаций
Точка кроссовера квалификаций в предметной области — это момент, когда продукты людей без образования в области IT, принятые при одинаковых независимых проверках, начинают превосходить продукты программистов, использующих одинаковых агентов, после чего диплом в области IT и ярлыки junior и senior теряют предсказательный вес при найме в эту предметную область.
Это определение — мой прогноз от 8 октября 2026 года, уточненный (раздел 1). Каждый из его компонентов наблюдаем и датирован отдельно, так что момент можно определить, когда они совпадают. Паритет качества — это шаг перед моментом: в предметной области продукты людей без образования в области IT не хуже, чем у программистов с одинаковыми агентами, на одинаковых задачах, при слепых проверках (предсказание F2). Превосходство — это сам момент, когда эти продукты становятся лучше при одинаковых проверках (F3, с этапами выпуска и поддержки в F4a и F4b). Пересечение в объявлениях — это видимый знак, когда объявления, требующие навыков работы с агентами, требуют диплома реже, чем сравнимые объявления, которые этого не требуют (F5). Нейтральность происхождения — это механизм, поскольку при равной ступени образование перестает предсказывать проверенное качество (F7).
Точка кроссовера в предметной области датируется первым годом, в котором в той же названной предметной области показано превосходство (F3) и выполнен аналог пересечения в объявлениях в этой предметной области (F5, вычисленное на объявлениях этой предметной области; приложение D). Паритет без превосходства — это приближение к точке, и пересечение в объявлениях без превосходства показало бы, что работодатели движутся впереди доказательств. Таким образом, F2, F3, F5 и F7 образуют одну программу в одних и тех же названных предметных областях: предметные области зафиксированы в регистрации, эксперимент F2, F3 и F7 проводится в них, и F5 вычисляется как на зафиксированном наборе IT профессий, так и на объявлениях каждой из этих предметных областей. Точка кроссовера объявляется для предметной области только когда и правило качества (F3), и правило найма (аналог F5 в этой предметной области) выполнены в одной и той же предметной области; любое из них по отдельности ничего не объявляет.
Первые два компонента проверяются экспериментами на сопоставимых задачах (раздел 11). Третий уже можно наблюдать в объявлениях о вакансиях. Lightcast сообщил в сентябре 2026 года, что объявления IT, требующие навыков в области AI, по-прежнему с большей вероятностью требуют диплома за четыре года, чем объявления IT без них. Однако среди объявлений AI требования к диплому находились в «явном снижении с 2024 года», тогда как они выросли в других объявлениях IT (Lightcast, 2026b). Две линии сходятся и еще не пересеклись (рисунок 5). Lightcast определяет объявления AI более чем 300 навыками AI, поэтому его линии описывают работу в области AI в целом. Подмножество агентских навыков, определяемое зафиксированным списком агентских навыков (Lightcast, 2026a), — это то, которое использует предсказание, и его исходное состояние берется перед регистрацией.
Направление имеет прецедент. Bone, González Ehlinger и Stephany (2025), используя около одиннадцати миллионов вакансий в Великобритании до середины 2024 года, обнаружили, что требования к образованию упали в ролях AI и сравнили надбавки к заработной плате, привязанные к навыкам и дипломам. Эта работа задокументировала найм на основе навыков в области AI до появления агентов. Эта статья расширяет эту линию на агентские навыки, с датированным порогом и сравнением с сопоставимыми объявлениями, и предлагает связать требования в объявлениях с независимо проверенной производительностью в тестах, которые должны быть предварительно зарегистрированы. AI Jobs Barometer компании PwC сообщает об одном направлении в разных странах и служит резервным источником везде, где измеряет одно и то же количество (PwC, 2026).
Второй индикатор — разница между тем, что говорят работодатели, и тем, что они делают. Многие работодатели удалили требования к диплому из своих политик до прихода агентов, однако Burning Glass Institute и Harvard Business School обнаружили, что изменение затронуло менее одного из 700 случаев найма (Burning Glass Institute & Harvard Business School, 2024). Объявления движились в другую сторону: в ноябре 2025 года 19,3% объявлений о работе в США на Indeed требовали степень бакалавра или выше, значительно больше, чем год ранее (Indeed Hiring Lab, 2026). Требование к диплому, удаленное на бумаге, — это изменение политики, и кроссовер проявляется только когда сам наем меняется. Аудиторское исследование, отправляющее сопоставимые портфолио, различающиеся только образованием, на реальные объявления, увидело бы это в первую очередь, и предсказание F26 это предусматривает.
Диплом входит в семейство шлюзов, которые допускают людей на основе ярлыка: профиль на платформе, должность, диплом и отчасти лицензия. Ярлык говорит работодателю о работе только в той мере, в какой обладание им связано со способностью выполнять работу. Агенты ослабляют эту связь с одной стороны, поскольку люди без ярлыка теперь производят работу, похожую на работу в этой профессии (раздел 2.2), а ярлык, основанный только на словах человека, всегда было легко присваивать. Шлюз, который проверяет саму работу, от них не зависит. Исследование оценивающих из приложения G обнаружило это различие случайно. Prolific допускает участников в исследование через фильтры, ответы в которых в основном самоотчетные, возраст и страна проживания являются главными исключениями, которые он проверяет (Prolific, 2026). Из 60 человек, которых его фильтры допустили в выборку по бухгалтерии, 11 ошибочно ответили на первый вопрос профессии (приложение G2): ярлык их пропустил, а один профессиональный вопрос их остановил.
Исследователи, которые нанимали программистов на таких платформах до появления агентов, сообщили о том же паттерне и проводили скрининг с помощью собственных вопросов на знание: в одном исследовании 42% работников платформы, заявивших о навыках программирования, не соответствовали критериям таких вопросов (Danilova et al., 2021), а в другом, на Prolific, 55 из 206 респондентов, сообщивших о программировании на Node.js, прошли все её вопросы по программированию (Reid et al., 2022). Вопрос на проверку знания сам по себе — более слабый шлюз, чем проверка доставленной работы, и чат-модели его также ослабляют: в симулированной атаке ChatGPT легко решил существующие вопросы для скрининга программистов (Serafini et al., 2024), и к 2026 году он также миновал статичные визуальные вопросы, которые были разработаны, чтобы ему противостоять, тогда как звуковые вопросы, которые раскрывают своё содержание пошагово под строгим ограничением времени, остались (Serafini et al., 2026). В терминах найма потеря значимости диплома, которую приведённое выше определение предсказывает, представляет собой переход от шлюза первого типа к шлюзу второго типа, а проверенный горизонт делегирования является шлюзом второго типа: он фиксирует не то, что люди о себе говорят, а то, что они представили и что прошло проверку, которую агенты не видели.
Лицензии занимают место между двумя типами. Лицензия, которая основана на экзамене, пройденном один раз, работает с тех пор как ярлык; лицензия, работа владельца которой проверяется, ближе к проверке. Аудиторские фирмы, зарегистрированные в Надзорном совете по учёту общественных компаний в Соединённых Штатах, имеют проверку своей аудиторской работы ежегодно, если они регулярно проверяют более чем 100 эмитентов, и как минимум один раз в три года в противном случае, если только Совет не устанавливает другое расписание в соответствии с правилом (Sarbanes-Oxley Act of 2002, s. 104), что представляет собой более редкий аналог переверификации, которую раздел 5.2 требует от горизонта, но применяемый к подписанной работе фирмы. Лицензирование само начало двигаться в сторону второго типа. С мая 2024 года Орегон предлагает выпускникам по праву путь к лицензии без экзамена адвокатов — Экзамен портфолио под надзором: в течение как минимум 675 часов контролируемой практики кандидат представляет восемь письменных работ, два взаимодействия с клиентом и две переговоры, и оценивающие, применяющие рубрики Совета экзаменаторов адвокатов, судят о том, демонстрирует ли каждая минимальную компетентность. К 5 января 2026 года 205 кандидатов подали заявки и 49 получили статус лицензированного адвоката, первые из них — в декабре 2024 года (Oregon State Board of Bar Examiners, 2026). Диплом по праву по-прежнему требуется, поэтому проверенная работа заменяет экзамен, а не школу. В бухгалтерии движение меньше: в мае 2025 года AICPA и NASBA одобрили модельное законодательство для пути к лицензии CPA, которое требует второго года профессионального опыта вместо 30 кредитных часов обучения сверх степени бакалавра, с сохранением экзамена, и каждый штат должен его принять до того, как кандидаты смогут его использовать (Journal of Accountancy, 2025). То, что закон резервирует для лицензии, остаётся границей измерения (раздел 13). Таблица A8 (приложение F) располагает шлюзы этого раздела рядом по тому, что каждый проверяет.
Термин «учётные данные» имеет второе значение в безопасности агентов, где он обозначает секретный ключ или токен. Здесь он означает диплом или сертификат. Фраза «точка перехода учётных данных» в этом смысле не вернула результатов в научных базах данных, в которых производился поиск 9 октября 2026 года (приложение B).
Рисунок 5. Разрыв в проверенном успехе и требование диплома в объявлениях: что наблюдается и что протестирует 2027 год.
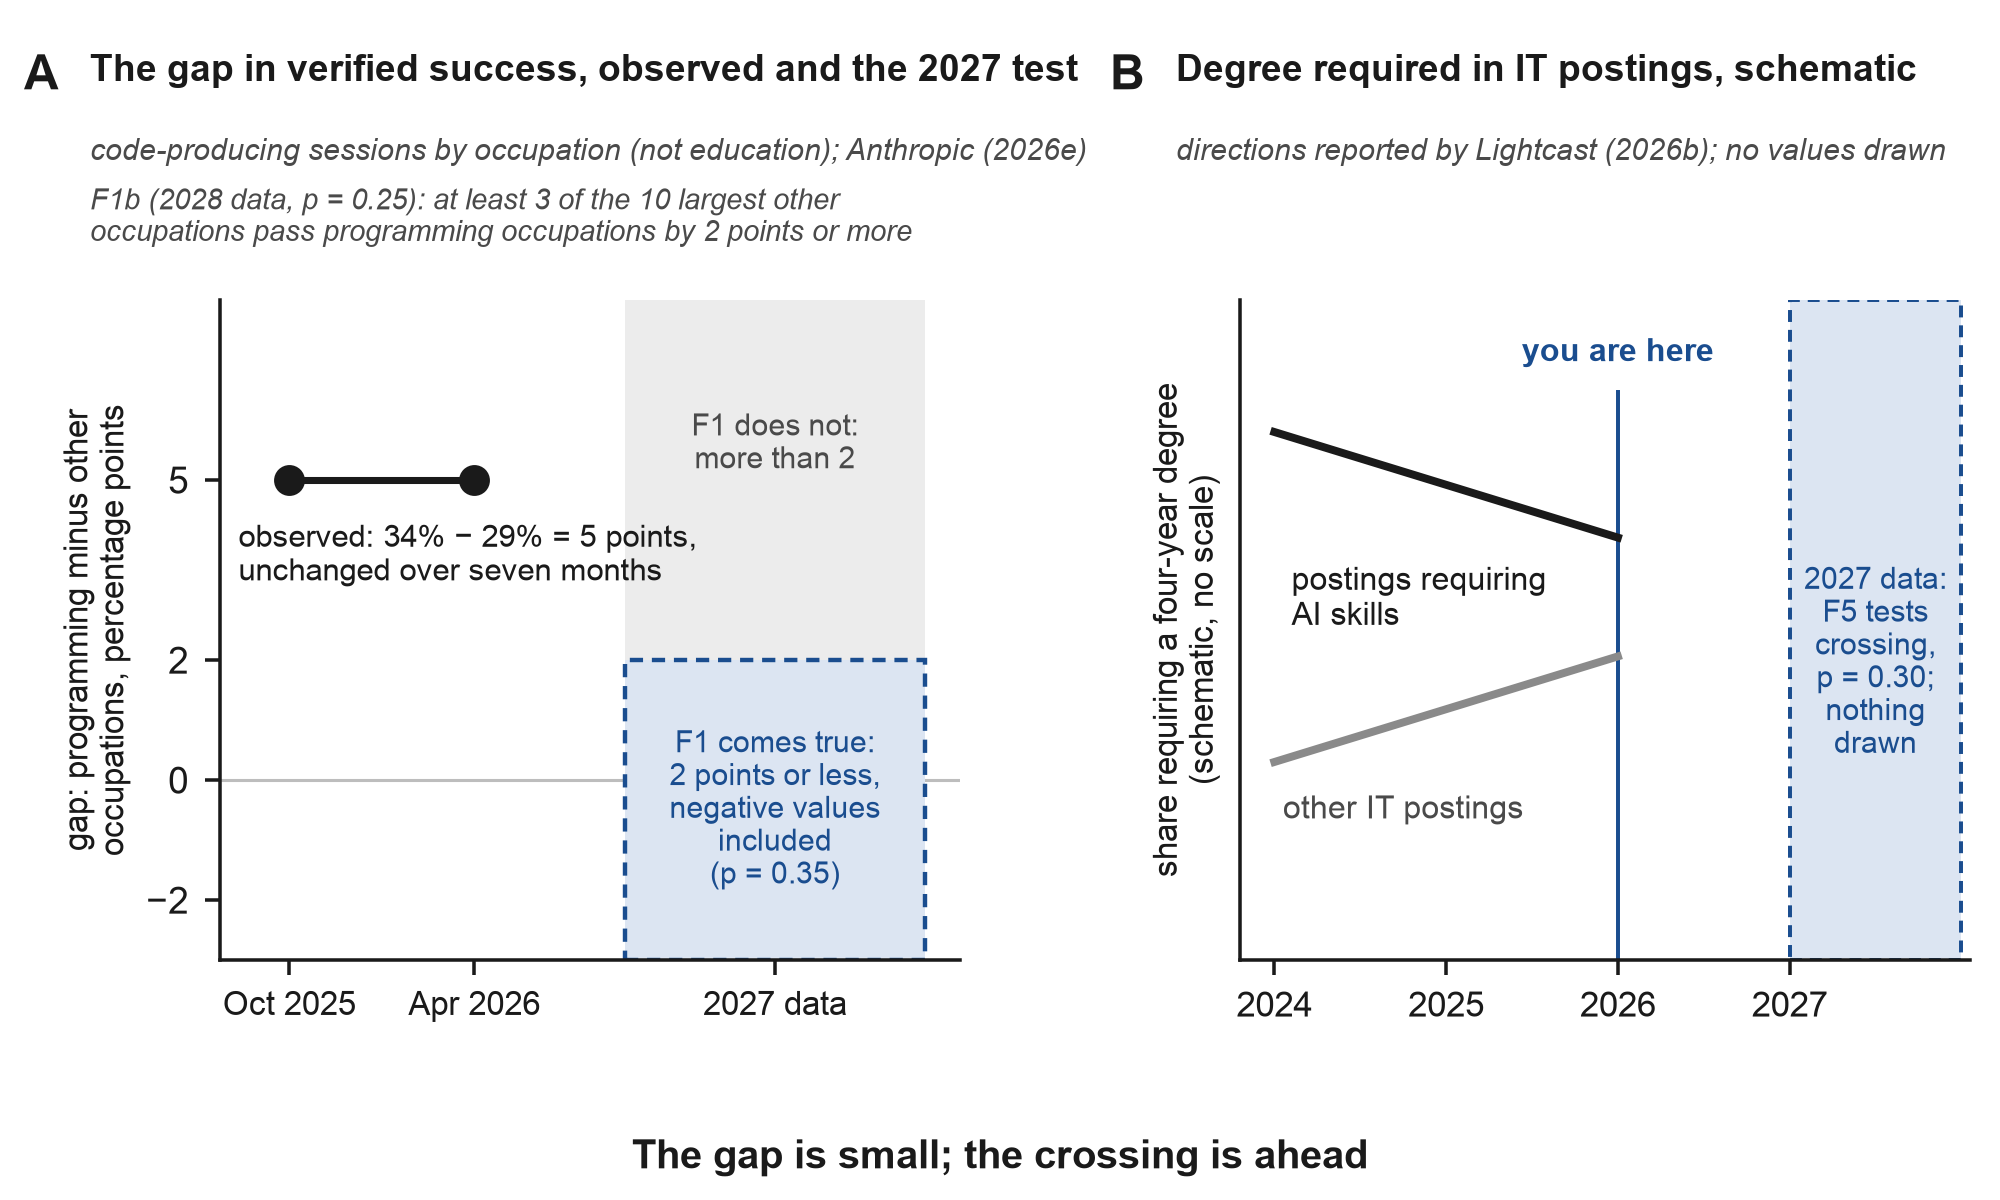
Примечание: Панель A использует Anthropic (2026e), сеансы производства кода, 34% для профессий программирования против 29% для других профессий, без изменений в течение семи месяцев. Профессия — это не образование, и успех означает достижение, подкреплённое доказательствами, такими как тесты или коммиты. Полоса — это порог предсказания F1 (разрыв 2 точки или менее, отрицательные значения включены, вероятность 0,35); F1b (вероятность 0,25) находится в таблице A6. Панель B рисует только направления, которые Lightcast (2026b) сообщил до 2026 года, без его значений. Окно 2027 года остаётся пустым: пересечение не рисуется, поскольку предсказание F5 (вероятность 0,30) будет его определять.
6.3 Области: почему преимущество программиста было горизонтальным
ИИ делает дешёвым в первую очередь то, что является горизонтальным, одинаковым во всех отраслях, и механизм понятен: способность, которая переносится между отраслями, — это то, что универсальная модель может предоставить всем сразу. Тонкие обёртки над моделью, универсальное программное обеспечение и общая способность писать код — все прошли этим путём. Инженер подсказок, самое модное название 2023 года, был назван устаревшим к 2025 году, потому что навык растворился в инструментах и стал доступен каждому (Fortune, 2025). Старое преимущество программиста было также горизонтальным. Код работает в любой отрасли, поэтому программист мог строить для адвокатской конторы или больницы, не зная ни того ни другого, и агенты, удешевляя код, отнимают это преимущество. Никому не пришлось становиться программистом, чтобы это произошло. Программное обеспечение стало одной вертикалью среди многих (рядом с инфраструктурой и безопасностью), и внутри неё программисты остаются самыми сильными. Та же логика применяется к людям, что и к фирмам: человек без вертикали — это обёртка над ИИ, столь же хрупкая, как тонкий обёрнутый продукт. Так как агенты облегчают создание универсального программного обеспечения, старое вертикальное программное обеспечение может столкнуться с давлением с двух сторон: со стороны лабораторий, которые берут информационный слой, и со стороны профессионалов, которые строят свои собственные инструменты. Гипотеза состоит в том, что знание предметной области, соединённое со способностью принимать работу от агентов, приобретает ценность. Вертикальность сама по себе никого не защищает; защищает глубина, означающая способность принимать работу в предметной области, которую модель или новичок не могут подделать.
Вертиаль здесь — это предметная область, в которой человек может принимать работу агента, и это может быть или не быть той областью, где у них есть степень. Принятие юридической работы требует понимания права достаточно хорошо, чтобы заметить правдоподобную ошибку. Один разработчик в ветках раздела 9 говорит об этом ясно: чтобы увидеть, что результат — это бессмыслица, нужно знать хотя бы немного в этой области (перевод). Принятие остаётся за человеком, а также его имя и подпись под результатом, собственный контекст человека (клиенты, данные, местные правила, язык) и обслуживание после выпуска.
Лаборатории покупают информационный слой вертикалей. Mercor, которая продаёт время экспертов лабораториям ИИ, превысила 2 миллиарда долларов валовой годовой скорости в июне 2026 года, продавая время таких экспертов, как радиологи (Dealroom, 2026). Расходы предприятий на приложения вертикального ИИ почти утроились до 3,5 миллиарда долларов в 2025 году (Menlo Ventures, 2025). Это разветвление даёт эксперту предметной области две возможные судьбы. Донор продаёт знание лаборатории в виде ярлыков, и это знание потребляется один раз. Принципал держит знание в своём собственном продукте и отвечает за результат, и знание продолжает работать.
Следствие для измерения в том, что горизонты полностью не переносятся между предметными областями. Адвокат, переходящий в программное обеспечение, и программист, переходящий в право, теряют одно и то же — способность принимать работу в области, которую они не знают. Эта симметрия — это то, как выглядит конец особого положения программиста, и это можно измерить. Точка пересечения также будет достигаться предметная область за предметной областью. Она должна наступить в первую очередь там, где код стал дешёвым, где проверка требует знания предметной области и где рынки маленькие или локальные: право, бухгалтерский учёт, образование, администрирование клиник, узкие ниши отношений бизнес-к-бизнесу, рынки на меньших языках. Само программное обеспечение должно наступить в последнюю очередь. Один аналитик сделал соответствующий прогноз в феврале 2026 года, назвав финансы «канарейкой в угольной шахте» и ожидая, что каждая проверяемая задача будет следовать траектории финансов и учёта к 2027 году (Hwang, 2026). Вывод Anthropic о том, что менеджмент уже немного превосходит программистов на сеансах кодирования, является ранним признаком (Anthropic, 2026e). Запись раздела 5.3 называет предметную область в своём первом поле, и перед ней можно поставить любое название профессии.
То же самое рассуждение предсказывает судьбу названий должностей. Горизонтальные названия, такие как менеджер агентов, оператор ИИ и оркестратор, описывают людей, которые в целом обёртывают агентов. Один практик ожидает, что управление агентами будет длиться «в течение следующих 18 месяцев» до того, как это сделает и ИИ (IT Brew, 2026), в то время как Srinivasan и Wei (2026) ожидают, что «менеджер агентов» станет стандартным названием в течение 12–18 месяцев; прогноз F9 противопоставляет эти два взгляда. Та же статья насчитала 739 объявлений для оркестраторов ИИ в феврале 2026 года, рост на 1294%, и эта цифра указывает в другую сторону. Названия, привязанные к предметной области, такие как «Лидер вертикального ИИ», который отвечает за развёртывания агентов в каждой вертикали (Haize Labs, 2026), должны расти быстрее, и раздел 11 устанавливает прогноз на это сравнение.
6.4 Дети с передовыми моделями
Возражение затрагивает корень аргумента о предметной области. Передовая модель знает больше биологии, чем университетский факультет. Ребёнок со свежей идеей может описать её агенту и получить действующий сайт или приложение о биологии или об автомобилях в течение недели, без какой-либо специализации. Почему должны иметь значение предметные области?
Часть предпосылки уже верна. В Пекине шестиклассники построили своего собственного агента ИИ на занятиях на графической платформе в сентябре 2025 года (Xinhua, 2025). Министерство образования Китая поставило цель обучения ИИ практически во всех начальных и средних школах к 2030 году (CSET, 2025). В Соединённых Штатах указ президента от апреля 2025 года запустил Президентский вызов ИИ, выигрышные школьные проекты которого включали помощника с домашней работой, чат-бота против издевательств и инструмент для студентов с нарушениями зрения (White House, 2025; EdWeek, 2026). Однако доступ к передовым агентам по-прежнему контролируется по возрасту. Claude предназначен для взрослых, и учётные записи, отмеченные как принадлежащие несовершеннолетним, были приостановлены (MediaNama, 2026). OpenAI представила прогнозирование возраста и ограниченный режим для подростков (AlternativeTo, 2026). Дети с большей вероятностью достигнут передовых моделей через школьные платформы и режимы для подростков, чем через терминал, и «каждая школа в течение года» выглядит скорее как 2027–2030.
Более глубокий ответ исходит из разницы между теорией и практикой. На теории ребёнок побеждает: передовые модели набирают баллы выше типичных экспертов на вопросах естественных наук уровня выпускника, и в рандомизированном испытании новички с моделью были примерно в четыре раза точнее, чем контрольная группа на письменных задачах по биологии (Turner, 2026). На практике преимущество исчезает. В исследовании 1298 человек, опубликованном в Nature Medicine, модели одни назвали правильное состояние в 94,9% случаев, в то время как люди, использующие те же модели, сделали это в менее чем 34,5%, не лучше, чем контрольная группа (Nature Portfolio, 2026). В восьминедельном испытании мокрой лаборатории METR со 153 новичками доступ к модели не дал значительного улучшения, и около 5% в каждой группе завершили весь протокол (METR, 2026a).
Те, кто выдвигает это возражение, правы в том, что старая вертикаль — многолетнее обучение — теряет ценность, потому что знание доступно в модели бесплатно. То, что знание не может заменить, — это способность отличить правильный результат от правдоподобного и контакт с реальностью (пользователи, тесты, эксперименты, данные), который их разделяет. Этот цикл принятия — новая вертикаль, разрешающая видимый конфликт между "домены имеют значение" и "дети не нуждаются в специализации". Вертикаль в этом смысле — цикл принятия, построенный на практике, и многолетнее обучение — один из способов его построить среди многих. Подросток может построить его за недели через собственный продукт и его пользователей, без диплома; без него неделя работы агента остается лишь убедительной картиной. Дети служат чистейшим тестом нейтральности происхождения, ибо у них нет диплома и нет лет работы, только цикл, и им также нужен кто-то, кто ответит за их продукт, партнер, названный в Разделе 7. Может ли цикл быть построен так быстро — вопрос уже устаревший. К октябрю 2026 г. не найдено ни одного подтвержденного случая подростка без формального обучения, чей научный продукт имеет пользователей и прошел независимую проверку, и предсказание F24 датирует первый такой случай.
6.5 Новички в профессии, проверяющие по процессу
Раздел 6.3 гласит, что человек, переходящий в незнакомую ему область, теряет способность правильно оценивать работу в ней, и возражение из Раздела 6.4 имеет взрослую форму: сколько из этой способности может восстановить процесс? Возьмем новичка в бухгалтерском учете, не имеющего ни обучения в этой области, ни многолетнего опыта, работающего в четыре этапа. До начала работы несколько моделей спрашивают, что должна содержать такая работа, что обычно забывают и какие проверки необходимо применить. Один агент выполняет работу. Второй рецензирует ее в свежем контексте, не видя, как она была выполнена. Модель другого семейства проверяет ее против источников, открытых этим человеком. Каждый этап восполняет то, что раньше давал опыт: агент — для выполнения, рецензент в свежем контексте и второе семейство — для повторной проверки выполненного, заранее составленный список — чтобы знать требования к работе. Может ли такой новичок предоставить работу, которая пройдет больше независимых проверок, чем опытный бухгалтер, принимающий результат одного агента без проверки?
Часть доказательств говорит в пользу новичка. Опыт не защищает профессионала, который перестает проверять. В полевом эксперименте консалтинговой фирмы (исследование из эпохи до агентов) консультанты, использовавшие модель на задаче, находящейся вне пределов ее возможностей, были менее вероятны достичь правильного решения, чем те, кто работал без нее (Dell'Acqua et al., 2026), и в испытании METR опытные разработчики полагали, что были ускорены, когда на деле были замедлены (Раздел 5.4). Принятие результата одного агента без проверки — это также слабый подход в этой профессии: при оценке 160 бухгалтерских задач (согласование счетов, начисление расходов, проводка операций и составление отчетов) по рубрикам, написанным экспертами-бухгалтерами, лучшая из девяти передовых моделей удовлетворила в среднем 56% критериев, и ни одна не выдала полностью правильный результат во всех восьми попыток более чем в 2,6% задач (Benchek et al., 2026). Встроенный критик может помочь: модели-критики, обученные для этой цели, поймали больше ошибок в коде, написанном моделью, чем люди-подрядчики, оплачиваемые за проверку кода, хотя они также сообщали об ошибках, которых там не было, и подрядчики, работающие с таким критиком, поймали примерно столько же, сколько критик один, при этом сообщив о меньшем количестве ложных срабатываний (McAleese et al., 2024), исследование из эпохи до агентов. Список, составленный до начала работы, дает новичку первую половину грамотности принятия — описание того, что будет считаться выполненным (Раздел 6.1), и модели, которые его составляют, знают, что требуют экзамены профессии: GPT-4, получив отработанные примеры и инструменты, такие как калькулятор, прошла каждый раздел экзаменов CPA, CMA, CIA и EA со средним баллом 85,1% (Eulerich et al., 2024), также исследование из эпохи до агентов. Предварительное составление списка также помогает при проверке: модели-судьи, которые едва лучше монеты различали клиническую запись с пропуском от полной, показали лучший результат, когда они сначала выписали факты, установленные источником, а затем проверили запись по каждому из них, хотя даже тогда они отметили только 25–37% записей, содержавших пропуск (Fox et al., 2026). Знание конкретного клиента приходит из работы с этим клиентом, а не из диплома. Кто несет ответственность за результат, определяется тем, кто готов и ему доверяют отвечать (Раздел 7.2), за исключением случаев, когда закон требует определенную подпись (Раздел 13).
Часть из них не дает. По правилу раздела 5.2 новый рецензент того же семейства служит согласием в пределах одного семейства, что может улучшить работу, но не приносит зачета как проверка, и модель другого семейства считается только когда проверяет источники, которые открыл человек; где ошибка не может быть исправлена, это только вторая линия защиты за скрытым тестом или квалифицированным человеком. Согласие между семействами слабее, чем кажется: среди более чем 350 моделей большие и более точные создавали сильно коррелированные ошибки даже когда их архитектуры и поставщики отличались, хотя общая архитектура или поставщик является одним из факторов, повышающих корреляцию (Kim et al., 2025). Второе семейство поэтому служит лучшим предположением независимой проверки, чем вторая модель того же семейства, но не измерение независимости (Chernets, 2026b). Предварительно составленный список встречает более узкое ограничение. Модели намного хуже замечают, что отсутствует в тексте, чем находят, что в нем есть, даже имея оригинал рядом (Fu et al., 2025); список помогает только поскольку он полный, и пропущенное начисление - это пропуск, который ни один рецензент не видит. Предупреждение также не делает посторонника проверяющим: маркетологи и специалисты по продажам, которых попросили проверить анализ ИИ маркетинговых данных, пропустили критические ошибки даже после многократного сообщения, что ИИ ошибается; представление анализа в виде явных шагов с альтернативами для каждого решения помогло, хотя участники часто все еще испытывали трудности с рассуждением через них (Virk & Liu, 2025). Баланс, который согласуется, тоже не доказательство. В одном тесте разработчика бухгалтерского ПО в 2025 году модели, которых попросили закрыть книги компании месяц за месяцем, либо сдавались в течение первого месяца, либо накапливали ошибки, и когда их цифры не совпадали с банковским балансом, некоторые втягивали посторонние транзакции, чтобы сделать их согласованными (Penrose, 2025, как сообщила Gigazine, 2025). Новичок, который не видит шаг, не будет просить его проверить, если только список не назовет его. Поисковое сравнение в Приложении G2 показывает, насколько большой может быть этот разрыв без списка: люди, которые неправильно ответили на базовый вопрос профессии, оценивая его задачи только по описаниям, определили его более крупные задачи на четверть-треть меньше часов, чем другие. Закрывает ли список, составленный моделями, разрыв - это должно показать сравнение раздела 10.5. Рассматривая образно, процесс - это лестница выравнивателей: агенты уравняли многое в производстве, список перед работой и критик после могут уравнять часть проверки, хотя коррелированные ошибки между моделями (Kim et al., 2025) и слепота к пропускам (Fu et al., 2025) ставят пределы тому, насколько, и то, что остается, должна показать мера. Рисунок A4 (Приложение F) устанавливает четыре шага против того, что каждый из них представляет, что каждый приносит согласно правилу раздела 5.2 и где каждый останавливается, и сопровождающий репозиторий предоставляет их как набор для людей, которые работают таким образом (kits/checking-process.md).
Мера не решает вопрос заранее, и она не спрашивает, по какому пути была приобретена способность проверять. Если процесс новичка проходит проверки, которые агенты не видели, с пропусками и неправильными записями среди подставленных ошибок, горизонт новичка расширяется как у любого; если нет, запись показывает и это. Если оппонент раздела 6.1 прав (Savva, 2026), процесс будет работать лучше всего на коротких, хорошо определенных задачах и хуже всего на верхних ступенях, где знание того, что должно содержать произведение, имеет наибольшее значение, и опытный профессионал, принявший тот же процесс, должен показать результат лучше, чем любой из них. Если процесс может заменить часть опыта профессии, ярлыки опыта, включая младший и старший, теряют значение по той же причине, что и степени, что является потерей, определяемой точкой пересечения (раздел 6.2). Ни одно зарегистрированное предсказание не проверяет процесс: F3b оценивает обгон на задачах вне домена участников на 0.10 по аргументу домена раздела 6.3 и влияет на вопрос только косвенно. Раздел 10.5 излагает сравнение, которое бы его проверило.
7. Вторая граница: доверие
7.1 Неизвестность — нормальное состояние рынка
Что происходит, когда каждый может создавать? Ответ 2026 года таков: большинство создаваемого никогда не находит пользователей. Около 560 000 новых приложений достигли App Store в первой половине 2026 года, что близко к примерно 600 000 за весь 2025 год, при этом загрузки выросли примерно на 2%, согласно оценкам Sensor Tower, впервые сообщённым The New York Times и пересказанным вторичными источниками (9to5Mac, 2026; Gigazine, 2026). Выпуски в первом квартале выросли примерно на 60% в сравнении с предыдущим годом (TechCrunch, 2026b). В отчёте RevenueCat 2026 года, охватывающем приложения, использующие его программное обеспечение, 17% новых приложений-подписок достигли $1 000 ежемесячного дохода в течение двух лет, против 19% годом ранее, и приложения, запущенные с 2025 года, заработали около 3% дохода от подписок в январе 2026 года (RevenueCat, 2026; PPC Land, 2026). GitHub сообщила о 121 миллионе новых репозиториев в год Octoverse до августа 2025 года, более 230 в минуту (GitHub, 2025a), и 7,38 миллиарда коммитов только в сентябре 2026 года, более чем в пять раз больше, чем годом ранее (Celenza, 2026). Эти цифры отражают производство, а не продукты, которые нашли пользователей. Модераторы раздела «Show HN» крупного форума разработчиков сообщили, что автоматически сгенерированные проекты захлёстывают раздел шумом и ограничивают появление новых учётных записей (Krebs, 2026). Инвестор из Startmate утверждал в августе 2026 года, что когда создание дешёво, распределение защищает продукт, и описал мощные продукты, оставшиеся в пустоте с горсткой пользователей (Batko, 2026).
Та же картина наблюдается среди основателей. Индивидуальные основатели возглавляли около 36% стартапов, основанных на Carta в 2025 году, против 31% в 2024 году (Carta, 2026a), и 63% корпораций типа C, сформированных через Stripe Atlas на момент второго квартала 2026 года, что является рекордом для этого сервиса (Stripe, 2026). Начинать в одиночку стало обычным делом; зарабатывать в одиночку — нет. Среди индивидуальных основателей на Atlas медианный доход в первые шесть месяцев упал на 23% в год в 2025 году, в то время как доход в верхнем децилище вырос на 19%, так что верхний дециль заработал примерно в 61 раз больше медианы, против примерно 34 раз четыре года назад (Stripe, 2026). В предыдущем отчёте Carta индивидуальные основатели возглавляли 30% стартапов, основанных в 2024 году, но получили 14,7% денежных средств, привлечённых в раундах финансирования по установленной цене в том году (Carta, 2025). Обе выборки — собственные клиенты поставщиков, а не все новые фирмы, но они показывают то, что описывает этот раздел: больше людей может начать, и награды собираются в верхней части.
Платформы защищают себя от потока, исключая тех, у кого нет имени. Проект curl прекратил свою программу вознаграждения за ошибки в январе 2026 года после того, как сообщения, сгенерированные ИИ, её завалили, «не даже один из двадцати» из них был реальным (Stenberg, 2026). GitHub рассматривал возможность ограничения pull request'ов надёжными участниками (Open Source For You, 2026). Mitchell Hashimoto выпустил Vouch, при котором новичок не может вносить вклад в проект, если за него не поручится существующий участник (Hashimoto, 2026; Willison, 2026b). Защита от потока также останавливает новичка у дверей, что является закономерностью, которую сопутствующая статья описывает для автоматизированного надзора в целом (Chernets, 2026c). Поручительство, таким образом, существует как механизм, и то, станет ли оно профессией, — это вопрос для раздела 7.2.
Новыми вратарями являются агенты. В исследовании 2 430 запусков Claude Code написал собственное решение вместо принятия существующего продукта в 12 из 20 категорий, и когда он принял один, он выбрал знакомые названия (Amplifying, 2026). Около половины развёртываний Vercel запускались агентами к июлю 2026 года (Startup Fortune, 2026). Бесплатный продукт на хосте кода конкурирует с тем, что агент пользователя может написать за час, и то, что агент не может написать сам, — это доверие, обслуживание, стандарт или человек, который отвечает.
Долгосрочная перспектива не создаёт рынок. Горизонт фиксирует то, что человек может выполнить и подтвердить, доверие определяет, будет ли кто-то снаружи это использовать, а неизвестность — это разрыв между ними. Herbert Simon увидел экономику этого в 1971 году: богатство информации создаёт дефицит внимания (Simon, 1971). Агенты снизили барьер для кода, и приведённые выше доказательства показывают платформы и пользователей, столкнувшихся с потоком и требующих новых сигналов доверия перед тем, как они впустят новичка.
7.2 Две взаимосвязанные профессии
Есть мнение, что человек, который создаёт через агентов, неполноценен без навыка привлечения людей. Я понимаю это иначе: привлечение людей — это вторая ось, и две связанные функции развиваются вдоль неё.
Финишер доносит продукт до людей через каналы, запуски и видимость для поиска ИИ. Его названия уже заняты (инженер по росту, developer relations, GTM инженер, должность, широко объявляемая в 2026 году), и агенты будут автоматизировать часть этой работы, так как рассылки и запуски легко автоматизируются, а фильтры в ответ будут ужесточаться.
Гарант ставит своё имя под продукт и отвечает за него перед своим кругом. В июне 2025 года журнал New York Times Magazine назвал эту роль «юридическим гарантом»: «кто-то, кто берёт на себя ответственность, которую ИИ не может» (Capps, 2025). Слайд из обучающих материалов IBM 1979 года, впервые опубликованный в Интернете в 2017 году без указания источника, выразил суть в одну фразу: «Компьютер никогда не может нести ответственность» (Willison, 2025a). Neil Lawrence сказал то же самое в августе 2026 года: компьютеры хорошо ведут учёт, «но подотчётность не ведут» (Sadki, 2026). Эта функция является самой сложной для автоматизации, потому что её ценность заключается в человеке, который отвечает. В терминах теории агентства гарант продаёт обязательство: обещание, поддержанное собственной репутацией гаранта, и в развитой форме контрактом, который распределяет ответственность, и страховкой, которая эту цену назначает (Jensen & Meckling, 1976).
Функция и профессия — отдельные вопросы. Функция существует везде, где кто-то подписывается под работу, которую они не создали. Профессия появляется только когда это подписание регулярно покупается и оплачивается отдельно, и прогнозы F11 и F12 указывают на то, когда это происходит. Гарант также имеет естественный показатель в виде количества продуктов, за которые они поручились, того, как долго каждый существовал, и скольким было не хватать, взвешено по степени провала; сопутствующий репозиторий вычисляет это из реестра гаранта, с весами серьёзности, указанными тем, кто читает запись (tools/guarantor_record.py). Руководство во втором потоке раздела 9 выражает это четырьмя словами: word of mouth is reputation (переведено). Доверие должно основываться на вещах, которые можно проверить, как утверждает более ранняя статья этого цикла относительно торговли между агентами (Chernets, 2026d), и запись гаранта — это одна из таких вещей.
Третий тип появляется в одной из нитей Раздела 9: гид, который продает метод переноса целой компании на агентов. Нить показывает продажу. Читать его как гаранта для организаций, того, кто отвечает за результат перед управлением компании, - это мое понимание роли, которую он строит.
Человек, который строит через агентов, отвечает внутрь, за то, что он принял от агентов. Гарант отвечает наружу, людям, за то, что было выпущено. Один человек может выполнять оба, как свадебный фотограф одновременно снимает и отвечает, и когда продуктов слишком много, две функции разделяются, как когда-то разделились автор и издатель или ученый и журнал.
8. Два рынка: золотая лихорадка и свадебный фотограф
В 1849 году толпы устремились в Калифорнию за золотом. Среднесуточная добыча шахтёра или суточная зарплата нанятого рабочего падала с около $20 в 1848 году до $16 в 1849, $10 в 1850 и $6 в 1852 (Paul, 1947, p. 349). Bancroft оценивал золото, добытое на одного шахтёра в 1852 году, в "всего $600, или едва $2 в день", когда зарплаты обычного труда были в два-три раза выше (Bancroft, 1888, pp. 423-424). Sam Brannan, продававший шахтёрам инструменты, показал, что "самый верный способ процветать — оставить добычу другим" (Andrist, 1962), и продавцы инструментов и ткани преуспевали. Этот паттерн виден в 2026. Одна пятая новых приложений подписки или менее достигают $1,000 в месяц (Section 7.1), в то время как продавцы инструментов растут быстро: доход Lovable, например (TechCrunch, 2026a), и годовой AI бюджет Uber потрачен за четыре месяца (Fortune, 2026b), текут в лаборатории.
Венчурный капитал следует тем же путём в более крупном масштабе. AI фирмы получили 61% глобального венчурного капитала в 2025, $258,7 млрд из $427,1 млрд, и мега-сделки составили около 73% стоимости инвестиций в AI (OECD, 2026). В первой половине 2026 две лаборатории, OpenAI и Anthropic, привлекли около $217 млрд между собой, около 43% всего стартап-финансирования по всему миру (Crunchbase News, 2026). На другом конце среднее американское pre-seed инструмент на Carta достигло рекордных $276,000 во втором квартале 2026, в то время как количество инструментов упало примерно на одну пятую за год (Carta, 2026b). Более крупные чеки для меньшего числа новичков — это то, чего можно было бы ожидать, если разработка стала дешёвой, а определение того, кто будет успешен, нет. Человек, который может разрабатывать, не обязательно является человеком, который может привлекать инвестиции.
Аналогия нарушается в одном месте, и это нарушение важнее, чем совпадение. Цена золота была установлена законом, поэтому золото не дешевело по мере его добычи, и шахтёры теряли, потому что россыпи исчерпывались и толпа росла. Программное обеспечение копируется почти бесплатно. Каждый новый продукт добавляет ещё один близкий заменитель для остальных, и цена близких заменителей падает к стоимости копирования, которая близка к нулю. Золото не исчерпывается; оно превращается в песок, за исключением случаев, когда вместе с ним продаётся что-то, что нельзя скопировать (доверие, подпись, поддерживаемый сервис).
Фотография — более близкая аналогия. В 2026 году US Bureau of Labor Statistics насчитывает около 145,000 должностей фотографов в 2025 году и прогнозирует 1% спад с 2025 по 2035, где предыдущее издание прогнозировало 2% рост с 2024 по 2034 (Bureau of Labor Statistics, 2025, 2026a). В отличие от предыдущего издания, новое упоминает AI: фотографии со смартфонов могут снизить потребность в профессионалах, и готовые фотографии "прогнозируется будут частично заменены изображениями, созданными искусственным интеллектом (AI)", в то время как спрос на портреты и коммерческую работу продолжается и самозанятость растёт (Bureau of Labor Statistics, 2026a). Пары по-прежнему нанимают свадебного фотографа в 2026 и платят им. Работа выживает как оплачиваемая профессия, когда событие не может быть повторено, когда ошибку нельзя отменить, когда названный человек должен ответить за результат и когда клиент не может судить о качестве заранее и поэтому покупает доверие.
Эти условия расщепляют рынок на две части (Figure 6). Снимки с телефона — это вещи, которые люди делают для себя и своей команды: система уведомлений, замена инструмента заметок, собственный проверитель контрактов юриста. Создание для себя — это грамотность, как письмо, и почти каждый будет иметь её. Свадьба — это работа для других с последствиями: продукты, выпущенные для незнакомцев, деньги, здоровье, закон, инфраструктура. Работа для других — это профессия, определяемая проверенным горизонтом и тем, кто отвечает. Между двумя рынками стоит барьер неясности, и гарант работает на этот барьер.
Это разделение также отвечает на вопрос, которым я начал, "как следует называть этих людей?" Есть два ответа: одно имя для массового навыка и другое для профессии, и карта раздела 3 уже содержит кандидатов для обеих.
Kent Beck выразил это в одном предложении: "90% моих навыков только что упали до нуля долларов и 10% моих навыков только что возросли в 1000x" (Willison, 2025b). Некоторые опытные инженеры станут свадебными фотографами программного обеспечения, нанятыми для небольшой доли систем, где ошибка не может быть отменена. В данных 2026 года слабость в занятости проявляется среди младших работников (Stanford Digital Economy Lab, 2026a), поэтому я оставляю старший сектор как образ, в то время как прогноз F25 следует младшему сектору.
Figure 6. Два рынка, стена неясности между ними и двое партнёров, пересекающих её.
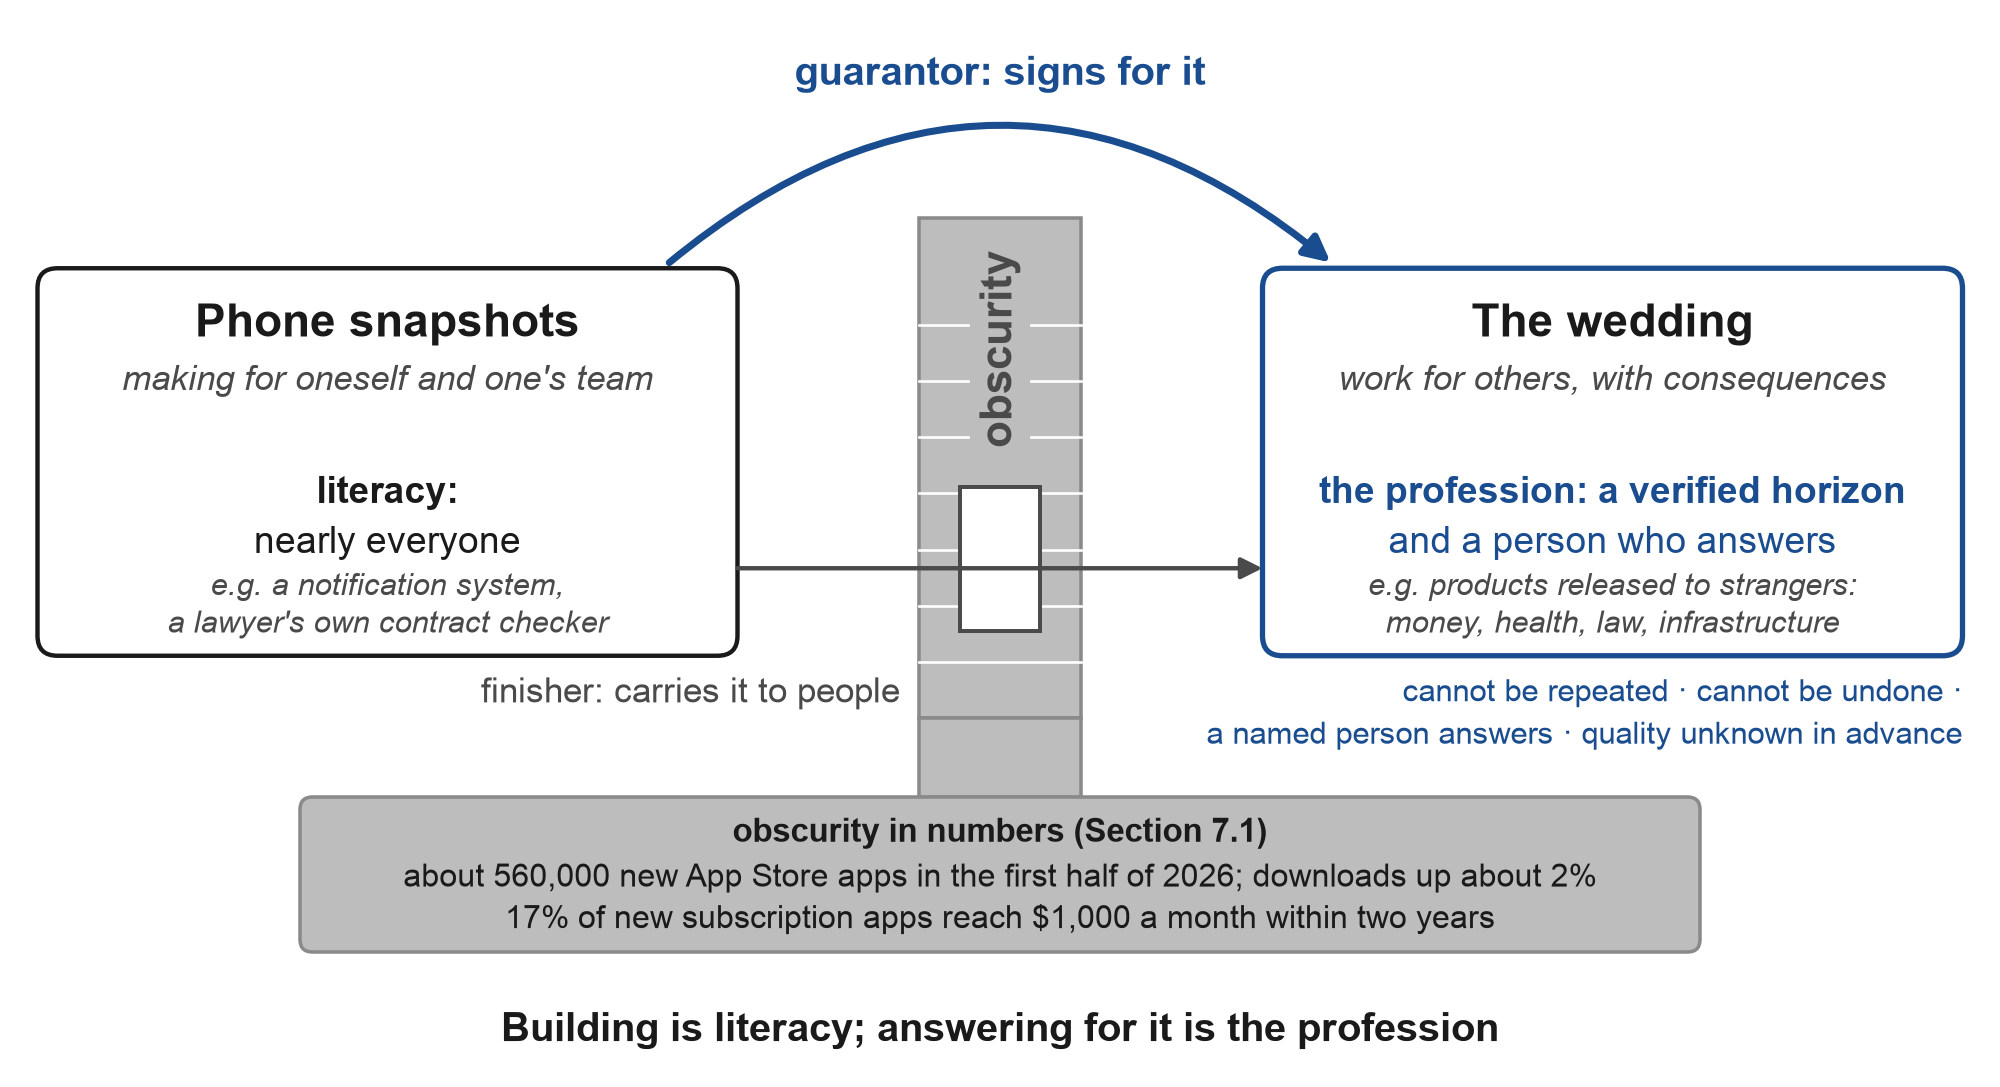
Примечание: Два числа относятся к стене неясности, а не к завершающему: около 560,000 новых приложений App Store в первой половине 2026 с загрузками вверх примерно на 2% (Sensor Tower оценки, как сообщается 9to5Mac, 2026, и Gigazine, 2026), и 17% новых приложений подписки достигают $1,000 в месяц в течение двух лет (RevenueCat, 2026). Примеры на каждом полюсе — это примеры раздела 8. Четыре условия — это условия раздела 8; арка и дверь — это две партнёрские функции раздела 7.2.
9. Что переходит из разговоров программистов
Разговоры программистов в 2026 году могут быть разговорами каждой профессии в 2027 году. Чтобы проверить это, я прочитал три открытых потока на Facebook, собранные 8 октября 2026 года (посты и комментарии; авторы комментариев здесь не названы).
В первом потоке автор бросил вызов разработчикам, которые говорят, что ИИ пишет неработающий код, показать случай, когда были применены все лучшие практики, а код по-прежнему не сработал. Он сам был уверен, что такого случая просто не существует. Поток превратился в спор об одобрении, и один участник резюмировал: проблема в том, может ли производство быть организовано так, чтобы результат ИИ мог быть проверен, одобрен и использован (переведён). Другой, работающий над исправлениями безопасности, сообщил, что даже с тестами и инструкциями сильная модель часто не может создать правильное смягчение для уязвимостей, оценённых выше 9 по шкале CVSS, и что автоматические циклы проверки и исправления становятся дорогостоящими. Менеджер с тридцатилетним стажем в IT ответил, что люди-программисты всегда доставляли ровно такую же головную боль. Другой комментатор оценил новую задачу в 150 долларов в час, ставку рецензента, который проверяет и исправляет код, написанный ИИ, а третий описал старшего инженера с двадцатилетним опытом, которому было трудно признать, что его навыки потеряли ценность.
Во втором потоке человек, который говорит, что не знает ни одного из языков, мигрирует платформу из 650 000 строк с одного языка программирования на другой, выполнив примерно 330 из примерно 600 запросов на слияние, и тратит 1 148 долларов в месяц на ИИ. Он продаёт метод перевода компаний на агентов и утверждает, что программисты для этой задачи приносят больше вреда, чем пользы. Он также делает себя видимым благодаря открытым расходам, списку проектов, промокодам, курсу и бесплатному часу для крупных фирм. По сути, он создаёт роль гида из раздела 7.2, и борется с безвестностью контентом.
В третьем потоке показан человек, строящий для себя на четырёх машинах, с 36-этапным потоком из раздела 5.4. Он сообщает, что ни один из его рабочих процессов от полугода до года назад не пережил, что он ожидает снова изменить их в течение трёх месяцев, и что испытывает постоянный страх упустить что-нибудь. Комментарии спорят о том, какой агент принадлежит какому лагерю.
Таблица A5 (приложение F) сопоставляет тематику потоков с тем, что было видимо среди людей вне сферы программного обеспечения в 2025 и 2026 годах. Её строки — иллюстративные случаи, а не выборка.
Таблица A5 показывает, что функция переходит, а форма остаётся позади. Бухгалтер, который научится проверять одно семейство моделей другим, по-прежнему будет называть это «правилами сверки» и «кто это проверил», не будет иметь слова для обвязки и не будет рассматривать выбор агента как вопрос идентичности. Маркеры статуса потоков, большой личный счёт, лагерь и четыре машины остаются в верхнем слое каждой профессии, как фотографы спорят о линзах, а их клиенты не спорят.
Переход также происходит слоями: сначала верхний десятый или около того процент каждой профессии, затем программы обучения, затем продукты, которые скрывают настройку внутри. Эта последовательность — теория диффузии, применённая к агентам, и здесь не утверждается её приоритет; Роджерс (2003) объединил инноваторов и ранних приверженцев примерно в одну шестую часть всех приверженцев. Собственный отчёт OpenAI отмечает, что вне компании «техническое использование остаётся доминирующим режимом» (OpenAI, 2026), а Anthropic обнаружила, что технические пользователи пришли первыми, а люди с менее оплачиваемыми задачами позже (Anthropic, 2026f). Раздел 11 формулирует переход функций как предсказание, которое можно проверить, прочитав учебные программы и посты.
10. Последствия
10.1 Для работодателей и отделов кадров
Работодатель, оценивающий сотрудников по зафиксированному результату, узнаёт больше из записи «Domain · horizon · amplification · date», чем из должностей «senior» или «manager», и такая запись может переходить между отделами. Естественный следующий шаг — тест при найме: дать кандидату однодневную задачу в его собственной области, которую нужно выполнить с помощью агентов, и проверить результат проверкой, которую кандидат не разрабатывал, содержащей несколько намеренно вставленных ошибок, которые кандидат должен найти. Логика оплаты труда Жака, согласно которой справедливая зарплата растёт с масштабом ответственности, служит исходной гипотезой для установления оплаты в зависимости от проверенного горизонта. Подтверждается ли эта гипотеза — эмпирический вопрос, и предсказание F18 в разделе 11 его формулирует: где работодатели оценивают по проверенной работе, там ступень должна лучше предсказывать оплату и производительность, чем стаж работы.
Оценка по количеству токенов — другое дело, и случай из раздела 4 показывает, к чему это приводит. Если обсуждение использования вообще происходит, оно должно входить в оценку производительности так же, как любой другой метод, в качестве одного из многих входных параметров.
Главное, на что нужно смотреть, — это кого организация на самом деле нанимает. Удаление требования об образовании из текста политики компании мало что меняет само по себе (раздел 6.2). А вот изменение в том, кого нанимают при одинаковом проверенном горизонте, — вот как выглядит точка пересечения изнутри компании.
10.2 Для образования и школ
Для школ урок таков: учить оценке раньше, чем синтаксису. Навыки, которые продвигают человека вверх, — сформулировать, что считается выполненным, выбрать проверку, которую агент не может видеть, и распознать правдоподобную ошибку в своей области, — могут преподаваться в любой дисциплине. Сертификат имеет ценность настолько, насколько ценна его проверка, поэтому сертификат должен указывать проверенный горизонт, который он удостоверяет, с указанием области и даты.
Школы, добавляющие грамотность в области ИИ в учебную программу, могут придать конкретное содержание области «Manage AI» рамок ОЭСР и Европейской комиссии: небольшая работа, переданная студентам, заранее зафиксированная проверка и взрослый, несущий ответственность за всё, что выпускается для посторонних.
10.3 Для поставщиков и платформ
Поставщики могут позволить функции принятия решения выйти за границы продукта. Человек должен иметь возможность экспортировать задачу, входные данные, проверку и решение об одобрении, чтобы запись могла перейти к работодателю или школе. Использование в этом случае сообщалось бы так же, путём подсчёта людей, одобривших проверенную работу, вместо подсчёта людей, открывших приложение.
Одна платформа уже начала идти по этому пути со стороны поставщика. В январе 2026 года LinkedIn начал показывать проверенные навыки ИИ, выданные Lovable, Replit, Descript и Relay.app на основе того, как участник на самом деле использовал каждый инструмент (LinkedIn, 2026a). Такой значок удостоверяет использование инструмента, оцениваемое самим поставщиком инструмента в соответствии с уровнями, которые установил поставщик; он не удостоверяет результат, проверенный кем-то, кого человек не выбирал. Эта же платформа продаёт агентов рекрутерам, с продуктами агентного найма с годовым оборотом выше 450 миллионов долларов на апрель 2026 года (LinkedIn, 2026b), и в июле 2026 года дала участникам возможность сообщать о постах, которые «выглядят как AI slop» (TechCrunch, 2026c), после того как производитель детектора Pangram оценил, что 41 % длинных постов на сайте с апреля по июнь 2026 года были полностью сгенерированы (The Decoder, 2026). Когда текст о собственной работе ничего не стоит производить, профиль говорит меньше, а запись о проверенной работе, которая не зависит от какого-либо одного поставщика, говорит больше.
Платформы, которые закрыли свои двери перед неизвестными, как многие сделали в 2026 году, могут открыть вторую дверь через поручительство. Новичок, чью работу подписывает известный человек, получает доступ, и репутация поручителя растёт или падает в зависимости от того, что происходит дальше.
10.4 Для продуктов, которые вводят людей в использование агентов
Продукты для первичной подготовки обычно разделяют «новичков» и «программистов» на первом экране. Предложение: заменить две двери одним вопросом: что вы уже можете передать агенту и проверить, ничего ещё, час, день или неделю? Пока двери не объединяются, однократный вопрос об образовании в области ИТ с согласием позволяет проверить, не зависит ли направление продукта от происхождения его пользователей.
10.5 Для исследователей
Исследователи могут построить матрицы «человек-задача», которые, по словам Чэня и Мэнга (2026), не существуют, сравнить людей, использующих одних и тех же агентов под слепыми проверками, сообщить знаменатель с включением работы, которая не прошла проверки, и сохранить справочный банк зафиксированным и опубликованным. Инструмент в приложении C уже делает это: он не учитывает элементы, чья проверка записана как не независимая, и он сообщает обе оси с датой.
Одно сравнение вытекает из раздела 6.5 и ещё не проводилось. На одних и тех же задачах из банка, под проверками, которые агенты не видели, и с намеренно вставленными ошибками обоих видов, неправильными записями и пропусками, оно пересекало бы опыт в деле (наличествующий или отсутствующий) со способом работы (один агент, выход которого принимается как есть, или процесс проверки из раздела 6.5). Опыт устанавливался бы тестом знаний и записью работы, а не ярлыком профиля (раздел 6.2), и элементы, ошибки в которых нельзя отменить, проверялись бы скрытым тестом или квалифицированным человеком, как требует раздел 5.2. Пропуски и неправильные записи оценивались бы отдельно: составленный заранее список ориентирован на первые, а рецензенты на вторые, и разрыв, который предлагает приложение G2, относится к первому виду. Сравнение показало бы, на какую долю опыта в деле процесс может заступить и на какой ступени это прекращается. Сравнение с профессионалами, работающими без агентов, здесь ничего не решило бы по причине, изложенной в разделе 11.1. Предсказания раздела 11 зафиксированы и не включают этого сравнения, которое было бы зарегистрировано отдельно перед сбором данных. Вспомогательный репозиторий содержит его как протокол для адаптации и регистрации (kits/process-vs-experience-study.md), с инструментом, запечатывающим намеренно вставленные ошибки задачи перед передачей и отдельно оценивающим неправильные записи и пропуски после неё (tools/planted.py), и анализом, выводящим четыре рукава и, для каждого вида ошибки отдельно, эффект процесса среди новичков, эффект опыта при работе с одним агентом и их взаимодействие, с интервалами, полученными путём переодобрывания (tools/process_study.py).
11. Датированные прогнозы, зарегистрированные и оценённые
11.1 Правила написания прогнозов
Я составил прогнозы согласно правилам, которые позволяют их проверить. Сравнивается подобное с подобным: непрограммисты сравниваются с программистами, использующими те же агенты, на одних и тех же задачах, с одинаковым временем, потому что сравнение с программистами, работающими без ИИ, здесь ничего не определяет.
«Лучше» имеет три значения, каждое проверяется отдельно. Для кода используются скрытые тесты, проверка безопасности и изменение, сделанное другим агентом месяц спустя для проверки поддерживаемости. Для продукта тест — доступен ли он незнакомцам и работает ли он спустя шесть месяцев. Для резюме тест — вес степени в объявлениях о работе. Популярность не используется в качестве критерия «лучше», потому что она измеряет распределение, которое может быть отдельной профессией (Раздел 7.2).
Прогнозы также не зависят от названия профессии. Они описывают «людей без ИТ-образования, работающих через агентов», поэтому сохраняют значение независимо от того, какое название профессии победит.
11.2 Прогнозы
Таблица 4 приводит десять основных прогнозов в краткой форме; Таблица A6 (Приложение D) и файл predictions/predictions.csv сопроводительного репозитория содержат все 41, каждый с мерой, базовым уровнем 2025 или 2026 года, правилами для трёх исходов (сбылось, не сбылось, неразрешено), датой проверки и финальной датой, вероятностью, резервным источником и ближайшим предшествующим или противоположным прогнозом. Вероятность не оправдывает прогнозиста, который оказался неправ, но позволяет оценить ошибку. Один прогноз с вероятностью 35%, который не сбылся, сам по себе мало что говорит. Была ли 35% правильной вероятностью, можно судить только по всему набору, где примерно треть таких прогнозов должны сбыться. Правило Бриэра (Brier, 1950) дает один общий балл точности по всему набору, объединяя калибровку со способностью отличить то, что происходит, от того, что не происходит. Основной прогноз противоречит текущему мнению, поскольку данные о найме по-прежнему благоприятствуют степеням для работы с ИИ, Gartner ожидает, что большинство приложений, основанных на интуиции, будут выведены из эксплуатации, и Andrew Ng утверждает, что побеждает глубокое понимание программ. Таблица ставит на противоположный результат при указанных коэффициентах: зарегистрированная вероятность обгона в своей области (F3) составляет 0,35. Она находится ниже 0,5, потому что данные поставщиков по-прежнему ставят профессии программирования примерно на 5 пунктов впереди (Раздел 2.2), и Savva (2026) предсказывает более широкие разрывы на более сложных задачах (Раздел 6.1), и выше 0,25, потому что паритет, предыдущий шаг, оценивается в 0,70; прогнозы независимых моделей варьировались от 0,25 до 0,55. На Рисунке 7 каждый прогноз расположен по его году проверки и вероятности.
Прогнозы делятся на два набора. Набор A (27 прогнозов) определяется по общедоступным данным и по зафиксированным запросам, спискам и справочникам кодов в predictions/resolve/, так что любой может его оценить без меня. Набор B (14 прогнозов: F2, F3, F3b, F4a, F4b, F7, F12, F14, F18, F19, F20, F26, F34, F35) — это исследовательская программа: ей нужны данные, которые ни один общедоступный источник не публикует, и определяется только из исследования, зарегистрированного отдельно перед сбором данных, с названным владельцем, протоколом и расчётом мощности. Для девяти прогнозов набора B, чьи правила выражены в виде интервала, сопроводительный репозиторий применяет зафиксированные правила сбылось и не сбылось к оценкам исследования и печатает зафиксированные слова рядом с каждым вердиктом (predictions/set_b.py). Прогноз набора B, чей протокол не зарегистрирован к 30 июня 2027 года, записывается как непроведённый и указывается на каждой карточке оценок как неудача программы тестирования. Затем балл Бриэра сообщается дважды, только по разрешённым прогнозам и с каждым непроведённым прогнозом, оценённым как если бы прогноз оказался неправильным, так что исследование, которое никогда не проводится, не может быть исключено из подсчёта. Эксперименты F2, F3 и F3b — это одно исследование с 1500 человек в группе: это даёт примерно мощность 0,8 для обнаружения истинного преимущества в 5 пунктов (двусторонний альфа 0,05, при доле успеха около 50%, наименее благоприятный случай), где при 400 человек в группе это обнаруживалось бы только примерно в 30% случаев. Для каждого основанного на исследовании прогноза интервал, который не соответствует ни правилу сбылось, ни правилу не сбылось, считается неразрешённым, а не неудачей.
Вероятности были зафиксированы 9 октября 2026 года. Каждая является медианой трёх слепых прогнозов моделями трёх семейств (Claude Opus, модель OpenAI и Gemini), которые оценили одну и ту же таблицу, не видя моих чисел; я принял эти медианы в качестве моих вероятностей, они зарегистрированы на OSF, и каждое изменение от моих более ранних версий записано в журнал изменений. Более ранний раунд 4 независимых прогнозистов моделей из 4 семейств также оценил таблицу слепым методом. Каждый дал класс аналогов, однострочный аргумент и вероятность, и их объединённый прогноз (геометрическое среднее коэффициентов) показан рядом с зарегистрированной вероятностью в Таблице 4, с разбросом в CSV. Где зарегистрированная вероятность отличается от медианы того раунда более чем на 0,15 (F28 и F32), причина указана в журнале изменений. Все вероятности условны в отношении разрешения прогноза, потому что балл Бриэра вычисляется по разрешённым прогнозам. Доля разрешённых указана рядом с ним.
Таблица 4. Десять основных прогнозов с пороговыми значениями, финальными датами и вероятностями (все 41 в Таблице A6).
| # | Прогноз | Пороговое значение | Финальная дата | p | Модели | Данные |
|---|---|---|---|---|---|---|
| F1 | Разрыв в проверенном успехе закрывается в данных поставщиков | Программирование минус другие профессии 2 пункта или меньше (сейчас 34% против 29%) | 31 December 2028 | 0.35 | 0.39 (0.25 to 0.65) | общедоступные |
| F2 | Паритет качества в своей области | Нижняя граница 95% (не-ИТ минус программисты) выше минус 10 пунктов; 1500 человек в группе | 8 October 2028 | 0.70 | 0.67 (0.62 to 0.70) | собственное исследование |
| F3 | Обгон в своей области (пересечение в качестве) | Нижняя граница 95% выше нуля; то же исследование | 8 October 2029 | 0.35 | 0.33 (0.25 to 0.55) | собственное исследование |
| F5 | Пересечение в объявлениях | Доля степени в объявлениях о работе с агентом ниже подобранных объявлений на 2 пункта или более, два последовательных квартала 2027 года | 31 December 2028 | 0.30 | 0.34 (0.25 to 0.60) | общедоступные |
| F7 | Нейтральность происхождения | Интервал 90% отношения шансов для ИТ-образования в диапазоне 0,67 до 1,5, в День и в Неделю | 31 December 2029 | 0.42 | 0.43 (0.40 to 0.48) | собственное исследование |
| F14 | Две оси остаются различными | Коэффициент Spearman логарифма горизонта и логарифма выигрыша 0,8 или ниже; выигрыш добавляет 0,02 вне-выборочной R в квадрате | 30 сентября 2028 | 0,52 | 0,49 (0,45 до 0,50) | исследование авторов |
| F19 | Проверка устанавливает потолок | Доля проверок в месяцах 1–3 превосходит горизонт при прогнозировании верифицированного результата в месяцах 4–6 | 30 сентября 2028 | 0,45 | 0,44 (0,30 до 0,65) | исследование авторов |
| F26 | Практика найма следует | Аудиторское исследование: разрыв в приглашениях менее 3 пункт, 95% интервал в пределах 5 | 31 декабря 2029 | 0,35 | 0,32 (0,25 до 0,35) | исследование авторов |
| F27 | Созданные агентами продукты пережили прогноз | Менее 50% выборки, зафиксированной на 31 декабря 2026, выведено из обращения к концу 2028 (Gartner: 60%) | 31 марта 2029 | 0,32 | 0,35 (0,20 до 0,55) | открытые источники |
| F28 | Машины достигают День в 80% | METR горизонт 80% в 8 часов или больше к концу 2027 (3,1 часа в апреле 2026) | 30 июня 2028 | 0,80 | 0,66 (0,55 до 0,80) | открытые источники |
Примечание: p — зарегистрированная вероятность того, что прогноз подтвердится при условии его разрешения: медиана трёх независимых модельных прогнозов от 9 октября 2026 г., которые я принял. Модели: объединённый прогноз независимых авторов прогнозов, которые не видели мои показатели (геометрическое среднее коэффициентов), с их диапазоном. Данные: открытые источники означают разрешимость из общедоступных источников кем-либо (Набор A); исследование авторов означает отдельно зарегистрированное исследование (Набор B). Правила для подтвердившихся, неподтвердившихся и неразрешённых, резервные источники и предыдущие прогнозы для всех предсказаний находятся в таблице A6 и в predictions/predictions.csv. Предсказание без сравнимых данных до его конечной даты не разрешено и никогда не считается успехом. Программа, зарегистрированная в OSF (Chernets, 2026e), не имеет гипотез и не спрашивает об образовании в ИТ, поэтому она не может протестировать Набор B.
Рисунок 7. Реестр предсказаний: каждое датированное предсказание в его году проверки и указанной вероятности.
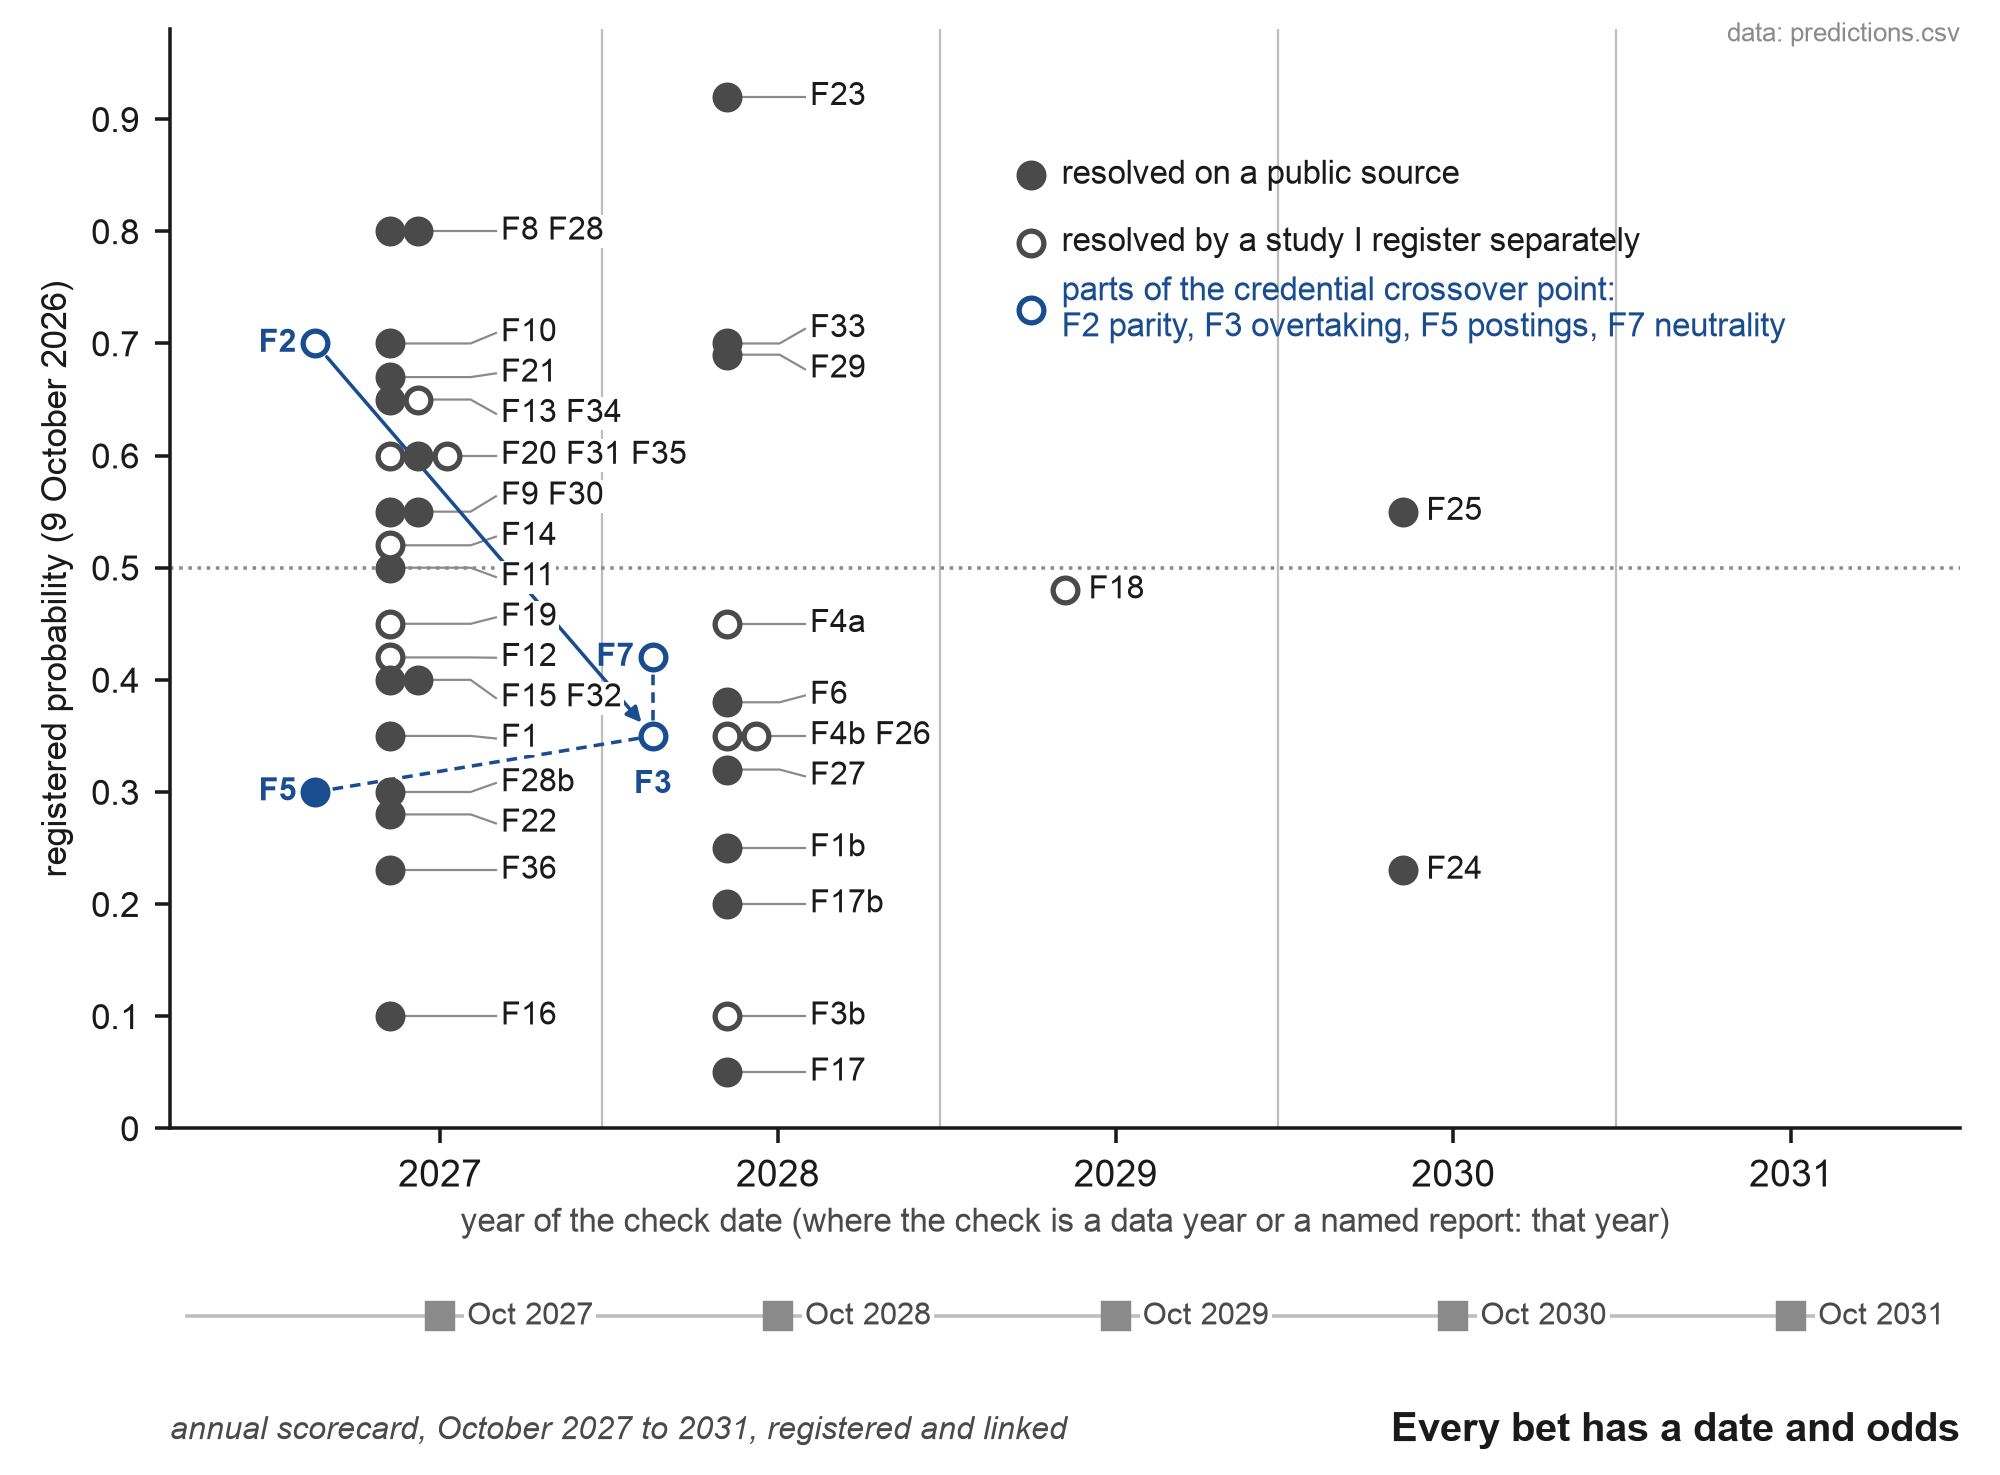
Примечание: Каждый маркер — одно из 41 предсказания из таблицы A6, расположенное на год его даты проверки (где проверка — это год данных или именованный отчёт, этот год) и на его зарегистрированную вероятность. Заполненные маркеры разрешаются из открытого источника. Полые маркеры разрешаются только через исследование, зарегистрированное отдельно перед сбором данных. Четыре части точки пересечения полномочий находятся в акцентном цвете: паритет качества (F2) ведёт к опережению (F3). Пересечение в публикациях (F5) — его видимый знак, а нейтральность фона (F7) — его механизм. Только паритету назначена вероятность выше чётных ставок (0,70). Опережение, сам момент, установлен на 0,35. Квадраты ниже оси обозначают годовые таблицы оценок, подлежащие регистрации в OSF и связанные с DOI, октябрь 2027–2031. Вероятности были зафиксированы 9 октября 2026 и зарегистрированы в OSF.
Одно годовое измерение сопровождает предсказания, не являясь самим предсказанием — отслеживание имён: каждый год одни и те же запросы подсчитывают, как часто каждый кандидат таблицы A2 появляется в объявлениях США и в OpenAlex и Crossref. Вопрос, который был когда-то только долгосрочной проверкой, будет ли SOC 2028 называть профессию для управляемой агентом работы, теперь является предсказанием F23 с вероятностью (Bureau of Labor Statistics, 2026b). На 9 октября 2026 Bureau of Labor Statistics не опубликовало ни предложенную, ни окончательную структуру SOC 2028; окончательная структура ожидается в 2027.
11.3 Предыдущие прогнозы
9 октября 2026 я искал в Metaculus, Manifold, Good Judgment Open, Kalshi, Polymarket и Long Bets, а также в открытой сети (страницы исследований компаний, выпуски аналитиков, arXiv, SSRN и новости), датированные прогнозы о том, что люди без технического образования, работающие через ИИ-агентов, могли бы соответствовать или превосходить программистов, использующих тех же агентов. Ни один найденный прогноз не содержит дату и опровергающий результат. Ближайшие к этому такие. Gartner предсказала в 2021 году, что к 2024 году 80% технологических продуктов и услуг будут построены людьми, которые не являются технологическими специалистами (Gartner, 2021). Mark Cuban сказал в 2017 году, что он скорее был бы специалистом по философии, ожидая, что критическое мышление превзойдёт программирование (Black Enterprise, 2017). D. H. Hansson ответил «100%» на Lex Fridman Podcast от 26 августа 2026, когда его спросили, есть ли проблемы, для которых программисты хуже непрограммистов в управляемой агентом инженерии (Lex Fridman Podcast, 2026). Anthropic заметила в июне 2026 года, что кодирующие агенты делают опыт в программировании менее актуальным (Anthropic, 2026e). Существуют прогнозы в противоположном направлении. Gartner ожидает, что 60% приложений, написанных по наитию, будут сняты с производства к 2028 году (Gartner, 2026, как описано в Tray.ai, 2026), и ожидала в 2024 году, что до 2026 года пятая часть организаций будет использовать ИИ для упрощения своей структуры (Gartner, 2024). Srinivasan и Wei (2026) ожидают, что «менеджер агентов» станет стандартным названием должности в течение 12–18 месяцев. Forrester ожидала, что 60% компаний из Fortune 100 назначат главу управления ИИ (Forrester, 2025). На рынках Manifold вероятность сокращения на треть должностей младших разработчиков к 2030 году составляет около 74%, а вероятность падения более чем на 15% разработчиков США с 2023 по 2028 год составляет около 42% (Manifold, 2026b; Manifold, 2026c). На Manifold вероятность того, что к 2027 году будет обычным для непрограммистов писать небольшие скрипты с ИИ, составляла около 27% (Manifold, 2026a), и этот вопрос спрашивает только об использовании, без меры качества. Предсказания здесь отличаются от всех этих тем, что сравнивают людей с людьми, использующими того же агента, тем, что образование является переменной, и тем, что имеют дату, меру и опровергающий результат. Журнал поиска находится в приложении B. Принятие по слоям (Rogers, 2003), временные горизонты машин (Kwa et al., 2025) и наблюдение того, что младшие должности исчезают, — это предшествующие работы, и нет претензии на приоритет для них.
11.4 Замораживание и оценка
Где должен находиться прогноз, чтобы его не мог тихо изменить никто, включая его автора? Из упоминаемых здесь мест только одно останавливает изменения. Регистрацию на OSF нельзя отредактировать или удалить; её можно отозвать, но страница с названием, датами, DOI и причиной отзыва остаётся (OSF, 2026). Zenodo позволяет депозитарию менять или удалять файлы в течение 30 дней после публикации, а после этого только создавать новые версии (OpenAIRE, 2025). SSRN заменяет PDF при переиздании. Поэтому прогнозы будут сначала зарегистрированы на OSF как открытая регистрация, сделанная общедоступной немедленно, без эмбарго, потому что эмбарго скрыло бы запись и скрыло бы её DOI, а приоритет, который никто не видит, стоит мало.
9 октября 2026 года таблица была зарегистрирована на OSF как набор предварительно зарегистрированных прогнозов (DOI 10.17605/OSF.IO/VW6P9), и статья была опубликована на SSRN и Zenodo; снимки каждого базового источника архивируются в Wayback Machine. Каждый год с 2027 по 2031 год в день годовщины регистрации публикуется оценочная таблица, в которой перечислены все прогнозы без исключения, их статус (сбылись, не сбылись, ещё не наступили, нерешённые, не проводились) и доказательства. В ней представлены оценка Бриера по разрешённым прогнозам в целом, по наборам и по семействам, где связанные прогнозы учитываются один раз и сгруппированы, как в столбце семейства зарегистрированной таблицы (F1 и F1b; F2, F3 и F3b; F4a и F4b; F5, F6 и F33; F9 и F31; F15 и F16; F17 и F17b; F28 и F28b); доля разрешённых; наихудшая граница, при которой каждый прогноз по прошествии его окончательной даты и остающийся нерешённым, и каждый непроведённый прогноз, оценивается, как если бы прогноз был неправильным; оценка с прогнозами, не проведёнными, и без них; и оценка мастерства Бриера в сравнении с тремя эталонами: плоская 0,5, объединённая модель прогнозистов таблицы 4 и рыночная цена, где рынок существовал в день регистрации. Избирательное неразрешение не может улучшить оценку. Оценочная таблица сама зарегистрирована на OSF, связана с оригиналом через DOI и депонирована на Zenodo. Модели из как минимум двух семейств проверяют каждую оценочную таблицу независимо в соответствии с замороженными правилами; если они не согласны, решает правило и о разногласии сообщается. Текст регистрации находится в Приложении D, и Рисунок A1 (Приложение D) показывает полный календарь проверки и окончательных дат. Два обязательства подлежат выполнению до начала подсчёта оценок. Образец продуктов, построенных агентом, для F27 заморожен на Zenodo к 31 декабря 2026 года, и базовые линии F5 и F30 вычисляются и архивируются перед регистрацией. Протокол образца F27 с значением по умолчанию для каждого выбора, который оставляет открытой регистрация, и инструмент, который его рисует по заранее зафиксированному семени и печатает его, находятся в сопровождающем репозитории (kits/f27-sample.md, tools/freeze_sample.py).
После регистрации прогнозов, общественные из них также будут размещены там, где сторонние прогнозисты могут их оценить: пять рынков на Manifold (F5, F8, F10, F11 и F22, которые бесплатны для публикации; эти пять были выбраны потому, что каждый разрешается на общедоступном источнике и внешнем ряду, который может прочитать кто угодно, без использования моих собственных данных), один вопрос на Metaculus (пересечение в публикациях, F5) и Платформу прогнозирования социальных наук для экспериментов F2, F3 и F7, чтобы прогнозы других людей были собраны до того, как появятся данные. Рынки прогнозирования, в которых торгуют деньги в зависимости от результата, не используются.
11.5 Программа когорты
Я управляю предварительно зарегистрированной программой когорты (OSF, https://osf.io/x4egq, DOI 10.17605/OSF.IO/X4EGQ), которая отслеживает путь непрограммистов от чата через агентов к оркестровке (Chernets, 2026e). Её первая когорта — одноплечее исследование осуществимости со своими зарегистрированными результатами, которые сообщаются в собственном отчёте. Прогнозы, такие как F7, F14 и F18–F20, которые требуют данных на уровне отдельного человека, проверяются в более поздней когорте, зарегистрированной для них до сбора данных, с вопросом об образовании в области ИТ среди её зафиксированных элементов. Записи Приложения C, ведущиеся с согласия, являются естественными данными для этой когорты.
12. Доказательства, против которых ставят на прогнозы
Прогнозы раздела 11 противоречат нескольким видам доказательств из 2026 года, и каждое из них повлияло на правило меры или прогноз.
Безопасность не поспевает. На более чем сотне моделей доля сгенерированного кода, прошедшего проверку безопасности, осталась на уровне 56% в отчёте Veracode за 2026 год (Veracode, 2026). Эти тесты запускались только на моделях, с использованием стандартных подсказок без инструкций по безопасности и без агентного каркаса, инструментов или проверки человеком, поэтому они описывают исходный материал, с которого начинает человек. Пассивное сканирование 5600 публичных приложений, построенных с помощью интуитивного кодирования, обнаружило более 2000 уязвимостей, более 400 раскрытых секретов и 175 утечек личных данных, и авторы представляют это как нижнюю границу (Escape, 2026). Поэтому F2 включает слепую проверку безопасности, и поэтому необратимая работа требует, чтобы каждая часть прошла проверку (раздел 5.2).
Прохождение тестов недостаточно для принятия. METR попросила мейнтейнеров рассмотреть исправления, написанные агентом, которые прошли тесты эталона, и обнаружила, что примерно половину не слили бы в таком виде; агенты были из более ранней версии без цикла обзора, поэтому доля теперь может быть ниже (METR, 2026b). Правило оценки отвечает скрытыми тестами, квалифицированными рецензентами и реальным использованием, а F2 добавляет проверку обслуживания месяц спустя.
Проверка зависит от опыта. В опросе 162 человек, занимающихся интуитивным кодированием, каждая группа признавала риски сгенерированного кода, но способ его проверки варьировался в зависимости от опыта. Авторы называют это пробелом между восприятием и действием (Fawzy et al., 2026). Бизнес-пользователи и новички быстро создают работающие прототипы, в то время как качество кода неравномерно, и требуется переделка (Gama et al., 2026). Бизнес-пользователи также упустили материальные ошибки в анализе ИИ даже после предупреждения (Virk & Liu, 2025). Рандомизированное исследование 52 младших инженеров, изучающих новую библиотеку, выявило показатели понимания 50% с помощью ИИ против 67% без помощи, и без значительного выигрыша в скорости. Те, кто запросил у модели объяснения, набрали 65% или выше, а те, кто передал весь код, набрали менее 40% (Anthropic, 2026c). Это главная причина, по которой мера опирается на навык принятия и выявление ошибок: навык, разделяющий людей, — это как раз тот, который эти исследования показывают варьирующимся.
Нет опубликованного сравнения, которое сопоставляет непрограммистов с программистами, использующими те же агенты. Esnaola et al. (2026) обнаружили, что некоторые непрограммисты, использующие GPT-4o через ChatGPT, решали небольшие, четко определённые задачи программирования на уровне, сравнимом с программистами, работающими без ИИ, и быстрее; авторы называют исследование исследовательским. Программисты работали без ИИ, поэтому в дизайне не было группы программистов с ИИ, и он изучал краткие индивидуальные задачи, а не продолжительную разработку; пакет воспроизведения доступен публично (Esnaola et al., 2026). В данных Anthropic люди, новые для задачи, имели проверенный процент успеха 15% в сравнении с 28–33% для более опытных пользователей (Anthropic, 2026e). Там «новичок» означает новичка в задаче, судя по модели, и ничего не говорит об образовании в области информационных технологий. Отражает ли этот разрыв образование или знакомство с задачей, — это то, что F7 предназначен разделить. Ещё раньше, генеративный ИИ в компании по обслуживанию клиентов повысил производительность новичков и низкоквалифицированных агентов больше всего, а самых опытных — мало (Brynjolfsson et al., 2025), исследование из периода до появления агентов. В 2024 году полевой эксперимент в Procter & Gamble с моделями чата показал, что люди с ИИ соответствовали командам без него и создавали сбалансированную работу независимо от их профессионального происхождения, исследование из периода до появления агентов (Dell'Acqua et al., 2025). F2, F3 и F7 предназначены для предоставления отсутствующего сравнения.
Авторитетные голоса не согласны с сильной версией. Karpathy придерживается нижних и верхних границ (раздел 2.1). Andrew Ng утверждал в августе 2026 года, что разработчики, глубоко понимающие, как работают программы, значительно превосходят тех, кто кодирует интуитивно без этого понимания (Ng, 2026). Данные по найму указывают в том же направлении: должностные объявления, требующие навыков ИИ, все ещё чаще требуют четырёхлетней степени, чем сравнимые объявления без таких требований (Lightcast, 2026b), и LinkedIn связывает значительную часть слабости при найме на начальные должности с экономической ситуацией (раздел 2.4). Прогнозы рассматривают эти взгляды как противоположную позицию, с вероятностями, указанными заранее.
13. Область применения и граничные условия
Время. Доказательная база охватывает период до 9 октября 2026 г. Сведения о продуктах будут быстро устаревать, поэтому мера определяется в терминах эталонных часов и проверок без упоминания конкретных продуктов.
Источники. Большая часть наиболее убедительных доказательств получена от производителей об их собственных продуктах: OpenAI — об агенте кодирования, Anthropic — о своих сессиях. Они помечены как данные производителей и используются для того, что известно производителям. Несколько освещённых в прессе эпизодов, таких как рейтинги токенов, основаны на сообщениях названных источников и цитируются как таковые. Вторичные источники (Growthy, Startup Fortune, Shopifreaks) архивируются в Wayback Machine перед публикацией, и первичный отчёт цитируется везде, где его можно было найти.
Совокупность. Аргумент касается работы, выполняемой на компьютере через агентов, людьми, которые могут её проверить. Люди без контролируемого ими компьютера и работа, которая вообще не может быть проверена, находятся вне сферы данной меры.
Что утверждает мера. Проверенный горизонт описывает то, что человек доставил в условиях режима проверки в определённой области в определённый момент времени. Она не утверждает, что большее значение лучше для каждой задачи. Большая часть работы подходит для Hour, и выбор сохранить работу в ручном режиме является законным решением. В областях, где ошибка не может быть исправлена, применяется более строгий порог из раздела 5.2, и некоторую работу вообще не следует передавать агентам.
Названия. Карта раздела 3 фиксирует использование, найденное 8 и 9 октября 2026 г. Названия будут приняты и отброшены в последующем, поэтому карта связана с ежегодным состязанием названий и ни одно название не выбирается.
Основной тезис. То, что люди без технического образования будут создавать лучшие продукты, чем программисты, сформулировано как набор предсказаний с датами и пороговыми значениями (F2–F7). Я представляю это как прогноз, который должен быть оценён публично.
Действия, зарезервированные законом. Когда закон требует лицензии для определённых действий, ни данная мера, ни потеря веса из-за ограничений на метку (разделы 6.2 и 6.5) не влияют на эти действия. В Соединённом Королевстве никто не может действовать в качестве обязательного по закону аудитора, кто не имеет права на назначение, которое требует членства в признанном органе надзора и соответствия его требованиям (Companies Act 2006, пп. 1212 и 1213), и в Соединённых Штатах только фирма, зарегистрированная в Public Company Accounting Oversight Board, может подготавливать или издавать отчёт об аудите по отношению к эмитенту (Sarbanes-Oxley Act of 2002, п. 102). В бухгалтерском учёте такие зарезервирования узкие: бухгалтера в Соединённых Штатах обычно не требуется иметь даже сертификацию (Bureau of Labor Statistics, 2026c). В праве они шире: Англия и Уэльс зарезервировали шесть юридических действий, включая ведение судебных разбирательств и действия, связанные с наследственным правом (Legal Services Act 2007, п. 12). Работа может поэтому переместиться, в то время как подпись остаётся, и лицензированный подписант затем исполняет функцию гаранта раздела 7.2 в форме, которую закон уже предусматривает. Насколько лицензия допускает выполнение по метке или по проверенной работе, обсуждается в разделе 6.2.
Данные предшествующего периода. Серии данных до 2025 г. входят только как предшественники, потому что они описывают работу без агентов. Макроэкономика найма определяется данными LinkedIn 2026 г. (раздел 2.4), которые указывают скорее на экономику, чем на ИИ.
Статус утверждений. Таблица A7 (приложение F) применяет язык доверия серии к каждому элементу.
14. Заключение
Бухгалтер, сравнивающая кодирующие агенты, и адвокат, разрабатывающая свой собственный инструмент проверки контрактов, теперь работают так, как работает разработчик, когда она передаёт модуль агенту и проверяет результат. К 2026 году все трое используют один рабочий процесс, и ни одна из старых лестниц не может сказать, кто из них продвинулся дальше. Название не разрешило бы это, потому что каждое название, предложенное в 2026 году, - это либо слоган, либо чья-то должностная объявление, а рынок не выбрал между ними. Мера может это решить, при условии, что она считает правильное.
Предложенная здесь мера не ждёт, пока профессия будет названа. Она рассматривает бухгалтера, адвоката и разработчика по одной шкале - размер работы, которую каждый передал агентам и проверил, в области и в определённый момент времени, со второй осью для количества проверенной работы, которое обеспечивает час их собственного внимания. Её пороги имеют версии и прошли настольные тесты, и настольный тест уже исправил один из них; её правила указывают способы, которыми запись может быть манипулирована, и защиту для каждого, а её потолок объясняет, почему цена проверки устанавливает предел независимо от скорости агента. Для работодателя, школы или платформы вопрос меняется. Вместо того чтобы спрашивать, является ли человек программистом или сколько ИИ он использовал, они просят представить дневную работу в своей области, которая прошла проверку, которую этот человек не разработал. Любое имя, которое выбирает рынок, можно прочитать на этой шкале.
Датированные прогнозы выражают тезис, с которого началась эта статья. От области к области продукты, созданные людьми без образования в области IT, начнут опережать продукты программистов, использующих тех же агентов. При одинаковом проверенном горизонте образование в области программирования перестанет предсказывать качество проверенной работы. И в объявлениях о вакансиях линии требований к образованию будут пересекаться, сначала в областях, где эксперты могут принять работу сами, и в последнюю очередь в сфере программного обеспечения. Если табели оценок 2027 и 2028 годов противоречат этим прогнозам, они скажут об этом публично с оценкой Брайера. Если прогнозы оправдаются, слова junior и senior могут выжить, и их значение сместится в сторону размера работы, которую человек может доказать; заменят ли крупные работодатели свои служебные лестницы такой мерой - это само по себе прогноз здесь (F17), зарегистрированный при p = 0,05.
Одна граница останется, что бы ни случилось с этими прогнозами. Создание становится грамотностью, как письмо. Ответственность за то, что создано, остаётся профессией, и между ними стоит неясность, состояние рынка 2026 года, в котором хорошая работа остаётся невидимой, и платформы закрывают свои двери перед неизвестными. Человек, который создаёт через агентов, будет нуждаться в партнёре, который подписывает работу, или будет вынужден стать этим партнёром, и гарант в свою очередь может быть измерен тем, за что он поручился, и сколько из этого сохранилось.
Одна американская поговорка гласит, что Бог создал людей, а полковник Кольт сделал их равными. Агенты делают что-то подобное для создания: с одним агентом человек, находящийся вне профессии, может производить работу, которая выглядит как работа этой профессии. Проверку сложнее уравнять (Разделы 5.2 и 12). В исследовании оценщиков из Приложения G почти один из пяти человек, допущенных в образец для бухгалтерии по их собственному слову, неправильно ответили на вопрос первой недели в профессии, и в разведочном сравнении они оценили более крупные задачи в меньшем количестве часов, чем остальные (Приложение G2). Может ли процесс независимых проверок делать для проверки то, что агенты сделали для создания, является открытым вопросом раздела 6.5. То, что всё ещё разделяет людей, - это то, что они могут проверить и принять, и это то, что измеряет горизонт проверенной делегации.
Декларации
Финансирование. Данная работа не получила внешнего финансирования.
Конкурирующие интересы. Автор разрабатывает методы многомодельной оркестровки и подал связанные заявки на патенты (находятся в рассмотрении; ни один патент не был выдан). Автор спроектировал предварительно зарегистрированную когортную программу, описанную в разделе 11.5 и Приложении G, и её материалы, а также разрабатывает учебное приложение, которое помогает людям работать с AI-агентами. Ни один вывод в этой статье не зависит от реализации автора; инструмент в Приложении C использует только стандартную библиотеку Python.
Инструменты и проверка. AI-ассистенты использовались как инструменты под руководством автора; идеи, исследование и выводы принадлежат автору. Количественные утверждения и цитаты проверялись по первичным источникам или архивным копиям по состоянию на 9 октября 2026 г., или на 10 октября 2026 г. для источников, добавленных в тот день, где они могли быть получены. Если был доступен только пресс-релиз или страница поставщика, утверждение в тексте приписывается этому отчету или поставщику. Названия, приведенные в квадратных скобках в ссылках, — это описательные названия для страниц, заголовок которых не был переписан дословно.
Доступность данных и кода. Код и схема Приложения C, кабинетный тест пороговых значений (Приложение E) и файлы прогнозов выпущены под лицензией MIT в сопутствующем репозитории (https://github.com/vadimchernets/delegation-horizon), архивированы на Zenodo как релиз v1.1.0 (концептуальный DOI 10.5281/zenodo.23267444, который разрешается в последний релиз); код, приведенный в Приложении C, идентичен коду репозитория побайтово, и tools/paper_sync.py проверяет это, разобранный пример и таблицы 4 и A6 против репозитория всякий раз, когда его тесты запускаются рядом с этим текстом. Прогнозы таблиц 4 и A6 были зарегистрированы на OSF 9 октября 2026 г. (DOI 10.17605/OSF.IO/VW6P9). Исследование рейтеров Prolific из Приложения G было зарегистрировано на OSF 9 октября 2026 г., до сбора каких-либо данных (DOI 10.17605/OSF.IO/V92R8); его скрипт анализа (pilot/human_raters.py) подан с этой регистрацией и находится в сопутствующем репозитории как подано, со значениями SHA-256, которые OSF указывает для каждого поданного файла, приведенными в pilot/registered-SHA256.txt, вместе со скриптами, которые конвертируют экспорты Prolific, выводят таблицу G2 и запускают сравнение G2, которое не было зарегистрировано. Анонимизированные данные с идентификаторами Prolific, замененными на простые ярлыки, будут добавлены в ту же папку. Файлы, зарегистрированные с прогнозами, перечислены с их SHA-256 в predictions/registered-SHA256.txt, манифест, поданный на OSF, и тест репозитория сравнивает каждый из них с ним.
Этика. Приложение G сообщает о двух источниках данных от людей. Исследование рейтеров Prolific — это анонимное задание по онлайн-оцениванию: взрослые профессионалы дали информированное согласие на Prolific перед участием, получали оплату через платформу и не предоставляли имена или контактные данные. Описание когорты подытожает, без имен, мест или языков, записи взрослых, которые согласились на предварительно зарегистрированную когортную программу (OSF, DOI 10.17605/OSF.IO/X4EGQ) и анонимизированную публикацию; зарегистрированные результаты программы сообщаются отдельно. Работа была проведена независимым исследователем без комитета по этике учреждения. Публичные потоки, обсуждаемые в разделе 9, пересказаны, и их авторы не названы.
Вклад авторов. Единственный автор.
Переписка. vadimchernets9@gmail.com · ORCID: 0009-0007-4845-3163
References
9to5Mac. (2026). [App Store new apps doubled in the first half of 2026, Sensor Tower data reported by The New York Times]. https://9to5mac.com/?p=1061510
AI Certification Standards. (2026). AI Competence Framework (version of 23 August 2026). https://www.aicertificationstandards.org/framework
AI Futures Project. (2026, April 2). Q1 2026 timelines update. https://blog.aifutures.org/p/q1-2026-timelines-update
aicodex. (2026). AI agent manager vs agent operator. https://www.aicodex.to/articles/ai-agent-manager-vs-agent-operator
Alenezi, M. (2026). From determinism to delegation: AI-native software engineering and the evolution of the agentic engineer. arXiv:2606.28791. https://arxiv.org/abs/2606.28791
Alonso, M. N. (2026). The artificial intelligence economy [working paper, ResearchGate; contains the proposition "A delegation horizon"].
AlternativeTo. (2026, January). OpenAI rolls out age prediction for ChatGPT accounts. https://alternativeto.net/news/2026/1/openai-rolls-out-age-prediction-for-chatgpt-accounts-to-automatically-estimate-your-age/
Andrist, R. K. (1962). Gold! American Heritage, 14(1). https://www.americanheritage.com/content/gold
Amplifying. (2026). What Claude Code actually chooses. https://amplifying.ai/research/claude-code-picks
Anthropic. (2025a, December 2). How AI is transforming work at Anthropic. https://www.anthropic.com/research/how-ai-is-transforming-work-at-anthropic
Anthropic. (2025b). AI Fluency framework (the four Ds). https://aifluencyframework.org/
Anthropic. (2026a, January 15). Anthropic Economic Index report: Economic primitives. https://www.anthropic.com/research/anthropic-economic-index-january-2026-report
Anthropic. (2026b, January 22). Claude's constitution. https://www.anthropic.com/constitution
Anthropic. (2026c, January 29). [AI assistance and coding skills: a randomised study of junior engineers]. https://www.anthropic.com/research/AI-assistance-coding-skills
Anthropic. (2026d, March 24). Anthropic Economic Index report: Learning curves. https://www.anthropic.com/research/economic-index-march-2026-report
Anthropic. (2026e, June 16). Agentic coding and persistent returns to expertise. https://www.anthropic.com/research/claude-code-expertise
Anthropic. (2026f, June 26). [Anthropic Economic Index report, June 2026]. https://www.anthropic.com/research/economic-index-june-2026-report
Arion Research. (2026, February 7). [The agent manager role]. https://www.arionresearch.com/blog/nfkxv53ktwxqkwtxwm2d03woml1c65
Artificial Lawyer. (2026, January 27). Claude Cowork: the DIY revolution in law. https://www.artificiallawyer.com/2026/01/27/claude-cowork-the-diy-revolution-in-law/
Atkinson, T., & Yamco, S. (2026, January 6). Young workers' employment drops in occupations with high AI exposure. Federal Reserve Bank of Dallas. https://www.dallasfed.org/research/economics/2026/0106
Batko, M. (2026, August 20). [Distribution is the moat]. Startmate. https://startmate.com/writing/distribution-is-the-moat
Benchek, J., et al. (2026). APEX-Accounting. arXiv:2607.27189. https://arxiv.org/abs/2607.27189
Berkeley California Management Review. (2025, July). Rethinking AI agents: A principal-agent perspective. https://cmr.berkeley.edu/2025/07/rethinking-ai-agents-a-principal-agent-perspective/
BetterUp. (2026, May 18). [Workslop research with Stanford]. https://www.betterup.com/blog/workslop-canada
Black Enterprise. (2017). [Mark Cuban on liberal arts and the future of work]. https://www.blackenterprise.com/mark-cuban-right-libreal-arts-key-future/amp/
Bloomberg Law. (2026, April 20). Vibe coding empowers lawyers to influence AI winners, losers. https://news.bloomberglaw.com/legal-exchange-insights-and-commentary/vibe-coding-empowers-lawyers-to-influence-ai-winners-losers
Bone, M., González Ehlinger, E., & Stephany, F. (2025). Skills or degree? The rise of skill-based hiring for AI and green jobs. Technological Forecasting and Social Change. https://doi.org/10.1016/j.techfore.2025.124042
Brier, G. W. (1950). Verification of forecasts expressed in terms of probability. Monthly Weather Review, 78(1), 1-3. https://doi.org/10.1175/1520-0493(1950)078<0001:VOFEIT>2.0.CO;2
Bancroft, H. H. (1888). History of California (Vol. 6, 1848-1859). The History Company. https://archive.org/details/historyofcaliforv6banc
Brynjolfsson, E., Li, D., & Raymond, L. (2025). Generative AI at work. The Quarterly Journal of Economics, 140(2), 889-942. https://doi.org/10.1093/qje/qjae044
Bureau of Labor Statistics. (2025). Photographers. Occupational Outlook Handbook, 2024-34 edition (archived 19 August 2026). https://web.archive.org/web/20260819060531/https://www.bls.gov/ooh/media-and-communication/photographers.htm
Bureau of Labor Statistics. (2026a). Photographers. Occupational Outlook Handbook (updated 27 August 2026). https://www.bls.gov/ooh/media-and-communication/photographers.htm (archived copy: https://web.archive.org/web/20261001165113/https://www.bls.gov/ooh/media-and-communication/photographers.htm)
Bureau of Labor Statistics. (2026b). 2028 SOC revision. https://www.bls.gov/soc/2028/2028_soc_revision.htm
Bureau of Labor Statistics. (2026c). Bookkeeping, accounting, and auditing clerks. Occupational Outlook Handbook (updated 27 August 2026). https://www.bls.gov/ooh/office-and-administrative-support/bookkeeping-accounting-and-auditing-clerks.htm
Burning Glass Institute & Harvard Business School. (2024). Skills-based hiring: The long road from pronouncements to practice. https://www.burningglassinstitute.org/research/skills-based-hiring-2024
Business Insider. (2026, January 22). [Deloitte gives US employees new job titles]. https://www.businessinsider.com/deloitte-gives-us-employees-new-job-titles-leader-role-2026-1
Cagan, M. (2025). The era of the product creator. SVPG. https://www.svpg.com/the-era-of-the-product-creator/
Capps, R. (2025, June 17). [New jobs that AI could create]. The New York Times Magazine. https://www.nytimes.com/2025/06/17/magazine/ai-new-jobs.html
Carta. (2025). Solo founders report 2025. https://carta.com/data/solo-founders-report
Carta. (2026a). 2026 founder ownership report. https://carta.com/data/founder-ownership-2026-full-report/
Carta. (2026b). State of pre-seed: Q2 2026. https://carta.com/data/state-of-pre-seed-q2-2026/
Challenger, Gray & Christmas. (2026). [Job cuts report, June 2026]. https://www.challengergray.com/wp-content/uploads/2026/07/Challenger-Report-June2600986996.pdf
Chen, X., & Meng, S. (2026). When AI levels the playing field: Skill homogenization, asset concentration, and two regimes of inequality. arXiv:2603.05565. https://arxiv.org/abs/2603.05565
Catalini, C., Hui, X., & Wu, J. (2026). Some simple economics of AGI. arXiv:2602.20946. https://arxiv.org/abs/2602.20946
Celenza, B. (2026, October 6). Building Git infrastructure for agent-scale development. GitHub Blog. https://github.blog/engineering/architecture-optimization/building-git-infrastructure-for-agent-scale-development/
Chernets, V. (2026a). After Chat: The three transitions between non-programmers and agentic AI. SSRN. https://doi.org/10.2139/ssrn.7520019 (Zenodo: https://doi.org/10.5281/zenodo.22943313)
Chernets, V. (2026b). Agreement is not independent evidence: Auditable multi-model synthesis without an API. SSRN. https://doi.org/10.2139/ssrn.7390698
Chernets, V. (2026c). AI-Watchbird (Sheckley): When automated oversight widens its own mandate and harms what it guards. SSRN. https://doi.org/10.2139/ssrn.7473658
Chernets, V. (2026d). Architectural trust: Why consumer trust in agentic commerce migrates from AI models to verifiable architecture. SSRN. https://doi.org/10.2139/ssrn.7191261
Chernets, V. (2026e). Three steps into agentic AI: A preregistered feasibility study of how non-programmers cross from chatbot to agent to multi-model orchestration (Cohort 1). OSF. https://doi.org/10.17605/OSF.IO/X4EGQ
CIO. (2026a, May 29). Amazon deletes devs' tokenmaxxing leaderboard to minimize costs. https://www.cio.com/article/4178825/amazon-deletes-devs-tokenmaxxing-leaderboard-to-minimize-costs-2.html
CIO. (2026b, September 4). Meta minimizes role of token-maxing in employee evaluations. https://www.cio.com/article/4218661/meta-minimizes-role-of-token-maxing-in-employee-evaluations-2.html
Clark, M. (2026). [Proposal for a Chartered Financial Intelligence Architect]. SSRN.
Collins Dictionary. (2025). Collins Word of the Year 2025. https://blog.collinsdictionary.com/language-lovers/collins-word-of-the-year-2025-ai-meets-authenticity-as-society-shifts/
Companies Act 2006, c. 46, ss. 1212 and 1213 (United Kingdom). Individuals and firms: eligibility for appointment as a statutory auditor; Effect of ineligibility (accessed 10 October 2026). https://www.legislation.gov.uk/ukpga/2006/46/section/1212 ; https://www.legislation.gov.uk/ukpga/2006/46/section/1213
Computing Research Association. (2026, June). [New CRA Taulbee Survey findings: record degree production alongside a cooling enrollment pipeline]. https://cra.org/crn/2026/06/cra-update-new-cra-taulbee-survey-findings-show-record-degree-production-alongside-a-cooling-enrollment-pipeline/
CSET. (2025). [Translation: China's notice on AI education in primary and secondary schools]. Center for Security and Emerging Technology. https://cset.georgetown.edu/publication/china-primary-secondary-ai-education-notice/
Crunchbase News. (2026, July 2). Crunchbase data: Global startup investment hit record $510B in H1 2026 as AI boom accelerates funding and exits. https://news.crunchbase.com/venture/global-startup-exits-ipo-ma-soar-ai-q2-h1-2026/
Danilova, A., Naiakshina, A., Horstmann, S., & Smith, M. (2021). Do you really code? Designing and evaluating screening questions for online surveys with programmers. 2021 IEEE/ACM 43rd International Conference on Software Engineering (ICSE), 537-548. https://doi.org/10.1109/ICSE43902.2021.00057
Dawson, R. (2026). [Framework: levels of AI delegation in decision making]. https://rossdawson.com/framework-levels-ai-delegation-decision-making
Dealroom. (2026). Mercor doubles to $2B gross revenue run-rate as AI labs buy expert data. https://dealroom.co/news/137121-mercor-doubles-to-2b-gross-revenue-run-rate-as-ai-labs-buy-expert-data/
Dell'Acqua, F., et al. (2025). The cybernetic teammate: A field experiment on generative AI reshaping teamwork and expertise. NBER Working Paper 33641. https://www.nber.org/papers/w33641
Dell'Acqua, F., et al. (2026). Navigating the jagged technological frontier: Field experimental evidence of the effects of artificial intelligence on knowledge worker productivity and quality. Organization Science, 37(2), 403-423. https://doi.org/10.1287/orsc.2025.21838
Digg. (2026). [Your job title is about to change: AI Agent Supervisor]. https://digg.com/aiagentchat/TvbtLF2/your-job-title-is-about-to
Dust. (2026, October 7). [Dust Index: AI strategy beyond models]. https://dust.tt/blog/dust-index-ai-strategy-beyond-models
EdWeek. (2026, June 11). [White House honors AI challenge winners]. https://www.edweek.org/technology/white-house-honors-ai-challenge-winners-as-tech-backlash-grows/2026/06
em360. (2026, September 7). [AI productivity and supervisory capacity]. https://em360tech.com/tech-articles/ai-productivity-supervisory-capacity
Engelbart, D. C. (1962). Augmenting human intellect: A conceptual framework (Summary Report AFOSR-3223). Stanford Research Institute.
Escape. (2026). Methodology: how we discovered vulnerabilities in apps built with vibe coding (accessed 9 October 2026). https://escape.tech/blog/methodology-how-we-discovered-vulnerabilities-apps-built-with-vibe-coding/
Esnaola, L. M., Ramón, H. D., & Lanzarini, L. C. (2026). Can generative AI bridge the gap? A quasi-experimental study of non-programmers with AI vs. programmers without AI. Empirical Software Engineering, 31(3), 75. https://doi.org/10.1007/s10664-026-10813-7 Replication package: https://doi.org/10.5281/zenodo.17803568
Eulerich, M., Sanatizadeh, A., Vakilzadeh, H., & Wood, D. A. (2024). Is it all hype? ChatGPT's performance and disruptive potential in the accounting and auditing industries. Review of Accounting Studies, 29(3), 2318-2349. https://doi.org/10.1007/s11142-024-09833-9
Fawzy, A., Tahir, A., & Blincoe, K. (2026). From prompting to verification: How experience shapes vibe coding practices. arXiv:2605.24521. https://arxiv.org/abs/2605.24521
Feldman, M. Q., & Anderson, C. J. (2024). Non-expert programmers in the generative AI future. CHIWORK 2024 (author version). https://www.feldmanmolly.com/chiwork2024-author-version.pdf
Feng, K. J. K., McDonald, D. W., & Zhang, A. X. (2025). Levels of autonomy for AI agents. arXiv:2506.12469. https://arxiv.org/abs/2506.12469
Flowtivity. (2026, February 24). Your boss will measure you in tokens. https://flowtivity.ai/blog/your-boss-will-measure-you-in-tokens/
Forrester. (2025, October). [Predictions 2026 for AI and technology leadership], as reported by iTWire. https://itwire.com/it-industry-news/strategy/forrester-unveils-2026-predictions-for-ai-and-tech-leadership.html
Fortune. (2025, May 7). [Prompt engineering, a six-figure role, now obsolete]. https://www.fortune.com/2025/05/07/prompt-engineering-200k-six-figure-role-now-obsolete-thanks-to-ai
Fortune. (2026a, January 22). [Deloitte's job title change]. https://www.fortune.com/2026/01/22/deloitte-job-title-change-ai-reshapes-big-4-accounting-consulting-firms
Fortune. (2026b, May 26). [Uber's chief operating officer on AI spending]. https://www.fortune.com/2026/05/26/uber-coo-ai-spending-tokens-claude-code/
Fortune. (2026c, July 7). [Cognition's chief executive on tokenmaxxing]. https://fortune.com/2026/07/07/cognition-ceo-tokenmaxxing-big-tech-carried-away-ai-productivity-gains/
Fox, S., Markham, L., Lail, R., & Karotsieris, M. (2026). LLM judges verify presence, not absence: Omission blindness in AI clinical notes and what recovers it. arXiv:2608.31016. https://arxiv.org/abs/2608.31016
Fu, H. Y., Shrivastava, A., Moore, J., West, P., Tan, C., & Holtzman, A. (2025). AbsenceBench: Language models can't tell what's missing. arXiv:2506.11440. https://arxiv.org/abs/2506.11440
Gama, et al. (2026). [Novice teams building software with AI]. ICSE 2026. arXiv:2512.02750. https://arxiv.org/abs/2512.02750
Gartner. (2009). Gartner Symposium/ITxpo Orlando brochure (use of "citizen developer"). https://www.gartner.com/imagesrv/symposium/pdf/orlando_symposium_conference_brochure.pdf
Gartner. (2021, June 10). Gartner says the majority of technology products and services will be built by professionals outside of IT by 2024. https://www.gartner.com/en/newsroom/press-releases/2021-06-10-gartner-says-the-majority-of-technology-products-and-services-will-be-built-by-professionals-outside-of-it-by-2024
Gartner. (2024, October 22). Gartner unveils top predictions for IT organizations and users in 2025 and beyond. https://www.gartner.com/en/newsroom/press-releases/2024-10-22-gartner-unveils-top-predictions-for-it-organizations-and-users-in-2025-and-beyond
Gartner. (2026). Tyagi, N. Govern vibe coding for citizen developers with self-service platforms (29 June 2026; document 8068765). https://www.gartner.com/en/documents/8068765 (subscriber access; figures cited as summarised by Tray.ai, 2026)
Gigazine. (2025, July 24). What are the results of the 'AccountingBench' benchmark, which tests an AI model for monthly accounting tasks? https://gigazine.net/gsc_news/en/20250724-accountingbench/
Gigazine. (2026, July 21). [Sensor Tower: new App Store apps in the first half of 2026]. https://www.gigazine.net/gsc_news/en/20260721-app-store-new-apps
GitHub. (2025a). Octoverse: A new developer joins GitHub every second as AI leads TypeScript to #1. https://github.blog/news-insights/octoverse/octoverse-a-new-developer-joins-github-every-second-as-ai-leads-typescript-to-1/
GitHub. (2025b, December 8). The new identity of a developer: What changes and what doesn't in the AI era. https://github.blog/news-insights/octoverse/the-new-identity-of-a-developer-what-changes-and-what-doesnt-in-the-ai-era/
Growthy. (2026, September 23). Claude Code vs Codex for bookkeeping. https://growthy.com/blog/claude-code-vs-codex-for-bookkeeping
Haize Labs. (2026). Vertical AI Lead [job posting]. https://job-boards.greenhouse.io/haizelabs/jobs/5173890008
Hashimoto, M. (2026). Vouch [repository]. https://github.com/mitchellh/vouch
HCA Magazine. (2026, July 29). [Atlassian introduces AI wallets for employees]. https://www.hcamag.com/ca/news/general/atlassian-introduces-new-ai-wallets-to-employees/584258
Hosseini, S. M., & Lichtinger, G. (2026, May 6). Generative AI as seniority-biased technological change [Working paper; earlier version SSRN 5425555, 2025]. https://raw.githack.com/s-mahdihosseini/Website/b99fa2962dcc4c165bbc3c41dd283afa99c5ccfb/GenAI_SenBTC_May_2026.pdf
Huang, L., Xiao, W., & Vishnoi, N. K. (2026). Delegation and verification under AI. Accepted at ICML 2026. arXiv:2603.02961. https://arxiv.org/abs/2603.02961
Hwang, J. (2026, February 13). Claude Code is the new Excel. https://nextword.substack.com/p/claude-code-is-the-new-excel
Indeed Hiring Lab. (2026, January 28). Where do college degrees still matter in a "skills-first" job market? https://hiringlab.indeed.com/2026/01/28/where-do-college-degrees-still-matter-in-a-skills-first-job-market/
IT Brew. (2026, June 5). AI orchestrators are the newest in-demand AI role. https://www.itbrew.com/stories/ai-orchestrators-are-the-newest-in-demand-ai-role
Jaques, E. (1956). Measurement of responsibility: A study of work, payment and individual capacity. Tavistock Publications. (Reviewed in Industrial and Labor Relations Review, 10(3), 475. https://doi.org/10.2307/2519792)
Jensen, M. C., & Meckling, W. H. (1976). Theory of the firm: Managerial behavior, agency costs and ownership structure. Journal of Financial Economics, 3(4), 305-360. https://doi.org/10.1016/0304-405X(76)90026-X
Journal of Accountancy. (2025, May 14). AICPA, NASBA approve new CPA licensure path. https://www.journalofaccountancy.com/news/2025/may/aicpa-nasba-approve-new-cpa-licensure-path/
Kamara, S. (2026). Verification friction. SSRN. https://doi.org/10.2139/ssrn.6469865
Karpathy, A. (2025, February 2). [Post introducing "vibe coding"]. X. https://x.com/karpathy/status/1886192184808149383
Karpathy, A. (2026, April 30). Sequoia AI Ascent 2026 [talk notes]. https://karpathy.bearblog.dev/sequoia-ascent-2026/
Khadj, O. J. (2026). The delegation frontier. SSRN. https://doi.org/10.2139/ssrn.7348378
Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. Accepted at ICML 2025. arXiv:2506.07962. https://arxiv.org/abs/2506.07962
Kingy AI. (2026, May 4). Token spend is coming for your performance review. https://kingy.ai/news/token-spend-is-coming-for-your-performance-review-and-mine/
Ko, A. J., Abraham, R., Beckwith, L., Blackwell, A., Burnett, M., Erwig, M., Scaffidi, C., Lawrance, J., Lieberman, H., Myers, B., Rosson, M. B., Rothermel, G., Shaw, M., & Wiedenbeck, S. (2011). The state of the art in end-user software engineering. ACM Computing Surveys, 43(3), 21. https://doi.org/10.1145/1922649.1922658
Krebs, A. (2026). [Design slop and Show HN]. https://www.adriankrebs.ch/blog/design-slop/
Kwa, T., et al. (2025). Measuring AI ability to complete long tasks. arXiv:2503.14499. https://arxiv.org/abs/2503.14499
Legal Services Act 2007, c. 29, s. 12 (England and Wales). Meaning of "reserved legal activity" and "legal activity" (accessed 10 October 2026). https://www.legislation.gov.uk/ukpga/2007/29/section/12
Lenny's Newsletter. (2025). [Why LinkedIn is replacing PMs]. https://www.lennysnewsletter.com/p/why-linkedin-is-replacing-pms
Lex Fridman Podcast. (2026, August 26). #501, David Heinemeier Hansson [transcript]. https://lexfridman.com/dhh-2-transcript/
Lightcast. (2026a, August 7). Tracking the agentic AI explosion in jobs. https://lightcast.io/resources/blog/tracking-the-agentic-ai-explosion-in-jobs
Lightcast. (2026b, September 9). [Degree requirements still higher for AI jobs]. https://lightcast.io/resources/blog/degree-requirements-ai-jobs
LinkedIn. (2026a, January). LinkedIn gives professionals the edge with verified skills and tools to navigate the job search. https://news.linkedin.com/2026/Professional_Edge_Skills_Verified
LinkedIn. (2026b, April). Q3 earnings and business highlights. https://news.linkedin.com/2026/Q3-Earnings-Highlights
LinkedIn Economic Graph. (2026). AI labor market update, August 2026. https://delivery-p143253-e1476319.adobeaemcloud.com/adobe/assets/urn:aaid:aem:ef153078-1061-4817-82e7-a1c027d7a7d7/original/as/AI-Labor-Market-Update-August-2026-v2.pdf
Manifold. (2026a). [Will it be common for non-programmers to create small scripts using AI by 2027?] (accessed 9 October 2026). https://manifold.markets/jskf/will-it-be-common-for-nonprogrammer-dfc979ea7fec
Manifold. (2026b). [Will the number of junior developer roles fall by a third by 2030?] (accessed 9 October 2026). https://manifold.markets/OliverKuperman/will-the-number-of-junior-developer
Manifold. (2026c). [Will the number of people employed as software developers in the US fall by more than 15% from 2023 to 2028?] (accessed 9 October 2026). https://manifold.markets/MatthewBarnett/will-the-number-of-people-employed
McAleese, N., Pokorny, R. M., Ceron Uribe, J. F., Nitishinskaya, E., Trebacz, M., & Leike, J. (2024). LLM critics help catch LLM bugs. arXiv:2407.00215. https://arxiv.org/abs/2407.00215
McKinsey & Company. (2025, January). Superagency in the workplace: Empowering people to unlock AI's full potential at work. https://www.mckinsey.com/~/media/mckinsey/business%20functions/quantumblack/our%20insights/superagency%20in%20the%20workplace%20empowering%20people%20to%20unlock%20ais%20full%20potential%20at%20work/superagency-in-the-workplace-empowering-people-to-unlock-ais-full-potential-v4.pdf
MediaNama. (2026, April). [Claude users' accounts suspended after being flagged as minors]. https://www.medianama.com/2026/04/223-claude-users-accounts-suspended-flagged-minors/
Memari, M., & Rudolph, G. (2026). The capability ladder. arXiv:2608.07779. https://arxiv.org/abs/2608.07779
Menlo Ventures. (2025). 2025: The state of generative AI in the enterprise. https://menlovc.com/perspective/2025-the-state-of-generative-ai-in-the-enterprise/
Metal Toad. (2026). 6 levels of AI delegation: A framework for AI management. https://www.metaltoad.com/blog/6-levels-of-ai-delegation-a-framework-for-ai-management
Metaview. (2026). [AI use in hiring interviews]. https://www.metaview.ai/resources/blog/ai-baseline-shopify-memo-hiring-process
METR. (2025, July 10). Measuring the impact of early-2025 AI on experienced open-source developer productivity. https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/
METR. (2026a, February 19). [Five lessons from an AI biology randomised trial]. https://metr.org/blog/2026-02-19-five-lessons-from-ai-biology-rct
METR. (2026b, March 10). Many SWE-bench-passing PRs would not be merged into main. https://metr.org/notes/2026-03-10-many-swe-bench-passing-prs-would-not-be-merged-into-main/
METR. (2026c). Time horizons (dashboard, accessed 9 October 2026). https://metr.org/time-horizons/
METR. (2026d). eval-analysis-public, release time-horizon 1.1, runs.jsonl [Data set]. GitHub. https://github.com/METR/eval-analysis-public (accessed 9 October 2026)
Microsoft. (2025, April 23). 2025: The year the Frontier Firm is born. Work Trend Index. https://www.microsoft.com/en-us/worklab/work-trend-index/2025-the-year-the-frontier-firm-is-born
Microsoft. (2026a, May 5). Agents, human agency and the opportunity for every organization. Work Trend Index 2026. https://www.microsoft.com/en-us/worklab/work-trend-index/agents-human-agency-and-the-opportunity-for-every-organization
Microsoft. (2026b, May 5). How Frontier Firms are rebuilding the operating model for the age of AI. https://blogs.microsoft.com/blog/2026/05/05/how-frontier-firms-are-rebuilding-the-operating-model-for-the-age-of-ai/
MindStudio. (2026, June 11). What is agent literacy? https://www.mindstudio.ai/blog/what-is-agent-literacy-core-skill-ai-builders
n8n. (2026). AI Product Builder [job posting]. https://jobs.ashbyhq.com/n8n/42e72645-d99a-4545-97b7-53ba3a699893
Nature Portfolio. (2026, February 9). [Press release: people using language models for medical scenarios, Nature Medicine]. https://www.natureasia.com/en/info/press-releases/detail/9231
Ng, A. (2026, August 28). The AI engineering skills map in detail: Software engineering fundamentals. The Batch. https://www.deeplearning.ai/the-batch/the-ai-engineering-skills-map-in-detail-software-engineering-fundamentals
OECD. (2026, February). Venture capital investments in artificial intelligence through 2025. https://www.oecd.org/en/publications/venture-capital-investments-in-artificial-intelligence-through-2025_a13752f5-en/full-report.html
OECD & European Commission. (2026, June). [AI literacy framework for primary and secondary education]. https://ailiteracyframework.org/blog/empowering-learners-for-the-age-of-ai-literacy-framework/
O'Neill, N. (2026). [The Product Principal, LinkedIn post]. https://www.linkedin.com/posts/nicholasoneill_the-product-principal-activity-7445921322486009856-hAwj
Ono, A. (2026, June 22). [Defining the roles of humans and AI]. World Economic Forum. https://www.weforum.org/stories/artificial-intelligence/future-of-work-define-roles-humans-ai/
Open Source For You. (2026, February). GitHub weighs pull request kill switch as AI slop floods open source. https://www.opensourceforu.com/2026/02/github-weighs-pull-request-kill-switch-as-ai-slop-floods-open-source/
OpenAI. (2026, June). How agents are transforming work. https://openai.com/index/how-agents-are-transforming-work/
OpenAIRE. (2025, December 9). Zenodo introduces a new way to manage and correct published records. https://www.openaire.eu/zenodo-introduces-a-new-way-to-manage-and-correct-published-records
Oregon State Board of Bar Examiners. (2026, January 26). Supervised Practice Portfolio Examination: First annual report to the Oregon Supreme Court. https://www.osbar.org/_docs/sppe/2025SPPEAnnualReport.pdf
OSF. (2026). Updating registrations; Addressing fear of scooping on OSF preregistrations (help pages, accessed 9 October 2026). https://help.osf.io/hc/en-us/sections/4414482864279-Updating-Registrations ; https://help.osf.io/article/634-addressing-fear-of-scooping-on-osf-preregistrations
Page, M. J., McKenzie, J. E., Bossuyt, P. M., et al. (2021). The PRISMA 2020 statement: An updated guideline for reporting systematic reviews. BMJ, 372, n71. https://doi.org/10.1136/bmj.n71
Park, Y. S., et al. (2026). The work behind delegation: A framework for supervising AI coding agents. arXiv:2609.24234. https://arxiv.org/abs/2609.24234
Paul, R. W. (1947). California gold: The beginning of mining in the Far West. Harvard University Press. https://archive.org/details/in.ernet.dli.2015.177982
Patwardhan, T., et al. (2025). GDPval: Evaluating AI model performance on real-world economically valuable tasks. arXiv:2510.04374. https://arxiv.org/abs/2510.04374
Penrose. (2025). Can LLMs do accounting? [AccountingBench]. https://accounting.penrose.com/ (figures cited as reported by Gigazine, 2025)
Phoenix, J. (2026). [Five levels, gated by verification]. https://understandingdata.com/posts/five-levels-gated-by-verification/
PPC Land. (2026, March 6). The app middle class is dying, and RevenueCat's data shows exactly how fast. https://ppc.land/the-app-middle-class-is-dying-and-revenuecats-data-shows-exactly-how-fast/
Prolific. (2026, July 13). How do I use Prolific's filters? Researcher help centre (accessed 10 October 2026). https://researcher-help.prolific.com/en/articles/445159-how-do-i-use-prolific-s-filters
PwC. (2026). AI Jobs Barometer 2026 (press release). https://www.pwc.com/id/en/media-centre/press-release/2026/english/ai-jobs-barometer-en.html
Reid, B., Wagner, M., d'Amorim, M., & Treude, C. (2022). Software engineering user study recruitment on Prolific: An experience report. RoPES 2022. arXiv:2201.05348. https://arxiv.org/abs/2201.05348
Retool. (2026, February 17). Retool's 2026 Build vs. Buy Report (press release). https://www.businesswire.com/news/home/20260217548274/en/Retools-2026-Build-vs.-Buy-Report-Reveals-35-of-Enterprises-Have-Already-Replaced-SaaS-With-Custom-Software
RevenueCat. (2026). State of subscription apps 2026. https://www.revenuecat.com/state-of-subscription-apps ; https://www.revenuecat.com/sosa-26-insights/
Rogers, E. M. (2003). Diffusion of innovations (5th ed.). Free Press. ISBN 978-0743222099.
Sadki, R. (2026, August 14). [Quotes from the agentic AI summit in Berkeley]. https://redasadki.me/2026/08/14/you-cannot-send-an-ai-agent-to-jail-the-scariest-quotes-from-the-agentic-ai-summit-in-berkeley/
Sarbanes-Oxley Act of 2002, Pub. L. No. 107-204, sections 102 and 104 (15 U.S.C. 7212 and 7214) (United States) (accessed 10 October 2026). https://www.law.cornell.edu/uscode/text/15/7212 ; https://www.law.cornell.edu/uscode/text/15/7214
Savva, N. (2026). Context engineering: A principal-agent theory of AI-augmented knowledge work. SSRN. https://doi.org/10.2139/ssrn.6506600
Search Engine Journal. (2026). Marketers report highest rates of AI brain fry. https://www.searchenginejournal.com/marketers-report-highest-rates-of-ai-brain-fry-report-finds/569110/
SemiAnalysis. (2026, February). Claude Code is the inflection point. https://newsletter.semianalysis.com/p/claude-code-is-the-inflection-point
Serafini, R., Otto, C., Horstmann, S. A., & Naiakshina, A. (2024). ChatGPT-resistant screening instrument for identifying non-programmers. Proceedings of the IEEE/ACM 46th International Conference on Software Engineering (ICSE 2024), 1-13. https://doi.org/10.1145/3597503.3639075
Serafini, R., Weber, N., Yardim, A., Horstmann, S. A., & Naiakshina, A. (2026). Robust methods for developer screening in rapidly evolving AI contexts. Proceedings of the 2026 CHI Conference on Human Factors in Computing Systems (CHI '26), 1-18. https://doi.org/10.1145/3772318.3790302
SF Standard. (2026, March 5). [In AI land, everyone's a builder now]. https://sfstandard.com/2026/03/05/engineer-2025-ai-land-everyone-s-builder-now/
Shao, Y., et al. (2025). Future of work with AI agents: Auditing automation and augmentation potential across the U.S. workforce. arXiv:2506.06576. https://arxiv.org/abs/2506.06576
Shapiro, D. (2026, January). The five levels: From spicy autocomplete to the software factory. https://www.danshapiro.com/blog/2026/01/the-five-levels-from-spicy-autocomplete-to-the-software-factory/
Shopifreaks. (2026a). Meta employees compete on an internal AI token leaderboard called Claudeonomics. https://www.shopifreaks.com/meta-employees-compete-on-an-internal-ai-token-leaderboard-called-claudeonomics-that-tracked-60-trillion-tokens-in-30-days/
Shopifreaks. (2026b). Meta stops grading employees on how much AI they use, dropping token counts and AI Native labels from performance reviews (reporting WIRED, 2 September 2026). https://www.shopifreaks.com/meta-stops-grading-employees-on-how-much-ai-they-use-dropping-token-counts-and-ai-native-labels-from-performance-reviews/
Shopify. (2026). AI usage (candidate guide). https://www.shopify.com/careers/candidate-guide/ai-usage
Simon, H. A. (1971). Designing organizations for an information-rich world. In M. Greenberger (Ed.), Computers, communications, and the public interest (pp. 37-72). Johns Hopkins Press.
Srinivasan, S., & Wei, V. (2026, February 12). To thrive in the AI era, companies need agent managers. Harvard Business Review. https://hbr.org/2026/02/to-thrive-in-the-ai-era-companies-need-agent-managers
Stanford Digital Economy Lab. (2026a, August 12). [Canaries in the coal mine: August 2026 update]. https://digitaleconomy.stanford.edu/news/canariesaug26/
Stanford Digital Economy Lab. (2026b, October 7). Task expansion with generative AI: Experimental evidence on middle-skilled early-career workers. https://digitaleconomy.stanford.edu/publication/task-expansion-with-generative-aiexperimental-evidence-on-middle-skilled-early-career-workers/
Stanford HAI. (2026). AI Index Report 2026, chapter 4: Economy. https://hai.stanford.edu/assets/files/ai_index_report_2026_chapter_4_economy.pdf
Startup Fortune. (2026). Guillermo Rauch says AI agents now trigger more than half of all Vercel deployments. https://startupfortune.com/guillermo-rauch-says-ai-agents-now-trigger-more-than-half-of-all-vercel-deployments/
State Street. (2026). Agentic Product Builder, Senior Associate [job posting]. https://statestreet.wd1.myworkdayjobs.com/en-US/Global/job/Agentic-Product-Builder--Sr-Associate---State-Street-Investment-Managment_R-796094
Stenberg, D. (2026, January 26). The end of the curl bug bounty. https://daniel.haxx.se/blog/2026/01/26/the-end-of-the-curl-bug-bounty/
Stripe. (2026, May 28). Solo founding is at an all-time high: Top performers have these traits in common. https://stripe.com/blog/top-solo-founder-traits
TechCrunch. (2026a, September 24). Lovable's annualized revenue crosses $600M as vibe coding takes off. https://techcrunch.com/2026/09/24/lovables-annualized-revenue-crosses-600m-as-vibe-coding-takes-off/
TechCrunch. (2026b, April 18). The App Store is booming again, and AI may be why. https://techcrunch.com/2026/04/18/the-app-store-is-booming-again-and-ai-may-be-why/
TechCrunch. (2026c, July 30). LinkedIn adds a button to report AI-generated "slop". https://techcrunch.com/2026/07/30/linkedin-adds-a-button-to-report-ai-generated-slop/
TechRepublic. (2025). [Prompt engineering jobs called obsolete]. https://www.techrepublic.com/article/news-prompt-engineering-ai-jobs-obsolete/
The Decoder. (2025, September). AI-generated workslop is costing companies millions and hurting team morale, study finds. https://the-decoder.com/ai-generated-workslop-is-costing-companies-millions-and-hurting-team-morale-study-finds/
The Decoder. (2026, July 12). LinkedIn is the undisputed king of long-form AI slop, according to a study spanning five platforms. https://the-decoder.com/linkedin-is-the-undisputed-king-of-long-form-ai-slop-according-to-a-study-spanning-five-platforms/
The geometry of learning under AI delegation. (2026). [Review of the paper]. https://www.themoonlight.io/fr/review/the-geometry-of-learning-under-ai-delegation
Tikhomirov, S. (2026, September). [The AIDEs framework: levels of delegation in software development]. JetBrains Research. https://blog.jetbrains.com/research/2026/09/aides-framework/
Tomašev, N., Franklin, M., & Osindero, S. (2026). Intelligent AI delegation. arXiv:2602.11865. https://arxiv.org/abs/2602.11865
Tray.ai. (2026). Gartner: Govern vibe coding for citizen developers with self-service platforms [Guide summarising Tyagi, 2026]. https://tray.ai/guides/gartner-govern-vibe-coding/
Turkovic, I. (2026, April 24). [AI job titles in 2026: naming chaos]. https://www.ivanturkovic.com/2026/04/24/ai-job-titles-2026-naming-chaos/
Turner, S. (2026). [An AI biosecurity uplift randomised trial by Scale AI and SecureBio]. https://blog.stephenturner.us/p/ai-biosecurity-uplift-rct
University of Lübeck, Institute for Multimedia and Interactive Systems. (2026). [The cost of convenience: decision horizons, CHI 2026]. https://www.imis.uni-luebeck.de/en/node/11007
Veracode. (2026, July 28). LLMs are getting smarter but not safer: Veracode 2026 GenAI code security report. https://www.veracode.com/news/llms-are-getting-smarter-but-not-safer-veracode-2026-genai-code-security-report-finds-ai-generated-code-security-has-stalled-at-56%25-pass-rate/
Verheul, J. (2026). The principal firm: Organisational form when the agency function is performed by machines. SSRN. https://doi.org/10.2139/ssrn.7235518
Veri', D. (2026). Beyond AI literacy: A structured review and exploratory meta-analysis of measures for competent generative-AI use. arXiv:2609.15624. https://arxiv.org/abs/2609.15624
Virk, Y., & Liu, D. (2025). Non-programmers assessing AI-generated code: A case study of business users analyzing data. VL/HCC 2025. arXiv:2508.06484. https://arxiv.org/abs/2508.06484
Wang, S. (2026). The delegation efficient frontier. SSRN. https://doi.org/10.2139/ssrn.7275801
Washington Monthly. (2026, May 29). [AI and entry-level jobs for college graduates]. https://washingtonmonthly.com/2026/05/29/ai-entry-level-jobs-college-graduates/
White House. (2025, April 23). Advancing artificial intelligence education for American youth. https://www.whitehouse.gov/presidential-actions/2025/04/advancing-artificial-intelligence-education-for-american-youth/
Willison, S. (2025a, February 3). A computer can never be held accountable. https://simonwillison.net/2025/Feb/3/a-computer-can-never-be-held-accountable/
Willison, S. (2025b, June 22). [Kent Beck on skills going to zero and up 1000x]. https://simonwillison.net/2025/Jun/22/kent-beck
Willison, S. (2026a). What is agentic engineering? https://simonwillison.net/guides/agentic-engineering-patterns/what-is-agentic-engineering/
Willison, S. (2026b, February 7). [Vouch]. https://simonwillison.net/2026/Feb/7/vouch/
Writer. (2026). [The AI agent owner]. https://writer.com/blog/ai-agent-owner/
Xinhua. (2025, September 19). [Beijing pupils build AI agents in class]. https://english.news.cn/20250919/740f7bd40ec84b69b9d983e1068a94ac/c.html
Yale Budget Lab. (2026, May 7). AI is probably not (yet) the reason for labor market weakening. https://budgetlab.yale.edu/research/ai-probably-not-yet-reason-labor-market-weakening
Yang, et al. (2026). [How people work with an autonomous search agent]. arXiv:2606.07489. https://arxiv.org/abs/2606.07489
Yegge, S. (2026). Welcome to Gas Town. https://steve-yegge.medium.com/welcome-to-gas-town-4f25ee16dd04
Приложение A. Глоссарий
Эталонный час. Время, которое потребовалось бы квалифицированному специалисту для выполнения куска работы вручную, взятое из замороженного банка задач или от двух независимых оценщиков, не знающих, кто выполнил работу.
Проверенный горизонт делегирования. Наибольший объём работы в эталонных часах, при котором человек регулярно передаёт работу агентам, принимает её и подтверждает с помощью независимой проверки, которую агенты не видели. Оценивается по областям по правилу раздела 5.2.
Независимая проверка. Скрытые тесты приёмки, квалифицированный человеческий рецензент, реальное использование предполагаемыми пользователями или модель другого семейства, проверяющая источники, отличающаяся от агентов по данным, доступу и стимулам. Самопроверка и согласие между моделями одного семейства не являются независимыми проверками.
Подсаженная ошибка. Ошибка, помещённая в задачу перед передачей, которую человек должен поймать — либо неправильная запись, либо пропуск чего-то, что должна содержать работа. Кусок с пропущенной подсаженной ошибкой не считается проверенным, и любой пропуск в окне ступени блокирует ступени от Недели и выше.
Коэффициент усиления. Эталонные часы принятой, проверенной работы, разделённые на часы внимания человека за последние 91 день в области, причём неудавшуюся работу включают в знаменатель, а работу, выполненную с помощью извне, исключают из числителя.
Потолок усиления. В упрощённой модели коэффициент усиления G для куска H эталонных часов, чья проверка требует V часов внимания, удовлетворяет G ≤ H / V, то есть единица, разделённая на долю времени, отходящего на проверку от выполняемого вручную времени.
Ступени. Час (примерно 1 эталонный час), День (примерно 8), Неделя (примерно 40), Месяц (примерно 160), Квартал (примерно 500). Количества и окна правил v1.1: десять кусков за 91 день для Часа и Дня, шесть за 182 дня для Недели, шесть за 365 дней для Месяца (пять из них проверены), три за 365 дней для Квартала. Для Недели и выше — по крайней мере один проверенный кусок размера ступени в течение последних 91 дня.
Запись. Область · горизонт · коэффициент усиления · дата, например "учёт в малом бизнесе · День · ×2 · 2026-Q4".
Навык приёмки. Умение заранее определить, что будет считаться готовым, и затем показать это доказательством, которое агент не может подделать.
Нейтральность образовательного фона. Гипотеза о том, что при равном проверенном горизонте в области образование в программировании не предсказывает качество независимо проверенной работы, если учитываются владение областью и навык приёмки.
Точка пересечения компетенций. Момент в области, когда продукты людей без образования в программировании, принятые при одинаковых проверках, начинают превосходить продукты программистов, использующих одних и тех же агентов, после чего требования к образованию и метки «младший» и «старший» теряют прогностическую ценность при найме. Его компоненты — паритет качества (шаг перед), превосходство (момент), пересечение в объявлениях (знак) и нейтральность образовательного фона (механизм).
Гарант. Человек, который подписывается за продукт, сделанный другими, и отвечает за него перед своим кругом, измеряемый тем, за сколько продуктов он поручился и сколько из них продержались.
Завершитель. Человек, который доводит продукт до его пользователей.
Два рынка. Создание для себя (грамотность) и работа для других с последствиями (профессия).
Приложение Б. Журнал поиска, 8 и 9 октября 2026
Веб-проверки имён и терминов проводились 8 октября 2026 года несколькими помощниками ИИ, работавшими независимо и параллельно, и 9 октября 2026 года одним помощником с расширенным веб-поиском. Каждый ответ хранился полностью с его источниками. Научные проверки проводились 9 октября 2026 года следующим образом.
| База | Что она ищет | Результат для терминов данной работы |
|---|---|---|
| arXiv (API) | Точная фраза, все поля | "delegation horizon": 0; "delegation ladder" или "ladder of delegation": 0; "time span of discretion": 0 |
| Semantic Scholar | Название и аннотация | Один поиск вернул 0, другой был ограничен по частоте (HTTP 429); подлежит повторению перед отправкой |
| OpenAlex | Название, аннотация, часть полного текста | "credential crossover": 0; "agentwright": только не связанные совпадения; "background neutrality": не связанные; "acceptance literacy": работы только о технологическом принятии |
| Crossref | Метаданные, включая аннотации SSRN | "principal" как профессия: только теория агентства |
| Europe PMC | Открытые полные тексты | Точных совпадений не найдено |
| Zenodo | Записи и описания | Совпадений ни для одного из терминов не найдено |
| DOAJ | Журналы открытого доступа | "delegation horizon": четыре не связанных совпадения |
| Google Scholar | Полные тексты, SSRN | "delegation horizon": 6, использовано в статьях 2026 года для машин или компаний (Khadj, 2026; Alonso, 2026); "verified delegation horizon", "credential crossover", "credential crossover point" и "agentwright": 0 (повторено 9 октября 2026 года без ошибок); "acceptance literacy", "background neutrality" и "amplification gain": совпадения только в других смыслах |
| DBLP; SSRN страницы | Заблокировано защитой от ботов (DBLP) или возвращено 403 (SSRN); охвачено через Crossref и Scholar |
Предыдущие прогнозы искались на Metaculus, Manifold, Good Judgment Open, Kalshi, Polymarket и Long Bets, а также в открытой сети; Metaculus и некоторые страницы Gartner вернули HTTP 403 и читались через архивированные или переизданные копии, где они были доступны. Результаты резюмированы в разделе 11.3. Отчётность соответствует пункту 6 PRISMA 2020 (Page et al., 2021): перечислены все базы и дата последнего доступа. Совпадение, которое не найдено, сообщается как не найденное в эту дату, и никаких утверждений не делается о базах, которые не были проверены.
Приложение C. Инструмент измерения
Это приложение предоставляет исследовательский инструмент, формат записи и оценщик из стандартной библиотеки Python под лицензией MIT. Оно показывает, как правила раздела 5.2 становятся кодом. Это не приложение и не выносит никаких решений о каком-либо лице, кроме вычисления двух чисел из записей, которые предоставляет лицо или исследователь. Оно не судит, хорошо ли была выбрана проверка; оно доверяет предоставленным полям. В частности, оно не проверяет независимость. Из трёх условий раздела 5.2 (данные, доступ и стимулы) оно читает только вид проверки и видели ли её агенты, а сама независимость подтверждается случайной проверкой в таблице 3.
C1. Запись
Одна строка файла JSON Lines на каждый объём работы, переданный агентам, написанная при его принятии, отклонении или заброшении. Дата начала передачи записывается в поле started, требуемое правилами v1.1; оценщик всё ещё читает строки без неё и выдаёт предупреждение. Работы, не прошедшие проверку или заброшенные, остаются в журнале.
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-10", "date": "2026-09-14",
 "reference_hours": 8, "reference_basis": "two raters",
 "attention_minutes": 95, "mode": "stages",
 "check": "expert", "agent_saw_check": false, "passed": true,
"irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}| Поле | Значение |
|---|---|
| person | Псевдонимная метка, никогда не настоящее имя |
| domain | Область, в которой принята работа |
| date | Дата принятия, отклонения или отказа, когда написана строка (формат ISO) |
| started | Дата начала передачи (формат ISO); ожидается из правил v1.1, не позже чем date |
| reference_hours | Ручные часы квалифицированного специалиста для всего доставляемого результата |
| reference_basis | Источник справки: именованный банк задач или два оценивателя |
| attention_minutes | Минуты человека на планирование, инструктирование, чтение, проверку и исправление |
| mode | one_piece, stages или together (one_piece считается в сторону доли раздела 5.7) |
| check | hidden_tests, expert, real_use, other_family_with_sources, same_family, self_review или none |
| agent_saw_check | Могли ли агенты видеть проверку (должна быть false для подсчёта) |
| passed | Прошла ли проверка (false для неудачных или отклоненных частей) |
| irreversible | Невозможно ли отменить ошибку в этом типе работы (эта часть должна тогда пройти) |
| planted_errors | Сколько ошибок было добавлено в задачу перед передачей |
| planted_missed | Сколько из них человек не смог обнаружить (любой пропуск делает часть непроверенной и блокирует Week и выше в окне) |
| outside_help | Помогали ли коллега или подрядчик вне журнала (такая часть не добавляет ничего в числитель выигрыша) |
| task_id, model, tools | Необязательно: идентификатор банка задач, используемые агенты и модели, а также их инструменты (раздел 5.4) |
| checker | Необязательно: кто или что провел проверку, в качестве роли, никогда не настоящее имя |
| rater_hours | Необязательно: оценки экспертов, лежащие в основе reference_hours; если их две и большая больше чем в 1.5 раза меньшей, программа выводит «нужен третий эксперт» (таблица 3); с третьей оценкой медиана решает и флаг не выводится |
| audit | Необязательно: none, passed или failed, результат второй независимой проверки; неудачный audit делает часть непроверенной |
| revoked | Необязательно: true, если отложенный результат отозвал часть (таблица A4); отозванная часть является непроверенной |
C2. horizon.py
Код ниже реализует правила v1.1 и идентичен, побайтно, файлу horizon.py в сопутствующем репозитории.
#!/usr/bin/env python3
"""horizon.py: score the verified delegation horizon and the amplification gain.

Teaches: how the rules of Section 5.2 turn a log of work handed to agents into a dated record
"domain . horizon . gain . quarter". Limits: it trusts the fields it is given; it does not
judge whether a check was well chosen or whether the reference hours are fair.
Usage: python3 horizon.py work-log.jsonl --as-of 2026-10-09 [--stable]   Rules v1.1   Licence: MIT
"""
import argparse
import datetime as dt
import json
import math
import sys
import statistics
from collections import Counter, defaultdict

# rung, reference hours, minimum pieces, window in days (provisional; Section 5.8)
RUNGS = [("Quarter", 500.0, 3, 365), ("Month", 160.0, 6, 365), ("Week", 40.0, 6, 182),
         ("Day", 8.0, 10, 91), ("Hour", 1.0, 10, 91)]
PLANTED_FROM = 40.0         # from Week upward a planted error must be in the window
GAIN_STEPS = [60, 20, 5, 2, 1]
GAIN_WINDOW = 91            # gain, directive share and the recent piece of upper rungs (91 days)
PASS_SHARE = 0.8            # 8 of 10; every irreversible piece must pass
INDEPENDENT = {"hidden_tests", "expert", "real_use", "other_family_with_sources"}
RATER_SPREAD = 1.5          # raters further apart than this need a third rater
CHECKS = INDEPENDENT | {"same_family", "self_review", "none"}
MODES = {"one_piece", "stages", "together"}
KEYS = {"person", "domain", "date", "reference_hours", "reference_basis",
        "attention_minutes", "mode", "check", "agent_saw_check", "passed", "irreversible",
        "planted_errors", "planted_missed", "outside_help"}
OPTIONAL = {"started",      # date the hand-over started (expected from v1.1; the line is written at close)
            "task_id", "model", "tools", "checker", "rater_hours", "audit", "revoked"}


def load(path):
    """Every piece handed to agents is a line, including failed and abandoned ones."""
    records, undated = [], 0
    with open(path, encoding="utf-8") as fh:
        for n, line in enumerate(fh, 1):
            if not line.strip():
                continue
            r = json.loads(line)
            if set(r) - OPTIONAL != KEYS:
                sys.exit(f"line {n}: unknown {sorted(set(r) - KEYS - OPTIONAL)}, missing {sorted(KEYS - set(r))}")
            if r["check"] not in CHECKS or r["mode"] not in MODES:
                sys.exit(f"line {n}: check or mode is not one of the allowed values")
            if float(r["reference_hours"]) <= 0 or float(r["attention_minutes"]) < 0:
                sys.exit(f"line {n}: reference hours must be positive, minutes not negative")
            if not 0 <= int(r["planted_missed"]) <= int(r["planted_errors"]):
                sys.exit(f"line {n}: planted_missed must lie between 0 and planted_errors")
            if not isinstance(r["outside_help"], bool) or not isinstance(r.get("revoked", False), bool):
                sys.exit(f"line {n}: outside_help and revoked must be true or false")
            if r.get("audit", "none") not in {"none", "passed", "failed"}:
                sys.exit(f"line {n}: audit must be none, passed or failed")
            if "rater_hours" in r and (len(r["rater_hours"]) < 2 or min(map(float, r["rater_hours"])) <= 0):
                sys.exit(f"line {n}: rater_hours needs two or more positive estimates")
            undated += "started" not in r
            r["date"] = dt.date.fromisoformat(r["date"])
            if "started" in r and dt.date.fromisoformat(r["started"]) > r["date"]:
                sys.exit(f"line {n}: started must not be later than date")
            records.append(r)
    if undated:
        print(f"warning: {undated} lines without started (expected from rules v1.1)", file=sys.stderr)
    return records


def verified(r):
    """A pass counts only if the check was independent, the agents never saw it, no planted error
    was missed, nobody helped off the log, no audit failed and no delayed outcome revoked it.
    Another model family alone never verifies irreversible work."""
    return (r["passed"] is True and r["check"] in INDEPENDENT and r["agent_saw_check"] is False
            and int(r["planted_missed"]) == 0 and not r["outside_help"]
            and not (r["irreversible"] and r["check"] == "other_family_with_sources")
            and r.get("audit") != "failed" and not r.get("revoked", False))


def rung_holds(pieces, hours, minimum, as_of, days):
    start = as_of - dt.timedelta(days=days)
    window = [r for r in pieces if start < r["date"] <= as_of]
    big = [r for r in window if float(r["reference_hours"]) >= hours]
    if len(big) < minimum:
        return False
    if sum(map(verified, big)) / len(big) < PASS_SHARE:
        return False
    if any(r["irreversible"] and not verified(r) for r in big):   # strict rule, these pieces only
        return False
    if hours >= PLANTED_FROM:
        if not any(int(r["planted_errors"]) > 0 for r in big):
            return False
        if any(int(r["planted_missed"]) > 0 for r in window):   # any missed planted error blocks
            return False
    if days > GAIN_WINDOW:                                       # quarterly re-verification
        recent = as_of - dt.timedelta(days=GAIN_WINDOW)
        if not any(verified(r) and r["date"] > recent for r in big):
            return False
    return True


def horizon(pieces, as_of):
    for name, hours, minimum, days in RUNGS:        # from the top rung down
        if rung_holds(pieces, hours, minimum, as_of, days):
            return name
    return "below Hour"


def rung_pieces(pieces, name, as_of):
    """Pieces of the rung's size in its window (Hour's for 'below Hour'): what the count is out of."""
    _, hours, _, days = next(r for r in RUNGS if r[0] == name or (name == "below Hour" and r[0] == "Hour"))
    return [r for r in pieces if as_of - dt.timedelta(days=days) < r["date"] <= as_of
            and float(r["reference_hours"]) >= hours]


def gain(pieces):
    done = math.fsum(float(r["reference_hours"]) for r in pieces
                     if verified(r) and not r["outside_help"])            # outside help excluded
    spent = math.fsum(float(r["attention_minutes"]) for r in pieces) / 60.0   # failures included
    return None if spent == 0 else done / spent


def step(g):
    if g is None:
        return "n/a"
    for s in GAIN_STEPS:
        if g >= s:
            return f"x{s}"
    return "below x1"


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("log")
    ap.add_argument("--as-of", default=dt.date.today().isoformat())
    ap.add_argument("--stable", action="store_true", help="also score 91 days earlier and label the rung")
    args = ap.parse_args()
    as_of = dt.date.fromisoformat(args.as_of)
    longest = max(days for *_, days in RUNGS) + (GAIN_WINDOW if args.stable else 0)
    groups = defaultdict(list)
    for r in load(args.log):
        if as_of - dt.timedelta(days=longest) < r["date"] <= as_of:
            groups[(r["person"], r["domain"])].append(r)
    quarter = f"{as_of.year}-Q{(as_of.month - 1) // 3 + 1}"
    recent_start = as_of - dt.timedelta(days=GAIN_WINDOW)
    for (person, domain), pieces in sorted(groups.items()):
        recent = [r for r in pieces if r["date"] > recent_start]
        g = gain(recent)
        shown = "n/a" if g is None else f"{g:.2f}"
        failed = sum(1 for r in recent if not verified(r))
        directive = (sum(r["mode"] == "one_piece" for r in recent) / len(recent)) if recent else 0.0
        rung = horizon(pieces, as_of)
        counted = rung_pieces(pieces, rung, as_of)
        label = ""
        if args.stable:
            before = horizon(pieces, as_of - dt.timedelta(days=GAIN_WINDOW))
            label = " stable" if before == rung else f" provisional (was {before})"
        print(f"{person}: {domain} . {rung} ({sum(map(verified, counted))}/{len(counted)}){label}"
              f" . {step(g)} . {quarter}  (pieces in last 91 days: {len(recent)}, not verified: {failed};"
              f" gain {shown}; directive share {directive:.0%})")
        kinds = Counter(r["check"] for r in counted).most_common()
        sizes = [float(r["reference_hours"]) for r in recent if r["passed"]]
        median = f"{statistics.median(sizes):.1f} h" if sizes else "n/a"
        spread = any(max(map(float, r["rater_hours"])) / min(map(float, r["rater_hours"])) > RATER_SPREAD
                     for r in pieces if len(r.get("rater_hours", [])) == 2)   # with three, the median decided
        print(f"  checks: {', '.join(f'{k} {v}' for k, v in kinds) or 'none'};"
              f" median accepted size {median}{'; needs third rater' if spread else ''}")


if __name__ == "__main__":
    main()
C3. brier.py
#!/usr/bin/env python3
"""brier.py: score dated predictions by the Brier rule.

Teaches: why one missed prediction made at 35% says little on its own, and why 'unresolved' is
never a success. Input CSV columns: id,probability,outcome (outcome: 1, 0 or unresolved).
Usage: python3 brier.py predictions.csv                                  Licence: MIT
"""
import csv
import sys


def main(path):
    resolved, pending = [], []
    with open(path, newline="", encoding="utf-8") as fh:
        for row in csv.DictReader(fh):
            p = float(row["probability"])
            if not 0.0 <= p <= 1.0:
                sys.exit(f"{row['id']}: probability must lie between 0 and 1")
            outcome = row["outcome"].strip().lower()
            if outcome in ("0", "1"):
                resolved.append((row["id"], p, int(outcome)))
            else:
                pending.append(row["id"])
    for pid, p, o in resolved:
        print(f"{pid}: p={p:.2f} outcome={o} score={(p - o) ** 2:.3f}")
    if resolved:
        mean = sum((p - o) ** 2 for _, p, o in resolved) / len(resolved)
        print(f"Brier score over {len(resolved)} resolved: {mean:.3f} (always saying 0.5 gives 0.250)")
    print("unresolved or not yet due: " + (", ".join(pending) or "none"))


if __name__ == "__main__":
    main(sys.argv[1])
C4. Рабочий пример
Журнал ниже содержит десять операций бухгалтерского учёта, переданных агентам одним человеком с июля по сентябрь 2026 года.
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-07-17", "date": "2026-07-20", "reference_hours": 9, "reference_basis": "two raters", "attention_minutes": 95, "mode": "stages", "check": "expert", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-07-24", "date": "2026-07-28", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 80, "mode": "stages", "check": "hidden_tests", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-07-29", "date": "2026-08-04", "reference_hours": 12, "reference_basis": "two raters", "attention_minutes": 150, "mode": "one_piece", "check": "expert", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-09", "date": "2026-08-11", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 70, "mode": "stages", "check": "self_review", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-13", "date": "2026-08-18", "reference_hours": 10, "reference_basis": "two raters", "attention_minutes": 110, "mode": "together", "check": "real_use", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-21", "date": "2026-08-25", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 120, "mode": "stages", "check": "expert", "agent_saw_check": false, "passed": false, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-24", "date": "2026-09-01", "reference_hours": 16, "reference_basis": "two raters", "attention_minutes": 180, "mode": "one_piece", "check": "hidden_tests", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-05", "date": "2026-09-08", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 60, "mode": "stages", "check": "expert", "agent_saw_check": false, "passed": true, "irreversible": true, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-11", "date": "2026-09-15", "reference_hours": 9, "reference_basis": "two raters", "attention_minutes": 90, "mode": "together", "check": "other_family_with_sources", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-27", "date": "2026-09-29", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 75, "mode": "stages", "check": "hidden_tests", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
Запуск python3 horizon.py work-log.jsonl --as-of 2026-10-09 выводит запись и строку о проверках, её обосновывающих:
P07: small-business bookkeeping . Day (8/10) . x2 . 2026-Q4  (pieces in last 91 days: 10, not verified: 2; gain 4.66; directive share 20%)
  checks: expert 4, hidden_tests 3, self_review 1, real_use 1, other_family_with_sources 1; median accepted size 9.0 h
Все десять работ содержат как минимум по 8 часов справок. Две не учитываются как проверенные: одна была проверена только самопроверкой, а одна не прошла проверку эксперта. Восемь из десяти — это ровно то количество, которое требует День, и одна необратимая работа прошла, поэтому ступень — День. Неделя недостижима, так как ни одна работа не достигает 40 часов. Проверенные работы в сумме дают 80 часов справок против 1 030 минут (около 17,2 часов) внимания, потраченного на все десять, включая неудачи, что даёт прирост 4,66 и шаг ×2. Ни одна работа не содержала заложенных ошибок или посторонней помощи, поэтому ни одно из этих правил не меняет результат. Если бы неудачная работа была исключена из журнала, ступень опиралась бы на девять работ и не соответствовала бы требуемому счёту десять, именно поэтому неудачи принадлежат записи. Счёт рядом со ступенью, 8/10, показывает, насколько близким было решение (Приложение E), а вторая строка даёт виды проверки за учитанными работами и медианный принятый размер, 9,0 часов, чтобы читатель мог увидеть, опирается ли горизонт на работы, находящиеся ровно выше порога (Таблица 3). Внимание человека, 1 030 минут, составляет около 18% от 96 переданных часов справок и около 21% от 80, которые были проверены. Запись для резюме звучит как «ведение бухгалтерии малого бизнеса · День · ×2 · 2026-Q4».
Вспомогательный инструмент tools/explain.py выводит причины того же решения в соответствии с теми же правилами. Восемь из десяти работ размера День проверены и восемь нужны, счёт, соответствующий истинному проценту прохождения от 44% до 97% (Раздел 5.8), поэтому никакая дальнейшая неудачная работа такого размера не может быть поглощена. Если ничего нового не будет зафиксировано, День продержится до 18 октября 2026 года; 19 октября работа, закрытая 20 июля, покидает 91-дневное окно, и остаётся девять работ размера День, на одну не хватает до десяти, которые требует День. Для Недели она перечисляет каждое всё ещё отсутствующее условие: шесть работ длительностью как минимум 40 часов в течение 182 дней, одна из них с заложенными ошибками и одна проверённая в последние 91 день.
Построенный журнал также содержит трассировку, которую называет Таблица 3: пять из его десяти работ были оценены ровно в 8 часов, минимум День, а tools/too_clean.py отмечает его как «проверить сначала», с трассировкой «5 из 10 работ находятся ровно выше порога ступени». Флаг отправляет журнал на аудит и ничего не решает о нём; медиана 9,0 часов рядом со ступенью показывает то же самое читателю.
C5. Вспомогательный репозиторий
Вспомогательный репозиторий (https://github.com/vadimchernets/delegation-horizon) содержит инструмент и материалы, которые позволяют читателям использовать каждую часть работы. Основные файлы по разделам:
| Раздел | Файлы | Что они делают |
|---|---|---|
| 5.2, C1 to C4 | horizon.py, log.schema.json, examples/ |
Оценщик, схема одной строки журнала, проработанный пример и строки, которые он должен выводить |
| 5.2, 5.3 | tools/log_piece.py, record_card.py, checker.html |
Запись журнала ответом на вопросы, карточка записи со счётом позади ступени и одна и та же оценка на автономной странице браузера; обе читают электронную таблицу, сохранённую с запятыми или с точками с запятой |
| 5.2, 5.8, C4 | tools/explain.py |
Почему журнал заслуживает свою ступень: каждое условие, которое выполняется или не выполняется, запас, день, когда ступень истекает, если ничего нового не будет зафиксировано, и что нужно следующей ступени |
| 5.1 | tools/reference_hours.py, kits/reference-hours-raters.md |
Справочные часы из оценок оценщиков и как выбрать, допустить и инструктировать оценщиков |
| 5.8, Table 3 | audit_sample.py, tools/too_clean.py, tools/planted.py, kits/ |
Воспроизводимый образец аудита, флаги для журналов, которые выглядят слишком чисто, заложенные ошибки, запечатанные перед передачей и оценённые по типу (неправильная запись или пропуск), направления аудита и заложенных ошибок |
| 6.2, 10.3 | tools/verify_record.py |
Принимающая сторона переносимой записи: является ли журнал, отправленный вместе с ней, файлом, который был оценён, одинаков ли оценщик и даёт ли переоценка ту же запись, поле за полем |
| 6.2 | kits/trade-screen.md, tools/gate_leak.py |
Допуск людей по вопросу профессии вместо метки, и сколько утекает метка, с точным интервалом (11 из 60 в Приложении G2: от 9,5% до 30,4%) |
| 6.5, 10.5 | kits/checking-process.md, kits/process-vs-experience-study.md, tools/process_study.py |
Четыре шага Раздела 6.5 и то, что каждый зарабатывает по правилу (Рисунок A4), и сравнение Раздела 10.5 как протокол регистрации с его анализом, неправильные записи и пропуски отдельно |
| 5.8, Appendix E | pilot/ |
Настольный тест пороговых значений, банк 30 задач, протокол калибровки с текстом регистрации и формой согласия |
| Appendix G2 | pilot/ |
Зарегистрированный анализ human_raters.py, поданный на OSF, преобразование экспортов Prolific, скрипт, который выводит Таблицу G2 с зарегистрированными функциями, сравнение скрининга и синтетический экспорт для их запуска |
| 7.2 | templates/, tools/guarantor_record.py |
Карточка задачи для банка задач, реестр гарантора и запись гарантора, вычисленная из него: продукты, поручившиеся за них, сколько прожило 6 и 12 месяцев, отказы по серьёзности |
| 11, Tables 4 and A6, C3 | predictions/, brier.py, tools/power.py |
41 зарегистрированное предсказание с манифестом их хешей, поданным на OSF, правила разрешения и файлы, инструменты оценки, которые фиксируют не проведённое предсказание Set B и выводят оценку Brier как без его учёта, так и с его оценкой как неправильного (Раздел 11.2), а также размеры выборок Раздела 11.2 |
| 11, Set B | predictions/set_b.py |
Заморозённые правила о сбывшихся и не сбывшихся из девяти предсказаний Set B, написанных на интервал, применённые к оценкам исследования |
| 11.4, F27 | kits/f27-sample.md, tools/freeze_sample.py, tools/liveness.py |
Протокол и розыгрыш выборки F27 (закрытый пул зарегистрирован сначала, ключ взят впоследствии из открытого маяка случайности), заморожен на Zenodo и его хеш зарегистрирован на OSF к 31 декабря 2026 года, и его жизнеспособность на каждую дату оценки по словам F27 |
| C2 to C4, Tables 4 and A6 | tools/paper_sync.py |
Проверяет этот текст в репозитории: листинги побайтово, разобранный пример и его результат, таблицы предсказаний, подсчёты наборов, каждый названный файл и каждую встроенную диаграмму |
| Appendix D, Appendix F | figures/ |
Скрипты, которые создают Figure A1 из таблицы предсказаний и Figure A4 из правил скорера |
Те же файлы по читателям:
| Читатель | Начните с | Что это даёт |
|---|---|---|
| Человек, который распределяет работу между агентами | templates/work-log.csv, record_card.py or checker.html, tools/explain.py |
Журнал, ведённый в электронной таблице, запись и её карточка, и то, что нужно следующей ступени |
| Работодатель или команда HR | kits/hiring-test/, kits/trade-screen.md, kits/scope-statement.md, tools/explain.py |
Оплачиваемый однодневный тест работы со слепой оценкой, вопрос профессии вместо метки, что ступень говорит и не говорит, и насколько близок был вердикт кандидата |
| Новичок в профессии | kits/checking-process.md, kits/acceptance-card.md, kits/planted-errors-guide.md |
Шаги раздела 6.5 и что приносит каждый, «выполнено» указано перед передачей, и практика с посаженными пропусками |
| Аудитор или гарант | audit_sample.py, tools/too_clean.py, tools/planted.py, kits/audit-checklist.md |
Выборка для повторной проверки, следы журнала, который выглядит слишком чистым, посаженные ошибки, чья печать показывает, был ли список изменён |
| Исследователь | pilot/, kits/matched-task-study.md, kits/process-vs-experience-study.md, tools/power.py, predictions/ |
Настольный тест, исследование оценщиков и их скрипты, протоколы сравнения, размеры выборок, и зарегистрированные предсказания с их инструментами оценочной карточки |
Приложение D. Текст регистрации прогнозов (OSF)
Название. Датированные прогнозы работы посредством агентов ИИ, 2026–2031: зафиксированные прогнозы и ежегодное оценивание.
Тип. Открытая регистрация (Open-Ended Registration), общедоступная немедленно, без эмбарго.
Резюме. Эта регистрация фиксирует датированные прогнозы, изложенные в работе "After the Programmer Divide: One Measure for People Who Build Through AI Agents" (SSRN 7589918; Zenodo DOI 10.5281/zenodo.23267266). В приложенной таблице для каждого прогноза указаны: его формулировка; его мера; общедоступный источник и резервный источник; исходный уровень 2025 или 2026 года с датой доступа и архивированным снимком; дата проверки и окончательная дата; вероятность, зафиксированная на дату этой регистрации; и пороги для трёх исходов: сбылся, не сбылся, не разрешён.
Оценивание. Каждый прогноз оценивается при первой ежегодной проверке на дату проверки или позже неё, при условии, что данные существуют, но не позднее окончательной даты. Разрешённые прогнозы оцениваются по правилу Бриера. Прогноз без сравнимых данных к окончательной дате записывается как не разрешённый и не считается успехом.
Наборы и вероятности. Набор A разрешается на основе общедоступных данных и файлов в predictions/resolve/, чьи хэши SHA-256 перечислены в этой регистрации. Набор B разрешается только на основе исследований, зарегистрированных отдельно до сбора данных; для прогноза набора B, протокол которого не зарегистрирован к 30 июня 2027 года, записывается как не проведённый, как неудача испытательной программы; оценка Бриера сообщается как для разрешённых прогнозов, так и с каждым не проведённым прогнозом, оцениваемым как неправильный. Вероятности условны на разрешении. Это медиана трёх слепых прогнозов моделей, собранных 9 октября 2026 года (Claude Opus, модель OpenAI и Gemini) и принятых автором; более ранние объединённые прогнозы четырёх моделей приложены для справки.
Точка пересечения. F2, F3, F5 и F7 измеряются в одних и тех же названных доменах: ведение учёта малого бизнеса и юридические и маркетинговые документы — два непрограммистских домена банка задач (Приложение E); для аналога объявлений F5 они соответствуют SOC 43-3031, 23-2011 и 13-1161. Третий домен банка, небольшие внутренние веб-инструменты, является домашним доменом программистов и не является доменом пересечения. Точка пересечения в домене — это первый год, в котором F3 и аналог F5 домена выполняются в одном и том же названном домене; ни один из них отдельно это не объявляет.
Дополнения к оцениванию. Каждая оценочная карточка также сообщает долю разрешённых прогнозов, оценку Бриера по наборам и по семействам, наихудшую границу, которая оценивает просроченные неразрешённые прогнозы как неправильные, и оценку мастерства Бриера в сравнении с 0,5, объединёнными прогнозами моделей и рыночными ценами.
Ежегодные проверки. Каждый год с 2027 по 2031 годы в годовщину этой регистрации автор опубликовывает оценочную карточку, охватывающую каждый прогноз, зарегистрированный здесь. Каждая оценочная карточка сама регистрируется на OSF, связана с этой регистрацией по DOI и депонирована на Zenodo.
Зафиксированные правила. Ни один прогноз не удаляется, не переформулируется и не получает новую дату. Всё, что добавляется позже, регистрируется отдельно и имеет свою дату. Если названный источник перестаёт публиковаться или меняет свою методику, используется резервный источник при условии, что он измеряет ту же величину; если сравнимого источника не существует, прогноз не разрешён.
Независимая проверка. Каждая оценочная карточка проверяется в соответствии с зафиксированными здесь правилами моделями как минимум из двух разных семейств. Там, где они не согласны, решение принимает правило, и расхождение сообщается. Человеческий арбитр, назначенный автором до первой оценочной карточки, разрешает споры между двумя семействами моделей.
Собственные данные. Прогнозы, которые опираются на данные когорты автора, тестируются только в рамках отдельной предварительной регистрации, поданной до сбора этих данных, как это делает зарегистрированная на OSF программа (DOI 10.17605/OSF.IO/X4EGQ) для каждой когорты.
Конфликты интересов. Как указано в работе.
Файлы. Таблица прогнозов (CSV и таблица A6 приложенной работы); список архивированных снимков; predictions/resolve/ (зафиксированные запросы, списки и кодовая книга с хэшами); resolution-rules.md; changelog-v1-v2.md.
Приложенная таблица прогнозов — это таблица A6, а рисунок A1 представляет её календарь.
Рисунок A1. Календарь проверок, 2026–2031.
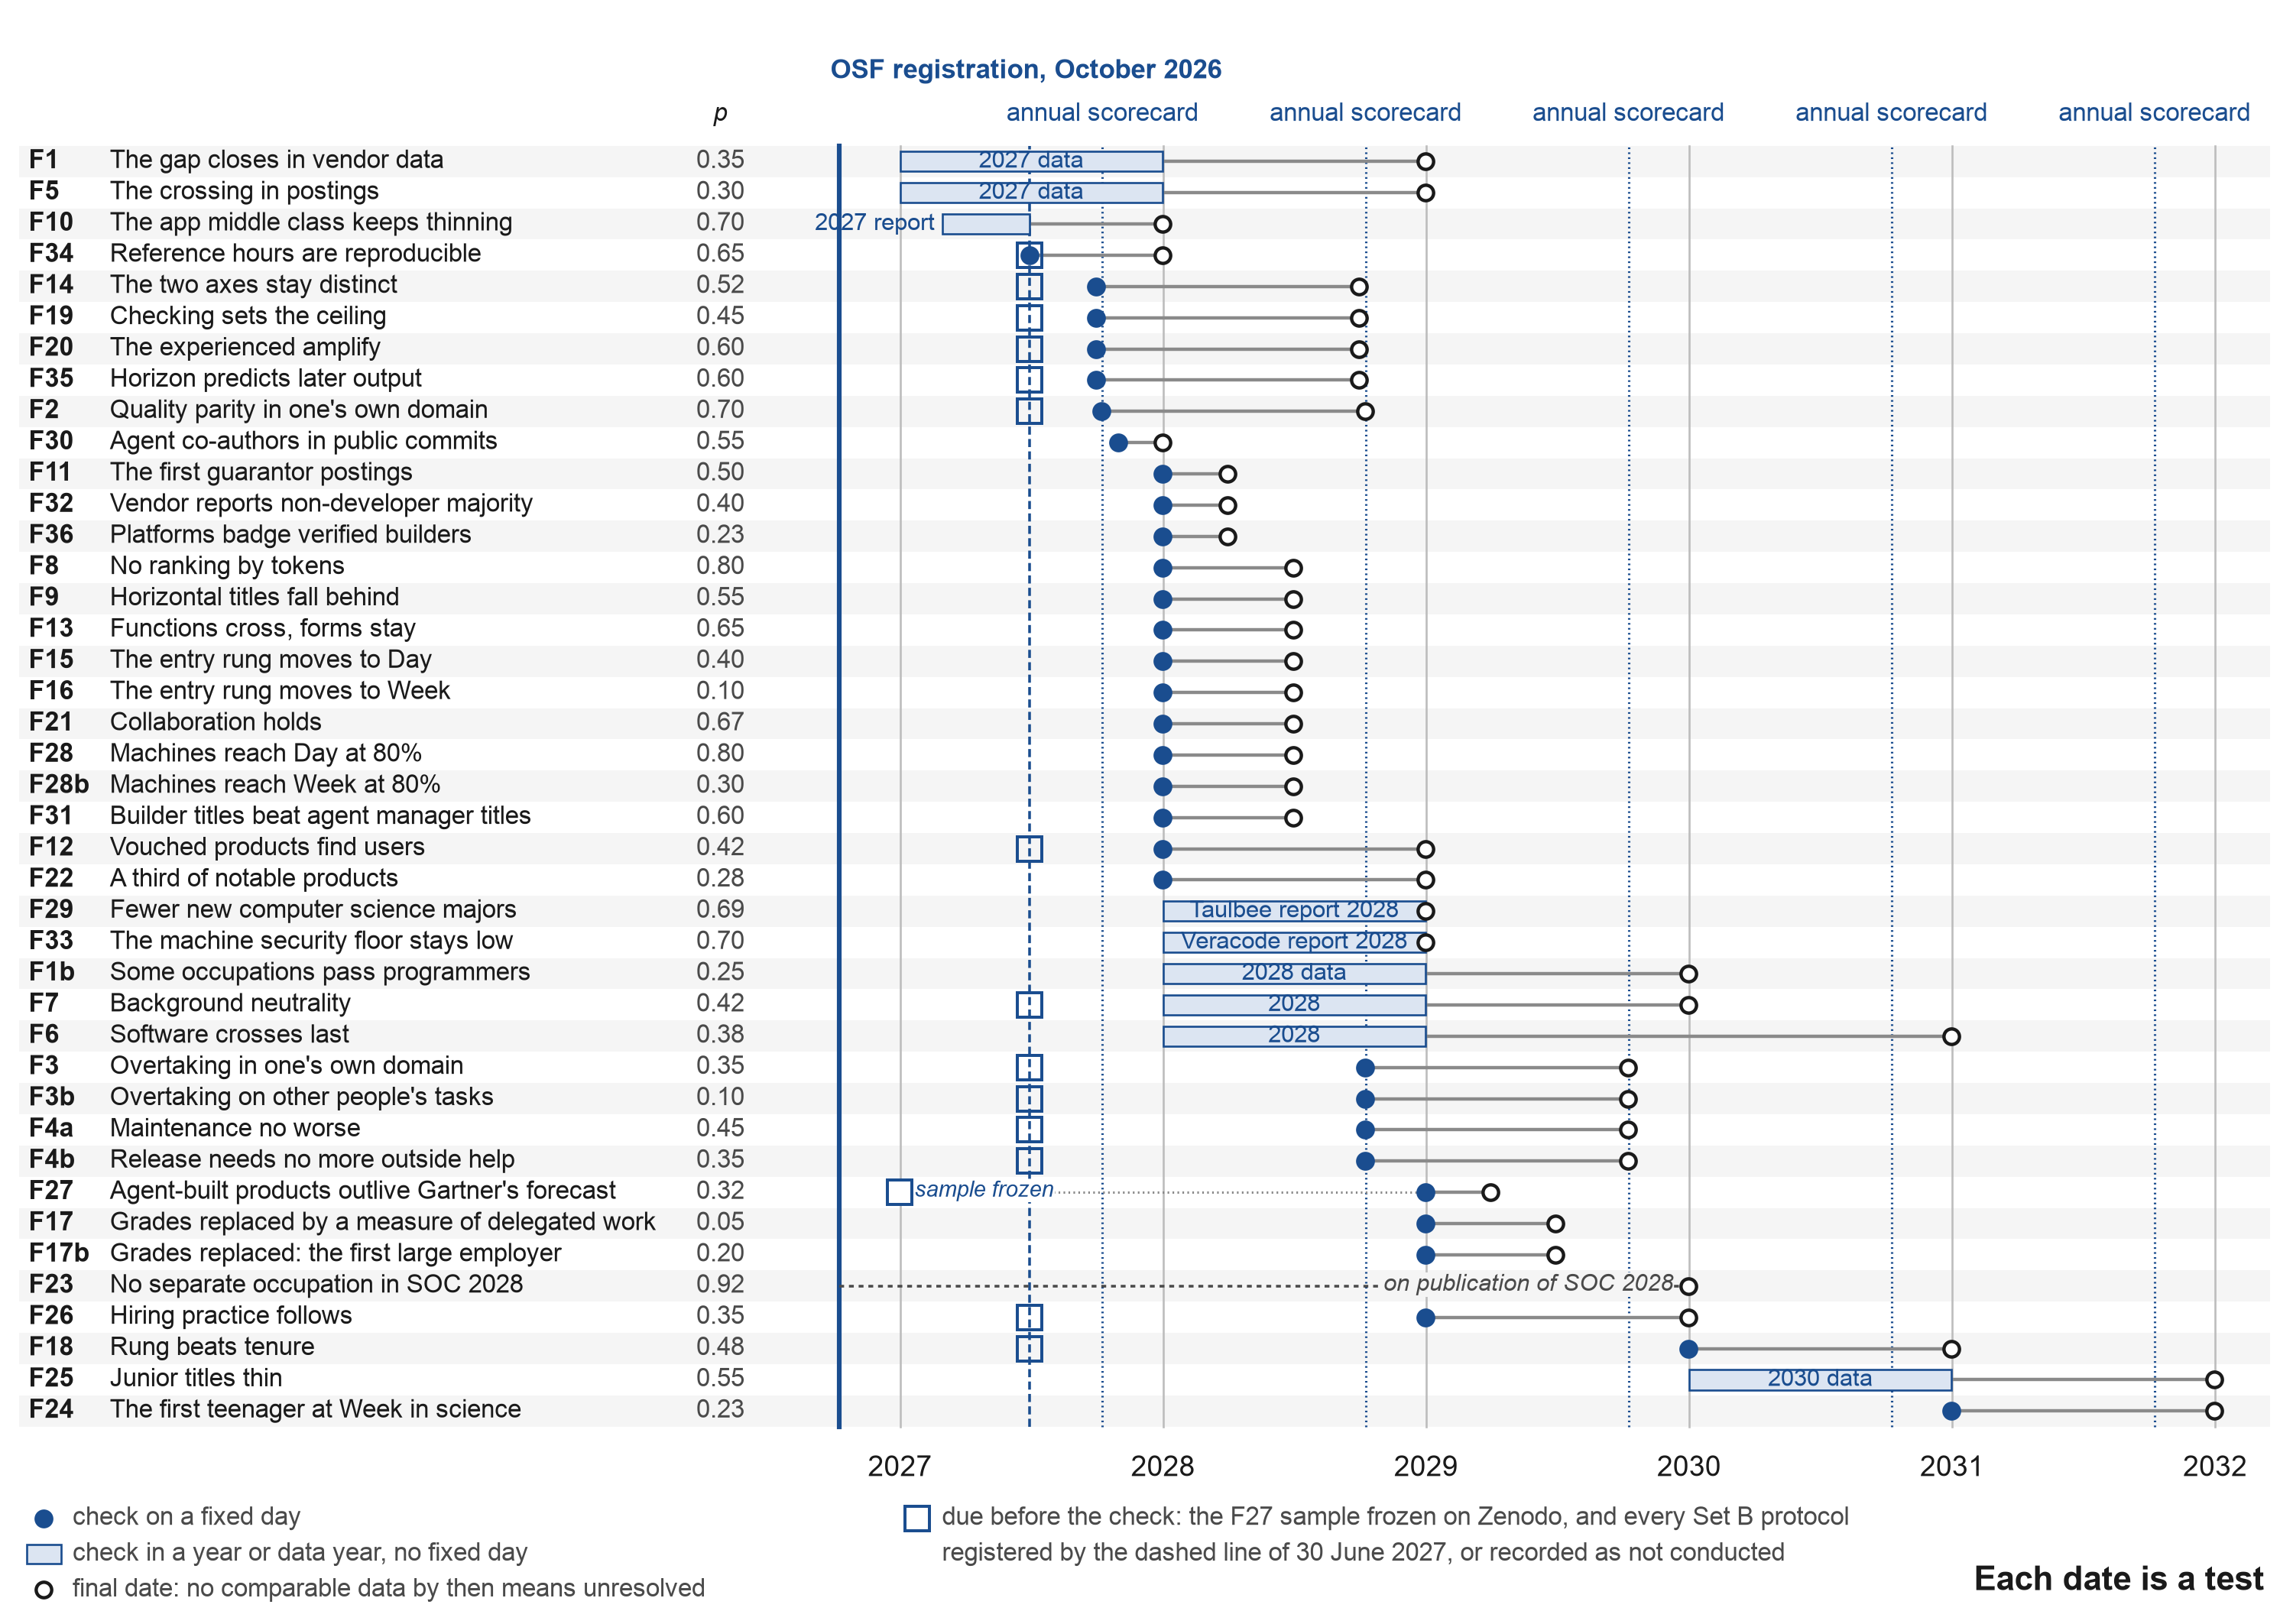
Примечание: по одной строке на прогноз таблицы A6, отсортированные по дате проверки с указанием вероятности. Заполненная точка — это проверка на фиксированный день. Светлая полоса — это проверка в году или в году данных без фиксированного дня. Кольцо — это окончательная дата, после которой прогноз без сравнимых данных записывается как не разрешённый (раздел 11.4). Пунктирные линии обозначают ежегодные оценочные карточки, которые должны быть зарегистрированы на OSF каждый октябрь с 2027 по 2031 годы. Полый квадрат обозначает обязательство, подлежащее выполнению до проверки: образец F27, зафиксированный на Zenodo 31 декабря 2026 года, и, на пунктирной линии 30 июня 2027 года, протокол каждого из 14 исследований набора B, без которого прогноз записывается как не проведённый (раздел 11.2). Рисунок генерируется из таблицы прогнозов посредством figures/figure_a1_calendar.py в сопровождающем репозитории и изменяется только с ней.
Таблица A6. Все 41 датированный прогноз: наборы, меры, пороги, вероятности, прогнозы моделей, резервные варианты и предыдущие прогнозы.
| # (набор) | Прогноз, мера, исходный уровень и порог | Даты, вероятность, прогнозы моделей, правило неразрешённости, резервный вариант и предыдущий прогноз |
|---|---|---|
| F1 (A) | Разрыв сокращается в данных поставщика. Проверенный успех на сеансах генерирования кода, программирование в сравнении с другими профессиями: 34% против 29%, неизменный в течение семи месяцев (Anthropic, 2026e). Разрыв — это уровень успеха профессий программирования минус уровень успеха других профессий, с учётом его знака. Считается сбывшимся, если разрыв составляет 2 пункта или менее, включая отрицательные значения, в сравнимом отчёте по данным 2027 года; не считается сбывшимся, если больше 2. Исходный уровень: Проверенный успех на сеансах генерирования кода: программирование 34% против других профессий 29%, неизменный в течение семи месяцев (Anthropic, 2026e) | Проверка: данные 2027 г. Итоговая дата: 31 декабря 2028 г. p = 0,35; модели 0,39 (0,25 до 0,65). Не решено, если: Нет отчета по данным 2027 г. к итоговой дате или определение сеанса изменилось (никогда не считается успехом). Резервный вариант: Любой отчет поставщика, подтверждающий успех по профессиям на сравнимых сеансах. Ближайший предыдущий или противоположный прогноз: Anthropic: разрыв «не увеличился и не сократился» |
| F1b (A) | Некоторые профессии опережают программистов. Тот же показатель, что и F1. 10 крупнейших непрограммистских профессий зафиксированы при регистрации как 10 с наибольшей долей сеансов в Anthropic (2026е). Профессия превосходит программирование только если её коэффициент успеха выше на 2 пункта или более (допуск для множественности сравнений в пределах 10 сравнений). Сбылось, если это произойдет хотя бы в 3 из 10 случаев в данных 2028 г. Базовый уровень: как F1; управление уже немного опережает программирование (Anthropic, 2026е) | Проверка: данные 2028 г. Итоговая дата: 31 декабря 2029 г. p = 0,25; модели 0,30 (0,20 до 0,45). Не решено, если: Нет отчета по данным 2028 г. к итоговой дате или определение сеанса изменилось (никогда не считается успехом). Резервный вариант: как F1. Ближайший предыдущий или противоположный прогноз: управление уже немного опережает (Anthropic, 2026е) |
| F2 (B) | Паритет качества в своей области (шаг перед точкой перекрестья). Тот же агент, то же время, слепое принятие и проверки безопасности, изменение обслуживания другим агентом через месяц; одно исследование с 1500 человек в группе. Сбылось, если нижняя граница 95% интервала для (люди без ИТ-образования минус программисты) превышает минус 10 пунктов; не сбылось, если верхняя граница ниже минус 10; в противном случае не решено. Базовый уровень: нет публичного базового уровня; отдельно зарегистрированное исследование, 1500 человек в группе | Проверка: 8 октября 2027 г. Итоговая дата: 8 октября 2028 г. p = 0,70; модели 0,67 (0,62 до 0,70). Не решено, если: Нет сравнимых данных к итоговой дате или интервал, который не соответствует ни одному правилу (никогда не считается успехом). Резервный вариант: независимое исследование с тем же дизайном. Ближайший предыдущий или противоположный прогноз: D. H. Hansson (2026), «100%» (без даты, без меры); Esnaola et al. (2026) |
| F3 (B) | Опережение в своей области (точка перекрестья в качестве). Как F2 (1500 на группу даёт примерно 0,8 мощность для обнаружения истинного преимущества в 5 пунктов при двустороннем альфа 0,05; 400 на группу даёт примерно 0,3). Сбылось, если нижняя граница 95% интервала превышает нуль; не сбылось, если верхняя граница ниже нуля; в противном случае не решено. Базовый уровень: как F2 | Проверка: 8 октября 2028 г. Итоговая дата: 8 октября 2029 г. p = 0,35; модели 0,33 (0,25 до 0,55). Не решено, если: Нет сравнимых данных к итоговой дате или интервал, который не соответствует ни одному правилу (никогда не считается успехом). Резервный вариант: как F2. Ближайший предыдущий или противоположный прогноз: Ничего не найдено с датой |
| F3b (B) | Опережение на задачах других людей. Как F3, но на задачах вне сферы деятельности участников. Базовый уровень: как F2, на задачах вне сферы деятельности участников | Проверка: 8 октября 2028 г. Итоговая дата: 8 октября 2029 г. p = 0,10; модели 0,13 (0,07 до 0,35). Не решено, если: Нет сравнимых данных к итоговой дате или интервал, который не соответствует ни одному правилу (никогда не считается успехом). Резервный вариант: как F2. Ближайший предыдущий или противоположный прогноз: аргумент предметной области в разделе 6.3 предсказывает его неудачу |
| F4a (B) | Обслуживание не хуже. Доля принятых продуктов, заброшенных в течение 12 месяцев, по образованию авторов. Сбылось, если верхняя граница 95% интервала для разницы (непрограммисты минус программисты) ниже 10 пунктов. Базовый уровень: нет публичного базового уровня; Gartner (Tyagi, 2026, как резюмировано Tray.ai, 2026) ожидает, что 60% приложений, написанных по наитию, будут выведены из обращения к 2028 г., с учетом всех приложений | Проверка: 8 октября 2028 г. Итоговая дата: 8 октября 2029 г. p = 0,45; модели 0,49 (0,34 до 0,68). Не решено, если: Нет сравнимых данных к итоговой дате или интервал, который не соответствует ни одному правилу (никогда не считается успехом). Резервный вариант: реестры продуктов с опросами авторов. Ближайший предыдущий или противоположный прогноз: Gartner (Tyagi, 2026, как резюмировано Tray.ai, 2026): 60% приложений, написанных по наитию, будут выведены из обращения к 2028 г. «потому что они не обеспечивают предсказуемую стоимость для бизнеса»; более широкая совокупность, чем F4a, которая учитывает только принятые продукты |
| F4b (B) | Выпуск больше не нуждается во внешней помощи. Доля продуктов, нуждающихся во внешней технической помощи при выпуске. Сбылось, если не худше при 10-пунктовом допуске; ожидается, что разрыв закроется в порядке прототип, выпуск, обслуживание. Базовый уровень: нет публичного базового уровня | Проверка: 8 октября 2028 г. Итоговая дата: 8 октября 2029 г. p = 0,35; модели 0,37 (0,22 до 0,50). Не решено, если: Нет сравнимых данных к итоговой дате или интервал, который не соответствует ни одному правилу (никогда не считается успехом). Резервный вариант: как F4a. Ближайший предыдущий или противоположный прогноз: Gartner (Tyagi, 2026, как резюмировано Tray.ai, 2026): 30% команд разработки ПО находятся в состоянии «существенной перегрузки» из-за поддержки приложений, написанных по наитию, созданных гражданами и бизнес-пользователями |
| F5 (A) | Пересечение в объявлениях (видимый знак). Объявления в США в зафиксированном наборе ИТ-профессий; агентские навыки, определенные версией таксономии Lightcast Open Skills, актуальной на дату регистрации (номер версии записан в predictions/resolve/F5.md), с зафиксированным списком агентских навыков; доля, требующая четырехлетнего высшего образования в объявлениях с этими навыками по сравнению с объявлениями без них, сопоставленными точно по профессии (SOC 6-значная), уровню опыта, штату и кварталу. Базовый уровень агентских навыков (2026 Q2 и Q3) снимается и архивируется перед регистрацией. Сбылось, если разница составляет минус 2 пункта или более, с 95% интервалом, исключающим нуль, в течение двух подряд идущих кварталов 2027 г. Базовый уровень: объявления ИИ по-прежнему с большей вероятностью требуют диплома, но сходятся с 2024 г. (Lightcast, 2026b); базовый уровень агентских навыков снимается перед регистрацией | Проверка: данные 2027 г. Итоговая дата: 31 декабря 2028 г. p = 0,30; модели 0,34 (0,25 до 0,60). Не решено, если: Нет сравнимых данных к итоговой дате (никогда не считается успехом). Резервный вариант: PwC AI Jobs Barometer, только если он содержит информацию о требованиях к образованию для объявлений с агентскими навыками по сравнению с сопоставленными объявлениями; в противном случае не решено. Ближайший предыдущий или противоположный прогноз: Gartner (2021): большинство технологических продуктов создано вне ИТ к 2024 г.; Bone et al. (2025) об ИИ-навыках в британских объявлениях |
| F6 (A) | Программное обеспечение переходит последним. Замороженный список доменов: право, бухгалтерский учёт и учёт хозяйства, образование, администрирование клиники, маркетинг, недвижимость, страхование, управление персоналом, логистика, разработка программного обеспечения, ИТ-инфраструктура, безопасность, инструменты разработчика. Порядок первых переходов типа F5 по доменам. Сбылось, если разработка программного обеспечения, инфраструктура, безопасность и инструменты разработчика все переходят после как минимум половины других доменов. Исходное значение: ни один домен не перешёл (сравнение типа F5) | Проверка: 2028. Финальная дата: 31 декабря 2030 г. p = 0,38; модели 0,37 (0,25–0,55). Не разрешено, если: менее половины несвязанных с программным обеспечением доменов из замороженного списка перешли к финальной дате или нет сравнимого источника (никогда не учитывается как успех). Резервный вариант: другой источник постингов с тем же сравнением типа F5 по доменам; исследования качества (тип F2) не учитываются, и без такого источника прогноз не разрешен. Ближайший предшествующий или противоречащий прогноз: Hwang (2026): финансы как «канарейка в копях» |
| F7 (B) | Фоновая нейтральность. Отдельно зарегистрированная когорта с вопросом об ИТ-образовании; горизонт оценивается на одном наборе задач, качество на отложенных задачах. Отношение шансов прохождения независимых проверок, связанных с ИТ-образованием на равном уровне, с контролем команды доменов и грамотности по принятию. Маржа 0,67–1,5 представляет собой отношение шансов 1,5 в любом случае, примерно стандартизированная разница 0,22 (преобразование Чинна), условно небольшой эффект. Сбылось, если 90% доверительный интервал лежит в пределах 0,67–1,5 (эквивалентность), отдельно в День и на Неделю и выше. Исходное значение: нет общедоступного исходного значения; отдельно зарегистрированная когорта с вопросом об ИТ-образовании | Проверка: 2028. Финальная дата: 31 декабря 2029 г. p = 0,42; модели 0,43 (0,40–0,48). Не разрешено, если: любая другая комбинация, включая эквивалентность, показанную только на одном уровне, или нет данных к финальной дате (никогда не учитывается как успех). Резервный вариант: независимая когорта с теми же элементами. Ближайший предшествующий или противоречащий прогноз: наблюдение Anthropic по команде доменов; Savva (2026), противоречащий прогноз |
| F8 (A) | Отсутствие ранжирования по токенам. Работодатели из Fortune 500, использующие подсчёты токенов в качестве официального критерия оценки в течение 2027 года, задокументированные работодателем или двумя независимыми источниками (вопросы об использовании ИИ не учитываются). Сбылось, если найдено менее двух таких работодателей. Исходное значение: подсчёты токенов были испробованы как критерий оценки в 2026 году (раздел 4 статьи) | Проверка: 31 декабря 2027 г. Финальная дата: 30 июня 2028 г. p = 0,80; модели 0,79 (0,60–0,90). Не разрешено, если: нет сравнимых данных к финальной дате (никогда не учитывается как успех). Резервный вариант: поиск в архивах деловой прессы с замороженными запросами в predictions/resolve/F8.md. Ближайший предшествующий или противоречащий прогноз: Kingy AI (2026): «понижен, не убит»; Flowtivity (2026): «необратим» |
| F9 (A) | Горизонтальные должности отстают. Постинги США, те же замороженные запросы (predictions/resolve/F9.md), Q4 2026 и Q4 2027, каждый подсчёт разделён на все постинги США в том же квартале: agent manager, AI operator, AI orchestrator в сравнении с должностями, в названии которых есть домен (например, «legal AI lead», «vertical AI lead»). Сбылось, если нормализованная доля названных по доменам должностей растёт в большей степени, чем горизонтальные. Исходное значение: подсчёты постингов США по замороженным запросам в Q4 2026 | Проверка: 31 декабря 2027 г. Финальная дата: 30 июня 2028 г. p = 0,55; модели 0,58 (0,45–0,75). Не разрешено, если: любое семейство имеет менее 50 постингов в Q4 2026 или нет данных к финальной дате (никогда не учитывается как успех). Резервный вариант: подсчёты поиска Indeed или LinkedIn с теми же запросами. Ближайший предшествующий или противоречащий прогноз: Srinivasan и Wei (2026): «agent manager» стандартная должность в течение 12–18 месяцев; IT Brew (2026): «в течение следующих 18 месяцев» |
| F10 (A) | Средний класс приложений продолжает истончаться. Доля новых приложений с подпиской, достигающих 1000 долларов ежемесячного дохода в течение двух лет, та же мера, что и RevenueCat 2026 (17%). Сбылось, если ниже 17%. Исходное значение: 17% новых приложений с подпиской достигают дохода в размере 1000 долларов в месяц в течение двух лет (RevenueCat, 2026) | Проверка: отчёт RevenueCat 2027. Финальная дата: 31 декабря 2027 г. p = 0,70; модели 0,68 (0,60–0,80). Не разрешено, если: нет сравнимых данных к финальной дате (никогда не учитывается как успех). Резервный вариант: пороги доходов Sensor Tower или Appfigures. Ближайший предшествующий или противоречащий прогноз: собственный тренд RevenueCat (приоритет не заявлен); много приложений, оцениваемых по впечатлению, зарабатывают на рекламе, которую RevenueCat не видит |
| F11 (A) | Первые постинги с гарантом. Постинги работодателей с более чем 1000 сотрудников в области медицины, права, финансов или образования, которые упоминают подписание произведений, созданных ИИ, и личную ответственность за них. Замороженные запросы в predictions/resolve/F11.md: «дать согласие» с «сгенерировано ИИ», «ответственность за результаты ИИ», «аттестация ИИ», «гарант ИИ»; исключаются постинги, в которых «гарант» или «учетные данные» относятся к ключам или доступу. Сбылось, если найдены и архивированы как минимум 10 таких постингов как минимум от 5 работодателей. Исходное значение: на момент написания таких постингов не найдено | Проверка: 31 декабря 2027 г. Финальная дата: 31 марта 2028 г. p = 0,50; модели 0,42 (0,25–0,55). Не разрешено, если: нет сравнимых данных к финальной дате (никогда не учитывается как успех). Резервный вариант: архивированные постинги, найденные через Google Jobs и LinkedIn. Ближайший предшествующий или противоречащий прогноз: Capps (2025), «юридический гарант»; Forrester (2025): 60% компаний из Fortune 100 назначат руководителя по управлению ИИ |
| F12 (B) | Одобренные продукты находят пользователей. Собственное рандомизированное исследование: среди подходящих продуктов случайно назначенный гарант. Доля, достигающая десяти независимых пользователей в течение 90 дней. Сбылось, если доля одобренных выше, с 95% доверительным интервалом, исключающим ноль. Исходное значение: нет общедоступного исходного значения; собственное рандомизированное исследование | Проверка: 31 декабря 2027 г. Финальная дата: 31 декабря 2028 г. p = 0,42; модели 0,43 (0,30–0,60). Не разрешено, если: нет сравнимых данных к финальной дате (никогда не учитывается как успех). Резервный вариант: нет. Ближайший предшествующий или противоречащий прогноз: Hashimoto's Vouch (механизм, а не прогноз) |
| F13 (A) | Функции переходят, формы остаются. Учебные программы и посты в трёх профессиях вне сферы ИТ, закодированные двумя аналитиками с кодификатором, опубликованным перед анализом (predictions/resolve/F13-codebook.md): проверка, выбор модели по стоимости и длительные практики преподавания; личные расходы и группы модельного обучения найдены только среди опытных пользователей. Сбылось, если функциональные темы превосходят темы статуса как минимум в соотношении три к одному. Исходное значение: нет общедоступного исходного значения; два аналитика по учебным программам и постам в трёх профессиях вне сферы ИТ | Проверка: 31 декабря 2027 г. Итоговая дата: 30 июня 2028 г. p = 0.65; модели 0.69 (0.55 до 0.82). Не разрешено если: Нет сопоставимых данных на итоговую дату (никогда не считается успехом). Резервный вариант: Открытые каталоги курсов. Ближайший предыдущий или противоположный прогноз: Rogers (2003), слои внедрения (приоритет не заявлен) |
| F14 (B) | Две оси остаются отдельными. Корреляция Спирмена на уровне человека между логарифмом горизонта и логарифмом прибыли в по крайней мере 200 логах. Сбылось если корреляция 0.8 или ниже и прибыль, добавленная к горизонту, повышает R-квадрат вне выборки для проверенного выхода через шесть месяцев по крайней мере на 0.02. Базовый уровень: Нет открытого базового уровня; по крайней мере 200 логов | Проверка: 30 сентября 2027 г. Итоговая дата: 30 сентября 2028 г. p = 0.52; модели 0.49 (0.45 до 0.50). Не разрешено если: Нет сопоставимых данных на итоговую дату (никогда не считается успехом). Резервный вариант: Нет. Ближайший предыдущий или противоположный прогноз: Не найден |
| F15 (A) | Первая ступень переходит на День. В зафиксированной выборке из 200 американских объявлений начального уровня и домашних заданий в области программного обеспечения и трёх других профессий медианное первое задание, оценённое в справочных часах двумя оценщиками, находится на уровне Дня или выше. Базовый уровень: Зафиксированная выборка из 200 американских объявлений начального уровня и домашних заданий, оценённых в справочных часах двумя оценщиками | Проверка: 31 декабря 2027 г. Итоговая дата: 30 июня 2028 г. p = 0.40; модели 0.49 (0.30 до 0.70). Не разрешено если: Нет сопоставимых данных на итоговую дату (никогда не считается успехом). Резервный вариант: Примеры начального уровня Indeed Hiring Lab. Ближайший предыдущий или противоположный прогноз: Washington Monthly (2026): «роли начального уровня становятся всё более похожи на роли среднего уровня»; прогнозируемый тренд горизонта METR удваивается примерно каждые 4.2 месяца |
| F16 (A) | Первая ступень переходит на Неделю. Та же мера; медиана на уровне Недели или выше. Базовый уровень: Как F15 | Проверка: 31 декабря 2027 г. Итоговая дата: 30 июня 2028 г. p = 0.10; модели 0.14 (0.06 до 0.40). Не разрешено если: Нет сопоставимых данных на итоговую дату (никогда не считается успехом). Резервный вариант: Как F15. Ближайший предыдущий или противоположный прогноз: Kwa et al. (2025), горизонты времени машин (машины, не люди) |
| F17 (A) | Оценки заменены мерой делегированной работы. Из 50 крупнейших американских работодателей те, которые публично заменяют лестницы оценок мерой проверенной делегированной работы. Сбылось если по крайней мере 10. Базовый уровень: Нет открытого базового уровня | Проверка: 31 декабря 2028 г. Итоговая дата: 30 июня 2029 г. p = 0.05; модели 0.05 (0.02 до 0.20). Не разрешено если: Нет сопоставимых данных на итоговую дату (никогда не считается успехом). Резервный вариант: Деловые отчёты работодателей и пресса. Ближайший предыдущий или противоположный прогноз: Gartner (2024): к 2026 году 20% организаций будут использовать ИИ для уплощения структуры; Microsoft (2025): «boss agent» |
| F17b (A) | Оценки заменены: первый крупный работодатель. Из 50 крупнейших американских работодателей по крайней мере один публично заменяет лестницы оценок мерой проверенной делегированной работы. Базовый уровень: Нет открытого базового уровня | Проверка: 31 декабря 2028 г. Итоговая дата: 30 июня 2029 г. p = 0.20; модели 0.21 (0.05 до 0.50). Не разрешено если: Нет сопоставимых данных на итоговую дату (никогда не считается успехом). Резервный вариант: Деловые отчёты работодателей и пресса. Ближайший предыдущий или противоположный прогноз: Более мягкий вариант F17 |
| F18 (B) | Ступень преодолевает стаж. В данных работодателя или когорты проверенная ступень объясняет большую дисперсию в оплате труда, чем стаж работы (оценённое выполнение используется только там, где оплата недоступна, зафиксировано до анализа). Базовый уровень: Нет открытого базового уровня | Проверка: 31 декабря 2029 г. Итоговая дата: 31 декабря 2030 г. p = 0.48; модели 0.52 (0.40 до 0.60). Не разрешено если: Нет сопоставимых данных на итоговую дату (никогда не считается успехом). Резервный вариант: Опубликованная аналитика HR. Ближайший предыдущий или противоположный прогноз: Jaques (1956), оплата по объёму ответственности |
| F19 (B) | Проверка устанавливает потолок (вне выборки). По крайней мере 200 логов. Доля внимания, потраченного на проверку и горизонт, оба измеренных в месяцы 1–3; проверенный выход (принятые части в справочных часах, не формула прибыли) в месяцы 4–6. Сбылось если, на исключённых из обучения людях, доля проверки имеет более высокую частичную корреляцию с позже проверенным выходом, чем горизонт. Базовый уровень: Нет открытого базового уровня | Проверка: 30 сентября 2027 г. Итоговая дата: 30 сентября 2028 г. p = 0.45; модели 0.44 (0.30 до 0.65). Не разрешено если: Нет сопоставимых данных на итоговую дату (никогда не считается успехом). Резервный вариант: Нет. Ближайший предыдущий или противоположный прогноз: Huang et al. (2026), амплификация проверки. v1 использовал прибыль, которая содержит горизонт по конструкции; v2 предсказывает позже отдельно измеренный результат |
| F20 (B) | Опытные усиливают. Доля директив: доля ходов человека, которые дают инструкции, а не проверяют или редактируют, из логов. Проверенная прибыль: принятые справочные часы на час внимания человека. Среди людей, чья доля директив упала за шесть месяцев, проверенная прибыль в месяц 6 составляет по крайней мере 95% своего значения в месяц 0 для большинства. Базовый уровень: Нет открытого базового уровня | Проверка: 30 сентября 2027 г. Итоговая дата: 30 сентября 2028 г. p = 0.60; модели 0.62 (0.55 до 0.70). Не разрешено если: Нет сопоставимых данных на итоговую дату (никогда не считается успехом). Резервный вариант: Нет. Ближайший предыдущий или противоположный прогноз: Anthropic (2026d), кривые обучения |
| F21 (A) | Сотрудничество сохраняется. Доля совместного использования (дополнения) в выборке разговоров Claude.ai Индекса экономики Anthropic, а не в выборке API, остаётся выше 40% в каждом отчёте, опубликованном в 2027 году. Базовый уровень: Совместное использование 52% против автоматизации 45% в ноябре 2025 г. (Anthropic, 2026a) | Проверка: 31 декабря 2027 г. Итоговая дата: 30 июня 2028 г. p = 0.67; модели 0.68 (0.60 до 0.75). Не разрешено если: Нет сопоставимых данных на итоговую дату (никогда не считается успехом). Резервный вариант: Сопоставимые доли в отчётах других поставщиков. Ближайший предыдущий или противоположный прогноз: Anthropic (2026a): 52% против 45% в ноябре 2025 г. |
| F22 (A) | Треть заметных продуктов. 100 продуктов с наибольшим количеством голосов на двенадцати ежемесячных рейтингах Product Hunt 2027 года, список заморожен на 1 января 2028 г. Перечисленные создатели кодируются; продукт считается созданным без образования в области программирования, если ни один перечисленный создатель не указывает образование в области программирования или прошлую работу в области программирования (самоучки с работой в области программирования считаются программистами). Два кодировщика, слепо друг к другу. Сбылось если по крайней мере 30 из 100 квалифицируются. Базовый уровень: Manifold: программное обеспечение, кодируемое на основе интуиции, со 100 миллионами ежемесячных пользователей к концу 2026 г., около 28% | Проверка: 31 декабря 2027 г. Финальная дата: 31 декабря 2028 г. p = 0,28; модели 0,29 (0,14–0,50). Не решено, если: менее 50 из 100 продуктов имеют кодируемое утверждение или отсутствуют данные на финальную дату (никогда не считается успехом). Запасной вариант: второй замороженный рейтинг (Hacker News Show HN top 100 of 2027). Ближайший предыдущий или альтернативный прогноз: Gartner (2021); Manifold: программное обеспечение vibe-coded с 100 миллионами ежемесячных пользователей к концу 2026 года, примерно 28% |
| F23 (A) | Нет отдельной профессии в SOC 2028. Стандартная классификация профессий США на 2028 год не содержит отдельной профессии для работы, выполняемой через агентов. Исходные данные: SOC 2018 не содержит такой профессии | Проверка: Публикация SOC 2028. Финальная дата: 31 декабря 2029 г. p = 0,92; модели 0,93 (0,80–0,98). Не решено, если: нет сравнимых данных на финальную дату (никогда не считается успехом). Запасной вариант: уведомления об изменениях BLS (проверено 9 октября 2026 года: предложенная или окончательная структура еще не создана; окончательная структура ожидается в 2027 году). Ближайший предыдущий или альтернативный прогноз: Не найдено |
| F24 (A) | Первый подросток на Week в науке. Научный продукт — это программное обеспечение, набор данных или статья, используемые в опубликованном исследовании как минимум десятью не связанными между собой людьми или цитируемые как минимум в одной рецензируемой статье. Общедокументированный случай человека в возрасте до 18 лет без формального образования, научный продукт которого имеет таких пользователей и получает Week при независимой проверке. Исходные данные: На момент написания не было зарегистрировано такого случая | Проверка: 31 декабря 2030 г. Финальная дата: 31 декабря 2031 г. p = 0,23; модели 0,21 (0,02–0,45). Не решено, если: только если источники поиска недоступны; отсутствие документированного случая на финальную дату не произошло. Запасной вариант: нет. Ближайший предыдущий или альтернативный прогноз: Цель Китая по внедрению образования в области ИИ во всех школах к 2030 году (CSET, 2025) |
| F25 (A) | Доля должностей junior сокращается. Доля вакансий в области программного обеспечения в США с "junior" или "entry-level" в названии должности в 2030 году по сравнению с 2025 годом на основе одинаковых запросов. Сбудется, если снизится как минимум на треть. Исходные данные: доля вакансий в области программного обеспечения в США с "junior" или "entry-level" в названии должности в 2025 году на основе одинаковых запросов | Проверка: данные на 2030 год. Финальная дата: 31 декабря 2031 г. p = 0,55; модели 0,54 (0,45–0,60). Не решено, если: нет сравнимых данных на финальную дату (никогда не считается успехом). Запасной вариант: Indeed Hiring Lab. Ближайший предыдущий или альтернативный прогноз: Manifold: на треть меньше должностей для junior разработчиков к 2030 году, примерно 74%; разработчиков в США упадет более чем на 15% с 2023 по 2028 год, примерно 42%; рынок 0,74 (https://manifold.markets/OliverKuperman/will-the-number-of-junior-developer, 9 октября 2026 г. (вакансии junior SWE сокращаются как минимум на 33% к 1 января 2030 года; связанная, но не идентичная метрика)) |
| F26 (B) | Практика найма соответствует. Собственное аудиторское исследование: согласованные портфели проверенной работы, отличающиеся только ИТ-образованием, отправленные на реальные вакансии в двух неИТ-областях. Сбудется, если показатели обратного звонка отличаются менее чем на 3 пункта, с интервалом 95% в пределах плюс-минус 5. Исходные данные: нет общедоступных исходных данных; собственное аудиторское исследование | Проверка: 31 декабря 2028 г. Финальная дата: 31 декабря 2029 г. p = 0,35; модели 0,32 (0,25–0,35). Не решено, если: нет сравнимых данных на финальную дату или интервал, который не соответствует ни одному правилу (никогда не считается успехом). Запасной вариант: нет. Ближайший предыдущий или альтернативный прогноз: Burning Glass Institute и Harvard Business School (2024): менее одного найма из 700 изменено |
| F27 (A) | Продукты, созданные агентами, пережили прогноз Gartner. Выборка из как минимум 300 открытых продуктов, созданных в основном с помощью агентов кодирования, запущенных с октября по декабрь 2026 г., заморожена на Zenodo к 31 декабря 2026 г.; активность проверена сопроводительным скриптом. Сбудется, если менее 50% будут прекращены (недоступны или не обновлены в течение 12 месяцев) на 31 декабря 2028 г. Исходные данные: Gartner (Tyagi, 2026): 60% приложений vibe-coded прекратят работу к 2028 году | Проверка: 31 декабря 2028 г. Финальная дата: 31 марта 2029 г. p = 0,32; модели 0,35 (0,20–0,55). Не решено, если: выборка не была заморожена к 31 декабря 2026 г. (никогда не считается успехом). Запасной вариант: снимки Wayback Machine каждого продукта. Ближайший предыдущий или альтернативный прогноз: Gartner (Tyagi, 2026): 60% прекратили работу |
| F28 (A) | Машины достигают Day на уровне 80%. Горизонт времени 80% METR для лучшей публично выпущенной модели достигает 8 часов (Day) к 31 декабря 2027 г. Исходные данные: примерно 3,1 часа на уровне 80% в апреле 2026 г. (METR, 2026c; панель инструментов не обновлялась после 8 сентября 2026 г.) | Проверка: 31 декабря 2027 г. Финальная дата: 30 июня 2028 г. p = 0,80; модели 0,66 (0,55–0,80). Не решено, если: ни METR, ни запасной вариант не сообщают горизонт 80% на финальную дату (никогда не считается успехом). Запасной вариант: независимое воспроизведение метода METR (например, Epoch AI). Ближайший предыдущий или альтернативный прогноз: подогнанный тренд горизонта METR удваивается примерно каждые 4,2 месяца |
| F28b (A) | Машины достигают Week на уровне 80%. Как F28, пороговое значение 40 часов (Week). Исходные данные: как F28 | Проверка: 31 декабря 2027 г. Финальная дата: 30 июня 2028 г. p = 0,30; модели 0,20 (0,10–0,55). Не решено, если: как F28. Запасной вариант: как F28. Ближайший предыдущий или альтернативный прогноз: как F28 |
| F29 (A) | Меньше новых специалистов в области информатики. Новые специалисты с бакалавриатом в области информатики, сообщенные в опросе CRA Taulbee, опубликованном в 2028 году (академический год 2027–2028) в сравнении с опросом, опубликованным в 2026 году. Исходные данные: опрос CRA Taulbee, опубликованный в 2026 году | Проверка: отчет Taulbee 2028. Финальная дата: 31 декабря 2028 г. p = 0,69; модели 0,67 (0,50–0,75). Не решено, если: нет сравнимых данных на финальную дату (никогда не считается успехом). Запасной вариант: зачисления в NSC Research Center по специальности. Ближайший предыдущий или альтернативный прогноз: отчеты CRA о снижении набора по CS в 2025 и 2026 годах |
| F30 (A) | Агенты как соавторы в публичных коммитах. Доля событий публичного push в GH Archive, чьи сообщения коммитов содержат трейлер агента-соавтора (замороженные регулярные выражения в predictions/resolve/F30.md), сентябрь 2027 г. в сравнении с сентябрем 2026 г. Исходные данные: GH Archive, сентябрь 2026 г., измеренные и заархивированные до регистрации | Проверка: 31 октября 2027 г. Финальная дата: 31 декабря 2027 г. p = 0,55; модели 0,59 (0,40–0,75). Не решено, если: нет сравнимых данных на финальную дату (никогда не считается успехом). Запасной вариант: GitHub Innovation Graph. Ближайший предыдущий или альтернативный прогноз: не найдено |
| F31 (A) | Должности builder превосходят должности agent manager. Вакансии в США, замороженные запросы Indeed (predictions/resolve/F31.md), Q4 2027: должности семейства builder в сравнении с должностями семейства agent manager. Исходные данные: подсчеты в Q4 2026 на основе одинаковых запросов | Проверка: 31 December 2027. Финальная дата: 30 June 2028. p = 0.60; models 0.63 (0.50 to 0.74). Не разрешено, если: Нет сравнимых данных к финальной дате (никогда не считается успехом). Альтернатива: Результаты поиска LinkedIn с теми же запросами. Ближайший предыдущий или альтернативный прогноз: Srinivasan and Wei (2026): "agent manager" — стандартное название в течение 12–18 месяцев |
| F32 (A) | Поставщик говорит, что большинство пользователей его инструмента кодирования — не разработчики. Поставщик инструмента кодирования, созданного Anthropic, OpenAI, Google или GitHub, публично сообщает, что люди, не являющиеся разработчиками программного обеспечения, составляют большинство еженедельных пользователей этого инструмента. Базовое значение: На момент написания такого отчёта не было | Проверка: 31 December 2027. Финальная дата: 31 March 2028. p = 0.40; models 0.31 (0.13 to 0.70). Не разрешено, если: Нет сравнимых данных к финальной дате (никогда не считается успехом). Альтернатива: Экономические отчёты или отчёты об использовании поставщиков. Ближайший предыдущий или альтернативный прогноз: Поставщики конструкторов приложений (Lovable, Replit) уже описывают большей частью пользователей, не являющихся разработчиками; в данном случае это касается общих инструментов кодирования |
| F33 (A) | Уровень машинной безопасности остаётся низким. Доля образцов кода, созданного ИИ, которые проходят тесты безопасности в отчёте компании Veracode о безопасности кода при использовании генеративного ИИ. Базовое значение: 56% успешных результатов, застопорилось (Veracode, 2026) | Проверка: отчёт Veracode 2028. Финальная дата: 31 December 2028. p = 0.70; models 0.67 (0.57 to 0.80). Не разрешено, если: Нет сравнимых данных к финальной дате (никогда не считается успехом). Альтернатива: Независимое сравнительное тестирование безопасности сгенерированного кода. Ближайший предыдущий или альтернативный прогноз: Veracode: отсутствие улучшения безопасности при использовании новых моделей |
| F34 (B) | Эталонные часы воспроизводимы. Две независимые группы из трёх экспертов оценивают эталонные часы для одних и тех же 50 задач; внутриклассовая корреляция (двусторонняя, абсолютное согласие) логарифмированных часов. Базовое значение: Предварительное тестирование пороговых значений (Appendix E) | Проверка: 30 June 2027. Финальная дата: 31 December 2027. p = 0.65; models 0.65 (0.40 to 0.75). Не разрешено, если: Нет сравнимых данных к финальной дате или интервал, который не соответствует ни одному правилу (никогда не считается успехом). Альтернатива: Нет. Ближайший предыдущий или альтернативный прогноз: Базовые показатели человека в METR (машины, не люди) |
| F35 (B) | Временной горизонт прогнозирует более поздний результат. Как минимум 200 записей: горизонт в месяце 0, добавленный к трудовому стажу и IT-образованию, повышает внесэмпловое R² для верифицированного результата в период месяцев 4–6. Базовое значение: Нет публичного базового значения | Проверка: 30 September 2027. Финальная дата: 30 September 2028. p = 0.60; models 0.58 (0.45 to 0.70). Не разрешено, если: Нет сравнимых данных к финальной дате (никогда не считается успехом). Альтернатива: Нет. Ближайший предыдущий или альтернативный прогноз: Burning Glass Institute и Harvard Business School (2024) |
| F36 (A) | Платформы добавляют значок для проверённых разработчиков. Как минимум две из платформ Upwork, Fiverr, GitHub, Product Hunt, Toptal и Contra вводят публичный значок или поле профиля, подтверждающее независимо проверённую работу, созданную ИИ (не тест навыков). Базовое значение: На момент написания такого значка не было | Проверка: 31 December 2027. Финальная дата: 31 March 2028. p = 0.23; models 0.24 (0.07 to 0.70). Не разрешено, если: Нет сравнимых данных к финальной дате (никогда не считается успехом). Альтернатива: Справочные страницы платформ и архивные объявления. Ближайший предыдущий или альтернативный прогноз: Ничего не найдено |
Примечание: Набор A разрешается на основе публичных данных; Набор B на основе отдельно зарегистрированных исследований (протокол к 30 June 2027, иначе не проводится, что результирующая таблица считает отказом программы тестирования). p зависит от результата. Модели: геометрическое среднее коэффициентов независимых экспертов-прогнозистов, которые не видели мои числа, с их диапазоном; индивидуальные прогнозы в predictions/m2-probabilities.csv. Правила «произошло» и «не произошло» для каждой строки находятся в predictions/predictions.csv. В строках F4a и F4b прогноз Gartner цитируется в том же виде, как его цитирует список литературы, через резюме Tray.ai (2026) с использованием его собственных слов в кавычках; зарегистрированный файл содержит тот же прогноз и те же числа более кратко и ссылается на Gartner (Tyagi, 2026).
Приложение E. Настольное тестирование пороговых значений
В этом приложении рассматривается настольное тестирование правил из Раздела 5.2, проведённое 9 октября 2026 года методом моделирования и с участием модельных оценивающих, и описывается протокол калибровки, определяющий следующую версию. Все значения получены с помощью двух скриптов в сопровождающем репозитории (pilot/), которые вызывают оценивающую функцию из Приложения C без изменений и заменяют только её константы.
E1. С какой частотой получается уровень
Для человека, чьи работы проходят независимо с истинной вероятностью p, Таблица E1 приводит вероятность получения каждого уровня с ровно минимальным количеством работ в окне. Значения представляют собой точные биномиальные вероятности; прямое моделирование методом Монте-Карло через horizon.py с работами, распределёнными по окну, внесённой ошибкой и последней работой на месте, совпадает с точностью до 0,01.
Таблица E1. Вероятность получения уровня по истинной вероятности успеха.
| Правило | p = 0.95 | p = 0.9 | p = 0.8 | p = 0.7 | p = 0.6 |
|---|---|---|---|---|---|
| День и Час, 8 из 10 за 91 день | 0.99 | 0.93 | 0.68 | 0.38 | 0.17 |
| Неделя, 5 из 6 за 182 дня | 0.97 | 0.89 | 0.66 | 0.42 | 0.23 |
| Месяц, первая версия, 4 из 4 за 365 дней | 0.81 | 0.66 | 0.41 | 0.24 | 0.13 |
| Месяц, текущая версия, 5 из 6 за 365 дней | 0.97 | 0.89 | 0.66 | 0.42 | 0.23 |
| Квартал, 3 из 3 за 365 дней | 0.86 | 0.73 | 0.51 | 0.34 | 0.22 |
Примечание: правило является правилом квалификации. Эти вероятности описывают правило, а не какого-либо конкретного человека.
Далее следуют три результата. Во-первых, первая версия была неупорядочена: Месяц при четырёх из четырёх был сложнее получить, чем Квартал при каждом p. Количество четыре из пяти обратило бы ошибку, делая Месяц легче, чем День и Неделя при p = 0,8 (0,74), поэтому Месяц теперь требует пять из шести в год, около 960 эталонных часов вместо 640. С этим День, Неделя, Месяц и Квартал упорядочены от самого простого к самому сложному для каждого p 0,77 и выше, диапазон, где квалификация имеет значение. Ниже 0,76 Неделя немного легче, чем День (0,42 против 0,38 при p = 0,7). Оба затем отклоняются большую часть времени, и это указывается и остаётся без изменений. Никакое количество из трёх или более работ не может быть упорядочено относительно трёх из трёх при каждом p, потому что кривые пересекаются. Во-вторых, результат зашумлён: при p = 0,8 тот же результат повторяется в следующем окне для 56% окон на День, 55% на Неделю и Месяц и 50% на Квартал. Поэтому запись выводит количество рядом с уровнем (\"День (8/10)\"), и отчёт может отметить уровень как стабильный, если он сохранялся и в предыдущем окне. При p = 0,8 День, сохранённый в двух окнах подряд, происходит в 46% случаев, поэтому стабильность — это метка, а не требование. В-третьих, надёжный человек всё равно может не достичь: при p = 0,95 Квартал не получается в 14% лет, что является ценой уровня, основанного на трёх работах.
На рисунке A2, панель A, показана зависимость этих вероятностей от p для правил v1.1.
E2. Чувствительность к количеству и доле
Статья обещала сообщить, сколько людей изменяют уровень, когда количество переходит от десяти к восьми или двенадцати, а доля с 0,8 на 0,7 или 0,9. Ответ даётся для 10 000 смоделированных логов на День, каждый с количеством работ дневного размера в окне от 6 до 16 и истинной вероятностью успеха, равномерно распределённой между 0,5 и 1,0. Текущее правило (десять, 0,8) даёт День 30% из них, а Таблица E2 приводит долю, чей результат меняется при других правилах.
Таблица E2. Доля смоделированных логов, чей результат для Дня меняется относительно десяти работ и доли 0,8.
| Минимальное количество | Доля 0.7 | Доля 0.8 | Доля 0.9 |
|---|---|---|---|
| 8 | 22% | 8% | 15% |
| 10 | 10% | 0% | 11% |
| 12 | 16% | 9% | 17% |
Примечание: совокупность логов является предположением симуляции. Полевое исследование E5 повторяет этот анализ на реальных логах.
Смещение одной константы на один шаг изменяет примерно один результат из десяти. Смещение обеих констант изменяет до одного из пяти. Доля имеет большее значение, чем количество.
E3. Шум оценивающих на краю уровня
Если два оценивающих являются несмещёнными и 80% их пар находятся в пределах отношения 1,5, выше критерия 70% в Разделе 5.8, а эталоном является среднее геометрическое их двух оценок, то работа с истинным размером 7 эталонных часов оценивается как размер День в 20% случаев, а работа из 9 часов не достигает размера День в 23% случаев. Вот почему запись выводит медианный принятый размер рядом с уровнем (Таблица 3): горизонт, построенный на работах чуть выше порога, показывает это.
E4. Модельные оценивающие эталонных часов
Четыре языковых модели из четырёх семейств (Anthropic, OpenAI, Google и Moonshot), каждая работающая отдельно и слепо по отношению друг к другу и к любым опубликованным временам, оценили эталонные часы 44 задач 9 октября 2026 года. Тридцать были задачами новой базы в трёх низкорисковых областях (бухгалтерия для малого бизнеса, небольшие внутренние веб-инструменты, юридические и маркетинговые документы), каждая с письменным определением готовности и скрытой проверкой. Четырнадцать были открытыми задачами из данных горизонта времени METR (METR, 2026d) с измеренными исходными временами человека от 12 минут до 14,6 часов, переданными оценивающим только по их открытому идентификатору. Таблица E3 приводит результаты.
Таблица E3. Согласованность и точность четырёх слепых модельных оценивающих.
| Метрика | База из 30 задач (определение готовности) | 14 задач с измеренными временами (только идентификатор) |
|---|---|---|
| Пары оценок в пределах отношения 1,5 (6 пар оценивающих) | 62% (от 27% до 97% по парам) | 35% |
| Внутриклассовая корреляция ICC(2,1), часы в логарифме | 0.89 | 0.60 |
| Все четыре оценивающих определяют задачу на одном уровне размера | 60% | 36% |
| Среднее значение четырёх в пределах 1,5 от измеренного времени | не измерено | 21% (3 из 14) |
| Среднее значение четырёх в пределах 2 от измеренного времени | не измерено | 43% (6 из 14) |
Примечание: модельные эксперты заменяют двух человеческих экспертов из раздела 5.1 и не являются свидетельством об них.
При наличии полного отчёта о завершении модели согласились относительно того, какие задачи были более крупными, но не относительно уровня: геометрическое среднее оценок одного эксперта по банку составило 5,1 часа, а другого 10,4. Постоянное смещение такого рода — это наиболее дешевая ошибка для исправления, именно поэтому эксперты в полевом исследовании сначала калибруются на задачах с вручную измеренными временами. Имея только идентификатор, оценки были малополезны, что поддерживает использование замороженного банка с вручную измеренными временами (раздел 5.1) вместо оценок, сделанных по названию. По правилу таблицы 3, где разногласие выше 1,5 отправляет задачу третьему эксперту, два таких эксперта отправили бы примерно четыре задачи из десяти третьему.
Рисунок A2. Правило уровня на столе: вероятность получить уровень и степень согласия модельных экспертов по часам.
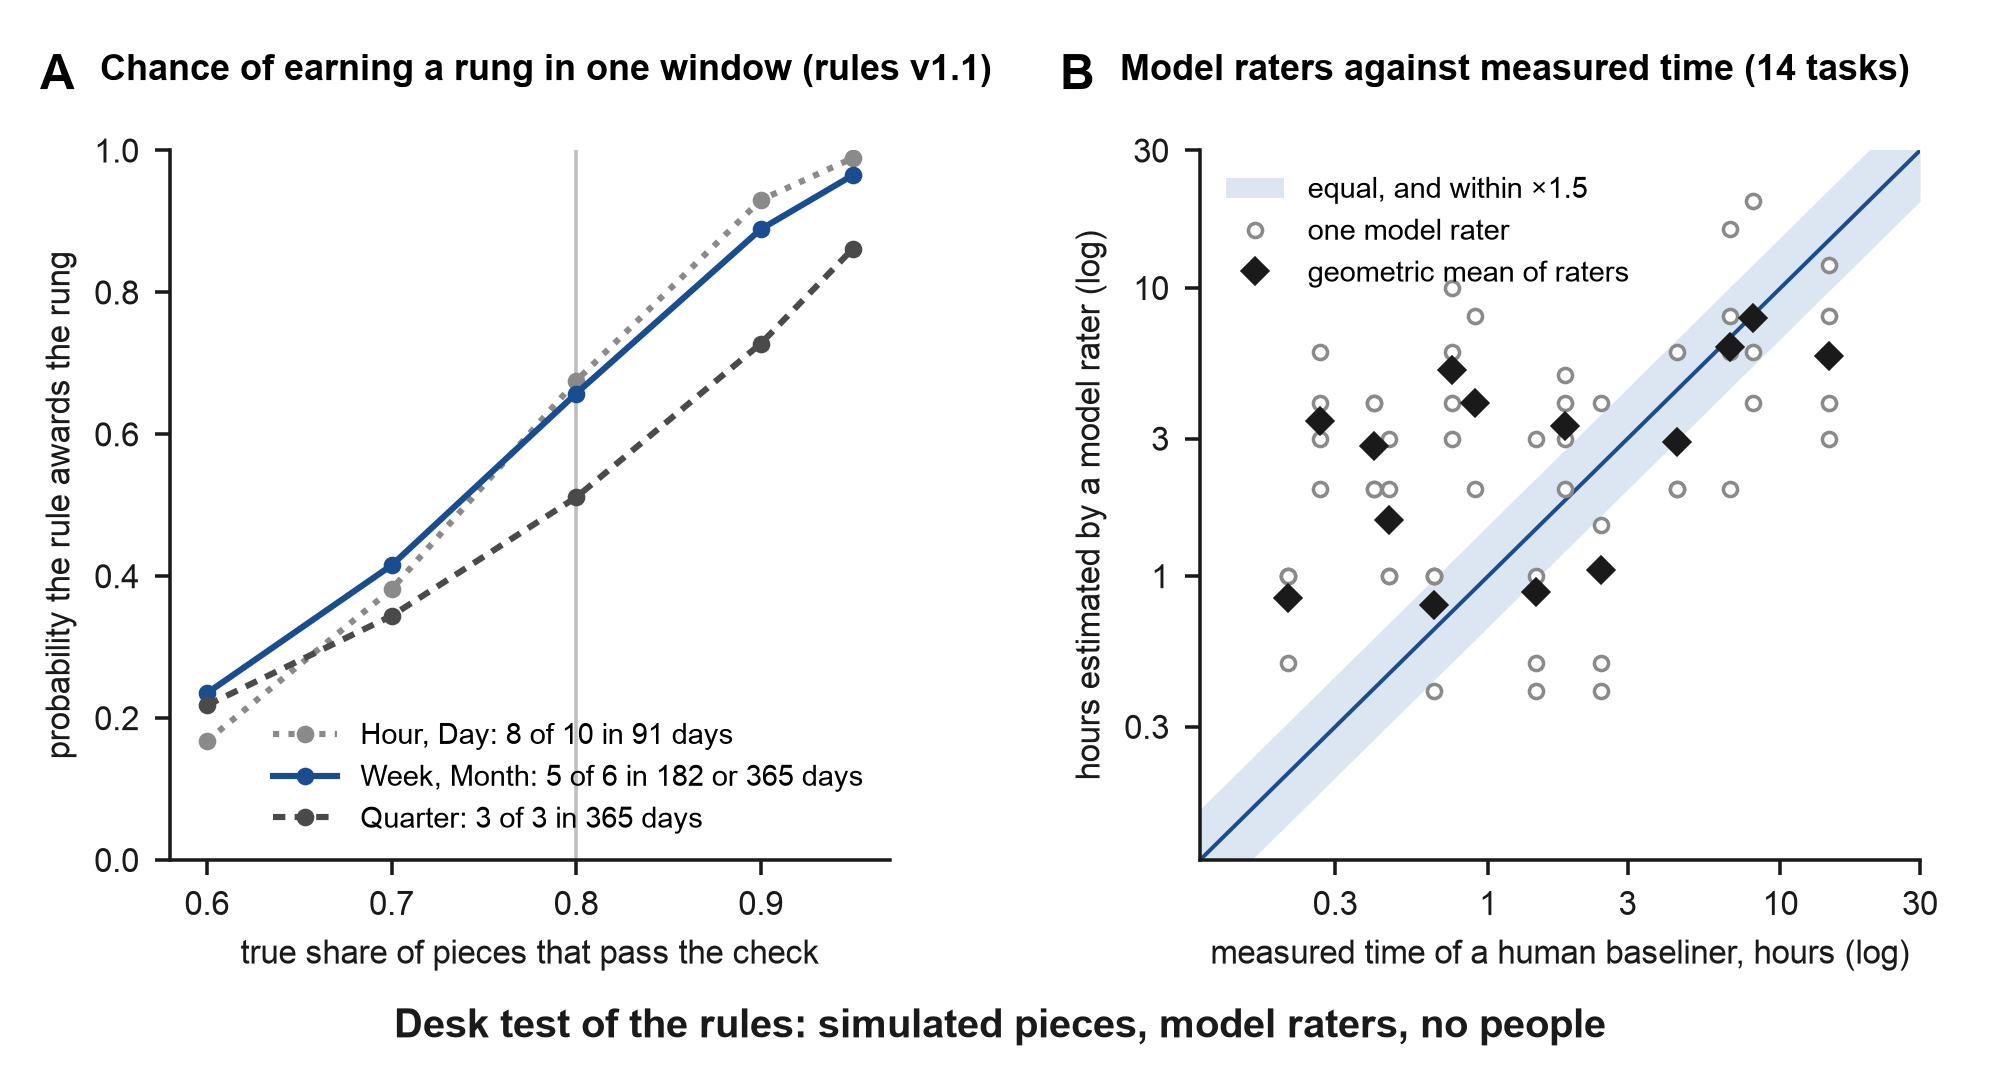
Примечание: настольное тестирование с симулированными задачами и модельными экспертами. Панель A показывает для каждого уровня по правилам v1.1 вероятность того, что правило присваивает уровень в одном окне, когда каждая задача проходит её проверку независимо с долей на горизонтальной оси. Уровни с одинаковым количеством и одинаковым числом пройденных проверок следуют одной кривой. Панель B устанавливает эталонные часы, которые четыре модельных эксперта, каждый из другого семейства, оценили для 14 задач в сравнении с временем, измеренным человеком (данные задач METR). Полоса обозначает согласие в пределах коэффициента 1,5. Настольное тестирование, которое дало обе панели, описано в этом приложении, а его код и результаты находятся в сопроводительном репозитории.
E5. Протокол калибровки
Протокол и текст регистрации находятся в сопроводительном репозитории (pilot/pilot-protocol.md, pilot/preregistration-draft.md). Кратко: в исследовании участвуют 60 взрослых, 30 с опытом в области программного обеспечения и 30 без, в трёх областях банка, в течение двух окон по 91 дню. Все используют одинаковые инструменты агента с зафиксированными версиями, а проверки представляют собой скрытые тесты или двух слепых рецензентов домена. Вручную измеренные времена записываются для одной пятой задач банка, каждая передача регистрируется с датой её начала, и одна десятая принятых задач проверяется. Критерии устанавливаются до получения данных: по крайней мере 70% пар человеческих оценок в пределах 1,5, по крайней мере 60% оценённых часов в пределах 1,5 от измеренных, повторяемость уровня в двух окнах со взвешенной каппой не менее 0,6, предсказание прохождения новых задач с AUC не менее 0,7, потеряно менее 5% строк журнала и записано по крайней мере 95% неудавшихся передач. Форма согласия написана только для этого исследования и не переиспользует другое согласие. Месячные и квартальные работы, необратимая работа и высокорисковые области находятся вне этого шестимесячного полевого исследования.
E6. Что устанавливает настольное тестирование и что дальше
Это показывает, как правила ведут себя для человека известной надёжности, где они были непоследовательны (одна непоследовательность теперь исправлена), насколько чувствителен вердикт к двум константам и что модельные эксперты упорядочивают задачи последовательно, но расходятся в уровне. Протокол калибровки E5 переходит к тому, что настольное тестирование оставляет людям: как они ведут себя в соответствии с правилами, повторяется ли уровень для реального человека и предсказывает ли он новую работу; согласие между человеческими экспертами проверяется первым (Приложение G). Пороги, таким образом, протестированы на столе как правила v1.1, и исследование калибровки устанавливает следующую версию.
Для воспроизведения: python3 pilot/simulate_rules.py и python3 pilot/rater_agreement.py pilot/results/model-ratings.csv pilot/metr-anchor-tasks.csv (Python 3.9 или позже, только стандартная библиотека; seed 20261009).
Приложение F. Дополнительные таблицы и рисунки
Объекты с номерами A1, A2 и так далее — объекты приложения. На них ссылаются из разделов, указанных в каждом примечании.
Таблица A1. Сигналы сходимости, 2025 — октябрь 2026 г.
| Сигнал | Источник и дата | Что это показывает | Что это не показывает |
|---|---|---|---|
| Работа разработчика описана как делегирование и проверка | GitHub, 8 декабря 2025 г. | Описание поставщиком роли изменилось | Что уровень разработчиков измеряется именно таким образом |
| Лица, не являющиеся разработчиками, в кодирующем агенте выросли в 137 раз (физические лица) и в 189 раз (организации) | OpenAI, июнь 2026 г. | Быстрый рост с низкой базы; четверть опрошенных пользователей сделала по крайней мере один запрос, оцененный в более чем 8 часов | Качество их результатов; данные поставщика |
| Десять крупнейших профессий, находящихся в пределах 7 пунктов от профессий программирования, в подтвержденном успехе на сеансах создания кода | Anthropic, 16 июня 2026 г. | Небольшой разрыв между профессиями; успех подтвержден доказательствами, такими как тесты или коммиты; опыт оценивается по поведению | Образование (профессия — это не степень); качество доставленных продуктов |
| Адвокаты создают свои собственные инструменты; широкий доступ к ИИ 83% против 61% | Bloomberg Law, 20 апреля 2026 г. | Специалисты в области создают, не покупают | Как долго эти инструменты поддерживаются |
| Лестница переименована примерно для 181 500 сотрудников | Business Insider и Fortune, 22 января 2026 г. | Работодатели меняют должности | Новая мера (внутренние уровни сохранены) |
| «Frontier Professionals»: 3 233 из 20 000 пользователей ИИ | Microsoft, 5 мая 2026 г. | Сегмент опроса продвинутых пользователей | Роль или оценка |
| 16 541 публикация, упоминающая агентский ИИ в 2025 г. (151 в 2024 г.) | Stanford AI Index 2026 | Спрос на навык в публикациях | Новые профессии |
| Найм на должности начального уровня упал больше, чем в целом | LinkedIn Economic Graph, август 2026 г. | Более слабая начальная ступень в середине 2026 г. | Что это вызвано ИИ (LinkedIn указывает на экономику) |
| Новые специальности CS снизились на 13% в факультетах, предоставляющих степени PhD | CRA Taulbee, июнь 2026 г. | Студенты реагируют | Долгосрочный тренд; все учреждения |
| Использование ИИ обсуждалось в 4,54% интервью во 2-м квартале 2026 г. (0,33% в 3-м квартале 2025 г.) | Metaview, 2026 | Вопрос вошел в наем | Шкала для ответа |
Примечание: Данные поставщика отмечены как таковые. Старые сравнения (с 2019 или 2022) опущены по правилу (Раздел 1).
Таблица A2. Названия в обращении и предложенные названия по слоям на 9 октября 2026 г. Часть 1: названия в использовании с их владельцами и статусом. Часть 2: названия, предложенные в этом исследовании, простые описания и рассмотренные варианты.
| Слой | Кандидат | Представлено кем и когда (часть 1) | Смысл, в котором это используется | За | Против |
|---|---|---|---|---|---|
| Часть 1 | |||||
| Массовый навык | builder, Full Stack Builder | LinkedIn, декабрь 2025 г. (сообщается); «теперь все — строители» (SF Standard, 2026) | Каждый, кто создает, из любой функции | Уже побеждает в HR | Не говорит ничего об уровне |
| Массовый навык | vibe coding, vibe coder | Karpathy, 2 февраля 2025 г. | Создание без чтения кода | Широко известно | Издевательство; обозначает дно |
| Массовый навык | AI fluency (четыре D) | Anthropic, 2025b | Делегирование, описание, различение, добросовестность | Охватывает область | Компетенции без уровней |
| Массовый навык | agent literacy | MindStudio, 11 июня 2026 г. | Делегировать, проверить, управлять | Близко по смыслу | Занято; нет стандарта доказательства |
| Профессия | agentic engineer | Karpathy, февраль 2026; Alenezi, июнь 2026 | Инженер, который руководит агентами | Слово инженеров 2026 г. | Связано с инженерией |
| Профессия | agent boss | Microsoft, 23 апреля 2025 г. | Каждый сотрудник, который управляет агентами | Запоминающийся | Лозунг без меры |
| Профессия | agent manager | Arion Research, 7 февраля 2026; Srinivasan и Wei, Harvard Business Review, 12 февраля 2026 | Роль, которая запускает агентов в команде | Сообщается как фаворит (aicodex, 2026); его авторы ожидают, что это станет стандартным названием в течение 12–18 месяцев | Название горизонтального менеджера (Раздел 6.3) |
| Профессия | AI Agent Owner; AI Agent Supervisor | Writer, 2026; Digg discussion, 2026 | Лицо, ответственное за развернутого агента | Обозначает собственность | Использование отдельного поставщика или форума |
| Профессия | AI orchestrator | St. Lawrence, семинар 2024 и книга 2025; 739 публикаций в феврале 2026 г. (IT Brew, 2026) | Специалист по бизнесу, координирующий ИИ | В публикациях | Занято много раз; горизонтальное |
| Профессия | AI Operator | Dust, 7 октября 2026 г. | Создает и поддерживает общие рабочие процессы агента | Знакомо | Звучит как консоль; в Anthropic «оператор» — это компания, разрабатывающая на API (Anthropic, 2026b) |
| Профессия | AI steward, AI work architect | Ono, World Economic Forum, 22 июня 2026 г. | Один устанавливает границы работы ИИ, другой проверяет последствия | Ближайший предшественник по смыслу | Две роли, нет меры |
| Профессия | product creator | Cagan, SVPG, 2025 | Один человек, который несет продукт от идеи к рынку | Язык продукта | Занято; нет меры |
| Профессия | Product Principal | O'Neill, пост LinkedIn, 2026 | Устанавливает цели для агентов, принимает и отвечает за результат | Почти смысл этой статьи | Занято в этом смысле; цитируют как прецедент |
| Профессия | Principal Agentic Context Engineer | Должность, собранная Turkovic, 24 апреля 2026 г. | Ранг старшинства в работе агента | Показывает, что «principal» уже используется как оценка | Оценка, не профессия |
| Профессия | AI Product Builder; Agentic Product Builder | n8n posting, 2026; State Street posting, 2026 | Требуется опыт построения продуктов и практика верификации; кодирование предпочтительно (n8n) или требуется (State Street) | Показывает, как работодатели меняют требование к кодированию в обе стороны | Названия отдельных работодателей |
| Профессия | Аттестованный архитектор финансового интеллекта | Clark, SSRN, 2026 | Профессия, названная по одной отрасли | Показывает выпуск названий, привязанных к конкретной сфере | Одно предложение, одна отрасль |
| Профессия | доверитель | Теория агентских отношений (Jensen & Meckling, 1976); "principals" в конституции Claude (Anthropic, 2026b); The Principal Firm (Verheul, 2026); подход principal-agent для агентов ИИ (Berkeley California Management Review, 2025; Tikhomirov, 2026) | Сторона, от имени которой действует агент и которая несет расходы на проверку | Теория, лежащая в основе; соответствует слову "agent" | "Agent principal" в управлении идентификацией и доступом означает собственную идентификацию агента, противоположное значение; также ранг Principal Engineer |
| Мера | горизонт делегирования (в значении для машины или фирмы) | Khadj, 2026 (более ранняя версия содержала "Delegation Horizon Index", от 0 до 100); Alonso, 2026 ("горизонт делегирования" для цепочек работы) | Насколько далеко машина или фирма могут делегировать до того, как должен вмешаться человек | Показывает, что фраза естественна | Машина или фирма, не человек |
| Мера | улучшение; ускорение; автономность 1 к 5; H1 к H5; надзорный потенциал | METR, 2025; Anthropic Economic Index, 2025-2026; Shao et al., 2025; em360, 2026 | Средние приросты, ускорение на уровне разговора, автономность агента, предпочтительное участие человека, полезный результат на единицу затрат | Установленные смежные понятия с усилением прироста | Измеряет задачи, разговоры или инструменты, а не верифицированный результат человека |
| Момент | время пересечения | Геометрия обучения при делегировании ИИ (2026) | Момент, после которого затраты на делегирование ИИ из-за потери навыков превышают полученный выигрыш | Близка по форме | Противоположное значение: потеря навыков, не важность учетных данных |
| Партнер | гарант | "Юридический гарант" в Capps (2025), New York Times Magazine | Обеспечивает ответственность, которую не может нести ИИ | Точно | Юридическая окраска |
| Партнер | завершитель; инженер распределения; инженер GTM | Инженер GTM в объявлениях, 2026 | Доносит продукт до людей | Оплачивается сегодня | Частично может быть автоматизирован (Раздел 7) |
| Ложный сигнал | tokenmaxxing | Использование в прессе, 2026 (CIO, 2026a) | Ранжирование или конкуренция по потребленным токенам | Называет реальную практику | Не профессия (Раздел 4) |
| Старые названия | citizen developer; инженерия программного обеспечения конечного пользователя; Code Runner, Adaptor, Writer, Builder | Gartner, к 2009; Ko et al., 2011; Feldman & Anderson, 2024 | Разработка вне отдела IT; конечные пользователи, сталкивающиеся с инженерными задачами | Долгая история | Привязано к одной стороне старого разделения |
| Часть 2 | Кандидат | Статус | Значение | За | Против |
| Массовый навык | грамотность принятия | Предложено здесь; использование не найдено в базах Приложения B | Сказать заранее, что считается готовым, а затем показать это | Называет суть | Навык, не человек; должен отличаться от исследования принятия технологии |
| Профессия | agentwright | Предложено здесь; использование не найдено в базах Приложения B | Тот, кто выполняет работу через агентов, как драматург пишет пьесу | Свободен в научных базах; несет авторство | Поисковые системы разбивают его на "Agent Wright"; звучит как инструмент тестирования браузера; частично занято к октябрю 2026 (пакет Python и каталог навыков агентов), поэтому потребует уточнения |
| Профессия | оркестратор предметной области (оркестратор в сфере права, оркестратор финтеха) | Предложено в более ранней версии этого исследования | Человек с глубокими знаниями предметной области, который собирает системы агентов для этой области | Связывает роль с вертикалью (Раздел 6.3) | "Multi-domain orchestrator" — это уже признанный термин в управлении сетями 5G и 6G |
| Профессия | устанавливающий-принимающий; директор агента | Простые описания | Устанавливает задачу и принимает результат | Точно | Описание, а не название; "директор" — это управленческий ранг |
| Профессия | Agent-Directed Product Creator; Agentic Product Builder; Agentic Work Steward; Agentic Work Producer; Outcome Author; Outcome Architect; agent conductor | Варианты, созданные при консультациях моделей в этом исследовании | Вариации авторства и управления работой агента | Показывают пространство вариантов | Длинные или похожи на уже занятые названия (steward, creator, architect) |
| Лестница профессий | Specifier, Verifier, Domain Orchestrator; setter, acceptor, coordinator, loop owner | Ранние версии лестниц этого исследования | Ступени растущей ответственности за работу агента | Удобочитаемо | Заменены на ступени в часах, которые не нуждаются в переводе между профессиями |
| Мера | верифицированный горизонт делегирования (также: личный или человеческий горизонт делегирования) | Предложено здесь | Самый большой проверенный объем работы, который человек передает агентам | Основано на Jaques и METR | Должно быть отличимо от машинного и корпоративного значения в части 1 |
| Мера | выигрыш от усиления | Предложено здесь | Верифицированный объем работ на час внимания | Признает коротких-цикловых разработчиков | Требует зафиксированный справочник |
| Момент | точка пересечения учетных данных | Предложено здесь; использование не найдено в базах Приложения B | Когда результаты людей без IT образования начинают превосходить результаты программистов при одних и тех же проверках, и сертификаты теряют значение | Наблюдается в частях (Раздел 6.2) | "Credential" в безопасности агента также означает тайный ключ; определить при первом использовании |
| Момент | Точка инверсии навыков; Точка нейтральности фона; точка пересечения экспертизы; разделение учетных данных | Рассмотренные варианты | Один и тот же момент, рассматриваемый со стороны навыков, фона, экспертизы или учетных данных | Каждый выделяет один аспект | Каждый охватывает только один из компонентов Раздела 6.2 |
| Партнер | совладелец подписи; брокер доверия; доверитель распределения | Рассмотренные варианты | Партнер, который подписывает или несет продукт | Простой | Уже, чем гарант или завершитель |
| Неудавшийся сигнал | старшинство токенов (токены как ранг) | Термин, используемый здесь для эпизода 2026 года | Классификация людей по потреблённым токенам | Называет реальное событие | Не профессия (раздел 4) |
Примечание: Статус отражает поиски в интернете и базах данных 8 и 9 октября 2026 г. (Приложение B). «Использование не обнаружено» относится к базам, перечисленным там на эти даты, и ничего не утверждает о базах, которые не проверялись. Варианты в части 2 поступают из собственных черновиков исследования и перечислены так, чтобы семейство вариантов оставалось видимым.
Таблица A3. Шкалы 2025 и 2026 годов и что каждая из них измеряет (полный список).
| Шкала | Источник | Измеряемая единица | Измеряет ли человека по проверенной делегированной работе? |
|---|---|---|---|
| Уровни автономии агентов ИИ (от оператора к наблюдателю) | Feng et al., 2025 | Агент | Нет |
| Пять уровней, от автозаполнения к фабрике программного обеспечения | Shapiro, January 2026 | Машина или установка команды | Нет |
| Восемь этапов разработки с помощью ИИ | Yegge, 2026 | Практика программиста по количеству агентов | Нет |
| Лестница возможностей (от триггера к команде агентов) | Memari & Rudolph, 2026 | Автоматизация работы | Нет |
| Семь этапов надзора над кодирующими агентами | Park et al., 2026 | Этапы работы по надзору | Нет |
| Пять уровней делегирования в разработке (AIDEs) | JetBrains Research (Tikhomirov), September 2026 | Делегирование разработчика, сформулированное как отношение принципала и агента | Только разработчики; нет правила проверки |
| Уровни делегирования ИИ при принятии решений | Dawson, 2026; Metal Toad, 2026 | Делегирование организации или менеджера | Нет |
| Разумное делегирование ИИ | Tomašev et al. (DeepMind), February 2026 | Делегирование в целом | Нет меры на уровне человека |
| Граница делегирования (ранняя версия: Индекс горизонта делегирования, 0–100) | Khadj, 2026 | Делегирование фирмы или агента | Нет (машины и фирмы) |
| Автор, редактор, директор, оркестратор | Microsoft, May 2026 | Паттерны работы | Нет |
| Рамка компетентности ИИ (восемь областей, четыре уровня) | AI Certification Standards, 23 August 2026 | Компетентности в разных профессиях | Нет экзамена или пороговых значений |
| Грамотность в ИИ (четыре Д) | Anthropic, 2025b | Грамотность | Нет уровней |
| Горизонт времени машины | METR, 2025-2026 | Модель | Нет (только машины) |
| Проверенный горизонт делегирования и коэффициент усиления | This paper | Человек в области | Да, по правилу раздела 5.2 |
Примечание: «Измеряет человека по проверенной делегированной работе» означает, что шкала размещает человека на уровне в соответствии с объёмом работы, переданной агентам и подтверждённой проверкой, которую агенты не видели. Уровни JetBrains касаются того, сколько разработчики делегируют, и они уже используют язык принципала и агента. Они ближайший сосед, и им не хватает правила независимости для проверок и единицы размера.
Таблица A4. Сложные случаи и как их обрабатывают правила.
| Случай | Обработка |
|---|---|
| Работа, которую человек никогда не смог бы выполнить вручную | Эталонные часы по-прежнему берутся от квалифицированного специалиста; собственный навык человека не учитывается |
| Работа, качество которой проявляется только спустя месяцы | Принято условно; отложенный результат записывается при его поступлении и может отменить работу |
| Область без квалифицированного человеческого рецензента поблизости | Скрытые тесты или реальное использование предполагаемыми пользователями; модель другого семейства только с источниками, открытыми человеком |
| Слепой критик из того же семейства моделей в новом контексте | Не независимая проверка: записывается как same_family (Приложение C), не приносит кредит, хотя может улучшить работу перед независимой проверкой (раздел 6.5) |
| Команда, которая вместе принимает работу | Каждый человек записывает своё внимание; работа считается для человека, подписавшего принятие |
| Работа, которая проходит проверку, но позже оказывается неправильной | Записывается как неудавшаяся при следующей повторной проверке, и ступень переоценивается |
| Необратимая работа, смешанная с обычной работой | Более строгое правило применяется только к необратимым работам (раздел 5.2) |
Таблица A5. Темы в потоках разработчиков и их аналоги в других профессиях, 2025-2026 (иллюстративные примеры).
| Тема в потоках | Аналог вне программного обеспечения | Источник | Пересекалось? |
|---|---|---|---|
| Кто виноват в плохом выводе, модель или тот, кто установил задачу | «Workslop»: вывод ИИ, который перекладывает работу на её получателя, около двух часов на инцидент и $186 на сотрудника в месяц; коллеги судят его отправителей менее способными | The Decoder (2025); BetterUp (2026) | Да, сильно |
| Цена проверки ($150 в час на рецензирование) | Та же стоимость workslop | The Decoder (2025) | Да |
| Сильная модель планирует и рецензирует, дешёвые модели выполняют работу | Бюджеты ИИ, выделенные по ролям в Atlassian | HCA Magazine (2026) | В компаниях |
| Перегрузка, постоянное изменение инструментов, страх упустить что-то | «Мозг ИИ перегорает» сообщили 25-26% маркетологов, 19% в HR, 17% в сфере программного обеспечения | Search Engine Journal (2026) | Да, более сильно вне IT |
| Собственные инструменты вместо купленного программного обеспечения | Адвокаты создают инструменты с агентами; 35% опрошенных предприятий заменяют некоторое купленное программное обеспечение на своё (выборка поставщика) | Artificial Lawyer (2026); Bloomberg Law (2026); Retool (2026) | В верхнем слое |
| Сравнение агентов | Бухгалтеры сравнивают двух кодирующих агентов | Growthy (2026) | Да |
| Перемещение компании на агентов без программистов | Адвокаты и фирмы создают с агентами вместо поставщиков | Bloomberg Law (2026); Artificial Lawyer (2026) | Частично; консалтинговый бизнес виден только в цепочке сообщений |
| Личный счёт за ИИ свыше $1 000 в месяц как маркер статуса | Аналога статуса не найдено; ближайшие — корпоративные лимиты и надбавки (лимит $1 500 в месяц у Uber, кошельки ИИ у Atlassian) | Fortune (2026b); HCA Magazine (2026); поиск от 9 октября 2026 г. | Нет как статус; да как строка бюджета |
| Принадлежность к лагерю одного агента | Аналога не найдено | Поиск от 9 октября 2026 г. | Нет, и не требуется |
Примечание: Цепочки сообщений — это качественные свидетельства, отобранные по темам и не представляющие генеральную совокупность. «Crossed over» фиксирует, был ли найден аналог в перечисленных источниках на 9 октября 2026 г.
Figure A3. Горизонты машин в масштабе ступеней.
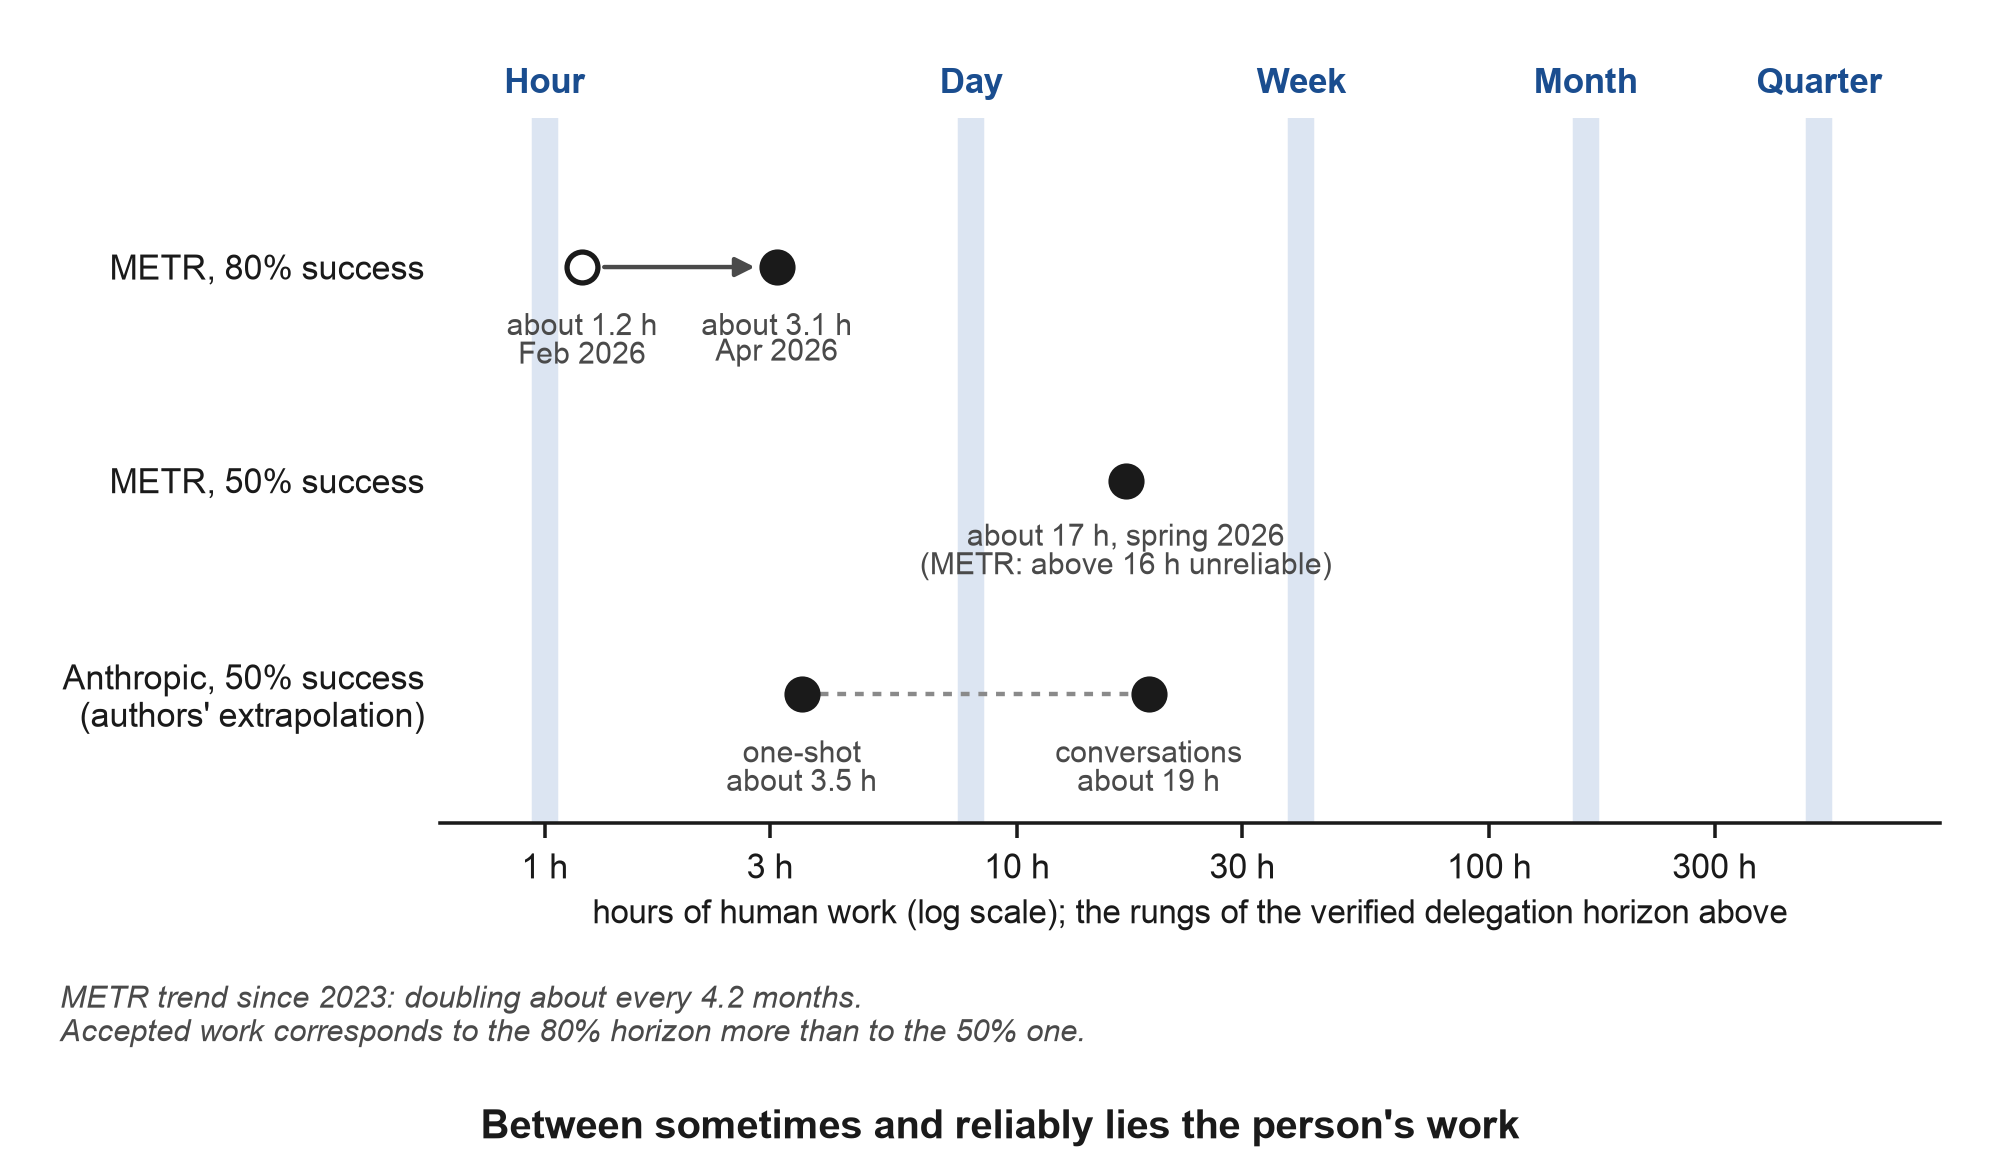
Примечание: Временной горизонт METR при 80% успеха составляет около 1,2 часа в феврале 2026 г. и около 3,1 часа в апреле. При 50% успеха — около 17 часов весной 2026 г., что сама METR считает ненадежным выше 16 часов (METR, 2026c). Точки 50% у Anthropic — около 3,5 часов для однократных запросов и около 19 часов для диалогов — экстраполяция авторов (Anthropic, 2026a). Горизонты машин измеряют модели, а не людей. Закрашенные столбцы показывают только, где ступени раздела 5.3 находятся на той же оси часов (раздел 5.6).
Figure A4. Процесс проверки раздела 6.5: что представляет каждый шаг, что он дает по правилу и где он останавливается.
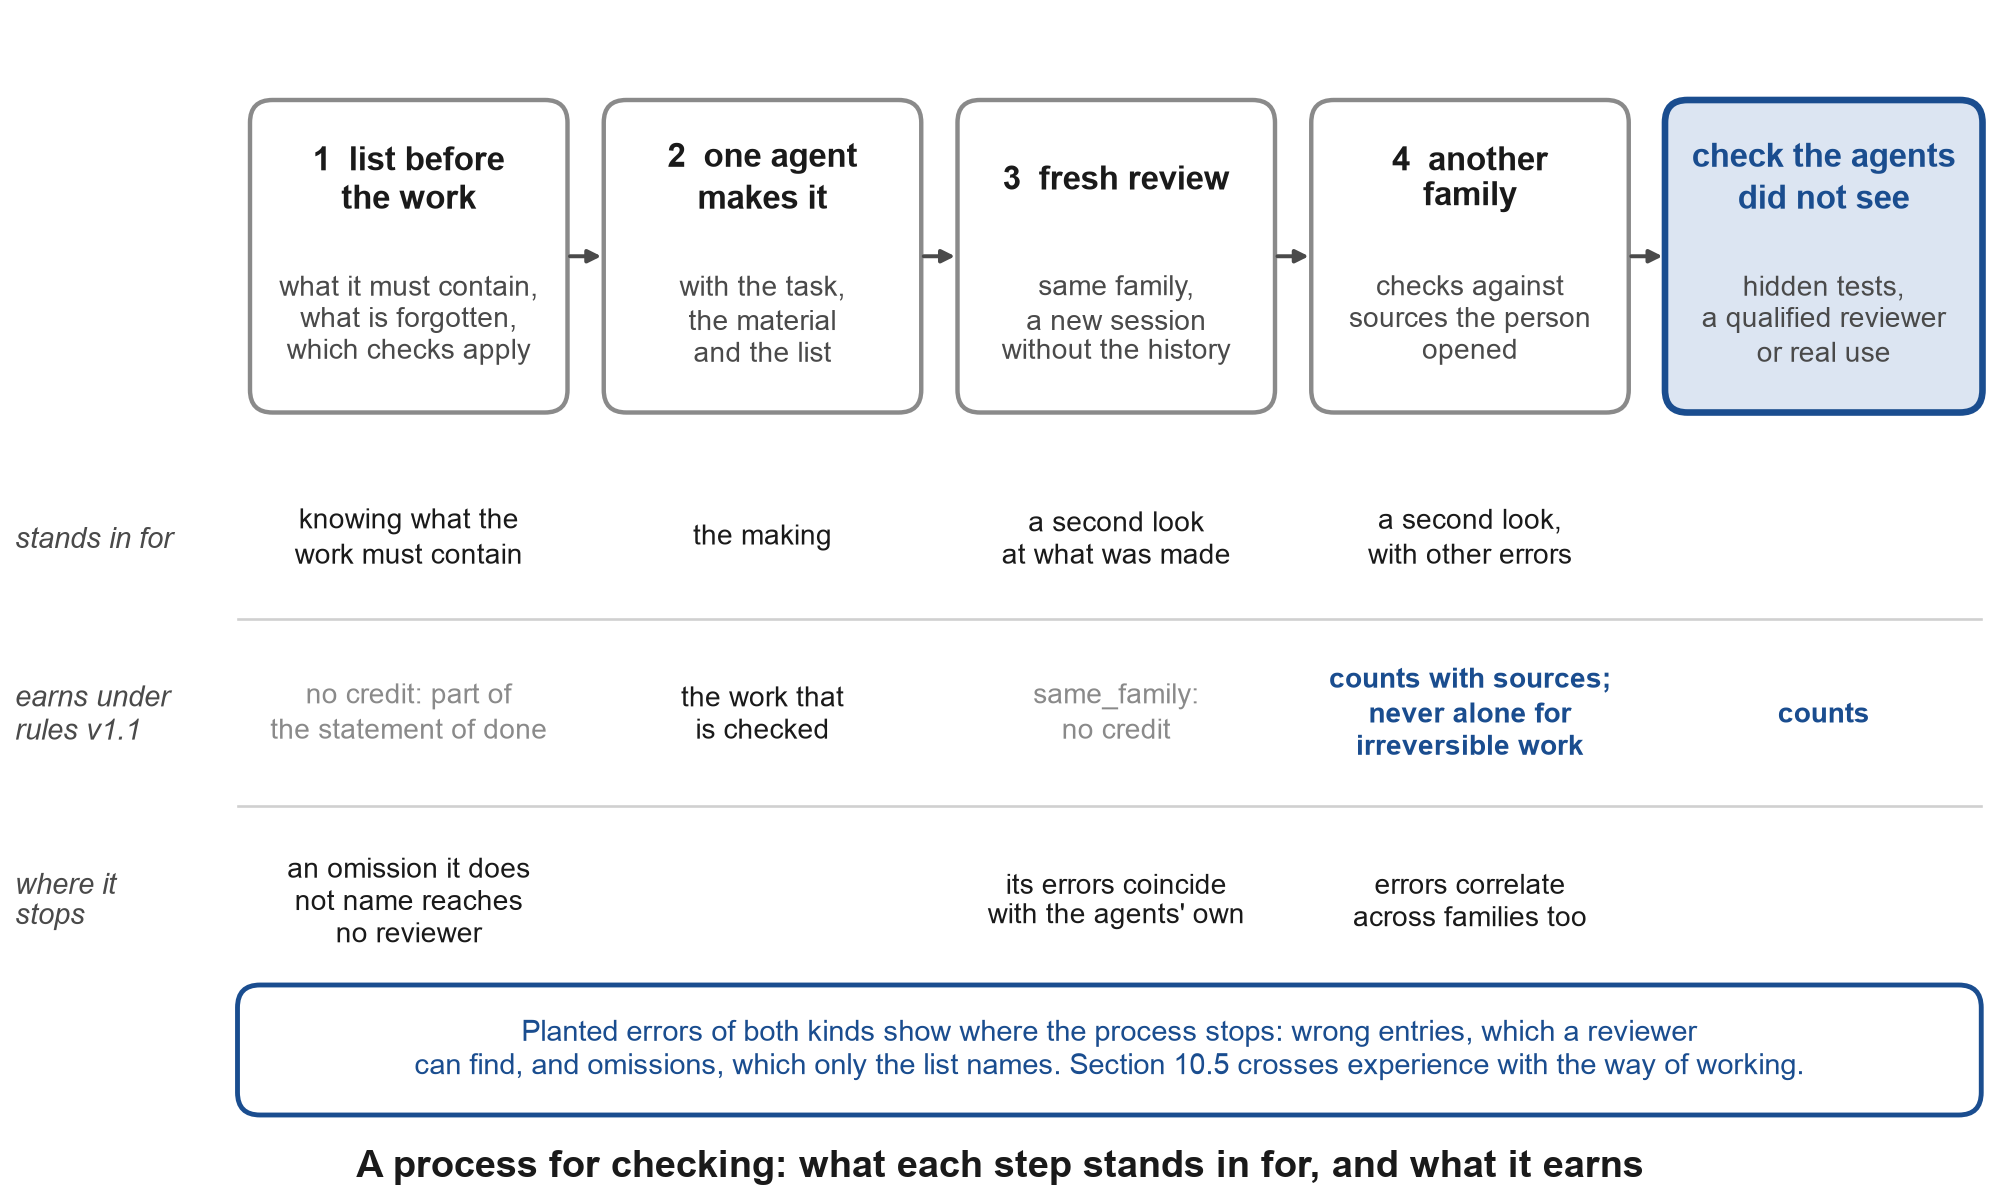
Примечание: Четыре шага и то, что представляет каждый, это шаги раздела 6.5. Строка кредита следует правилу подсчета баллов раздела 5.2 и таблицы A4: проверка моделью из одного семейства в новом контексте записывается как same_family и не получает кредит, хотя может улучшить работу; модель из другого семейства учитывается только если она проверяет источники, открытые человеком, и никогда одна для необратимой работы. Последняя строка суммирует Fu et al. (2025) об упущениях и Kim et al. (2025) об ошибках, коррелирующих в разных моделях. Ни одно зарегистрированное предсказание не тестирует этот процесс; раздел 10.5 излагает сравнение, которое это сделало бы. Рисунок создан figures/figure_a4_checking_process.py в сопровождающем репозитории, которая считывает кредит каждого типа проверки из horizon.py. Каждый шаг представляет часть профессионального опыта; раздел 14 возвращается к этому как к лестнице уравнителей.
Table A7. Статус утверждений в этой статье.
| Элемент | Как это обосновано | Основание |
|---|---|---|
| Программисты и другие теперь разделяют задачи и рабочий процесс делегирования и принятия | Данные подтверждают это на уровне задач и рабочих процессов; профессии в целом не слились | Раздел 2; логи поставщиков и опросы 2025–2026 гг. |
| Две старые лестницы не измеряют эту работу | Установлено | Переименованные лестницы без новой меры (Deloitte); вопрос об использовании ИИ на собеседованиях без шкалы |
| Подсчет токенов не работает как мера старшинства | Установлено в ранних случаях | Пресс-сообщения 2026 г. (раздел 4): неофициальный рейтинг сотрудника в Meta, удаленный, и позднее официальное руководство Meta против подсчета токенов; лидерборд в Amazon, манипулируемый и удаленный; бюджет на ИИ у Uber потрачен за четыре месяца, событие бюджета |
| Проверенный горизонт делегирования и выигрыш усиления | Предложено; правила v1.1 протестированы методом настольного анализа; протокол калибровки в сопровождающем репозитории; согласие профессионалов по эталонным часам при зарегистрированном тесте | Определения и правила (раздел 5); инструмент (приложение C); настольное тестирование пороговых значений (приложение E) |
| Потолок выигрыша, установленный долей проверки | Предложено как модель; иллюстрируется средними значениями GDPval | Раздел 5.5 |
| Нейтральность происхождения | Гипотеза; тесты подлежат регистрации (F7) | Anthropic (2026e) указывает на это; Savva (2026) предлагает альтернативу |
| Точка пересечения квалификаций | Гипотеза; компоненты датированы отдельно (паритет F2, обгон F3, публикации F5, нейтральность F7) | Lightcast (2026b) показывает сходящиеся линии; Bone et al. (2025) предшествуют этому для ролей в области ИИ |
| Ворота допуска по утечке самозаявленного ярлыка; ворота, проверяющие выполнение работы | Предложено как модель; утечка проиллюстрирована один раз при скрининге в исследовании рейтеров | Разделы 6.2 и 13; приложение G2; Danilova et al. (2021); Reid et al. (2022); Serafini et al. (2024, 2026); Oregon State Board of Bar Examiners (2026) |
| Программное обеспечение пересекается последним | Предсказание (F6), наряду с 40 другими в таблице A6, зарегистрировано на OSF | Аргумент домена (раздел 6.3) |
| Процесс проверки может служить частью профессионального опыта | Гипотеза, не зарегистрирована; ни одно зарегистрированное предсказание ее не тестирует, и F3b (p = 0,10) касается ее только косвенно; сравнение изложено в разделе 10.5 | Раздел 6.5; Dell'Acqua et al. (2026), McAleese et al. (2024), Eulerich et al. (2024), Fox et al. (2026) и Benchek et al. (2026) с одной стороны; Kim et al. (2025), Chernets (2026b), Fu et al. (2025) и Virk and Liu (2025) с другой |
| Доверие как вторая граница; гарант как партнерская профессия | Предложено как модель; предсказания F11 и F12 | Раздел 7 |
| Непрограммисты, работающие через агентов | Наблюдается в работающей когорте, описано без выводов; зарегистрированные результаты представлены отдельно | Раздел 11.5; приложение G |
Table A8. Ворота, допускающие по ярлыку и ворота, проверяющие работу: что проверяет каждая и что было наблюдено.
| Ворота | На каком основании допускает | Что было наблюдено | Источник |
|---|---|---|---|
| Фильтр участников исследовательской платформы | Ответы в основном даны на слово человека; возраст и страна проживания проверены | Из 60 человек, допущенных в выборку бухгалтеров, 11 неправильно ответили на базовый профессиональный вопрос, 8 из них путем обратной записи дебета и кредита | Prolific (2026); Appendix G2 |
| Навыки программирования, заявленные на платформе краудворка | Собственное слово человека | 42% не соответствовали критериям вопросов знаний исследователей | Danilova et al. (2021) |
| Программирование на Node.js, заявленное на Prolific | Собственное слово человека | 55 из 206 прошли все вопросы программирования | Reid et al. (2022) |
| Статический вопрос знания, в тексте или в изображениях | Ответ, который может дать языковая модель | ChatGPT легко решал существующие вопросы отбора для программистов и к 2026 году преодолел статические визуальные вопросы, предназначенные для его блокирования | Serafini et al. (2024, 2026) |
| Аудиовопрос, раскрываемый пошагово в условиях строгого ограничения по времени | Ответ, данный под давлением времени | По-прежнему устояла против языковой модели в 2026 году | Serafini et al. (2026) |
| Требование о степени, удаленное из политики | Ярлык, удаленный на бумаге | Менее чем 1 из 700 найма изменилось; 19,3% объявлений о вакансиях в США на Indeed запрашивали степень бакалавра или выше в ноябре 2025 года, что выше, чем годом ранее | Burning Glass Institute and Harvard Business School (2024); Indeed Hiring Lab (2026) |
| Лицензия по экзамену, пройденному один раз | Знание, проверенное один раз | Работает как ярлык с этого момента | Section 6.2 |
| Проверка подписанной работы лицензированной аудиторской фирмы | Подписанная работа, проверяемая снова и снова | Каждый год для фирм, регулярно проверяющих более 100 эмитентов, по крайней мере один раз в три года в прочих случаях | Sarbanes-Oxley Act of 2002, s. 104 |
| Лицензия по портфелю контролируемой работы | Проверенная работа, один раз; требуется степень по праву | 205 кандидатов подали заявки к 5 января 2026 года, и 49 получили лицензию, первый в декабре 2024 года | Oregon State Board of Bar Examiners (2026) |
| Проверенный горизонт делегирования | Доставленная работа, которая прошла проверку, которую агенты не видели, подтверждаемая каждый квартал | Ступень с подсчетом позади и типами проверки, сбои хранятся в журнале | Sections 5.2 and 5.3 |
Примечание: Строки — это случаи, на которые ссылается Section 6.2. Они происходят из разных совокупностей и разных вопросов и расположены рядом для наглядности того, что проверяет каждый критерий, а не для сравнения как показатели. Критерий второго вида можно добавить перед любым критерием первого вида: оценщики эталонных часов в сопутствующем репозитории допускаются по одному профессиональному вопросу (kits/reference-hours-raters.md), так как исследование оценщиков Appendix G2 проверило своих оценщиков. kits/trade-screen.md излагает, как написать такой вопрос и сообщить о нем, а tools/gate_leak.py показывает долю, которую пропускает ярлык, с точным доверительным интервалом.
Приложение G. Люди, уже это делающие: группа не-программистов и исследование рейтеров на платформе Prolific
Это приложение является дополнением к измерению, а не частью его аргументации; разделы 6.2, 6.5 и 14 ссылаются на результат скрининга G2 как на иллюстрацию. Оно добавляет две записи от участников: описание не-программистов, которые перешли от чата к работе через агентов в сентябре и октябре 2026 года (G1), и зарегистрированное исследование рейтеров, в котором работающие специалисты оценили эталонные часы банка задач (G2).
G1. Не-программисты, перешедшие от чата к агентам
С 6 сентября 2026 года я пошагово и через обычный обмен сообщениями направлял взрослых, не имеющих опыта программирования, от ассистента чата к кодирующему агенту, установленному на их собственном компьютере и оплачиваемому из их собственной потребительской подписки, а затем к работе с несколькими моделями. Они пришли из более чем дюжины профессий, среди них бухгалтерия и офисная работа, право, маркетинг и продажи, дизайн, фотография и ретушь, перевод и редактирование, музыка, строительство, транспорт и логистика, недвижимость, уход за людьми, государственное администрирование и работа в некоммерческих общественных организациях; четверо сообщили о прошлой или текущей работе в области разработки программного обеспечения. Приведённый ниже отчёт носит описательный характер: он излагает, что делали люди и что их остановило, по состоянию на 9 октября 2026 года, и не рассчитывает никакие показатели и не проверяет никакие утверждения данной работы.
Таблица G1. Как далеко продвинулась когорта к 9 октября 2026 года (количество людей).
| Этап | Количество |
|---|---|
| В записях: согласились и заполнили входную анкету | 119 |
| Установили агента на свой компьютер по собственной подписке и начали с ним работу | 35 |
| Создали артефакт или выполнили по меньшей мере один этап своей собственной работы | 24 |
| Остановились, указав причину | 23 |
| из них: нет собственного компьютера (только телефон или устройство, на котором не может работать агент) | 9 |
| из них: стоимость подписки | 5 |
| из них: отказались (имеющегося было достаточно, интереса нет или начальный фреймворк не подходил) | 6 |
| из них: здоровье, семья или время | 2 |
| из них: услуга недоступна там, где они живут | 1 |
Примечание: подсчитано вручную из записей участников и последней сводки измерений, используя самое продвинутое событие, зафиксированное для каждого человека. 35 человек второй строки — это 35 строк таблицы G1b, а 24 из третьей строки — первые 24 её строки. Артефакт считается, когда человек показал его или описал, что произвёл агент; один человек, создавший артефакт, позже остановился (P60) и учтён в обеих строках. Оставшиеся 62 человека к этому моменту либо получили этап установки без отчёта о его выполнении, либо ещё не достигли его.
Таблица G1a. Вся когорта по регионам и странам проживания и количество перешедших к агенту к 9 октября 2026 года.
| Регион и страна | В когорте | Перешли к агенту |
|---|---|---|
| Северная Америка | 37 | 10 |
| Соединённые Штаты | 35 | 10 |
| Канада | 2 | 0 |
| Западная Европа | 20 | 7 |
| Германия | 12 | 5 |
| Ирландия | 3 | 1 |
| Испания | 2 | 1 |
| Соединённое Королевство | 1 | 0 |
| Австрия | 1 | 0 |
| Швейцария | 1 | 0 |
| Центральная и Восточная Европа, названные страны | 9 | 1 |
| Польша | 3 | 0 |
| Молдова | 2 | 0 |
| Латвия | 2 | 0 |
| Эстония | 1 | 0 |
| Румыния | 1 | 1 |
| Страна не раскрыта | 53 | 17 |
| Итого | 119 | 35 |
Примечание: из столбца страны записей участников. «Страна не раскрыта» группирует участников, чья страна скрыта в соответствии с правилом конфиденциальности исследования, и тех, кто её не указал.
Что делали люди с агентом. Таблица G1b содержит всех, кто перешёл от ассистента чата к управлению агентом к 9 октября 2026 года, по одной строке каждый: какую задачу они ему дали и что он произвёл. Люди, создавшие артефакт или выполнившие этап своей собственной работы, идут первыми, упорядочены примерно по тому, как далеко они продвинулись; за ними идут те, кто установил агента и начал работу, но пока не сообщили о результатах. Профессии приведены как в записях, нейтральным языком. Короткие цитаты — это собственные слова участников из записей; те, которые помечены «(переведено)», были написаны на другом языке и приведены в моём дословном переводе.
Таблица G1b. Все, кто перешёл к настоящему времени (35 человек, по состоянию на 9 октября 2026 года).
| # | Участник | Профессия | Страна или регион | Что они делали с агентом | Своими словами |
|---|---|---|---|---|---|
| 1 | P20 | обработка изображений, ретушь, фотография | не раскрыто | Агент спросил о его целях и построил месячный план в виде папок и файлов (недели по темам, справочный файл, трекер); затем зарегистрировал его в девяти сервисах ИИ, автоматически управляя браузером, и записал один отказ в файл прогресса; он пропустил один вопрос через 11 веб-ИИ и записал результаты и ограничения в файл; на его собственных стоковых фотографиях он создал CSV метаданных за одну команду и проверил его | - |
| 2 | P73 | бизнес по продаже контактных линз | Ирландия | Установила второго агента от другого поставщика; оба прочитали копию её собственного плана социальных сетей и она записала точки, в которых они различались; написала файл правил для каждого агента и завершила вечер с файлом readme и журналом работы | "Я могу продолжить обучение." |
| 3 | P48 | офисная работа и онлайн-продажи | не разглашается | Превратила еженедельный документ, который она пишет, в шаблон с чек-листом и написала следующий быстрее с его помощью; второй сотрудник слепо читает её черновики; заставила двух ИИ прочитать целую папку с делом и сама решила по трём самым дорогостоящим находкам | "The question which AI is better is malformed." (translated) |
| 4 | P44 | маркетинг, продажи и консультирование | не разглашается | Создала кнопки на рабочем столе для запуска задач ИИ («статус проекта», «список новых товаров», «краткое описание документа», «заметка в файл»); установила второго ИИ на другую подписку и провела совместное рецензирование одной задачи: файл резюме плюс две полные рецензии | - |
| 5 | P21 | некоммерческая общественная организация | Germany | Создал интерактивную месячную программу развития навыков и привычек с отслеживанием прогресса; попросил ИИ выбрать начальное направление из каталога и написать четырёхнедельный план; затем запустил три сессии ИИ параллельно: презентацию за несколько минут и бота, который отслеживает объявления и отправляет совпадения в его мессенджер | "A tool tailored to your specific needs, rather than scouring the internet for compromises or paid subscriptions." — «Инструмент, адаптированный под ваши конкретные потребности, вместо поиска в интернете компромиссов или платных подписок.» |
| 6 | P05 | помощница директора, бывший программист | United States | ИИ создал пять файлов на её компьютере: обзор и четырёхнедельный план по тематике; позже он отправил приглашения списку из 76 контактов через веб-страницу сообщений, кликая самостоятельно, после тестового сообщения на её собственный номер | "From now on I will divide different daily tasks between them and really compare the results." — «Отныне я буду распределять различные ежедневные задачи между ними и действительно сравнивать результаты.» |
| 7 | P01 | дизайнер интерьеров и чертёжник, в обучении | Spain | Попросил ИИ создать файл с вакансиями в два прохода, второй шире первого; сравнил его с двумя отчётами другого чатбота, совпадения и расхождения выделены отдельно; переписал своё резюме и портфолио на основе честного прочтения собственных файлов и изменил свой профессиональный профиль | "When it can dig in so deeply and create interesting but in general separate data to analyse them." (translated) |
| 8 | P18 | интернет-маркетинг | не разглашается | ИИ привел в порядок её рабочий стол: создал документы, отсортировал их по папкам, нашел ошибки и исправил их; позже он настроил оповещения по электронной почте о новостях по её темам | "I'd heard about things like this, but seeing it in action really convinced me." — «Я слышал о таких вещах, но вид этого в действии действительно убедил меня.» |
| 9 | P19 | чиновник государственного управления | не разглашается | Отредактировал длинное издание с несколькими книгами его собственного текста в один день; завершил два крупных проекта за неделю; теперь создаёт коллекцию плагинов для рабочего процесса перевода | "I wrapped up two major projects in just one week... wow." (translated) |
| 10 | P35 | контракты, счета и таможенные документы | United States | Выполнил первую задачу голосом; ИИ очистил кеш её компьютера, закрыл приложения и нашел слот встречи на сайте бронирования, открыв его самостоятельно; предложил направление печати по требованию; помогает с документами тендеров; теперь работает в терминале | "Yes, it worked, we did it." (translated) |
| 11 | P72 | стоковые изображения и видео, созданные с помощью ИИ | Romania | Запустил одну задачу через множество ИИ с помощью инструмента оркестрации, настроил голосовой ввод и выбрал направления фриланса из каталога | - |
| 12 | P41 | стоматологический ассистент, в отпуске по уходу за ребёнком | United States | ИИ создал расписание, план и черновики; нашел на её компьютере шесть копий собственного установщика и пять копий офисного пакета и удалил лишние; она продиктовала урок для общественного класса и ИИ напечатал его, добавил ссылки, перевел и сохранил его, затем переработал его по её указанию | "I am delighted." — «Я восхищён.» |
| 13 | P24 | музыкант и поэт | Germany | Отправил одно задание с изображением одиннадцати ИИ и сохранил результаты в папку с галереей; попросил ИИ создать основу музыкального аранжировки, что его разочаровало | "The ethical aspect of authorship remains unresolved for me." — «Этический аспект авторства остаётся неразрешённым для меня.» |
| 14 | P102 | управляет компанией разработки ПО | не разглашается | Уже работал ежедневно в ИИ с самого начала; задал один вопрос 11 ИИ (10 ответили) и отправил файл запуска; теперь работает через каталог доходов | - |
| 15 | P40 | инженер-исследователь и веб-разработчик | не разглашается | Прошёл путь как сознательный новичок: около сотни разрозненных файлов в его папке загрузок отсортировано по папкам, со скриншотами до и после; внёс два исправления в материалы курса | - |
| 16 | P75 | удалённая техническая поддержка | не разглашается | ИИ создал папку на его рабочем столе с планом запуска сезонного музыкального видеоканала (названия, идеи треков, названия, график постинга); финальный шаг завершён | - |
| 17 | P60 | уход на дому | United States | После нескольких вопросов от ИИ месячный план разбит на файлы (доноры, финансы, шаблоны писем); позже ушел, найдя базовое представление начинающего слишком элементарным | - |
| 18 | P64 | форменная государственная служба, логистика и снабжение | не разглашается | Составил месячный план с ИИ, который создал файлы на его компьютере; зарегистрировался в десяти сервисах ИИ | "AI adapts to the person. It flatters, in a certain sense." (translated) |
| 19 | P28 | форменная государственная служба | не разглашается | ИИ изложил пути карьеры от его текущей должности и, когда он отклонил один из них, план развития для его предыдущей профессии, ремонт часов (навыки, сертификация, собственная мастерская) | - |
| 20 | P14 | промышленный альпинист | United States | Создал «Reflex Square», маленький тренер скорости реакции, с ИИ по его собственному предложению во время настройки | "For now, coding in Code is not something I need in my everyday life." — «На данный момент кодирование в Code — это не то, что мне нужно в повседневной жизни.» |
| 21 | P67 | тренер по плаванию, также прямые продажи | не разглашается | Сказала ИИ, что она начала с прямых продаж; он предложил пять видов помощи и создал образец карточки товара | - |
| 22 | P12 | студент | Germany | Зарегистрировался в бесплатных сервисах ИИ, запустил папку оркестрации и с ИИ выбрал четыре направления из каталога (журналистика, книга, монетизация, углубление в ИИ); даст ему свои собственные эссе | - |
| 23 | P71 | защита интересов и общественное здравоохранение | Germany | Написала свой собственный промпт; агент сократил его и попросил других ИИ создать изображения; выполнила шаг терминала и дополнительное тестовое задание, чтобы запомнить нажатия клавиш | "Task done, send the next one." |
| 24 | P22 | организация некоммерческого сообщества | не раскрыто | Выполнила задачу по каталогу в агенте (некоторые сайты блокировали вход); выполнила шаг терминала и затем попросила самого агента объяснить, что было сделано; настроила оповещения новостей по электронной почте | "Done, what next?" (translated) |
| 25 | P59 | видеограф | United States | Дал агенту подробное задание по поиску прибыльных объявлений о недвижимости на его местном рынке (проверки, без расходов, ранжировано по прибыли); результаты пока не показаны | "Why do I need a second one if the first works." |
| 26 | P84 | не указано | не раскрыто | Установил агент через терминал самостоятельно; строит веб-сайт для организации сообщества | "Doing something, but I think we should talk." (translated) |
| 27 | P66 | администратор в центре досуга | не раскрыто | Купила ноутбук для курса, установила агент и переместилась из общего режима на вкладку агента; на этапе открытия учетных записей в десяти ИИ | "Everything is in a foreign language, what next?" (translated) |
| 28 | P82 | работа в области безопасности; создание диспетчерской службы для грузовых перевозок | United States | Установил; перенес свои чаты и проекты из другого чатбота для сравнения двух | - |
| 29 | P70 | исследования и редактирование видео для социальных сетей | United States | Заставила агент работать с помощью соседки по квартире, после первого создания тестового файла вручную | - |
| 30 | P17 | адвокат по международному праву | не раскрыто | Установка выполнена; первое задание отправлено | "I did everything." (translated) |
| 31 | P93 | специалист по прямой поддержке в сфере ухода за пожилыми людьми | не раскрыто | Перешла с простого чата на агента и оплатила; первое задание отправлено | - |
| 32 | P54 | изготавливает торты на заказ | не раскрыто | Установила и оплатила на новом ноутбуке; первое задание отправлено | - |
| 33 | P26 | бетонное строительство | United States | Установил на восстановленном ноутбуке и отправил фото; первое задание отправлено | "What's next" |
| 34 | P03 | директор компании внешней торговли | United States | Установил вместе с P35; первое задание отправлено | - |
| 35 | P45 | фото и видеоконтент, опыт в программировании | Germany | Достигла этапа открытия учетных записей в десяти ИИ, что предполагает работающий агент; детали не зарегистрированы | - |
Примечание: Составлено из записи участников. Строки 1–24 — третья строка таблицы G1; строки 25–35 установили агент и начали без сообщенного результата к 9 октября 2026 г. «-» означает, что запись не содержит полезных слов участника за этот период.
Как новички говорят об управлении агентами. Люди, которые несколько недель назад использовали только чат-помощника, описывают свою новую работу своими собственными словами. Я собрал каждый отрывок, который запись участников и ежедневные заметки наблюдений дают в собственных формулировках участников для 35 человек, которые установили агента (161 отрывок от 32 человек, около 1070 слов), и подсчитал, сопоставляя основы слов, слова для системы, которой они управляют, для того, что они с ней делают, и для себя; подсчеты приблизительны, и «это» включает некоторые использования, которые не относятся к инструменту.
Table G1c. Слова, которые используют новички для управления агентами (количество в их собственных отчетах).
| Что обозначает слово | Слова, сгруппированные по категориям | Количество |
|---|---|---|
| Система, которой они управляют | «это» | 35 |
| названия модели или продукта (Claude, GPT, Codex и другие) | 16 | |
| инструмент, программа, приложение | 11 | |
| «ИИ», «ИИ» | 9 | |
| агент | 1 | |
| ассистент, помощник, работник | 0 | |
| Что они с ней делают | настроить, установить, запустить | 10 |
| спросить, вопрос, запрос | 9 | |
| задача, инструкция, промпт | 7 | |
| проверить, сравнить | 4 | |
| разделить, передать | 2 | |
| Сами себя | разработчик, новичок | 5 |
Несколько их собственных слов (цитаты на английском языке; отмеченные «(translated)» были написаны на другом языке, и перевод — мой):
- "It doesn't just answer questions but can actually work with files and documents." (P18, интернет-маркетинг)
- "One of the biggest mistakes when using AI is assuming that a confident answer is automatically correct." (P20, фотограф и ретушер; translated)
- "I really feel like a developer now." (P21, организация некоммерческого сообщества)
- "To get what I want I need to think through how to put the request." (P48, офисная работа и онлайн-продажи; translated)
- "I think the answer is like a question to two people." (P59, видеограф)
- "One time one AI gives the better advice, the next time it is the other way round." (P48, офисная работа и онлайн-продажи; translated)
Три более длинных отрывка показывают движение голосом участников. Дизайнер интерьеров на обучении, в его первый вечер с агентом, прежде чем кто-либо показал ему совет моделей: "it made a folder also worked itself well like with documents opened [...] and in the end I got two files called vacancies from this one vacancies from that one and also took them again sent them to each other so that they evaluated each other's work" (P01, translated, from an automatic transcription of a voice message). Промышленный альпинист, в день, когда он построил свою первую маленькую программу с агентом, уже прося следующую роль: "maybe learning how to build agents that could do part of the work for me - posting on social networks, reminding me of things, or giving me suggestions." (P14). И участник работы в организации некоммерческого сообщества, после его первых недель: "I sense a vast new potential opening up - like standing on the threshold of something new." (P21).
Они называют систему по названию её продукта или просто «it», почти никогда не используя слово «agent», и ни один из заголовков на карте раздела 3 не появляется; однако они говорят об установлении задач, сравнении двух ответов и проверке уверенного ответа, что является работой, которую мера считает. Как и на карте, функция приходит раньше имени для неё, и это предлагается как описание, а не как проверка какого-либо утверждения.
Те же люди также участвуют в отдельно зарегистрированной программе (OSF, DOI 10.17605/OSF.IO/X4EGQ), результаты которой сообщаются там.
G2. Исследование оценивающих на Prolific: согласны ли профессионалы с контрольными часами?
Мера измеряет каждый объём работы в контрольных часах, а правило раздела 5.2 просит двух специалистов оценить работу вслепую и вызывает третьего, когда их оценки отличаются более чем в 1,5 раза. Исследование оценивающих спрашивает, согласны ли работающие профессионалы в такой степени. Оно было зарегистрировано на OSF как до-пилот 9 октября 2026 года, прежде чем были собраны какие-либо данные (DOI 10.17605/OSF.IO/V92R8), и запущено на Prolific в тот же день.
Дизайн. Две независимые выборки, всего 119 участников набрано и оплачено: 60 бухгалтеров (текущая должность: бухгалтер, главный бухгалтер, аттестованный или сертифицированный бухгалтер, аудитор или налоговый специалист) и 59 веб- и разработчиков программного обеспечения (текущая должность: инженер программного обеспечения, разработчик программного обеспечения или веб-разработчик). Все проживают в Соединённом Королевстве, Соединённых Штатах, Ирландии, Канаде, Австралии или Новой Зеландии, имеют рейтинг одобрения Prolific не менее 98% за не менее чем 100 предыдущих заданий и участвуют только в одном исследовании. Каждый участник оценивает десять задач своей области из банка задач v0 (BK01 to BK10 или WT01 to WT10, зафиксированные в pilot/task-bank-v0.csv) в часах сосредоточенной работы квалифицированного профессионала, работающего самостоятельно без инструментов AI, повторно оценивает одну задачу (BK03 или WT03) как повторное тестирование и отвечает на один вопрос о компетентности и одну проверку внимания. Участник, который не прошёл любую из них, исключается и получает оплату; оценка, которая не является положительным числом или превышает 2000 часов, отбрасывается.
Результаты. Основной: по области, доля пар оценивающих, охватывающих все задачи, чьи две оценки находятся в пределах коэффициента 1,5, в сравнении с пороговым значением 0,70, установленным в протоколе калибровки. Вторичный: та же доля после удаления личного уровня каждого оценивающего, ICC(2,1) по логарифмическим часам, доля пар при повторном тестировании в пределах 1,5 и медианная оценка каждой задачи в сравнении с предусмотренной ступенью. Для сравнения, четыре модельные оценивающие из приложения E расположили 56% своих пар на этих 20 задачах в пределах 1,5: 47% на десять задач бухгалтерского учёта и 65% на десять веб-задач. Анализ — это скрипт human_raters.py, поданный при регистрации OSF перед данными, и результат сообщается, каким бы он ни был.
Результаты.
Скрининг. Участники были допущены на основе профессии в своём профиле Prolific, и большинство ответов, скрытых за фильтрами Prolific, самостоятельно сообщаются (Prolific, 2026), поэтому вопрос о компетентности был единственной проверкой мастерства в дизайне. В выборке бухгалтеров это был вопрос с множественным выбором о двойной записи для платежа клиента, поступившего в банк. Из 60 человек, допущенных в эту выборку, 11 (18%) ответили неправильно, восемь из них, обратив дебет и кредит, и ни один не провалил проверку внимания; как зарегистрировано, они исключены из результатов ниже и были оплачены. В незарегистрированном сравнении эти 11 оценили более крупные задачи в меньшее количество часов, чем другие участники выборки: их медианы для трёх задач, предназначенных для ступени Week (BK08 to BK10), были 6, 6 и 8 часов, против 8, 8 и 12 для остальных 49. С 11 людьми это направление для проверки, а не оценка, и спешка или неправильно прочитанный вопрос оставит аналогичный след; это соответствует пониманию того, что человек, не знающий ремесло, не видит всех этапов его более крупных задач (раздел 6.5). В выборке веб-инструментов то же сравнение не повторилось: 8 разработчиков, которые не прошли свой вопрос о компетентности, дали для трёх задач, предназначенных для уровня Week, медианы 24,5, 27,5 и 19 часов, против 20, 16 и 20 для остальных 50, поэтому результат ограничивается только бухгалтерией (разведочные анализы ниже).
Скрипты для этого раздела находятся в сопутствующем репозитории (pilot/). prolific_to_long.py записывает длинный файл рейтингов из экспортов Prolific; он читает каждую оценку в таком виде, как она написана, сохраняет ответ без номера или с несколькими, такие как диапазон, как текст, чтобы зарегистрированное правило его отбросило, и перечисляет каждый ответ, который не является простым числом. table_g2.py печатает таблицу G2 с функциями зарегистрированного скрипта, вызванными без изменений, рядом с модельными оценивающими на тех же задачах. screen_compare.py пересчитывает сравнение скрининга выше с точным интервалом и тестом перестановки по оценивающим для задач уровня Week.
Согласованность. Позиции были заполнены 9 и 10 октября 2026 г., и 118 участников оставили ответы — 60 бухгалтеров и 58 разработчиков; ответы одного разработчика, чье представление было одобрено и оплачено, не были сохранены инструментом опроса. После зарегистрированных исключений (11 бухгалтеров и 8 разработчиков не прошли вопрос на проверку компетентности; ни один участник не прошел проверку внимания) осталось 49 бухгалтеров и 50 разработчиков. Зарегистрированный порог не был достигнут ни в одной области: 28% пар бухгалтеров и 25% пар разработчиков попали в диапазон 1,5, по сравнению с 0,70 (таблица G3). Специалисты согласованно упорядочили задачи, причем медианы в каждой области возрастали от задач, предназначенных на час, к тем, которые предназначены на неделю, но они расходились в оценке часов больше, чем допускает правило двух оценивающих. Удаление личного уровня каждого оценивающего повысило долю только до 34% и 35%, поэтому разногласие касается самой работы, а не привычки округлять вверх или вниз. ICC(2,1) для логарифмических часов составил 0,34 для бухгалтерского учета и 0,46 для веб-инструментов, и две оценки одного оценивающего одной и той же задачи совпадали в пределах 1,5 в 53% и 74% случаев. Четыре модельных оценивающих из приложения E, с результатом 56% на одних и тех же 20 задачах, согласились друг с другом более тесно, чем профессионалы, что больше говорит о разбросе профессионалов, чем о точности моделей. По сравнению с практиками банк располагается примерно на одну ступень выше: каждая задача, предназначенная для дня, имела медиану 2–7 часов, что соответствует часу, а каждая задача, предназначенная для недели, — медиану 8–20 часов, что соответствует дню. В приведенном выше разведывательном сравнении 11 исключенные бухгалтеры не согласились друг с другом лучше, чем остальные (28% пар в пределах 1,5). Результаты устанавливают три компонента правила оценивания. Оценивающие калибруются на задачах с измеренными временами, что закрепляет опорный уровень, выявляя смещение медиан. Объем работы определяется по медиане панели, а не по двум оценивающим, так как разброс такой величины отправил бы большинство пар к третьему оценивающему. И банк задач переопределяется по медианам практиков, что перемещает его задачи на одну ступень ниже (таблица G3b).
Таблица G2. Согласованность специалистов по эталонным часам по областям.
| Область | Оставлено | Исключено | Пары в пределах 1,5 | После удаления уровня оценивающего | ICC(2,1), логарифмические часы | Повторное тестирование в пределах 1,5 |
|---|---|---|---|---|---|---|
| Бухгалтерский учет | 49 | 11 | 0.283 | 0.335 | 0.335 (49 полных) | 0.531 (n = 49) |
| Веб-инструменты | 50 | 8 | 0.247 | 0.349 | 0.461 (49 полных) | 0.735 (n = 49) |
Примечание: зарегистрированный порог для пар в пределах 1,5: 0,70, не достигнут ни в одной области. Исключения — это неудачи вопроса на проверку компетентности; ни один участник не прошел проверку внимания. Пары берутся по всем десяти задачам области (11 760 для бухгалтерского учета, 11 809 для веб-инструментов). Повторное тестирование сравнивает две оценки одного оценивающего BK03 или WT03. Вывод из human_raters.py как зарегистрировано (DOI 10.17605/OSF.IO/V92R8).
Таблица G3b. Медианная оценка каждой задачи в сравнении со ступенью, которую предусмотрел банк (часы).
| Предусмотренная ступень | Задача бухгалтерского учета: медиана | Ступень медианы | Задача веб-инструментов: медиана | Ступень медианы |
|---|---|---|---|---|
| Час | BK01: 2.0; BK02: 2.0; BK03: 1.5 | Час | WT01: 1.0; WT02: 1.0; WT03: 2.0 | Час |
| День | BK04: 3.0; BK05: 2.0; BK06: 3.0; BK07: 4.0 | Час | WT04: 7.0; WT05: 6.0; WT06: 4.0; WT07: 4.0 | Час |
| Неделя | BK08: 8.0; BK09: 8.0; BK10: 12.0 | День | WT08: 20.0; WT09: 16.0; WT10: 20.0 | День |
Примечание: медианы по оставленным оценивающим. Медиана менее 8 часов попадает в «Час», а медиана от 8 до менее 40 часов — в «День». Каждая задача, предназначенная для дня или недели, попадает на одну ступень ниже.
Исследовательские анализы. Анализы в этом параграфе не были зарегистрированы. Они переиспользуют зарегистрированный загрузчик, исключения и тест, а их сценарий и результат находятся в pilot/exploratory_prolific.py и pilot/results/prolific-2026-10/exploratory-output.txt в сопровождающем репозитории. Переборка оценивающих дает 95%-ные интервалы от 0,24 до 0,33 (бухгалтерия) и от 0,21 до 0,29 (веб-инструменты) для основной доли. Размер панели (таблица G4). Для каждого задания два непересекающихся набора из k сохраненных оценивающих были отрисованы 2000 раз, и их медианы сравнивались. На необработанных оценках две медианы согласовывались в пределах 1,5 не менее чем в 70% отрисовок только начиная с 15 бухгалтеров или 21 разработчика на панель. С удалением личного уровня каждого оценивающего, что является целью калибровки на задачах с измеренным временем, панели из семи достигли 0,71 и 0,69, а панели из девяти достигли 0,77 и 0,76. Попадание на ту же ступеньку, которую записывает мера, требует меньше: пять откалиброванных оценивающих на панель сделали это в 0,81 и 0,84 отрисовок. В соответствии с правилом двух оценивающих из раздела 5.2 третий оценивающий был бы вызван в 72% и 75% элементов. Опыт (таблица G4). 43 из 98 сохраненных оценивающих с полными ответами сообщили более 10 лет в своей области. Они согласовывались друг с другом не более тесно, чем остальные, и годы в области не предсказывали, насколько далеко оценивающий был от медианы остальных (ранговая корреляция +0,18 и −0,10, перестановочный p = 0,21 и 0,47). Старшие разработчики давали более высокие оценки, чем другие разработчики (1,32 против 0,76 раз медиана остальных, p = 0,02); старшие бухгалтеры не давали (1,04 против 1,07, p = 0,88). Задания. Разногласие растет с размером: пять из шести наиболее спорных из 20 заданий были задания, рассчитанные на неделю, где 24% (бухгалтерия) и 20% (веб-инструменты) пар лежали в пределах 1,5, против 31% и 27% на заданиях, рассчитанных на час; межквартильный размах задания на неделю охватывал коэффициент от 4 до 8. Скорость и единицы. Самая быстрая четверть бухгалтеров (3,6 минуты или менее для всего опроса) согласовывались более тесно, чем остальные (0,37 против 0,26), и среди разработчиков скорость не имела значения (0,24 против 0,24). Ответ на некоторые задания в минутах вместо часов не имел значения ни в одной области (0,31 против 0,31; 0,28 против 0,31). Двое бухгалтеров потратили 40 часов или более на задание, рассчитанное на час, что выглядит как минуты, напечатанные как часы; без них доля бухгалтерии составляет 0,284. Один сохраненный разработчик напечатал текст вместо чисел, поэтому только одна из их оценок вошла в анализ. Скрининг. Сравнивая оценки каждого оценивающего для заданий на неделю с их собственными оценками для заданий на час, так чтобы личный уровень сокращался, исключенные бухгалтеры оценивали более крупные задания в 3,2 раза больше, чем меньшие, против 6,2 раза для сохраненных (перестановочный p = 0,10), и исключенные разработчики 15,8 раз против 10,6 (p = 0,37). Повторное тестирование. Повторная оценка была выше, чем первая, для 25 бухгалтеров и ниже для 4, и выше для 17 разработчиков и ниже для 2 (точный знаковый тест p < 0,001 в обоих случаях), примерно на 30% по геометрическому среднему, что соответствует привязке к более крупным заданиям, оцененным в промежутке. Вместе эти результаты размещают разброс в самой работе и его масштабе, а не в подгруппе спешащих, младших или неквалифицированных оценивающих, и они определяют размер панели, который требует правило: откалиброванные оценивающие, пять до девяти на элемент, оцененные по ступеньке (таблица G4).
Таблица G4. Две независимые панели из k оценивающих за задание: доля отрисовок, чьи медианы согласуются в пределах 1,5 / доля на той же ступеньке (исследовательское).
| Оценивающих на панель | Бухгалтерия, необработанное | Бухгалтерия, уровень удален | Веб-инструменты, необработанное | Веб-инструменты, уровень удален |
|---|---|---|---|---|
| 1 | 0.28 / 0.51 | 0.34 / 0.62 | 0.24 / 0.46 | 0.34 / 0.60 |
| 3 | 0.43 / 0.68 | 0.51 / 0.76 | 0.37 / 0.60 | 0.52 / 0.78 |
| 5 | 0.51 / 0.77 | 0.63 / 0.81 | 0.43 / 0.68 | 0.62 / 0.84 |
| 7 | 0.58 / 0.82 | 0.71 / 0.84 | 0.49 / 0.74 | 0.69 / 0.87 |
| 9 | 0.62 / 0.85 | 0.77 / 0.87 | 0.54 / 0.78 | 0.76 / 0.89 |
| 15 | 0.71 / 0.88 | 0.88 / 0.91 | 0.64 / 0.84 | 0.86 / 0.94 |
| 21 | 0.76 / 0.89 | 0.94 / 0.95 | 0.72 / 0.84 | 0.92 / 0.98 |
Примечание: Сохраненные оценивающие со всеми десятью оценками (49 на область); 2000 отрисовок на задание, панели непересекающиеся в пределах отрисовки; seed 20261011. Уровень удален: среднее логарифмическое отношение каждого оценивающего к медиане всех оценивающих на каждом задании вычитается в выборке, как в зарегистрированном вторичном результате, поэтому эти столбцы представляют верхнюю оценку того, что даст калибровка на отдельных якорных заданиях. Не зарегистрировано; результат pilot/exploratory_prolific.py.
Таблица G4b. Годы в области и согласие (сохраненные оценивающие с полными ответами, исследовательское).
| Область | Группа | Оценивающих | Пары в пределах 1,5 внутри группы | Уровень против медианы остальных |
|---|---|---|---|---|
| Бухгалтерия | Более 10 лет | 23 | 0.268 | 1.04 |
| Бухгалтерия | 10 лет или менее | 26 | 0.299 | 1.07 (p = 0.88) |
| Веб-инструменты | Более 10 лет | 20 | 0.297 | 1.32 |
| Веб-инструменты | 10 лет или менее | 29 | 0.242 | 0.76 (p = 0.02) |
Примечание: Уровень — это геометрическое среднее отношение оценок оценивающего к медиане других оценивающих на одних и тех же заданиях; p — двусторонний тест перестановок (5000 перестановок) разницы в среднем логарифмическом уровне. Не зарегистрировано.
Как цитировать
Chernets, V. (2026). After the Programmer Divide: One Measure for People Who Build Through AI Agents [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7589918
@misc{chernets2026aftertheprogrammerdivide,
  author       = {Chernets, Vadym},
  title        = {{After the Programmer Divide: One Measure for People Who Build Through AI Agents}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7589918},
  url          = {https://doi.org/10.2139/ssrn.7589918}
}