Después de la Brecha del Programador: Una Medida para Personas que Construyen a través de Agentes de IA
Esta es una traducción. La versión de referencia es el original en inglés; cite esa.
El horizonte de delegación verificado, ganancia de amplificación, un mapa fechado de nombres de roles, y 41 predicciones registradas calificadas cada año hasta 2031
Vadym Chernets, PhD, arquitecto de sistemas de IA · ORCID 0009-0007-4845-3163
SSRN 7589918 · DOI 10.2139/ssrn.7589918 · Zenodo 10.5281/zenodo.23267267 · GitHub
Descargar este artículo
- SSRN (versión de registro): ssrn.com/abstract=7589918 · DOI 10.2139/ssrn.7589918
- Zenodo (archivado, acceso abierto): doi.org/10.5281/zenodo.23267266
- OSF (las 41 predicciones, registradas el 9 de octubre de 2026): doi.org/10.17605/OSF.IO/VW6P9
- GitHub (texto completo como Markdown): github.com/vadimchernets/papers/tree/main/after-the-programmer-divide; código del Apéndice C: github.com/vadimchernets/delegation-horizon
SSRN contiene la versión de registro; cite esa.
Palabras clave: agentes de IA; IA agéntica; no programadores; agentes de codificación; títulos de trabajo; contratación basada en habilidades; teoría del principal-agente; ingeniería de software de usuario final; alfabetización en IA; horizonte de delegación verificado; punto de cruce de credenciales; predicciones preregistradas
Resumen
Un contador solicita a un agente una herramienta de conciliación; un desarrollador le pide que cambie un sistema de facturación. Cada uno debe aceptar el trabajo de un día y demostrar que se sostiene. Para octubre de 2026, los abogados también estaban asignando tareas a los mismos agentes. En aproximadamente 400.000 sesiones, el éxito verificado por el proveedor en trabajo generador de código fue del 34% para ocupaciones de programación y del 29% para otras, aunque la ocupación no es educación. Ninguna escala de carrera dice qué puede confiarse que alguien que construye a través de agentes entregue. Propongo una medida en lugar de un título. El horizonte de delegación verificado es la pieza de trabajo coherente más grande, en horas de referencia de un especialista calificado, que una persona entrega regularmente a los agentes y acepta después de una verificación independiente que los agentes no vieron. La ganancia de amplificación, horas de referencia aceptadas por hora de atención, es un rendimiento verificado, no una estimación causal del aumento de velocidad. Ambos se califican por dominio, hora a trimestre; una prueba de escritorio corrigió un umbral. Tres grandes empleadores probaron recuentos de tokens y los abandonaron en 2026: un ranking eliminado, una tabla de clasificación manipulada, un presupuesto gastado. El trabajo verificado es más difícil de manipular gastando, y cada ruta restante cumple una defensa establecida. Un mapa fechado registra nombres rivales (constructor, gestor de agentes, principal y otros) sin elegir. La neutralidad de fondo es la hipótesis de que en un horizonte igual, una educación en programación deja de predecir la calidad verificada. El punto de cruce de credenciales es el momento, dominio por dominio, cuando los productos de personas sin educación en TI comienzan a superar los de programadores bajo los mismos controles, después de lo cual los títulos y las etiquetas de antigüedad pierden peso. Cuarenta y una predicciones fechadas, valuadas al 9 de octubre de 2026 en la mediana de tres pronósticos de modelos ciegos, están registradas en OSF y se califican anualmente hasta 2031; un estudio nunca realizado cuenta como un fracaso, y superar en el propio dominio se sitúa en 0,35.
Resumen ejecutivo
Para 2026, los contables estaban comparando agentes de codificación de la manera en que los programadores lo hicieron un año antes, los abogados estaban construyendo sus propias herramientas con ellos, y las personas fuera del software se habían convertido en una parte de rápido crecimiento de los usuarios de agentes de codificación de un proveedor; en los registros de otro proveedor, aproximadamente 400.000 sesiones, las ocupaciones que no programan se quedaban atrás de los programadores por unos pocos puntos porcentuales en el éxito verificado en el trabajo de codificación (34% frente al 29%). Donde se realiza el trabajo, el límite entre programadores y todos los demás se ha adelgazado. En títulos de puesto, escalas salariales y currículums se mantiene donde estaba.
Algunos programadores y algunos profesionales del dominio ahora comparten un flujo de trabajo: entregan trabajo a agentes y deciden si aceptarlo. Las tareas y los flujos de trabajo se han fusionado por delante de profesiones completas, por lo que la pregunta informativa sobre una persona es cuán grande es el trabajo que pueden entregar y demostrar, sin importar de qué lado del antiguo límite provengan. La medida que propongo para esa pregunta, el horizonte de delegación verificado, se basa en algunas opciones de diseño, y este resumen da la razón de cada una. La unidad es el tiempo que un especialista calificado habría necesitado (una hora, un día, una semana, un mes, un trimestre), porque ambas escaleras antiguas pueden leerla y no se necesita traducción entre profesiones. Una herramienta de conciliación de un contador y un cambio de facturación de un desarrollador enfrentan la misma regla. Solo el trabajo que pasó una verificación que los agentes no vieron se cuenta, y el acuerdo entre modelos de una familia no cuenta como tal verificación, porque sus errores están correlacionados. Un segundo número, ganancia de amplificación, registra cuánto trabajo verificado rinde cada hora de la atención de la persona (el trabajo fallido aún cuesta atención, y el tiempo desatendido de los agentes no lo hace), de modo que alguien que trabaja al lado de un agente en bucles cortos sea acreditado tan completamente como alguien que entrega piezas grandes. Ambos números se mantienen por dominio, por una razón simétrica: un abogado que se traslada al software y un programador que se traslada a la ley pierden lo mismo, la capacidad de aceptar trabajo en un campo que no conocen. Los umbrales se versionan como reglas v1.1 y se prueban en escritorio, y la prueba de escritorio ya ha corregido uno de ellos (Apéndice E).
Los nombres no están establecidos. Constructor, ingeniero agéntico, gerente de agentes, operador de IA, orquestador y principal están todos en uso en octubre de 2026, cada uno con un propietario y una fecha. Los mapeo sin elegir, para que sea cual sea el que gane pueda leerse en una escala: un constructor en Semana, un gerente de agentes en Día.
El mercado ya ha intentado un atajo. En 2026, los conteos de tokens fueron intentados como una medida de personal en grandes empleadores y fallaron en cuestión de meses: la clasificación no oficial de un empleado en Meta fue eliminada y la orientación oficial de la empresa posteriormente descartó los conteos de tokens, un tablero de clasificación en Amazon fue manipulado con tareas vacías y eliminado, y Uber gastó su presupuesto anual de IA en cuatro meses. Un conteo de entradas recompensa el gasto. Un conteo de trabajo aceptado, verificado de forma independiente, es más difícil de inflar de esa manera por diseño. Las rutas que quedan (verificaciones fáciles, calificadores generosos, ayuda oculta y trabajo dividido en piezas) cada una se encuentran con una defensa en la Sección 5.8: auditorías aleatorias, calificadores independientes de horas, un registro público de fracasos, una unidad coherente de trabajo y errores plantados.
Dos predicciones sustentan mi tesis fechada. La neutralidad de antecedentes dice que en el mismo peldaño una educación en programación deja de predecir la calidad verificada. El punto de cruce de credenciales es el momento, en un dominio, cuando los productos realizados por personas sin educación en TI comienzan a superar a los de programadores que utilizan los mismos agentes, después de lo cual un grado y las etiquetas junior y senior pierden peso. La paridad de calidad llega antes de ese momento, un cruce de requisitos de titulación en anuncios de empleo es su signo visible, y cada parte está fechada y probada por su cuenta. La predicción principal va en contra de la opinión actual, y el documento lo dice donde formula la predicción. Cada predicción también nombra el resultado que la refutaría, para que un lector pueda ver por adelantado cómo sería un fracaso. Los 41 aparecen en una tabla con probabilidades, umbrales, fuentes de retorno y fechas finales, registrados en OSF el 9 de octubre de 2026 (DOI 10.17605/OSF.IO/VW6P9) y calificados por la regla de Brier cada año hasta 2031. Veintisiete se resuelven a partir de datos públicos. Catorce necesitan estudios registrados por separado antes de que se recopilen datos, y la evidencia faltante o inconcluyente se registra como no resuelta y no cuenta como un éxito; un estudio que nunca se ejecuta es un fracaso del programa de prueba y permanece en la hoja de puntuación. Las probabilidades se fijaron el 9 de octubre de 2026 como la mediana de tres pronósticos de modelo ciego, que adopté, y están registradas en OSF; la probabilidad de superar en el propio dominio es 0.35.
Cuando la construcción cuesta poco, la confianza se convierte en el filtro escaso. Las tiendas de aplicaciones y los alojadores de código están inundados, las plataformas están cerrando sus puertas a contribuyentes desconocidos, y los agentes cada vez escriben una solución en lugar de adoptar la de alguien más. Junto a la persona que construye, dos funciones de asociado son visibles: un finalizador lleva el producto a las personas, y un garante firma por él. El segundo nombre proviene de una descripción de 2025 del rol, y también propongo una medida para el garante.
1. Introducción
El 23 de septiembre de 2026, un blog para contables comparó dos agentes de programación, Claude Code y Codex, para categorizar transacciones y reconciliar cuentas (Growthy, 2026). Un año antes esa comparación pertenecía a programadores, y en los hilos de programadores sigue siendo así, completa con bandos y lealtades. Lo que cambió fue el lector. Las personas que ahora eligen entre agentes llevan libros de contabilidad, redactan contratos y ejecutan campañas, y los agentes entre los que eligen son los que usan los desarrolladores de software.
Durante décadas la economía ha mantenido dos escaleras profesionales. En software los peldaños eran junior, intermedio, senior, staff y principal, valorados por años de experiencia y por cuántos ingenieros necesitaba un proyecto. En otros lugares los peldaños eran analista, consultor, gerente, director y socio. Las escaleras se encontraban en la puerta del departamento de TI, en el sentido de que un profesional de la segunda escalera obtenía software encargándoselo a alguien de la primera. En 2025 y 2026 ambas escaleras comenzaron a describir el mismo trabajo. A los desarrolladores se les dijo que sus actividades principales se habían convertido en delegación y verificación (GitHub, 2025b). Los profesionales fuera del software, con un agente en una terminal o una ventana de escritorio, comenzaron a construir las herramientas, sitios y pequeñas aplicaciones que solían encargar (Bloomberg Law, 2026; OpenAI, 2026). Ninguna escalera dice qué se puede confiar que tal persona entregue, y ninguna dice cómo comparar un antiguo desarrollador con un antiguo analista que ahora hacen el mismo trabajo.
Las preguntas que siguen son cómo deberían llamarse las personas en el lado fusionado de esa frontera, cómo debería medirse su nivel una vez que un título y años de servicio dejan de indicar al empleador qué pueden entregar, y cuándo podría desaparecer la frontera. La última de ellas obtiene su respuesta en forma de predicciones fechadas.
Esa pregunta también tiene un origen fechado. El 8 de octubre de 2026 establecí un pronóstico: en uno o dos años la capacidad agéntica crecerá tanto que la educación técnica ya no será necesaria, y las personas sin ella construirán mejores aplicaciones, sitios y productos, con código mejor que el código de los programadores. Más tarde esa misma noche añadí un corolario. Cuando los productos hechos por personas sin educación informática comiencen a superar los hechos por profesionales informáticos, los títulos en TI y las etiquetas junior y senior perderán rápidamente peso en un currículum. (Ambas declaraciones se traducen de mis notas de ese día.) Las secciones 6 y 11 convierten ambas en predicciones con fechas, medidas, umbrales y resultados que las refutarían. La segunda declaración nombra el momento que el resto del artículo llama el punto de cruce de credenciales.
El documento complementario de esta serie siguió a no programadores desde el chat hasta los agentes y definió cuatro niveles según dónde trabaja un agente y qué debe poseer la persona (Chernets, 2026a). Contabilizó una transición solo cuando un agente había producido un artefacto, y se negó a convertir al gerente de agentes en un título de trabajo, utilizando el término "para un patrón de comportamiento en lugar de un rol contra el que alguien deba contratar, porque el comportamiento deja evidencia y un título no" (Chernets, 2026a, Sección 8.4). El presente artículo parte de esa condición: un nivel se otorga, y cualquier título puede adjuntársele, solo sobre evidencia, es decir, trabajo entregado a agentes, aceptado por una persona, y confirmado por una verificación que los agentes no vieron.
La sección 3 proporciona un mapa fechado de los nombres en circulación en octubre de 2026. La sección 5 proporciona la escala sobre la cual se pueden leer cualquiera de esos nombres, el horizonte de delegación verificado con su segundo eje, ganancia de amplificación. La sección 6 establece dos hipótesis, neutralidad de antecedentes y el punto de cruce de credenciales, y pregunta cuánta experiencia de un oficio puede compensar un proceso de verificaciones. Las secciones 7 y 8 abordan la confianza, la frontera que no se disuelve, y las dos funciones de socio junto a la persona que construye. La sección 11 establece predicciones fechadas con probabilidades, umbrales y fuentes de respaldo, registradas en OSF y calificadas cada año hasta 2031 en público.
No elijo entre los nombres. El mercado elegirá, probablemente en cuestión de meses, y un artículo que apuesta por una palabra está equivocado el día que otra palabra gana. Lo que un artículo puede fijar es la escala. La sección 5 la define completamente; en resumen, el horizonte de delegación verificado pregunta qué tan grande es una pieza de trabajo, en las horas que un especialista calificado habría necesitado, que una persona entrega regularmente a agentes y acepta con una verificación independiente detrás de la aceptación, y la ganancia de amplificación pregunta cuántas tales horas cada hora de la propia atención de la persona produce. Ambas se mantienen por dominio, fechadas, y colocadas en cinco peldaños desde Hora hasta Trimestre. La figura 1 coloca las dos escaleras antiguas junto a esa.
Una definición del punto de cruce de credenciales sirve a todo el artículo. En un dominio, es el momento cuando los productos hechos por personas sin educación informática, aceptados bajo las mismas verificaciones independientes, comienzan a superar los de programadores que usan los mismos agentes, después de lo cual un título y las etiquetas junior y senior pierden su peso en la contratación. La paridad de calidad es el paso antes de ese momento, y un cruce de requisitos de grado en ofertas de empleo es su signo visible. La neutralidad de antecedentes, la hipótesis de que la educación deja de predecir la calidad verificada en un peldaño igual, es el mecanismo que lo explicaría. Cada una de estas cuatro partes lleva su propia predicción fechada (Sección 6.2).
La evidencia se extrae de 2025 y 2026, un período en el cual un mes de desarrollo de agentes cambia lo que una medida tiene que contar. Una cifra ampliamente citada sitúa la contratación de nuevos graduados en grandes empresas de tecnología muy por debajo de su nivel de 2019. Se omite, al igual que las comparaciones con el pico de contratación de 2022, porque miden un mundo anterior a los agentes. Las series de antes de los agentes entran solo como predecesores, y la macroeconomía de la contratación se lleva por el contrapunto de LinkedIn de la sección 2.4. El trabajo más antiguo también entra como teoría, precedente o analogía: Jaques sobre el lapso temporal de responsabilidad, Jensen y Meckling sobre el costo de la delegación, una fiebre del oro y un fotógrafo.
Figura 1. Dos escaleras y una medida.
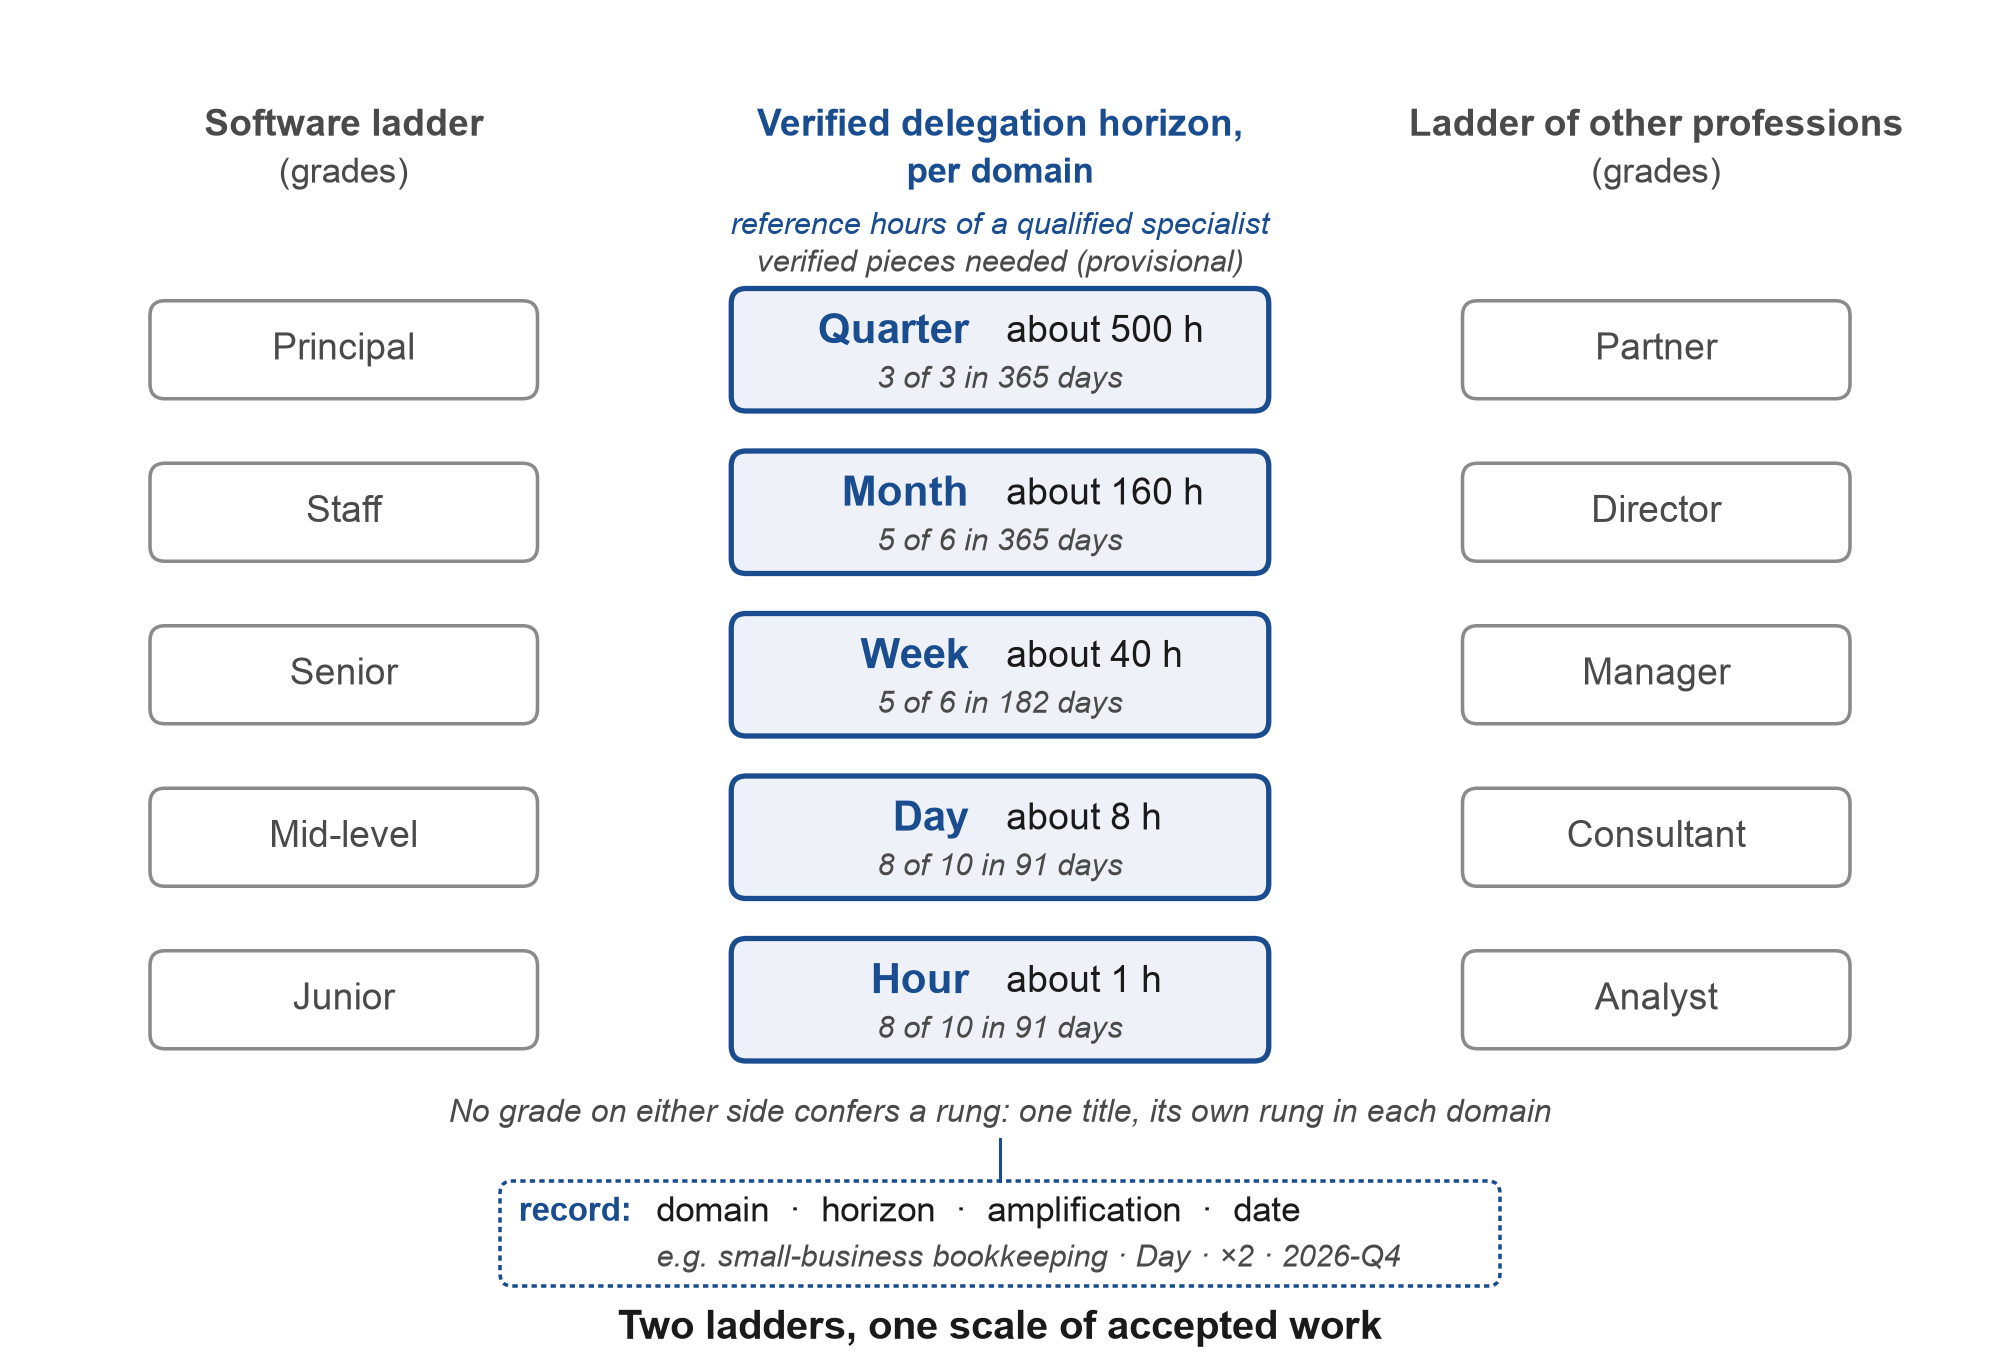
Nota: Las escaleras antiguas se dibujan lado a lado con los cinco peldaños y deliberadamente no están conectadas: ninguna calificación en ninguna escalera confiere un peldaño, y la misma persona tiene un peldaño separado en cada dominio (Sección 5.2). Los peldaños se cuentan en horas de referencia de un especialista calificado, con los recuentos y ventanas de la sección 5.2 (reglas v1.1). El registro mostrado es el impreso por el ejemplo trabajado del Apéndice C4.
En torno a esos apartados, la Sección 2 expone la evidencia de convergencia y la Sección 4 describe cómo la primera medida del mercado fracasó, que es el caso para una medida de este tipo. La Sección 9 examina qué temas de las conversaciones de los programadores se extienden a otras profesiones, y la Sección 10 extrae las implicaciones. La Sección 12 recopila la evidencia en contra de la tesis, la Sección 13 establece sus condiciones límite, y la Sección 14 concluye.
2. Dos mundos convergentes: evidencia de 2025 y 2026
2.1 El trabajo del programador, redescrito
Los proveedores que venden a desarrolladores ahora describen el trabajo del desarrollador como dirigir agentes. La descripción de GitHub sobre "la nueva identidad de un desarrollador" puso la delegación y la verificación en el centro del trabajo (GitHub, 2025b). Anthropic encuestó a 132 de sus propios ingenieros e investigadores en agosto de 2025. Informaron de usar IA en aproximadamente el 60% de su trabajo y una ganancia de productividad autoevaluada de aproximadamente el 50%, y se describieron a sí mismos como volviéndose más "full-stack". La mayoría dijo que podría delegar completamente solo hasta una quinta parte de su trabajo, y el 27% de su trabajo asistido por IA consistía en tareas que no se hubieran hecho en absoluto sin IA (Anthropic, 2025a). Una medida construida únicamente sobre delegación completa vería por lo tanto como máximo una quinta parte de lo que los usuarios más avanzados del mundo hacen con IA, por lo que la Sección 5 añade un segundo eje. El mismo informe nombró una "paradoja de la supervisión": supervisar el modelo requiere las habilidades de codificación que se atrofian cuando todo se delega a él.
Las palabras siguieron al trabajo. Andrej Karpathy nombró "vibe coding" el 2 de febrero de 2025 (Karpathy, 2025), Collins la convirtió en palabra del año (Collins Dictionary, 2025), y un año después Karpathy pasó a "agentic engineering". En el AI Ascent de Sequoia el 30 de abril de 2026 expresó la diferencia como "vibe coding eleva el piso, agentic engineering extrapola el techo" (Karpathy, 2026; Willison, 2026a). Un artículo académico describió al ingeniero agencial como un nuevo arquetipo profesional, con la responsabilidad desplazándose de la autoría del código a la propiedad de los resultados (Alenezi, 2026), y Microsoft describió los patrones de trabajo en sus clientes como autor, editor, director y orquestador (Microsoft, 2026b).
2.2 Todos los demás, dentro de los mismos agentes
Dos proveedores informan de un amplio uso de agentes de codificación por personas fuera de la programación, con diferentes límites de selección y medición. OpenAI informó en junio de 2026 que los usuarios semanales de su agente de codificación que no son desarrolladores habían crecido 137 veces entre usuarios individuales y 189 veces entre organizaciones desde agosto de 2025 (OpenAI, 2026). La base era baja y los datos son del proveedor. El mismo informe proporciona una distribución que importa para la Sección 5. En una muestra de aproximadamente el 0.1% de los usuarios individuales del agente en mayo de 2026, el 80.6% hizo al menos una solicitud cuya duración manual, según lo estimado por un modelo, superó 30 minutos, el 70.2% al menos una de más de una hora, y el 25.6% al menos una de más de ocho horas. Estas son proporciones de usuarios que hacen solicitudes largas, con duraciones estimadas por un modelo, que es algo diferente de una tasa de finalización o un horizonte verificado, y la Sección 5 explica por qué la diferencia importa. Más de una cuarta parte del trabajo del agente para funciones comerciales fue trabajo de ingeniería.
El estudio de Claude Code de Anthropic, publicado el 16 de junio de 2026, es el dato público más cercano a la tesis (Anthropic, 2026e). Analizó aproximadamente 400,000 sesiones por aproximadamente 235,000 personas entre octubre de 2025 y abril de 2026. La experiencia se juzgó a partir del comportamiento, por tres signos: con qué precisión la persona indicó la tarea, qué pidieron que se verificara, y quién corrigió a quién. Un contador sin Python que escribió reglas de reconciliación exactas y detectó casos excepcionales fue calificado como experto. En sesiones donde se produjo código, cada una de las diez ocupaciones más grandes se quedaba no más de siete puntos porcentuales atrás de las ocupaciones de programación en éxito verificado, donde el éxito significa logro respaldado por evidencia como pruebas aprobadas o trabajo confirmado. La clasificación del proveedor se basa en parte en señales en la transcripción de la sesión, como la confirmación explícita de un usuario, y el informe señala que la tasa ligeramente más alta de los gerentes puede reflejar en parte cómo informan del éxito, así que "verificado" aquí es el término del proveedor, no una verificación independiente. Agregado en sesiones que producen código fue del 34% contra el 29% (aproximadamente el 30% contra el 26% en todas las sesiones), y los gerentes funcionaron ligeramente mejor que los programadores. Estos datos clasifican a las personas por ocupación y no dicen nada sobre la educación: un contador puede poseer un título en ciencias de la computación, y un programador puede no tener ninguno. El informe concluyó que "los agentes de codificación están haciendo que los antecedentes de codificación sean menos relevantes para la programación exitosa". Las personas tomaron aproximadamente el 70% de las decisiones sobre qué hacer y el agente aproximadamente el 80% de las decisiones sobre cómo hacerlo. El conjunto de instrucciones de un experto desencadenó aproximadamente doce acciones de agente, el de un novato aproximadamente cinco.
El mismo cambio aparece en fuentes que no provienen de las empresas que venden los agentes. Los abogados, desde asociados junior hasta socios, han estado construyendo prototipos funcionales de sus propias herramientas con Claude Code en lugar de esperar a los proveedores, y la proporción de abogados con acceso amplio a IA aumentó del 61% en 2025 al 83% en 2026 (Bloomberg Law, 2026; Artificial Lawyer, 2026). Los contadores comparan agentes (Growthy, 2026). Lovable, un creador de aplicaciones basado en navegador, superó los $600 millones en ingresos anualizados en septiembre de 2026 (TechCrunch, 2026a). Según una estimación, Claude Code fue autor de aproximadamente el 4% de las confirmaciones públicas en GitHub a principios de febrero de 2026 (SemiAnalysis, 2026).
2.3 Las escaleras bajo presión
Los empleadores han comenzado a renombrar sus escaleras sin aún decir qué las reemplaza. A partir del 1 de junio de 2026 Deloitte dio a sus aproximadamente 181,500 empleados estadounidenses nuevos títulos organizados por familia de trabajo y agregó un nivel de liderazgo (Business Insider, 2026). Sus niveles internos y principios salariales se mantuvieron en su lugar (Fortune, 2026a), por lo que esto fue un renombramiento con la medida dejada como estaba. Se informó que LinkedIn había reemplazado su programa de gerente de producto asociado con una pista "Associate Product Builder" y había abierto un rol "Full Stack Builder" a personas de cualquier función (Lenny's Newsletter, 2025). Microsoft contó 3,233 de 20,000 usuarios de IA encuestados, aproximadamente el 16%, como "Profesionales Fronterizos" que ejecutan agentes multietapa y rediseñan sus procesos (Microsoft, 2026a). Srinivasan y Wei argumentaron en la Harvard Business Review en febrero de 2026 que las empresas necesitan gerentes de agentes, y esperaban que el título se convirtiera en estándar dentro de 12 a 18 meses (Srinivasan & Wei, 2026). Algunos empleadores van más lejos y escriben el nuevo rol en las publicaciones: State Street publicó un "Agentic Product Builder" que aún requiere programación (State Street, 2026). El 7 de octubre de 2026 Dust presentó el "AI Operator" como la persona que construye y mantiene flujos de trabajo de agentes compartidos (Dust, 2026).
La contratación lo ha notado. La proporción de entrevistas de trabajo en las que se discutió el uso de IA de los candidatos aumentó del 0.33% en el tercer trimestre de 2025 al 4.54% en el segundo trimestre de 2026 (Metaview, 2026). La pregunta ha entrado en la contratación antes de que exista algún criterio para la respuesta.
2.4 Publicaciones, contratación a nivel de entrada y educación
Las ofertas de empleo en EE.UU. que mencionan «agentic AI» pasaron de 151 en 2024 a 16,541 en 2025 (Stanford HAI, 2026). Un recuento diferente, realizado por Lightcast, encontró más de 86,000 ofertas en 2025 que mencionaban habilidades de agentic AI, un aumento anual del 280% en las menciones de esas habilidades y un salario anunciado mediano de $153,000; las habilidades se añadieron principalmente a títulos de trabajo existentes (Lightcast, 2026a). El AI Index cuenta ofertas que contienen la frase «agentic AI», mientras que el blog de Lightcast cuenta ofertas que incluyen habilidades agentic en su propia taxonomía, lo que explica la mayor parte de la distancia entre 16,541 y aproximadamente 86,000. Los números miden cosas diferentes y se mantienen separados aquí.
La contratación de nivel de entrada se ha debilitado, y su causa es controvertida. LinkedIn encontró que la contratación de nivel de entrada en EE.UU. de abril a junio de 2026 disminuyó un 7.6% año tras año en comparación con el 6.9% para todos los niveles, y en ocupaciones que la IA potencia, la contratación de nivel de entrada cayó un 9.6% en comparación con el 6.5% para todos los niveles en esas ocupaciones (LinkedIn Economic Graph, 2026). LinkedIn atribuye más de la caída a la incertidumbre económica que a la IA, y señala que, entre los roles de nivel de entrada, aquellos no expuestos a la IA cayeron más en Francia, el Reino Unido y los Estados Unidos. El estudio «canaries» de Stanford, en su actualización de agosto de 2026, encontró que el empleo de jóvenes de 22 a 25 años en ocupaciones expuestas a la IA estaba aproximadamente 19% por debajo de lo esperado sin una brecha comparable para trabajadores experimentados, y describe el resultado como descriptivo (Stanford Digital Economy Lab, 2026a). Dos otras fuentes encuentran el mismo mecanismo. Economistas del Banco de la Reserva Federal de Dallas, utilizando datos de microencuestas de la Encuesta de Población Actual, encontraron disminuciones de empleo vinculadas a la exposición a la IA solo entre trabajadores jóvenes, impulsadas principalmente por menos nuevas incorporaciones a la fuerza laboral que por separaciones (Atkinson & Yamco, 2026). En datos de currículos que cubren aproximadamente 65 millones de trabajadores, el empleo junior en empresas que adoptaron IA generativa fue aproximadamente un 9% inferior que en las que no la adoptaron seis trimestres después de la adopción, nuevamente a través de una contratación más lenta en lugar de separaciones (Hosseini & Lichtinger, 2026). En toda la economía, el Yale Budget Lab todavía no encuentra evidencia clara de que las ocupaciones expuestas a la IA se desempeñen peor que las equivalentes no expuestas (Yale Budget Lab, 2026), por lo que la presión recae en el nivel de entrada, no en la ocupación como un todo. Los empleadores citaron la IA en 101,743 despidos anunciados en la primera mitad de 2026, aproximadamente el 23% de todos los despidos anunciados (Challenger, Gray & Christmas, 2026).
La educación también está cambiando. El número de nuevos estudiantes de licenciatura en ciencias de la computación disminuyó un 13% en los departamentos cubiertos por la encuesta Taulbee de 2026, que incluye departamentos que otorgan doctorados en América del Norte; sus autores describen esto como los primeros signos claros de contracción en el canal de matrícula, junto con una producción de títulos en un máximo histórico (Computing Research Association, 2026). Un experimento de campo con 673 aprendices de TI alemanes encontró ganancias de 26 a 31 puntos porcentuales en tareas fuera de su capacitación formal cuando contaban con IA (Stanford Digital Economy Lab, 2026b). El marco conjunto de la OCDE y la Comisión Europea de junio de 2026 incluye un dominio llamado «Manage AI» (OECD & European Commission, 2026).
La Tabla A1 (Apéndice F) enumera diez señales de esta convergencia con sus fuentes, y para cada una qué muestra y qué no muestra. Leídas en conjunto, también muestran dónde falta la medición: los datos de los proveedores sobre usuarios no desarrolladores de agentes de codificación muestran crecimiento, no la calidad de sus resultados. La cercanía de ocupaciones en el éxito verificado se refiere a la ocupación, no al grado. Las escalas renombradas y los segmentos de encuestas son títulos, no medidas. Y no se demuestra que el escalón de entrada más débil sea causado por la IA.
Estas señales muestran, con cierta confianza, que ahora el trabajo con agentes se establece y se acepta en ambos lados de la antigua frontera, y que empleadores, escuelas y proveedores han comenzado a renombrar cosas. ¿Realizan personas ajenas al software este trabajo tan bien como los programadores? Las señales dejan eso sin resolver, y tampoco muestran medida alguna para ello. La Sección 5 propone la medida, la Sección 11 establece un cronograma para la cuestión de la calidad, y la Sección 12 presenta la evidencia que las predicciones deben superar.
La evidencia de 2026 distingue entre personas que pueden demostrar que un resultado es correcto y personas que no pueden. La educación en programación es un camino hacia esa habilidad. Maestría en un campo, el hábito de verificación y herramientas de verificación son otros, y los datos de la Sección 2.2 sugieren que pueden sustituir al primero más a menudo de lo que las antiguas escaleras suponen, aunque aún no que siempre puedan. La medida de la Sección 5 se construyó para probar esa afirmación.
3. Nombres en circulación: un mapa fechado
3.1 Por qué no elijo un nombre
Cada pocas semanas en 2026 una empresa o un consultor, a veces una revista, proponía un nombre para las personas descritas aquí, y algunos de esos nombres perdurarán. Como el uso está sin resolver, hago dos cosas en lugar de recomendar una: mapeo los nombres ya en circulación, incluyendo los que están ocupados, con quién introdujo cada uno, cuándo y en qué sentido, y ofrezco una medida por la cual cualquiera de ellos puede ser leído. Si «constructor» gana, el registro dice «constructor at Week»; si «gestor de agentes» gana, dice «gestor de agentes at Day». Se reclama prioridad para la medida, la escalera, las definiciones y las predicciones, incluyendo los términos que las nombran (horizonte de delegación verificado, ganancia de amplificación, punto de cruce de credenciales), y no para ningún nombre de rol; los nombres de rol añadidos en la Sección 3.3 se ofrecen como candidatos sin prioridad.
3.2 Seis capas
Los candidatos no compiten todos por un solo puesto. Algunos nombran una habilidad que casi todos tendrán, otros una profesión, una medida, un momento, un socio, o una señal que fracasó. La Tabla A2 (Apéndice F) enumera los nombres ya en uso, con sus propietarios, y, en una segunda parte, los nombres propuestos en este estudio o usados aquí solo como descripciones simples, junto con variantes que fueron consideradas y descartadas, para que un lector pueda ver toda la familia. La Figura 2 coloca los nombres por capa y por la fecha en que cada uno fue introducido.
Figura 2. Nombres en circulación, por capa y por la fecha en que cada uno fue introducido.
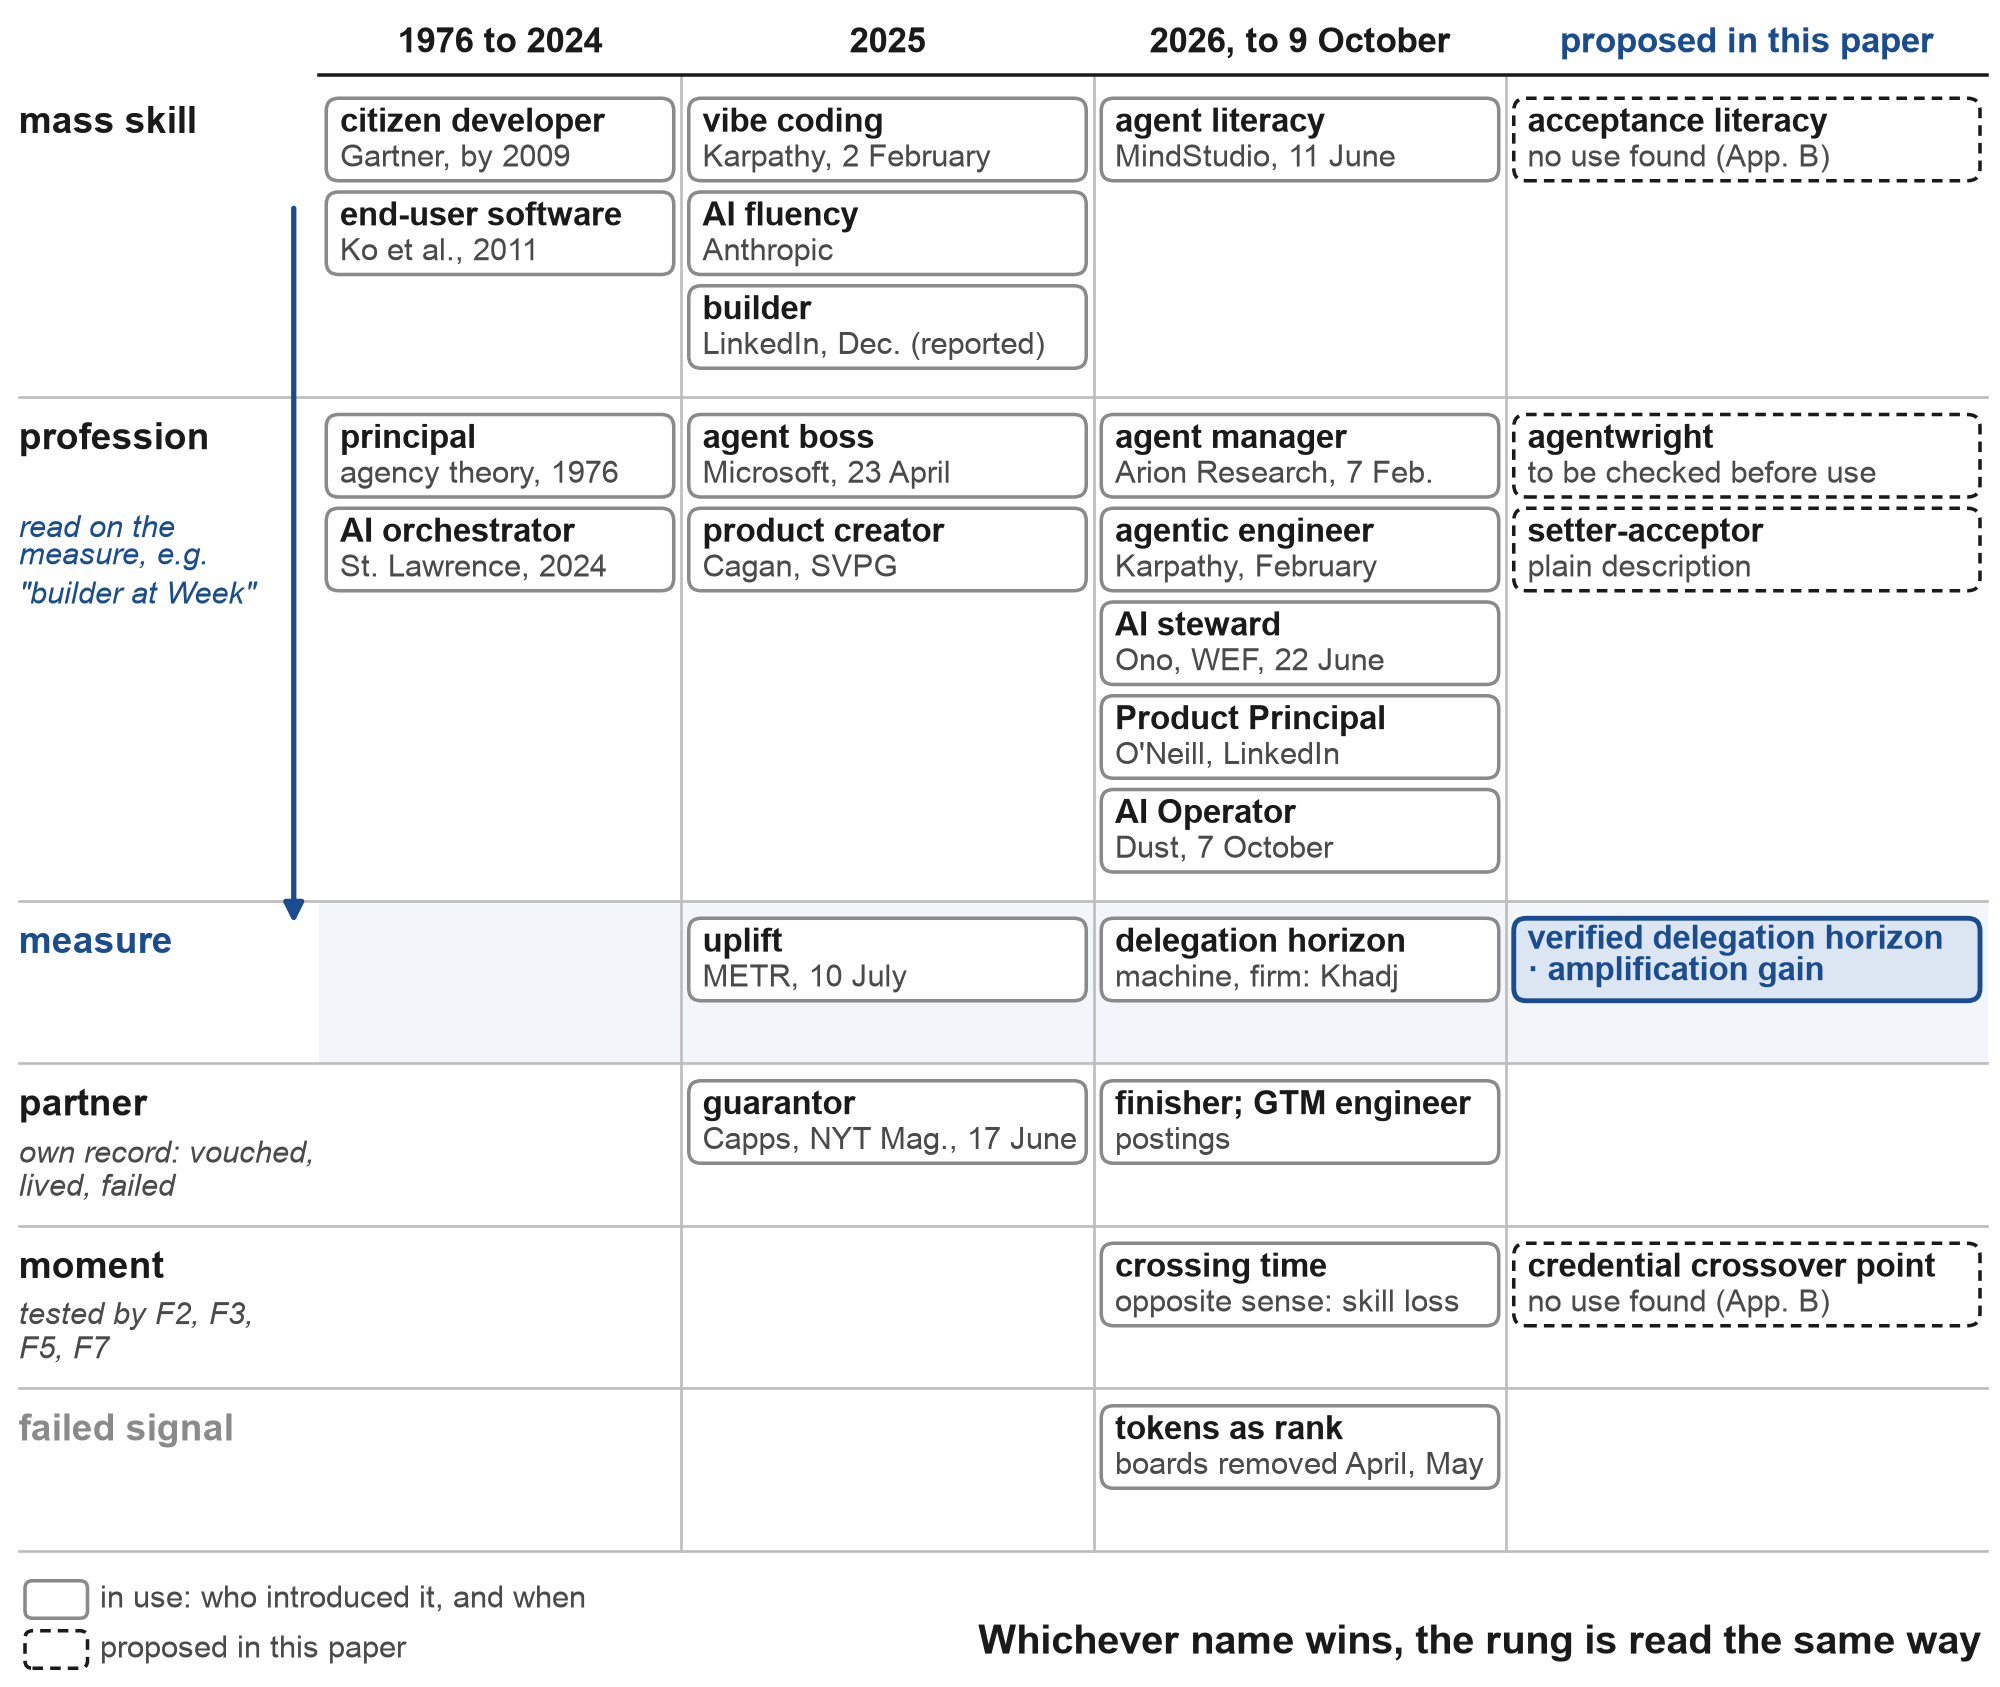
Nota: Los propietarios y fechas siguen la Tabla A2. Un nombre cuya fuente da solo un año no lleva mes. La figura es una selección; la Tabla A2 enumera cada candidato. Solo las capas de habilidad masiva y profesión se leen en la medida («constructor at Week», «gestor de agentes at Day», Sección 3.1). El socio tiene su propio registro, cuántos productos fueron avalados, cuánto tiempo vivió cada uno y cuántos fracasaron (Sección 7.2), y el momento no es un peldaño sino que se prueba por predicciones fechadas F2, F3, F5 y F7 (Sección 11.2). «Horizonte de delegación» en la fila de medida es el sentido de máquina o firma (Khadj, 2026; Alonso, 2026), no la medida personal de la Sección 5. La figura no lleva juicio sobre qué nombre prevalecerá.
3.3 Observaciones sobre el mapa
«Constructor» probablemente está ganando en HR masivo: LinkedIn la ha adoptado, y periodistas escribieron en 2026 que todos en el Área de la Bahía ahora son constructores (SF Standard, 2026). No hay razón para luchar contra la palabra, ya que no dice nada sobre el nivel y el nivel es lo que proporciona la medida.
Los nombres gerenciales (gestor de agentes, operador de IA, orquestador) son horizontales: describen la ejecución de agentes en general, en ningún dominio particular. La Sección 6.3 da la razón para esperar que sigan al ingeniero de prompts, un título que estaba en todas partes en 2023 y fue llamado obsoleto en 2025 (Fortune, 2025; TechRepublic, 2025).
«Principal» tiene la teoría más fuerte detrás de ella y las peores colisiones. En la teoría de agencia, el principal es la parte que delega y paga los costos de monitoreo (Jensen & Meckling, 1976), y la constitución de Anthropic para sus modelos llama «principales» a aquellos en cuyo nombre el modelo actúa (Anthropic, 2026b). Verheul (2026) argumenta que cuando las máquinas realizan la función de agencia, las personas en una firma solo ocupan posiciones principales y la escalera de carrera desaparece. Acepto el diagnóstico y propongo una nueva escalera en su lugar. En gestión de identidad y acceso, sin embargo, «agente principal» nombra la propia identidad del agente, lo contrario del sentido previsto, por lo que la frase en inglés «Agent Principal» no debe usarse para una persona. «Principal de Producto» de O'Neill es un precedente en casi este sentido y se cita como tal, y el marco AIDEs de JetBrains ya describe los niveles de desarrollador como propiedades de una relación principal-agente (Tikhomirov, 2026).
Los nombres propuestos aquí (agentwright, setter-acceptor, agent director) se unen a la familia como candidatos, ninguno de ellos favorito. Agentwright está disponible en las bases eruditas buscadas, pero los motores de búsqueda lo dividen en «Agent Wright», suena como una herramienta de prueba de navegador que los desarrolladores conocen, y para octubre de 2026 la palabra ya se usaba para un paquete de Python y un catálogo de habilidades de agentes, por lo que se mantiene como una variante que necesitaría un calificador.
Una observación sobre el significado puede registrarse sin quitarle la elección al mercado. Por sentido, «principal» está más cerca de la profesión de la Sección 8, trabajo realizado para otros con responsabilidad por el resultado, y «constructor» más cercano a la habilidad masiva, trabajo realizado para uno mismo.
4. Por qué una medida: el año en que los tokens se probaron como antigüedad
El mercado no esperó una escala. En 2026 probó varias, y porque los episodios difieren en naturaleza se mantienen separados aquí, en el orden en que ocurrieron.
En Meta, un empleado construyó un panel interno apodado «Claudeonomics» que clasificaba aproximadamente 85,000 colegas por tokens consumidos, más de 60 billones de ellos en treinta días (Shopifreaks, 2026a). Fue un proyecto de un empleado, sin estatus oficial, y fue retirado en abril después de que se reportara fuera de la empresa. La línea oficial de Meta se movió por separado. Desde febrero, el uso de IA fue parte formal de la evaluación de empleados, y a principios de septiembre WIRED y CIO reportaron nueva orientación según la cual Meta «no utilizará paneles de adopción de IA ni conteos de tokens para evaluar el impacto» e eliminó la etiqueta «AI Native» como criterio (CIO, 2026b; Shopifreaks, 2026b). En Amazon, una tabla de clasificación de uso de tokens fue manipulada con tareas vacías y retirada en mayo (CIO, 2026a), lo cual es la ley de Goodhart en su forma más pura: una vez que la medida se convirtió en objetivo, dejó de medir. El caso de Uber es un evento presupuestario. La empresa gastó su presupuesto anual de IA en cuatro meses e impuso un límite a los empleados de $1,500 al mes (Fortune, 2026b). En julio el director ejecutivo de Cognition dijo que las empresas deberían medir la productividad, no el uso de IA (Fortune, 2026c).
Los contraejemplos importan igual. Shopify añade preguntas sobre el uso de IA a sus evaluaciones de desempeño y revisiones por pares (Shopify, 2026), y un comentarista espera que las métricas de tokens sean «degradadas, no eliminadas» (Kingy AI, 2026). Las preguntas sobre cómo usa una persona la IA son algo diferente de una clasificación por volumen, y la predicción F8 en la Sección 11 las distingue.
Los hilos de desarrolladores examinados en la Sección 9 muestran el mismo instinto en personas individuales. Se presentan con datos: una factura mensual de IA de $1,148, una captura de pantalla de una suscripción, aproximadamente 330 de algunos 600 solicitudes de extracción realizadas (una unidad descrita en el hilo como muy aproximada), 36 etapas construidas en tres días. Uno de ellos publicó los ahorros que su agente había calculado para él sin verificar el cálculo, lo cual es el episodio de los tokens repetido por una persona. Cada uno de estos cuenta lo que se gastó o produjo; lo que fue aceptado, por quién y después de qué verificación, queda sin registrar.
Extraigo una lección directa para la medida: contar trabajo, y solo trabajo que superó una verificación que los agentes no vieron. El acuerdo entre modelos de la misma familia no puede ser esa verificación, porque sus errores están correlacionados y su acuerdo representa menos opiniones independientes de lo que aparenta (Chernets, 2026b). Gastar más tokens no puede inflar una medida construida de esta forma, ya que el trabajo no aceptado no añade nada a ella. Otras formas de inflación persisten, y la Sección 5.8 las enumera con sus defensas.
5. La medida: horizonte de delegación verificado y ganancia de amplificación
5.1 Horas de referencia
Ambos ejes utilizan una unidad, la hora de referencia: el tiempo que un especialista calificado necesitaría para realizar el mismo trabajo manualmente. La referencia es externa a propósito. El que la persona hubiera podido hacer el trabajo por sí misma no entra en la medida, tampoco su formación. Una herramienta de conciliación para un contable y un módulo de facturación para un desarrollador se miden ambas por lo que un profesional competente habría invertido en ellas.
Las horas de referencia provienen de una de dos fuentes. Una es un banco congelado de tareas cuyos tiempos manuales se midieron en 2025 y 2026; GDPval, con tareas extraídas de 44 ocupaciones y tiempos de sus expertos, muestra que tal banco puede construirse (Patwardhan et al., 2025). La otra es dos evaluadores independientes que estiman las horas sin saber quién hizo el trabajo; cuando los evaluadores de un dominio resultan estar demasiado alejados, la referencia puede ser en cambio la mediana de un panel calibrado de cinco a nueve evaluadores, puntuados por nivel (Apéndice G2). Congelo el banco deliberadamente, de la manera en que el metro estuvo una vez guardado en una bóveda cerca de París, porque en algunos años pocas personas seguirán haciendo estas tareas manualmente y no habrá nada contra lo que comparar. El banco debe contener, para cada dominio, tareas en cada nivel, cada una con una declaración escrita de qué cuenta como completado, tiempos medidos manualmente, las verificaciones ocultas, y algunos errores plantados cuya detección es parte de la aceptación. Los tiempos manuales de GDPval son auto-reportes verificados de expertos, mientras que sus tiempos de revisión fueron medidos, que es el estándar que un banco debe cumplir o mejorar. Para evitar que la medida se evalúe a sí misma, el horizonte se puntúa en un conjunto de tareas y la calidad utilizada para probar hipótesis sobre él (Sección 6) en otro.
5.2 El horizonte de delegación verificado
Definición. El horizonte de delegación verificado de una persona en un dominio es el tamaño máximo de trabajo, en horas de referencia, al que la persona entrega regularmente trabajo a agentes, lo acepta, y lo confirma mediante una verificación independiente que los agentes no vieron.
La regla en un párrafo. Un trabajo delegado cuenta como verificado, y entra en el horizonte, solo cuando se cumplen todos los siguientes requisitos. Se estableció con una declaración escrita de qué contará como completado, y sus horas de referencia provienen del banco o de dos evaluadores. La persona lo aceptó como un entregable coherente: un mes de trabajo dividido en 160 tickets de una hora es 160 Horas, mientras que el trabajo realizado en fases y aceptado como un todo cuenta como un todo, por las horas de referencia de ese todo. Una verificación independiente lo confirmó, y una verificación es independiente cuando difiere de los agentes en datos (entradas que los agentes no produjeron), en acceso (los agentes no podían verlo o editarlo) e incentivos (quien lo ejecuta no gana nada con un aprobado). Cuatro tipos califican: pruebas de aceptación ocultas, un revisor humano calificado, uso real por los usuarios previstos, o un modelo de otra familia que verifica contra fuentes que la persona abrió y deja un veredicto que puede ser auditado. La auto-revisión y el acuerdo entre modelos de una familia no cuentan, porque sus puntos ciegos coinciden con los de los propios agentes. Dentro de la ventana del nivel (91 días en Hora y Día, 182 en Semana, 365 en Mes y Trimestre), la persona aceptó el número requerido de piezas de al menos ese tamaño en el dominio (diez en Hora y Día, seis en Semana y en Mes y tres en Trimestre), y al menos ocho de cada diez pasaron, lo que significa cinco de seis en Semana y Mes y los tres en Trimestre. Desde Semana en adelante, al menos una de esas piezas contiene errores plantados. Un error plantado no detectado, de cualquier tipo, bloquea los niveles desde Semana en adelante para esa ventana, y la pieza que lo contiene no cuenta ni hacia un nivel ni hacia ganancia de amplificación. Cuando un error no puede deshacerse (dinero trasladado, el registro de un paciente, un trámite que no puede retirarse), cada una de estas piezas debe pasar, con una prueba oculta o un humano calificado como verificación predeterminada y un modelo de otra familia como segunda línea, y la regla más estricta se aplica solo a esas piezas. Cada entrega se registra, incluyendo fallos y piezas abandonadas, con la atención que requirieron. El nivel se confirma de nuevo cada trimestre: en Semana y superior, al menos una pieza verificada del tamaño del nivel debe caer dentro de los últimos 91 días, por lo que un horizonte no puede basarse en trabajo de hace casi un año. Los párrafos siguientes dan las razones para cada parte.
Regla de puntuación. Dentro de la ventana establecida para cada nivel (91 días para Hora y Día, 182 para Semana, 365 para Mes y Trimestre), un nivel cuenta si la persona aceptó el número requerido de piezas de al menos ese tamaño en el dominio (diez para Hora y Día, menos arriba, como se establece a continuación), y al menos ocho de cada diez pasaron una verificación de uno de estos tipos: pruebas de aceptación ocultas, un revisor humano calificado, uso real por los usuarios previstos, o un modelo de otra familia que verificó contra fuentes. La auto-revisión y el acuerdo entre modelos de una familia no cuentan. Cuando los errores no pueden deshacerse (dinero trasladado, el registro de un paciente, un trámite que no puede retirarse), cada una de estas piezas debe pasar, y el umbral más estricto se aplica solo a esas piezas. Para estas piezas, la verificación predeterminada es una prueba oculta o un humano calificado, con un modelo de otra familia como segunda línea.
Niveles superiores. Un único conteo de diez pondría los niveles superiores fuera del alcance de cualquiera, ya que diez piezas de 40 horas de referencia en tres meses son 400 horas de trabajo de un especialista, y diez piezas de 500 horas son 5.000. La regla por lo tanto alarga la ventana y reduce el conteo a medida que el nivel aumenta: diez piezas en 91 días para Hora y Día, seis en 182 días para Semana, seis en 365 días para Mes y tres en 365 días para Trimestre, con la misma proporción de ocho de diez (lo que significa cinco de seis para Semana y Mes, y los tres para Trimestre). Una versión anterior pedía cuatro de cuatro en Mes; la prueba de escritorio del Apéndice E mostró que esto hacía Mes más difícil de obtener que Trimestre para una persona de cualquier confiabilidad, y el conteo fue cambiado. Desde Semana en adelante, al menos una pieza del tamaño del nivel en la ventana debe contener errores plantados. Cualquier error plantado que la persona no detecte, sea cual sea su tipo, bloquea los niveles desde Semana en adelante para esa ventana, y una pieza con un error plantado no detectado no cuenta como verificada, ni hacia un nivel ni hacia ganancia de amplificación. Trimestre está destinado a seguir siendo un nivel raro, y los conteos anteriores se establecen de modo que así sea.
Cada entrega es registrada. El registro documenta cada pieza entregada a los agentes, incluyendo las que fallaron la verificación y las abandonadas antes de ella, y solo una pieza aceptada como un entregable coherente cuenta para un peldaño. Un mes de trabajo dividido en 160 tickets de una hora es 160 Horas, no un Mes: las horas de referencia se estiman para el entregable que el usuario, cliente o revisor acepta como un todo, en el espíritu de las tareas coherentes de METR. Lo inverso también se cumple: el trabajo realizado en etapas y aceptado como un entregable coherente cuenta como un todo, por las horas de referencia de ese entregable, sin importar cuántas etapas haya tomado.
Independencia. Una verificación es independiente cuando difiere de los agentes en datos (usa inputs que los agentes no produjeron), en acceso (los agentes no podrían verla o editarla) e incentivos (quien la ejecuta no gana nada de un resultado positivo). Un modelo de otra familia añade diversidad de errores. Solo cuenta cuando verifica contra fuentes que la persona abrió, y su veredicto es un input que puede ser auditado.
Una pieza de trabajo sigue esta ruta (Figure 3). Una tarea se establece con una declaración escrita de qué contará como realizado. Sus horas de referencia se toman del banco o de dos evaluadores. Los agentes realizan el trabajo mientras la persona dedica atención, lo cual es registrado. La persona acepta, rechaza o abandona la pieza, una verificación independiente confirma o refuta, y la línea del registro se escribe en ese momento, manteniendo la fecha de inicio como un campo separado donde importa. Donde existe un resultado retrasado (un documento aceptado, un lanzamiento aún en ejecución después de un mes), se registra cuando llega. El horizonte y la ganancia se calculan a partir de esos registros, con una fecha.
Figure 3. Una pieza de trabajo, un registro.
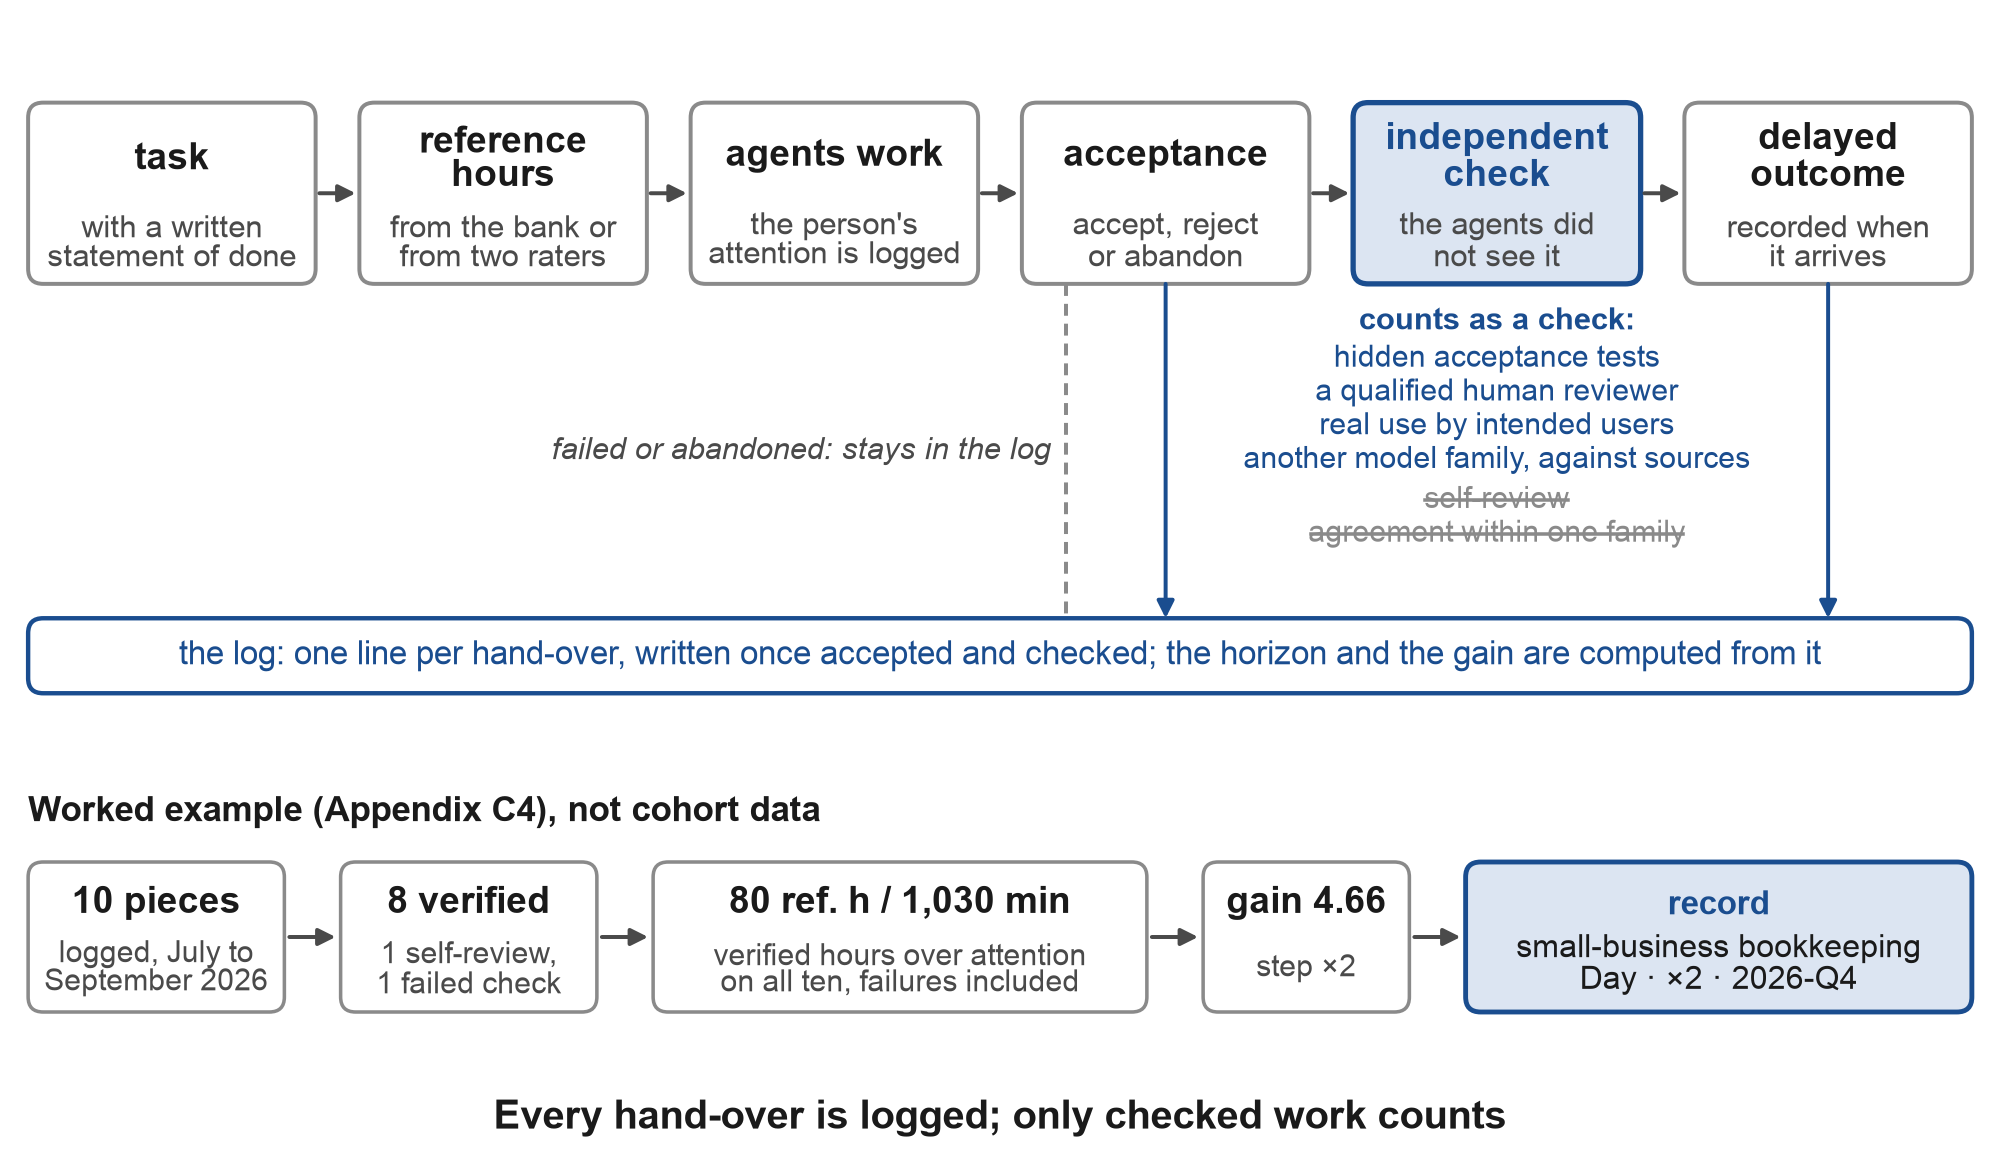
Nota: La fila superior es el camino de Section 5.2. Los cuatro tipos de verificación independiente son los de la regla de puntuación. La autorrevisión y el acuerdo entre modelos de una familia no cuentan. Las piezas fallidas y abandonadas permanecen en el registro y añaden sus minutos al denominador de la ganancia de amplificación. La fila inferior es el ejemplo trabajado de Appendix C4, un registro construido, no datos de cohorte: diez piezas, ocho verificadas, 80 horas de referencia contra 1,030 minutos de atención, una ganancia de 4.66 (step ×2) y el registro "small-business bookkeeping · Day · ×2 · 2026-Q4".
Re-verificación. Un horizonte se confirma nuevamente cada trimestre. La paradoja de la supervisión de Anthropic (Section 2.1) explica por qué: un horizonte ganado mientras la habilidad de verificación se deteriora es prestado, y una verificación trimestral muestra si aún se mantiene. Para los peldaños cuyos períodos se extienden más de un trimestre (Week, Month and Quarter), la verificación tiene una forma concreta: al menos una pieza verificada del tamaño del peldaño debe caer dentro de los últimos 91 días, para que un peldaño no pueda basarse en piezas próximas a un año de antigüedad.
5.3 La escalera
Nombro los cinco peldaños en unidades de tiempo porque las unidades de tiempo no necesitan traducción entre profesiones, pueden leerse en los registros, y crecen con la tecnología sin necesidad de renombrarse. Table 1 los proporciona con ejemplos y los recuentos que cada uno necesita.
Table 1. La escalera del horizonte de delegación verificada.
| Peldaño | Tamaño del trabajo entregado y verificado | Ejemplo en software | Ejemplo en otros lugares | Piezas verificadas necesarias, ventana |
|---|---|---|---|---|
| Hora | Aproximadamente 1 hora de referencia | Un script, una corrección pequeña | Respuestas extraídas de un conjunto de documentos | 8 de 10 en 91 días |
| Día | Aproximadamente 8 | Una característica, una herramienta interna pequeña | Un informe de fin de mes con sus verificaciones | 8 de 10 en 91 días |
| Semana | Aproximadamente 40 | Un sitio o herramienta interna según especificaciones, con ejecuciones durante la noche | Un paquete completo de debida diligencia, un sistema de campañas | 5 de 6 en 182 días |
| Mes | Aproximadamente 160, usualmente en varios flujos | Un lanzamiento de producto; reglas de aceptación por las que otros trabajan | Las herramientas de una práctica, con reglas que los colegas usan | 5 de 6 en 365 días |
| Trimestre | Aproximadamente 500 | Una línea de producto con usuarios activos | Una línea de servicio ejecutada a través de agentes | 3 de 3 en 365 días |
Nota: Un peldaño se gana solo por la regla de puntuación de Section 5.2, separadamente en cada dominio, con los recuentos de las reglas v1.1 (Appendix E). Ninguna calificación en una escalera antigua otorga un peldaño, y una persona puede estar en Week en herramientas financieras y en Day en aplicaciones web.
El registro para un currículum o un archivo de RR.HH. contiene el dominio, el horizonte, la amplificación y la fecha, por ejemplo "small-business bookkeeping · Day · ×2 · 2026-Q4". La fecha pertenece al registro porque el mismo peldaño significará algo diferente un año después, a medida que la tecnología evoluciona.
5.4 Ganancia de amplificación
No todos los que trabajan bien con agentes les entregan piezas grandes. Uno de los desarrolladores en Section 9, quien construye con cuatro máquinas, describe tres de ellas como "a boost of personal efficiency" sin agente autónomo en ellas. Los agentes autónomos que también ejecuta "did not take root" para trabajo diario, escribe, y prefiere "boost, not delegation" (translated). Su flujo más largo alcanzó 36 etapas en tres días, cada etapa entregada y comprometida, con el agente luego solicitado para confirmar que todo se había implementado. Por la regla de Section 5.2, esa confirmación es autorrevisión, por lo que su registro publicado no muestra ningún peldaño verificado en absoluto, y el hilo no proporciona números para su ganancia. Dónde se situaría con una verificación independiente depende de qué fue aceptado. Si las 36 etapas fueron aceptadas como un entregable coherente, el flujo cuenta como un todo, por sus horas de referencia, como lo hace el trabajo por etapas de Appendix C, section C4. Si cada etapa fue aceptada por su cuenta, cada una es una pieza pequeña y se sitúa en Hour en el primer eje. El post no especifica cuál. Sin embargo, construye herramientas que reemplazan software que solía comprar, y él mismo nombra el denominador del segundo eje cuando llama al tiempo el único cuello de botella.
No es una excepción. Anthropic informó que los usuarios con seis meses o más de experiencia tenían una "probabilidad mucho menor de delegar mayor responsabilidad mediante patrones de uso directivo", trabajaban con el modelo de forma más iterativa y planteaban tareas más difíciles, con un éxito de tres a cinco puntos más alto después de los controles (Anthropic, 2026d). En Claude.ai, el uso colaborativo superó la automatización 52% frente al 45% en noviembre de 2025, y las conversaciones tuvieron más éxito que las solicitudes programáticas de una sola pasada, 67% frente al 49% (Anthropic, 2026a). Las personas en ocupaciones mejor remuneradas realizaron aproximadamente 1,5 veces más turnos, y las mujeres automatizaron 7,3 puntos menos que los hombres en la misma ocupación (Anthropic, 2026f). En la encuesta de Stanford con 1.500 trabajadores, el arreglo más preferido en 47 de 104 ocupaciones fue una asociación equitativa entre persona y agente (Shao et al., 2025). Una medida construida únicamente sobre delegación subestimaría, por lo tanto, a los usuarios más experimentados, a los mejor pagados y a las mujeres, aunque nada en estos datos sugiere que su trabajo sea peor.
Definición. La ganancia de amplificación es las horas de referencia de trabajo aceptado y verificado divididas por las horas de atención de la persona empleadas en él, durante los últimos 91 días en el dominio, sea cual sea la ventana del escalón de la persona. El trabajo realizado con ayuda externa (un colega o contratista que lo corrige fuera del registro) se registra como tal y no añade nada al numerador, mientras que los minutos de la persona en él permanecen en el denominador. La atención abarca la planificación, la instrucción, la lectura, la verificación y la corrección. El tiempo que el agente funciona mientras la persona hace otra cosa no cuenta.
La ganancia de amplificación es un rendimiento verificado: producción aceptada y revisada por hora de atención. No es una estimación causal de cuanto más rápido trabaja la misma persona con agentes que sin ellos. Una ganancia en ese sentido comparativo necesita una línea base, la misma persona o personas equiparadas realizando el mismo tipo de trabajo sin agentes, y solo un estudio comparativo puede proporcionarla.
El trabajo fallido no añade nada al numerador y todos sus minutos al denominador, lo que mantiene visible el autoengaño. En el ensayo de METR de 2025, los desarrolladores experimentados creían que la IA los había acelerado, mientras que la medición mostró que eran 19% más lentos (METR, 2025).
Los pasos del segundo eje son ×1 ("un día por un día"), ×2, ×5 ("una semana por un día"), ×20 ("un mes por un día") y ×60 ("un trimestre por un día"). Las dos escalas son independientes, así que un paso en una no es igual a un escalón en la otra. Cuando una persona ejecuta varios agentes en paralelo, la atención se cuenta una sola vez, en los propios minutos de la persona: una hora dedicada a ver tres flujos es una hora en el denominador, compartida entre los elementos en proporción a los minutos registrados contra cada uno. Una puntuación se reporta junto con la configuración que la produjo (el modelo y las herramientas, el tipo de verificación y el escalón de las tareas), porque la misma persona obtendrá puntuaciones diferentes bajo una verificación más estricta.
5.5 Dos ejes, cuatro perfiles y un techo
Colocar a las personas en ambos ejes proporciona cuatro perfiles (Figura 4). Un aprendiz tiene un horizonte corto y una ganancia baja. Un amplificador tiene un horizonte corto y una ganancia alta, como el constructor de 36 etapas si sus etapas fueran aceptadas una por una. Un delegador tiene un horizonte largo y una ganancia alta. El cuarto perfil, al que llamo supervisor, es un horizonte largo con una ganancia baja: los agentes funcionan durante mucho tiempo, y la verificación y la revisión se comen el beneficio, así que es más una señal de advertencia que un escalón.
Los dos ejes están vinculados por un techo. La atención se dedica a plantear un trabajo y a verificarlo. Sea H las horas de referencia de un trabajo, V las horas de atención que cuesta verificarlo, y S las horas empleadas en plantearlo. Entonces la ganancia G = H / (S + V + revisión), y así G ≤ H / V. Si la verificación sola consume una cuarta parte del tiempo manual, la ganancia no puede exceder ×4, sin importar cuánto tiempo funcione el agente desatendido. Por el mismo límite, los pasos ×2, ×5, ×20 y ×60 están abiertos solo cuando la verificación consume no más del 50%, 20%, 5% y aproximadamente el 1,7% del tiempo manual (Figura 4). Este es un modelo simplificado con límites de contabilidad declarados: ignora el valor del trabajo que la persona no podría haber hecho en absoluto, asume que el tiempo de verificación se escala con el trabajo, y se mantiene por trabajo, así que una persona que verifica trabajos pequeños económicamente puede superar el techo calculado para trabajos grandes. A nivel de economía, Catalini et al. (2026) hacen el mismo punto: la restricción vinculante se convierte en "ancho de banda de verificación humana", y se abre una "Brecha de Medibilidad" entre lo que los agentes pueden ejecutar y lo que las personas pueden permitirse verificar.
GDPval muestra lo que el límite significa en la práctica. En su subconjunto de oro de 220 tareas, sus expertos informaron (y los autores verificaron) en promedio 404 minutos por tarea manual, y revisar un entregable tomó 109 minutos medidos, aproximadamente el 27%, lo que pone el techo cerca de ×3,7 para tareas de ese tipo. Los modelos produjeron sus borradores 90 a 327 veces más rápido que los expertos. Sin embargo, en el escenario donde una persona prueba el modelo y luego corrige su trabajo, el cálculo de los autores (no una medición) le dio a GPT-5 una aceleración de 1,12 cuando el modelo se prueba una sola vez y 1,39 cuando se prueba varias veces, dos columnas separadas de la misma tabla (Patwardhan et al., 2025). Sea cual sea la velocidad del agente, el precio de la verificación establece el techo, y ese precio sube con el escalón, ya que un trabajo más grande cuesta más verificar. Kamara (2026) llama a este costo fricción de verificación. Los profesionales en los hilos de la Sección 9 lo expresan en sus propias palabras: después de cierto punto, verificar el código del agente "difiere menos y menos de reescribirlo manualmente", y puede tomar más tiempo que escribirlo uno mismo (traducido).
La misma ganancia se puede lograr por dos caminos. Una correa larga entrega un trabajo grande y lo verifica al final; los bucles cortos y rápidos entregan trabajos pequeños y verifican cada uno cuando llega. Mi hipótesis es que verificar trabajos pequeños en el camino es a menudo más barato que verificar un resultado grande al final, y los datos de Anthropic apuntan en esa dirección. Las conversaciones tuvieron más éxito que las solicitudes de una sola pasada, y según la propia extrapolación de los autores, las solicitudes de una sola pasada alcanzan el 50% de éxito en tareas de aproximadamente 3,5 horas, mientras que las conversaciones lo lograrían en tareas de aproximadamente 19 horas (Anthropic, 2026a). La participación del uso colaborativo cayó por debajo de la automatización en agosto de 2025 y estaba de nuevo adelante, 52% frente al 45%, en noviembre. El camino del bucle corto es cercano a lo que estudia la literatura de colaboración humano-IA, y la ganancia de amplificación lo acredita tan plenamente como la delegación larga. Las predicciones F19 a F21 en la Sección 11 prueban el camino del bucle corto.
Figura 4. Dos ejes, cuatro perfiles y los techos que establece la verificación.
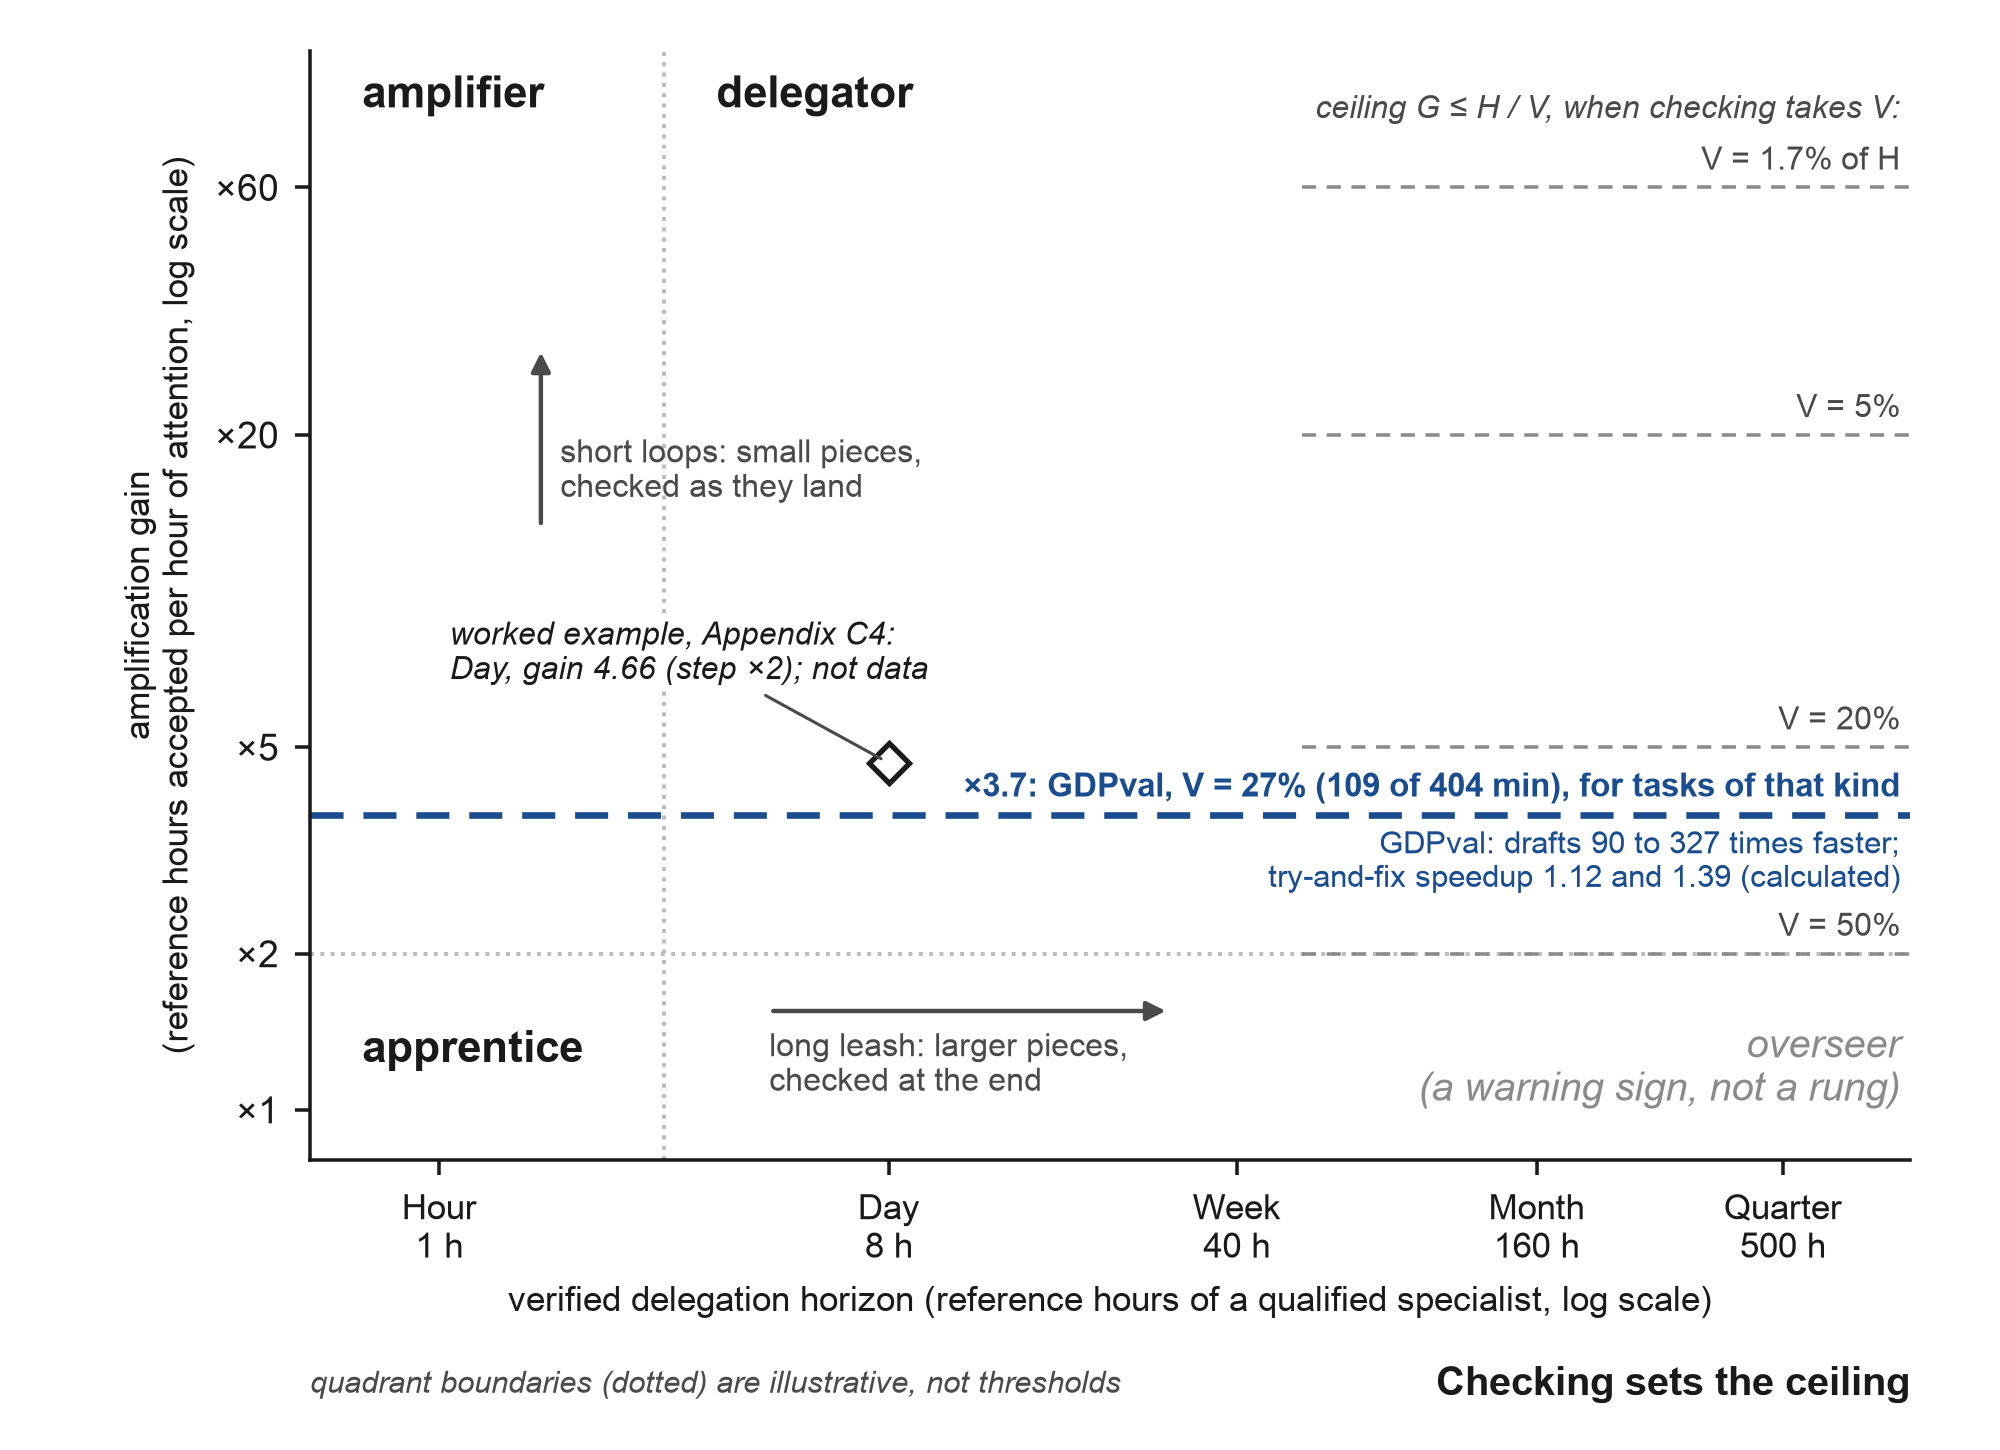
Nota: Los cuadrantes son perfiles, no escalones, y sus límites son ilustrativos. Cada línea gris es el límite G ≤ H / V de la Sección 5.5 para una proporción dada de tiempo de verificación V en tiempo manual H. La línea de énfasis utiliza los promedios de GDPval en su subconjunto de oro de 220 tareas, 404 minutos manuales y 109 minutos de revisión experta de la salida del modelo (Patwardhan et al., 2025), y se mantiene para tareas de ese tipo. Las aceleraciones 1.12 y 1.39 son el cálculo de los autores, no una medición. El diamante es el ejemplo resuelto del Apéndice C4, no datos. Se encuentra por encima de la línea de GDPval porque el techo se calcula por tipo de tarea, y pequeños fragmentos verificados económicamente pueden superar un techo calculado para los grandes (Sección 5.5). El caso de 36 etapas en la Sección 5.4 no se representa: la publicación no da ganancia ni verificación independiente.
5.6 De dónde viene la medida y qué es nuevo
La medida tiene antecedentes, y el más antiguo es Elliott Jaques, quien midió el nivel de cualquier trabajo, en cualquier función, por su período de discreción: el tiempo más largo que una persona trabaja por su propio criterio antes de que alguien revise el resultado. Argumentó que el salario justo aumenta con ese período (Jaques, 1956). El horizonte de delegación verificado lleva la idea a la era de los agentes con un cambio. Jaques midió cuánto tiempo trabaja una persona sin verificación, mientras que esta medida cuenta cuánto trabajo entrega una persona a los agentes, acepta y tiene verificado. Los dos pueden divergir, y sus estratos, contados en meses y años, no se mapean en estos escalones.
La teoría del agente principal es el segundo antecedente. Jensen y Meckling (1976) fijaron el precio de la delegación como monitoreo, garantía y pérdida residual. La verificación es el costo de monitoreo de entregar trabajo a un agente, y el horizonte marca el punto donde verificar una pieza más grande ya no es rentable.
METR mide máquinas en el mismo eje. Su horizonte de tiempo es la duración de la tarea, en horas humanas, que un modelo completa a una tasa de éxito determinada (Kwa et al., 2025). En primavera de 2026, el modelo fronterizo en su panel de control alcanzó aproximadamente 17 horas con 50% de éxito, aunque METR advierte que las mediciones por encima de 16 horas no son confiables con sus tareas actuales. El horizonte con 80% de éxito subió de aproximadamente 1,2 horas en febrero de 2026 a aproximadamente 3,1 horas en abril, dos puntos que ilustran el ritmo de crecimiento sin medir su tasa. La tendencia ajustada en el panel de control en todos los modelos desde 2023 se duplica aproximadamente cada 4,2 meses (128,7 días), y el panel de control no se había actualizado después del 8 de septiembre de 2026 cuando fue accedido por última vez (METR, 2026c). Los pronosticadores del Proyecto AI Futures trabajan con un tiempo de duplicación de 4 a 4,5 meses (AI Futures Project, 2026). El trabajo aceptado corresponde más al horizonte del 80% que al del 50%. La brecha entre lo que un modelo a veces termina y lo que termina de manera confiable es el trabajo de la persona, que es mostrar que un resultado es correcto y verlo hasta el final. La Figura A3 (Apéndice F) establece estos horizontes de máquinas contra los escalones.
La teoría de 2026 apunta a la misma brecha. Huang, Xiao y Vishnoi (2026) modelan la delegación bajo IA y encuentran que pequeñas diferencias en la capacidad de verificar producen grandes diferencias en los resultados: la IA ayuda a quienes verifican y daña a quienes entregan demasiado. Su artículo fue aceptado en ICML 2026, y llaman al efecto amplificación de verificación. Una revisión estructurada de 24 estudios encontró que ningún instrumento validado en su corpus focal cubre la combinación completa de habilidades necesarias para supervisar agentes (alcance, permisos, recuperación, revisión independiente y cierre basado en evidencia), aunque algunos instrumentos cubren partes de él (Veri', 2026). El marco de DeepMind para la delegación inteligente de IA describe la delegación en general y no contiene una medida a nivel de persona (Tomašev et al., 2026), y la economía de la delegación ahora tiene sus propios modelos fronterizos (Wang, 2026). Chen y Meng (2026) muestran que la IA generativa comprime las diferencias de habilidades dentro de una tarea y desplaza el valor hacia activos complementarios escasos, y añaden que los datos del panel persona-por-tarea necesarios para probar sus predicciones "aún no existen a escala". La medida que propongo produce datos exactamente de ese tipo, ya que cada pieza registrada lleva una persona, un tamaño y una fecha.
El segundo eje tiene sus propios vecinos, y la ganancia de amplificación es su forma verificada a nivel de persona. Engelbart (1962) enmarco la computación como aumentar el intelecto humano, y "superagencia" es la palabra de McKinsey para la misma esperanza en 2025 (McKinsey, 2025). El Índice Económico Anthropic califica las conversaciones por aceleración (tiempo sin IA dividido por tiempo con IA) y autonomía del agente en una escala de 1 a 5, ambas juzgadas por un modelo (Anthropic, 2026a). WORKBank de Stanford califica la participación humana que los trabajadores prefieren en una escala de H1 a H5 (Shao et al., 2025). Un ensayo de 2026 definió la capacidad de supervisión como salida verificada útil contra el esfuerzo humano y explícitamente declinó darle un número (em360, 2026), y "supervisión amplificada" es un término de seguridad de IA para ayudar a las personas a supervisar sistemas más fuertes que ellos mismos. La observación de un agente de búsqueda muestra el mismo cambio del tiempo humano hacia la verificación: el agente trabaja solo durante 26 minutos por sesión, donde una búsqueda simple tomó 33 segundos (Yang et al., 2026). En el lado de la delegación, Khadj (2026) y Alonso (2026) usan "horizonte de delegación" para qué tan lejos puede delegar una máquina o una firma, el trabajo CHI 2026 en "horizontes de decisión" estudia la pérdida de autodirección (Universidad de Lübeck, 2026), y Dawson (2026) y Metal Toad (2026) publican los niveles de delegación de IA de los profesionales. Ninguno de estos coloca a una persona en un nivel por trabajo que una verificación independiente confirmó.
El marco reciente más cercano se compara aquí directamente. El marco AIDEs de JetBrains Research (Tikhomirov, 2026) comparte dos características con la medida: trata la delegación como una relación de agente principal, y ordena la delegación en niveles, cinco de ellos, descritos por atributos como autonomía y planificación. Difiere en cuatro. Su tema es el desarrollo de software, mientras que el horizonte se califica en cualquier dominio. Sus niveles describen cómo se delega el trabajo, mientras que un escalón se establece por el tamaño del trabajo, en horas de referencia de un especialista calificado. No tiene regla de que la verificación sea independiente de los agentes, mientras que un escalón cuenta solo piezas confirmadas por una verificación que los agentes no vieron. Y no tiene recuento durante una ventana y no hay segundo eje, mientras que un escalón necesita una proporción de pase durante una ventana con fecha y la ganancia de amplificación agrega las horas de atención. El lenguaje de la agencia se comparte; la unidad, la regla de independencia y el alcance más allá del software son lo que este documento propone.
Muchas escalas fueron publicadas en 2025 y 2026, y ninguna de las escalas en la Tabla 2 mide a una persona por trabajo verificado. La Tabla 2 agrupa los principales por lo que miden; la Tabla A3 (Apéndice F) enumera cada uno de ellos.
Tabla 2. Escalas de 2025 y 2026, agrupadas por lo que miden.
| Familia | Ejemplos | Unidad medida | ¿Ubica a una persona por trabajo delegado verificado? |
|---|---|---|---|
| Niveles de autonomía de agentes y máquinas | Feng et al., 2025; Shapiro, January 2026; Memari & Rudolph, 2026; METR, 2025-2026 | El agente, el modelo o la configuración del equipo | No |
| Etapas de la práctica de un desarrollador | Yegge, 2026; Park et al., 2026; Microsoft, May 2026 | Práctica, trabajo de supervisión o patrones de trabajo | No |
| Delegación por organismos y empresas | Dawson, 2026; Metal Toad, 2026; Tomašev et al. (DeepMind), February 2026; Khadj, 2026 | Un organismo, un gestor, una empresa o delegación en general | No |
| Delegación de desarrollador como relación principal-agente | JetBrains Research (Tikhomirov), September 2026 | Delegación de un desarrollador | Solo desarrolladores; sin regla de independencia para verificaciones y sin unidad de tamaño |
| Marcos de competencia y alfabetización | AI Certification Standards, 23 August 2026; Anthropic AI Fluency, 2025b | Competencias o alfabetización | Sin examen, umbrales o niveles |
| Horizonte de delegación verificado y ganancia de amplificación | This paper | Una persona en un dominio | Sí, por la regla de la Sección 5.2 |
Nota: "Ubica a una persona por trabajo delegado verificado" significa que la escala coloca a un individuo en un nivel por el tamaño del trabajo entregado a agentes y confirmado por una verificación que los agentes no vieron. El vecino más cercano es los cinco niveles de JetBrains: comparten el lenguaje de principal y agente, y difieren en la regla de verificación (una verificación independiente que los agentes no vieron) y en la unidad (horas de referencia). La Tabla A3 (Apéndice F) enumera cada escala por separado.
Un practicante planteó bien la objeción a cualquier escala personal: "tu nivel de autonomía es una propiedad del repositorio, no del desarrollador ni del modelo" (Phoenix, 2026). Acepto la mitad de eso. Un horizonte pertenece a una persona, en un dominio, bajo un régimen de verificación, y un repositorio bien construido con pruebas ocultas es parte de ese régimen, lo que es una razón por la cual el horizonte se registra por dominio y con una fecha.
5.7 Dos preguntas del documento complementario
El documento complementario dejó abierta la pregunta de por qué los usuarios experimentados delegan menos, si se quemaron o si su juicio es el producto (Chernets, 2026a). El segundo eje puede diferenciar los dos. Si la proporción de uso directivo disminuye mientras la ganancia verificada aumenta, el juicio es el producto; si la ganancia también disminuye, se quemaron. El documento complementario también preguntó si el vocabulario de delegación es una gramática o una por profesión. Adopto una posición: la gramática es una (establecer la tarea, luego aceptarla basándose en evidencia), mientras que lo que cuenta como evidencia difiere por dominio, por lo que los peldaños se comparten y la puntuación ocurre por dominio.
El instrumento del Apéndice C reporta una proporción directiva para cada persona y dominio, contada en piezas (la proporción de piezas entregadas en una sola pieza, contra etapas o trabajo conjunto), por lo que se puede ejecutar una primera prueba aproximada en los mismos registros que dan los peldaños. La Predicción F20 establece la prueba con una fecha en su medida registrada, la "proporción de turnos de una persona que dan instrucciones en lugar de verificar o editar, del registro" (Tabla A6): allí la proporción se cuenta sobre los turnos del registro de sesión en lugar de sobre las piezas del registro de trabajo del Apéndice C, por lo que es la más fina de las dos cuentas.
5.8 Cómo se puede falsificar la medida y las defensas
Contar el trabajo aceptado e independientemente verificado cierra la ruta más barata, gasto, pero una persona decidida o un empleador persiguiendo un objetivo aún tiene otras. La Tabla 3 las enumera con la defensa que proporcionan las reglas. Las defensas cuestan algo, y el costo es parte del diseño: un peldaño auditado vale más que uno autorreportado, de la misma manera que una cuenta auditada vale más que una declaración.
Tabla 3. Formas de falsificar la medida y las defensas.
| Ruta | Cómo se ve | Defensa |
|---|---|---|
| Verificaciones fáciles | Pruebas ocultas que una solución débil aprueba; un revisor que hojea | Auditoría aleatoria de una proporción de piezas aceptadas por un segundo verificador independiente; errores plantados de la Semana en adelante; el tipo de verificación se imprime junto a la puntuación |
| Elegir tareas justo por encima de un umbral | Muchas piezas de 8.1 horas de referencia para alcanzar Día | Peldaños leídos de la distribución de tamaños, con el tamaño aceptado mediano reportado junto al peldaño |
| Calificadores generosos de horas | Calificadores que inflan horas de referencia | Dos calificadores ciegos a la persona; desacuerdo por encima de una proporción fija envía la pieza al banco congelado o a un tercer calificador; registros de calificadores auditados |
| Ayuda oculta | Un colega o contratista arregla el trabajo fuera del registro | Atención registrada por pieza; entrevistas aleatorias o repeticiones; ayuda externa registrada como campo y excluida de la ganancia de la persona |
| Corte | Un mes de trabajo cortado en boletos de una hora | Solo un entregable coherente, aceptado como un todo, cuenta hacia un peldaño |
| Ocultación de fallos | Piezas abandonadas o fallidas dejadas fuera del registro | Cada entrega registrada, con su fecha de inicio, y cerrada cuando se acepta, rechaza o abandona; un registro público de fallos; una tasa de aprobación que se ve demasiado limpia desencadena una auditoría |
| Verificación correlacionada | Un segundo modelo de la misma familia que coincide | No contado (Sección 5.2) |
| Transmisiones paralelas | Atención contada una vez por transmisión | Atención contada una vez por persona-minuto (Sección 5.4) |
Los umbrales son opciones de diseño, versionados como reglas v1.1 y cambiados solo en una nueva versión después de datos. Diez piezas en una ventana es el número más pequeño en el que una tasa de aprobación del 80% significa algo (ocho aprobaciones de diez). La ventana de 91 días de los escalones inferiores, y de la pieza reciente requerida en los superiores, coincide con la reverificación trimestral y el ritmo al que cambian las herramientas. La regla del escalón es una regla de calificación y no estima la confiabilidad de una persona. Ocho aprobaciones de diez son consistentes con una tasa de aprobación verdadera entre aproximadamente 44% y 97% (intervalo exacto del 95%), y tres de tres con una tan baja como aproximadamente 37% (límite unilateral del 95%). El estudio de calibración registrado estima la confiabilidad. La proporción del 80% sigue el uso de METR del horizonte del 80% como el nivel de trabajo confiable, y los escalones de 1, 8, 40, 160 y 500 horas siguen la hora de trabajo, día, semana, mes y trimestre, para que no necesiten traducción entre profesiones. Una prueba de escritorio de los umbrales verificó las reglas mediante simulación y con calificadores de modelo (Apéndice E). Calculó con qué frecuencia una persona de confiabilidad conocida gana cada escalón (Figura A2, Apéndice E). Con una tasa de aprobación verdadera de 0,8, Día se gana en el 68% de las ventanas y el mismo veredicto se repite en la siguiente ventana en el 56%, por lo que el registro imprime el recuento junto al escalón, como en "Día (8/10)". También encontró un error en la primera versión de las reglas: cuatro de cuatro en Mes era más difícil de ganar que tres de tres en Trimestre (41% contra 51% con una tasa de aprobación de 0,8), por lo que Mes ahora solicita cinco de seis en un año. Mover el recuento de diez a ocho o doce, o la proporción de 0,8 a 0,7 o 0,9, cambia el veredicto de Día para 8% a 11% de registros simulados, y mover ambos lo cambia hasta 22%. Cuatro calificadores de modelo de cuatro familias, estimando horas de referencia a ciegas, ordenaron 30 tareas de manera consistente (correlación intraclase de 0,89 en horas de registro) pero colocaron solo el 62% de pares dentro de una proporción de 1,5, contra el criterio del protocolo de calibración del 70%, y diferían por un factor de dos en su nivel general; dado solo un identificador público de tarea, su estimación media cayó dentro de 1,5 de tiempos humanos medidos para 3 de 14 tareas. Los calificadores de modelo, por lo tanto, no pueden reemplazar a los dos calificadores humanos, y los calificadores del estudio de campo calibran primero en tareas con tiempos medidos. El protocolo de calibración fija las siguientes pruebas de antemano: acuerdo entre calificadores humanos (criterio: al menos 70% de pares dentro de 1,5), repetibilidad del escalón de una persona en dos ventanas consecutivas (kappa ponderada de al menos 0,6), y la capacidad del escalón para predecir el paso de nuevas tareas del mismo tamaño (AUC de al menos 0,7). Su protocolo y texto de registro están en el repositorio complementario, y una primera prueba con profesionales en activo, de su acuerdo en horas de referencia, está registrada y descrita en el Apéndice G.
La Tabla A4 (Apéndice F) proporciona la regla para los casos difíciles que surgen primero.
El Apéndice C, sección C4, recorre el registro de una persona de diez líneas hasta el único registro que produce.
6. Neutralidad de antecedentes y el punto de cruzamiento de credenciales
6.1 Neutralidad de antecedentes
La hipótesis es que en un horizonte verificado equivalente en un dominio, una educación en programación no predice la calidad del trabajo verificado independientemente una vez que se tienen en cuenta el dominio del campo y la alfabetización de aceptación.
El hallazgo de Anthropic de que "la capacidad de dirigir a Claude hacia el éxito proviene más del dominio del campo que de la capacidad de escribir código" es consistente con la hipótesis pero no la pone a prueba (Anthropic, 2026e): sus datos clasifican a las personas por ocupación, no por educación, y la brecha del 34% frente al 29% de la Sección 2.2 es una brecha entre ocupaciones. Solo el estudio de F7 pone a prueba la hipótesis. También existe un fuerte rival. Savva (2026) modela el trabajo de conocimiento aumentado por IA como un problema de principal-agente y predice que la IA reduce las brechas entre personas en tareas fáciles y las amplía en tareas difíciles. Si Savva tiene razón, la neutralidad de antecedentes se mantendrá en tareas cortas y fallará en los escalones superiores, por lo que la predicción F7 se califica por separado en Día y en Semana y superior, donde la hipótesis enfrenta su prueba más difícil.
La alfabetización de aceptación es la habilidad en la que se basa la hipótesis. Significa establecer de antemano qué contará como hecho, y luego demostrarlo: a través de una prueba oculta, una segunda familia de modelos que verifican contra fuentes, una comparación con una fuente que la persona abrió ella misma, o un artefacto en lugar de una garantía. La alfabetización de agentes cubre la delegación, verificación y gestión en general (MindStudio, 2026); la alfabetización de aceptación pone un estándar de prueba en su centro. También difiere de la aceptación tecnológica en el sentido de la tradición TAM, que estudia si las personas adoptan una tecnología, ya que aquí la aceptación es la decisión de aceptar un trabajo. El registro de aceptación del documento complementario se convierte en la unidad de evidencia para un escalón.
6.2 El punto de cruzamiento de credenciales
El punto de cruzamiento de credenciales en un dominio es el momento en que los productos realizados por personas sin educación en TI, aceptados bajo las mismas verificaciones independientes, comienzan a superar los realizados por programadores que usan los mismos agentes, después de lo cual un grado en TI y las etiquetas junior y senior pierden su peso predictivo en la contratación para ese dominio.
Esta definición es mi pronóstico del 8 de octubre de 2026 hecho exacto (Sección 1). Sus componentes son cada uno observable y cada uno fechado por su cuenta, de modo que el momento se puede leer cuando se alinean. La paridad de calidad es el paso anterior al momento: en un dominio, los productos de personas sin educación en TI no son peores que los de programadores con los mismos agentes, en las mismas tareas, bajo verificaciones ciegas (predicción F2). El adelantamiento es el momento en sí, cuando esos productos se vuelven mejores en las mismas verificaciones (F3, con las etapas de lanzamiento y mantenimiento en F4a y F4b). El cruzamiento en las publicaciones es la señal visible, cuando las publicaciones que piden habilidades de agentes requieren un grado con menos frecuencia que las publicaciones comparables que no lo hacen (F5). La neutralidad de antecedentes es el mecanismo, ya que en un escalón equivalente la educación deja de predecir la calidad verificada (F7).
El punto de cruzamiento en un dominio se fecha por el primer año en el que, en ese mismo dominio nombrado, se muestra el adelantamiento (F3) y se cumple el análogo del dominio del cruzamiento en las publicaciones (F5 calculado en las publicaciones de ese dominio; Apéndice D). La paridad sin adelantamiento es el acercamiento al punto, y un cruzamiento en las publicaciones sin adelantamiento mostraría a los empleadores adelantándose a la evidencia. F2, F3, F5 y F7 por lo tanto forman un programa sobre los mismos dominios nombrados: los dominios se fijan en el registro, el experimento de F2, F3 y F7 se ejecuta en ellos, y F5 se calcula tanto en el conjunto congelado de ocupaciones en TI como en las publicaciones de cada uno de esos dominios. El punto de cruzamiento se declara para un dominio solo cuando tanto la regla de calidad (F3) como la regla de contratación (el análogo del dominio de F5) se cumplen en ese mismo dominio; cualquiera de los dos solo no declara nada.
Los dos primeros componentes se prueban mediante experimentos en tareas emparejadas (Sección 11). El tercero ya se puede observar en las publicaciones de empleos. Lightcast reportó en septiembre de 2026 que las publicaciones de TI que requieren habilidades de IA aún tienen más probabilidad de solicitar un título de cuatro años que las publicaciones de TI sin ellas. Sin embargo, entre las publicaciones de IA, los requisitos de grado han estado en "claro declive desde 2024" mientras que aumentaron en otras publicaciones de TI (Lightcast, 2026b). Las dos líneas están convergiendo y no se han cruzado (Figura 5). Lightcast define las publicaciones de IA por más de 300 habilidades de IA, por lo que sus líneas describen el trabajo de IA en general. El subconjunto de agentes, definido por una lista congelada de habilidades de agentes (Lightcast, 2026a), es el que usa la predicción, y su línea base se toma antes del registro.
La dirección tiene un precedente. Bone, González Ehlinger y Stephany (2025), utilizando aproximadamente once millones de vacantes del Reino Unido hasta mediados de 2024, encontraron que los requisitos de educación disminuyeron en roles de IA y compararon las primas salariales adjuntas a habilidades y grados. Ese trabajo documentó la contratación basada en habilidades para IA antes de los agentes. Este artículo extiende esa línea a habilidades de agentes, con un umbral fechado y una comparación con publicaciones emparejadas, y propone vincular los requisitos de publicación con el desempeño verificado independientemente, en pruebas que se deben preregistrar. El Barómetro de Empleos en IA de PwC informa la misma dirección en todos los países y sirve como fuente de respaldo dondequiera que mida la misma cantidad (PwC, 2026).
Un segundo indicador es la distancia entre lo que dicen los empleadores y lo que hacen. Muchos empleadores eliminaron los requisitos de grado de sus políticas antes de que llegaran los agentes, sin embargo, el Instituto Burning Glass y la Escuela de Negocios de Harvard encontraron que el cambio afectó a menos de una contratación en 700 (Instituto Burning Glass & Escuela de Negocios de Harvard, 2024). Las publicaciones se movieron en sentido contrario: en noviembre de 2025, el 19,3% de las publicaciones estadounidenses en Indeed solicitaban una licenciatura o superior, considerablemente más que un año antes (Indeed Hiring Lab, 2026). Un requisito de grado eliminado en papel es un cambio de política, y el cruzamiento se muestra solo cuando la contratación misma cambia. Un estudio de auditoría, enviando portafolios emparejados que difieren solo en educación a publicaciones reales, vería eso primero, y la predicción F26 establece uno.
Un título pertenece a una familia de puertas que admiten a las personas por una etiqueta: un perfil en una plataforma, un puesto de trabajo, un título y, en parte, una licencia. Una etiqueta le dice a un empleador sobre el trabajo solo en la medida en que tenerla va vinculado con la capacidad de hacer el trabajo. Los agentes aflojaron ese vínculo desde un lado, ya que ahora las personas sin la etiqueta producen trabajo que parece el del oficio (Sección 2.2), y una etiqueta que descansa en la palabra de una persona siempre fue barata de reclamar. Una puerta que verifica el trabajo en sí mismo no depende de ninguna de las dos. El estudio de evaluadores del Apéndice G se encontró con la diferencia por accidente. Prolific admite participantes a un estudio a través de filtros cuyas respuestas son mayormente autoinformadas, siendo la edad y el país de residencia las principales excepciones que verifica (Prolific, 2026). De las 60 personas que sus filtros admitieron en la muestra de contabilidad, 11 respondieron incorrectamente una pregunta de la primera semana del oficio (Apéndice G2): la etiqueta los dejó entrar, y una pregunta del oficio los detuvo.
Los investigadores que reclutaron programadores en tales plataformas antes de los agentes reportaron el mismo patrón y seleccionaron con preguntas de conocimiento propias: en un estudio, el 42% de los trabajadores de una plataforma que afirmaban tener habilidades de programación no cumplieron con los criterios de tales preguntas (Danilova et al., 2021), y en otro, en Prolific, 55 de los 206 encuestados que reportaron programación en Node.js aprobaron todas sus preguntas de programación (Reid et al., 2022). Una pregunta de conocimiento es en sí misma una puerta más débil que una verificación del trabajo entregado, y los modelos de chat también la debilitan: en un ataque simulado, ChatGPT resolvió fácilmente las preguntas de selección existentes para programadores (Serafini et al., 2024), y en 2026 también pasó las preguntas visuales estáticas que habían sido diseñadas para resistirse, mientras que las preguntas de audio que revelan su contenido paso a paso bajo un límite de tiempo estricto aún se mantuvieron (Serafini et al., 2026). En términos de contratación, la pérdida de peso que la definición anterior predice para un título es una puerta del primer tipo que da paso a una puerta del segundo tipo, y el horizonte de delegación verificado es una puerta del segundo tipo: registra no lo que una persona dice que es, sino lo que entregó y lo que pasó una verificación que los agentes no vieron.
Las licencias se encuentran entre los dos tipos. Una licencia que descansa en un examen aprobado una vez funciona, a partir de entonces, como una etiqueta; una licencia cuyo trabajo del titular es inspeccionado está más cerca de una verificación. Las firmas de auditoría registradas con la Junta de Vigilancia de Contabilidad de Empresas Públicas en los Estados Unidos tienen su trabajo de auditoría inspeccionado, cada año si auditan regularmente más de 100 emisores y al menos una vez cada tres años de otra manera, a menos que la Junta establezca otro cronograma por regla (Ley Sarbanes-Oxley de 2002, s. 104), un contraparte más lento, para el trabajo firmado de una firma, de la reverificación que la Sección 5.2 pide de un horizonte. La licencia en sí ha comenzado a moverse hacia el segundo tipo. Desde mayo de 2024 Oregon ha ofrecido a los graduados de derecho una ruta hacia la licencia sin el examen de barras, el Examen de Cartera de Práctica Supervisada: durante al menos 675 horas de práctica supervisada el candidato presenta ocho piezas de trabajo escrito, dos interacciones con clientes y dos negociaciones, y los calificadores que aplican rúbricas de la Junta de Examinadores de Barras juzgan si cada una muestra competencia mínima. Para el 5 de enero de 2026, 205 candidatos habían solicitado y 49 se habían convertido en abogados licenciados, el primero de ellos en diciembre de 2024 (Junta Estatal de Examinadores de Barras de Oregon, 2026). El título de derecho aún se requiere, por lo que el trabajo verificado reemplaza el examen, no la escuela. En contabilidad el movimiento es menor: en mayo de 2025 la AICPA y NASBA aprobaron legislación modelo para una ruta hacia la licencia de CPA que pide un segundo año de experiencia profesional en lugar de 30 horas de crédito de estudio más allá de una licenciatura, con el examen mantenido, y cada estado debe promulgarlo antes de que los candidatos puedan usarlo (Journal of Accountancy, 2025). Lo que la ley se reserva a una licencia sigue siendo un límite de la medida (Sección 13). La Tabla A8 (Apéndice F) pone las puertas de esta sección lado a lado por lo que cada una verifica.
El término "credencial" tiene un segundo significado en la seguridad de agentes, donde denota una clave secreta o un token. Aquí significa un título o certificado. La frase "punto de cruce de credencial" en este sentido no devolvió coincidencias en las bases académicas buscadas el 9 de octubre de 2026 (Apéndice B).
Figura 5. La brecha en el éxito verificado y el requisito de título en los anuncios: lo que se observa y lo que 2027 probará.
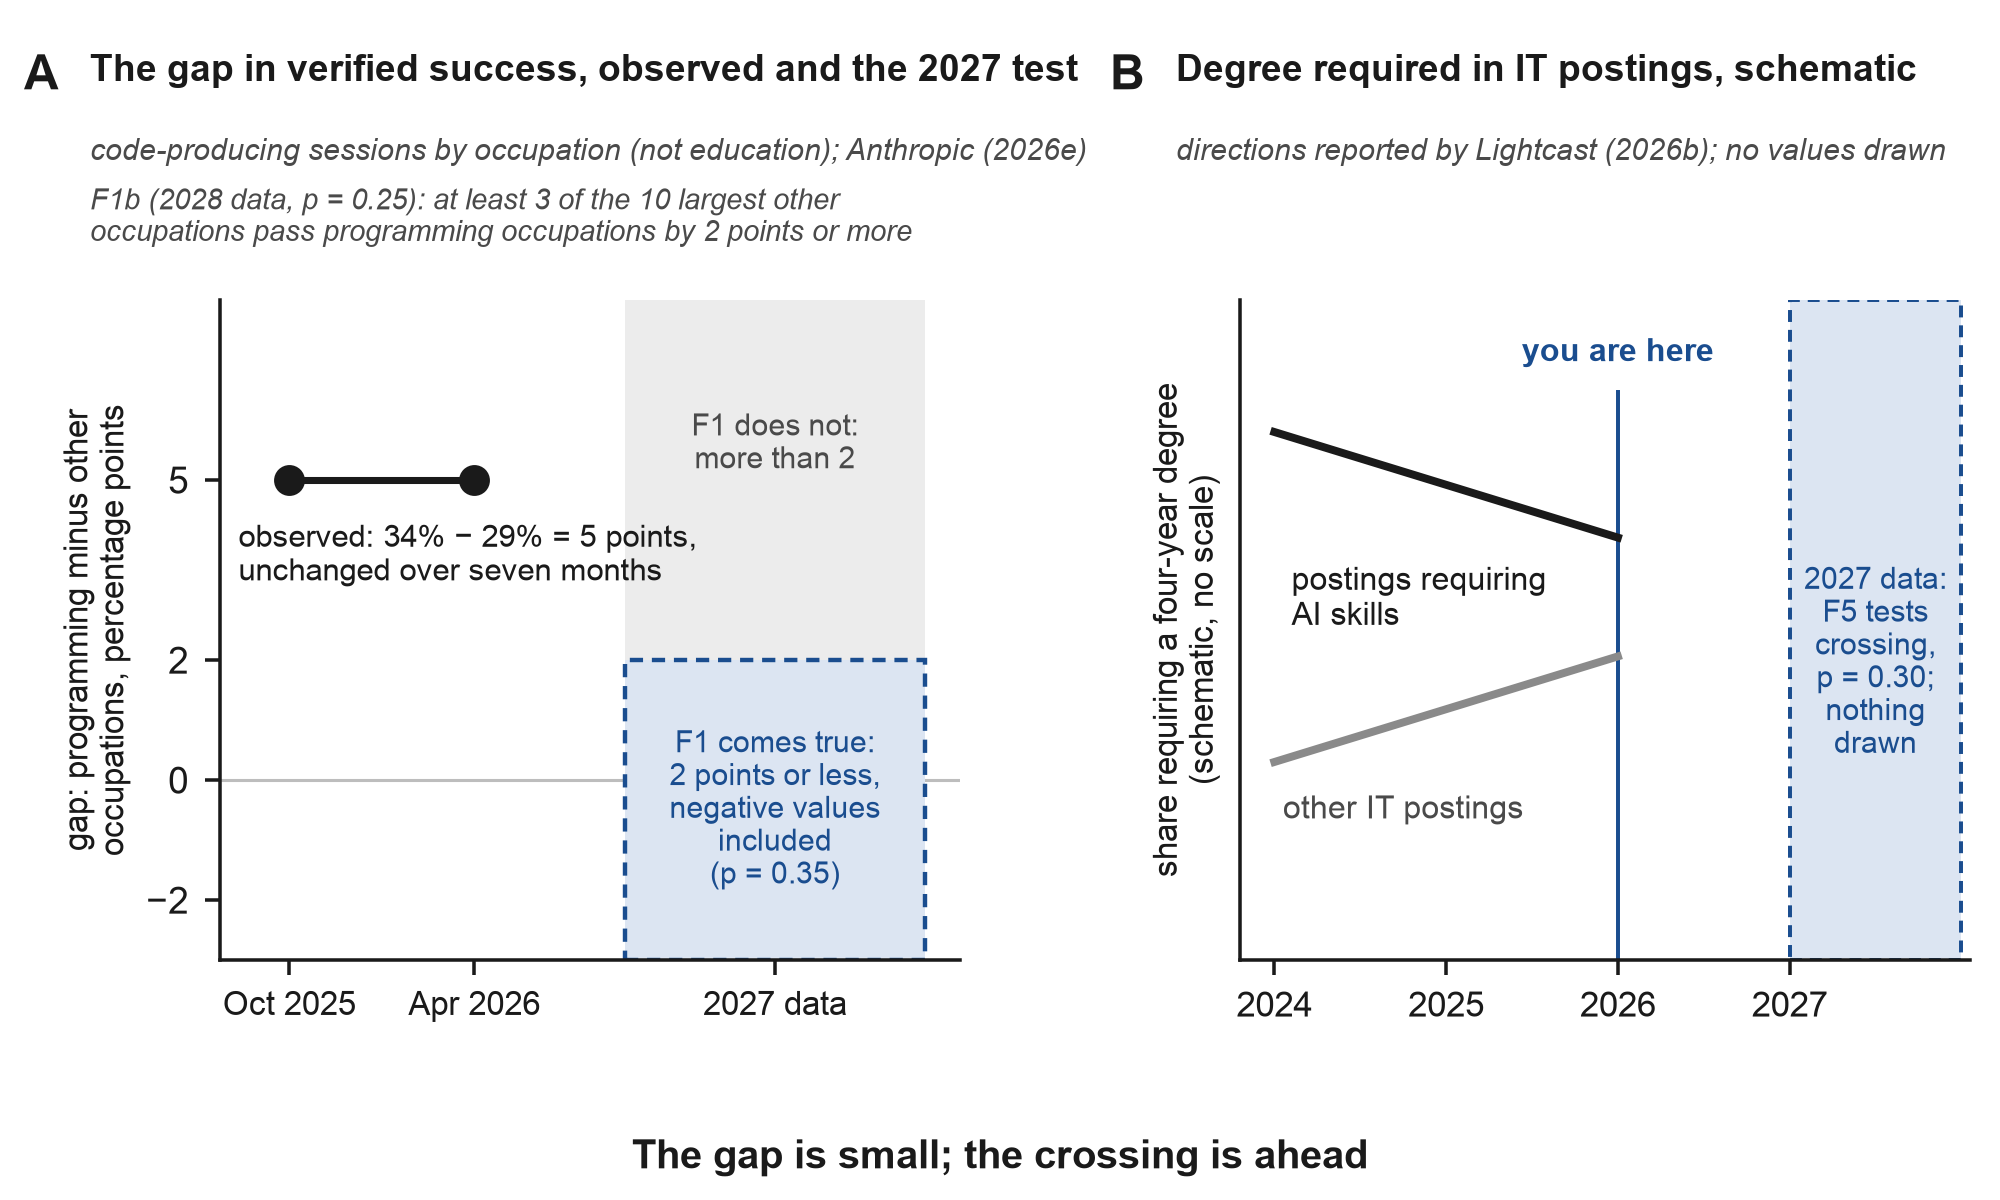
Nota: El Panel A utiliza Anthropic (2026e), sesiones que producen código, 34% para ocupaciones de programación contra 29% para otras ocupaciones, sin cambios durante siete meses. La ocupación no es educación, y el éxito significa logro respaldado por evidencia como pruebas o commits. La banda es el umbral de predicción F1 (una brecha de 2 puntos o menos, valores negativos incluidos, probabilidad 0.35); F1b (probabilidad 0.25) está en la Tabla A6. El Panel B dibuja solo las direcciones que Lightcast (2026b) reportó hasta 2026, sin sus valores. La ventana de 2027 se deja vacía: no se dibuja ningún cruce, porque la predicción F5 (probabilidad 0.30) es lo que lo decidirá.
6.3 Dominios: por qué la ventaja del programador fue horizontal
Lo que la IA abarata primero es lo que es horizontal, lo mismo en cada industria, y el mecanismo es evidente: una capacidad que se transfiere entre industrias es una que un modelo de propósito general puede suministrar a todas a la vez. Los finos envoltorios sobre un modelo, el software de propósito general y la habilidad general de escribir código han seguido ese camino. El ingeniero de prompts, el título más de moda de 2023, fue declarado obsoleto en 2025 porque la habilidad se disolvió en las herramientas y pasó a ser de todos (Fortune, 2025). La antigua ventaja del programador también era horizontal. El código funciona en cualquier industria, así que un programador podría crear para un bufete de abogados o un hospital sin conocer ninguno, y los agentes, al abaratar el código, están quitando esa ventaja. Nadie tuvo que convertirse en programador para que esto sucediera. El software se convirtió en una vertical más entre muchas (con infraestructura y seguridad como vecinos cercanos), y dentro de ella los programadores siguen siendo los más fuertes. La misma lógica se aplica a las personas como a las firmas: una persona sin una vertical es un envoltorio sobre IA, tan expuesta como un producto de envoltorio delgado. Cuando los agentes hacen que el software de propósito general sea más fácil de construir, el antiguo software vertical puede enfrentar presión desde dos lados, desde los laboratorios, que toman la capa de información, y desde los profesionales que construyen sus propias herramientas. La hipótesis es que el conocimiento del dominio unido a la capacidad de aceptar trabajo de agentes gana valor. La verticalidad por sí sola no protege a nadie; la profundidad sí, es decir, la capacidad de aceptar trabajo en el dominio que un modelo o un recién llegado no puede falsificar.
Una vertical aquí es un dominio donde una persona puede aceptar el trabajo de un agente, y puede o no ser donde tienen un título. Aceptar trabajo legal requiere conocer la ley lo suficientemente bien para detectar un error plausible. Un desarrollador en los hilos de la Sección 9 lo dice claramente: para ver que un resultado es un sinsentido, necesitas saber al menos un poco del campo (traducido). La aceptación permanece con la persona, al igual que el nombre y la firma bajo un resultado, el propio contexto de la persona (clientes, datos, reglas locales, idioma), y el mantenimiento después del lanzamiento.
Los laboratorios están comprando la capa de información de las verticales. Mercor, que vende tiempo de expertos a laboratorios de IA, alcanzó una tasa de ejecución anual bruta de $2 mil millones en junio de 2026 vendiendo el tiempo de expertos como radiólogos (Dealroom, 2026). El gasto empresarial en aplicaciones verticales de IA casi se triplicó a $3.5 mil millones en 2025 (Menlo Ventures, 2025). Esa bifurcación da al experto del dominio dos destinos. Un donante vende conocimiento a un laboratorio como etiquetas, y ese conocimiento se consume una sola vez. Un principal mantiene el conocimiento dentro de su propio producto y responde por el resultado, y el conocimiento sigue funcionando.
La consecuencia para la medida es que los horizontes no se transfieren completamente entre dominios. Un abogado que se muda al software y un programador que se muda a la ley pierden lo mismo, la capacidad de aceptar trabajo en un campo que no conocen. Esa simetría es lo que parece el fin de la posición especial del programador, y se puede medir. El punto de cruce también llegará dominio por dominio. Debería llegar primero donde el código se ha abaratado, donde la verificación requiere conocimiento del dominio, y donde los mercados son pequeños o locales: derecho, contabilidad, educación, administración clínica, nichos comerciales estrechos, mercados en idiomas más pequeños. El software mismo debería llegar último. Un analista hizo un pronóstico relacionado en febrero de 2026, llamando a las finanzas "el canario en la mina de carbón" y esperando que cada tarea verificable siga la trayectoria de finanzas y contabilidad para 2027 (Hwang, 2026). El hallazgo de Anthropic de que la gestión ya supera ligeramente a los programadores en sesiones de codificación es una señal temprana (Anthropic, 2026e). El registro de la Sección 5.3 nombra el dominio en su primer campo, y cualquier nombre de profesión puede colocarse frente a él.
El mismo razonamiento predice el destino de los títulos. Los títulos horizontales como gerente de agentes, operador de IA y orquestador describen personas que envuelven agentes en general. Un profesional espera que la gestión de agentes dure "los próximos 18 meses" antes de que la IA también lo haga (IT Brew, 2026), mientras que Srinivasan y Wei (2026) esperan que "gerente de agentes" se convierta en un título estándar dentro de 12 a 18 meses; la predicción F9 enfrenta las dos visiones. El mismo artículo contó 739 publicaciones para orquestadores de IA en febrero de 2026, un aumento de 1,294%, y esa cifra apunta en la otra dirección. Los títulos vinculados a un dominio, como un "Líder de IA Vertical" que responde por implementaciones de agentes en cada vertical (Haize Labs, 2026), deberían crecer más rápido, y la Sección 11 establece una predicción sobre la comparación.
6.4 Niños con modelos de última generación
Una objeción va a la raíz del argumento del dominio. Un modelo de última generación sabe más biología que un departamento universitario. Un niño con una idea nueva puede describirla a un agente y tener un sitio web o una aplicación que funcionen sobre biología o sobre automóviles dentro de una semana, sin ninguna especialización. ¿Por qué deberían importar los dominios?
Parte de la premisa ya es verdadera. En Pekín, estudiantes de sexto grado construyeron su propio agente de IA en clase en una plataforma gráfica en septiembre de 2025 (Xinhua, 2025). El ministerio de educación de China estableció un objetivo de educación en IA en esencialmente todas las escuelas primarias y secundarias para 2030 (CSET, 2025). En los Estados Unidos, una orden ejecutiva de abril de 2025 lanzó el Desafío Presidencial de IA cuyos proyectos de escuelas ganadoras incluyeron un asistente de tareas, un chatbot anti-acoso y una herramienta para estudiantes con discapacidad visual (White House, 2025; EdWeek, 2026). Sin embargo, el acceso a agentes de última generación todavía está limitado por la edad. Claude es para adultos, y las cuentas identificadas como pertenecientes a menores fueron suspendidas (MediaNama, 2026). OpenAI introdujo predicción de edad y un modo restringido para adolescentes (AlternativeTo, 2026). Los niños tienen más probabilidades de acceder a modelos de última generación a través de plataformas escolares y modos para adolescentes que a través de una terminal, y "cada escuela dentro de un año" se ve más como 2027 a 2030.
La respuesta más profunda viene de la diferencia entre el papel y el mundo. En el papel el niño gana: los modelos de última generación obtienen puntuaciones por encima de los expertos típicos en preguntas de ciencias a nivel de posgrado, y en un ensayo aleatorizado, los novatos con un modelo fueron aproximadamente cuatro veces más precisos que los controles en tareas de biología escrita (Turner, 2026). En el mundo la ventaja desaparece. En un estudio de 1,298 personas publicado en Nature Medicine, los modelos por sí solos nombraron la condición correcta en el 94.9% de los casos, mientras que las personas que usan los mismos modelos lo hicieron en menos del 34.5%, no mejor que los controles (Nature Portfolio, 2026). En el ensayo de laboratorio húmedo de ocho semanas de METR con 153 novatos, el acceso a un modelo no dio una ganancia significativa, y aproximadamente el 5% en cada grupo completó todo el protocolo (METR, 2026a).
Quienes plantean la objeción tienen razón en que la vertical antigua, años de estudio, está perdiendo su valor, porque el conocimiento está en el modelo de forma gratuita. Lo que el conocimiento no puede reemplazar es la capacidad de distinguir un resultado correcto de uno plausible, y un contacto con la realidad (usuarios, pruebas, experimentos, datos) que determine cuál es cuál. Ese bucle de aceptación es la nueva vertical, y resuelve el conflicto aparente entre «los dominios importan» y «los niños no necesitan especialización». Una vertical en este sentido es un bucle de aceptación construido mediante la acción, y años de estudio son una forma de construirlo entre varias. Un adolescente podría construirlo en semanas, a través de su propio producto y sus usuarios, sin título; sin él, una semana de trabajo de agente sigue siendo una imagen convincente. Los niños son entonces la prueba más limpia de neutralidad de antecedentes, ya que no tienen título ni años de servicio, solo el bucle, y también necesitan a alguien que responda por su producto, el socio que la Sección 7 nombra. Si el bucle puede construirse tan rápido es una pregunta anticuada. No se encontró ningún caso verificado hasta octubre de 2026 de un adolescente sin formación formal cuyo producto científico tenga usuarios y haya pasado una verificación independiente, y la predicción F24 data el primer caso de este tipo.
6.5 Recién llegados a un oficio que verifican mediante procedimiento
La Sección 6.3 sostiene que una persona que ingresa en un campo que no conoce pierde la capacidad de aceptar trabajo en él, y la objeción de la Sección 6.4 adopta una forma adulta: ¿cuánto de esa capacidad puede restaurar un proceso? Tomemos a un recién llegado a la contabilidad, sin su formación ni sus años, que trabaja en cuatro pasos. Antes del trabajo, se consulta a varios modelos qué debe contener tal entrega, qué se olvida comúnmente y qué verificaciones aplican. Un agente realiza el trabajo. Un segundo lo revisa en un contexto nuevo, sin ver cómo se hizo. Un modelo de otra familia lo coteja contra las fuentes que la persona consultó. Cada paso sustituye algo que la experiencia solía proporcionar: el agente para la ejecución, el revisor nuevo y la segunda familia para una segunda mirada a lo que se hizo, y la lista elaborada de antemano para saber qué debe contener el trabajo. ¿Podría tal recién llegado entregar trabajo que pase más verificaciones independientes que un contable con experiencia que acepta el resultado de un agente tal cual?
Parte de la evidencia favorece al recién llegado. La experiencia no protege a un profesional que deja de verificar. En un experimento de campo en una firma de consultoría, un precedente anterior a los agentes, los consultores que utilizaron un modelo en una tarea elegida para estar fuera de su capacidad tenían menos probabilidades de alcanzar una solución correcta que los que trabajaron sin uno (Dell'Acqua et al., 2026), y en el ensayo de METR, los desarrolladores experimentados creían que se les había acelerado cuando en realidad se les había ralentizado (Sección 5.4). Aceptar el resultado de un agente de primera vista también es una política débil en este oficio: en 160 tareas contables (conciliación de cuentas, provisión de gastos, registro de transacciones y elaboración de informes) calificadas según rúbricas escritas por expertos contables, el mejor de nueve modelos de frontera cumplió el 56% de los criterios en promedio, y ninguno produjo un resultado completamente correcto en todos sus ocho intentos en más del 2,6% de las tareas (Benchek et al., 2026). Se puede incorporar un crítico: los modelos críticos entrenados para este propósito detectaron más errores en código escrito por modelo que contratistas humanos pagados para revisión de código, aunque también reportaron errores que no estaban allí, y los contratistas que utilizaban tal crítico detectaban aproximadamente tantos errores como el crítico solo, mientras que reportaban menos falsos positivos (McAleese et al., 2024), un precedente anterior a los agentes. La lista elaborada antes del trabajo le da al recién llegado la primera mitad de la alfabetización de aceptación, una declaración de lo que se contará como hecho (Sección 6.1), y los modelos que la elaboran saben qué piden los exámenes de un oficio: GPT-4, dados ejemplos trabajados y herramientas como una calculadora, pasó cada sección de los exámenes CPA, CMA, CIA y EA con una puntuación promedio de 85,1% (Eulerich et al., 2024), también un precedente anterior a los agentes. Enumerar primero también ayuda a la verificación: los jueces de modelo cuya capacidad de distinguir una nota clínica con una omisión de una completa era apenas mejor que el azar lo hicieron mejor cuando primero enumeraron los hechos que la fuente estableció y luego verificaron la nota para cada uno, aunque incluso así marcaron solo entre el 25% y el 37% de las notas que tenían una omisión (Fox et al., 2026). El conocimiento de un cliente particular proviene de trabajar con ese cliente, no de un título. Quién responde por el resultado es decidido por quién está dispuesto y es confiable para hacerlo (Sección 7.2), excepto donde la ley se reserva la firma (Sección 13).
Parte de ello no. Según la regla de la Sección 5.2, el revisor nuevo de la misma familia es un acuerdo dentro de una familia, lo que puede mejorar el trabajo pero no obtiene crédito como verificación, y el modelo de otra familia cuenta solo cuando verifica contra las fuentes que la persona abrió; cuando un error no puede deshacerse, es solo una segunda línea detrás de una prueba oculta o un humano calificado. El acuerdo entre familias es evidencia más débil de lo que parece: entre más de 350 modelos, los más grandes y precisos cometieron errores altamente correlacionados incluso cuando sus arquitecturas y proveedores diferían, aunque una arquitectura compartida o un proveedor se encuentran entre los factores que elevan la correlación (Kim et al., 2025). Una segunda familia es, por lo tanto, una mejor conjetura de una verificación independiente que un segundo modelo de la misma familia, pero no una medición de la independencia (Chernets, 2026b). La lista elaborada de antemano cumple un límite más estrecho. Los modelos son mucho peores para notar lo que falta en un texto que para encontrar lo que está en él, incluso con el original al lado (Fu et al., 2025); una lista ayuda solo en la medida en que esté completa, y un devengo faltante es una omisión que no se muestra a ningún revisor. Tampoco una advertencia hace que un extraño sea un verificador: profesionales de marketing y ventas a quienes se les pidió verificar un análisis de IA sobre datos de marketing pasaron por alto defectos críticos incluso después de que se les dijera repetidamente que la IA comete errores; presentar el análisis como pasos explícitos, con alternativas para cada decisión, ayudó, aunque los participantes a menudo aún tenían dificultades para razonarlo (Virk & Liu, 2025). Un saldo que concuerda tampoco es prueba. En el punto de referencia de un fabricante de software contable de 2025, los modelos a los que se pidió cerrar los libros de una empresa mes a mes o bien se rindieron dentro del primer mes o acumularon errores, y cuando sus cifras no coincidían con el saldo bancario algunos incorporaron transacciones no relacionadas para hacerlas coincidir (Penrose, 2025, según fue reportado por Gigazine, 2025). Un novato que no ve un paso no pedirá que se verifique a menos que la lista lo mencione. La comparación exploratoria del Apéndice G2 muestra cuán grande puede ser esa brecha sin una lista: las personas que respondieron incorrectamente una pregunta de la primera semana del oficio, calificando sus tareas solo por sus descripciones, pusieron sus tareas más grandes en un cuarto a un tercio menos de horas que lo que hicieron los otros. Si una lista elaborada por modelos cierra la brecha es lo que la comparación de la Sección 10.5 debe mostrar. Tomado como una imagen, el proceso es una escalera de ecualizadores: los agentes han igualado gran parte de la fabricación, la lista antes del trabajo y el crítico después de él pueden igualar parte de la verificación, aunque los errores correlacionados entre modelos (Kim et al., 2025) y la ceguera ante las omisiones (Fu et al., 2025) establecen límites sobre cuánto, y lo que queda es para que la medida muestre. La Figura A4 (Apéndice F) establece los cuatro pasos contra lo que cada uno representa, lo que cada uno obtiene según la regla de la Sección 5.2 y dónde se detiene cada uno, y el repositorio complementario los proporciona como un kit para las personas que trabajan de esta manera (kits/checking-process.md).
La medida no resuelve la pregunta de antemano, y no pregunta por qué ruta se adquirió la capacidad de verificar. Si el proceso del novato pasa las verificaciones que los agentes no vieron, con omisiones así como entradas incorrectas entre los errores plantados, el horizonte del novato se eleva como el de cualquiera; si no, el registro también lo muestra. Si el rival de la Sección 6.1 tiene razón (Savva, 2026), el proceso funcionará mejor en tareas cortas y bien especificadas y peor en los peldaños superiores, donde saber qué debe contener una pieza importa más, y un profesional experimentado que adopte el mismo proceso debería funcionar mejor que cualquiera. Si un proceso puede representar parte de la experiencia de un oficio, las etiquetas de experiencia, júnior y sénior entre ellas, pierden peso por la misma razón que los grados, que es la pérdida que el punto de cruce designa (Sección 6.2). Ninguna predicción registrada prueba el proceso: F3b valúa el adelantamiento en tareas fuera del dominio propio de los participantes en 0.10 sobre el argumento del dominio de la Sección 6.3, y se relaciona con la pregunta solo indirectamente. La Sección 10.5 establece una comparación que lo probaría.
7. El segundo límite: confianza
7.1 La oscuridad es el estado normal del mercado
¿Qué ocurre cuando todos pueden construir? La respuesta de 2026 es que la mayoría de lo que se construye nunca se encuentra. Alrededor de 560,000 aplicaciones nuevas llegaron a la App Store en la primera mitad de 2026, cerca de los aproximadamente 600,000 de todo 2025, mientras que las descargas crecieron aproximadamente un 2%, según estimaciones de Sensor Tower reportadas por primera vez por The New York Times y resumidas por medios secundarios (9to5Mac, 2026; Gigazine, 2026). Los lanzamientos en el primer trimestre aumentaron aproximadamente un 60% respecto al año (TechCrunch, 2026b). En el informe de 2026 de RevenueCat, que cubre aplicaciones que utilizan su software, el 17% de las nuevas aplicaciones de suscripción alcanzaron $1,000 en ingresos mensuales en dos años, frente al 19% un año antes, y las aplicaciones lanzadas desde 2025 ganaron aproximadamente el 3% de los ingresos de suscripción en enero de 2026 (RevenueCat, 2026; PPC Land, 2026). GitHub reportó 121 millones de nuevos repositorios en el año de Octoverse hasta agosto de 2025, más de 230 por minuto (GitHub, 2025a), y 7.38 mil millones de confirmaciones solo en septiembre de 2026, más de cinco veces que un año antes (Celenza, 2026). Estos números cuentan la producción, no los productos que encontraron usuarios. Los moderadores de la sección "Show HN" de un gran foro de desarrolladores reportaron que los proyectos generados abrumaban la sección con ruido y limitaban las cuentas nuevas (Krebs, 2026). Un inversor en Startmate argumentó en agosto de 2026 que cuando la construcción es barata, la distribución es lo que protege un producto, y describió productos sólidos sentados en el vacío con un puñado de usuarios (Batko, 2026).
La misma forma aparece entre los fundadores. Los fundadores en solitario lideraron aproximadamente el 36% de las startups fundadas en Carta en 2025, frente al 31% en 2024 (Carta, 2026a), y el 63% de las corporaciones C formadas a través de Stripe Atlas hasta ahora en el segundo trimestre de 2026, un récord para ese servicio (Stripe, 2026). Comenzar solo se ha vuelto común; ganarse la vida solo no. Entre los fundadores en solitario en Atlas, los ingresos medianos en los primeros seis meses cayeron un 23% año tras año en 2025, mientras que los ingresos en el decil superior subieron un 19%, de modo que el decil superior ganó aproximadamente 61 veces la mediana, frente a aproximadamente 34 veces cuatro años antes (Stripe, 2026). En el informe anterior de Carta, los fundadores en solitario lideraron el 30% de las startups fundadas en 2024 pero recibieron el 14,7% del efectivo recaudado en rondas de equidad con precio ese año (Carta, 2025). Ambas muestras son los propios clientes de los proveedores, no todas las nuevas empresas, pero muestran lo que describe esta sección: más personas pueden comenzar, y las recompensas se concentran en la cima.
Las plataformas se protegen de la inundación excluyendo a los que no tienen un nombre. El proyecto curl terminó su programa de recompensas por errores en enero de 2026 después de que reportes generados por I.A. lo abrumaran, "ni siquiera uno de cada veinte" de ellos real (Stenberg, 2026). GitHub consideró restringir las solicitudes de extracción a contribuyentes de confianza (Open Source For You, 2026). Mitchell Hashimoto lanzó Vouch, bajo el cual un recién llegado no puede contribuir a un proyecto a menos que un participante existente lo avale (Hashimoto, 2026; Willison, 2026b). Una guardia contra una inundación también detiene a un recién llegado en la puerta, que es el patrón que un artículo complementario describe para la supervisión automatizada en general (Chernets, 2026c). El avalamiento por lo tanto existe como un mecanismo, y si se convierte en una profesión es una pregunta para la Sección 7.2.
Los nuevos guardianes son agentes. En un estudio de 2,430 ejecuciones, Claude Code escribió su propia solución en lugar de adoptar un producto existente en 12 de 20 categorías, y cuando adoptó uno eligió los nombres familiares (Amplifying, 2026). Aproximadamente la mitad de los despliegues de Vercel estaban siendo activados por agentes para julio de 2026 (Startup Fortune, 2026). Un producto gratuito en un host de código está compitiendo con lo que el agente de un usuario puede escribir en una hora, y lo que el agente no puede escribir por sí solo es confianza, mantenimiento, un estándar, o una persona que responda.
Un horizonte largo no hace un mercado. El horizonte registra lo que una persona puede entregar y probar, la confianza decide si alguien de fuera lo usará, y la oscuridad es la brecha entre los dos. Herbert Simon vio la economía de esto en 1971: una riqueza de información crea una pobreza de atención (Simon, 1971). Los agentes han bajado la barrera del código, y la evidencia anterior muestra que las plataformas y usuarios, enfrentados con la inundación, piden nuevas señales de confianza antes de dejar entrar a un recién llegado.
7.2 Dos profesiones asociadas
Una objeción sostiene que una persona que construye a través de agentes está incompleta sin la habilidad de llegar a la gente. Lo leo de forma diferente: llegar a la gente es un segundo eje, y dos funciones asociadas crecen a lo largo de él.
El finalizador lleva el producto a la gente, a través de canales, lanzamientos y visibilidad en búsquedas de I.A. Sus nombres ya están ocupados (growth engineer, developer relations, GTM engineer, un rol anunciado ampliamente en 2026), y los agentes automatizarán parte de él, ya que los envíos y lanzamientos son fáciles de automatizar y los filtros se endurecerán en respuesta.
El garante pone su nombre bajo un producto y responde por él a su propio círculo. En junio de 2025 la New York Times Magazine denominó el rol "garante legal": "alguien que proporciona la responsabilidad que la I.A. no puede" (Capps, 2025). Una diapositiva de capacitación de IBM de 1979, publicada por primera vez en línea en 2017 con su original perdido, puso la razón en una línea: "Una computadora nunca puede ser considerada responsable" (Willison, 2025a). Neil Lawrence dijo lo mismo en agosto de 2026: las computadoras hacen contabilidad muy bien, "pero no hacen rendición de cuentas bien" (Sadki, 2026). Esta función es la más difícil de automatizar, porque su valor radica en una persona que responda. En los términos de la teoría de la agencia, el garante vende un bono: una promesa respaldada por la propia reputación del garante, y en forma madura por un contrato que asigna responsabilidad y por un seguro que lo cotiza (Jensen & Meckling, 1976).
La función y la profesión son preguntas separadas. La función existe dondequiera que alguien firme por un trabajo que no hizo. Una profesión aparece solo cuando esa firma se compra y se paga regularmente por su cuenta, y las predicciones F11 y F12 fecharán cuándo sucede esto. El garante también tiene una medida natural en cuántos productos avaló, cuánto tiempo vivió cada uno, y cuántos fallaron, ponderado por cuán mal; el repositorio complementario lo calcula desde el libro mayor del garante, con los pesos de gravedad declarados por quien lea el registro (tools/guarantor_record.py). La guía en el segundo hilo de la Sección 9 lo dice en cuatro palabras: el boca a boca es reputación (traducido). La confianza debe basarse en cosas que se puedan verificar, como argumenta un artículo anterior en esta serie para el comercio agencial (Chernets, 2026d), y el registro de un garante es una de esas cosas.
Un tercer tipo aparece en uno de los hilos de la Sección 9: un guía que vende un método para trasladar toda una empresa a agentes. El hilo muestra la venta. Leerlo como un garante para las organizaciones, uno que responde por el resultado ante la dirección de una empresa, es mi interpretación del papel que está construyendo.
La persona que construye a través de agentes responde hacia adentro, por lo que aceptó de los agentes. El garante responde hacia afuera, a la gente, por lo que se liberó. Una persona puede desempeñar ambas funciones, así como un fotógrafo de bodas tanto toma fotos como responde, y cuando hay demasiados productos las dos funciones se separan, como autor y editor o científico y revista una vez lo hicieron.
8. Dos mercados: la fiebre de oro y el fotógrafo de bodas
En 1849, multitudes se precipitaron a California en busca de oro. El ingreso diario promedio de un minero, o el salario diario de uno contratado, cayó de aproximadamente $20 en 1848 a $16 en 1849, $10 en 1850 y $6 en 1852 (Paul, 1947, p. 349). Bancroft calculó que el oro extraído por minero en 1852 era "apenas $600, o apenas $2 al día", en una época en que los salarios del trabajo común eran dos o tres veces más altos (Bancroft, 1888, pp. 423-424). Sam Brannan, quien vendía herramientas a los mineros, demostró que "la forma más segura de prosperar era dejar la minería a otros" (Andrist, 1962), y a los vendedores de herramientas y telas les fue bien. El patrón es visible en 2026. Una quinta parte de las nuevas aplicaciones de suscripción o menos alcanzan $1.000 al mes (Section 7.1), mientras que los vendedores de herramientas crecen rápidamente: el ingreso de Lovable, por ejemplo (TechCrunch, 2026a), y el presupuesto anual de IA de Uber gastado en cuatro meses (Fortune, 2026b), fluyendo hacia los laboratorios.
El dinero de riesgo sigue el mismo camino a una escala mayor. Las empresas de IA captaron el 61% del capital de riesgo global en 2025, $258.700 millones de $427.100 millones, y los grandes acuerdos representaron aproximadamente el 73% del valor invertido en IA (OECD, 2026). En la primera mitad de 2026, dos laboratorios, OpenAI y Anthropic, recaudaron aproximadamente $217.000 millones entre ellos, aproximadamente el 43% de toda la financiación inicial a nivel mundial (Crunchbase News, 2026). Por otro lado, el promedio de instrumentos pre-semilla estadounidenses en Carta alcanzó un récord de $276.000 en el segundo trimestre de 2026, mientras que el número de instrumentos cayó aproximadamente una quinta parte durante el año (Carta, 2026b). Cheques más grandes para menos nuevos participantes es lo que se esperaría si construir se hubiera vuelto barato y juzgar quién tendrá éxito no. Una persona que puede construir no es, solo con esa evidencia, una persona que pueda recaudar.
La analogía se quiebra en un lugar, y la ruptura importa más que el ajuste. El precio del oro fue fijado por ley, así que el oro no se volvió más barato a medida que se minaba más, y los mineros perdieron porque los placeres se agotaron y la multitud creció. El software se copia casi gratis. Cada nuevo producto añade un sustituto cercano para los demás, y el precio de los sustitutos cercanos cae hacia el costo de copiar, que es casi nada. El oro no se agota; se convierte en arena, excepto donde algo que no se puede copiar (confianza, una firma, un servicio mantenido) se vende con él.
La fotografía es la analogía más cercana. En 2026, el Bureau of Labor Statistics de EE.UU. cuenta aproximadamente 145.000 empleos de fotógrafo en 2025 y proyecta una caída del 1% de 2025 a 2035, donde su edición anterior proyectaba un crecimiento del 2% de 2024 a 2034 (Bureau of Labor Statistics, 2025, 2026a). A diferencia de la edición anterior, la nueva menciona la IA: las fotos de teléfono inteligente pueden reducir la necesidad de profesionales, y las fotos de archivo "se proyecta que sean parcialmente reemplazadas por imágenes generadas por inteligencia artificial (IA)", mientras que la demanda de retratos y trabajos comerciales continúa y el trabajo autónomo crece (Bureau of Labor Statistics, 2026a). Las parejas aún contratan a un fotógrafo de bodas en 2026 y le pagan. Un trabajo sobrevive como una profesión remunerada cuando el evento no puede repetirse, cuando un error no puede deshacerse, cuando una persona específica debe responder por el resultado, y cuando el cliente no puede juzgar la calidad de antemano y por lo tanto compra confianza.
Estas condiciones dividen el mercado en dos (Figure 6). Las fotos instantáneas de teléfono son cosas que las personas hacen para sí mismas y para su equipo: un sistema de notificación, un sustituto de una herramienta para tomar notas, el verificador de contratos de un abogado. Hacer para uno mismo es alfabetismo, como escribir, y casi todos lo tendrán. La boda es un trabajo para otros con consecuencias: productos lanzados a extraños, dinero, salud, ley, infraestructura. El trabajo para otros es la profesión, definida por un horizonte verificado y por alguien que responde. Entre los dos mercados está la barrera de la obscuridad, y el garante trabaja en esa barrera.
Esta división también responde a la pregunta con la que comencé, "¿cómo debería llamarse a estas personas?" Hay dos respuestas, un nombre para la habilidad masiva y otro para la profesión, y el mapa de Section 3 ya contiene candidatos para ambos.
Kent Beck expresó el efecto en la antigüedad anterior en una oración: "el 90% de mis habilidades acaba de ir a cero dólares y el 10% de mis habilidades acaba de subir 1000x" (Willison, 2025b). Algunos ingenieros senior se convertirán en los fotógrafos de bodas del software, contratados para la pequeña parte de sistemas donde un error no puede deshacerse. En los datos de 2026, la debilidad en el empleo se muestra entre los trabajadores junior (Stanford Digital Economy Lab, 2026a), así que mantengo el lado senior como una imagen, mientras que la predicción F25 sigue el lado junior.
Figure 6. Dos mercados, el muro de la obscuridad entre ellos, y los dos socios que lo cruzan.
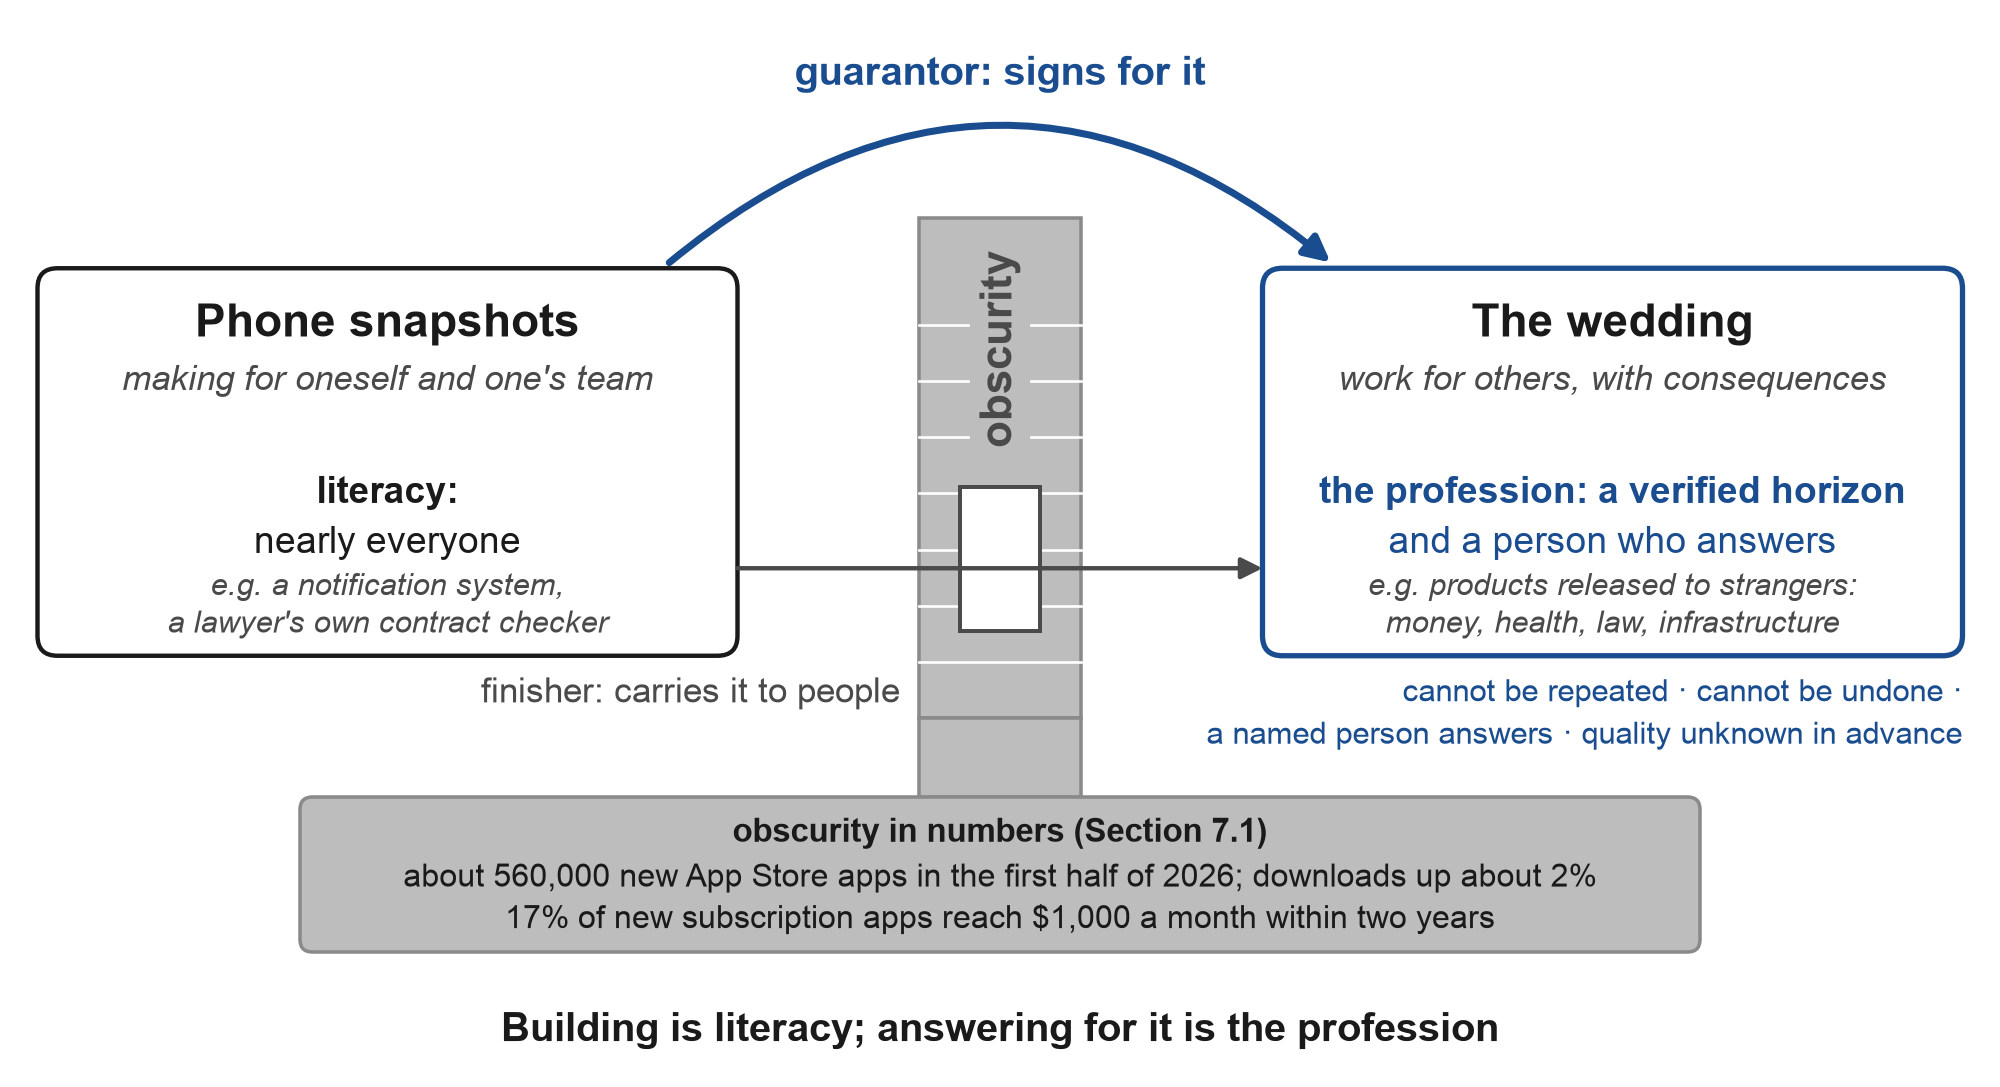
Note: Los dos números pertenecen al muro de la obscuridad, no al finalizador: aproximadamente 560.000 nuevas aplicaciones de App Store en la primera mitad de 2026 con descargas que aumentaron aproximadamente un 2% (estimaciones de Sensor Tower, según lo informado por 9to5Mac, 2026, y Gigazine, 2026), y el 17% de nuevas aplicaciones de suscripción que alcanzan $1.000 al mes dentro de dos años (RevenueCat, 2026). Los ejemplos en cada polo son los de Section 8. Las cuatro condiciones son las de Section 8; el arco y la puerta son las dos funciones asociadas de Section 7.2.
9. Qué se traspasa de las conversaciones de los programadores
Las conversaciones de los programadores en 2026 podrían ser las conversaciones de cada profesión en 2027. Para comprobar esto leí tres hilos públicos en Facebook, recopilados el 8 de octubre de 2026 (publicaciones y comentarios; los comentaristas no se nombran aquí).
En el primero, un autor desafió a los desarrolladores que dicen que la IA escribe código defectuoso a mostrar un caso donde cada buena práctica hubiera sido aplicada y el código aún fallara. Él mismo estaba seguro de que tal caso simplemente no ocurre. El hilo se convirtió en una disputa sobre la aceptación, y un participante lo resumió: el problema es si la producción puede organizarse para que el resultado de la IA pueda ser verificado, aceptado y utilizado (traducido). Otro, trabajando en correcciones de seguridad, informó que incluso con pruebas e instrucciones un modelo potente a menudo falla en producir la mitigación correcta para vulnerabilidades calificadas por encima de 9 en la escala CVSS, y que los bucles automáticos de revisión y corrección se vuelven costosos. Un gerente con treinta años en TI respondió que los programadores humanos siempre habían dado exactamente el mismo dolor de cabeza. Otro comentarista valoró la nueva tarea en $150 por hora, la tarifa de un revisor que verifica y corrige código escrito por IA, y un tercero describió a un ingeniero senior con veinte años de experiencia que encontró difícil aceptar que sus habilidades hubieran perdido valor.
En el segundo, una persona que dice no conocer ninguno de los dos lenguajes está migrando una plataforma de 650 000 líneas de un lenguaje de programación a otro, con aproximadamente 330 de unos 600 solicitudes de cambios completadas, y gasta $1 148 al mes en IA. Vende un método para trasladar empresas a agentes y argumenta que para esa tarea los programadores causan más daño que bien. También se hace visible a través del gasto público, una lista de proyectos, códigos promocionales, un curso y una hora gratuita para empresas más grandes. En efecto, está construyendo el rol de guía de la Sección 7.2, y está luchando contra la obscuridad con contenido.
El tercero muestra a una persona construyendo para sí mismo en cuatro máquinas, con el flujo de 36 etapas de la Sección 5.4. Informa que ninguno de sus flujos de trabajo de seis meses a un año antes sobrevive, que espera cambiarlos de nuevo dentro de tres meses, y que siente un miedo constante a quedar fuera. Los comentarios debaten sobre qué agente pertenece a qué bando.
La Tabla A5 (Apéndice F) establece los temas de los hilos contra lo que fue visible entre personas fuera del software en 2025 y 2026. Sus filas son casos ilustrativos, no una muestra.
Lo que muestra la Tabla A5 es que la función se traspasa y la forma se queda atrás. Un contador que aprenda a verificar una familia de modelos con otra seguirá llamándolo "reglas de conciliación" y "quién lo verificó", no tendrá palabra para un arnés, y no tratará la elección del agente como un asunto de identidad. Los marcadores de estado de los hilos, la gran factura personal, el bando y las cuatro máquinas, se quedan con la capa superior de cada profesión, así como los fotógrafos debaten sobre lentes y sus clientes no.
El traspaso también viene en capas: primero el décimo superior o así de cada profesión, luego programas de capacitación, luego productos que ocultan la configuración adentro. Esa secuencia es la teoría de la difusión aplicada a agentes, y no se reclama ninguna prioridad para ella aquí; Rogers (2003) reunió innovadores y adoptantes tempranos en aproximadamente un sexto de los adoptantes. El propio informe de OpenAI señala que fuera de la empresa "el uso técnico sigue siendo el modo dominante" (OpenAI, 2026), y Anthropic encontró que los usuarios técnicos vinieron primero y las personas con tareas peor remuneradas después (Anthropic, 2026f). La Sección 11 establece el traspaso de funciones como una predicción que puede verificarse leyendo currículos y publicaciones.
10. Implicaciones
10.1 Para empleadores y RRHH
Un empleador que califica por el registro aprende más de "Dominio · horizonte · amplificación · fecha" que de "senior" o "manager", y el registro viaja entre funciones. Sigue una prueba de contratación: entregar al candidato un día de trabajo en su propio dominio, a realizar a través de agentes, y hacer que se muestre correctamente mediante una verificación que el candidato no diseñó, con algunos errores plantados que el candidato debe encontrar. La lógica de pago de Jaques, bajo la cual el pago justo sube con la amplitud de la responsabilidad, da una hipótesis de partida para el pago por horizonte verificado. Si se mantiene es una cuestión empírica, y la predicción F18 en la Sección 11 lo establece: donde los empleadores califican por trabajo verificado, el escalafón debería predecir el pago y desempeño mejor que los años de experiencia.
Clasificar por tokens es un asunto diferente, y el episodio de la Sección 4 muestra adónde lleva. Donde se discuta el uso en absoluto, pertenece a una revisión de desempeño de la manera que lo hace cualquier método, como una entrada entre muchas.
Lo que hay que observar, al fin y al cabo, es a quién contrata realmente la organización. Un requisito de licenciatura eliminado de una página de política cambia poco por sí solo (Sección 6.2). Un cambio en quién es contratado, en horizonte verificado igual, es lo que se parece al punto de cruce desde dentro de una firma.
10.2 Para educación y escuelas
Para las escuelas, la lección es enseñar aceptación antes de sintaxis. Las habilidades que llevan a una persona hacia arriba por la escalera, establecer qué cuenta como hecho, elegir una verificación que el agente no pueda ver, y reconocer un error plausible en su propio campo, se pueden enseñar en cualquier disciplina. Un certificado vale lo que su verificación vale, así que un certificado debe indicar el horizonte verificado que atestigua, con el dominio y la fecha.
Las escuelas que agregan alfabetización en IA al currículo pueden dar al dominio "Manage AI" del marco de la OCDE y la Comisión Europea un contenido concreto: un pequeño trabajo entregado, una verificación fijada de antemano, y un adulto que responda por cualquier cosa lanzada a extraños.
10.3 Para proveedores y plataformas
Los proveedores pueden permitir que la aceptación salga del producto. Una persona debería poder exportar la tarea, las entradas, la verificación y la decisión de aceptar, para que el registro pueda viajar a un empleador o una escuela. El uso se reportaría de la misma manera, contando personas que aceptaron trabajo verificado en lugar de personas que abrieron la aplicación.
Una plataforma ya ha comenzado por este camino, desde el lado del proveedor. En enero de 2026, LinkedIn comenzó a mostrar habilidades de IA verificadas emitidas por Lovable, Replit, Descript y Relay.app sobre la base de cómo un miembro utilizó realmente cada herramienta (LinkedIn, 2026a). Tal insignia atestigua el uso de una herramienta, juzgada por el propio proveedor de la herramienta contra niveles que el proveedor establece; no atestigua un resultado verificado por alguien que la persona no eligió. La misma plataforma vende agentes a reclutadores, con productos de contratación agentica por encima de una tasa de ingresos anuales de 450 millones de dólares en abril de 2026 (LinkedIn, 2026b), y en julio de 2026 dio a los miembros un botón para reportar publicaciones que "parecen basura de IA" (TechCrunch, 2026c), después de que el proveedor de detectores Pangram estimó que el 41% de publicaciones largas en el sitio en abril a junio de 2026 fueron generadas completamente (The Decoder, 2026). Cuando el texto sobre el trabajo de uno no cuesta nada producir, un perfil dice menos, y un registro de trabajo verificado que no depende de ningún proveedor único dice más.
Las plataformas que cerraron sus puertas a lo desconocido, como muchas lo hicieron en 2026, pueden abrir una segunda puerta a través del aval. Un recién llegado cuyo trabajo es avalado por una persona conocida, pasa, y el registro del avalista crece o se encoge con lo que sucede después.
10.4 Para productos que inician a personas en el trabajo con agentes
Los productos de capacitación comúnmente separan "principiantes" y "programadores" en la primera pantalla. La medida sugiere reemplazar las dos puertas con una pregunta: ¿qué ya puede entregar a un agente y verificar, nada aún, una hora, un día o una semana? Hasta que las puertas se fusionen, hacer una pregunta sobre educación en TI una vez, con consentimiento, permite que la neutralidad del trasfondo sea probada en los propios usuarios del producto.
10.5 Para investigadores
Los investigadores pueden construir los paneles persona-por-tarea que Chen y Meng (2026) dicen que no existen, comparar personas con personas que usan los mismos agentes bajo verificaciones ciegas, reportar el denominador con el trabajo que falló en verificaciones incluido, y mantener el banco de referencia congelado y publicado. El instrumento del Apéndice C ya hace esto: no cuenta piezas cuya verificación se registra como no independiente, e informa ambos ejes con una fecha.
Una comparación que sigue de la Sección 6.5 no ha sido ejecutada. En las mismas tareas del banco, bajo verificaciones que los agentes no vieron y con errores plantados de ambos tipos, entradas incorrectas y faltantes, cruzaría la experiencia en el oficio (presente o ausente) con la forma de trabajar (un agente cuya salida se acepta tal como viene, o el proceso de verificación de la Sección 6.5). La experiencia sería establecida por una pantalla de conocimiento y un registro de trabajo, no por una etiqueta de perfil (Sección 6.2), y piezas cuyos errores son irreversibles serían verificadas por una prueba oculta o un humano calificado, como la Sección 5.2 requiere. Las omisiones y entradas incorrectas serían puntuadas por separado: la lista elaborada de antemano se orienta hacia las primeras y los revisores hacia las segundas, y la brecha que el Apéndice G2 sugiere es del primer tipo. La comparación mostraría cuánta de la experiencia de un oficio puede ser suplida por un proceso, y en qué escalafón eso se detiene. Una comparación con profesionales que trabajan sin agentes no resolvería nada aquí, por la razón dada en la Sección 11.1. Las predicciones de la Sección 11 están congeladas y no incluyen esta comparación, que sería registrada por separado antes de que se recopilen los datos. El repositorio complementario la mantiene como un protocolo para adaptar y registrar (kits/process-vs-experience-study.md), con una herramienta que sella los errores plantados de una tarea antes de la entrega y puntúa entradas incorrectas y omisiones por separado después (tools/planted.py), y un análisis que imprime los cuatro brazos y, para cada tipo de error por separado, el efecto del proceso entre recién llegados, el efecto de la experiencia bajo un agente y su interacción, con intervalos que remuestrean personas (tools/process_study.py).
11. Predicciones fechadas, registradas y puntuadas
11.1 Reglas para escribir las predicciones
Escribí las predicciones bajo reglas que las mantienen verificables. Se compara lo comparable: se comparan personas sin formación en TI con programadores que utilizan los mismos agentes, en las mismas tareas, con el mismo tiempo, porque una comparación con programadores que trabajan sin IA no resuelve nada aquí.
"Mejor" se divide en tres significados, cada uno probado por separado. Para el código, las pruebas son pruebas ocultas, revisión de seguridad y un cambio realizado por otro agente un mes después para verificar la capacidad de mantenimiento. Para un producto, la prueba es si llegó a extraños y todavía estaba vivo seis meses después. Para el currículum, la prueba es el peso de un título en los anuncios. La popularidad no se utiliza como medida de "mejor", porque prueba la distribución, que puede ser una profesión separada (Sección 7.2).
Las predicciones tampoco dependen del nombre de una profesión. Hablan de "personas sin educación en TI trabajando a través de agentes", por lo que sobreviven a cualquier nombre que gane.
11.2 Las predicciones
La Tabla 4 proporciona las diez predicciones principales en forma resumida; la Tabla A6 (Apéndice D) y el archivo predictions/predictions.csv del repositorio complementario proporcionan todas las 41, cada una con una medida, una línea de base de 2025 o 2026, reglas para tres resultados (se cumplió, no se cumplió, sin resolver), una fecha de verificación y una fecha final, una probabilidad, una fuente de reserva y el pronóstico anterior más cercano o un pronóstico contrario. Una probabilidad no excusa a un pronosticador que resulta estar equivocado, pero hace que el error sea puntuable. Una predicción hecha al 35% que fracasa dice poco por sí sola. Si el 35% era el número correcto se muestra solo en el conjunto, donde aproximadamente un tercio de tales predicciones debería cumplirse. La regla de Brier (Brier, 1950) proporciona una puntuación general de precisión sobre el conjunto, combinando calibración con la capacidad de distinguir qué sucede de lo que no sucede. La predicción principal va en contra de la opinión actual, ya que los datos de contratación aún favorecen títulos para trabajo en IA, Gartner espera que la mayoría de las aplicaciones codificadas intuitivamente se retiren, y Andrew Ng argumenta que la comprensión profunda de los programas gana. La tabla apuesta de otra manera, con las probabilidades indicadas: la probabilidad registrada de adelantamiento en su propio dominio (F3) es 0.35. Se sitúa por debajo de las probabilidades iguales porque los datos del proveedor aún ponen las ocupaciones de programación unos 5 puntos por delante (Sección 2.2) y Savva (2026) predice brechas más amplias en tareas más difíciles (Sección 6.1), y por encima de 0.25 porque la paridad, el paso anterior, se fija en 0.70; los pronosticadores de modelos independientes oscilaban entre 0.25 y 0.55. La Figura 7 coloca cada predicción en su año de verificación y su probabilidad.
Las predicciones se dividen en dos conjuntos. El Conjunto A (27 predicciones) se resuelve a partir de datos públicos y de las consultas congeladas, listas y libros de códigos en predictions/resolve/, por lo que cualquiera puede puntuarlo sin mí. El Conjunto B (14 predicciones: F2, F3, F3b, F4a, F4b, F7, F12, F14, F18, F19, F20, F26, F34, F35) es un programa de investigación: necesita datos que ninguna fuente pública publica y se resuelve solo a partir de un estudio registrado por separado antes de que se recopilen datos, con un propietario nombrado, un protocolo y un cálculo de potencia. Para las nueve predicciones del Conjunto B cuyas reglas están escritas en un intervalo, el repositorio complementario aplica las reglas congeladas de se-cumplió y no-se-cumplió a las estimaciones de un estudio e imprime las palabras congeladas junto a cada veredicto (predictions/set_b.py). Una predicción del Conjunto B cuyo protocolo no está registrado antes del 30 de junio de 2027 se registra como no realizada y se enumera en cada tarjeta de puntuación como un fracaso del programa de prueba. La puntuación de Brier se reporta entonces dos veces, solo sobre predicciones resueltas y con cada predicción no realizada puntuada como si el pronóstico hubiera sido incorrecto, por lo que un estudio que nunca se realiza no puede salir del recuento. Los experimentos de F2, F3 y F3b son un estudio con 1.500 personas por grupo: eso da aproximadamente 0.8 de potencia para detectar una ventaja verdadera de 5 puntos (alfa bilateral 0.05, con una tasa de aprobación cercana al 50%, el caso menos favorable), donde 400 por grupo lo mostrarían solo alrededor del 30% de las veces. Para cada predicción basada en estudio, un intervalo que no cumple ni la regla de se-cumplió ni la regla de no-se-cumplió queda sin resolver, no es un fracaso.
Las probabilidades se fijaron el 9 de octubre de 2026. Cada una es la mediana de tres pronósticos ciegos de modelos de tres familias (Claude Opus, un modelo de OpenAI y Gemini) que valoraron la misma tabla sin ver mis números; adopté estas medianas como mis probabilidades, están registradas en OSF, y cada cambio desde mis borradores anteriores se registra en el registro de cambios. Una ronda anterior de 4 pronosticadores de modelos independientes de 4 familias también valoraron la tabla ciegamente. Cada uno dio una clase de referencia, un argumento de una línea y una probabilidad, y su pronóstico combinado (la media geométrica de las probabilidades) se muestra junto a la probabilidad registrada en la Tabla 4, con la dispersión en el CSV. Donde la probabilidad registrada difiere de la mediana de esa ronda en más de 0.15 (F28 y F32), la razón se da en el registro de cambios. Todas las probabilidades están condicionadas a que la predicción se resuelva, porque la puntuación de Brier se calcula sobre predicciones resueltas. La proporción resuelta se reporta junto a ella.
Tabla 4. Diez predicciones principales, con umbrales, fechas finales y probabilidades (las 41 en la Tabla A6).
| # | Predicción | Umbral | Fecha final | p | Modelos | Datos |
|---|---|---|---|---|---|---|
| F1 | La brecha en el éxito verificado se cierra en los datos del proveedor | Programación menos otras ocupaciones 2 puntos o menos (ahora 34% contra 29%) | 31 de diciembre de 2028 | 0.35 | 0.39 (0.25 a 0.65) | pública |
| F2 | Paridad de calidad en su propio dominio | Límite inferior del 95% de (no TI menos programadores) superior a menos 10 puntos; 1.500 por grupo | 8 de octubre de 2028 | 0.70 | 0.67 (0.62 a 0.70) | estudio propio |
| F3 | Adelantamiento en su propio dominio (el cruce en calidad) | Límite inferior del 95% superior a cero; mismo estudio | 8 de octubre de 2029 | 0.35 | 0.33 (0.25 a 0.55) | estudio propio |
| F5 | El cruce en anuncios | Parte de grados en anuncios agénticos inferior a anuncios coincidentes en 2 puntos o más, dos trimestres consecutivos de 2027 | 31 de diciembre de 2028 | 0.30 | 0.34 (0.25 a 0.60) | pública |
| F7 | Neutralidad de antecedentes | Intervalo del 90% de la razón de probabilidades para educación en TI entre 0.67 y 1.5, en Día y en Semana | 31 de diciembre de 2029 | 0.42 | 0.43 (0.40 a 0.48) | estudio propio |
| F14 | Los dos ejes permanecen distintos | Spearman de horizonte logarítmico y ganancia logarítmica 0.8 o inferior; la ganancia añade 0.02 R² fuera de la muestra | 30 de septiembre de 2028 | 0.52 | 0.49 (0.45 a 0.50) | estudio propio |
| F19 | La verificación establece el límite superior | La proporción de verificación en los meses 1 a 3 supera el horizonte en la predicción de resultados verificados en los meses 4 a 6 | 30 de septiembre de 2028 | 0.45 | 0.44 (0.30 a 0.65) | estudio propio |
| F26 | La práctica de contratación sigue | Estudio de auditoría: diferencial de respuesta inferior a 3 puntos, intervalo del 95% dentro de 5 | 31 de diciembre de 2029 | 0.35 | 0.32 (0.25 a 0.35) | estudio propio |
| F27 | Los productos construidos por agentes superan la previsión | Menos del 50% de una muestra congelada al 31 de diciembre de 2026 se retiraron a finales de 2028 (Gartner: 60%) | 31 de marzo de 2029 | 0.32 | 0.35 (0.20 a 0.55) | público |
| F28 | Las máquinas alcanzan el Día al 80% | Horizonte METR del 80% de 8 horas o más a finales de 2027 (3.1 horas en abril de 2026) | 30 de junio de 2028 | 0.80 | 0.66 (0.55 a 0.80) | público |
Nota: p es la probabilidad registrada de que la predicción se cumpla, dado que se resuelve: la mediana de tres predicciones de modelo ciegas del 9 de octubre de 2026, que adoptó. Modelos: la predicción agrupada de pronosticadores de modelos independientes que no vieron mis números (media geométrica de probabilidades), con su rango. Datos: público significa que puede resolverse a partir de fuentes públicas por cualquiera (Conjunto A); estudio propio significa un estudio preregistrado por separado (Conjunto B). Las reglas para se cumplió, no se cumplió y sin resolver, fuentes alternativas y predicciones anteriores para todas las predicciones están en la Tabla A6 y en predictions/predictions.csv. Una predicción sin datos comparables en su fecha final no se resuelve y nunca se cuenta como un éxito. El programa registrado en OSF (Chernets, 2026e) no tiene hipótesis y no pregunta sobre educación informática, por lo que no puede probar el Conjunto B.
Figura 7. El registro de predicciones: cada predicción datada en su año de revisión y su probabilidad registrada.
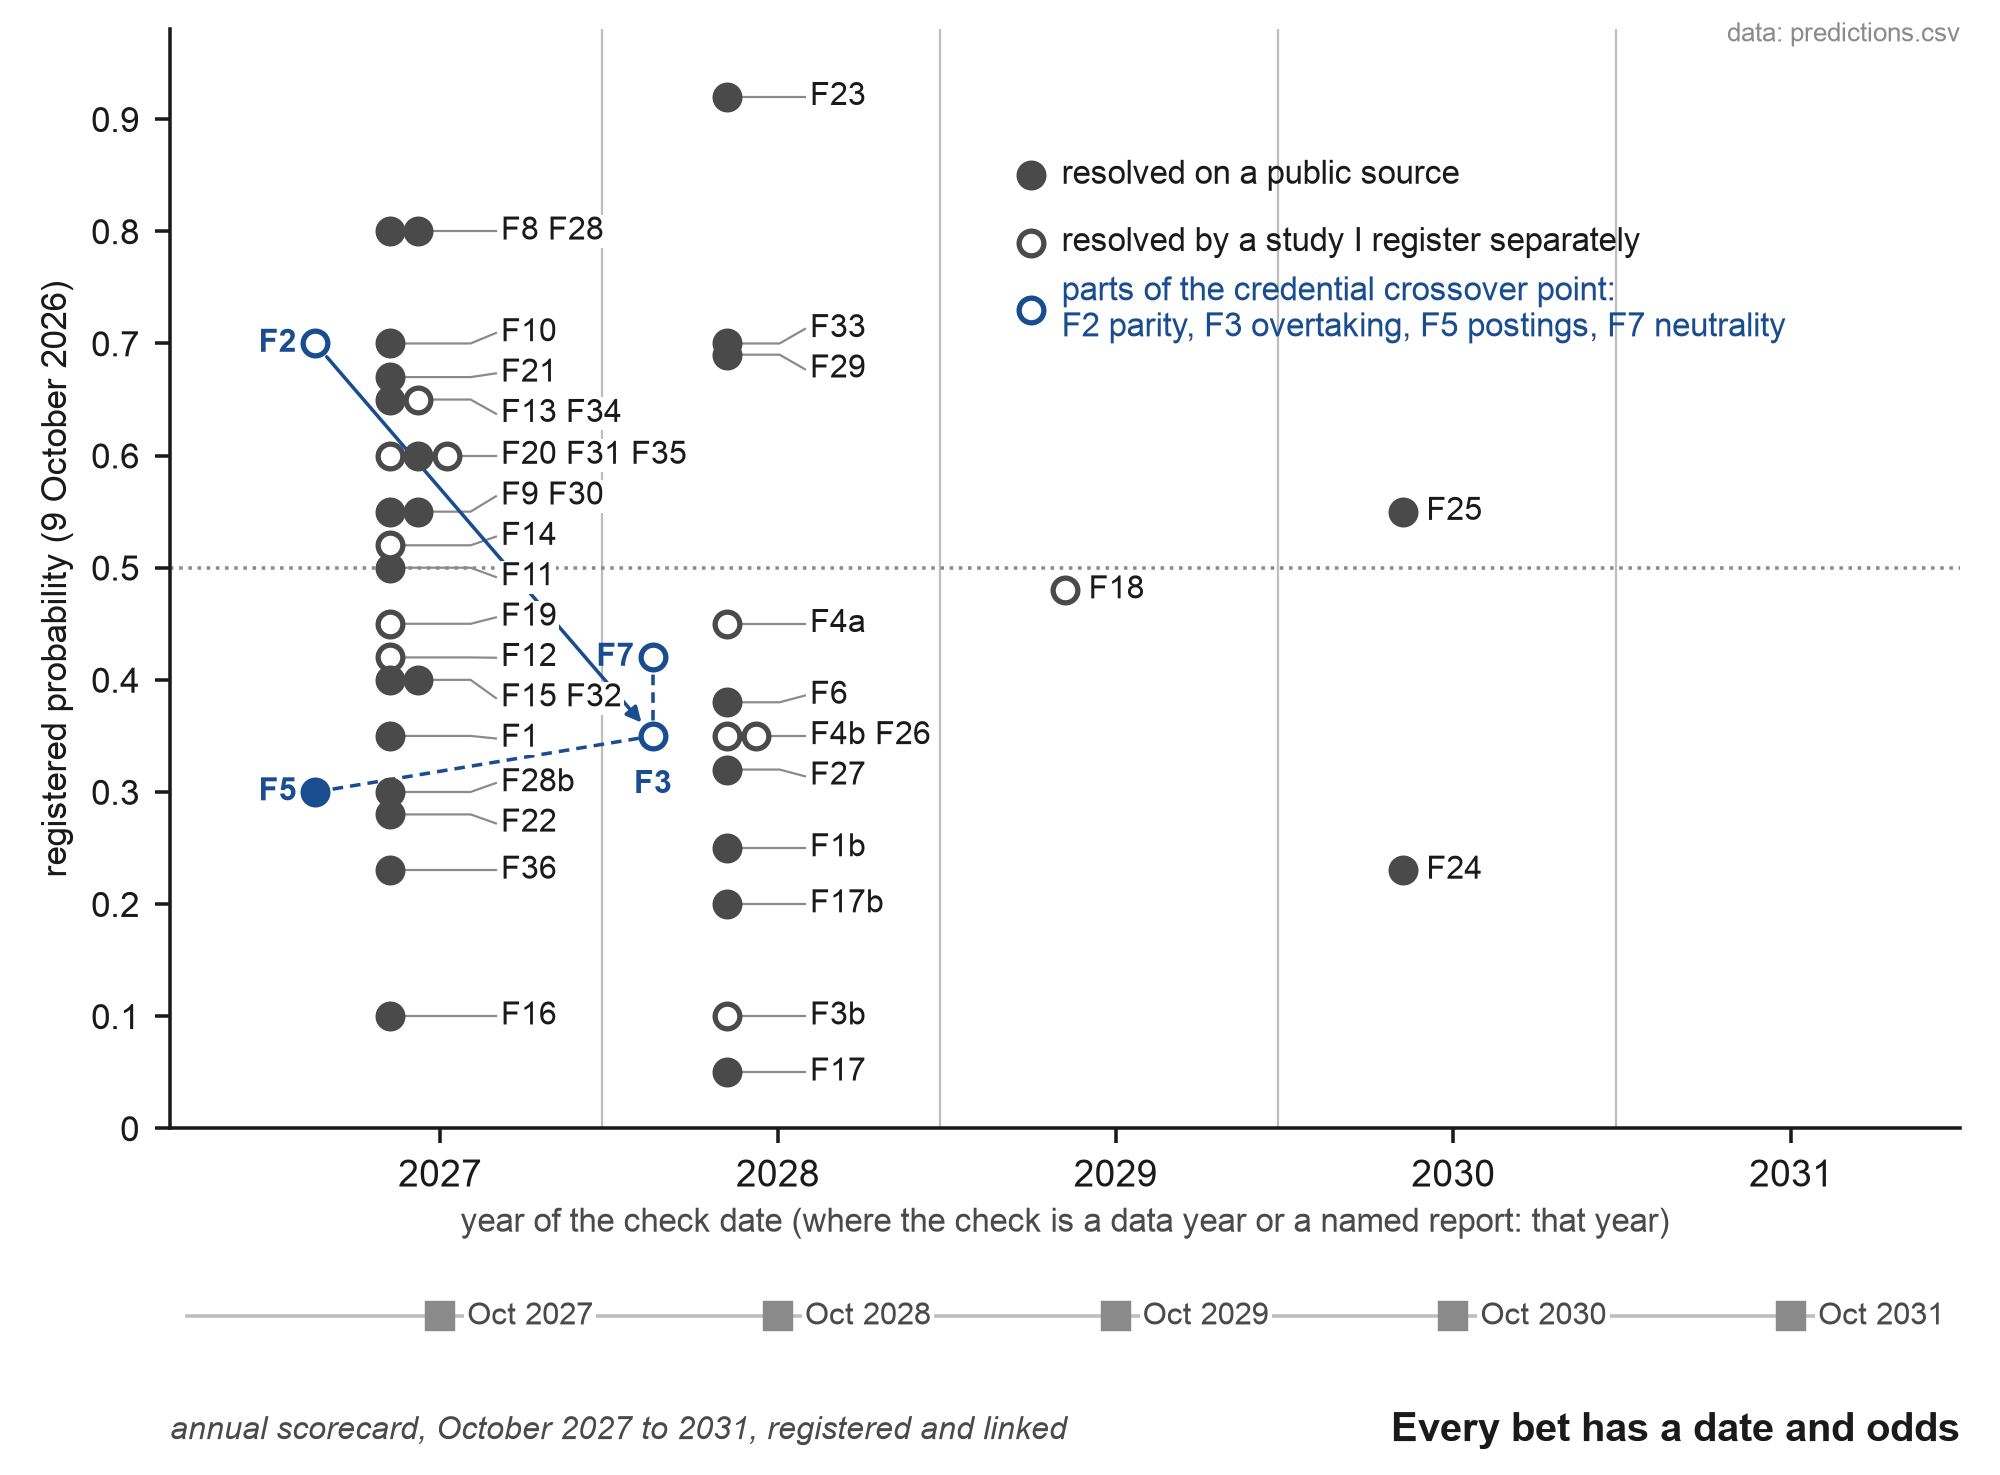
Nota: Cada marcador es una de las 41 predicciones de la Tabla A6, colocada en el año de su fecha de revisión (donde la revisión es un año de datos o un informe nombrado, ese año) y en su probabilidad registrada. Los marcadores rellenos se resuelven en una fuente pública. Los marcadores huecos se resuelven solo a través de un estudio preregistrado por separado antes de que se recopilen los datos. Las cuatro partes del punto de cruce de credenciales están en el color de acento: la paridad de calidad (F2) conduce al adelantamiento (F3). El cruce en los anuncios (F5) es su signo visible y la neutralidad de fondo (F7) su mecanismo. Solo la paridad tiene precio superior a probabilidades iguales (0.70). El adelantamiento, el momento en sí, se sitúa en 0.35. Los cuadrados debajo del eje marcan los cuadros de mandos anuales, que se registrarán en OSF y se vincularán por DOI, octubre de 2027 a 2031. Las probabilidades se fijaron el 9 de octubre de 2026 y se registran en OSF.
Una medición anual acompaña las predicciones sin ser una predicción en sí, una carrera de nombres: cada año las mismas consultas cuentan con qué frecuencia aparece cada candidato de la Tabla A2 en los anuncios estadounidenses y en OpenAlex y Crossref. La pregunta que alguna vez fue solo una verificación a largo plazo, si SOC 2028 nombrará una ocupación para el trabajo dirigido por agentes, es ahora la predicción F23, con una probabilidad (Bureau of Labor Statistics, 2026b). El 9 de octubre de 2026, la Oficina de Estadísticas Laborales no había publicado ni una estructura SOC 2028 propuesta ni final; se espera que la estructura final sea en 2027.
11.3 Pronósticos anteriores
El 9 de octubre de 2026 busqué en Metaculus, Manifold, Good Judgment Open, Kalshi, Polymarket y Long Bets, así como en la web abierta (páginas de investigación de empresas, comunicados de analistas, arXiv, SSRN y noticias), pronósticos datados de que personas sin educación técnica, trabajando a través de agentes de IA, igualarían o superarían a los programadores que usan los mismos agentes. Ninguno de los encontrados lleva una fecha y un resultado refutador. Los más cercanos son estos. Gartner pronosticó en 2021 que para 2024, el 80% de los productos y servicios tecnológicos serían construidos por personas que no son profesionales tecnológicos (Gartner, 2021). Mark Cuban dijo en 2017 que preferiría ser licenciado en filosofía, esperando que el pensamiento crítico superara el valor de la programación (Black Enterprise, 2017). D. H. Hansson respondió «100%» en el Podcast de Lex Fridman del 26 de agosto de 2026 cuando se le preguntó si hay problemas para los cuales los programadores son peores que los no programadores en ingeniería agentica (Lex Fridman Podcast, 2026). Anthropic observó en junio de 2026 que los agentes de codificación están haciendo que la experiencia en codificación sea menos relevante (Anthropic, 2026e). Existen pronósticos en la dirección opuesta. Gartner espera que el 60% de las aplicaciones codificadas al tanteo se retiren para 2028 (Gartner, 2026, resumido por Tray.ai, 2026), y esperaba en 2024 que a través de 2026 una quinta parte de las organizaciones usaría IA para aplanar su estructura (Gartner, 2024). Srinivasan y Wei (2026) esperan que «gestor de agentes» se convierta en un título estándar dentro de 12 a 18 meses. Forrester esperaba que el 60% de las empresas Fortune 100 designara un jefe de gobernanza de IA (Forrester, 2025). Los mercados en Manifold colocan una tercera parte menos de funciones de desarrollador junior para 2030 en aproximadamente el 74%, y una caída de más del 15% en desarrolladores estadounidenses de 2023 a 2028 en aproximadamente el 42% (Manifold, 2026b; Manifold, 2026c). En Manifold, la probabilidad de que sea común para 2027 que los no programadores escriban pequeños scripts con IA fue cercana al 27% (Manifold, 2026a), y esa pregunta trata solo el uso, sin medida de calidad. Las predicciones aquí difieren de todas estas en comparar personas con personas que usan el mismo agente, en hacer de la educación la variable, y en llevar una fecha, una medida y un resultado refutador. El registro de búsqueda está en el Apéndice B. La adopción en capas (Rogers, 2003), los horizontes de tiempo de máquina (Kwa et al., 2025) y la observación de que los roles junior se están reduciendo son trabajos anteriores, y no se reclama prioridad para ellos.
11.4 Congelación y puntuación
¿Dónde debería vivir una predicción para que nadie, ni siquiera su autor, pueda cambiarla discretamente? De los lugares que esta serie utiliza, solo uno se congela. Un registro de OSF no puede ser editado ni eliminado; puede ser retirado, pero permanece una página con su título, fechas, DOI y la razón para su retiro (OSF, 2026). Zenodo permite al depositante cambiar o eliminar archivos durante 30 días después de la publicación, y solo nuevas versiones después de eso (OpenAIRE, 2025). SSRN reemplaza el PDF en la revisión. Por lo tanto, las predicciones se registrarán primero en OSF, como un registro abierto hecho público inmediatamente, sin periodo de embargo, porque un embargo ocultaría el registro y retendría su DOI, y una prioridad que nadie puede ver vale poco.
El 9 de octubre de 2026, la tabla fue registrada en OSF como un conjunto de predicciones preregistradas (DOI 10.17605/OSF.IO/VW6P9), y el artículo fue publicado en SSRN y Zenodo; las instantáneas de cada fuente de referencia están archivadas en la Wayback Machine. Cada año de 2027 a 2031, en el aniversario del registro, se publica un cuadro de resultados que enumera cada predicción sin excepción, su estado (se cumplió, no se cumplió, aún no vencida, sin resolver, no realizada) y la evidencia. Informa la puntuación de Brier sobre predicciones resueltas en general, por conjunto y por familia, donde las predicciones vinculadas cuentan una vez, agrupadas como en la columna de familia de la tabla registrada (F1 y F1b; F2, F3 y F3b; F4a y F4b; F5, F6 y F33; F9 y F31; F15 y F16; F17 y F17b; F28 y F28b); la proporción resuelta; un límite en el peor caso en el que cada predicción pasada su fecha final y aún sin resolver, y cada predicción no realizada, se puntúa como si el pronóstico hubiera sido incorrecto; la puntuación con y sin las predicciones no realizadas; y la puntuación de habilidad de Brier contra tres referencias: un 0,5 constante, los pronósticos agregados del modelo de la Tabla 4, y el precio de mercado donde existía un mercado en el día del registro. Por lo tanto, la no resolución selectiva no puede mejorar la puntuación. El cuadro de resultados se registra a su vez en OSF, vinculado al original por DOI, y se deposita en Zenodo. Modelos de al menos dos familias verifican cada cuadro de resultados independientemente contra las reglas congeladas; cuando no están de acuerdo, la regla decide y el desacuerdo se reporta. El texto del registro está en el Apéndice D, y la Figura A1 (Apéndice D) muestra el calendario completo de fechas de verificación y finales. Dos compromisos vencen antes de que comience la puntuación. La muestra de productos construidos por agentes para F27 se congela en Zenodo para el 31 de diciembre de 2026, y los valores base de F5 y F30 se calculan y se archivan antes del registro. El protocolo de la muestra de F27, con un valor predeterminado para cada opción que deja abierta el registro, y la herramienta que la genera mediante una semilla fijada de antemano y la sella están en el repositorio complementario (kits/f27-sample.md, tools/freeze_sample.py).
Una vez que las predicciones estén registradas, las públicas también se publicarán donde los pronosticadores externos puedan establecer precios en ellas: cinco mercados en Manifold (F5, F8, F10, F11 y F22, que son gratuitos para publicar; estos cinco se eligieron porque cada uno se resuelve en una fuente pública y una serie externa que cualquiera puede leer, sin ninguno de mis propios datos), una pregunta en Metaculus (el cruce en publicaciones, F5), y la Plataforma de Predicción de Ciencias Sociales para los experimentos de F2, F3 y F7, de modo que se recopilen los pronósticos de otras personas antes de que existan los datos. No se utilizan mercados de predicción que cotizan dinero sobre el resultado.
11.5 El programa de cohorte
Dirijo un programa de cohorte preregistrado (OSF, https://osf.io/x4egq, DOI 10.17605/OSF.IO/X4EGQ) que sigue a no programadores desde chat hasta agentes hasta orquestación (Chernets, 2026e). Su primera cohorte es un estudio de viabilidad de un solo brazo con sus propios resultados registrados, que se informan en su propio informe. Predicciones tales como F7, F14 y F18 a F20, que necesitan datos a nivel de persona, se prueban en una cohorte posterior registrada para ellas antes de que se recopilen los datos, con una pregunta sobre educación en TI entre sus elementos congelados. Los registros del Apéndice C, mantenidos con consentimiento, son los datos naturales para esa cohorte.
12. La evidencia que contradice las predicciones
Las predicciones de la Sección 11 van en contra de varios tipos de evidencia de 2026, y cada uno de ellos configuró una regla de la medida o una predicción.
La seguridad no ha mantenido el ritmo. En más de cien modelos, la proporción de código generado que pasó las pruebas de seguridad se mantuvo en el 56% en el informe de Veracode de 2026 (Veracode, 2026). Esas pruebas se ejecutaron solo en modelos, bajo indicaciones estándar sin instrucciones de seguridad, y sin un arnés de agente, herramientas o revisión humana, por lo que describen el material bruto del que una persona comienza. Un escaneo pasivo de 5.600 aplicaciones públicas construidas mediante programación intuitiva encontró más de 2.000 vulnerabilidades, más de 400 secretos expuestos y 175 exposiciones de datos personales, y sus autores presentan estos como un límite inferior (Escape, 2026). Por eso F2 incluye una revisión de seguridad ciega, y por eso el trabajo irreversible necesita que cada pieza pase (Sección 5.2).
Pasar pruebas no es suficiente para la aceptación. METR pidió a los mantenedores que revisaran correcciones escritas por agentes que habían pasado las pruebas de un benchmark y encontró que aproximadamente la mitad no habrían sido fusionadas tal como estaban; los agentes eran de una generación anterior sin un ciclo de revisión, por lo que la proporción puede ser ahora menor (METR, 2026b). La regla de puntuación responde con pruebas ocultas, revisores calificados y uso real, y F2 agrega un cambio de mantenimiento un mes después.
La verificación depende de la experiencia. En una encuesta de 162 personas que construyen mediante programación intuitiva, cada grupo reconoció los riesgos del código generado, pero la forma en que lo revisaban variaba con la experiencia. Los autores llaman a esto una brecha de percepción-acción (Fawzy et al., 2026). Los usuarios empresariales y los novatos producen prototipos funcionales rápidamente, mientras que la calidad del código es inconsistente y requiere rehacer (Gama et al., 2026). Los usuarios empresariales también pasaron por alto errores importantes en el análisis de una IA incluso después de ser advertidos (Virk & Liu, 2025). Un estudio aleatorizado de 52 ingenieros junior que aprendían una nueva biblioteca encontró puntuaciones de comprensión del 50% con IA frente al 67% sin IA, y sin mejora significativa en velocidad. Aquellos que pidieron al modelo explicaciones obtuvieron puntuaciones del 65% o más, y aquellos que entregaron todo el código obtuvieron menos del 40% (Anthropic, 2026c). Esta es la razón más fuerte por la que la medida se basa en la alfabetización de aceptación y errores implantados: la habilidad que distingue a las personas es la que estos estudios muestran que varía.
Ninguna comparación publicada enfrenta no programadores con programadores que utilizan los mismos agentes. Esnaola et al. (2026) encontraron que algunos no programadores que utilizaban GPT-4o a través de ChatGPT resolvieron pequeños problemas de programación bien especificados a un nivel comparable al de programadores que trabajan sin IA, y más rápido; los autores califican el estudio como exploratorio. Los programadores trabajaban sin IA, por lo que el diseño no tenía un brazo de programadores con IA, y estudiaba tareas individuales breves, no desarrollo sostenido; un paquete de replicación es público (Esnaola et al., 2026). En los datos de Anthropic, las personas nuevas en una tarea tenían una tasa de éxito verificada del 15% contra el 28% al 33% para usuarios más experimentados (Anthropic, 2026e). Allí, "novato" significa un novato en la tarea, según lo juzgado por un modelo, y no dice nada sobre educación en TI. Si esa brecha refleja educación o familiaridad con la tarea es lo que F7 está escrito para separar. Más aún, la IA generativa en una empresa de atención al cliente aumentó mucho la productividad de los agentes novatos y poco calificados, pero poco la de los más experimentados (Brynjolfsson et al., 2025), un predecesor anterior a los agentes. En 2024 un experimento de campo en Procter & Gamble con modelos de chat encontró que individuos con IA igualaban equipos sin IA y producían trabajo equilibrado independientemente de su trasfondo profesional, un predecesor anterior a los agentes (Dell'Acqua et al., 2025). F2, F3 y F7 están diseñados para proporcionar la comparación faltante.
Voces respetadas están en desacuerdo con la versión fuerte. Karpathy mantiene un piso y un techo (Sección 2.1). Andrew Ng argumentó en agosto 2026 que los desarrolladores que entienden profundamente cómo funcionan los programas superan ampliamente a aquellos que programan intuitivamente sin esa comprensión (Ng, 2026). Los datos de contratación señalan el mismo patrón por ahora: los anuncios que requieren habilidades de IA aún tienen más probabilidades de requerir un título de cuatro años que los anuncios comparables que no lo hacen (Lightcast, 2026b), y LinkedIn atribuye gran parte de la debilidad en la contratación de nivel de entrada a la economía (Sección 2.4). Las predicciones toman estas opiniones como su contraparte, con cuotas de apuesta establecidas de antemano.
13. Alcance y condiciones límite
Tiempo. La evidencia llega hasta el 9 de octubre de 2026. Los datos del producto se desactualizarán rápidamente, por lo que la medida se define en términos de horas de referencia y verificaciones, sin mencionar producto alguno.
Fuentes. Gran parte de la evidencia más sólida proviene de proveedores sobre sus propios productos: OpenAI sobre su agente de codificación, Anthropic sobre sus sesiones. Estos se marcan como datos de proveedores y se utilizan para lo que los proveedores pueden saber. Varios episodios reportados por la prensa, como las clasificaciones de tokens, se basan en reportes de medios identificados y se citan como tales. Las fuentes secundarias (Growthy, Startup Fortune, Shopifreaks) se archivan en la Wayback Machine antes de su publicación, y el informe principal se cita dondequiera que pudiera alcanzarse.
Población. El argumento se refiere al trabajo realizado en una computadora, a través de agentes, por personas que pueden verificarlo. Las personas sin una computadora que controlen, y el trabajo que no puede verificarse en absoluto, quedan fuera de la medida.
Lo que afirma la medida. Un horizonte verificado describe lo que una persona entregó bajo un régimen de verificación, en un dominio, en una fecha. No afirma que mayor sea mejor para cada tarea. Gran parte del trabajo pertenece a Hour, y elegir mantener el trabajo manual es una decisión legítima. En dominios donde un error no puede deshacerse, se aplica el umbral más estricto de la Sección 5.2, y parte del trabajo no debería entregarse a agentes en absoluto.
Nombres. El mapa de la Sección 3 registra el uso encontrado el 8 y 9 de octubre de 2026. Los nombres serán adoptados y abandonados después de eso, por lo que el mapa se empareja con una carrera anual de nombres y no se elige un solo nombre.
La tesis fuerte. Que las personas sin educación técnica construirán mejores productos que los programadores se plantea como un conjunto de predicciones con fechas y umbrales (F2 a F7). Lo presento como un pronóstico, para ser calificado públicamente.
Actos reservados por ley. Cuando la ley reserva un acto a una licencia, ni la medida ni la pérdida de peso por puertas de etiqueta (Secciones 6.2 y 6.5) mueve ese acto. En el Reino Unido nadie puede actuar como statutory auditor quien no sea elegible para el nombramiento, lo que requiere ser miembro de un organismo supervisor reconocido y cumplir con sus reglas (Companies Act 2006, ss. 1212 y 1213), y en los Estados Unidos solo una firma registrada en la Public Company Accounting Oversight Board puede preparar o emitir un informe de auditoría sobre un emisor (Sarbanes-Oxley Act of 2002, s. 102). En contabilidad tales reservaciones son estrechas: un empleado de contabilidad en los Estados Unidos generalmente no está obligado a tener ni siquiera una certificación (Bureau of Labor Statistics, 2026c). En derecho son más amplias: Inglaterra y Gales reservan seis actividades legales, entre ellas la conducción de litigios y actividades de sucesión (Legal Services Act 2007, s. 12). El trabajo puede por lo tanto moverse mientras la firma permanece, y el firmante con licencia luego realiza la función de garante de la Sección 7.2 en una forma que la ley ya ha contemplado. Hasta qué punto una licencia misma se admite por una etiqueta o por trabajo verificado se discute en la Sección 6.2.
Datos anteriores a agentes. Las series anteriores a 2025 entran solo como predecesoras, porque describen trabajo sin agentes. La macroeconomía de la contratación se lleva por los datos de LinkedIn de 2026 (Sección 2.4), que apuntan más a la economía que a la IA.
Estado de las afirmaciones. La Tabla A7 (Apéndice F) aplica el lenguaje de confianza de la serie a cada elemento.
14. Conclusión
Un contador que compara agentes de codificación y una abogada que construye su propio verificador de contratos ahora trabajan de la manera en que lo hace una desarrolladora cuando entrega un módulo a un agente y verifica el resultado. Para 2026 los tres comparten un flujo de trabajo, y ninguna de las antiguas escalas puede decir cuál de ellos ha avanzado más. Un título no lo resolvería, porque cada título propuesto en 2026 es o bien un eslogan o un anuncio de empleo de alguien, y el mercado no ha elegido entre ellos. Una medida puede resolverlo, siempre que cuente la cosa correcta.
La medida propuesta aquí no espera a que se nombre la profesión. Lee al contador, la abogada y la desarrolladora en una escala, el tamaño del trabajo que cada uno entregó a agentes y verificó, en un dominio y en una fecha, con un segundo eje para cuánto trabajo verificado una hora de su propia atención compró. Sus umbrales se versionan y se prueban en el escritorio, y la prueba de escritorio ya ha corregido uno de ellos; sus reglas nombran las formas en que el registro puede ser manipulado y una defensa para cada una, y su techo explica por qué el precio de la verificación establece el límite sin importar la velocidad del agente. Para un empleador, una escuela o una plataforma la pregunta cambia. En lugar de preguntar si una persona es programadora, o cuánta IA utilizó, piden un día de trabajo en el campo propio de la persona que pasó una verificación que la persona no diseñó. Cualquier nombre que el mercado elija puede leerse en esa escala.
Las predicciones fechadas llevan la tesis que comenzó este documento. Dominio por dominio, los productos realizados por personas sin educación en TI comenzarán a superar los de programadores que utilizan los mismos agentes. En un horizonte verificado igual, una educación en programación dejará de predecir la calidad del trabajo verificado. Y en las ofertas de empleo, las líneas de requisitos de titulación se cruzarán, primero en dominios donde los expertos pueden aceptar el trabajo por sí mismos y finalmente en software. Si las tarjetas de puntuación de 2027 y 2028 van contra estos pronósticos, lo dirán en público, con una puntuación de Brier. Si los pronósticos se cumplen, las palabras junior y senior pueden sobrevivir, con su significado desplazado hacia el tamaño del trabajo que una persona puede probar; si los grandes empleadores reemplazan sus escalas de calificación con tal medida es en sí mismo una predicción aquí (F17), registrada en p = 0.05.
Un límite permanecerá sea lo que sea que suceda con estas predicciones. La construcción se está convirtiendo en una alfabetización, como la escritura. Responder por lo que se construye sigue siendo una profesión, y entre los dos está la obscuridad, la condición del mercado de 2026, en la que el buen trabajo pasa desapercibido y las plataformas cierran sus puertas a lo desconocido. La persona que construye a través de agentes necesitará un socio que firme el trabajo, o tendrá que convertirse en ese socio, y el garante a su vez puede medirse por lo que avalizó y cuánto de ello se mantuvo.
Un dicho estadounidense sostiene que Dios creó a los hombres y el Coronel Colt los hizo iguales. Los agentes hacen algo parecido para la fabricación: con uno, una persona fuera del oficio puede producir trabajo que se parece al del oficio. La verificación es más difícil de igualar (Secciones 5.2 y 12). En el estudio de calificadores del Apéndice G, casi una de cada cinco personas admitidas en la muestra de contabilidad con su propia palabra respondieron incorrectamente una pregunta de la primera semana del oficio, y en una comparación exploratoria calificaron las tareas más grandes con menos horas de lo que hicieron los demás (Apéndice G2). Si un proceso de verificaciones independientes puede hacer para la verificación lo que los agentes hicieron para la fabricación es la pregunta abierta de la Sección 6.5. Lo que aún separa a las personas es lo que pueden verificar y aceptar, y eso es lo que mide el horizonte de delegación verificado.
Declaraciones
Financiación. Este trabajo no fue financiado con fondos externos.
Conflictos de interés. El autor desarrolla métodos de orquestación multimodelo y ha presentado solicitudes de patente relacionadas (en trámite; ninguna patente ha sido otorgada). El autor diseñó el programa de cohorte preregistrado descrito en la Sección 11.5 y el Apéndice G y sus materiales, y desarrolla una aplicación educativa que ayuda a las personas a trabajar con agentes de IA. Ninguno de los hallazgos en este artículo depende de la implementación del autor; el instrumento en el Apéndice C utiliza solo la biblioteca estándar de Python.
Herramientas y verificación. Se utilizaron asistentes de IA como instrumentos bajo la dirección del autor; las ideas, la investigación y las conclusiones son del autor. Las afirmaciones cuantitativas y las citas se verificaron contra fuentes primarias o copias archivadas al 9 de octubre de 2026, o al 10 de octubre de 2026 para las fuentes añadidas ese día, donde pudieron recuperarse. Cuando solo estaba disponible un comunicado de prensa o una página de un proveedor, la afirmación se atribuyó a ese comunicado o proveedor en el texto. Los títulos dados entre corchetes en las referencias son títulos descriptivos para páginas cuyo titular no fue releído textualmente.
Disponibilidad de datos y código. El código y el esquema del Apéndice C, la prueba de escritorio de los umbrales (Apéndice E) y los archivos de predicción se publican bajo la licencia MIT en un repositorio complementario (https://github.com/vadimchernets/delegation-horizon), archivado en Zenodo como versión v1.1.0 (DOI conceptual 10.5281/zenodo.23267444, que se resuelve en la versión más reciente); el código impreso en el Apéndice C es idéntico al del repositorio, byte por byte, y tools/paper_sync.py verifica esto, el ejemplo trabajado y las Tablas 4 y A6 contra el repositorio siempre que sus pruebas se ejecuten junto a este texto. Las predicciones de las Tablas 4 y A6 se registraron en OSF el 9 de octubre de 2026 (DOI 10.17605/OSF.IO/VW6P9). El estudio de calificadores de Prolific del Apéndice G se registró en OSF el 9 de octubre de 2026, antes de que se recopilaran datos (DOI 10.17605/OSF.IO/V92R8); su script de análisis (pilot/human_raters.py) se archiva con ese registro y está en el repositorio complementario tal como se archivó, con el SHA-256 que OSF reporta para cada archivo archivado listado en pilot/registered-SHA256.txt, junto con los scripts que convierten las exportaciones de Prolific, imprimen la Tabla G2 y ejecutan la comparación de G2 que no fue registrada. Los datos anonimizados, con identificadores de Prolific reemplazados por etiquetas simples, se agregarán a la misma carpeta. Los archivos registrados con las predicciones se enumeran con su SHA-256 en predictions/registered-SHA256.txt, el manifiesto archivado en OSF, y una prueba del repositorio los compara a todos con él.
Ética. El Apéndice G reporta dos fuentes de datos de personas. El estudio de calificadores de Prolific es una tarea de calificación en línea anónima: profesionales adultos dieron consentimiento informado en Prolific antes de participar, fueron pagados a través de la plataforma, y no proporcionaron nombres ni detalles de contacto. El relato de la cohorte resume, sin nombres, lugares o idiomas, los registros de adultos que consintieron al programa de cohorte preregistrado (OSF, DOI 10.17605/OSF.IO/X4EGQ) y a la publicación anonimizada; los resultados registrados del programa se reportan por separado. El trabajo fue realizado por un investigador independiente sin un comité de ética institucional. Los hilos públicos discutidos en la Sección 9 se parafrasean, y sus autores no se nombran.
Contribuciones del autor. Autor único.
Correspondencia. vadimchernets9@gmail.com · ORCID: 0009-0007-4845-3163
References
9to5Mac. (2026). [App Store new apps doubled in the first half of 2026, Sensor Tower data reported by The New York Times]. https://9to5mac.com/?p=1061510
AI Certification Standards. (2026). AI Competence Framework (version of 23 August 2026). https://www.aicertificationstandards.org/framework
AI Futures Project. (2026, April 2). Q1 2026 timelines update. https://blog.aifutures.org/p/q1-2026-timelines-update
aicodex. (2026). AI agent manager vs agent operator. https://www.aicodex.to/articles/ai-agent-manager-vs-agent-operator
Alenezi, M. (2026). From determinism to delegation: AI-native software engineering and the evolution of the agentic engineer. arXiv:2606.28791. https://arxiv.org/abs/2606.28791
Alonso, M. N. (2026). The artificial intelligence economy [working paper, ResearchGate; contains the proposition "A delegation horizon"].
AlternativeTo. (2026, January). OpenAI rolls out age prediction for ChatGPT accounts. https://alternativeto.net/news/2026/1/openai-rolls-out-age-prediction-for-chatgpt-accounts-to-automatically-estimate-your-age/
Andrist, R. K. (1962). Gold! American Heritage, 14(1). https://www.americanheritage.com/content/gold
Amplifying. (2026). What Claude Code actually chooses. https://amplifying.ai/research/claude-code-picks
Anthropic. (2025a, December 2). How AI is transforming work at Anthropic. https://www.anthropic.com/research/how-ai-is-transforming-work-at-anthropic
Anthropic. (2025b). AI Fluency framework (the four Ds). https://aifluencyframework.org/
Anthropic. (2026a, January 15). Anthropic Economic Index report: Economic primitives. https://www.anthropic.com/research/anthropic-economic-index-january-2026-report
Anthropic. (2026b, January 22). Claude's constitution. https://www.anthropic.com/constitution
Anthropic. (2026c, January 29). [AI assistance and coding skills: a randomised study of junior engineers]. https://www.anthropic.com/research/AI-assistance-coding-skills
Anthropic. (2026d, March 24). Anthropic Economic Index report: Learning curves. https://www.anthropic.com/research/economic-index-march-2026-report
Anthropic. (2026e, June 16). Agentic coding and persistent returns to expertise. https://www.anthropic.com/research/claude-code-expertise
Anthropic. (2026f, June 26). [Anthropic Economic Index report, June 2026]. https://www.anthropic.com/research/economic-index-june-2026-report
Arion Research. (2026, February 7). [The agent manager role]. https://www.arionresearch.com/blog/nfkxv53ktwxqkwtxwm2d03woml1c65
Artificial Lawyer. (2026, January 27). Claude Cowork: the DIY revolution in law. https://www.artificiallawyer.com/2026/01/27/claude-cowork-the-diy-revolution-in-law/
Atkinson, T., & Yamco, S. (2026, January 6). Young workers' employment drops in occupations with high AI exposure. Federal Reserve Bank of Dallas. https://www.dallasfed.org/research/economics/2026/0106
Batko, M. (2026, August 20). [Distribution is the moat]. Startmate. https://startmate.com/writing/distribution-is-the-moat
Benchek, J., et al. (2026). APEX-Accounting. arXiv:2607.27189. https://arxiv.org/abs/2607.27189
Berkeley California Management Review. (2025, July). Rethinking AI agents: A principal-agent perspective. https://cmr.berkeley.edu/2025/07/rethinking-ai-agents-a-principal-agent-perspective/
BetterUp. (2026, May 18). [Workslop research with Stanford]. https://www.betterup.com/blog/workslop-canada
Black Enterprise. (2017). [Mark Cuban on liberal arts and the future of work]. https://www.blackenterprise.com/mark-cuban-right-libreal-arts-key-future/amp/
Bloomberg Law. (2026, April 20). Vibe coding empowers lawyers to influence AI winners, losers. https://news.bloomberglaw.com/legal-exchange-insights-and-commentary/vibe-coding-empowers-lawyers-to-influence-ai-winners-losers
Bone, M., González Ehlinger, E., & Stephany, F. (2025). Skills or degree? The rise of skill-based hiring for AI and green jobs. Technological Forecasting and Social Change. https://doi.org/10.1016/j.techfore.2025.124042
Brier, G. W. (1950). Verification of forecasts expressed in terms of probability. Monthly Weather Review, 78(1), 1-3. https://doi.org/10.1175/1520-0493(1950)078<0001:VOFEIT>2.0.CO;2
Bancroft, H. H. (1888). History of California (Vol. 6, 1848-1859). The History Company. https://archive.org/details/historyofcaliforv6banc
Brynjolfsson, E., Li, D., & Raymond, L. (2025). Generative AI at work. The Quarterly Journal of Economics, 140(2), 889-942. https://doi.org/10.1093/qje/qjae044
Bureau of Labor Statistics. (2025). Photographers. Occupational Outlook Handbook, 2024-34 edition (archived 19 August 2026). https://web.archive.org/web/20260819060531/https://www.bls.gov/ooh/media-and-communication/photographers.htm
Bureau of Labor Statistics. (2026a). Photographers. Occupational Outlook Handbook (updated 27 August 2026). https://www.bls.gov/ooh/media-and-communication/photographers.htm (archived copy: https://web.archive.org/web/20261001165113/https://www.bls.gov/ooh/media-and-communication/photographers.htm)
Bureau of Labor Statistics. (2026b). 2028 SOC revision. https://www.bls.gov/soc/2028/2028_soc_revision.htm
Bureau of Labor Statistics. (2026c). Bookkeeping, accounting, and auditing clerks. Occupational Outlook Handbook (updated 27 August 2026). https://www.bls.gov/ooh/office-and-administrative-support/bookkeeping-accounting-and-auditing-clerks.htm
Burning Glass Institute & Harvard Business School. (2024). Skills-based hiring: The long road from pronouncements to practice. https://www.burningglassinstitute.org/research/skills-based-hiring-2024
Business Insider. (2026, January 22). [Deloitte gives US employees new job titles]. https://www.businessinsider.com/deloitte-gives-us-employees-new-job-titles-leader-role-2026-1
Cagan, M. (2025). The era of the product creator. SVPG. https://www.svpg.com/the-era-of-the-product-creator/
Capps, R. (2025, June 17). [New jobs that AI could create]. The New York Times Magazine. https://www.nytimes.com/2025/06/17/magazine/ai-new-jobs.html
Carta. (2025). Solo founders report 2025. https://carta.com/data/solo-founders-report
Carta. (2026a). 2026 founder ownership report. https://carta.com/data/founder-ownership-2026-full-report/
Carta. (2026b). State of pre-seed: Q2 2026. https://carta.com/data/state-of-pre-seed-q2-2026/
Challenger, Gray & Christmas. (2026). [Job cuts report, June 2026]. https://www.challengergray.com/wp-content/uploads/2026/07/Challenger-Report-June2600986996.pdf
Chen, X., & Meng, S. (2026). When AI levels the playing field: Skill homogenization, asset concentration, and two regimes of inequality. arXiv:2603.05565. https://arxiv.org/abs/2603.05565
Catalini, C., Hui, X., & Wu, J. (2026). Some simple economics of AGI. arXiv:2602.20946. https://arxiv.org/abs/2602.20946
Celenza, B. (2026, October 6). Building Git infrastructure for agent-scale development. GitHub Blog. https://github.blog/engineering/architecture-optimization/building-git-infrastructure-for-agent-scale-development/
Chernets, V. (2026a). After Chat: The three transitions between non-programmers and agentic AI. SSRN. https://doi.org/10.2139/ssrn.7520019 (Zenodo: https://doi.org/10.5281/zenodo.22943313)
Chernets, V. (2026b). Agreement is not independent evidence: Auditable multi-model synthesis without an API. SSRN. https://doi.org/10.2139/ssrn.7390698
Chernets, V. (2026c). AI-Watchbird (Sheckley): When automated oversight widens its own mandate and harms what it guards. SSRN. https://doi.org/10.2139/ssrn.7473658
Chernets, V. (2026d). Architectural trust: Why consumer trust in agentic commerce migrates from AI models to verifiable architecture. SSRN. https://doi.org/10.2139/ssrn.7191261
Chernets, V. (2026e). Three steps into agentic AI: A preregistered feasibility study of how non-programmers cross from chatbot to agent to multi-model orchestration (Cohort 1). OSF. https://doi.org/10.17605/OSF.IO/X4EGQ
CIO. (2026a, May 29). Amazon deletes devs' tokenmaxxing leaderboard to minimize costs. https://www.cio.com/article/4178825/amazon-deletes-devs-tokenmaxxing-leaderboard-to-minimize-costs-2.html
CIO. (2026b, September 4). Meta minimizes role of token-maxing in employee evaluations. https://www.cio.com/article/4218661/meta-minimizes-role-of-token-maxing-in-employee-evaluations-2.html
Clark, M. (2026). [Proposal for a Chartered Financial Intelligence Architect]. SSRN.
Collins Dictionary. (2025). Collins Word of the Year 2025. https://blog.collinsdictionary.com/language-lovers/collins-word-of-the-year-2025-ai-meets-authenticity-as-society-shifts/
Companies Act 2006, c. 46, ss. 1212 and 1213 (United Kingdom). Individuals and firms: eligibility for appointment as a statutory auditor; Effect of ineligibility (accessed 10 October 2026). https://www.legislation.gov.uk/ukpga/2006/46/section/1212 ; https://www.legislation.gov.uk/ukpga/2006/46/section/1213
Computing Research Association. (2026, June). [New CRA Taulbee Survey findings: record degree production alongside a cooling enrollment pipeline]. https://cra.org/crn/2026/06/cra-update-new-cra-taulbee-survey-findings-show-record-degree-production-alongside-a-cooling-enrollment-pipeline/
CSET. (2025). [Translation: China's notice on AI education in primary and secondary schools]. Center for Security and Emerging Technology. https://cset.georgetown.edu/publication/china-primary-secondary-ai-education-notice/
Crunchbase News. (2026, July 2). Crunchbase data: Global startup investment hit record $510B in H1 2026 as AI boom accelerates funding and exits. https://news.crunchbase.com/venture/global-startup-exits-ipo-ma-soar-ai-q2-h1-2026/
Danilova, A., Naiakshina, A., Horstmann, S., & Smith, M. (2021). Do you really code? Designing and evaluating screening questions for online surveys with programmers. 2021 IEEE/ACM 43rd International Conference on Software Engineering (ICSE), 537-548. https://doi.org/10.1109/ICSE43902.2021.00057
Dawson, R. (2026). [Framework: levels of AI delegation in decision making]. https://rossdawson.com/framework-levels-ai-delegation-decision-making
Dealroom. (2026). Mercor doubles to $2B gross revenue run-rate as AI labs buy expert data. https://dealroom.co/news/137121-mercor-doubles-to-2b-gross-revenue-run-rate-as-ai-labs-buy-expert-data/
Dell'Acqua, F., et al. (2025). The cybernetic teammate: A field experiment on generative AI reshaping teamwork and expertise. NBER Working Paper 33641. https://www.nber.org/papers/w33641
Dell'Acqua, F., et al. (2026). Navigating the jagged technological frontier: Field experimental evidence of the effects of artificial intelligence on knowledge worker productivity and quality. Organization Science, 37(2), 403-423. https://doi.org/10.1287/orsc.2025.21838
Digg. (2026). [Your job title is about to change: AI Agent Supervisor]. https://digg.com/aiagentchat/TvbtLF2/your-job-title-is-about-to
Dust. (2026, October 7). [Dust Index: AI strategy beyond models]. https://dust.tt/blog/dust-index-ai-strategy-beyond-models
EdWeek. (2026, June 11). [White House honors AI challenge winners]. https://www.edweek.org/technology/white-house-honors-ai-challenge-winners-as-tech-backlash-grows/2026/06
em360. (2026, September 7). [AI productivity and supervisory capacity]. https://em360tech.com/tech-articles/ai-productivity-supervisory-capacity
Engelbart, D. C. (1962). Augmenting human intellect: A conceptual framework (Summary Report AFOSR-3223). Stanford Research Institute.
Escape. (2026). Methodology: how we discovered vulnerabilities in apps built with vibe coding (accessed 9 October 2026). https://escape.tech/blog/methodology-how-we-discovered-vulnerabilities-apps-built-with-vibe-coding/
Esnaola, L. M., Ramón, H. D., & Lanzarini, L. C. (2026). Can generative AI bridge the gap? A quasi-experimental study of non-programmers with AI vs. programmers without AI. Empirical Software Engineering, 31(3), 75. https://doi.org/10.1007/s10664-026-10813-7 Replication package: https://doi.org/10.5281/zenodo.17803568
Eulerich, M., Sanatizadeh, A., Vakilzadeh, H., & Wood, D. A. (2024). Is it all hype? ChatGPT's performance and disruptive potential in the accounting and auditing industries. Review of Accounting Studies, 29(3), 2318-2349. https://doi.org/10.1007/s11142-024-09833-9
Fawzy, A., Tahir, A., & Blincoe, K. (2026). From prompting to verification: How experience shapes vibe coding practices. arXiv:2605.24521. https://arxiv.org/abs/2605.24521
Feldman, M. Q., & Anderson, C. J. (2024). Non-expert programmers in the generative AI future. CHIWORK 2024 (author version). https://www.feldmanmolly.com/chiwork2024-author-version.pdf
Feng, K. J. K., McDonald, D. W., & Zhang, A. X. (2025). Levels of autonomy for AI agents. arXiv:2506.12469. https://arxiv.org/abs/2506.12469
Flowtivity. (2026, February 24). Your boss will measure you in tokens. https://flowtivity.ai/blog/your-boss-will-measure-you-in-tokens/
Forrester. (2025, October). [Predictions 2026 for AI and technology leadership], as reported by iTWire. https://itwire.com/it-industry-news/strategy/forrester-unveils-2026-predictions-for-ai-and-tech-leadership.html
Fortune. (2025, May 7). [Prompt engineering, a six-figure role, now obsolete]. https://www.fortune.com/2025/05/07/prompt-engineering-200k-six-figure-role-now-obsolete-thanks-to-ai
Fortune. (2026a, January 22). [Deloitte's job title change]. https://www.fortune.com/2026/01/22/deloitte-job-title-change-ai-reshapes-big-4-accounting-consulting-firms
Fortune. (2026b, May 26). [Uber's chief operating officer on AI spending]. https://www.fortune.com/2026/05/26/uber-coo-ai-spending-tokens-claude-code/
Fortune. (2026c, July 7). [Cognition's chief executive on tokenmaxxing]. https://fortune.com/2026/07/07/cognition-ceo-tokenmaxxing-big-tech-carried-away-ai-productivity-gains/
Fox, S., Markham, L., Lail, R., & Karotsieris, M. (2026). LLM judges verify presence, not absence: Omission blindness in AI clinical notes and what recovers it. arXiv:2608.31016. https://arxiv.org/abs/2608.31016
Fu, H. Y., Shrivastava, A., Moore, J., West, P., Tan, C., & Holtzman, A. (2025). AbsenceBench: Language models can't tell what's missing. arXiv:2506.11440. https://arxiv.org/abs/2506.11440
Gama, et al. (2026). [Novice teams building software with AI]. ICSE 2026. arXiv:2512.02750. https://arxiv.org/abs/2512.02750
Gartner. (2009). Gartner Symposium/ITxpo Orlando brochure (use of "citizen developer"). https://www.gartner.com/imagesrv/symposium/pdf/orlando_symposium_conference_brochure.pdf
Gartner. (2021, June 10). Gartner says the majority of technology products and services will be built by professionals outside of IT by 2024. https://www.gartner.com/en/newsroom/press-releases/2021-06-10-gartner-says-the-majority-of-technology-products-and-services-will-be-built-by-professionals-outside-of-it-by-2024
Gartner. (2024, October 22). Gartner unveils top predictions for IT organizations and users in 2025 and beyond. https://www.gartner.com/en/newsroom/press-releases/2024-10-22-gartner-unveils-top-predictions-for-it-organizations-and-users-in-2025-and-beyond
Gartner. (2026). Tyagi, N. Govern vibe coding for citizen developers with self-service platforms (29 June 2026; document 8068765). https://www.gartner.com/en/documents/8068765 (subscriber access; figures cited as summarised by Tray.ai, 2026)
Gigazine. (2025, July 24). What are the results of the 'AccountingBench' benchmark, which tests an AI model for monthly accounting tasks? https://gigazine.net/gsc_news/en/20250724-accountingbench/
Gigazine. (2026, July 21). [Sensor Tower: new App Store apps in the first half of 2026]. https://www.gigazine.net/gsc_news/en/20260721-app-store-new-apps
GitHub. (2025a). Octoverse: A new developer joins GitHub every second as AI leads TypeScript to #1. https://github.blog/news-insights/octoverse/octoverse-a-new-developer-joins-github-every-second-as-ai-leads-typescript-to-1/
GitHub. (2025b, December 8). The new identity of a developer: What changes and what doesn't in the AI era. https://github.blog/news-insights/octoverse/the-new-identity-of-a-developer-what-changes-and-what-doesnt-in-the-ai-era/
Growthy. (2026, September 23). Claude Code vs Codex for bookkeeping. https://growthy.com/blog/claude-code-vs-codex-for-bookkeeping
Haize Labs. (2026). Vertical AI Lead [job posting]. https://job-boards.greenhouse.io/haizelabs/jobs/5173890008
Hashimoto, M. (2026). Vouch [repository]. https://github.com/mitchellh/vouch
HCA Magazine. (2026, July 29). [Atlassian introduces AI wallets for employees]. https://www.hcamag.com/ca/news/general/atlassian-introduces-new-ai-wallets-to-employees/584258
Hosseini, S. M., & Lichtinger, G. (2026, May 6). Generative AI as seniority-biased technological change [Working paper; earlier version SSRN 5425555, 2025]. https://raw.githack.com/s-mahdihosseini/Website/b99fa2962dcc4c165bbc3c41dd283afa99c5ccfb/GenAI_SenBTC_May_2026.pdf
Huang, L., Xiao, W., & Vishnoi, N. K. (2026). Delegation and verification under AI. Accepted at ICML 2026. arXiv:2603.02961. https://arxiv.org/abs/2603.02961
Hwang, J. (2026, February 13). Claude Code is the new Excel. https://nextword.substack.com/p/claude-code-is-the-new-excel
Indeed Hiring Lab. (2026, January 28). Where do college degrees still matter in a "skills-first" job market? https://hiringlab.indeed.com/2026/01/28/where-do-college-degrees-still-matter-in-a-skills-first-job-market/
IT Brew. (2026, June 5). AI orchestrators are the newest in-demand AI role. https://www.itbrew.com/stories/ai-orchestrators-are-the-newest-in-demand-ai-role
Jaques, E. (1956). Measurement of responsibility: A study of work, payment and individual capacity. Tavistock Publications. (Reviewed in Industrial and Labor Relations Review, 10(3), 475. https://doi.org/10.2307/2519792)
Jensen, M. C., & Meckling, W. H. (1976). Theory of the firm: Managerial behavior, agency costs and ownership structure. Journal of Financial Economics, 3(4), 305-360. https://doi.org/10.1016/0304-405X(76)90026-X
Journal of Accountancy. (2025, May 14). AICPA, NASBA approve new CPA licensure path. https://www.journalofaccountancy.com/news/2025/may/aicpa-nasba-approve-new-cpa-licensure-path/
Kamara, S. (2026). Verification friction. SSRN. https://doi.org/10.2139/ssrn.6469865
Karpathy, A. (2025, February 2). [Post introducing "vibe coding"]. X. https://x.com/karpathy/status/1886192184808149383
Karpathy, A. (2026, April 30). Sequoia AI Ascent 2026 [talk notes]. https://karpathy.bearblog.dev/sequoia-ascent-2026/
Khadj, O. J. (2026). The delegation frontier. SSRN. https://doi.org/10.2139/ssrn.7348378
Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. Accepted at ICML 2025. arXiv:2506.07962. https://arxiv.org/abs/2506.07962
Kingy AI. (2026, May 4). Token spend is coming for your performance review. https://kingy.ai/news/token-spend-is-coming-for-your-performance-review-and-mine/
Ko, A. J., Abraham, R., Beckwith, L., Blackwell, A., Burnett, M., Erwig, M., Scaffidi, C., Lawrance, J., Lieberman, H., Myers, B., Rosson, M. B., Rothermel, G., Shaw, M., & Wiedenbeck, S. (2011). The state of the art in end-user software engineering. ACM Computing Surveys, 43(3), 21. https://doi.org/10.1145/1922649.1922658
Krebs, A. (2026). [Design slop and Show HN]. https://www.adriankrebs.ch/blog/design-slop/
Kwa, T., et al. (2025). Measuring AI ability to complete long tasks. arXiv:2503.14499. https://arxiv.org/abs/2503.14499
Legal Services Act 2007, c. 29, s. 12 (England and Wales). Meaning of "reserved legal activity" and "legal activity" (accessed 10 October 2026). https://www.legislation.gov.uk/ukpga/2007/29/section/12
Lenny's Newsletter. (2025). [Why LinkedIn is replacing PMs]. https://www.lennysnewsletter.com/p/why-linkedin-is-replacing-pms
Lex Fridman Podcast. (2026, August 26). #501, David Heinemeier Hansson [transcript]. https://lexfridman.com/dhh-2-transcript/
Lightcast. (2026a, August 7). Tracking the agentic AI explosion in jobs. https://lightcast.io/resources/blog/tracking-the-agentic-ai-explosion-in-jobs
Lightcast. (2026b, September 9). [Degree requirements still higher for AI jobs]. https://lightcast.io/resources/blog/degree-requirements-ai-jobs
LinkedIn. (2026a, January). LinkedIn gives professionals the edge with verified skills and tools to navigate the job search. https://news.linkedin.com/2026/Professional_Edge_Skills_Verified
LinkedIn. (2026b, April). Q3 earnings and business highlights. https://news.linkedin.com/2026/Q3-Earnings-Highlights
LinkedIn Economic Graph. (2026). AI labor market update, August 2026. https://delivery-p143253-e1476319.adobeaemcloud.com/adobe/assets/urn:aaid:aem:ef153078-1061-4817-82e7-a1c027d7a7d7/original/as/AI-Labor-Market-Update-August-2026-v2.pdf
Manifold. (2026a). [Will it be common for non-programmers to create small scripts using AI by 2027?] (accessed 9 October 2026). https://manifold.markets/jskf/will-it-be-common-for-nonprogrammer-dfc979ea7fec
Manifold. (2026b). [Will the number of junior developer roles fall by a third by 2030?] (accessed 9 October 2026). https://manifold.markets/OliverKuperman/will-the-number-of-junior-developer
Manifold. (2026c). [Will the number of people employed as software developers in the US fall by more than 15% from 2023 to 2028?] (accessed 9 October 2026). https://manifold.markets/MatthewBarnett/will-the-number-of-people-employed
McAleese, N., Pokorny, R. M., Ceron Uribe, J. F., Nitishinskaya, E., Trebacz, M., & Leike, J. (2024). LLM critics help catch LLM bugs. arXiv:2407.00215. https://arxiv.org/abs/2407.00215
McKinsey & Company. (2025, January). Superagency in the workplace: Empowering people to unlock AI's full potential at work. https://www.mckinsey.com/~/media/mckinsey/business%20functions/quantumblack/our%20insights/superagency%20in%20the%20workplace%20empowering%20people%20to%20unlock%20ais%20full%20potential%20at%20work/superagency-in-the-workplace-empowering-people-to-unlock-ais-full-potential-v4.pdf
MediaNama. (2026, April). [Claude users' accounts suspended after being flagged as minors]. https://www.medianama.com/2026/04/223-claude-users-accounts-suspended-flagged-minors/
Memari, M., & Rudolph, G. (2026). The capability ladder. arXiv:2608.07779. https://arxiv.org/abs/2608.07779
Menlo Ventures. (2025). 2025: The state of generative AI in the enterprise. https://menlovc.com/perspective/2025-the-state-of-generative-ai-in-the-enterprise/
Metal Toad. (2026). 6 levels of AI delegation: A framework for AI management. https://www.metaltoad.com/blog/6-levels-of-ai-delegation-a-framework-for-ai-management
Metaview. (2026). [AI use in hiring interviews]. https://www.metaview.ai/resources/blog/ai-baseline-shopify-memo-hiring-process
METR. (2025, July 10). Measuring the impact of early-2025 AI on experienced open-source developer productivity. https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/
METR. (2026a, February 19). [Five lessons from an AI biology randomised trial]. https://metr.org/blog/2026-02-19-five-lessons-from-ai-biology-rct
METR. (2026b, March 10). Many SWE-bench-passing PRs would not be merged into main. https://metr.org/notes/2026-03-10-many-swe-bench-passing-prs-would-not-be-merged-into-main/
METR. (2026c). Time horizons (dashboard, accessed 9 October 2026). https://metr.org/time-horizons/
METR. (2026d). eval-analysis-public, release time-horizon 1.1, runs.jsonl [Data set]. GitHub. https://github.com/METR/eval-analysis-public (accessed 9 October 2026)
Microsoft. (2025, April 23). 2025: The year the Frontier Firm is born. Work Trend Index. https://www.microsoft.com/en-us/worklab/work-trend-index/2025-the-year-the-frontier-firm-is-born
Microsoft. (2026a, May 5). Agents, human agency and the opportunity for every organization. Work Trend Index 2026. https://www.microsoft.com/en-us/worklab/work-trend-index/agents-human-agency-and-the-opportunity-for-every-organization
Microsoft. (2026b, May 5). How Frontier Firms are rebuilding the operating model for the age of AI. https://blogs.microsoft.com/blog/2026/05/05/how-frontier-firms-are-rebuilding-the-operating-model-for-the-age-of-ai/
MindStudio. (2026, June 11). What is agent literacy? https://www.mindstudio.ai/blog/what-is-agent-literacy-core-skill-ai-builders
n8n. (2026). AI Product Builder [job posting]. https://jobs.ashbyhq.com/n8n/42e72645-d99a-4545-97b7-53ba3a699893
Nature Portfolio. (2026, February 9). [Press release: people using language models for medical scenarios, Nature Medicine]. https://www.natureasia.com/en/info/press-releases/detail/9231
Ng, A. (2026, August 28). The AI engineering skills map in detail: Software engineering fundamentals. The Batch. https://www.deeplearning.ai/the-batch/the-ai-engineering-skills-map-in-detail-software-engineering-fundamentals
OECD. (2026, February). Venture capital investments in artificial intelligence through 2025. https://www.oecd.org/en/publications/venture-capital-investments-in-artificial-intelligence-through-2025_a13752f5-en/full-report.html
OECD & European Commission. (2026, June). [AI literacy framework for primary and secondary education]. https://ailiteracyframework.org/blog/empowering-learners-for-the-age-of-ai-literacy-framework/
O'Neill, N. (2026). [The Product Principal, LinkedIn post]. https://www.linkedin.com/posts/nicholasoneill_the-product-principal-activity-7445921322486009856-hAwj
Ono, A. (2026, June 22). [Defining the roles of humans and AI]. World Economic Forum. https://www.weforum.org/stories/artificial-intelligence/future-of-work-define-roles-humans-ai/
Open Source For You. (2026, February). GitHub weighs pull request kill switch as AI slop floods open source. https://www.opensourceforu.com/2026/02/github-weighs-pull-request-kill-switch-as-ai-slop-floods-open-source/
OpenAI. (2026, June). How agents are transforming work. https://openai.com/index/how-agents-are-transforming-work/
OpenAIRE. (2025, December 9). Zenodo introduces a new way to manage and correct published records. https://www.openaire.eu/zenodo-introduces-a-new-way-to-manage-and-correct-published-records
Oregon State Board of Bar Examiners. (2026, January 26). Supervised Practice Portfolio Examination: First annual report to the Oregon Supreme Court. https://www.osbar.org/_docs/sppe/2025SPPEAnnualReport.pdf
OSF. (2026). Updating registrations; Addressing fear of scooping on OSF preregistrations (help pages, accessed 9 October 2026). https://help.osf.io/hc/en-us/sections/4414482864279-Updating-Registrations ; https://help.osf.io/article/634-addressing-fear-of-scooping-on-osf-preregistrations
Page, M. J., McKenzie, J. E., Bossuyt, P. M., et al. (2021). The PRISMA 2020 statement: An updated guideline for reporting systematic reviews. BMJ, 372, n71. https://doi.org/10.1136/bmj.n71
Park, Y. S., et al. (2026). The work behind delegation: A framework for supervising AI coding agents. arXiv:2609.24234. https://arxiv.org/abs/2609.24234
Paul, R. W. (1947). California gold: The beginning of mining in the Far West. Harvard University Press. https://archive.org/details/in.ernet.dli.2015.177982
Patwardhan, T., et al. (2025). GDPval: Evaluating AI model performance on real-world economically valuable tasks. arXiv:2510.04374. https://arxiv.org/abs/2510.04374
Penrose. (2025). Can LLMs do accounting? [AccountingBench]. https://accounting.penrose.com/ (figures cited as reported by Gigazine, 2025)
Phoenix, J. (2026). [Five levels, gated by verification]. https://understandingdata.com/posts/five-levels-gated-by-verification/
PPC Land. (2026, March 6). The app middle class is dying, and RevenueCat's data shows exactly how fast. https://ppc.land/the-app-middle-class-is-dying-and-revenuecats-data-shows-exactly-how-fast/
Prolific. (2026, July 13). How do I use Prolific's filters? Researcher help centre (accessed 10 October 2026). https://researcher-help.prolific.com/en/articles/445159-how-do-i-use-prolific-s-filters
PwC. (2026). AI Jobs Barometer 2026 (press release). https://www.pwc.com/id/en/media-centre/press-release/2026/english/ai-jobs-barometer-en.html
Reid, B., Wagner, M., d'Amorim, M., & Treude, C. (2022). Software engineering user study recruitment on Prolific: An experience report. RoPES 2022. arXiv:2201.05348. https://arxiv.org/abs/2201.05348
Retool. (2026, February 17). Retool's 2026 Build vs. Buy Report (press release). https://www.businesswire.com/news/home/20260217548274/en/Retools-2026-Build-vs.-Buy-Report-Reveals-35-of-Enterprises-Have-Already-Replaced-SaaS-With-Custom-Software
RevenueCat. (2026). State of subscription apps 2026. https://www.revenuecat.com/state-of-subscription-apps ; https://www.revenuecat.com/sosa-26-insights/
Rogers, E. M. (2003). Diffusion of innovations (5th ed.). Free Press. ISBN 978-0743222099.
Sadki, R. (2026, August 14). [Quotes from the agentic AI summit in Berkeley]. https://redasadki.me/2026/08/14/you-cannot-send-an-ai-agent-to-jail-the-scariest-quotes-from-the-agentic-ai-summit-in-berkeley/
Sarbanes-Oxley Act of 2002, Pub. L. No. 107-204, sections 102 and 104 (15 U.S.C. 7212 and 7214) (United States) (accessed 10 October 2026). https://www.law.cornell.edu/uscode/text/15/7212 ; https://www.law.cornell.edu/uscode/text/15/7214
Savva, N. (2026). Context engineering: A principal-agent theory of AI-augmented knowledge work. SSRN. https://doi.org/10.2139/ssrn.6506600
Search Engine Journal. (2026). Marketers report highest rates of AI brain fry. https://www.searchenginejournal.com/marketers-report-highest-rates-of-ai-brain-fry-report-finds/569110/
SemiAnalysis. (2026, February). Claude Code is the inflection point. https://newsletter.semianalysis.com/p/claude-code-is-the-inflection-point
Serafini, R., Otto, C., Horstmann, S. A., & Naiakshina, A. (2024). ChatGPT-resistant screening instrument for identifying non-programmers. Proceedings of the IEEE/ACM 46th International Conference on Software Engineering (ICSE 2024), 1-13. https://doi.org/10.1145/3597503.3639075
Serafini, R., Weber, N., Yardim, A., Horstmann, S. A., & Naiakshina, A. (2026). Robust methods for developer screening in rapidly evolving AI contexts. Proceedings of the 2026 CHI Conference on Human Factors in Computing Systems (CHI '26), 1-18. https://doi.org/10.1145/3772318.3790302
SF Standard. (2026, March 5). [In AI land, everyone's a builder now]. https://sfstandard.com/2026/03/05/engineer-2025-ai-land-everyone-s-builder-now/
Shao, Y., et al. (2025). Future of work with AI agents: Auditing automation and augmentation potential across the U.S. workforce. arXiv:2506.06576. https://arxiv.org/abs/2506.06576
Shapiro, D. (2026, January). The five levels: From spicy autocomplete to the software factory. https://www.danshapiro.com/blog/2026/01/the-five-levels-from-spicy-autocomplete-to-the-software-factory/
Shopifreaks. (2026a). Meta employees compete on an internal AI token leaderboard called Claudeonomics. https://www.shopifreaks.com/meta-employees-compete-on-an-internal-ai-token-leaderboard-called-claudeonomics-that-tracked-60-trillion-tokens-in-30-days/
Shopifreaks. (2026b). Meta stops grading employees on how much AI they use, dropping token counts and AI Native labels from performance reviews (reporting WIRED, 2 September 2026). https://www.shopifreaks.com/meta-stops-grading-employees-on-how-much-ai-they-use-dropping-token-counts-and-ai-native-labels-from-performance-reviews/
Shopify. (2026). AI usage (candidate guide). https://www.shopify.com/careers/candidate-guide/ai-usage
Simon, H. A. (1971). Designing organizations for an information-rich world. In M. Greenberger (Ed.), Computers, communications, and the public interest (pp. 37-72). Johns Hopkins Press.
Srinivasan, S., & Wei, V. (2026, February 12). To thrive in the AI era, companies need agent managers. Harvard Business Review. https://hbr.org/2026/02/to-thrive-in-the-ai-era-companies-need-agent-managers
Stanford Digital Economy Lab. (2026a, August 12). [Canaries in the coal mine: August 2026 update]. https://digitaleconomy.stanford.edu/news/canariesaug26/
Stanford Digital Economy Lab. (2026b, October 7). Task expansion with generative AI: Experimental evidence on middle-skilled early-career workers. https://digitaleconomy.stanford.edu/publication/task-expansion-with-generative-aiexperimental-evidence-on-middle-skilled-early-career-workers/
Stanford HAI. (2026). AI Index Report 2026, chapter 4: Economy. https://hai.stanford.edu/assets/files/ai_index_report_2026_chapter_4_economy.pdf
Startup Fortune. (2026). Guillermo Rauch says AI agents now trigger more than half of all Vercel deployments. https://startupfortune.com/guillermo-rauch-says-ai-agents-now-trigger-more-than-half-of-all-vercel-deployments/
State Street. (2026). Agentic Product Builder, Senior Associate [job posting]. https://statestreet.wd1.myworkdayjobs.com/en-US/Global/job/Agentic-Product-Builder--Sr-Associate---State-Street-Investment-Managment_R-796094
Stenberg, D. (2026, January 26). The end of the curl bug bounty. https://daniel.haxx.se/blog/2026/01/26/the-end-of-the-curl-bug-bounty/
Stripe. (2026, May 28). Solo founding is at an all-time high: Top performers have these traits in common. https://stripe.com/blog/top-solo-founder-traits
TechCrunch. (2026a, September 24). Lovable's annualized revenue crosses $600M as vibe coding takes off. https://techcrunch.com/2026/09/24/lovables-annualized-revenue-crosses-600m-as-vibe-coding-takes-off/
TechCrunch. (2026b, April 18). The App Store is booming again, and AI may be why. https://techcrunch.com/2026/04/18/the-app-store-is-booming-again-and-ai-may-be-why/
TechCrunch. (2026c, July 30). LinkedIn adds a button to report AI-generated "slop". https://techcrunch.com/2026/07/30/linkedin-adds-a-button-to-report-ai-generated-slop/
TechRepublic. (2025). [Prompt engineering jobs called obsolete]. https://www.techrepublic.com/article/news-prompt-engineering-ai-jobs-obsolete/
The Decoder. (2025, September). AI-generated workslop is costing companies millions and hurting team morale, study finds. https://the-decoder.com/ai-generated-workslop-is-costing-companies-millions-and-hurting-team-morale-study-finds/
The Decoder. (2026, July 12). LinkedIn is the undisputed king of long-form AI slop, according to a study spanning five platforms. https://the-decoder.com/linkedin-is-the-undisputed-king-of-long-form-ai-slop-according-to-a-study-spanning-five-platforms/
The geometry of learning under AI delegation. (2026). [Review of the paper]. https://www.themoonlight.io/fr/review/the-geometry-of-learning-under-ai-delegation
Tikhomirov, S. (2026, September). [The AIDEs framework: levels of delegation in software development]. JetBrains Research. https://blog.jetbrains.com/research/2026/09/aides-framework/
Tomašev, N., Franklin, M., & Osindero, S. (2026). Intelligent AI delegation. arXiv:2602.11865. https://arxiv.org/abs/2602.11865
Tray.ai. (2026). Gartner: Govern vibe coding for citizen developers with self-service platforms [Guide summarising Tyagi, 2026]. https://tray.ai/guides/gartner-govern-vibe-coding/
Turkovic, I. (2026, April 24). [AI job titles in 2026: naming chaos]. https://www.ivanturkovic.com/2026/04/24/ai-job-titles-2026-naming-chaos/
Turner, S. (2026). [An AI biosecurity uplift randomised trial by Scale AI and SecureBio]. https://blog.stephenturner.us/p/ai-biosecurity-uplift-rct
University of Lübeck, Institute for Multimedia and Interactive Systems. (2026). [The cost of convenience: decision horizons, CHI 2026]. https://www.imis.uni-luebeck.de/en/node/11007
Veracode. (2026, July 28). LLMs are getting smarter but not safer: Veracode 2026 GenAI code security report. https://www.veracode.com/news/llms-are-getting-smarter-but-not-safer-veracode-2026-genai-code-security-report-finds-ai-generated-code-security-has-stalled-at-56%25-pass-rate/
Verheul, J. (2026). The principal firm: Organisational form when the agency function is performed by machines. SSRN. https://doi.org/10.2139/ssrn.7235518
Veri', D. (2026). Beyond AI literacy: A structured review and exploratory meta-analysis of measures for competent generative-AI use. arXiv:2609.15624. https://arxiv.org/abs/2609.15624
Virk, Y., & Liu, D. (2025). Non-programmers assessing AI-generated code: A case study of business users analyzing data. VL/HCC 2025. arXiv:2508.06484. https://arxiv.org/abs/2508.06484
Wang, S. (2026). The delegation efficient frontier. SSRN. https://doi.org/10.2139/ssrn.7275801
Washington Monthly. (2026, May 29). [AI and entry-level jobs for college graduates]. https://washingtonmonthly.com/2026/05/29/ai-entry-level-jobs-college-graduates/
White House. (2025, April 23). Advancing artificial intelligence education for American youth. https://www.whitehouse.gov/presidential-actions/2025/04/advancing-artificial-intelligence-education-for-american-youth/
Willison, S. (2025a, February 3). A computer can never be held accountable. https://simonwillison.net/2025/Feb/3/a-computer-can-never-be-held-accountable/
Willison, S. (2025b, June 22). [Kent Beck on skills going to zero and up 1000x]. https://simonwillison.net/2025/Jun/22/kent-beck
Willison, S. (2026a). What is agentic engineering? https://simonwillison.net/guides/agentic-engineering-patterns/what-is-agentic-engineering/
Willison, S. (2026b, February 7). [Vouch]. https://simonwillison.net/2026/Feb/7/vouch/
Writer. (2026). [The AI agent owner]. https://writer.com/blog/ai-agent-owner/
Xinhua. (2025, September 19). [Beijing pupils build AI agents in class]. https://english.news.cn/20250919/740f7bd40ec84b69b9d983e1068a94ac/c.html
Yale Budget Lab. (2026, May 7). AI is probably not (yet) the reason for labor market weakening. https://budgetlab.yale.edu/research/ai-probably-not-yet-reason-labor-market-weakening
Yang, et al. (2026). [How people work with an autonomous search agent]. arXiv:2606.07489. https://arxiv.org/abs/2606.07489
Yegge, S. (2026). Welcome to Gas Town. https://steve-yegge.medium.com/welcome-to-gas-town-4f25ee16dd04
Apéndice A. Glosario
Hora de referencia. El tiempo que un especialista cualificado necesitaría para hacer un trabajo manualmente, tomado de un banco de tareas congelado o de dos calificadores independientes que no saben quién hizo el trabajo.
Horizonte de delegación verificado. El tamaño más grande de trabajo, en horas de referencia, en el que una persona regularmente encomienda trabajo a agentes, lo acepta, y lo confirma mediante una verificación independiente que los agentes no vieron. Puntuado por dominio según la regla de la Sección 5.2.
Verificación independiente. Pruebas de aceptación ocultas, un revisor humano cualificado, uso real por parte de los usuarios previstos, o un modelo de otra familia verificando contra fuentes, diferente de los agentes en datos, acceso e incentivos. La autorrevisión y el acuerdo entre modelos de una misma familia no son verificaciones independientes.
Error plantado. Un error colocado en una tarea antes de la entrega, que la persona debe detectar, ya sea una entrada incorrecta o una omisión de algo que el trabajo debe contener. Un trabajo con un error plantado no detectado no cuenta como verificado, y cualquier fallo en la ventana de un peldaño bloquea los peldaños desde Semana en adelante.
Ganancia de amplificación. Horas de referencia de trabajo aceptado y verificado divididas por horas de atención de la persona durante los últimos 91 días en el dominio, trabajo fallido incluido en el denominador y trabajo realizado con ayuda externa excluido del numerador.
Techo de ganancia. En un modelo simplificado, la ganancia de amplificación G para un trabajo de H horas de referencia cuya verificación toma V horas de atención satisface G ≤ H / V, es decir, uno sobre la proporción de tiempo manual que la verificación toma.
Peldaños. Hora (aproximadamente 1 hora de referencia), Día (aproximadamente 8), Semana (aproximadamente 40), Mes (aproximadamente 160), Trimestre (aproximadamente 500). Recuentos y ventanas de reglas v1.1: diez trabajos en 91 días para Hora y Día, seis en 182 días para Semana, seis en 365 días para Mes (cinco de ellos verificados), tres en 365 días para Trimestre. Para Semana y superior, al menos un trabajo verificado del tamaño del peldaño dentro de los últimos 91 días.
Registro. Dominio · horizonte · amplificación · fecha, por ejemplo "contabilidad de pequeñas empresas · Día · ×2 · 2026-Q4".
Alfabetización de aceptación. La habilidad de establecer por adelantado qué contará como hecho y luego demostrarlo con evidencia que un agente no puede fabricar.
Neutralidad de formación. La hipótesis de que, a un horizonte verificado igual en un dominio, una educación en programación no predice la calidad del trabajo verificado independientemente una vez que se consideran el dominio de la materia y la alfabetización de aceptación.
Punto de cruce de credenciales. El momento, en un dominio, cuando productos de personas sin educación en TI, aceptados bajo las mismas verificaciones, comienzan a superar los de programadores que utilizan los mismos agentes, después del cual los requisitos de grado y las etiquetas junior y senior pierden peso predictivo en la contratación. Sus componentes son paridad de calidad (el paso anterior), superación (el momento), el cruce en publicaciones (la señal) y neutralidad de formación (el mecanismo).
Garante. Una persona que se responsabiliza de un producto hecho por otros y responde por él ante su círculo, medida por cuántos productos avaló y cuántos se mantuvieron.
Finalizador. Una persona que lleva un producto a sus usuarios.
Dos mercados. Hacer para uno mismo (alfabetización) y trabajar para otros con consecuencias (profesión).
Apéndice B. Registro de búsqueda, 8 y 9 de octubre de 2026
Se realizaron búsquedas en la web de nombres y términos el 8 de octubre de 2026 con varios asistentes de IA buscando de forma independiente y en paralelo, y el 9 de octubre de 2026 por un asistente con búsqueda web extendida. Cada respuesta se mantuvo en su totalidad, con sus fuentes. Las verificaciones académicas se realizaron el 9 de octubre de 2026, como sigue.
| Base | Qué busca | Resultado para los términos de este artículo |
|---|---|---|
| arXiv (API) | Frase exacta, todos los campos | «delegation horizon»: 0; «delegation ladder» o «ladder of delegation»: 0; «time span of discretion»: 0 |
| Semantic Scholar | Título y resumen | Una búsqueda devolvió 0 y otra fue limitada por velocidad (HTTP 429); se debe repetir antes de la presentación |
| OpenAlex | Título, resumen, algo de texto completo | «credential crossover»: 0; «agentwright»: solo coincidencias no relacionadas; «background neutrality»: no relacionada; «acceptance literacy»: trabajos solo en aceptación de tecnología |
| Crossref | Metadatos incluyendo resúmenes de SSRN | «principal» como profesión: solo teoría de agencia |
| Europe PMC | Textos completos abiertos | Sin coincidencias exactas |
| Zenodo | Registros y descripciones | Sin coincidencias para ningún término |
| DOAJ | Revistas de acceso abierto | «delegation horizon»: cuatro coincidencias no relacionadas |
| Google Scholar | Textos completos, SSRN | «delegation horizon»: 6, utilizado en artículos de 2026 para máquinas o empresas (Khadj, 2026; Alonso, 2026); «verified delegation horizon», «credential crossover», «credential crossover point» y «agentwright»: 0 (repetida el 9 de octubre de 2026 sin errores); «acceptance literacy», «background neutrality» y «amplification gain»: coincidencias solo en otros sentidos |
| DBLP; SSRN pages | Bloqueado por protección de bot (DBLP) o devolvió 403 (SSRN); cubierto a través de Crossref y Scholar |
Se buscaron pronósticos anteriores en Metaculus, Manifold, Good Judgment Open, Kalshi, Polymarket y Long Bets, y en la web abierta; Metaculus y algunas páginas de Gartner devolvieron HTTP 403 y se leyeron a través de copias archivadas o reimpresas donde estaban disponibles. Los resultados se resumen en la Sección 11.3. El informe sigue el elemento 6 de PRISMA 2020 (Page et al., 2021): se enumeran todas las bases y la fecha del último acceso. Una coincidencia que no se encuentra se informa como no encontrada en esa fecha, y no se hace ninguna afirmación sobre bases que no fueron buscadas.
Apéndice C. El instrumento de medición
Este apéndice proporciona un instrumento de investigación, un formato de registro y un evaluador, en la biblioteca estándar de Python, bajo la licencia MIT. Enseña cómo las reglas de la Sección 5.2 se convierten en código. No es una aplicación y no toma ninguna decisión sobre ninguna persona más allá de calcular los dos números a partir de registros que la persona o un investigador proporcionan. No juzga si una verificación fue bien elegida; confía en los campos que le son proporcionados. En particular, no prueba la independencia. De las tres condiciones de la Sección 5.2 (datos, acceso e incentivos) solo lee el tipo de verificación y si los agentes la vieron, y la independencia misma se confirma por la auditoría aleatoria de la Tabla 3.
C1. El registro
Una línea de un archivo JSON Lines por cada pieza de trabajo entregada a los agentes, escrita cuando la pieza es aceptada, rechazada o abandonada. La fecha en la que comenzó la entrega va en el campo started, esperada de las reglas v1.1; el evaluador aún lee líneas sin ella y advierte. Las piezas que fallaron en la verificación o fueron abandonadas permanecen en el registro.
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-10", "date": "2026-09-14",
 "reference_hours": 8, "reference_basis": "two raters",
 "attention_minutes": 95, "mode": "stages",
 "check": "expert", "agent_saw_check": false, "passed": true,
"irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}| Campo | Significado |
|---|---|
| person | Una etiqueta seudónima, nunca un nombre real |
| domain | El dominio en el que fue aceptado el trabajo |
| date | Fecha de aceptación, rechazo o abandono, cuando se escribe la línea (formato ISO) |
| started | Fecha en que comenzó la entrega (formato ISO); esperada de acuerdo con las reglas v1.1, no posterior a date |
| reference_hours | Horas manuales de un especialista calificado para el entregable completo |
| reference_basis | De dónde procedió la referencia: un banco de tareas denominado o dos evaluadores |
| attention_minutes | Los minutos de la persona dedicados a planificación, instrucción, lectura, verificación y corrección |
| mode | one_piece, stages o together (one_piece cuenta hacia la participación directiva de la Sección 5.7) |
| check | hidden_tests, expert, real_use, other_family_with_sources, same_family, self_review o none |
| agent_saw_check | Si los agentes podían ver la verificación (debe ser false para contar) |
| passed | Si la verificación pasó (false para piezas fallidas o abandonadas) |
| irreversible | Si un error en este tipo de trabajo no puede deshacerse (esta pieza debe entonces pasar) |
| planted_errors | Cuántos errores fueron plantados en la tarea antes de la entrega |
| planted_missed | Cuántos de ellos la persona no logró detectar (cualquier error hace que la pieza sea no verificada y bloquea Week y superiores en la ventana) |
| outside_help | Si un colega o contratista ayudó fuera del registro (tal pieza no suma nada al numerador de ganancia) |
| task_id, model, tools | Opcional: identificador del banco de tareas, los agentes y modelos utilizados, y sus herramientas (Sección 5.4) |
| checker | Opcional: quién o qué ejecutó la verificación, como un rol, nunca un nombre real |
| rater_hours | Opcional: las estimaciones de los evaluadores detrás de reference_hours; si hay dos y la mayor es más de 1.5 veces la menor, el puntuador imprime "needs third rater" (Tabla 3); con una tercera estimación la mediana decide y la bandera no se imprime |
| audit | Opcional: none, passed o failed, el resultado de una segunda verificación independiente; una auditoría fallida hace que la pieza sea no verificada |
| revoked | Opcional: true si un resultado retrasado revocó la pieza (Tabla A4); una pieza revocada es no verificada |
C2. horizon.py
El código a continuación implementa las reglas v1.1 y es idéntico, byte por byte, a horizon.py en el repositorio acompañante.
#!/usr/bin/env python3
"""horizon.py: score the verified delegation horizon and the amplification gain.

Teaches: how the rules of Section 5.2 turn a log of work handed to agents into a dated record
"domain . horizon . gain . quarter". Limits: it trusts the fields it is given; it does not
judge whether a check was well chosen or whether the reference hours are fair.
Usage: python3 horizon.py work-log.jsonl --as-of 2026-10-09 [--stable]   Rules v1.1   Licence: MIT
"""
import argparse
import datetime as dt
import json
import math
import sys
import statistics
from collections import Counter, defaultdict

# rung, reference hours, minimum pieces, window in days (provisional; Section 5.8)
RUNGS = [("Quarter", 500.0, 3, 365), ("Month", 160.0, 6, 365), ("Week", 40.0, 6, 182),
         ("Day", 8.0, 10, 91), ("Hour", 1.0, 10, 91)]
PLANTED_FROM = 40.0         # from Week upward a planted error must be in the window
GAIN_STEPS = [60, 20, 5, 2, 1]
GAIN_WINDOW = 91            # gain, directive share and the recent piece of upper rungs (91 days)
PASS_SHARE = 0.8            # 8 of 10; every irreversible piece must pass
INDEPENDENT = {"hidden_tests", "expert", "real_use", "other_family_with_sources"}
RATER_SPREAD = 1.5          # raters further apart than this need a third rater
CHECKS = INDEPENDENT | {"same_family", "self_review", "none"}
MODES = {"one_piece", "stages", "together"}
KEYS = {"person", "domain", "date", "reference_hours", "reference_basis",
        "attention_minutes", "mode", "check", "agent_saw_check", "passed", "irreversible",
        "planted_errors", "planted_missed", "outside_help"}
OPTIONAL = {"started",      # date the hand-over started (expected from v1.1; the line is written at close)
            "task_id", "model", "tools", "checker", "rater_hours", "audit", "revoked"}


def load(path):
    """Every piece handed to agents is a line, including failed and abandoned ones."""
    records, undated = [], 0
    with open(path, encoding="utf-8") as fh:
        for n, line in enumerate(fh, 1):
            if not line.strip():
                continue
            r = json.loads(line)
            if set(r) - OPTIONAL != KEYS:
                sys.exit(f"line {n}: unknown {sorted(set(r) - KEYS - OPTIONAL)}, missing {sorted(KEYS - set(r))}")
            if r["check"] not in CHECKS or r["mode"] not in MODES:
                sys.exit(f"line {n}: check or mode is not one of the allowed values")
            if float(r["reference_hours"]) <= 0 or float(r["attention_minutes"]) < 0:
                sys.exit(f"line {n}: reference hours must be positive, minutes not negative")
            if not 0 <= int(r["planted_missed"]) <= int(r["planted_errors"]):
                sys.exit(f"line {n}: planted_missed must lie between 0 and planted_errors")
            if not isinstance(r["outside_help"], bool) or not isinstance(r.get("revoked", False), bool):
                sys.exit(f"line {n}: outside_help and revoked must be true or false")
            if r.get("audit", "none") not in {"none", "passed", "failed"}:
                sys.exit(f"line {n}: audit must be none, passed or failed")
            if "rater_hours" in r and (len(r["rater_hours"]) < 2 or min(map(float, r["rater_hours"])) <= 0):
                sys.exit(f"line {n}: rater_hours needs two or more positive estimates")
            undated += "started" not in r
            r["date"] = dt.date.fromisoformat(r["date"])
            if "started" in r and dt.date.fromisoformat(r["started"]) > r["date"]:
                sys.exit(f"line {n}: started must not be later than date")
            records.append(r)
    if undated:
        print(f"warning: {undated} lines without started (expected from rules v1.1)", file=sys.stderr)
    return records


def verified(r):
    """A pass counts only if the check was independent, the agents never saw it, no planted error
    was missed, nobody helped off the log, no audit failed and no delayed outcome revoked it.
    Another model family alone never verifies irreversible work."""
    return (r["passed"] is True and r["check"] in INDEPENDENT and r["agent_saw_check"] is False
            and int(r["planted_missed"]) == 0 and not r["outside_help"]
            and not (r["irreversible"] and r["check"] == "other_family_with_sources")
            and r.get("audit") != "failed" and not r.get("revoked", False))


def rung_holds(pieces, hours, minimum, as_of, days):
    start = as_of - dt.timedelta(days=days)
    window = [r for r in pieces if start < r["date"] <= as_of]
    big = [r for r in window if float(r["reference_hours"]) >= hours]
    if len(big) < minimum:
        return False
    if sum(map(verified, big)) / len(big) < PASS_SHARE:
        return False
    if any(r["irreversible"] and not verified(r) for r in big):   # strict rule, these pieces only
        return False
    if hours >= PLANTED_FROM:
        if not any(int(r["planted_errors"]) > 0 for r in big):
            return False
        if any(int(r["planted_missed"]) > 0 for r in window):   # any missed planted error blocks
            return False
    if days > GAIN_WINDOW:                                       # quarterly re-verification
        recent = as_of - dt.timedelta(days=GAIN_WINDOW)
        if not any(verified(r) and r["date"] > recent for r in big):
            return False
    return True


def horizon(pieces, as_of):
    for name, hours, minimum, days in RUNGS:        # from the top rung down
        if rung_holds(pieces, hours, minimum, as_of, days):
            return name
    return "below Hour"


def rung_pieces(pieces, name, as_of):
    """Pieces of the rung's size in its window (Hour's for 'below Hour'): what the count is out of."""
    _, hours, _, days = next(r for r in RUNGS if r[0] == name or (name == "below Hour" and r[0] == "Hour"))
    return [r for r in pieces if as_of - dt.timedelta(days=days) < r["date"] <= as_of
            and float(r["reference_hours"]) >= hours]


def gain(pieces):
    done = math.fsum(float(r["reference_hours"]) for r in pieces
                     if verified(r) and not r["outside_help"])            # outside help excluded
    spent = math.fsum(float(r["attention_minutes"]) for r in pieces) / 60.0   # failures included
    return None if spent == 0 else done / spent


def step(g):
    if g is None:
        return "n/a"
    for s in GAIN_STEPS:
        if g >= s:
            return f"x{s}"
    return "below x1"


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("log")
    ap.add_argument("--as-of", default=dt.date.today().isoformat())
    ap.add_argument("--stable", action="store_true", help="also score 91 days earlier and label the rung")
    args = ap.parse_args()
    as_of = dt.date.fromisoformat(args.as_of)
    longest = max(days for *_, days in RUNGS) + (GAIN_WINDOW if args.stable else 0)
    groups = defaultdict(list)
    for r in load(args.log):
        if as_of - dt.timedelta(days=longest) < r["date"] <= as_of:
            groups[(r["person"], r["domain"])].append(r)
    quarter = f"{as_of.year}-Q{(as_of.month - 1) // 3 + 1}"
    recent_start = as_of - dt.timedelta(days=GAIN_WINDOW)
    for (person, domain), pieces in sorted(groups.items()):
        recent = [r for r in pieces if r["date"] > recent_start]
        g = gain(recent)
        shown = "n/a" if g is None else f"{g:.2f}"
        failed = sum(1 for r in recent if not verified(r))
        directive = (sum(r["mode"] == "one_piece" for r in recent) / len(recent)) if recent else 0.0
        rung = horizon(pieces, as_of)
        counted = rung_pieces(pieces, rung, as_of)
        label = ""
        if args.stable:
            before = horizon(pieces, as_of - dt.timedelta(days=GAIN_WINDOW))
            label = " stable" if before == rung else f" provisional (was {before})"
        print(f"{person}: {domain} . {rung} ({sum(map(verified, counted))}/{len(counted)}){label}"
              f" . {step(g)} . {quarter}  (pieces in last 91 days: {len(recent)}, not verified: {failed};"
              f" gain {shown}; directive share {directive:.0%})")
        kinds = Counter(r["check"] for r in counted).most_common()
        sizes = [float(r["reference_hours"]) for r in recent if r["passed"]]
        median = f"{statistics.median(sizes):.1f} h" if sizes else "n/a"
        spread = any(max(map(float, r["rater_hours"])) / min(map(float, r["rater_hours"])) > RATER_SPREAD
                     for r in pieces if len(r.get("rater_hours", [])) == 2)   # with three, the median decided
        print(f"  checks: {', '.join(f'{k} {v}' for k, v in kinds) or 'none'};"
              f" median accepted size {median}{'; needs third rater' if spread else ''}")


if __name__ == "__main__":
    main()
C3. brier.py
#!/usr/bin/env python3
"""brier.py: score dated predictions by the Brier rule.

Teaches: why one missed prediction made at 35% says little on its own, and why 'unresolved' is
never a success. Input CSV columns: id,probability,outcome (outcome: 1, 0 or unresolved).
Usage: python3 brier.py predictions.csv                                  Licence: MIT
"""
import csv
import sys


def main(path):
    resolved, pending = [], []
    with open(path, newline="", encoding="utf-8") as fh:
        for row in csv.DictReader(fh):
            p = float(row["probability"])
            if not 0.0 <= p <= 1.0:
                sys.exit(f"{row['id']}: probability must lie between 0 and 1")
            outcome = row["outcome"].strip().lower()
            if outcome in ("0", "1"):
                resolved.append((row["id"], p, int(outcome)))
            else:
                pending.append(row["id"])
    for pid, p, o in resolved:
        print(f"{pid}: p={p:.2f} outcome={o} score={(p - o) ** 2:.3f}")
    if resolved:
        mean = sum((p - o) ** 2 for _, p, o in resolved) / len(resolved)
        print(f"Brier score over {len(resolved)} resolved: {mean:.3f} (always saying 0.5 gives 0.250)")
    print("unresolved or not yet due: " + (", ".join(pending) or "none"))


if __name__ == "__main__":
    main(sys.argv[1])
C4. Un ejemplo práctico
El registro a continuación contiene diez trabajos de contabilidad entregados a agentes por una persona entre julio y septiembre de 2026.
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-07-17", "date": "2026-07-20", "reference_hours": 9, "reference_basis": "two raters", "attention_minutes": 95, "mode": "stages", "check": "expert", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-07-24", "date": "2026-07-28", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 80, "mode": "stages", "check": "hidden_tests", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-07-29", "date": "2026-08-04", "reference_hours": 12, "reference_basis": "two raters", "attention_minutes": 150, "mode": "one_piece", "check": "expert", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-09", "date": "2026-08-11", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 70, "mode": "stages", "check": "self_review", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-13", "date": "2026-08-18", "reference_hours": 10, "reference_basis": "two raters", "attention_minutes": 110, "mode": "together", "check": "real_use", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-21", "date": "2026-08-25", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 120, "mode": "stages", "check": "expert", "agent_saw_check": false, "passed": false, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-24", "date": "2026-09-01", "reference_hours": 16, "reference_basis": "two raters", "attention_minutes": 180, "mode": "one_piece", "check": "hidden_tests", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-05", "date": "2026-09-08", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 60, "mode": "stages", "check": "expert", "agent_saw_check": false, "passed": true, "irreversible": true, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-11", "date": "2026-09-15", "reference_hours": 9, "reference_basis": "two raters", "attention_minutes": 90, "mode": "together", "check": "other_family_with_sources", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-27", "date": "2026-09-29", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 75, "mode": "stages", "check": "hidden_tests", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
Ejecutar python3 horizon.py work-log.jsonl --as-of 2026-10-09 imprime el registro y una línea sobre las comprobaciones detrás de él:
P07: small-business bookkeeping . Day (8/10) . x2 . 2026-Q4  (pieces in last 91 days: 10, not verified: 2; gain 4.66; directive share 20%)
  checks: expert 4, hidden_tests 3, self_review 1, real_use 1, other_family_with_sources 1; median accepted size 9.0 h
Los diez artículos tienen al menos 8 horas de referencia. Dos no cuentan como verificados: uno fue revisado solo por autorrevisión, y uno falló la verificación de un experto. Ocho de diez es exactamente la proporción que Day requiere, y la pieza irreversible pasó, por lo que el escalón es Day. Week está fuera del alcance, ya que ninguna pieza alcanza 40 horas. Las piezas verificadas suman 80 horas de referencia, contra 1.030 minutos (aproximadamente 17,2 horas) de atención dedicados a los diez, incluidos los fallos, lo que da una ganancia de 4,66 y el paso ×2. Ninguna pieza contenía errores plantados ni ayuda externa, por lo que ninguna de esas reglas cambia el resultado. Si la pieza fallida se hubiera omitido del registro, el escalón habría descansado en nueve piezas y habría fallado el recuento de diez, por lo que los fallos pertenecen al registro. El recuento junto al escalón, 8/10, muestra cuán cerca estuvo el veredicto (Apéndice E), y la segunda línea da los tipos de verificación detrás de las piezas contadas y el tamaño mediano aceptado, 9,0 horas, para que un lector pueda ver si el horizonte descansa en piezas justo por encima de un umbral (Tabla 3). La atención de la persona, 1.030 minutos, es aproximadamente el 18% de las 96 horas de referencia entregadas y aproximadamente el 21% de las 80 que fueron verificadas. El registro de un currículum dice «contabilidad de pequeñas empresas · Day · ×2 · 2026-Q4».
La herramienta complementaria tools/explain.py imprime las razones detrás del mismo veredicto, a partir de las mismas reglas. Ocho de diez piezas de tamaño Day se verifican y se necesitan ocho, un recuento consistente con una tasa de aprobación verdadera entre 44% y 97% (Sección 5.8), por lo que ninguna pieza fallida adicional de ese tamaño puede ser absorbida. Si nada nuevo se registra, Day se mantiene hasta el 18 de octubre de 2026; el 19 de octubre, la pieza cerrada el 20 de julio sale de la ventana de 91 días, y quedan nueve piezas de tamaño Day, una corta del diez que Day necesita. Para Week enumera todas las condiciones aún faltantes: seis piezas de al menos 40 horas en 182 días, una de ellas con errores plantados y una verificada en los últimos 91 días.
El registro construido también lleva un rastro que Table 3 nombra: cinco de sus diez piezas fueron calificadas en exactamente 8 horas, el piso de Day, y tools/too_clean.py lo marca como «auditoría primero», con el rastro «5 de 10 piezas se sientan justo por encima del umbral de un escalón». Una bandera envía un registro a una auditoría y no decide nada sobre él; la mediana de 9,0 horas junto al escalón muestra lo mismo a un lector.
C5. El repositorio complementario
El repositorio complementario (https://github.com/vadimchernets/delegation-horizon) contiene el instrumento y los materiales que permiten a los lectores utilizar cada parte del artículo. Los archivos principales, por sección:
| Sección | Archivos | Qué hacen |
|---|---|---|
| 5.2, C1 to C4 | horizon.py, log.schema.json, examples/ |
Puntuador, esquema de una línea de registro, el ejemplo resuelto y las líneas que debe imprimir |
| 5.2, 5.3 | tools/log_piece.py, record_card.py, checker.html |
Escribir el registro respondiendo preguntas, una tarjeta de registro con el recuento detrás del escalón, y la misma puntuación en una página del navegador sin conexión; ambos leen una hoja de cálculo guardada con comas o con puntos y comas |
| 5.2, 5.8, C4 | tools/explain.py |
Por qué un registro gana su escalón: cada condición que se cumple o falla, el margen, el día en que el escalón caduca si nada nuevo se registra, y lo que el siguiente escalón necesita |
| 5.1 | tools/reference_hours.py, kits/reference-hours-raters.md |
Horas de referencia de las estimaciones de los evaluadores, y cómo elegir, admitir e instruir a los evaluadores |
| 5.8, Table 3 | audit_sample.py, tools/too_clean.py, tools/planted.py, kits/ |
Muestra de auditoría reproducible, banderas para registros que se ven demasiado limpios, errores plantados sellados antes de la entrega y puntuados por tipo (entrada incorrecta u omisión), guías de auditoría y errores plantados |
| 6.2, 10.3 | tools/verify_record.py |
El lado receptor de un registro portátil: si el registro enviado con él es el archivo que fue puntuado, si el puntuador es el mismo, y si la repuntuación da el mismo registro, campo por campo |
| 6.2 | kits/trade-screen.md, tools/gate_leak.py |
Admitir personas por una pregunta del oficio en lugar de una etiqueta, y cuánto filtra una etiqueta, con un intervalo exacto (11 de 60 en el Apéndice G2: 9,5% a 30,4%) |
| 6.5, 10.5 | kits/checking-process.md, kits/process-vs-experience-study.md, tools/process_study.py |
Los cuatro pasos de la Sección 6.5 y lo que cada uno gana según la regla (Figura A4), y la comparación de la Sección 10.5 como protocolo de registro, con su análisis, entradas incorrectas y omisiones aparte |
| 5.8, Appendix E | pilot/ |
Prueba de escritorio de los umbrales, un banco de 30 tareas, el protocolo de calibración con su texto de registro y formulario de consentimiento |
| Appendix G2 | pilot/ |
El análisis registrado human_raters.py presentado en OSF, la conversión de las exportaciones de Prolific, el script que imprime Table G2 con las funciones registradas, la comparación de la selección, y una exportación sintética para ejecutarlas en |
| 7.2 | templates/, tools/guarantor_record.py |
Tarjeta de tarea para un banco de tareas, el libro mayor de un garante, y el registro del garante calculado a partir de él: productos avalados, cuántos vivieron 6 y 12 meses, fallos por severidad |
| 11, Tables 4 and A6, C3 | predictions/, brier.py, tools/power.py |
Las 41 predicciones registradas, con el manifiesto de sus hashes archivados en OSF, las reglas de resolución y archivos, las herramientas de puntuación, que registran una predicción del Conjunto B no realizada y reportan la puntuación de Brier tanto sin ella como con ella puntuada como incorrecta (Sección 11.2), y los tamaños de muestra de la Sección 11.2 |
| 11, Set B | predictions/set_b.py |
Las reglas congeladas que se cumplieron y que no se cumplieron de las nueve predicciones del Conjunto B escritas en un intervalo, aplicadas a las estimaciones de un estudio |
| 11.4, F27 | kits/f27-sample.md, tools/freeze_sample.py, tools/liveness.py |
El protocolo y el sorteo de la muestra F27 (el grupo cerrado registrado primero, la clave tomada después de un faro de aleatoriedad pública), congelada en Zenodo y su hash registrado en OSF antes del 31 de diciembre de 2026, y su disponibilidad en cada fecha de puntuación según las palabras de F27 |
| C2 to C4, Tables 4 and A6 | tools/paper_sync.py |
Comprueba este texto contra el repositorio: los listados byte a byte, el ejemplo resuelto y su resultado, las tablas de predicciones, los recuentos de los conjuntos, todos los archivos nombrados y todas las figuras incrustadas |
| Apéndice D, Apéndice F | figures/ |
Los scripts que dibujan la Figura A1 a partir de la tabla de predicciones y la Figura A4 a partir de las reglas del evaluador |
Los mismos archivos por lector:
| Lector | Empiece con | Lo que proporciona |
|---|---|---|
| Una persona que entrega trabajo a agentes | templates/work-log.csv, record_card.py o checker.html, tools/explain.py |
Un registro mantenido en una hoja de cálculo, el registro y su tarjeta, y lo que necesita el siguiente peldaño |
| Un empleador o un equipo de recursos humanos | kits/hiring-test/, kits/trade-screen.md, kits/scope-statement.md, tools/explain.py |
Una prueba de trabajo remunerada de un día con un evaluador ciego, una pregunta del oficio en lugar de una etiqueta, lo que un peldaño dice y no dice, y cuán cerca estuvo el veredicto del candidato |
| Un novato en un oficio | kits/checking-process.md, kits/acceptance-card.md, kits/planted-errors-guide.md |
Los pasos de la Sección 6.5 y lo que cada uno obtiene, "hecho" establecido antes de la entrega, y práctica en omisiones plantadas |
| Un auditor o un garante | audit_sample.py, tools/too_clean.py, tools/planted.py, kits/audit-checklist.md |
Una muestra para comprobar de nuevo, los rastros de un registro que se ve demasiado limpio, errores plantados cuyo sello muestra si la lista fue modificada |
| Un investigador | pilot/, kits/matched-task-study.md, kits/process-vs-experience-study.md, tools/power.py, predictions/ |
La prueba de escritorio, el estudio de evaluadores y sus scripts, protocolos para las comparaciones, tamaños de muestra, y las predicciones registradas con sus herramientas de tarjeta de puntuación |
Apéndice D. Texto de registro para las predicciones (OSF)
Título. Predicciones datadas sobre trabajo a través de agentes de IA, 2026 a 2031: pronósticos congelados y puntuación anual.
Tipo. Registro abierto, público inmediatamente, sin embargo.
Resumen. Este registro congela las predicciones datadas enunciadas en "After the Programmer Divide: One Measure for People Who Build Through AI Agents" (SSRN 7589918; Zenodo DOI 10.5281/zenodo.23267266). La tabla adjunta proporciona, para cada predicción: su redacción; su medida; una fuente pública y una fuente alternativa; una línea base de 2025 o 2026 con la fecha de acceso y una instantánea archivada; una fecha de verificación y una fecha final; una probabilidad fija en la fecha de este registro; y los umbrales para tres resultados: se cumplió, no se cumplió, sin resolver.
Puntuación. Cada predicción se puntúa en la primera verificación anual en o después de su fecha de verificación en la que existan los datos, y no más tarde de su fecha final. Las predicciones resueltas se puntúan según la regla de Brier. Una predicción sin datos comparables en su fecha final se registra como sin resolver y no se cuenta como un éxito.
Conjuntos y probabilidades. El conjunto A se resuelve a partir de datos públicos y archivos en predictions/resolve/, cuyos hashes SHA-256 se enumeran en este registro. El conjunto B se resuelve solo a partir de estudios registrados por separado antes de la recopilación de datos; una predicción del conjunto B cuyo protocolo no se registra antes del 30 de junio de 2027 se registra como no realizada, como un fracaso del programa de pruebas; la puntuación de Brier se reporta tanto en las predicciones resueltas como con cada predicción no realizada puntuada como incorrecta. Las probabilidades dependen de la resolución. Son la mediana de tres pronósticos de modelo ciego recopilados el 9 de octubre de 2026 (Claude Opus, un modelo de OpenAI y Gemini) y adoptados por el autor; los pronósticos agrupados anteriores de cuatro modelos se adjuntan como referencia.
Punto de cruce. F2, F3, F5 y F7 se miden en los mismos dominios nombrados: contabilidad de pequeñas empresas, y documentos legales y de marketing, los dos dominios no relacionados con software del banco de tareas (Apéndice E); para el análogo de publicaciones de F5 se asignan a SOC 43-3031, 23-2011 y 13-1161. El tercer dominio del banco, pequeñas herramientas web internas, es el dominio de los programadores y no es un dominio de cruce. El punto de cruce en un dominio es el primer año en el que F3 y el análogo de dominio de F5 se cumplen ambos en ese mismo dominio nombrado; ninguno solo lo declara.
Adiciones de puntuación. Cada hoja de puntuación también informa la parte resuelta, la puntuación de Brier por conjunto y por familia, un límite inferior que puntúa las predicciones sin resolver vencidas como incorrectas, y la puntuación de habilidad de Brier contra 0.5, los pronosticadores de modelo agrupados y los precios de mercado.
Verificaciones anuales. Cada año de 2027 a 2031, en el aniversario de este registro, el autor publica una hoja de puntuación que cubre cada predicción registrada aquí. Cada hoja de puntuación se registra en OSF, vinculada a este registro por DOI, y depositada en Zenodo.
Reglas fijas. Ninguna predicción se elimina, se reformula o se le asigna una nueva fecha. Cualquier cosa agregada después se registra por separado y tiene su propia fecha. Si una fuente nombrada deja de publicarse o cambia su método, se utiliza la fuente alternativa, siempre que mida la misma cantidad; si no existe una fuente comparable, la predicción no se resuelve.
Verificación independiente. Cada hoja de puntuación se verifica contra las reglas congeladas aquí por modelos de al menos dos familias diferentes. Donde no están de acuerdo, la regla decide y se reporta el desacuerdo. Un árbitro humano, designado por el autor antes de la primera hoja de puntuación, decide las disputas entre las dos familias de modelos.
Datos propios. Las predicciones que se basan en los datos de cohorte del autor se prueban solo bajo un preregistro separado presentado antes de que se recopilen esos datos, como lo hace el programa registrado en OSF (DOI 10.17605/OSF.IO/X4EGQ) para cada cohorte.
Conflictos de intereses. Como se declara en el artículo.
Archivos. Tabla de predicciones (CSV, y Tabla A6 del artículo adjunto); lista de instantáneas archivadas; predictions/resolve/ (consultas congeladas, listas y libro de códigos, con hashes); resolution-rules.md; changelog-v1-v2.md.
La tabla de predicciones adjunta es la Tabla A6, y la Figura A1 dibuja su calendario.
Figura A1. El calendario de verificaciones, 2026 a 2031.
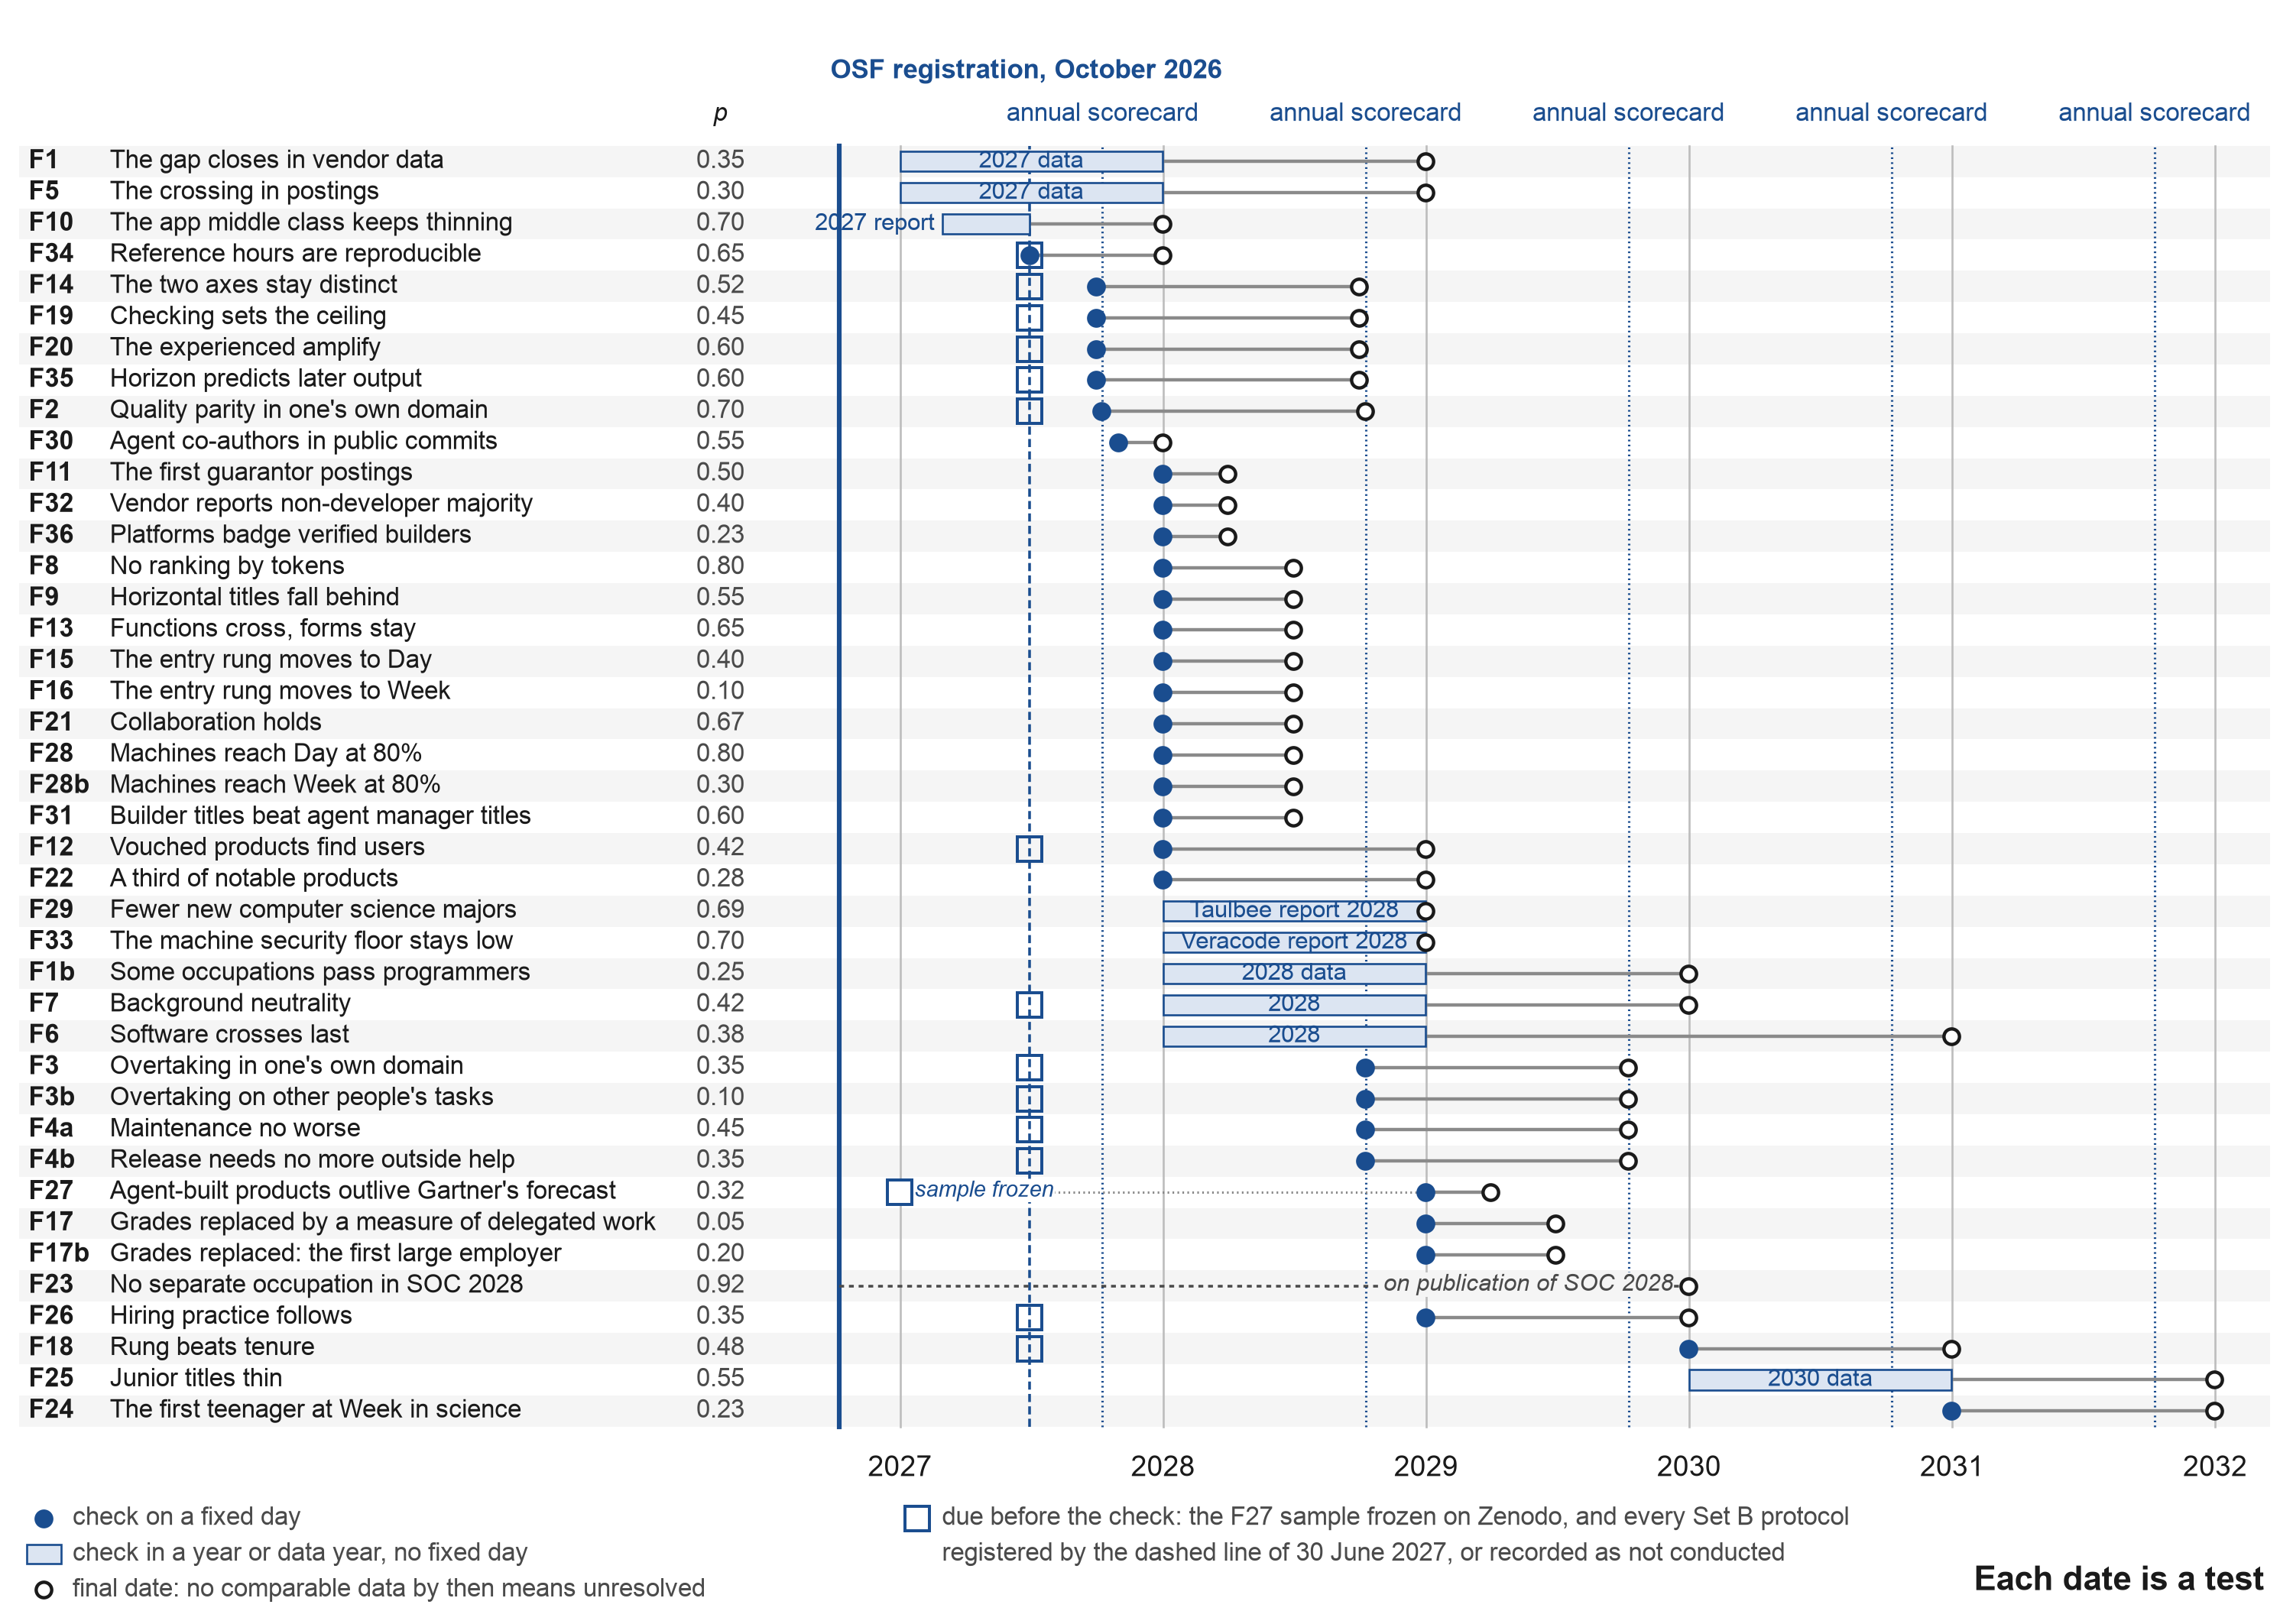
Nota: Una fila por predicción de la Tabla A6, ordenada por fecha de verificación, con su probabilidad. Un punto lleno es una verificación en un día fijo. Una barra clara es una verificación en un año o un año de datos sin un día fijo. El anillo es la fecha final, después de la cual una predicción sin datos comparables se registra como sin resolver (Sección 11.4). Las líneas punteadas marcan las hojas de puntuación anuales, para registrarse en OSF cada octubre de 2027 a 2031. Un cuadrado hueco marca un compromiso debido antes de la verificación: la muestra F27, congelada en Zenodo antes del 31 de diciembre de 2026, y, en la línea discontinua del 30 de junio de 2027, el protocolo de cada uno de los 14 estudios del Conjunto B, sin lo cual la predicción se registra como no realizada (Sección 11.2). La figura se genera a partir de la tabla de predicciones misma, por figures/figure_a1_calendar.py en el repositorio acompañante, y cambia solo con ella.
Tabla A6. Las 41 predicciones datadas: conjuntos, medidas, umbrales, probabilidades, pronósticos de modelos, alternativas y pronósticos anteriores.
| # (conjunto) | Predicción, medida, línea base y umbral | Fechas, probabilidad, pronósticos de modelos, regla sin resolver, alternativa y pronóstico anterior |
|---|---|---|
| F1 (A) | La brecha se cierra en los datos del proveedor. Éxito verificado en sesiones que producen código, programación frente a otras ocupaciones: 34% frente a 29%, sin cambios durante siete meses (Anthropic, 2026e). La brecha es la tasa de éxito de las ocupaciones de programación menos la de otras ocupaciones, con su signo. Se cumplió si la brecha es de 2 puntos o menos, valores negativos incluidos, en un informe comparable sobre datos de 2027; no se cumplió si es más de 2. Línea base: Éxito verificado en sesiones que producen código: programación 34% frente a otras ocupaciones 29%, sin cambios durante siete meses (Anthropic, 2026e) | Verificación: datos de 2027. Fecha final: 31 de diciembre de 2028. p = 0,35; modelos 0,39 (0,25 a 0,65). Sin resolver si: Sin informe sobre los datos de 2027 en la fecha final, o si la definición de sesión cambió (nunca se cuenta como un éxito). Alternativa: Cualquier informe del proveedor que proporcione éxito verificado por ocupación en sesiones comparables. Pronóstico anterior más cercano o contrario: Anthropic: la brecha "no se ha ampliado ni estrechado" |
| F1b (A) | Algunas ocupaciones superan a los programadores. Misma medida que F1. Las 10 ocupaciones no relacionadas con la programación más grandes se congelan en el registro como las 10 con las mayores participaciones de sesión en Anthropic (2026e). Una ocupación solo supera la programación si su tasa de éxito es mayor en 2 puntos o más (un margen para la multiplicidad en 10 comparaciones). Se hizo realidad si al menos 3 de los 10 lo hacen en los datos de 2028. Línea base: Como F1; la gestión ya ligeramente por delante de la programación (Anthropic, 2026e) | Verificación: datos de 2028. Fecha final: 31 de diciembre de 2029. p = 0,25; modelos 0,30 (0,20 a 0,45). Sin resolver si: Sin informe sobre los datos de 2028 en la fecha final, o si la definición de sesión cambió (nunca se cuenta como un éxito). Alternativa: Como F1. Pronóstico anterior más cercano o contrario: La gestión ya ligeramente por delante (Anthropic, 2026e) |
| F2 (B) | Paridad de calidad en el propio dominio (el paso antes del punto de cruce). Mismo agente, mismo tiempo, aceptación ciega y comprobaciones de seguridad, un cambio de mantenimiento por otro agente después de un mes; un estudio con 1.500 personas por grupo. Se hizo realidad si el límite inferior del intervalo del 95 % para (personas sin educación en TI menos programadores) está por encima de menos 10 puntos; no se hizo realidad si el límite superior está por debajo de menos 10; de lo contrario, sin resolver. Línea base: Sin línea base pública; estudio preregistrado por separado, 1.500 personas por grupo | Verificación: 8 de octubre de 2027. Fecha final: 8 de octubre de 2028. p = 0,70; modelos 0,67 (0,62 a 0,70). Sin resolver si: Sin datos comparables en la fecha final, o un intervalo que no cumple ninguna regla (nunca se cuenta como un éxito). Alternativa: Un estudio independiente con el mismo diseño. Pronóstico anterior más cercano o contrario: D. H. Hansson (2026), "100%" (sin fecha, sin medida); Esnaola et al. (2026) |
| F3 (B) | Superación en el propio dominio (el punto de cruce en calidad). Como F2 (1.500 por grupo da aproximadamente 0,8 de potencia para detectar una verdadera ventaja de 5 puntos con un alfa de dos colas de 0,05; 400 por grupo daría aproximadamente 0,3). Se hizo realidad si el límite inferior del intervalo del 95 % está por encima de cero; no se hizo realidad si el límite superior está por debajo de cero; de lo contrario, sin resolver. Línea base: Como F2 | Verificación: 8 de octubre de 2028. Fecha final: 8 de octubre de 2029. p = 0,35; modelos 0,33 (0,25 a 0,55). Sin resolver si: Sin datos comparables en la fecha final, o un intervalo que no cumple ninguna regla (nunca se cuenta como un éxito). Alternativa: Como F2. Pronóstico anterior más cercano o contrario: Ninguno encontrado con una fecha |
| F3b (B) | Superación en las tareas de otras personas. Como F3, pero en tareas fuera del propio dominio de los participantes. Línea base: Como F2, en tareas fuera del propio dominio de los participantes | Verificación: 8 de octubre de 2028. Fecha final: 8 de octubre de 2029. p = 0,10; modelos 0,13 (0,07 a 0,35). Sin resolver si: Sin datos comparables en la fecha final, o un intervalo que no cumple ninguna regla (nunca se cuenta como un éxito). Alternativa: Como F2. Pronóstico anterior más cercano o contrario: El argumento del dominio de la Sección 6.3 predice que falla |
| F4a (B) | Mantenimiento no peor. Participación de productos aceptados abandonados en los 12 meses, por educación de los autores. Se hizo realidad si el límite superior del intervalo del 95 % para la diferencia (no programadores menos programadores) está por debajo de 10 puntos. Línea base: Sin línea base pública; Gartner (Tyagi, 2026, como resumió Tray.ai, 2026) espera que el 60 % de las aplicaciones codificadas por intuición se retiren en 2028, contando todas las aplicaciones | Verificación: 8 de octubre de 2028. Fecha final: 8 de octubre de 2029. p = 0,45; modelos 0,49 (0,34 a 0,68). Sin resolver si: Sin datos comparables en la fecha final, o un intervalo que no cumple ninguna regla (nunca se cuenta como un éxito). Alternativa: Registros de productos con encuestas de autores. Pronóstico anterior más cercano o contrario: Gartner (Tyagi, 2026, como resumió Tray.ai, 2026): el 60 % de las aplicaciones codificadas por intuición se retiran en 2028 "porque no logran proporcionar el valor empresarial predecible"; una población más amplia que F4a, que cuenta solo productos aceptados |
| F4b (B) | El lanzamiento no necesita más ayuda externa. Participación de productos que necesitan ayuda técnica externa en el lanzamiento. Se hizo realidad si no es inferior con un margen de 10 puntos; se espera que la brecha se cierre en el orden prototipo, lanzamiento, mantenimiento. Línea base: Sin línea base pública | Verificación: 8 de octubre de 2028. Fecha final: 8 de octubre de 2029. p = 0,35; modelos 0,37 (0,22 a 0,50). Sin resolver si: Sin datos comparables en la fecha final, o un intervalo que no cumple ninguna regla (nunca se cuenta como un éxito). Alternativa: Como F4a. Pronóstico anterior más cercano o contrario: Gartner (Tyagi, 2026, como resumió Tray.ai, 2026): el 30 % de los equipos de ingeniería de software bajo "presión de capacidad material" por mantener aplicaciones codificadas por intuición construidas por desarrolladores ciudadanos y usuarios empresariales |
| F5 (A) | El cruce en los anuncios (la señal visible). Anuncios estadounidenses en un conjunto congelado de ocupaciones de TI; habilidades agénticas definidas por la versión de taxonomía de habilidades abiertas de Lightcast actual en la fecha de registro (número de versión registrado en predictions/resolve/F5.md), con la lista congelada de habilidades agénticas; la participación que requiere un grado de cuatro años en anuncios con esas habilidades contra anuncios sin ellas ajustados exactamente por ocupación (SOC de 6 dígitos), antigüedad, estado y trimestre. La línea base agéntica (2026 Q2 y Q3) se toma y se archiva antes del registro. Se hizo realidad si la diferencia es negativa en 2 puntos o más, con el intervalo del 95 % excluyendo cero, en dos trimestres consecutivos de 2027. Línea base: Los anuncios de IA aún tienen más probabilidad de requerir un grado pero convergen desde 2024 (Lightcast, 2026b); la línea base agéntica se toma antes del registro | Verificación: datos de 2027. Fecha final: 31 de diciembre de 2028. p = 0,30; modelos 0,34 (0,25 a 0,60). Sin resolver si: Sin datos comparables en la fecha final (nunca se cuenta como un éxito). Alternativa: PwC AI Jobs Barometer, solo si informa requisitos de grado para anuncios con habilidades agénticas contra anuncios coincidentes; de lo contrario, sin resolver. Pronóstico anterior más cercano o contrario: Gartner (2021): la mayoría de los productos tecnológicos construidos fuera de TI por 2024; Bone et al. (2025) sobre habilidades de IA en anuncios del Reino Unido |
| F6 (A) | El software cruza al final. Lista congelada de dominios: derecho, contabilidad y teneduría de libros, educación, administración clínica, comercialización, bienes raíces, seguros, recursos humanos, logística, desarrollo de software, infraestructura informática, seguridad, herramientas para desarrolladores. Orden de los primeros cruces de tipo F5 por dominio. Se cumplió si el desarrollo de software, la infraestructura, la seguridad y las herramientas para desarrolladores cruzaron después de al menos la mitad de los otros dominios. Línea base: Ningún dominio ha cruzado aún (comparación de tipo F5) | Verificación: 2028. Fecha final: 31 de diciembre de 2030. p = 0.38; modelos 0.37 (0.25 a 0.55). Sin resolver si: Menos de la mitad de los dominios no relacionados con software en la lista congelada han cruzado antes de la fecha final, o no hay una fuente comparable (nunca se cuenta como un éxito). Alternativa: Otra fuente de anuncios con la misma comparación de tipo F5 por dominio; los estudios de calidad (tipo F2) no cuentan, y sin tal fuente la predicción no se resuelve. Pronóstico anterior más cercano o contrario: Hwang (2026): finanzas "el canario en la mina" |
| F7 (B) | Neutralidad de antecedentes. Cohorte registrada por separado con una pregunta sobre educación en TI; horizonte puntuado en un conjunto de tareas, calidad en tareas retrasadas. Razón de probabilidades de pasar controles independientes asociados con educación en TI en nivel igual, controlando por competencia en el dominio y alfabetismo de aceptación. El margen de 0.67 a 1.5 es una razón de probabilidades de 1.5 de cualquier manera, aproximadamente una diferencia estandarizada de 0.22 (conversión de Chinn), convencionalmente un efecto pequeño. Se cumplió si el intervalo del 90% cae dentro de 0.67 a 1.5 (equivalencia), por separado a nivel Día, a nivel Semana, y superiores. Línea base: Sin línea base pública; cohorte registrada por separado con una pregunta sobre educación en TI | Verificación: 2028. Fecha final: 31 de diciembre de 2029. p = 0.42; modelos 0.43 (0.40 a 0.48). Sin resolver si: Cualquier otra combinación, incluyendo equivalencia mostrada en un solo nivel, o sin datos antes de la fecha final (nunca se cuenta como un éxito). Alternativa: Una cohorte independiente con los mismos elementos. Pronóstico anterior más cercano o contrario: Observación de Anthropic sobre competencia en el dominio; Savva (2026), el rival |
| F8 (A) | Sin clasificación por tokens. Empleadores de Fortune 500 utilizando recuentos de tokens como criterio oficial de evaluación durante 2027, documentado por el empleador o por dos medios independientes (las preguntas sobre uso de IA no cuentan). Se cumplió si se encontraron menos de dos empleadores de este tipo. Línea base: Recuentos de tokens probados como criterio de evaluación en 2026 (Sección 4 del documento) | Verificación: 31 de diciembre de 2027. Fecha final: 30 de junio de 2028. p = 0.80; modelos 0.79 (0.60 a 0.90). Sin resolver si: Sin datos comparables antes de la fecha final (nunca se cuenta como un éxito). Alternativa: Búsqueda en archivos de prensa empresarial con las consultas congeladas en predictions/resolve/F8.md. Pronóstico anterior más cercano o contrario: Kingy AI (2026): "downgraded, not killed"; Flowtivity (2026): "irreversible" |
| F9 (A) | Los títulos horizontales se quedan atrás. Anuncios de EE.UU., mismas consultas congeladas (predictions/resolve/F9.md), Q4 2026 y Q4 2027, cada recuento dividido por todos los anuncios de EE.UU. en el mismo trimestre: gestor de agentes, operador de IA, orquestador de IA contra títulos que nombran un dominio (por ejemplo "líder de IA legal", "líder de IA vertical"). Se cumplió si la participación normalizada de títulos nombrados por dominio crece por un factor mayor que la de los horizontales. Línea base: Recuentos de anuncios de EE.UU. en las consultas congeladas en Q4 2026 | Verificación: 31 de diciembre de 2027. Fecha final: 30 de junio de 2028. p = 0.55; modelos 0.58 (0.45 a 0.75). Sin resolver si: Cualquier familia tiene menos de 50 anuncios en Q4 2026, o sin datos antes de la fecha final (nunca se cuenta como un éxito). Alternativa: Recuentos de búsqueda de Indeed o LinkedIn con las mismas consultas. Pronóstico anterior más cercano o contrario: Srinivasan y Wei (2026): "agent manager" un título estándar dentro de 12 a 18 meses; IT Brew (2026): "the next 18 months" |
| F10 (A) | La clase media de las aplicaciones se sigue adelgazando. Proporción de nuevas aplicaciones de suscripción que alcanzan $1,000 de ingresos mensuales dentro de dos años, misma medida que RevenueCat 2026 (17%). Se cumplió si estaba por debajo del 17%. Línea base: El 17% de las nuevas aplicaciones de suscripción alcanzan $1,000 de ingresos mensuales dentro de dos años (RevenueCat, 2026) | Verificación: Informe de RevenueCat 2027. Fecha final: 31 de diciembre de 2027. p = 0.70; modelos 0.68 (0.60 a 0.80). Sin resolver si: Sin datos comparables antes de la fecha final (nunca se cuenta como un éxito). Alternativa: Umbrales de ingresos de Sensor Tower o Appfigures. Pronóstico anterior más cercano o contrario: Tendencia propia de RevenueCat (sin prioridad reclamada); muchas aplicaciones codificadas por vibes ganan mediante anuncios, que RevenueCat no ve |
| F11 (A) | Los primeros anuncios de garante. Anuncios de empleadores con más de 1.000 empleados en medicina, derecho, finanzas o educación que mencionan la firma de trabajos producidos por IA y responsabilidad personal por ello. Consultas congeladas en predictions/resolve/F11.md: "sign off" con "AI-generated", "accountable for AI output", "AI attestation", "AI guarantor"; los anuncios donde "guarantor" o "credential" se refieren a claves o acceso se excluyen. Se cumplió si se encontraron al menos 10 anuncios de al menos 5 empleadores y se archivaron. Línea base: No se encontró tal anuncio en el momento de la redacción | Verificación: 31 de diciembre de 2027. Fecha final: 31 de marzo de 2028. p = 0.50; modelos 0.42 (0.25 a 0.55). Sin resolver si: Sin datos comparables antes de la fecha final (nunca se cuenta como un éxito). Alternativa: Anuncios archivados encontrados a través de Google Jobs y LinkedIn. Pronóstico anterior más cercano o contrario: Capps (2025), "legal guarantor"; Forrester (2025): El 60% de Fortune 100 designar un jefe de gobierno de IA |
| F12 (B) | Los productos avalados encuentran usuarios. Estudio aleatorio propio: entre productos elegibles, un garante nombrado asignado al azar. Proporción que alcanza diez usuarios no relacionados dentro de 90 días. Se cumplió si la proporción avalada es mayor, con el intervalo del 95% excluyendo cero. Línea base: Sin línea base pública; estudio aleatorio propio | Verificación: 31 de diciembre de 2027. Fecha final: 31 de diciembre de 2028. p = 0.42; modelos 0.43 (0.30 a 0.60). Sin resolver si: Sin datos comparables antes de la fecha final (nunca se cuenta como un éxito). Alternativa: Ninguna. Pronóstico anterior más cercano o contrario: Vouch de Hashimoto (un mecanismo, no un pronóstico) |
| F13 (A) | Las funciones cruzan, las formas permanecen. Currículos y anuncios en tres profesiones no informáticas, codificados por dos codificadores con un libro de códigos publicado antes de la codificación (predictions/resolve/F13-codebook.md): verificación, elección de modelo por costo y ejecuciones largas enseñadas; gastos personales y campamentos de modelos encontrados solo entre usuarios de nivel superior. Se cumplió si los temas funcionales superan en número a los temas de estado en al menos tres a uno. Línea base: Sin línea base pública; dos codificadores en currículos y anuncios en tres profesiones no informáticas | Comprobación: 31 de diciembre de 2027. Fecha final: 30 de junio de 2028. p = 0.65; modelos 0.69 (0.55 a 0.82). Sin resolver si: No hay datos comparables en la fecha final (nunca se cuentan como un éxito). Opción alternativa: Catálogos de cursos públicos. Pronóstico anterior o contrario más cercano: Rogers (2003), capas de adopción (sin prioridad reclamada) |
| F14 (B) | Los dos ejes se mantienen distintos. Correlación de Spearman a nivel de persona entre el horizonte logarítmico y la ganancia logarítmica en al menos 200 registros. Se cumplió si la correlación es 0.8 o menor y la ganancia, sumada al horizonte, aumenta la R cuadrada fuera de muestra para la salida verificada seis meses después en al menos 0.02. Línea base: Sin línea base pública; al menos 200 registros | Comprobación: 30 de septiembre de 2027. Fecha final: 30 de septiembre de 2028. p = 0.52; modelos 0.49 (0.45 a 0.50). Sin resolver si: No hay datos comparables en la fecha final (nunca se cuentan como un éxito). Opción alternativa: Ninguna. Pronóstico anterior o contrario más cercano: Ninguno encontrado |
| F15 (A) | El peldaño de entrada se mueve a Día. En una muestra congelada de 200 publicaciones de nivel de entrada en EE.UU. y tareas para llevar a casa en software y tres otras profesiones, la asignación primera mediana, medida en horas de referencia por dos evaluadores, está en Día o superior. Línea base: Muestra congelada de 200 publicaciones de nivel de entrada en EE.UU. y tareas para llevar a casa, medidas en horas de referencia por dos evaluadores | Comprobación: 31 de diciembre de 2027. Fecha final: 30 de junio de 2028. p = 0.40; modelos 0.49 (0.30 a 0.70). Sin resolver si: No hay datos comparables en la fecha final (nunca se cuentan como un éxito). Opción alternativa: Muestras de nivel de entrada de Indeed Hiring Lab. Pronóstico anterior o contrario más cercano: Washington Monthly (2026): "los roles de nivel de entrada se están volviendo más como roles de nivel medio"; la tendencia del horizonte ajustado de METR se duplica aproximadamente cada 4.2 meses |
| F16 (A) | El peldaño de entrada se mueve a Semana. Misma medida; mediana en Semana o superior. Línea base: Como F15 | Comprobación: 31 de diciembre de 2027. Fecha final: 30 de junio de 2028. p = 0.10; modelos 0.14 (0.06 a 0.40). Sin resolver si: No hay datos comparables en la fecha final (nunca se cuentan como un éxito). Opción alternativa: Como F15. Pronóstico anterior o contrario más cercano: Kwa et al. (2025), horizontes de tiempo de máquina (máquinas, no personas) |
| F17 (A) | Las calificaciones se reemplazan por una medida del trabajo delegado. De los 50 mayores empleadores de EE.UU., aquellos que reemplazan públicamente las escalas de calificación por una medida del trabajo delegado verificado. Se cumplió si al menos 10. Línea base: Sin línea base pública | Comprobación: 31 de diciembre de 2028. Fecha final: 30 de junio de 2029. p = 0.05; modelos 0.05 (0.02 a 0.20). Sin resolver si: No hay datos comparables en la fecha final (nunca se cuentan como un éxito). Opción alternativa: Presentaciones de empleadores y prensa. Pronóstico anterior o contrario más cercano: Gartner (2024): hasta 2026, el 20% de las organizaciones utilizarán IA para aplanar la estructura; Microsoft (2025): "jefe agente" |
| F17b (A) | Calificaciones reemplazadas: el primer gran empleador. De los 50 mayores empleadores de EE.UU., al menos uno reemplaza públicamente las escalas de calificación por una medida del trabajo delegado verificado. Línea base: Sin línea base pública | Comprobación: 31 de diciembre de 2028. Fecha final: 30 de junio de 2029. p = 0.20; modelos 0.21 (0.05 a 0.50). Sin resolver si: No hay datos comparables en la fecha final (nunca se cuentan como un éxito). Opción alternativa: Presentaciones de empleadores y prensa. Pronóstico anterior o contrario más cercano: Gemelo más suave de F17 |
| F18 (B) | El peldaño supera la antigüedad. En datos de empleador o cohorte, el peldaño verificado explica más varianza en el salario que años de experiencia (el desempeño calificado se utiliza solo cuando el salario no está disponible, fijado antes del análisis). Línea base: Sin línea base pública | Comprobación: 31 de diciembre de 2029. Fecha final: 31 de diciembre de 2030. p = 0.48; modelos 0.52 (0.40 a 0.60). Sin resolver si: No hay datos comparables en la fecha final (nunca se cuentan como un éxito). Opción alternativa: Analítica de RRHH publicada. Pronóstico anterior o contrario más cercano: Jaques (1956), pago por alcance de responsabilidad |
| F19 (B) | La verificación establece el techo (fuera de muestra). Al menos 200 registros. Parte de la atención dedicada a la verificación y el horizonte, ambos medidos en meses 1 a 3; salida verificada (piezas aceptadas en horas de referencia, no la fórmula de ganancia) en meses 4 a 6. Se cumplió si, en personas retenidas, la parte de verificación tiene una correlación parcial más alta con la salida verificada posterior que el horizonte. Línea base: Sin línea base pública | Comprobación: 30 de septiembre de 2027. Fecha final: 30 de septiembre de 2028. p = 0.45; modelos 0.44 (0.30 a 0.65). Sin resolver si: No hay datos comparables en la fecha final (nunca se cuentan como un éxito). Opción alternativa: Ninguna. Pronóstico anterior o contrario más cercano: Huang et al. (2026), amplificación de verificación. v1 utilizó ganancia, que contiene horizonte por construcción; v2 predice un resultado medido separadamente y posterior |
| F20 (B) | Los experimentados amplifican. Parte directiva: parte de los turnos de una persona que dan instrucciones en lugar de verificar o editar, del registro. Ganancia verificada: horas de referencia aceptadas por hora de la atención de la persona. Entre personas cuya parte directiva disminuyó durante seis meses, la ganancia verificada en el mes 6 es al menos el 95% de su valor en el mes 0 para la mayoría. Línea base: Sin línea base pública | Comprobación: 30 de septiembre de 2027. Fecha final: 30 de septiembre de 2028. p = 0.60; modelos 0.62 (0.55 a 0.70). Sin resolver si: No hay datos comparables en la fecha final (nunca se cuentan como un éxito). Opción alternativa: Ninguna. Pronóstico anterior o contrario más cercano: Anthropic (2026d), curvas de aprendizaje |
| F21 (A) | Se mantiene la colaboración. La parte del uso colaborativo (aumento) en la muestra de conversación de Claude.ai del Índice Económico de Anthropic, no la muestra de API, se mantiene por encima del 40% en cada informe publicado en 2027. Línea base: Uso colaborativo del 52% frente a automatización del 45% en noviembre de 2025 (Anthropic, 2026a) | Comprobación: 31 de diciembre de 2027. Fecha final: 30 de junio de 2028. p = 0.67; modelos 0.68 (0.60 a 0.75). Sin resolver si: No hay datos comparables en la fecha final (nunca se cuentan como un éxito). Opción alternativa: Partes comparables en informes de otros proveedores. Pronóstico anterior o contrario más cercano: Anthropic (2026a): 52% frente a 45% en noviembre de 2025 |
| F22 (A) | Un tercio de productos notables. Los 100 productos con más votos positivos en los doce leaderboards mensuales de Product Hunt de 2027, lista congelada el 1 de enero de 2028. Los creadores enumerados están codificados; un producto cuenta como hecho sin educación en programación si ningún creador enumerado declara educación en programación o un trabajo de programación anterior (las personas autodidactas con trabajos de programación cuentan como programadores). Dos codificadores, ciegos entre sí. Se cumplió si al menos 30 de los 100 califican. Línea base: Manifold: software creado intuitivamente con 100 millones de usuarios mensuales a finales de 2026, aproximadamente el 28% | Verificación: 31 de diciembre de 2027. Fecha final: 31 de diciembre de 2028. p = 0.28; modelos 0.29 (0.14 a 0.50). Sin resolver si: Menos de 50 de los 100 productos tienen una declaración codificable, o no hay datos en la fecha final (nunca contado como un éxito). Alternativa: Una segunda clasificación congelada (Hacker News Show HN top 100 de 2027). Pronóstico anterior más cercano o contrario: Gartner (2021); Manifold: software codificado intuitivamente con 100 millones de usuarios mensuales al final de 2026, aproximadamente 28% |
| F23 (A) | Sin ocupación separada en SOC 2028. La Clasificación Estándar de Ocupaciones de EE. UU. para 2028 no contiene una ocupación separada para el trabajo dirigido a través de agentes. Línea base: SOC 2018 no tiene tal ocupación | Verificación: Publicación de SOC 2028. Fecha final: 31 de diciembre de 2029. p = 0.92; modelos 0.93 (0.80 a 0.98). Sin resolver si: Sin datos comparables en la fecha final (nunca contado como un éxito). Alternativa: Avisos de revisión de BLS (verificado 9 de octubre de 2026: sin estructura propuesta o final aún; estructura final esperada en 2027). Pronóstico anterior más cercano o contrario: Ninguno encontrado |
| F24 (A) | El primer adolescente en Week en la ciencia. Un producto científico es software, un conjunto de datos o un artículo utilizado en investigación publicada por al menos diez personas no relacionadas o citado en al menos un artículo revisado por pares. Un caso documentado públicamente de una persona menor de 18 años sin capacitación formal cuyo producto científico tiene tales usuarios y gana Week bajo una verificación independiente. Línea base: Ningún caso documentado de este tipo en el momento de la redacción | Verificación: 31 de diciembre de 2030. Fecha final: 31 de diciembre de 2031. p = 0.23; modelos 0.21 (0.02 a 0.45). Sin resolver si: Solo si las fuentes de búsqueda no están disponibles; la ausencia de un caso documentado en la fecha final no. Alternativa: Ninguna. Pronóstico anterior más cercano o contrario: Objetivo de China de educación en IA en todas las escuelas para 2030 (CSET, 2025) |
| F25 (A) | Títulos junior escasos. Proporción de publicaciones de software de EE. UU. con "junior" o "entry-level" en el título en 2030, contra 2025 en las mismas búsquedas. Se cumplió si bajó al menos una tercera parte. Línea base: Proporción de publicaciones de software de EE. UU. con "junior" o "entry-level" en el título en 2025, mismas búsquedas | Verificación: Datos de 2030. Fecha final: 31 de diciembre de 2031. p = 0.55; modelos 0.54 (0.45 a 0.60). Sin resolver si: Sin datos comparables en la fecha final (nunca contado como un éxito). Alternativa: Indeed Hiring Lab. Pronóstico anterior más cercano o contrario: Manifold: un tercio menos de funciones de desarrollador junior para 2030, aproximadamente 74%; desarrolladores de EE. UU. bajaron más del 15% de 2023 a 2028, aproximadamente 42%; mercado 0.74 (https://manifold.markets/OliverKuperman/will-the-number-of-junior-developer, 9 de octubre de 2026 (vacantes junior de SWE bajaron al menos 33% al 1 de enero de 2030; una medida relacionada, no idéntica)) |
| F26 (B) | La práctica de contratación sigue. Estudio de auditoría propia: carteras coincidentes de trabajo verificado que difieren solo en educación en IT enviadas a publicaciones reales en dos dominios no-IT. Se cumplió si las tasas de devolución de llamada difieren en menos de 3 puntos, con el intervalo del 95% dentro de más o menos 5. Línea base: Sin línea base pública; estudio de auditoría propia | Verificación: 31 de diciembre de 2028. Fecha final: 31 de diciembre de 2029. p = 0.35; modelos 0.32 (0.25 a 0.35). Sin resolver si: Sin datos comparables en la fecha final, o un intervalo que no cumple ninguna regla (nunca contado como un éxito). Alternativa: Ninguna. Pronóstico anterior más cercano o contrario: Burning Glass Institute y Harvard Business School (2024): menos de una contratación en 700 cambió |
| F27 (A) | Los productos construidos por agentes sobreviven a la previsión de Gartner. Una muestra de al menos 300 productos públicos construidos principalmente con agentes de codificación, lanzados de octubre a diciembre de 2026, congelados en Zenodo antes del 31 de diciembre de 2026; vida útil verificada por el script complementario. Se cumplió si menos del 50% se retiraron (inaccesibles o no actualizados durante 12 meses) el 31 de diciembre de 2028. Línea base: Gartner (Tyagi, 2026): 60% de aplicaciones codificadas intuitivamente retiradas para 2028 | Verificación: 31 de diciembre de 2028. Fecha final: 31 de marzo de 2029. p = 0.32; modelos 0.35 (0.20 a 0.55). Sin resolver si: La muestra no fue congelada antes del 31 de diciembre de 2026 (nunca contado como un éxito). Alternativa: Instantáneas de Wayback Machine de cada producto. Pronóstico anterior más cercano o contrario: Gartner (Tyagi, 2026): 60% retirado |
| F28 (A) | Las máquinas alcanzan Day al 80%. El horizonte de tiempo del 80% de METR para el mejor modelo lanzado públicamente alcanza 8 horas (Day) antes del 31 de diciembre de 2027. Línea base: Aproximadamente 3.1 horas al 80% en abril de 2026 (METR, 2026c; panel de control no actualizado después del 8 de septiembre de 2026) | Verificación: 31 de diciembre de 2027. Fecha final: 30 de junio de 2028. p = 0.80; modelos 0.66 (0.55 a 0.80). Sin resolver si: Ni METR ni la alternativa reportan un horizonte del 80% antes de la fecha final (nunca contado como un éxito). Alternativa: Una replicación independiente del método de METR (por ejemplo Epoch AI). Pronóstico anterior más cercano o contrario: La tendencia del horizonte ajustado de METR se duplica aproximadamente cada 4.2 meses |
| F28b (A) | Las máquinas alcanzan Week al 80%. Como F28, umbral de 40 horas (Week). Línea base: Como F28 | Verificación: 31 de diciembre de 2027. Fecha final: 30 de junio de 2028. p = 0.30; modelos 0.20 (0.10 a 0.55). Sin resolver si: Como F28. Alternativa: Como F28. Pronóstico anterior más cercano o contrario: Como F28 |
| F29 (A) | Menos nuevas especialidades en ciencias de la computación. Nuevas especialidades de pregrado en ciencias de la computación reportadas por la Encuesta Taulbee de CRA publicada en 2028 (año académico 2027 a 2028) contra la encuesta publicada en 2026. Línea base: Encuesta Taulbee de CRA publicada en 2026 | Verificación: Informe Taulbee 2028. Fecha final: 31 de diciembre de 2028. p = 0.69; modelos 0.67 (0.50 a 0.75). Sin resolver si: Sin datos comparables en la fecha final (nunca contado como un éxito). Alternativa: Matrícula del Centro de Investigación NSC por especialidad. Pronóstico anterior más cercano o contrario: Informes de CRA de matriculación decreciente en CS en 2025 y 2026 |
| F30 (A) | Coautores de agentes en commits públicos. Proporción de eventos de push público en GH Archive cuyos mensajes de commit llevan un tráiler de coautor de agente (expresiones regulares congeladas en predictions/resolve/F30.md), septiembre de 2027 contra septiembre de 2026. Línea base: GH Archive, septiembre de 2026, medido y archivado antes del registro | Verificación: 31 de octubre de 2027. Fecha final: 31 de diciembre de 2027. p = 0.55; modelos 0.59 (0.40 a 0.75). Sin resolver si: Sin datos comparables en la fecha final (nunca contado como un éxito). Alternativa: Gráfico de innovación de GitHub. Pronóstico anterior más cercano o contrario: Ninguno encontrado |
| F31 (A) | Los títulos de constructor superan los títulos de gerente de agentes. Publicaciones de EE. UU., consultas Indeed congeladas (predictions/resolve/F31.md), Q4 2027: títulos de la familia constructor contra la familia gerente de agentes. Línea base: Conteos en Q4 2026 en las mismas consultas | Verificación: 31 December 2027. Fecha final: 30 June 2028. p = 0.60; models 0.63 (0.50 to 0.74). Sin resolver si: No hay datos comparables en la fecha final (nunca se cuenta como un éxito). Alternativa: búsquedas de LinkedIn con las mismas consultas. Pronóstico anterior o contrario más próximo: Srinivasan and Wei (2026): "gerente de agentes" un título estándar dentro de 12 a 18 meses |
| F32 (A) | Un proveedor dice que la mayoría de los usuarios de su agente de codificación no son desarrolladores. Un proveedor de un agente de codificación hecho por Anthropic, OpenAI, Google o GitHub informa públicamente que las personas que no son desarrolladores de software son la mayoría de los usuarios semanales de ese agente. Línea base: No hay tal informe en el momento de la escritura | Verificación: 31 December 2027. Fecha final: 31 March 2028. p = 0.40; models 0.31 (0.13 to 0.70). Sin resolver si: No hay datos comparables en la fecha final (nunca se cuenta como un éxito). Alternativa: informes económicos o de uso del proveedor. Pronóstico anterior o contrario más próximo: Proveedores de constructores de aplicaciones (Lovable, Replit) ya describen principalmente usuarios no desarrolladores; esta pregunta es para agentes de codificación generales |
| F33 (A) | El piso de seguridad de la máquina se mantiene bajo. Proporción de muestras de código generadas por IA que pasan las pruebas de seguridad en el informe de seguridad de código GenAI de Veracode. Línea base: tasa de aprobación del 56%, estancada (Veracode, 2026) | Verificación: Veracode report 2028. Fecha final: 31 December 2028. p = 0.70; models 0.67 (0.57 to 0.80). Sin resolver si: No hay datos comparables en la fecha final (nunca se cuenta como un éxito). Alternativa: Un punto de referencia independiente comparable de seguridad en código generado. Pronóstico anterior o contrario más próximo: Veracode: sin mejora en seguridad con modelos más nuevos |
| F34 (B) | Las horas de referencia son reproducibles. Dos paneles independientes de tres evaluadores estiman horas de referencia para las mismas 50 tareas; correlación intraclase (bidireccional, acuerdo absoluto) de log de horas. Línea base: Prueba de escritorio de los umbrales (Apéndice E) | Verificación: 30 June 2027. Fecha final: 31 December 2027. p = 0.65; models 0.65 (0.40 to 0.75). Sin resolver si: No hay datos comparables en la fecha final, o un intervalo que no cumpla con ninguna regla (nunca se cuenta como un éxito). Alternativa: Ninguna. Pronóstico anterior o contrario más próximo: líneas de base humanas de METR (máquinas, no personas) |
| F35 (B) | Horizonte predice rendimiento posterior. Al menos 200 registros: horizonte en el mes 0 añadido a antigüedad y educación en TI aumenta el R cuadrado fuera de la muestra para la salida verificada en los meses 4 a 6. Línea base: No hay línea de base pública | Verificación: 30 September 2027. Fecha final: 30 September 2028. p = 0.60; models 0.58 (0.45 to 0.70). Sin resolver si: No hay datos comparables en la fecha final (nunca se cuenta como un éxito). Alternativa: Ninguna. Pronóstico anterior o contrario más próximo: Burning Glass Institute and Harvard Business School (2024) |
| F36 (A) | Las plataformas otorgan insignias a constructores verificados. Al menos dos de Upwork, Fiverr, GitHub, Product Hunt, Toptal y Contra introducen una insignia pública o campo de perfil que certifica trabajo construido por IA verificado independientemente (no un cuestionario de habilidades). Línea base: No hay tal insignia en el momento de la escritura | Verificación: 31 December 2027. Fecha final: 31 March 2028. p = 0.23; models 0.24 (0.07 to 0.70). Sin resolver si: No hay datos comparables en la fecha final (nunca se cuenta como un éxito). Alternativa: Páginas de ayuda de plataforma y anuncios archivados. Pronóstico anterior o contrario más próximo: Ninguno encontrado |
Nota: El Conjunto A se resuelve a partir de datos públicos; el Conjunto B a partir de estudios preregistrados por separado (protocolo antes del 30 June 2027, de lo contrario no se lleva a cabo, que el cuadro de resultados cuenta como un fracaso del programa de pruebas). p está condicionado a la resolución. Modelos: media geométrica de las probabilidades de pronosticadores de modelos independientes que no vieron mis números, con su rango; pronósticos individuales en predictions/m2-probabilities.csv. Reglas de lo que se hizo verdad y lo que no se hizo para cada fila están en predictions/predictions.csv. En las filas F4a y F4b el pronóstico de Gartner se cita como lo cita la lista de referencias, a través del resumen de Tray.ai (2026), con sus propias palabras citadas; el archivo registrado proporciona el mismo pronóstico y los mismos números de forma más breve y cita Gartner (Tyagi, 2026).
Apéndice E. Prueba de escritorio de los umbrales
Este apéndice informa sobre la prueba de escritorio de las reglas de la Sección 5.2, ejecutada el 9 de octubre de 2026 mediante simulación y con evaluadores de modelos, y establece el protocolo de calibración que fija la siguiente versión. Cada número es producido por dos scripts en el repositorio complementario (pilot/), que invocan el evaluador del Apéndice C sin cambios e intercambian solo sus constantes.
E1. Con qué frecuencia se obtiene un escalón
Para una persona cuyas piezas pasan independientemente con una probabilidad verdadera p, la Tabla E1 da la probabilidad de obtener cada escalón con exactamente el recuento mínimo de piezas en la ventana. Los valores son probabilidades binomiales exactas; una ejecución de Monte Carlo a través de horizon.py, con las piezas distribuidas en la ventana, el error plantado y la pieza reciente en su lugar, concuerda dentro de 0,01.
Tabla E1. Probabilidad de obtener un escalón, según la tasa de aprobación verdadera.
| Regla | p = 0.95 | p = 0.9 | p = 0.8 | p = 0.7 | p = 0.6 |
|---|---|---|---|---|---|
| Hora y Día, 8 de 10 en 91 días | 0.99 | 0.93 | 0.68 | 0.38 | 0.17 |
| Semana, 5 de 6 en 182 días | 0.97 | 0.89 | 0.66 | 0.42 | 0.23 |
| Mes, primera versión, 4 de 4 en 365 días | 0.81 | 0.66 | 0.41 | 0.24 | 0.13 |
| Mes, actual, 5 de 6 en 365 días | 0.97 | 0.89 | 0.66 | 0.42 | 0.23 |
| Trimestre, 3 de 3 en 365 días | 0.86 | 0.73 | 0.51 | 0.34 | 0.22 |
Nota: la regla es una regla de calificación. Estas probabilidades describen la regla, no a ninguna persona.
Tres hallazgos siguen. Primero, la primera versión no estaba ordenada: Mes, con cuatro de cuatro, era más difícil de obtener que Trimestre en cada p. Un recuento de cuatro de cinco habría invertido el error, haciendo Mes más fácil que Día y Semana en p = 0,8 (0,74), por lo que Mes ahora solicita cinco de seis en un año, aproximadamente 960 horas de referencia en lugar de 640. Con esto, Día, Semana, Mes y Trimestre están ordenados de más fácil a más difícil para cada p de 0,77 y superior, el rango donde la calificación importa. Por debajo de 0,76 Semana es ligeramente más fácil que Día (0,42 contra 0,38 en p = 0,7). Ambos se rechazan la mayoría de las veces, y esto se informa y se deja sin cambios. Ningún recuento de tres o más piezas puede ordenarse contra tres de tres en cada p, porque las curvas se cruzan. Segundo, un veredicto es ruidoso: en p = 0,8 el mismo veredicto se repite en la siguiente ventana para el 56% de las ventanas en Día, 55% en Semana y Mes y 50% en Trimestre. El registro, por lo tanto, imprime el recuento junto al escalón ("Día (8/10)"), y un informe puede marcar un escalón como estable cuando también se mantuvo en la ventana anterior. En p = 0,8 un Día que se mantuvo en dos ventanas consecutivas ocurre en el 46% de los casos, por lo que la estabilidad es una etiqueta, no un requisito. Tercero, una persona confiable aún puede fallar: en p = 0,95 Trimestre se pierde en el 14% de los años, que es el precio de un escalón que descansa en tres piezas.
La Figura A2, panel A, traza estas probabilidades contra p para las reglas v1.1.
E2. Sensibilidad al recuento y la proporción
El artículo prometió informar cuántas personas cambian de escalón cuando el recuento se mueve de diez a ocho o doce y la proporción de 0,8 a 0,7 o 0,9. La respuesta se da para 10.000 registros simulados en Día, cada uno con entre 6 y 16 piezas de tamaño Día en la ventana y una tasa de aprobación verdadera extraída uniformemente entre 0,5 y 1,0. La regla actual (diez, 0,8) da Día al 30% de ellos, y la Tabla E2 da la proporción cuyo veredicto cambia bajo las otras reglas.
Tabla E2. Proporción de registros simulados cuyo veredicto de Día cambia respecto a diez piezas y una proporción de 0,8.
| Recuento mínimo | Proporción 0,7 | Proporción 0,8 | Proporción 0,9 |
|---|---|---|---|
| 8 | 22% | 8% | 15% |
| 10 | 10% | 0% | 11% |
| 12 | 16% | 9% | 17% |
Nota: la población de registros es un supuesto de la simulación. El estudio de campo de E5 repite este análisis en registros reales.
Mover cualquier constante un paso cambia aproximadamente un veredicto de diez. Mover ambas cambia hasta uno de cinco. La proporción es más importante que el recuento.
E3. Ruido del evaluador en el borde de un escalón
Si dos evaluadores no tienen sesgos y el 80% de sus pares caen dentro de una razón de 1,5, por encima del criterio del 70% en la Sección 5.8, y la referencia es la media geométrica de sus dos estimaciones, entonces una pieza cuyo tamaño verdadero es de 7 horas de referencia se califica con tamaño Día el 20% de las veces, y una pieza de 9 horas no alcanza el tamaño Día el 23% de las veces. Esta es la razón por la que el registro informa el tamaño mediano aceptado junto al escalón (Tabla 3): un horizonte construido sobre piezas justo por encima de un umbral se muestra.
E4. Evaluadores de modelos de horas de referencia
Cuatro modelos de lenguaje de cuatro familias (Anthropic, OpenAI, Google y Moonshot), cada uno trabajando solo y ciego a los otros y a cualquier tiempo publicado, estimaron las horas de referencia de 44 tareas el 9 de octubre de 2026. Treinta fueron tareas de un nuevo banco en tres dominios de bajo riesgo (contabilidad de pequeñas empresas, pequeñas herramientas web internas, documentos legales y de marketing), cada una con una declaración escrita de cumplimiento y una verificación oculta. Catorce fueron tareas públicas de los datos de horizonte de tiempo de METR (METR, 2026d) con tiempos de línea de base humana medidos de 12 minutos a 14,6 horas, proporcionadas a los evaluadores solo por su identificador público. La Tabla E3 da los resultados.
Tabla E3. Acuerdo y precisión de cuatro evaluadores de modelos ciegos.
| Medida | Banco de 30 tareas (declaración de cumplimiento) | 14 tareas con tiempos medidos (solo identificador) |
|---|---|---|
| Pares de estimaciones dentro de una razón de 1,5 (6 pares de evaluadores) | 62% (del 27% al 97% por par) | 35% |
| Correlación intraclase ICC(2,1), log horas | 0.89 | 0.60 |
| Los cuatro evaluadores colocan la tarea al mismo tamaño de escalón | 60% | 36% |
| Media de los cuatro dentro de 1,5 del tiempo medido | no medido | 21% (3 de 14) |
| Media de los cuatro dentro de 2 del tiempo medido | no medido | 43% (6 de 14) |
Nota: los evaluadores del modelo actúan en lugar de los dos evaluadores humanos de la Sección 5.1 y no son evidencia sobre ellos.
Dada una declaración completa de realizado, los modelos acordaron cuáles tareas eran más grandes, pero no sobre el nivel: la media geométrica de las estimaciones de un evaluador sobre el banco era de 5.1 horas y la de otro de 10.4. Un desplazamiento fijo de ese tipo es el error más barato de eliminar, razón por la cual los evaluadores del estudio de campo primero calibran en tareas con tiempos medidos. Dado solo un identificador, las estimaciones fueron de poco uso, lo que respalda un banco congelado con tiempos medidos a mano (Sección 5.1) sobre estimaciones realizadas a partir de un título. Bajo la regla de la Tabla 3, donde un desacuerdo superior a 1.5 envía una pieza a un tercer evaluador, dos evaluadores de este tipo enviarían aproximadamente cuatro piezas de diez a un tercero.
Figura A2. La regla del peldaño en el escritorio: la probabilidad de ganar un peldaño y hasta qué punto los evaluadores del modelo están de acuerdo en horas.
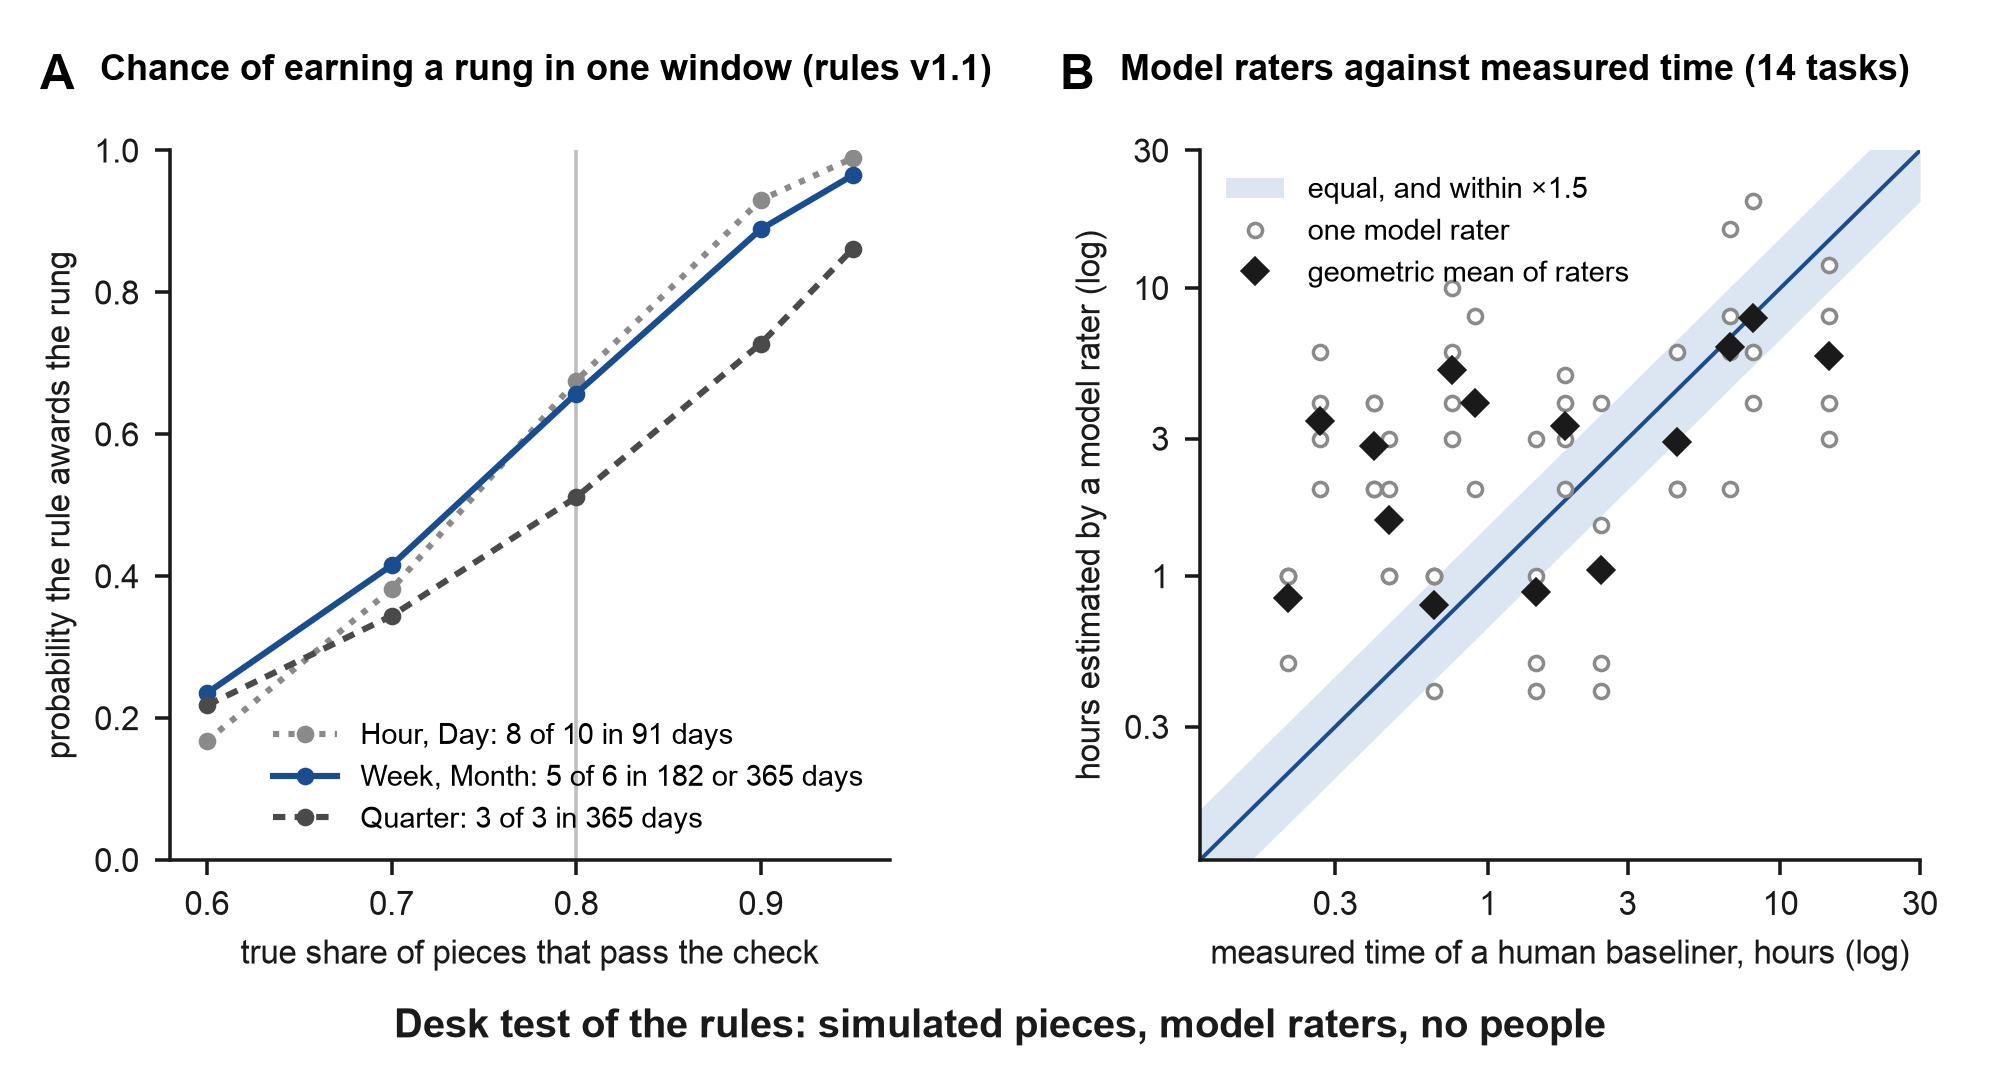
Nota: una prueba de escritorio con piezas simuladas y evaluadores del modelo. Panel A proporciona, para cada peldaño según las reglas v1.1, la probabilidad de que la regla otorgue el peldaño en una ventana cuando cada pieza aprueba su verificación de forma independiente con la proporción en el eje horizontal. Los peldaños con la misma cantidad y el mismo número de aprobaciones siguen la misma curva. Panel B establece las horas de referencia que cuatro evaluadores de modelo, cada uno de una familia diferente, estimaron para 14 tareas frente al tiempo medido para un evaluador humano base (datos de tareas de METR). La banda marca acuerdo dentro de un factor de 1.5. La prueba de escritorio que produjo ambos paneles se describe en este apéndice, y su código y salidas están en el repositorio complementario.
E5. El protocolo de calibración
El protocolo y el texto de registro están en el repositorio complementario (pilot/pilot-protocol.md, pilot/preregistration-draft.md). En resumen, 60 adultos participan, 30 con antecedentes de software y 30 sin, en los tres dominios del banco, durante dos ventanas de 91 días. Todos utilizan las mismas herramientas de agente, con versiones registradas, y las verificaciones son pruebas ocultas o dos revisores de dominio ciegos. Los tiempos a mano se miden en una quinta parte de las tareas del banco, cada entrega se registra con su fecha de inicio, y una décima parte aleatoria de las piezas aceptadas se audita. Los criterios se establecen antes de los datos: al menos el 70% de pares de estimaciones humanas dentro de 1.5, al menos el 60% de horas calificadas dentro de 1.5 de las medidas, repetibilidad del peldaño en las dos ventanas con una kappa ponderada de al menos 0.6, predicción de pasar nuevas tareas con un AUC de al menos 0.7, menos del 5% de líneas de registro perdidas, y al menos el 95% de entregas fallidas registradas. El formulario de consentimiento está escrito solo para este estudio y no reutiliza ningún otro consentimiento. Mes y Trimestre, trabajo irreversible y dominios de alto riesgo están fuera de este estudio de campo de seis meses.
E6. Lo que resuelve la prueba de escritorio y qué viene después
Muestra cómo se comportan las reglas para una persona de confiabilidad conocida, donde fueron inconsistentes (una inconsistencia ya está corregida), qué tan sensible es un veredicto a las dos constantes, y que los evaluadores del modelo ordenan las tareas consistentemente pero discrepan en el nivel. El protocolo de calibración de E5 asume lo que una prueba de escritorio deja a las personas: cómo se comportan bajo las reglas, si un peldaño se repite para una persona real, y si predice un trabajo nuevo; el acuerdo entre evaluadores humanos se prueba primero (Apéndice G). Los umbrales se prueban en el escritorio como reglas v1.1, y el estudio de calibración establece la siguiente versión.
Para reproducir: python3 pilot/simulate_rules.py y python3 pilot/rater_agreement.py pilot/results/model-ratings.csv pilot/metr-anchor-tasks.csv (Python 3.9 o posterior, solo biblioteca estándar; seed 20261009).
Apéndice F. Tablas y figuras complementarias
Los objetos numerados A1, A2 y así sucesivamente son objetos de apéndice. Se citan de las secciones nombradas en cada nota.
Tabla A1. Señales de convergencia, 2025 a octubre de 2026.
| Señal | Fuente y fecha | Lo que muestra | Lo que no muestra |
|---|---|---|---|
| Trabajo del desarrollador descrito como delegación y verificación | GitHub, 8 December 2025 | La descripción del proveedor del rol ha cambiado | Que el nivel de los desarrolladores se mida de esa manera |
| Los no desarrolladores dentro de un agente de codificación crecieron 137 veces (individuos) y 189 veces (organizaciones) | OpenAI, June 2026 | Crecimiento rápido desde una base baja; una cuarta parte de los usuarios muestreados hicieron al menos una solicitud estimada en más de 8 horas | Calidad de sus resultados; datos del proveedor |
| Las diez ocupaciones más grandes dentro de 7 puntos de las ocupaciones de programación en éxito verificado en sesiones que producen código | Anthropic, 16 June 2026 | Pequeña brecha entre ocupaciones; éxito respaldado por evidencia como pruebas o confirmaciones; experiencia juzgada por comportamiento | Educación (la ocupación no es un título); calidad de los productos entregados |
| Abogados construyendo sus propias herramientas; acceso amplio a IA 83% frente a 61% | Bloomberg Law, 20 April 2026 | Expertos en dominio construyendo, no comprando | Cuánto tiempo se mantienen esas herramientas |
| Escala renombrada para aproximadamente 181,500 empleados | Business Insider and Fortune, 22 January 2026 | Empleadores cambiando títulos | Una nueva medida (niveles internos mantenidos) |
| «Frontier Professionals»: 3,233 de 20,000 usuarios de IA | Microsoft, 5 May 2026 | Un segmento de encuesta de usuarios avanzados | Un rol o un grado |
| 16,541 publicaciones mencionando IA agéntica en 2025 (151 en 2024) | Stanford AI Index 2026 | Demanda de la habilidad en publicaciones | Nuevas ocupaciones |
| Contratación de nivel de entrada bajó más que el promedio general | LinkedIn Economic Graph, August 2026 | Un peldaño de entrada más débil a mediados de 2026 | Que la IA lo causó (LinkedIn señala la economía) |
| Nuevos estudiantes de Ciencias de la Computación bajaron 13% en departamentos que otorgan doctorado | CRA Taulbee, June 2026 | Estudiantes reaccionando | Una tendencia a largo plazo; todas las instituciones |
| El uso de IA se discutió en 4.54% de las entrevistas en Q2 2026 (0.33% en Q3 2025) | Metaview, 2026 | La pregunta ha entrado en la contratación | Una escala para la respuesta |
Nota: Los datos del proveedor se marcan como tales. Se omiten las comparaciones antiguas (con 2019 o 2022) por regla (Sección 1).
Tabla A2. Nombres en circulación y nombres propuestos, por capa, el 9 de octubre de 2026. Parte 1: nombres en uso, con sus propietarios y estado. Parte 2: nombres propuestos en este estudio, descripciones simples y variantes consideradas.
| Capa | Candidato | Introducido por, y cuándo (parte 1) | Sentido en que se usa | A favor | En contra |
|---|---|---|---|---|---|
| Parte 1 | |||||
| Habilidad masiva | constructor, Construtor Full Stack | LinkedIn, December 2025 (reportado); «ahora todos son constructores» (SF Standard, 2026) | Cualquiera que construye, desde cualquier función | Ya ganando en Recursos Humanos | No dice nada sobre el nivel |
| Habilidad masiva | codificación vibe, codificador vibe | Karpathy, 2 February 2025 | Construir sin leer el código | Ampliamente conocido | Burlándose; nombra el piso |
| Habilidad masiva | AI fluency (cuatro Ds) | Anthropic, 2025b | Delegación, descripción, discernimiento, diligencia | Cubre el terreno | Competencias sin niveles |
| Habilidad masiva | agent literacy | MindStudio, 11 June 2026 | Delegar, verificar, gestionar | Cercano en sentido | Tomado; sin estándar de prueba |
| Profesión | ingeniero agéntico | Karpathy, February 2026; Alenezi, June 2026 | Un ingeniero que dirige agentes | La palabra del ingeniero de 2026 | Vinculado a la ingeniería |
| Profesión | jefe de agentes | Microsoft, 23 April 2025 | Cada empleado que gestiona agentes | Memorable | Un eslogan sin medida |
| Profesión | gestor de agentes | Arion Research, 7 February 2026; Srinivasan and Wei, Harvard Business Review, 12 February 2026 | Un rol que ejecuta agentes en un equipo | Reportado como el favorito (aicodex, 2026); sus autores esperan que se convierta en un título estándar dentro de 12 a 18 meses | Un título de gerente horizontal (Sección 6.3) |
| Profesión | Propietario de Agente de IA; Supervisor de Agente de IA | Writer, 2026; Digg discussion, 2026 | Una persona responsable de un agente implementado | Nombra la propiedad | El uso de un único proveedor o foro |
| Profesión | orquestador de IA | St. Lawrence, 2024 seminar and 2025 book; 739 postings in February 2026 (IT Brew, 2026) | Un profesional de negocios que coordina IA | En publicaciones | Tomado muchas veces; horizontal |
| Profesión | Operador de IA | Dust, 7 October 2026 | Construye y mantiene flujos de trabajo de agentes compartidos | Familiar | Suena como una consola; en Anthropic un «operador» es una empresa que construye sobre la API (Anthropic, 2026b) |
| Profesión | custodio de IA, arquitecto de trabajo de IA | Ono, World Economic Forum, 22 June 2026 | Uno establece los límites del trabajo de IA, el otro verifica las consecuencias | El predecesor más cercano en sentido | Dos roles, sin medida |
| Profesión | creador de productos | Cagan, SVPG, 2025 | Una persona que lleva un producto de la idea al mercado | Lenguaje de producto | Tomado; sin medida |
| Profesión | Principal de Producto | O'Neill, LinkedIn post, 2026 | Establece objetivos para agentes, acepta y responde por el resultado | Casi el sentido de este artículo | Tomado en ese sentido; citar como precedente |
| Profesión | Ingeniero Principal de Contexto Agéntico | Job title collected by Turkovic, 24 April 2026 | Un grado de antigüedad en trabajo de agentes | Muestra que «principal» ya se usa como un grado | Grado, no una profesión |
| Profesión | AI Product Builder; Agentic Product Builder | anuncio de n8n, 2026; anuncio de State Street, 2026 | Se requiere construcción de productos y práctica de verificación; se prefiere (n8n) o se requiere (State Street) codificación | Muestra empleadores avanzando en el requisito de codificación en ambas direcciones | Títulos de empleadores individuales |
| Profesión | Chartered Financial Intelligence Architect | Clark, SSRN, 2026 | Una profesión nombrada para una industria | Muestra nombres ligados al dominio siendo emitidos | Una propuesta, una industria |
| Profesión | principal | Teoría de agencia (Jensen & Meckling, 1976); "principals" en la constitución de Claude (Anthropic, 2026b); The Principal Firm (Verheul, 2026); encuadre principal-agente de agentes de IA (Berkeley California Management Review, 2025; Tikhomirov, 2026) | La parte en cuyo nombre actúa un agente y que soporta el costo de la verificación | Teoría detrás de ello; coincide con la palabra "agente" | "Agent principal" en gestión de identidad y acceso significa la identidad propia del agente, el sentido opuesto; también el grado de Ingeniero Principal |
| Medida | horizonte de delegación (sentido de máquina o empresa) | Khadj, 2026 (una versión anterior llevaba un "Índice de Horizonte de Delegación", 0 a 100); Alonso, 2026 ("un horizonte de delegación" para cadenas de trabajo) | Hasta qué punto una máquina o una empresa puede delegar antes de que un humano deba intervenir | Muestra que la frase es natural | Máquina o empresa, no una persona |
| Medida | mejora; aceleración; autonomía 1 a 5; H1 a H5; capacidad de supervisión | METR, 2025; Anthropic Economic Index, 2025-2026; Shao et al., 2025; em360, 2026 | Ganancias promedio, aceleración a nivel de conversación, autonomía del agente, participación humana preferida, salida útil por esfuerzo | Vecinos establecidos de ganancia de amplificación | Mide tareas, conversaciones o herramientas, no la salida verificada de una persona |
| Momento | tiempo de cruce | The geometry of learning under AI delegation (2026) | El punto después del cual delegar a la IA cuesta más por la pérdida de habilidades de la que gana | Cercano en forma | Sentido opuesto: pérdida de habilidades, no peso de credenciales |
| Socio | garante | "Garante legal" en Capps (2025), New York Times Magazine | Proporciona la responsabilidad que la IA no puede | Exacto | Coloración legal |
| Socio | finalizador; ingeniero de distribución; ingeniero de GTM | ingeniero de GTM en anuncios, 2026 | Lleva el producto a las personas | Pagado hoy | Parcialmente automatizable (Sección 7) |
| Señal fallida | maximización de tokens | Uso en prensa, 2026 (CIO, 2026a) | Clasificación o competencia por tokens consumidos | Nombra una práctica real | No es una profesión (Sección 4) |
| Nombres antiguos | desarrollador ciudadano; ingeniería de software de usuarios finales; Code Runner, Adaptor, Writer, Builder | Gartner, para 2009; Ko et al., 2011; Feldman & Anderson, 2024 | Construcción fuera de TI; usuarios finales enfrentándose a problemas de ingeniería | Linaje largo | Ligado a un lado de la vieja división |
| Parte 2 | Candidato | Estado | Sentido | A favor | En contra |
| Habilidad masiva | alfabetización de aceptación | Propuesto aquí; no se encontró uso en las bases del Apéndice B | Decir por adelantado qué cuenta como hecho, luego mostrarlo | Nombra el núcleo | Una habilidad, no una persona; debe distinguirse de la investigación de aceptación de tecnología |
| Profesión | agentwright | Propuesto aquí; no se encontró uso en las bases del Apéndice B | Quien hace trabajo a través de agentes, como un dramaturgo hace una obra | Libre en las bases académicas; conlleva autoría | Los motores de búsqueda lo dividen en "Agent Wright"; suena como una herramienta de prueba de navegador; parcialmente ocupado a partir de octubre de 2026 (un paquete de Python y un catálogo de habilidades de agentes), por lo que necesitaría un calificador |
| Profesión | orquestador de dominio (orquestador legal, orquestador fintech) | Propuesto en un borrador anterior de este estudio | Una persona con conocimiento profundo del dominio que ensambla sistemas de agentes para ese dominio | Vincula el rol a un vertical (Sección 6.3) | "Orquestador multidominio" es un término establecido en la gestión de redes 5G y 6G |
| Profesión | definidor-aceptador; director de agentes | Descripciones simples | Define la tarea y acepta el resultado | Exacto | Una descripción, no un nombre; "director" es un rango de gerente |
| Profesión | Creador de Producto Dirigido por Agentes; Creador de Producto de Agentes; Administrador de Trabajo de Agentes; Productor de Trabajo de Agentes; Autor de Resultados; Arquitecto de Resultados; director de agentes | Variantes producidas en las consultas de modelo de este estudio | Variaciones sobre la autoría y administración del trabajo de agentes | Muestran el espacio de opciones | Largo, o cercano a nombres tomados (administrador, creador, arquitecto) |
| Escalera profesional | Especificador, Verificador, Orquestador de Dominio; definidor, aceptador, coordinador, propietario del bucle | Escaleras tempranas de este estudio | Pasos de responsabilidad creciente para el trabajo de agentes | Legible | Reemplazado por peldaños en horas, que no necesitan traducción entre profesiones |
| Medida | horizonte de delegación verificado (también: horizonte de delegación personal o humano) | Propuesto aquí | El trabajo verificado más grande que una persona entrega a agentes | Arraigado en Jaques y METR | Debe distinguirse del sentido de máquina y empresa en la parte 1 |
| Medida | ganancia de amplificación | Propuesto aquí | Trabajo verificado por hora de atención | Acredita a los constructores de bucles cortos | Necesita una referencia congelada |
| Momento | punto de cruce de credenciales | Propuesto aquí; no se encontró uso en las bases del Apéndice B | Cuando los productos de personas sin educación en TI comienzan a superar los de los programadores bajo las mismas verificaciones, y las credenciales pierden peso | Observable en partes (Sección 6.2) | "Credencial" también significa una clave secreta en la seguridad del agente; definir en el primer uso |
| Momento | Punto de Inversión de Habilidades; Punto de Neutralidad de Antecedentes; punto de cruce de experiencia; desacoplamiento de credenciales | Variantes consideradas | El mismo momento visto desde habilidades, antecedentes, experiencia o credenciales | Cada uno enfatiza una parte | Cada uno cubre solo uno de los componentes de la Sección 6.2 |
| Socio | co-firmante; intermediario de confianza; principal de distribución | Variantes consideradas | El socio que firma o lleva el producto | Plano | Más estrecho que garante o finalizador |
| Señal fallida | antigüedad de token (tokens como rango) | Término utilizado aquí para el episodio 2026 | Clasificación de personas por tokens consumidos | Nombra un evento real | No es una profesión (Sección 4) |
Nota: El estado refleja búsquedas en web y bases de datos del 8 y 9 de octubre de 2026 (Apéndice B). "No se encontró uso" se refiere a las bases enumeradas en esas fechas y no reclama nada sobre bases que no fueron buscadas. Las variantes en la parte 2 provienen de los borradores propios del estudio y se enumeran para que la familia de opciones permanezca visible.
Tabla A3. Escalas de 2025 y 2026 y qué mide cada una (lista completa).
| Escala | Fuente | Unidad medida | ¿Mide a una persona por trabajo delegado verificado? |
|---|---|---|---|
| Niveles de autonomía para agentes de IA (operador a observador) | Feng et al., 2025 | El agente | No |
| Cinco niveles, desde autocompletar hasta la fábrica de software | Shapiro, January 2026 | La máquina o la configuración del equipo | No |
| Ocho etapas del desarrollo asistido por IA | Yegge, 2026 | La práctica de un programador, por número de agentes | No |
| La Escalera de Capacidad (disparador a equipo de agentes) | Memari & Rudolph, 2026 | La automatización del trabajo | No |
| Siete etapas de supervisión de agentes de codificación | Park et al., 2026 | Etapas del trabajo de supervisión | No |
| Cinco niveles de delegación en desarrollo (AIDEs) | JetBrains Research (Tikhomirov), September 2026 | Delegación de un desarrollador, enmarcada como una relación principal-agente | Solo desarrolladores; sin regla de verificación |
| Niveles de delegación de IA en toma de decisiones | Dawson, 2026; Metal Toad, 2026 | Delegación de una organización o gerente | No |
| Delegación inteligente de IA | Tomašev et al. (DeepMind), February 2026 | Delegación en general | Sin medida a nivel de persona |
| La frontera de delegación (versión inicial: Índice de Horizonte de Delegación, 0 a 100) | Khadj, 2026 | Delegación de una firma o agente | No (máquinas y firmas) |
| Autor, editor, director, orquestador | Microsoft, May 2026 | Patrones de trabajo | No |
| Marco de Competencia de IA (ocho áreas, cuatro niveles) | AI Certification Standards, 23 August 2026 | Competencias en todas las profesiones | Sin examen ni umbrales |
| Fluidez en IA (cuatro Ds) | Anthropic, 2025b | Alfabetización | Sin niveles |
| Horizonte de tiempo de máquina | METR, 2025-2026 | El modelo | No (solo máquinas) |
| Horizonte de delegación verificado y ganancia de amplificación | This paper | Una persona en un dominio | Sí, según la regla de la Sección 5.2 |
Nota: "Mide a una persona por trabajo delegado verificado" significa que la escala coloca a un individuo en un nivel según el tamaño del trabajo entregado a agentes y confirmado por una verificación que los agentes no vieron. Los niveles de JetBrains se refieren a cuánto delegan los desarrolladores, y ya utilizan el lenguaje de principal y agente. Son el vecino más cercano, y carecen de una regla de independencia para verificaciones y una unidad de tamaño.
Tabla A4. Casos difíciles y cómo los tratan las reglas.
| Caso | Tratamiento |
|---|---|
| Trabajo que la persona nunca hubiera podido hacer manualmente | Las horas de referencia siguen siendo de un especialista calificado; la propia habilidad de la persona no interviene |
| Trabajo cuya calidad se muestra solo meses después | Aceptado provisionalmente; el resultado retrasado se registra cuando llega y puede revocar la pieza |
| Un dominio sin revisor humano calificado disponible | Pruebas ocultas o uso real por usuarios previstos; un modelo de otra familia solo con fuentes que la persona abrió |
| Un crítico ciego de la misma familia de modelos, en un contexto nuevo | No es una verificación independiente: registrado como same_family (Apéndice C), no obtiene crédito, aunque puede mejorar el trabajo antes de una verificación independiente (Sección 6.5) |
| Un equipo que acepta trabajo conjuntamente | Cada persona registra su propia atención; la pieza cuenta para la persona que firmó la aceptación |
| Una pieza que pasa la verificación pero se encuentra que es incorrecta más tarde | Registrado como fallido en la siguiente reverificación, y el escalón se puntúa nuevamente |
| Trabajo irreversible mezclado con trabajo ordinario | La regla más estricta se aplica solo a las piezas irreversibles (Sección 5.2) |
Tabla A5. Temas en los hilos de desarrolladores y sus contrapartes en otras profesiones, 2025-2026 (casos ilustrativos).
| Tema en los hilos | Contraparte fuera del software | Fuente | ¿Se cruzó? |
|---|---|---|---|
| Quién es responsable de la salida deficiente, el modelo o quienquiera que estableció la tarea | "Workslop": salida de IA que traslada el trabajo a su destinatario, aproximadamente dos horas por incidente y $186 por empleado al mes; los colegas juzgan a sus remitentes menos capaces | The Decoder (2025); BetterUp (2026) | Sí, fuertemente |
| El precio de verificación ($150 la hora para revisión) | El mismo costo de workslop | The Decoder (2025) | Sí |
| Un modelo fuerte planifica y revisa, los modelos baratos hacen el trabajo | Presupuestos de IA asignados por función en Atlassian | HCA Magazine (2026) | En empresas |
| Sobrecarga, cambio constante de herramientas, miedo a quedarse atrás | "AI brain fry" reportado por 25-26% de los mercadólogos, 19% en HR, 17% en software | Search Engine Journal (2026) | Sí, más fuertemente fuera de TI |
| Herramientas propias en lugar de software comprado | Abogados construyendo herramientas con agentes; 35% de empresas encuestadas reemplazando algo de software comprado con el propio (muestra del proveedor) | Artificial Lawyer (2026); Bloomberg Law (2026); Retool (2026) | En la capa superior |
| Comparación de agentes | Contables comparando dos agentes de codificación | Growthy (2026) | Sí |
| Mover una empresa a agentes sin programadores | Abogados y firmas construyendo con agentes en lugar de proveedores | Bloomberg Law (2026); Artificial Lawyer (2026) | En parte; el negocio de consultoría en sí se ve solo en el hilo |
| Una factura de IA personal superior a $1,000 al mes como marcador de estatus | No se encontró contrapartida de estado; los más cercanos son límites y asignaciones de la empresa (límite de $1,500 al mes de Uber, carteras de IA de Atlassian) | Fortune (2026b); HCA Magazine (2026); búsqueda del 9 de octubre de 2026 | No, como estatus; sí, como línea presupuestaria |
| Pertenencia al campamento de un agente | No se encontró contrapartida | Búsqueda del 9 de octubre de 2026 | No, y no es necesario |
Nota: Los hilos son evidencia cualitativa elegida por sus temas y no representan una población. «Crossed over» registra si se encontró una contrapartida en las fuentes enumeradas el 9 de octubre de 2026.
Figura A3. Horizontes de máquinas en la escala de los peldaños.
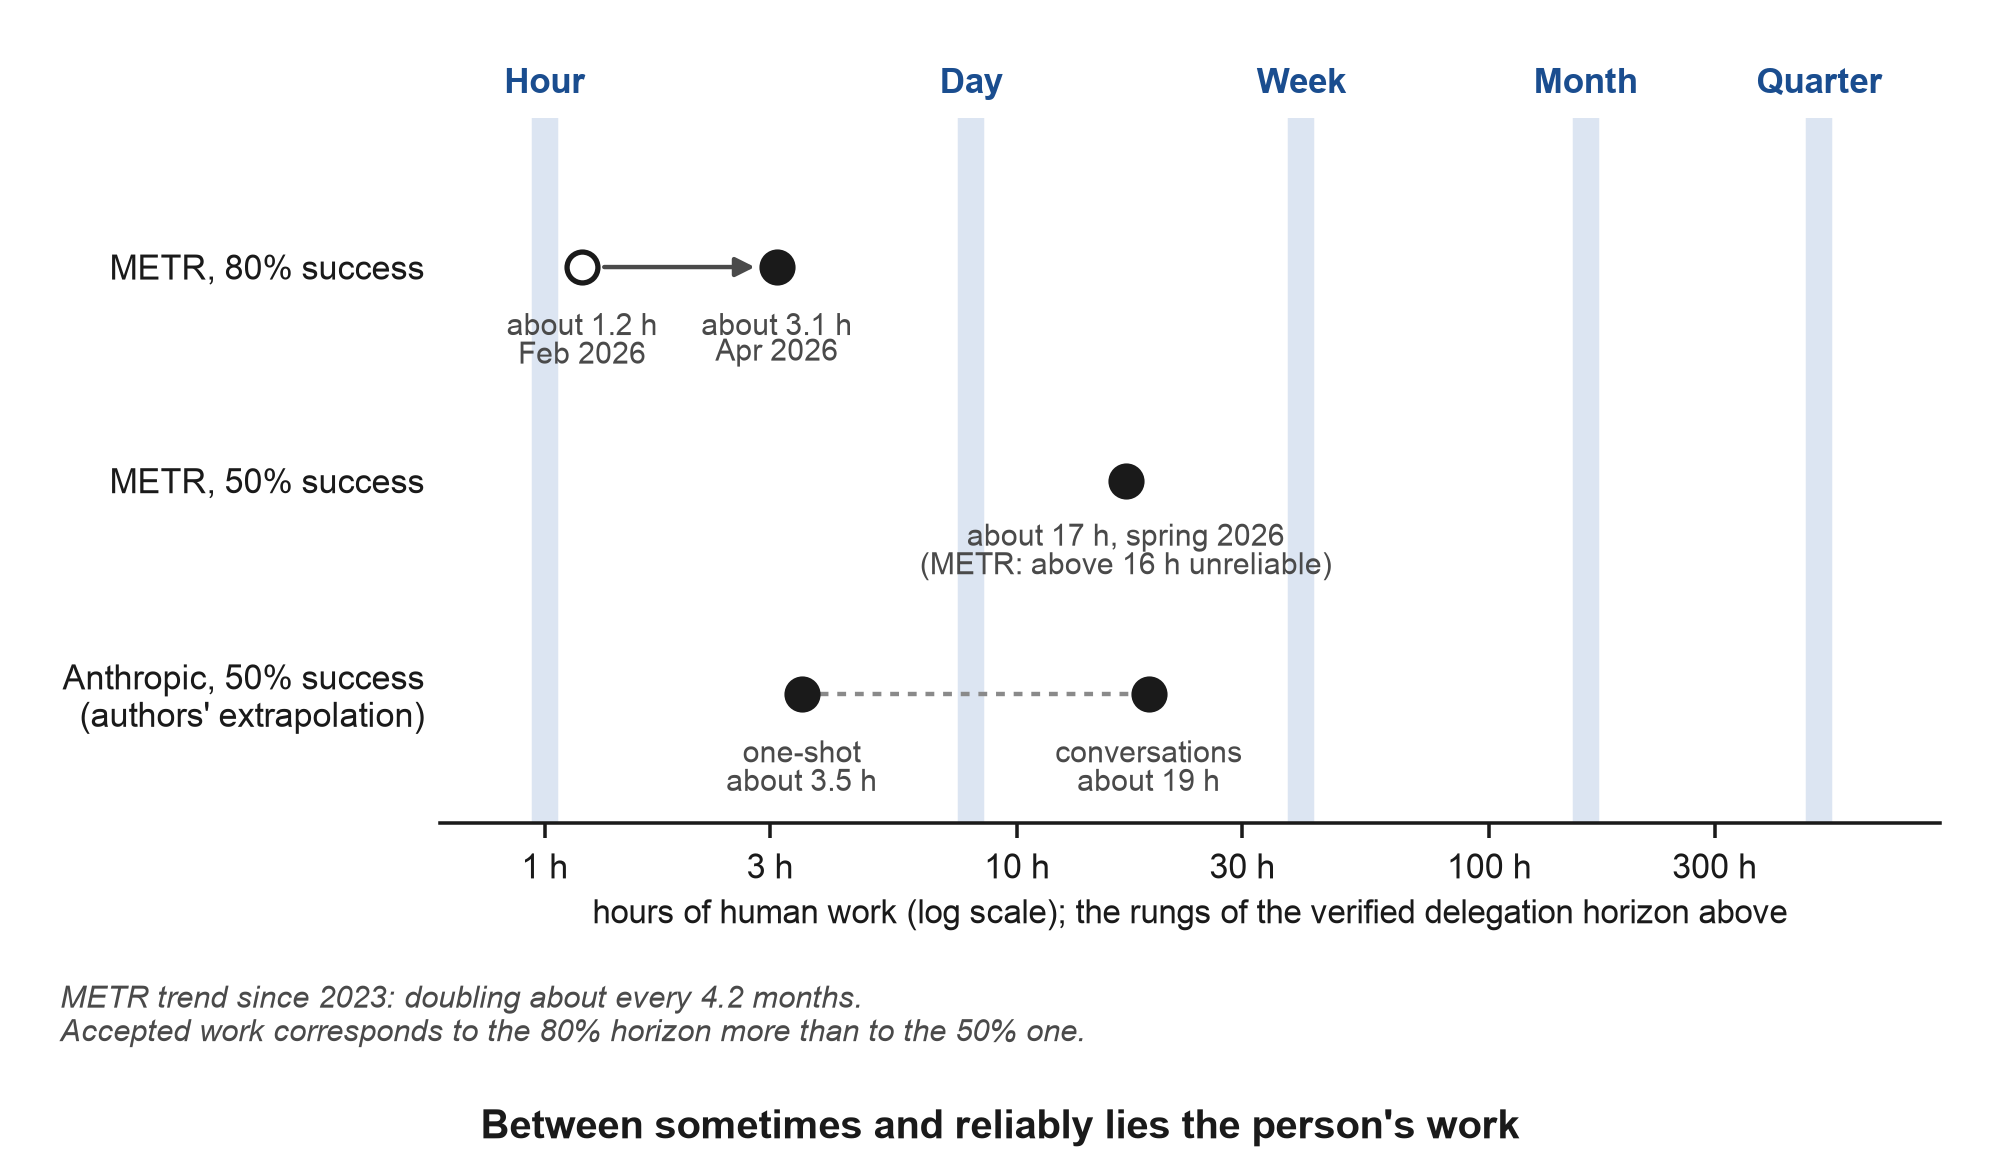
Nota: El horizonte de tiempo de METR al 80% de éxito, aproximadamente 1,2 horas en febrero de 2026 y aproximadamente 3,1 horas en abril. Al 50% de éxito, aproximadamente 17 horas en primavera de 2026, lo que METR mismo denomina poco confiable por encima de 16 horas (METR, 2026c). Los puntos del 50% de Anthropic, aproximadamente 3,5 horas para solicitudes puntuales y aproximadamente 19 horas para conversaciones, son extrapolación de los autores (Anthropic, 2026a). Los horizontes de máquinas miden modelos, no personas. Las columnas sombreadas solo muestran dónde caen los peldaños de la Sección 5.3 en el mismo eje de horas (Sección 5.6).
Figura A4. El proceso de verificación de la Sección 6.5: en qué se detalla cada paso, qué gana bajo la regla y dónde se detiene.
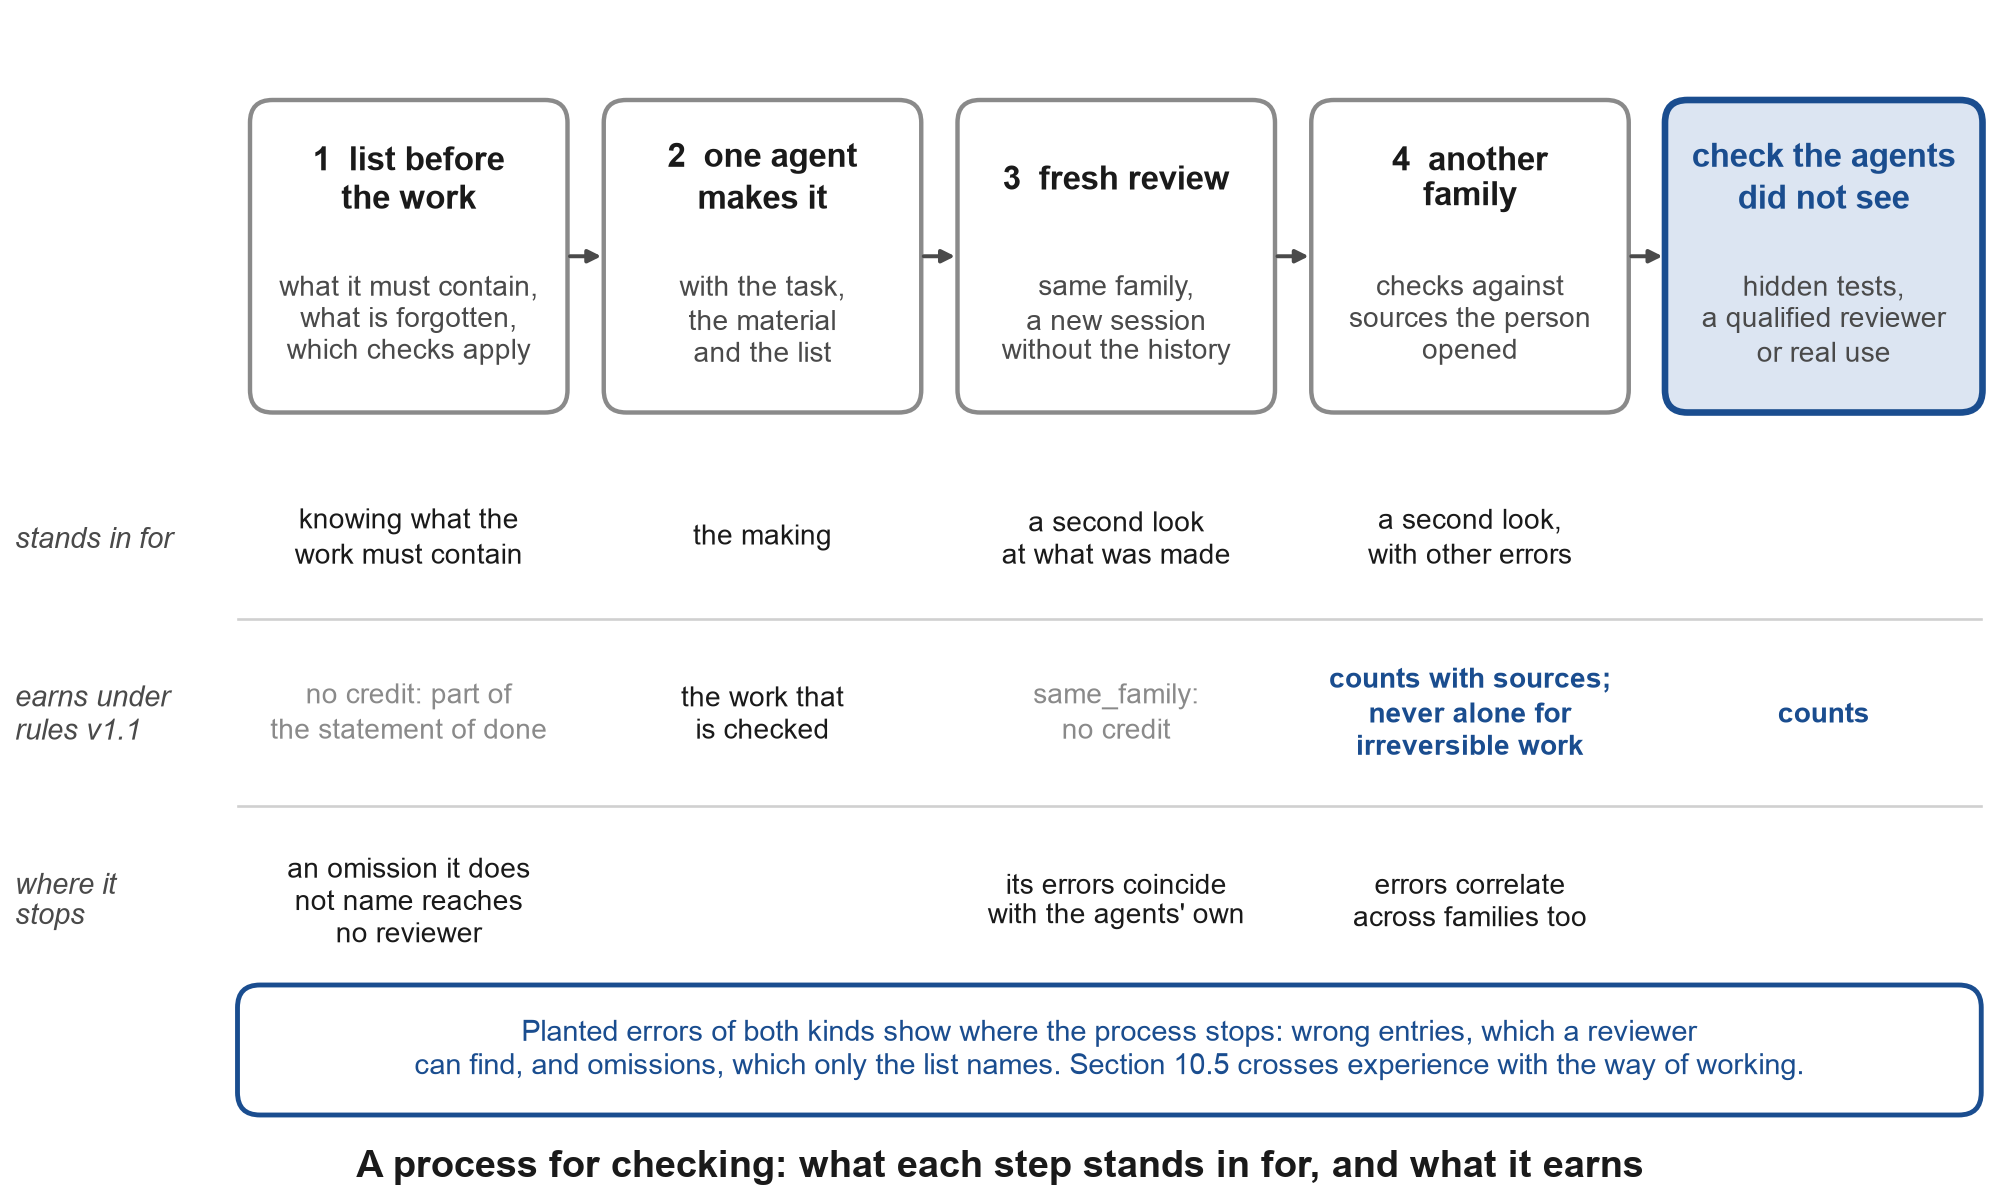
Nota: Los cuatro pasos y en qué se detalla cada uno son los de la Sección 6.5. La fila de crédito sigue la regla de puntuación de la Sección 5.2 y la Tabla A4: una revisión por un modelo de la misma familia en un contexto nuevo se registra como same_family y no gana crédito, aunque puede mejorar el trabajo; un modelo de otra familia cuenta solo cuando verifica contra fuentes que la persona abrió, y nunca solo para trabajo irreversible. La última fila resume Fu et al. (2025) sobre omisiones y Kim et al. (2025) sobre errores que correlacionan en modelos. Ninguna predicción registrada prueba el proceso; la Sección 10.5 expone la comparación que lo haría. La figura se dibuja mediante figures/figure_a4_checking_process.py en el repositorio acompañante, que lee el crédito de cada tipo de verificación de horizon.py. Cada paso se detalla en parte de la experiencia de un oficio; la Sección 14 vuelve a esto como una escalera de igualadores.
Tabla A7. Estado de las afirmaciones en este artículo.
| Elemento | Cómo se sostiene | Base |
|---|---|---|
| Los programadores y otros ahora comparten las tareas y el flujo de trabajo de delegación y aceptación | Los datos lo apoyan a nivel de tareas y flujos de trabajo; las profesiones en conjunto no se han fusionado | Sección 2; registros de proveedores y encuestas de 2025-2026 |
| Las dos escaleras antiguas no miden ese trabajo | Observado | Escaleras renombradas sin una nueva medida (Deloitte); pregunta sobre el uso de IA que entra en entrevistas sin una escala |
| Los recuentos de tokens fallan como medida de antigüedad | Observado en casos tempranos | Reportes de prensa de 2026 (Sección 4): una clasificación no oficial de un empleado en Meta, derribada, y la posterior orientación oficial de Meta contra recuentos de tokens; una tabla de clasificación en Amazon, manipulada y eliminada; presupuesto de IA de Uber gastado en cuatro meses, un evento presupuestario |
| Horizonte de delegación verificado y ganancia de amplificación | Propuesto; reglas v1.1 probadas en escritorio; protocolo de calibración en el repositorio acompañante; acuerdo de profesionales sobre horas de referencia bajo prueba registrada | Definiciones y reglas (Sección 5); instrumento (Apéndice C); prueba de escritorio de los umbrales (Apéndice E) |
| Techo de ganancia establecido por la parte de la verificación | Ofrecido como modelo; ilustrado por promedios de GDPval | Sección 5.5 |
| Neutralidad de antecedentes | Hipótesis; pruebas a registrar (F7) | Anthropic (2026e) lo señala; Savva (2026) es un rival |
| Punto de cruce de credencial | Hipótesis; componentes fechados por separado (paridad F2, adelantamiento F3, publicaciones F5, neutralidad F7) | Lightcast (2026b) muestra líneas convergentes; Bone et al. (2025) la preceden para roles de IA |
| Compuertas que admiten por una fuga de etiqueta autoinformada; compuertas que verifican que el trabajo se mantenga | Ofrecido como modelo; la fuga se ilustra una vez, por el cribado del estudio del evaluador | Secciones 6.2 y 13; Apéndice G2; Danilova et al. (2021); Reid et al. (2022); Serafini et al. (2024, 2026); Junta Estatal de Examinadores de Abogados de Oregón (2026) |
| Software cruza último | Predicción (F6), con 40 otros en la Tabla A6, registrada en OSF | Argumento de dominio (Sección 6.3) |
| Un proceso de verificación puede representar parte de la experiencia de un oficio | Hipótesis, no registrada; ninguna predicción registrada la prueba, y F3b (p = 0,10) se relaciona con ella solo indirectamente; se establece una comparación en la Sección 10.5 | Sección 6.5; Dell'Acqua et al. (2026), McAleese et al. (2024), Eulerich et al. (2024), Fox et al. (2026) y Benchek et al. (2026) de un lado; Kim et al. (2025), Chernets (2026b), Fu et al. (2025) y Virk y Liu (2025) del otro |
| Confianza como segundo límite; garante como profesión asociada | Ofrecido como modelo; predicciones F11 y F12 | Sección 7 |
| No programadores trabajando a través de agentes | Observado en una cohorte en ejecución, descrito sin inferencia; resultados registrados reportados por separado | Sección 11.5; Apéndice G |
Tabla A8. Compuertas que admiten por una etiqueta y compuertas que verifican el trabajo: qué verifica cada una y qué se observó.
| Compuerta | En qué admite | Lo que se observó | Fuente |
|---|---|---|---|
| Un filtro de participante de una plataforma de investigación | Respuestas dadas principalmente en palabra del participante; edad y país de residencia verificados | De 60 personas admitidas en una muestra de contabilidad, 11 respondieron incorrectamente una pregunta de la primera semana del oficio, 8 de ellas al invertir el débito y el crédito | Prolific (2026); Apéndice G2 |
| Habilidad de programación declarada en una plataforma de crowdwork | La palabra de la persona | 42% no cumplieron los criterios de las preguntas de conocimiento de los investigadores | Danilova et al. (2021) |
| Programación en Node.js reportada en Prolific | La palabra de la persona | 55 de 206 aprobaron todas las preguntas de programación | Reid et al. (2022) |
| Una pregunta estática de conocimiento, en texto o en imágenes | Una respuesta que un modelo de chat puede dar | ChatGPT resolvió fácilmente las preguntas de selección existentes para programadores, y para 2026 superó preguntas visuales estáticas diseñadas para resistirlo | Serafini et al. (2024, 2026) |
| Una pregunta de audio revelada paso a paso bajo un límite de tiempo estricto | Una respuesta dada bajo presión de tiempo | Aún mantenido contra un modelo de chat en 2026 | Serafini et al. (2026) |
| Un requisito de grado eliminado de una política | Una etiqueta, eliminada en papel | Menos de una contratación en 700 cambió; 19,3% de las publicaciones de EE. UU. en Indeed solicitaban una licenciatura o superior en noviembre de 2025, más que hace un año | Burning Glass Institute y Harvard Business School (2024); Indeed Hiring Lab (2026) |
| Una licencia por un examen aprobado una vez | Conocimiento, verificado una vez | Funciona como una etiqueta desde entonces | Sección 6.2 |
| Inspección del trabajo firmado de una firma de auditoría licenciada | Trabajo firmado, verificado una y otra vez | Cada año para firmas que regularmente auditan más de 100 emisores, al menos una vez cada tres años de lo contrario | Sarbanes-Oxley Act of 2002, s. 104 |
| Una licencia por un portafolio de trabajo supervisado | Trabajo verificado, una vez; el título de derecho aún es requerido | 205 candidatos habían solicitado antes del 5 de enero de 2026 y 49 fueron licenciados, el primero en diciembre de 2024 | Oregon State Board of Bar Examiners (2026) |
| El horizonte de delegación verificado | Trabajo entregado que pasó una verificación que los agentes no vieron, confirmado cada trimestre | Un peldaño con el recuento y los tipos de verificación, con los fallos mantenidos en el registro | Secciones 5.2 y 5.3 |
Nota: Las filas son los casos que cita la Sección 6.2. Provienen de diferentes poblaciones y diferentes preguntas y se colocan una al lado de la otra por lo que verifica cada puerta, no para compararse como tasas. Una puerta del segundo tipo se puede agregar delante de cualquier puerta del primero: los evaluadores de horas de referencia en el repositorio complementario son admitidos por una pregunta del oficio (kits/reference-hours-raters.md), como el estudio de evaluadores del Apéndice G2 evaluó a sus evaluadores. kits/trade-screen.md establece cómo escribir una pregunta de este tipo e informarla, y tools/gate_leak.py da la proporción que una etiqueta permite, con un intervalo exacto.
Apéndice G. Personas que ya lo hacen: una cohorte de no programadores y un estudio de evaluadores Prolific
Este apéndice es un suplemento de la medida, no parte de su argumento; las secciones 6.2, 6.5 y 14 citan el resultado del cribado de G2 como ilustración. Añade dos registros de personas: un relato de no programadores que pasaron del chat a trabajar con agentes en septiembre y octubre de 2026 (G1), y un estudio registrado de evaluadores en el que profesionales en activo calificaron las horas de referencia del banco de tareas (G2).
G1. No programadores que pasaron del chat a los agentes
Desde el 6 de septiembre de 2026 guié a adultos sin formación en programación, paso a paso y mediante mensajería ordinaria, desde un asistente de chat hasta un agente de codificación instalado en su propio ordenador y pagado con su propia suscripción de consumidor, y luego hacia el trabajo con varios modelos. Procedían de más de una docena de ocupaciones, entre ellas contabilidad y trabajo de oficina, derecho, marketing y ventas, diseño, fotografía y retoque, traducción y edición, música, construcción, transporte y logística, bienes raíces, trabajo de cuidados, administración pública y trabajo comunitario sin fines de lucro; cuatro reportaron trabajo pasado o presente en software. El relato siguiente es descriptivo: informa qué hicieron las personas y qué las detuvo, tal y como se registró el 9 de octubre de 2026, y no calcula ninguna tasa ni prueba ninguna afirmación de este artículo.
Tabla G1. Hasta dónde había llegado la cohorte el 9 de octubre de 2026 (número de personas).
| Paso | Personas |
|---|---|
| En el registro: consintieron y devolvieron el cuestionario de entrada | 119 |
| Instalaron un agente en su propio ordenador y suscripción y comenzaron a trabajar con él | 35 |
| Produjeron un artefacto, o completaron al menos un paso, en su propio trabajo | 24 |
| Se detuvieron, con una razón establecida | 23 |
| de los cuales: ningún ordenador propio (solo teléfono, o un dispositivo que no puede ejecutar el agente) | 9 |
| de los cuales: el costo de una suscripción | 5 |
| de los cuales: rechazaron (lo que tenían era suficiente, sin interés, o el encuadre de principiante no encajaba) | 6 |
| de los cuales: salud, familia o tiempo | 2 |
| de los cuales: el servicio no estaba disponible donde viven | 1 |
Nota: Contado manualmente a partir del registro de participantes y del último resumen de mediciones, utilizando el evento más avanzado registrado para cada persona. Las 35 personas de la segunda fila son los 35 renglones de la Tabla G1b, y las 24 de la tercera fila son sus primeros 24 renglones. Un artefacto cuenta cuando la persona lo mostró o describió lo que el agente produjo; una persona que produjo un artefacto posteriormente se detuvo (P60) y se cuenta en ambas filas. Las 62 personas restantes, para esa fecha, o bien habían recibido el paso de instalación sin informar su conclusión, o bien aún no habían llegado a él.
Tabla G1a. La cohorte completa por región y país de residencia, y cuántas de cada una cruzaron a un agente el 9 de octubre de 2026.
| Región y país | En la cohorte | Cruzaron a un agente |
|---|---|---|
| América del Norte | 37 | 10 |
| Estados Unidos | 35 | 10 |
| Canadá | 2 | 0 |
| Europa Occidental | 20 | 7 |
| Alemania | 12 | 5 |
| Irlanda | 3 | 1 |
| España | 2 | 1 |
| Reino Unido | 1 | 0 |
| Austria | 1 | 0 |
| Suiza | 1 | 0 |
| Europa Central y Oriental, países mencionados | 9 | 1 |
| Polonia | 3 | 0 |
| Moldavia | 2 | 0 |
| Letonia | 2 | 0 |
| Estonia | 1 | 0 |
| Rumania | 1 | 1 |
| País no divulgado | 53 | 17 |
| Total | 119 | 35 |
Nota: De la columna de país del registro de participantes. "País no divulgado" agrupa a los participantes cuyo país está protegido por la regla de privacidad del estudio y aquellos que no proporcionaron uno.
Lo que las personas hicieron con un agente. La Tabla G1b enumera a todos los que habían cruzado desde un asistente de chat a dirigir un agente el 9 de octubre de 2026, uno por línea: qué tarea le encomendaron y qué produjo. Las personas que produjeron un artefacto o completaron un paso en su propio trabajo aparecen primero, ordenadas aproximadamente por el progreso alcanzado; las que habían instalado el agente y comenzado, sin un resultado reportado aún, siguen. Las profesiones se dan tal como figuran en el registro, en términos neutros. Las breves citas son las propias palabras de los participantes del registro; las marcadas "(traducido)" fueron escritas en otro idioma y se dan en mi traducción literal.
Tabla G1b. Todos los que han cruzado hasta ahora (35 personas, a partir del 9 de octubre de 2026).
| # | Participante | Profesión | País o región | Lo que hicieron con un agente | Con sus propias palabras |
|---|---|---|---|---|---|
| 1 | P20 | procesamiento de imágenes, retoque, fotografía | no divulgado | El agente preguntó sobre sus objetivos y construyó un plan mensual como carpetas y archivos (semanas por tema, un archivo de referencia, un rastreador); luego lo registró en nueve servicios de IA controlando el navegador y registró el único rechazo en su archivo de progreso; pasó una pregunta a través de 11 IA web y escribió resultados y limitaciones en un archivo; en sus propias fotografías de stock produjo un CSV de metadatos en un comando y lo verificó | - |
| 2 | P73 | negocio de ventas de lentes de contacto | Irlanda | Instaló un segundo agente de otro proveedor; ambos leyeron una copia de su propio plan de redes sociales y ella mantuvo una página de los puntos en los que diferían; escribió un archivo de reglas para cada agente y terminó con un archivo léame y un registro de trabajo | "Puedo continuar el entrenamiento." |
| 3 | P48 | trabajo de oficina y ventas en línea | no revelado | Convirtió un documento que escribe cada semana en una plantilla con una lista de verificación y escribió el siguiente más rápidamente; un segundo trabajador lee sus borradores sin información; hizo que dos IAs leyeran toda una carpeta de casos y decidió por sí misma los tres hallazgos más costosos | "The question which AI is better is malformed." (translated) |
| 4 | P44 | marketing, ventas y consultoría | no revelado | Creó botones de escritorio que ejecutan tareas de agentes ("estado del proyecto", "inventario de nuevos elementos", "resumen del documento", "nota en el archivo"); instaló un segundo agente en otra suscripción y ejecutó una revisión conjunta de una tarea: un archivo de resumen más dos revisiones completas | - |
| 5 | P21 | organización comunitaria sin fines de lucro | Alemania | Construyó un programa interactivo de un mes de habilidades y hábitos con seguimiento del progreso; hizo que el agente eligiera una dirección de inicio del catálogo y escribiera un plan de cuatro semanas; luego ejecutó tres sesiones de agentes en paralelo: una presentación en minutos y un bot que monitorea listados y envía coincidencias a su messenger | "A tool tailored to your specific needs, rather than scouring the internet for compromises or paid subscriptions." |
| 6 | P05 | asistente de un director, ex programador | Estados Unidos | El agente creó cinco archivos en su máquina: una descripción general y un plan de cuatro semanas por tema; luego envió invitaciones a una lista de 76 contactos a través de una página de mensajería web, haciendo clic por sí mismo, después de un mensaje de prueba a su propio número | "From now on I will divide different daily tasks between them and really compare the results." |
| 7 | P01 | diseñador de interiores y dibujante, en formación | España | Hizo que el agente construyera un archivo de oportunidades de empleo en dos pasadas, la segunda más amplia que la primera; lo comparó con dos informes de otro chatbot, acuerdos y divergencias separados; reescribió su CV y portafolio a partir de una lectura honesta de sus propios archivos y revisó su perfil profesional | "When it can dig in so deeply and create interesting but in general separate data to analyse them." (translated) |
| 8 | P18 | marketing de internet | no revelado | El agente ordenó su escritorio: creó documentos, los clasificó en carpetas, encontró errores y los corrigió; luego configuró alertas de noticias por correo electrónico sobre sus propios temas | "I'd heard about things like this, but seeing it in action really convinced me." |
| 9 | P19 | funcionario de administración pública | no revelado | Corrigió una larga edición de texto de varios libros de su autoría en un solo día; terminó dos proyectos grandes en una semana; ahora está construyendo una colección de complementos para un flujo de trabajo de traducción | "I wrapped up two major projects in just one week... wow." (translated) |
| 10 | P35 | contratos, facturas y documentos aduanales | Estados Unidos | Realizó la primera tarea por voz; el agente limpió la caché de su computadora, cerró aplicaciones y encontró un espacio de cita en un sitio de reservas abriéndolo por sí mismo; propuso una dirección de impresión bajo demanda; ayuda con la documentación de licitaciones; ahora se ejecuta en la terminal | "Yes, it worked, we did it." (translated) |
| 11 | P72 | imágenes de archivo y video hecho con IA | Rumania | Ejecutó una tarea a través de muchas IAs con la herramienta de orquestación, configuró entrada de voz y eligió direcciones de trabajo independiente del catálogo | - |
| 12 | P41 | asistente dental, en licencia parental | Estados Unidos | El agente hizo un cronograma, un plan y borradores; encontró seis copias de su propio instalador y cinco de una suite ofimática en su máquina y eliminó las extras; ella dictó una lección para una clase comunitaria y el agente la escribió, agregó referencias y enlaces, la tradujo y guardó, luego la reelaboró según su indicación | "I am delighted." |
| 13 | P24 | músico y poeta | Alemania | Envió una tarea de imagen a once IAs y guardó los resultados en una carpeta con una página de galería; hizo que el agente construyera el esqueleto de un arreglo musical, lo cual lo decepcionó | "The ethical aspect of authorship remains unresolved for me." |
| 14 | P102 | gestiona una empresa de software | no revelado | Ya trabajaba diariamente en un agente a su llegada; pasó una pregunta a través de 11 IAs (10 respondieron) y envió el archivo de ejecución; ahora está trabajando a través del catálogo de ganancias | - |
| 15 | P40 | ingeniero de investigación y desarrollador web | no revelado | Recorrió el camino como un principiante deliberado: alrededor de cien archivos sueltos en su carpeta de descargas clasificados en carpetas, con capturas de pantalla antes y después; devolvió dos correcciones a los materiales del curso | - |
| 16 | P75 | soporte técnico remoto | no revelado | El agente hizo una carpeta en su escritorio con un plan de lanzamiento para un canal de video musical estacional (nombres, ideas de pistas, títulos, cronograma de publicación); paso terminal realizado | - |
| 17 | P60 | cuidado del hogar | Estados Unidos | Después de un par de preguntas del agente, un plan de un mes dividido en archivos (donantes, finanzas, plantillas de cartas); luego se fue, encontrando que el marco de principiante era demasiado básico | - |
| 18 | P64 | servicio público uniformado, logística y suministro | no revelado | Hizo un plan de un mes con el agente, que creó los archivos en su computadora; se registró en diez servicios de IA | "AI adapts to the person. It flatters, in a certain sense." (translated) |
| 19 | P28 | servicio público uniformado | no revelado | El agente presentó caminos de carrera desde su puesto actual y, cuando rechazó uno, un plan de desarrollo para su oficio anterior, reparación de relojes (habilidades, certificación, taller propio) | - |
| 20 | P14 | escalador industrial | Estados Unidos | Construyó "Reflex Square", un pequeño entrenador de velocidad de reacción, con el agente por sugerencia del propio agente durante la configuración | "For now, coding in Code is not something I need in my everyday life." |
| 21 | P67 | entrenador de natación, también ventas directas | no revelado | Le dijo al agente que había comenzado en ventas directas; este le ofreció cinco tipos de ayuda y redactó una tarjeta de producto de muestra | - |
| 22 | P12 | estudiante | Alemania | Se registró en los servicios de IA gratuitos, ejecutó la carpeta de orquestación y con el agente eligió cuatro direcciones del catálogo (periodismo, un libro, monetización, profundizar en IA); le dará sus propios ensayos | - |
| 23 | P71 | abogacía y salud pública | Germany | Escribió su propia instrucción; el agente la acortó e hizo que otras IAs crearan las imágenes; realizó el paso de terminal y una tarea de prueba adicional propia para recordar las pulsaciones de teclado | "Tarea completada, envía la siguiente." |
| 24 | P22 | organización comunitaria sin ánimo de lucro | no revelado | Realizó la tarea de catálogo en el agente (algunos sitios bloquearon su inicio de sesión); realizó el paso de terminal y luego pidió al agente que explicara qué se había hecho; configuró alertas de noticias por correo electrónico | "Hecho, ¿qué sigue?" (traducido) |
| 25 | P59 | videógrafo | United States | Proporcionó al agente un resumen detallado para encontrar listados de propiedades rentables en su mercado local (verificaciones, sin gastos, ordenados por ganancia); resultados aún no mostrados | "¿Por qué necesito un segundo si el primero funciona?" |
| 26 | P84 | no indicado | no revelado | Instaló el agente a través del terminal él mismo; construyendo un sitio web para una organización comunitaria | "Haciendo algo, pero creo que deberíamos hablar." (traducido) |
| 27 | P66 | administrador en una instalación de ocio | no revelado | Compró una computadora portátil para el curso, instaló el agente y pasó del modo general a la pestaña del agente; en el paso de abrir cuentas en diez IAs | "Todo está en un idioma extranjero, ¿qué sigue?" (traducido) |
| 28 | P82 | trabajo de seguridad; construcción de un servicio de despacho para transporte | United States | Instalado; trasladó sus chats y proyectos de otro chatbot para comparar los dos | - |
| 29 | P70 | investigación y edición de video para redes sociales | United States | Logró que el agente funcionara con la ayuda de un compañero de cuarto, después de crear primero un archivo de prueba manualmente | - |
| 30 | P17 | abogado de derecho internacional | no revelado | Instalación completada; primera tarea enviada | "Hice todo." (traducido) |
| 31 | P93 | profesional de apoyo directo en cuidado de personas mayores | no revelado | Se trasladó del chat simple al agente y pagó; primera tarea enviada | - |
| 32 | P54 | hace pasteles por encargo | no revelado | Instaló y pagó en una computadora portátil nueva; primera tarea enviada | - |
| 33 | P26 | construcción de hormigón | United States | Lo instaló en una computadora portátil reparada y envió una foto de ella; primera tarea enviada | "¿Qué sigue?" |
| 34 | P03 | director de una empresa de comercio exterior | United States | Se instaló junto con P35; primera tarea enviada | - |
| 35 | P45 | contenido de fotografía y video, experiencia en programación | Germany | Alcanzó el paso de abrir cuentas en diez IAs, lo que presupone un agente funcionando; detalles no registrados | - |
Nota: Compilado del registro de participantes. Las filas 1 a 24 son la tercera fila de la Tabla G1; las filas 25 a 35 habían instalado el agente y comenzaron sin un resultado reportado antes del 9 de octubre de 2026. "-" significa que el registro no contiene palabras utilizables del participante para este período.
Cómo hablan los recién llegados sobre la dirección de agentes. Las personas que hace pocas semanas solo habían usado un asistente de chat describen su nuevo trabajo con palabras propias. Recogí cada pasaje que el registro de participantes y las notas de observación diaria proporcionan en la propia redacción de un participante para las 35 personas que instalaron un agente (161 pasajes de 32 personas, aproximadamente 1.070 palabras) y conté, haciendo coincidir raíces de palabras, las palabras para el sistema que dirigen, para lo que hacen con él y para sí mismos; los recuentos son aproximados, e "it" incluye algunos usos que no se refieren a la herramienta.
Tabla G1c. Palabras que los recién llegados usan para dirigir agentes (apariciones en sus propios informes).
| Lo que la palabra nombra | Palabras, traducidas en categorías | Recuento |
|---|---|---|
| El sistema que dirigen | "it" | 35 |
| un nombre de modelo o producto (Claude, GPT, Codex y otros) | 16 | |
| herramienta, programa, aplicación | 11 | |
| "IA", "las IAs" | 9 | |
| agente | 1 | |
| asistente, ayudante, trabajador | 0 | |
| Lo que hacen con él | configurar, instalar, ejecutar | 10 |
| pedir, cuestionar, solicitar | 9 | |
| tarea, instrucción, indicador | 7 | |
| verificar, comparar | 4 | |
| dividir, entregar | 2 | |
| Ellos mismos | desarrollador, principiante | 5 |
Algunas de sus propias palabras (citas en inglés; las marcadas "(traducido)" fueron escritas en otro idioma y la traducción es mía):
- "No solo responde preguntas sino que puede trabajar realmente con archivos y documentos." (P18, marketing por internet)
- "Uno de los errores más grandes al usar IA es asumir que una respuesta confiada es automáticamente correcta." (P20, fotógrafo y retocador; traducido)
- "Realmente me siento como un desarrollador ahora." (P21, organización comunitaria sin ánimo de lucro)
- "Para obtener lo que quiero, necesito pensar en cómo formular la solicitud." (P48, trabajo de oficina y ventas en línea; traducido)
- "Creo que la respuesta es como una pregunta a dos personas." (P59, videógrafo)
- "A veces una IA da el mejor consejo, otras veces es lo contrario." (P48, trabajo de oficina y ventas en línea; traducido)
Tres pasajes más largos muestran el movimiento en la voz de los participantes. Un diseñador de interiores en capacitación, en su primera noche con un agente, antes de que alguien le mostrara un consejo de modelos: "hizo una carpeta también funcionó bien por sí solo como con documentos abiertos [...] y al final obtuve dos archivos llamados vacantes de este, vacantes de ese, y también los volví a tomar, los envié uno al otro para que evaluaran el trabajo del otro" (P01, traducido, de una transcripción automática de un mensaje de voz). Un escalador industrial, el día que construyó su primer programa pequeño con un agente, ya pidiendo el siguiente rol: "tal vez aprender cómo construir agentes que pudieran hacer parte del trabajo para mí - publicar en redes sociales, recordarme cosas, o darme sugerencias." (P14). Y un participante en trabajo comunitario sin ánimo de lucro, después de sus primeras semanas: "Siento un vasto potencial nuevo abriéndose - como estar en el umbral de algo nuevo." (P21).
Nombran el sistema por su nombre de producto o simplemente "it", casi nunca "agent", y ninguno de los títulos del mapa de la Sección 3 aparece; sin embargo, hablan de establecer tareas, comparar dos respuestas y verificar una confiable, que es el trabajo que la medida cuantifica. Como en el mapa, la función llega antes de un nombre para ella, y esto se ofrece como una descripción, no como prueba de ninguna afirmación.
Las mismas personas también participan en un programa separadamente preregistrado (OSF, DOI 10.17605/OSF.IO/X4EGQ), cuyos resultados se reportan allí.
G2. El estudio de calificadores de Prolific: ¿están de acuerdo los profesionales en las horas de referencia?
La medida dimensiona cada pieza de trabajo en horas de referencia, y la regla de la Sección 5.2 pide a dos especialistas que califiquen una pieza a ciegas y llama a un tercero cuando sus estimaciones difieren por más de un factor de 1.5. El estudio de calificadores pregunta si los profesionales en activo están de acuerdo tan estrechamente. Fue registrado en OSF como un pre-piloto el 9 de octubre de 2026, antes de que se recopilaran datos (DOI 10.17605/OSF.IO/V92R8), y se lanzó en Prolific el mismo día.
Diseño. Dos muestras independientes, 119 participantes reclutados y pagados en total: 60 contables (puesto actual contador, contable, contador colegiado o certificado, auditor o especialista en impuestos) y 59 desarrolladores web y de software (puesto actual ingeniero de software, desarrollador de software o desarrollador web). Todos viven en el Reino Unido, los Estados Unidos, Irlanda, Canadá, Australia o Nueva Zelanda, tienen una tasa de aprobación de Prolific de al menos 98% en al menos 100 presentaciones anteriores, y participan en un solo estudio. Cada participante califica las diez tareas de su propio dominio del banco de tareas v0 (BK01 a BK10 o WT01 a WT10, conforme se congelaron en pilot/task-bank-v0.csv) en horas de trabajo enfocado para un profesional calificado trabajando solo sin herramientas de IA, califica una tarea nuevamente (BK03 o WT03) como retest, y responde una pregunta de competencia y una verificación de atención. Un participante que falla en cualquiera es excluido y pagado; una estimación que no es un número positivo o excede 2000 horas se descarta.
Medidas de resultado. Primarias: por dominio, la proporción de pares de calificadores, en todas las tareas, cuyas dos estimaciones se encuentran dentro de un factor de 1.5, frente al umbral de 0.70 establecido en el protocolo de calibración. Secundarias: la misma proporción después de eliminar el nivel personal de cada calificador, ICC(2,1) en log horas, la proporción de prueba-reprueba dentro de 1.5, y la estimación mediana de cada tarea contra el peldaño que el banco pretendía. Para comparación, los cuatro calificadores modelo del Apéndice E colocan 56% de sus pares en estas 20 tareas dentro de 1.5: 47% en las diez tareas de contabilidad y 65% en las diez tareas web. El análisis es el script human_raters.py, presentado con el registro de OSF antes de los datos, y el resultado se reporta sin importar cuál sea.
Resultados.
Cribado. Los participantes fueron admitidos según la ocupación en su perfil de Prolific, y la mayoría de las respuestas en los filtros de Prolific son autoinformadas (Prolific, 2026), por lo que la pregunta de competencia fue la única verificación del oficio en el diseño. En la muestra de contabilidad fue una pregunta de opción múltiple sobre la partida doble para un pago de cliente recibido en el banco. De las 60 personas admitidas en esa muestra, 11 (18%) respondieron incorrectamente, ocho de ellas invirtiendo el débito y el crédito, y ninguno falló la verificación de atención; conforme se registró, fueron excluidos de los resultados que se indican a continuación y fueron pagados. En una comparación que no fue registrada, estas 11 calificaron las tareas más grandes del banco con menos horas que los otros participantes de la muestra: sus medianas para las tres tareas destinadas al peldaño de Week (BK08 a BK10) fueron 6, 6 y 8 horas, contra 8, 8 y 12 para los otros 49. Con 11 personas esto es una pista a probar, no una estimación, y la prisa o una pregunta mal leída dejaría un rastro similar; es coherente con la idea de que una persona que no conoce un oficio no ve todos los pasos de sus tareas más grandes (Sección 6.5). En la muestra de web-tools la misma comparación no se repitió: los 8 desarrolladores que fallaron su pregunta de competencia proporcionaron medianas de 24.5, 27.5 y 19 horas para las tres tareas destinadas a Week, contra 20, 16 y 20 de los otros 50, por lo que la pista recae solo en contabilidad (análisis exploratorios a continuación).
Los scripts para esta sección están en el repositorio complementario (pilot/). prolific_to_long.py escribe el archivo largo de calificaciones desde las exportaciones de Prolific; lee cada estimación como está escrita, mantiene una respuesta sin número o con varios, como un rango, como texto de modo que la regla registrada la descarte, y lista toda respuesta que no sea un número simple. table_g2.py imprime la Tabla G2 usando las funciones del script registrado sin cambios, junto con los calificadores modelo en las mismas tareas. screen_compare.py recomputa la comparación del cribado anterior, con el intervalo exacto y una prueba de permutación entre los calificadores para las tareas de Week.
Acuerdo. Los puestos se cubrieron el 9 y 10 de octubre de 2026, y 118 participantes dejaron respuestas, 60 contables y 58 desarrolladores; las respuestas de un desarrollador, cuyo envío fue aprobado y pagado, no fueron guardadas por la herramienta de encuesta. Después de las exclusiones registradas (11 contables y 8 desarrolladores fallaron la pregunta de competencia; ningún participante falló la prueba de atención), permanecen 49 contables y 50 desarrolladores. El umbral registrado no se cumplió en ninguno de los dominios: el 28% de los pares de contables y el 25% de los pares de desarrolladores se encuentran dentro de una proporción de 1,5, frente al 0,70 (Tabla G3). Los profesionales ordenaron las tareas de manera consistente, con las medianas de cada dominio aumentando de las tareas destinadas a Hour a las destinadas a Week, pero discreparon en las horas más de lo que la regla de dos evaluadores permite. Eliminar el nivel individual de cada evaluador solo aumentó la proporción al 34% y 35%, por lo que el desacuerdo se debe al trabajo en sí, no a un hábito de redondeo hacia arriba o hacia abajo. ICC(2,1) en horas logarítmicas fue de 0,34 para contabilidad y 0,46 para herramientas web, y las dos estimaciones de un evaluador para la misma tarea estuvieron de acuerdo dentro de 1,5 en el 53% y 74% de los casos. Los cuatro evaluadores de modelo del Apéndice E, al 56% en las mismas 20 tareas, estuvieron más de acuerdo entre sí que los profesionales, lo que dice más sobre la dispersión de los profesionales que sobre la precisión de los modelos. Frente a los profesionales, el banco se sitúa aproximadamente un escalón arriba: cada tarea destinada a Day tenía una mediana de 2 a 7 horas, lo que es Hour, y cada tarea destinada a Week una mediana de 8 a 20 horas, lo que es Day. En la comparación exploratoria anterior, los 11 contables excluidos estuvieron de acuerdo entre sí no mejor que los otros (28% de pares dentro de 1,5). Los resultados establecen tres partes de la regla del evaluador. Los evaluadores se calibran en tareas con tiempos medidos, lo que ancla el nivel que las medianas muestran que está desajustado. Una pieza se dimensiona por la mediana de un panel en lugar de por dos evaluadores, ya que una dispersión de este ancho enviaría la mayoría de pares a un tercer evaluador. Y el banco de tareas se re-clasifica a partir de las medianas de los profesionales, lo que mueve sus tareas un escalón hacia abajo (Tabla G3b).
Tabla G2. Acuerdo de profesionales sobre horas de referencia, por dominio.
| Dominio | Retenidos | Excluidos | Pares dentro de 1,5 | Después de eliminar el nivel del evaluador | ICC(2,1), horas logarítmicas | Test-retest dentro de 1,5 |
|---|---|---|---|---|---|---|
| Contabilidad | 49 | 11 | 0,283 | 0,335 | 0,335 (49 completos) | 0,531 (n = 49) |
| Herramientas web | 50 | 8 | 0,247 | 0,349 | 0,461 (49 completos) | 0,735 (n = 49) |
Nota: Umbral registrado para pares dentro de 1,5: 0,70, no cumplido en ninguno de los dominios. Las exclusiones son fallos de la pregunta de competencia; ningún participante falló la prueba de atención. Los pares se toman sobre las diez tareas de un dominio (11,760 para contabilidad, 11,809 para herramientas web). Test-retest compara las dos estimaciones de un evaluador de BK03 o WT03. Salida de human_raters.py como se registró (DOI 10.17605/OSF.IO/V92R8).
Tabla G3b. Estimación mediana de cada tarea frente al escalón previsto por el banco (horas).
| Escalón previsto | Tarea de contabilidad: mediana | Escalón de la mediana | Tarea de herramientas web: mediana | Escalón de la mediana |
|---|---|---|---|---|
| Hour | BK01: 2,0; BK02: 2,0; BK03: 1,5 | Hour | WT01: 1,0; WT02: 1,0; WT03: 2,0 | Hour |
| Day | BK04: 3,0; BK05: 2,0; BK06: 3,0; BK07: 4,0 | Hour | WT04: 7,0; WT05: 6,0; WT06: 4,0; WT07: 4,0 | Hour |
| Week | BK08: 8,0; BK09: 8,0; BK10: 12,0 | Day | WT08: 20,0; WT09: 16,0; WT10: 20,0 | Day |
Nota: Medianas sobre los evaluadores retenidos. Una mediana por debajo de 8 horas cae en Hour y una de 8 a menos de 40 horas cae en Day. Cada tarea destinada a Day o Week desciende un escalón.
Análisis exploratorios. Los análisis en este párrafo no fueron registrados. Reutilizan el cargador, exclusiones y prueba registrados, y su script y resultado son pilot/exploratory_prolific.py y pilot/results/prolific-2026-10/exploratory-output.txt en el repositorio complementario. El remuestreo de evaluadores coloca intervalos del 95% de 0.24 a 0.33 (contabilidad) y de 0.21 a 0.29 (herramientas web) en la proporción principal. Tamaño del panel (Tabla G4). Para cada tarea, se extrajeron dos paneles disjuntos de k evaluadores conservados 2,000 veces y se compararon sus medianas. En las estimaciones brutas, las dos medianas estuvieron de acuerdo dentro de 1.5 en al menos el 70% de los sorteos solo a partir de 15 contadores o 21 desarrolladores por panel. Con el nivel personal de cada evaluador eliminado, que es lo que la calibración en tareas con tiempos medidos está destinada a hacer, los paneles de siete alcanzaron 0.71 y 0.69, y los paneles de nueve 0.77 y 0.76. Aterrizar en el mismo escalón, que es lo que mide el registro, necesita menos: cinco evaluadores calibrados por panel lo hicieron en 0.81 y 0.84 de los sorteos. Según la regla de dos evaluadores de la Sección 5.2, se llamaría a un tercer evaluador en el 72% y 75% de las piezas. Experiencia (Tabla G4b). 43 de los 98 evaluadores conservados con respuestas completas reportaron más de 10 años en su campo. Estuvieron de acuerdo entre sí no más estrechamente que los demás, y los años en el campo no predijeron qué tan lejos se sentaba un evaluador de la mediana de los otros (correlación de rango +0.18 y -0.10, permutación p = 0.21 y 0.47). Los desarrolladores senior estimaron más alto que otros desarrolladores (1.32 contra 0.76 veces la mediana de los otros, p = 0.02); los contadores senior no (1.04 contra 1.07, p = 0.88). Tareas. El desacuerdo crece con el tamaño: cinco de las seis tareas más disputadas de las 20 tareas fueron tareas destinadas para Semana, donde el 24% (contabilidad) y 20% (herramientas web) de los pares estaban dentro de 1.5, contra 31% y 27% en las tareas destinadas para Hora; el rango intercuartílico de una tarea de Semana abarcaba un factor de 4 a 8. Velocidad y unidades. El cuarto más rápido de los contadores (3.6 minutos o menos para la encuesta completa) estuvo de acuerdo más estrechamente que el resto (0.37 contra 0.26), y entre los desarrolladores la velocidad no marcó diferencia (0.24 contra 0.24). Responder algunas tareas en minutos en lugar de horas no marcó diferencia en ninguno de los dominios (0.31 contra 0.31; 0.28 contra 0.31). Dos contadores dedicaron 40 horas o más a una tarea destinada para Hora, que parece minutos escritos como horas; sin ellos, la proporción de contabilidad es 0.284. Un desarrollador conservado escribió texto en lugar de números, por lo que solo una de sus estimaciones entró en el análisis. Selección. Comparando las estimaciones de cada evaluador para las tareas de Semana con sus propias estimaciones para las tareas de Hora, de modo que un nivel personal se cancele, los contadores excluidos calificaron las tareas más grandes 3.2 veces las más pequeñas contra 6.2 veces para los conservados (permutación p = 0.10), y los desarrolladores excluidos 15.8 veces contra 10.6 (p = 0.37). Reprueba. La estimación repetida fue más alta que la primera para 25 contadores y más baja para 4, y más alta para 17 desarrolladores y más baja para 2 (prueba de signo exacto p < 0.001 en ambos), aproximadamente 30% en la media geométrica, lo que es consistente con el anclaje en las tareas más grandes calificadas en el medio. En conjunto, estos resultados sitúan la dispersión en el trabajo y su escala en lugar de en un subgrupo de evaluadores apresurados, junior o no calificados, y dimensionan el panel que la regla necesita: evaluadores calibrados, de cinco a nueve por pieza, puntuados por escalón (Tabla G4).
Tabla G4. Dos paneles independientes de k evaluadores por tarea: proporción de sorteos cuyas medianas concuerdan dentro de 1.5 / proporción en el mismo escalón (exploratorio).
| Evaluadores por panel | Contabilidad, bruto | Contabilidad, nivel eliminado | Herramientas web, bruto | Herramientas web, nivel eliminado |
|---|---|---|---|---|
| 1 | 0.28 / 0.51 | 0.34 / 0.62 | 0.24 / 0.46 | 0.34 / 0.60 |
| 3 | 0.43 / 0.68 | 0.51 / 0.76 | 0.37 / 0.60 | 0.52 / 0.78 |
| 5 | 0.51 / 0.77 | 0.63 / 0.81 | 0.43 / 0.68 | 0.62 / 0.84 |
| 7 | 0.58 / 0.82 | 0.71 / 0.84 | 0.49 / 0.74 | 0.69 / 0.87 |
| 9 | 0.62 / 0.85 | 0.77 / 0.87 | 0.54 / 0.78 | 0.76 / 0.89 |
| 15 | 0.71 / 0.88 | 0.88 / 0.91 | 0.64 / 0.84 | 0.86 / 0.94 |
| 21 | 0.76 / 0.89 | 0.94 / 0.95 | 0.72 / 0.84 | 0.92 / 0.98 |
Nota: Evaluadores conservados con las diez estimaciones completas (49 por dominio); 2,000 sorteos por tarea, paneles disjuntos dentro de un sorteo; semilla 20261011. Nivel eliminado: se resta en la muestra la razón media logarítmica de cada evaluador a la mediana de todos los evaluadores en cada tarea, como en el resultado secundario registrado, por lo que estas columnas son una estimación superior de lo que la calibración en tareas de anclaje separadas daría. No registrado; salida de pilot/exploratory_prolific.py.
Tabla G4b. Años en el campo y acuerdo (evaluadores conservados con respuestas completas, exploratorio).
| Dominio | Grupo | Evaluadores | Pares dentro de 1.5 dentro del grupo | Nivel contra la mediana de los otros |
|---|---|---|---|---|
| Contabilidad | Más de 10 años | 23 | 0.268 | 1.04 |
| Contabilidad | 10 años o menos | 26 | 0.299 | 1.07 (p = 0.88) |
| Herramientas web | Más de 10 años | 20 | 0.297 | 1.32 |
| Herramientas web | 10 años o menos | 29 | 0.242 | 0.76 (p = 0.02) |
Nota: El nivel es la razón media geométrica de las estimaciones de un evaluador a la mediana de otros evaluadores en las mismas tareas; p es una prueba de permutación bilateral (5,000 permutaciones) de la diferencia en el nivel logarítmico medio. No registrado.
Cómo citar
Chernets, V. (2026). After the Programmer Divide: One Measure for People Who Build Through AI Agents [Preimpresión]. SSRN. https://doi.org/10.2139/ssrn.7589918
@misc{chernets2026aftertheprogrammerdivide,
  author       = {Chernets, Vadym},
  title        = {{After the Programmer Divide: One Measure for People Who Build Through AI Agents}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7589918},
  url          = {https://doi.org/10.2139/ssrn.7589918}
}