Як вимірювати продуктивність AI за перевіреною роботою, а не токенами
Це переклад. Основна версія — оригінал англійською; посилайтеся на неї.
Якщо ви виконуєте реальну роботу, доручаючи її агентам AI (Claude Code, Codex, Cursor та подібні), жодна посадова назва, диплом чи рядок резюме не показує, що ви можете надійно виконати. Цифра, яку багато роботодавців розглядали у 2026 році — скільки токенів спалює людина — показує навіть менше. Delegation Horizon - це безкоштовний інструмент з відкритим кодом, який перетворює простий журнал роботи, яку ви передаєте агентам AI, в один датований рядок:
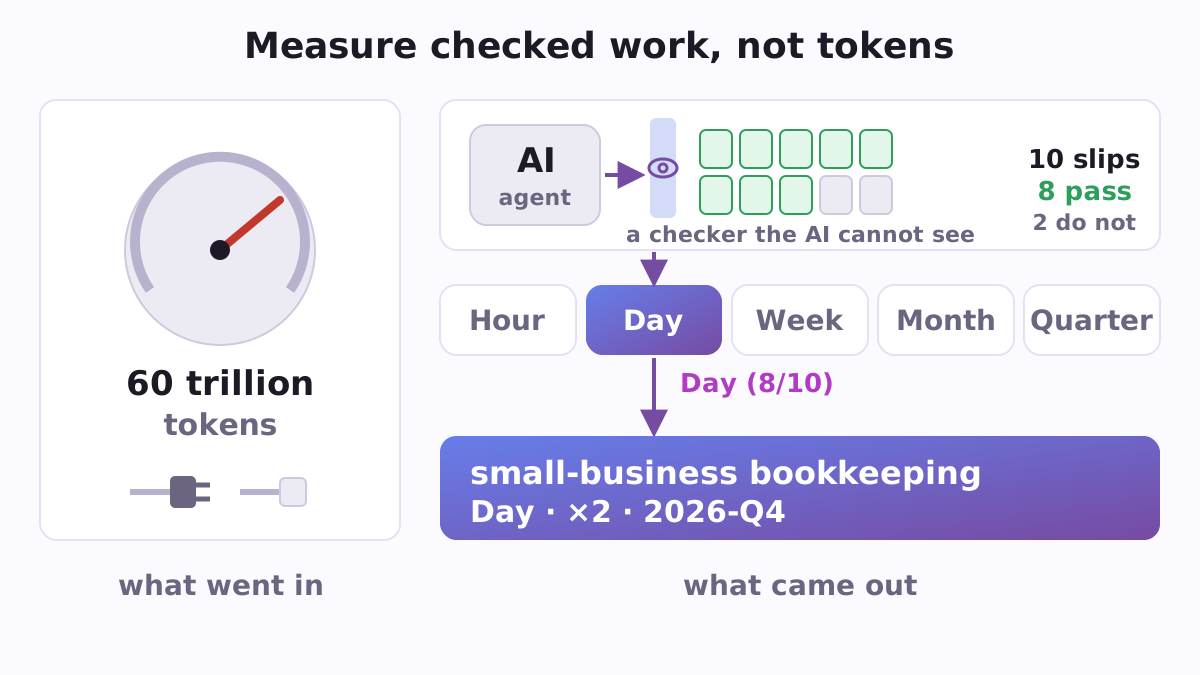
small-business bookkeeping · Day · ×2 · 2026-Q4Це означає: у бухгалтерії малого бізнесу ця людина регулярно передає агентам ШІ фрагменти роботи, які спеціаліст виконував би вручну приблизно день, а перевірка, яку агенти не бачили, їх підтверджує; на кожну годину власної уваги припадає принаймні дві години перевіреної роботи; оцінено у четвертому кварталі 2026 року. Ви зберігаєте журнал у будь-якій електронній таблиці, а оцінка розраховується на вашому комп'ютері за допомогою невеликого скрипту Python або веб-сторінки, яка працює в автономному режимі. Немає облікового запису, немає ключа, нічого не потрібно платити, і журнал ніколи не залишає ваш комп'ютер.
Чому підрахунок токенів виявився невдалим
У 2026 році кілька великих компаній намагалися оцінити, наскільки добре штат користується ШІ, за кількістю використаного ШІ, тренду, яку преса назвала tokenmaxxing. У Meta рейтинг, побудований працівниками і названий Claudeonomics, зафіксував 60 трильйонів токенів за 30 днів серед понад 85,000 співробітників (Shopifreaks). У Amazon "співробітники створювали агентів ШІ для виконання непотрібних завдань у спробі підвищити свої результати", і трекер був знятий з мережі (CIO). У вересні Meta заявила, що "не буде використовувати панелі впровадження ШІ або підрахунок токенів для оцінки впливу" (CIO).
Підрахунок токенів вимірює те, що потрапило, а не те, що вийшло; DORA, дослідницька програма Google Cloud, називає це "суто мірою вводу" (DORA). Однак у опитуванні LeadDev 2026 року 58% респондентів сказали, що їхня організація все ще вимірює вплив ШІ за допомогою використання токенів, тоді як лише 19% назвали це ефективним (LeadDev). Delegation Horizon замість цього підраховує результат у будь-якій професії.
Два числа і одна лінія
Кожна одиниця роботи, яку ви передаєте агентам, стає одним рядком у логу: її поле, скільки часу потрібно було б кваліфікованому фахівцю, щоб зробити її вручну (її «орієнтовні години»), скільки хвилин вашої власної уваги це потребувало, яку перевірку вона пройшла, та чи вона пройшла.
- Верифікований горизонт делегування — це найбільший обсяг роботи, яку ви регулярно передаєте агентам і яка підтверджується перевіркою, яку вони не бачили. Він має п'ять рівнів: Hour, Day, Week, Month та Quarter (1, 8, 40, 160 та 500 орієнтовних годин). Hour та Day потребують десяти завдань такого розміру за останні 91 день; Week потребує шести за 182 дні; Month шести за рік; Quarter трьох за рік. Бухгалтер та розробник стикаються з тим самим правилом.
- Коефіцієнт посилення — це перевірені орієнтовні години на годину вашої уваги за останні 91 день, невдачі у тому числі, показано в кроках ×1, ×2, ×5, ×20 та ×60.
Обидва показники ведуться за полями, тому одна й та ж особа може бути на рівні Week у фінансових інструментах та на рівні Day у веб-додатках. Обидва мають дату: рівень отримується знову кожного кварталу, і від Week та вище одна з його одиниць має бути з останніх 91 днів.
Що вважається перевіреним
Щонайменше вісім з кожних десяти частин розміру ступеня мають пройти одну з чотирьох видів перевірки: приховані тести, кваліфікований експерт, реальне використання людьми, для яких це призначено, або модель з іншої сім'ї ШІ, що перевіряє проти джерел, які ви самі відкрили. Ваш власний огляд та узгодження між моделями однієї сім'ї записуються, але ніколи не враховуються. Невдалі та залишені частини залишаються в журналі та враховуються проти вас, так само як частина, з якою хтось допомагав поза журналом, частина, чия пізніша перевірка не пройшла, та результат, який було пізніше відкликано. Частина, помилки якої не можна виправити, як-от відправлені гроші, має пройти, а модель з іншої сім'ї ШІ ніколи недостатня для її перевірки самостійно. Від Тижня і вище, навмисні помилки закладаються щонайменше в одне завдання перед передачею; їх виявлення показує, що ви справді перевіряєте, а пропущена блокує Тиждень і вище.
Суворість має причину: люди погано оцінюють власну швидкість роботи зі ШІ. У дослідженні METR 2025 року 16 досвідчених розробників працювали на 19% довше з інструментами ШІ, проте пізніше "вони все ще вважали, що ШІ пришвидшив їх на 20%" (METR).
Відпрацьований приклад
Сховище містить журнал вигаданого бухгалтера P07: десять завдань, кожне на день спеціаліста чи більше, передані агентам з липня по вересень 2026. Оцінено 9 жовтня 2026:
P07: small-business bookkeeping . Day (8/10) . x2 . 2026-Q4  (pieces in last 91 days: 10, not verified: 2; gain 4.66; directive share 20%)
  checks: expert 4, hidden_tests 3, self_review 1, real_use 1, other_family_with_sources 1; median accepted size 9.0 h
Вісім з десяти пройшли, саме те, що потрібно Day; один матеріал перевірений лише на основі власного огляду бухгалтера, а один не пройшов перевірку експерта. Вісім перевірених матеріалів складають 80 еталонних годин проти приблизно 17,2 годин уваги на всіх десяти, прибуток 4,66, що припадає на крок ×2. Якби бухгалтер видалив невдалий матеріал, журнал виглядав би краще, а результат був би гіршим: сходинка спиралася б на дев'ять матеріалів, не мала б числа десяти та впадала б нижче Hour, тоді як прибуток стрибнув би на ×5. Кожен, хто отримує запис, видить це одразу, тому що перепідрахунок на дату карти більше не збігається. Ось чому невдачі повинні бути в записі.
Для людей, які будують через агентів
record_card.pyчитає вашу таблицю й виводить рядок та коротку карточку: щабель, кількість, що його підтримує ("8 з 10 елементів розміру Day перевірено в його 91-денному вікні"), користь та види перевірки.--format mdстворює карточку для профілю або електронного листа роботодавцеві;--format recordвиводить лише рядок для резюме.tools/explain.py(нове у версії 1.1.0) говорить вам, чому ваш журнал заробив щабель, який він має: яка умова виконується або не виконується і який елемент це вирішує, скільки ще помилок може витримати щабель, день, коли щабель закінчиться, якщо ви не додасте нічого нового, та що все ще потребує наступний щабель. Він також показує, як мало доводять десять елементів самі по собі: вісім з десяти підходять до будь-якого істинного рівня проходження від близько 44% до 97%.checker.htmlвиконує те саме оцінювання в браузері в режимі офлайн; тест порівнює його з Python оцінювачем на розроблених прикладах та 40 випадкових журналах. Обидва читають таблицю, збережену з крапками з комами, десятковими комами та датами у форматі день.місяць.рік, як це роблять європейські таблиці.tools/log_piece.pyбудує рядок журналу, задаючи вам запитання. Якщо ви працюєте у Claude Code, готовий гак (невеликий скрипт, який Claude Code запускає при подіїї) відкриває очікуючий запис щоразу, коли сеанс агента завершується, тому елемент, що не пройшов, ніколи не забувається. Він не читає стенограму та не надсилає нічого ніде; будь-який інструмент агента, який може запустити команду в кінці сеансу, може його використовувати.tools/planted.pyзапечатує ваш список посаджених помилок відбитком пальця перед передачею та оцінює його потім, неправильні записи та упущені речи розраховуються окремо, та відмовляється від списку, зміненого після запечатування.
Для четвертого виду перевірки, інша сім'я ШІ, яка читає ваші джерела, Sidecall передає фрагмент роботи іншим інструментам ШІ на вашому комп'ютері.
Для менеджерів та HR
kits/ai-usage-in-reviews.md — це готова політика для AI в оцінках ефективності роботи. Замість токенів або витрат вона запитує про прийняті шматки роботи з перевіркою для кожної; замість «користується AI щодня» — про найбільший шматок роботи, переданий агентам і перевірений минулого кварталу. Його розмова огляду має три питання, починаючи з: який найбільший шматок роботи ви передали агентам цього кварталу і показали, що він правильний, і як?
Команда веде один журнал із вигаданою міткою для кожної людини (оцінювач не приймає невідомі стовпці, тому реальні імена не можуть закрастися); examples/team-log.csv показує чотирьох людей у п'яти полях. Кожен квартал record_card.py друкує карту на людину та поле. Щоб перевірити один, tools/verify_record.py бере запис і журнал і говорить поле за полем, чи журнал це файл, який був оцінений, чи оцінювач той же, і чи запис той же при перерахунку. audit_sample.py витягує випадкову вибірку для перевірки на основі слова, яке другий перевіривач обирає після отримання журналу, щоб ніхто не міг вгадати, які шматки будуть витягнуті, і tools/too_clean.py позначає журнали, які виглядають занадто добре: без помилок, розміри майже не змінюються, кожен шматок перевірений одним способом.
Контрольні години встановлюються поза командою: з банку завдань або двома оцінювачами, які не знають, чия це робота. tools/reference_hours.py бере їх оцінки і дає їхнє геометричне середнє, коли вони в межах 1,5 разів один від одного, або викликає третього оцінювача; kits/reference-hours-raters.md говорить, як їх вибрати та провести брифінг.
Щоб найняти на основі перевіреної роботи, а не диплома, kits/hiring-test/ проводить оплачувану однодневну робочу тестування в галузі кандидата, з прихованою перевіркою, спеціально розташованими помилками та оцінювачем, який не бачив CV. kits/trade-screen.md додає запитання спеціальності перед допуском, оскільки профіль або назва посади говорять менше, ніж видається: з 60 осіб, яких фільтри платформи опитування допустили як бухгалтерів, 11 дали неправильну відповідь на таке запитання, восьмеро з них поміняли дебет та кредит місцями.
Що показав перший тест з людьми
Найслабшою ланкою будь-якої оцінки в «годинах фахівця» є сама оцінка, тому її першою й тестували. У жовтні 2026 року попередній пілот на Prolific, зареєстрований на OSF перед надходженням будь-яких даних, залучив 119 працюючих бухгалтерів та веб-розробників оцінити, скільки часу кожне з десяти завдань тривало б при ручному виконанні. Два оцінювачі, вибрані випадково, збігалися в межах коефіцієнта 1,5 лише в 28% випадків у бухгалтерії та 25% у веб-роботі, порівняно з 70%, які передбачав план. Завдання, розраховані на тиждень роботи, отримали медіанні оцінки від 8 до 20 годин, а те ж саме завдання, поставлене знову в кінці, отримало вищу оцінку набагато частіше, ніж нижчу.
Наслідок для будь-кого, хто користується інструментом: припущення двох незнайомців занадто варіативні, щоб оцінити розмір роботи. Медіани більших панелей швидко стабілізуються; дві окремі панелі з 15 бухгалтерів або 21 веб-розробника збігалися в межах коефіцієнта 1,5 принаймні в 70% вибірок. Отже, еталонні години походять з банку завдань із виміреними часами або від панелі, а анонімізовані дані, зареєстрований аналіз та дослідницький аналіз знаходяться в pilot/ для переробки будь-ким.
Для дослідників
METR вимірює моделі ШІ за часовим горизонтом: довжину завдання в експертних годинах, яку модель надійно завершує. Delegation Horizon ставить те саме питання людині, і його частка «вісім з десяти» відображає 80% горизонт METR. Попередній пілот на змодельованих логах налагодив правила (версія 1.1), попередній пілот Prolific вище протестував еталонні години, і протокол, чернетка попередної реєстрації та форма інформованої згоди повного пілота з людьми знаходяться в pilot/. kits/process-vs-experience-study.md і kits/matched-task-study.md — це готові протоколи для порівняння груп на одних і тих же завданнях, і tools/power.py говорить, скільки людей потребує таке дослідження.
Стаття, що лежить в основі інструменту, також робить датовані, перевіряні прогнози. У дослідженні Anthropic приблизно 400 000 сеансів Claude Code сеанси, які видали код, завершилися перевіреним успіхом у 34% випадків для людей у сфері розробки ПО та у 29% для всіх інших (Anthropic). Сорок один прогноз був зареєстрований на OSF 9 жовтня 2026 року, кожен з імовірністю, серед них — що 80% горизонт METR для найкращої публічної моделі досягне тривалості робочого дня до кінця 2027 року (0.80) та що менше ніж два роботодавці Fortune 500 використовуватимуть підрахунок токенів як офіційний критерій оцінки протягом 2027 року (0.80). Тест показує, що кожен зареєстрований файл все ще є побайтово ідентичним поданому, і brier.py, predictions/score.py та predictions/skill.py оцінюють їх щороку; дослідження, яке ніколи не проводилось, вважається збоєм, а не мовчазно виключається.
Як почати
Вам потрібен Python 3.9 або новіший та нічого більше.
- Завантажте репозиторій з сторінки GitHub (Code, потім Download ZIP) або клонуйте його.
- Відкрийте
templates/work-log.csvу будь-якій електронній таблиці (Excel, Numbers, LibreOffice, Google Sheets) і додайте один рядок на кожне завдання, яке ви передали агентам: прийнята, відхилена або скасована.templates/README.mdпояснює кожен стовпець простою мовою, іexamples/c4-log.csv— це заповнений журнал для копіювання. - Збережіть як CSV і запустіть картку, або двічі клацніть
checker.html, якщо ви надаєте перевагу браузеру.
git clone https://github.com/vadimchernets/delegation-horizon
cd delegation-horizon
python3 record_card.py examples/c4-log.csv --as-of 2026-10-09
python3 record_card.py my-log.csv --format md --out card.md
python3 tools/explain.py my-log.csv
Звідки це походить
Delegation Horizon — супровідний код статті After the Programmer Divide: One Measure for People Who Build Through AI Agents Vadym Chernets (жовтень 2026, SSRN 7589918, DOI 10.2139/ssrn.7589918). Поточний випуск 1.1.0 від 11 жовтня 2026 р. тестується під час кожного коміту на Python 3.9–3.13. Код розповсюджується під ліцензією MIT і архівується на Zenodo (DOI 10.5281/zenodo.23267444, що завжди указує на найновіший випуск); все розташоване на github.com/vadimchernets/delegation-horizon. Більш ранна стаття того ж автора, After Chat, досліджує, чому так мало людей перейшло від спілкування зі штучним інтелектом до того, щоб дозволити агентам працювати за них; її код, After Chat, ставить одне питання кільком ШІ і показує, де вони не згідні.
Переглянути delegation-horizon на GitHub
Vadym Chernets також розробляє Poly A1, додаток, у якому штучні інтелекти різних компаній перевіряють роботу один одного.