Como Medir Produtividade em IA por Trabalho Verificado, Não por Tokens
Esta é uma tradução. A versão de referência é o original em inglês; cite essa.
Se você realiza trabalho de verdade entregando-o a agentes de IA (Claude Code, Codex, Cursor e similares), nenhum título de cargo, diploma ou linha de currículo mostra o que você pode ser confiado para entregar. O número que muitos empregadores buscaram em 2026, quantos tokens uma pessoa queima, mostra ainda menos. Delegation Horizon é uma ferramenta gratuita e de código aberto que transforma um simples registro do trabalho que você entrega a agentes de IA em uma linha datada:
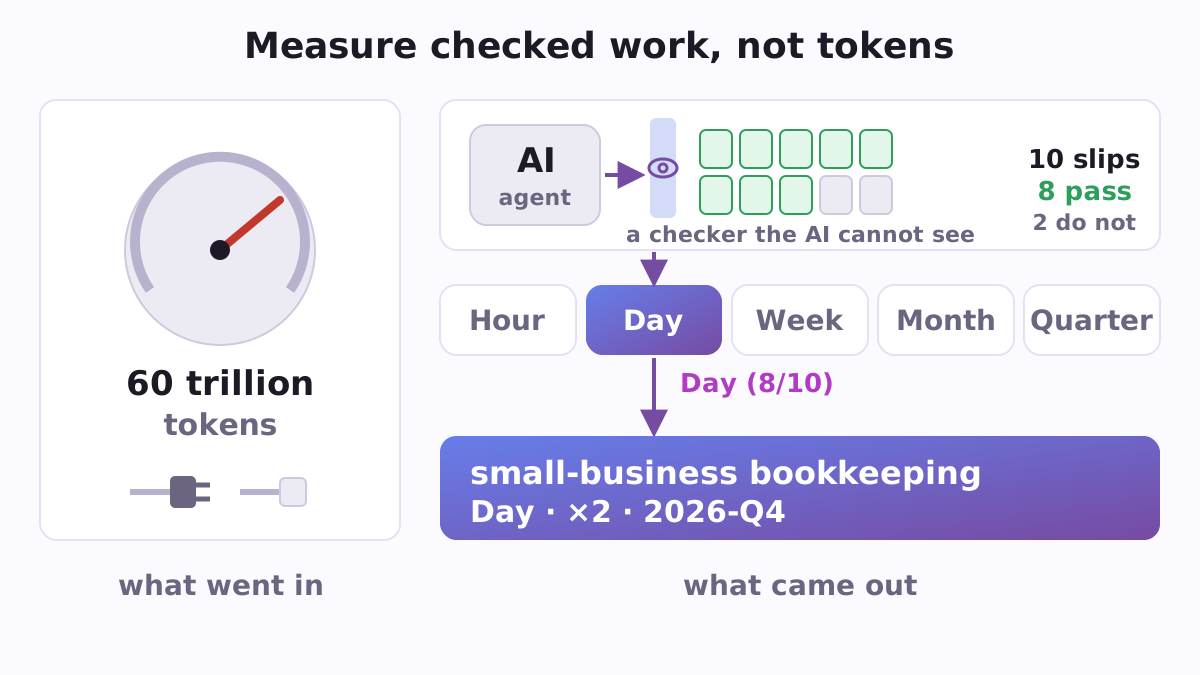
small-business bookkeeping · Day · ×2 · 2026-Q4Diz-se: em contabilidade de pequenas empresas, essa pessoa regularmente passa a agentes de IA trabalhos que levaria um especialista cerca de um dia de trabalho manual, e uma verificação que os agentes nunca viram os confirma; cada hora de sua atenção produz pelo menos duas horas de trabalho verificado; medido no quarto trimestre de 2026. Você mantém o registro em qualquer planilha, e a pontuação é calculada em seu próprio computador, por um pequeno script Python ou por uma página web que funciona offline. Sem conta, sem chave, nada a pagar, e o registro nunca sai do seu computador.
Por que a contagem de tokens falhou
Em 2026, várias grandes empresas tentaram medir o quão bem os funcionários usavam IA pela quantidade de IA que usavam, uma tendência que a imprensa chamou de tokenmaxxing. Na Meta, um placar construído por funcionários apelidado de Claudeonomics registrou 60 trilhões de tokens em 30 dias entre mais de 85.000 funcionários (Shopifreaks). Na Amazon, "funcionários estavam criando agentes de IA para executar tarefas desnecessárias na tentativa de aumentar suas pontuações", e o rastreador foi desativado (CIO). Em setembro, a Meta afirmou que "não usará painéis de adoção de IA ou contagens de tokens para avaliar impacto" (CIO).
Uma contagem de tokens mede o que entrou, não o que saiu; DORA, o programa de pesquisa do Google Cloud, a chama de "puramente uma medida de entrada" (DORA). No entanto, na pesquisa de 2026 da LeadDev, 58% dos respondentes disseram que sua organização ainda mede o impacto da IA pelo uso de tokens, enquanto apenas 19% a chamaram de eficaz (LeadDev). Delegation Horizon conta a saída em vez disso, em qualquer profissão.
Dois números e uma linha
Cada trabalho que você entrega aos agentes se torna uma linha do log: seu campo, quanto tempo um especialista qualificado levaria para fazê-lo manualmente (suas "horas de referência"), quantos minutos de sua própria atenção levou, que verificação o trabalho passou por e se foi aprovado.
- O horizonte de delegação verificado é o maior tamanho de trabalho que você regularmente entrega aos agentes e é confirmado por uma verificação que eles não viram. Possui cinco degraus: Hora, Dia, Semana, Mês e Trimestre (1, 8, 40, 160 e 500 horas de referência). Hora e Dia precisam de dez peças desse tamanho nos últimos 91 dias; Semana precisa de seis em 182 dias; Mês seis em um ano; Trimestre três em um ano. Um guarda-livros e um desenvolvedor enfrentam a mesma regra.
- O ganho de amplificação é horas de referência verificadas por hora de sua atenção nos últimos 91 dias, falhas incluídas, mostrado em passos de ×1, ×2, ×5, ×20 e ×60.
Ambos são mantidos por campo, então a mesma pessoa pode estar em Semana em ferramentas financeiras e em Dia em aplicações web. Ambos carregam uma data: um degrau é conquistado novamente a cada trimestre, e a partir de Semana para cima uma de suas peças deve vir dos últimos 91 dias.
O que conta como verificado
Pelo menos oito em cada dez peças do tamanho de um degrau devem passar por um de quatro tipos de verificação: testes ocultos, um especialista qualificado, uso real pelas pessoas para as quais o trabalho é feito, ou um modelo de outra família de IA verificando contra fontes que você abriu. Sua própria revisão e concordância entre modelos da mesma família são registradas mas nunca contam. Peças falhadas e abandonadas permanecem no registro e contam contra você, assim como uma peça com a qual alguém ajudou fora do registro, uma peça cuja auditoria posterior falhou e um resultado que foi posteriormente retirado. Uma peça cujos erros não podem ser desfeitos, como dinheiro enviado, deve passar, e outra família de IA nunca é suficiente por si só para verificá-la. A partir de Week, erros deliberados são plantados em pelo menos uma tarefa antes da entrega; detectá-los mostra que você realmente verifica, e deixar passar um bloqueia Week e acima.
O rigor tem uma razão: as pessoas julgam mal sua própria velocidade com IA. Em um estudo da METR de 2025, 16 desenvolvedores experientes levaram 19% mais tempo com ferramentas de IA, mas depois ainda acreditavam que "a IA os havia acelerado em 20%" (METR).
Um exemplo prático
O repositório inclui o registro de um guarda-livros fictício, P07: dez trabalhos, cada um com um dia ou mais de um especialista, entregues a agentes entre julho e setembro de 2026. Avaliado em 9 de outubro de 2026:
P07: small-business bookkeeping . Day (8/10) . x2 . 2026-Q4  (pieces in last 91 days: 10, not verified: 2; gain 4.66; directive share 20%)
  checks: expert 4, hidden_tests 3, self_review 1, real_use 1, other_family_with_sources 1; median accepted size 9.0 h
Oito de dez foram aprovados, exatamente o que Day precisa; uma peça foi verificada apenas pela revisão do próprio contador e uma falhou na verificação de um especialista. As oito peças verificadas somam 80 horas de referência em contraste com cerca de 17,2 horas de atenção em todos os dez, um ganho de 4,66, que cai na etapa ×2. Se o contador tivesse excluído a peça rejeitada, o registro pareceria melhor e teria uma pontuação pior: o degrau repousaria em nove peças, perderia a contagem de dez e cairia abaixo de Hour, enquanto o ganho saltaria para ×5. Qualquer pessoa que receba o registro o vê imediatamente, porque uma reavaliação na data do cartão não corresponde mais. É por isso que as falhas pertencem ao registro.
Para pessoas que criam por meio de agentes
record_card.pylê sua planilha e imprime a linha e um cartão resumido: o degrau, a contagem por trás dele ("8 de 10 peças de tamanho Day verificadas em sua janela de 91 dias"), o ganho e os tipos de verificação.--format mdcria um cartão para um perfil ou um e-mail para um empregador;--format recordimprime apenas a linha para um currículo.tools/explain.py(novo na versão 1.1.0) diz por que seu registro obtém o degrau que consegue: qual condição se mantém ou falha e qual peça a decide, quantas falhas a mais o degrau pode suportar, o dia em que vence se você não registrar nada novo e o que o próximo degrau ainda precisa. Também mostra como dez peças provam pouco por si só: oito de dez se ajustam a qualquer taxa de aprovação verdadeira de aproximadamente 44% a 97%.checker.htmlfaz a mesma pontuação em um navegador, offline; um teste a compara com o avaliador de Python no exemplo resolvido e 40 registros aleatórios. Ambos leem uma planilha salva com ponto-e-vírgula, vírgulas decimais e datas dia.mês.ano, como as planilhas europeias as salvam.tools/log_piece.pyconstrói uma linha de registro fazendo perguntas a você. Se você trabalha em Claude Code, um hook pronto (um pequeno script que Claude Code executa em um evento) abre uma entrada pendente sempre que uma sessão de agente termina, para que uma peça com falha nunca seja esquecida. Não lê nenhuma transcrição e não envia nada para lugar nenhum; qualquer ferramenta de agente que possa executar um comando no final de uma sessão pode usá-la.tools/planted.pysela sua lista de erros plantados com uma impressão digital antes da entrega e a pontua depois, entradas incorretas e coisas omitidas contadas em separado, e recusa uma lista alterada após a selagem.
Para o quarto tipo de verificação, outra família de IA lendo suas fontes, Sidecall coloca um pedaço de trabalho nas outras ferramentas de IA do seu computador.
Para gerentes e RH
kits/ai-usage-in-reviews.md é uma política pronta para IA em avaliações de desempenho. Em vez de tokens ou gasto, solicita peças de trabalho aceitas com verificação de cada uma; em vez de "usa IA diariamente", a maior peça entregue aos agentes e verificada no trimestre passado. Sua conversa de revisão tem três perguntas, começando com: qual é a maior peça de trabalho que você entregou aos agentes neste trimestre e mostrou estar correta, e como?
Uma equipe mantém um log com um rótulo fictício por pessoa (o avaliador recusa colunas desconhecidas, então nomes reais não podem se infiltrar); examples/team-log.csv mostra quatro pessoas em cinco campos. A cada trimestre record_card.py imprime um cartão por pessoa e campo. Para verificar um, tools/verify_record.py pega o registro e o log e diz, campo por campo, se o log é o arquivo que foi pontuado, o avaliador é o mesmo e o registro é o mesmo quando reavaliado. audit_sample.py extrai uma amostra aleatória para verificação a partir de uma palavra que o segundo verificador escolhe após receber o log, para que ninguém possa adivinhar quais peças serão extraídas, e tools/too_clean.py marca logs que parecem muito bons: sem falhas, tamanhos que variam pouco, todas as peças verificadas da mesma forma.
As horas de referência são definidas fora da equipe: de um banco de tarefas ou por dois avaliadores que não sabem de quem é o trabalho. tools/reference_hours.py pega suas estimativas e fornece sua média geométrica quando uma está dentro de 1,5 vezes da outra, ou chama um terceiro avaliador; kits/reference-hours-raters.md diz como escolhê-los e instruí-los.
Para contratar por trabalho verificado em vez de por diploma, kits/hiring-test/ realiza um teste de trabalho remunerado de um dia no próprio campo do candidato, com uma verificação oculta, erros plantados e um avaliador que não viu o CV. kits/trade-screen.md adiciona uma pergunta de primeira semana da profissão antes de qualquer pessoa ser admitida, pois um perfil ou cargo diz menos do que parece: das 60 pessoas que os filtros de uma plataforma de pesquisa admitiram como contadores, 11 erraram tal pergunta, oito deles trocando débito e crédito.
O que o primeiro teste com pessoas descobriu
O elo mais fraco de qualquer medida em "horas de um especialista" é a própria estimativa, portanto foi testado primeiro. Em outubro de 2026, um pré-piloto no Prolific, registrado no OSF antes de qualquer dado chegar, pagou 119 guarda-livros e desenvolvedores web em atividade para estimar quanto tempo cada uma das dez tarefas levaria à mão. Dois avaliadores selecionados aleatoriamente ficaram dentro de um fator de 1,5 um do outro apenas 28% das vezes em contabilidade e 25% no trabalho web, em contraste com os 70% que o plano estabeleceu. Tarefas planejadas como uma semana de trabalho receberam estimativas medianas de 8 a 20 horas, e a mesma tarefa solicitada novamente no final resultou em estimativas mais altas muito mais frequentemente do que em estimativas mais baixas.
O que se segue para quem usar a ferramenta: as estimativas de dois desconhecidos são muito ruidosas para dimensionar uma tarefa. As medianas de painéis maiores se estabilizam rapidamente; dois painéis separados de 15 guarda-livros ou 21 desenvolvedores web concordaram dentro de um fator de 1,5 em pelo menos 70% dos casos. Portanto, as horas de referência vêm de um banco de tarefas com tempos medidos ou de um painel, e os dados anonimizados, a análise registrada e a exploratória estão todos em pilot/ para qualquer pessoa reexecutar.
Para pesquisadores
O METR mede modelos de IA por um horizonte de tempo: a duração da tarefa, em horas de especialista, que um modelo completa de forma confiável. O Delegation Horizon pergunta o mesmo a uma pessoa, e sua taxa de oito em dez espelha o horizonte de 80% do METR. Um pré-piloto de mesa com registros simulados ajustou as regras (versão 1.1), o pré-piloto Prolific acima testou as horas de referência, e o protocolo, rascunho de pré-registro e formulário de consentimento do piloto completo com pessoas estão em pilot/. kits/process-vs-experience-study.md e kits/matched-task-study.md são protocolos prontos para comparar grupos nas mesmas tarefas, e tools/power.py diz quantas pessoas tal estudo necessita.
O artigo que fundamenta a ferramenta também faz apostas datadas e verificáveis. No estudo da Anthropic com cerca de 400,000 sessões do Claude Code, as sessões que produziram código terminaram em sucesso verificado 34% das vezes para pessoas em profissões de software e 29% para todos os outros (Anthropic). Quarenta e uma previsões foram registradas em OSF em 9 de outubro de 2026, cada uma com uma probabilidade, entre elas que o horizonte de 80% do METR para o melhor modelo público alcance um dia de trabalho até o final de 2027 (0.80) e que menos de dois empregadores da Fortune 500 usem contagens de token como critério oficial de avaliação durante 2027 (0.80). Um teste mostra que todo arquivo registrado ainda é byte para byte o que foi arquivado, e brier.py, predictions/score.py e predictions/skill.py os pontuam a cada ano; um estudo que nunca é executado é contado como uma falha, não silenciosamente descartado.
Como começar
Você precisa de Python 3.9 ou mais recente e nada mais.
- Baixe o repositório de a página do GitHub (Code, then Download ZIP) ou clone-o.
- Abra
templates/work-log.csvem qualquer planilha (Excel, Numbers, LibreOffice, Google Sheets) e adicione uma linha por cada trabalho que você atribuiu aos agentes: aceito, rejeitado ou abandonado.templates/README.mdexplica cada coluna em palavras simples, eexamples/c4-log.csvé um registro preenchido para copiar. - Salve-o como CSV e execute o card, ou clique duas vezes em
checker.htmlse você preferir um navegador.
git clone https://github.com/vadimchernets/delegation-horizon
cd delegation-horizon
python3 record_card.py examples/c4-log.csv --as-of 2026-10-09
python3 record_card.py my-log.csv --format md --out card.md
python3 tools/explain.py my-log.csv
De onde vem
Delegation Horizon é o código complementar do artigo After the Programmer Divide: One Measure for People Who Build Through AI Agents de Vadym Chernets (outubro de 2026, SSRN 7589918, DOI 10.2139/ssrn.7589918). A versão atual, 1.1.0, de 11 de outubro de 2026, é testada a cada push em Python 3.9 a 3.13. O código está sob a licença MIT e arquivado no Zenodo (DOI 10.5281/zenodo.23267444, que sempre aponta para a versão mais recente); tudo está em github.com/vadimchernets/delegation-horizon. Um artigo anterior do mesmo autor, After Chat, questiona por que tão poucas pessoas passaram de conversar com IA para deixar agentes trabalharem para elas; seu código, After Chat, faz uma pergunta a vários IAs e mostra onde discordam.
Ver delegation-horizon no GitHub
Vadym Chernets também constrói Poly A1, um aplicativo no qual IAs de diferentes empresas verificam o trabalho um do outro.