After Chat: As Três Transições Entre Não-Programadores e IA Agentiva
Esta é uma tradução. A versão de referência é o original em inglês; cite essa.
O terminal não é mais um terminal: um modelo de quatro níveis, a evidência de 2025 e 2026 e um programa pré-registrado para medir as travessias
Vadym Chernets, PhD, arquiteto de sistemas de IA · ORCID 0009-0007-4845-3163
SSRN 7520019 · DOI 10.2139/ssrn.7520019 · Zenodo 10.5281/zenodo.22943313 · GitHub
Baixe este artigo
- SSRN (versão de registro): ssrn.com/abstract=7520019 · DOI 10.2139/ssrn.7520019
- Zenodo (arquivado, acesso aberto): doi.org/10.5281/zenodo.22943313
- GitHub (texto completo como Markdown e PDF): github.com/vadimchernets/papers/tree/main/after-chat; código: github.com/vadimchernets/after-chat
O mesmo texto está em três lugares para que possa ser acessado quando um deles não conseguir servi-lo. SSRN mantém a versão de registro; cite essa.
Palavras-chave: IA agentiva; agentes de IA; não-programadores; programação do usuário final; alfabetização em IA; trabalhadores do conhecimento; adoção de tecnologia; adoção de IA generativa; supervisão humana; delegação; divisão digital de segundo nível; erros correlacionados; ironias da automação; desqualificação; pré-registro
Resumo
A maioria dos profissionais conhece IA como um chatbot, enquanto os mesmos modelos, como agentes de IA, agora atuam em arquivos e programas. Questiono por que tão poucos não-programadores passaram do chat para IA agencial, e como medir essa transição. A resposta repousa em um modelo de quatro níveis definido por alcance e função e independente de produtos: chat, um ambiente agencial seguro limitado ao fornecedor, um agente no próprio computador da pessoa, e trabalho repetível orquestrado entre vários modelos. Uma transição conta apenas quando um agente produziu um artefato que a pessoa pediu. Instalar software conta como uma tentativa. Evidências de 2025 a setembro de 2026 indicam que a barreira para instalação e para uma primeira tentativa limitada caiu, enquanto a confiabilidade em trabalhos inteiros, a estabilidade do produto e a segurança de pastas não. Instalação é um passo, o próprio chatbot da pessoa pode orientá-lo ("integração reflexiva"), e dois fornecedores uniram as interfaces de agente e chat em 2026. Um número de um fornecedor relatado pela imprensa coloca trabalhadores do conhecimento em um quinto dos cinco milhões de usuários semanais do seu agente de codificação; mede o uso de um agente de herança terminal, não adoção de nível 3 conforme definido aqui. O uso permanece amplo e superficial: cerca de metade dos trabalhadores dos EUA usa IA, cerca de um em sete diariamente, e poucos para automação. A barreira moveu-se de instalar para direcionar. Baseando-me em pesquisa de programação do usuário final, nomeio o vocabulário de fluxo de trabalho de capacidade ausente e estabeleço o trabalho do gerente como um contrato de delegação: objetivo, limite, artefato e verificação. Orquestração web (uma pergunta para vários chatbots) é proposta como a ponte que ensina comparação, e orquestração CLI (um agente chamando outros) como a camada durável, limitada pelo fato de que o acordo de modelos correlacionados é evidência fraca. O artigo encerra com quinze proposições falsificáveis, o design de um programa de coorte pré-registrado sem seus resultados, e código aberto de ensino.
Resumo Executivo
O terminal, a janela preta que representava tudo o que não programadores não conseguiam fazer com IA, mudou seu significado. Agora é o lugar na máquina própria de uma pessoa onde um agente trabalha, e a habilidade que exige não é mais digitar comandos. A habilidade é gerenciar o trabalhador que os digita.
Desenvolvedores profissionais estão mais avançados: 90% de mais de 15.000 entrevistados em 2026 usaram ferramentas agênticas pelo menos semanalmente (uma pesquisa de fornecedor), embora o uso semanal ainda não seja a competência do gerenciador da Seção 8. Todos os outros ainda estão principalmente conversando com um chatbot. 52% dos trabalhadores dos EUA usam IA em sua função, 15% diariamente, e 16% desses usuários nomeiam automação entre seus usos.
A razão não é mais que agentes sejam difíceis de instalar. Instalar um requer um comando ou um clique, o chatbot que uma pessoa já usa pode orientá-los através disso, e os fornecedores começaram a mesclar chat com agentes. O que permanece difícil é de natureza diferente. Agentes ainda falham em tarefas completas, o produto que uma pessoa aprende pode ser renomeado ou descontinuado dentro de um ano, e uma pasta concedida ainda precisa ser protegida. Após o instalador, a primeira coisa que impede as pessoas é que elas não sabem o que entregar ou como verificar, a lacuna que a Seção 1 chama de vocabulário de fluxo de trabalho. Atrás disso vêm o primeiro erro, permissões e segurança, regras organizacionais, hardware e custo, e a competência para julgar resultados.
O modelo tem quatro níveis, ordenados por quão longe o modelo chega e pelo que a pessoa deve fazer: conversa, um espaço cercado que o fornecedor executa, o próprio computador da pessoa, e trabalho direcionado entre vários modelos. As pessoas podem pular um nível. Um cruzamento é mostrado apenas por um artefato que o agente produziu, de modo que instalações, crachás e autorrelato não contam.
Orquestração, enviar uma pergunta para vários modelos, vem em duas camadas. No navegador não custa nada tentar e ensina o hábito de comparar respostas, e na linha de comando pode ser escrito e executado novamente. Em ambos, o que importa é o número de famílias de modelos questionadas, porque erros correlacionados limitam o que a concordância vale.
Gerenciar agentes é uma competência em si. Ela tem um contrato de delegação em quatro partes (objetivo, limite, artefato, verificação), quatro práticas (delegar, supervisionar, verificar, revogar), uma regra de parada para revisões, e um registro de aceitação que separa o que o agente produziu do que a pessoa confiou.
O argumento é construído para ser testado. Quinze proposições carregam medidas e falsificadores. O desenho de um programa de coorte pré-registrado (OSF DOI 10.17605/OSF.IO/X4EGQ) é descrito aqui, e seus resultados serão informados separadamente. Uma tabela de status diz com que firmeza cada reivindicação é mantida, e o código aberto está no Apêndice C.
1. Introdução
Considere uma profissional de escritório em setembro de 2026. Ela usa um chatbot todas as semanas. Pede-lhe para redigir um email, resumir um relatório, sugerir uma fórmula. O que ela recebe é texto, e ela transfere esse texto manualmente para o lugar onde seu trabalho vive: uma pasta de contratos, uma planilha de contas, uma apresentação com prazo para sexta-feira. O mesmo modelo, através de uma porta diferente, pode abrir aquela pasta, ler todos os arquivos nela, escrever a planilha, criar a apresentação e verificar sua própria aritmética. A maioria dos profissionais, tanto quanto as pesquisas da Seção 4.4 conseguem dizer, ainda não usou aquela porta, e muitos não sabem que ela existe.
Por dois anos a porta pareceu um terminal: uma janela preta, um cursor piscante, um comando para colar. Essa imagem está desatualizada. O terminal permaneceu um terminal apenas visualmente. Tornou-se o ambiente em que um agente vive, o lugar na máquina de uma pessoa onde um modelo pode ler, escrever, executar e agendar, e a pessoa em sua frente não precisa mais operar um shell tanto quanto direcionar o agente que o faz. O que muda é o papel humano, de alguém que faz perguntas a um modelo para alguém que gerencia um trabalhador.
Meu assunto é a estrada entre esses dois papéis e quem está nela. Entre desenvolvedores profissionais, as ferramentas, pelo menos, já chegaram. Uma pesquisa com mais de 15.000 desenvolvedores profissionais de maio a julho de 2026 descobriu que 90% usavam agentes de IA para codificação no trabalho pelo menos semanalmente e 68% diariamente, e que a participação usando um agente de terminal, Claude Code, no trabalho aumentou de cerca de 3% na primavera de 2025 para 18% em janeiro de 2026 e 39% até meados de 2026 (JetBrains Research, 2026a, 2026b; uma pesquisa de fornecedor, já que JetBrains vende um agente de codificação). Entre todos os outros não foi, e o padrão de uso é amplo e raso. Nos mesmos meses, 52% dos trabalhadores dos EUA relataram usar IA em sua função, 15% o usavam diariamente, e apenas 16% desses usuários nomearam automação entre seus usos; escrita e busca dominaram (Gallup, 2026). Para o profissional típico a IA ainda é uma conversa, e as figuras do St. Louis Fed dizem o mesmo em um período mais longo: entre agosto de 2024 e maio de 2026 a participação de trabalhadores usando IA generativa para seus trabalhos aumentou de 33% para 45%, enquanto menos de 3% das tarefas tiveram taxas de adoção acima de 50% (Bick et al., 2026).
A explicação padrão da lacuna é dificuldade técnica: agentes são para pessoas que podem programar. Essa resposta era razoável em 2024 e é fraca em 2026. Instalar um agente de terminal agora leva um comando ou um instalador de desktop, e o agente líder envia um aplicativo de desktop cuja documentação diz claramente: "Nenhum terminal necessário" (Anthropic, 2026a). Os fornecedores foram além. OpenAI transformou seu aplicativo de agente de codificação no cliente ChatGPT de desktop padrão em 9 de julho de 2026 e adicionou um agente, ChatGPT Work, que usa arquivos e aplicativos locais (MacRumors, 2026). Anthropic mesclou seu agente de desktop para trabalho de conhecimento, Cowork, na conversa ordinária em 16 de setembro de 2026; TechCrunch relatou a empresa dizendo que clientes "frequentemente lutavam para escolher a guia certa para a tarefa certa" (TechCrunch, 2026a). OpenAI relatou, através da imprensa, que profissionais de conhecimento constituíram cerca de 20% dos cinco milhões de usuários semanais de seu agente de codificação em junho de 2026 e o adotaram mais de três vezes mais rápido que desenvolvedores (Help Net Security, 2026). A figura é relatada pelo fornecedor e direcional, a página própria do fornecedor não foi acessível aos meus controles, e mede o uso do agente de herança de terminal para profissionais de conhecimento, que é mais amplo que adoção de nível 3 conforme definido na Seção 3. É difícil ver onde a barreira técnica está nessa imagem.
A barreira se moveu. Ela se moveu da instalação para o direcionamento: de "como faço isso funcionar?" para "o que peço a ele para fazer, dentro de quais limites, e como saberei que ele fez?" A segunda pergunta é mais difícil do que parece, e a literatura sobre programação do usuário final explica por quê. Não-especialistas lutam para expressar intenção para modelos de linguagem mesmo quando o acesso é gratuito e imediato (Zamfirescu-Pereira et al., 2023), e devem aprender quais fraseados mapeiam o que o sistema pode fazer (Liu et al., 2023). Delegar para uma IA também desloca o trabalho da produção para especificação e verificação (Sarkar & Drosos, 2025; Simkute et al., 2024). Chamo a capacidade faltante vocabulário de fluxo de trabalho: um estoque de trabalho de tarefas que uma pessoa sabe como entregar a um agente, fraseado de modo que o agente possa executá-las e o resultado possa ser verificado. Declarado formalmente, é o mapeamento entre os objetivos de domínio de uma pessoa e as sub-tarefas que um agente pode executar, com as palavras para entradas, transformações, saídas, exceções e evidências que o mapeamento precisa. Um desenvolvedor que abre um agente já sabe as primeiras dez coisas a digitar. Um contador ou um professor geralmente não faz, e ninguém em seu escritório disse-lhes.
A primeira contribuição é um modelo de quatro níveis da estrada do chat para o trabalho agêntico, definido pelo alcance e papel e por nenhum nome de produto. Os níveis vão do chat através de um ambiente agêntico seguro e um agente no próprio computador de alguém até o trabalho orquestrado repetível. Cada um é definido pelo que o agente pode tocar e pelo que a pessoa deve especificar e verificar, e cada transição é definida por um artefato que o agente produziu, e o software instalado sozinho não conta. Como as definições não dependem de nomes de produtos, o modelo sobrevive ao atual hábito dos fornecedores de mesclar seus produtos (Seção 3).
O segundo é uma síntese de evidências para 2025 até setembro de 2026. Mostra que a instalação e uma primeira tentativa limitada se tornaram muito mais fáceis, que os três limites estabelecidos na Seção 4.5 (trabalho confiável em tarefas inteiras, produtos estáveis, pastas seguras) não se moveram com eles, e que o padrão raso de uso persiste. Também localiza as barreiras que permanecem: vocabulário de fluxo de trabalho, o erro que detém um novato, permissão e segurança, regras organizacionais, e a competência para julgar resultados (Seções 4 e 5).
O terceiro é uma análise das duas camadas de orquestração. A orquestração da web, uma pergunta enviada para vários chatbots de consumo, é a ponte: não requer instalação e ensina o hábito de comparação. A orquestração CLI, um agente chamando ferramentas de linha de comando de outros agentes, é a camada de delegação que persiste. Ambas são limitadas por um fato que os usuários tendem a perder, que o acordo entre modelos não é evidência independente (Chernets, 2026a) (Seções 6 e 7).
O quarto é um programa de medição com proposições falseáveis: o projeto de um programa de coorte pré-registrado que acompanha não-programadores através dessas transições (Chernets, 2026d), e um kit de ferramentas de ensino aberto de padrões de orquestração e segurança nos apêndices (Seções 9 e 10, Apêndice C).
Alguns limites de escopo se aplicam por toda parte. "Profissional não programador" significa um profissional cujo trabalho ocorre substancialmente em um computador e que não possui treinamento em scripts ou engenharia de software. Um analista fluente em fórmulas de planilhas conta, um desenvolvedor não conta, e desenvolvedores aparecem aqui como um grupo de comparação. Não relato resultados do programa de coorte; aqueles pertencem a um artigo separado após seu período de observação. A maioria das figuras de adoção vêm dos Estados Unidos e de fornecedores, e são marcadas como tal. E as ferramentas descritas mudam a cada mês, então o modelo é construído para as superar e os detalhes do produto deverão ficar desatualizados.
A Seção 2 coloca o argumento na literatura e a Seção 3 define os níveis e as transições. A Seção 4 mostra para onde a barreira técnica foi, a Seção 5 o que a substituiu, as Seções 6 e 7 as duas formas de orquestração, e a Seção 8 o que a mudança faz ao papel humano. A Seção 9 descreve o programa que mede os cruzamentos, a Seção 10 declara as proposições, a Seção 11 extrai implicações, a Seção 12 estabelece condições de contorno, e a Seção 13 conclui.
2. Antecedentes: da programação por usuários finais para delegação por usuários finais
2.1 Usuários finais sempre programaram
A ideia de que pessoas que não são programadores direcionam a computação é anterior aos modelos de linguagem. Nardi (1993) argumentou que usuários finais comandam poder computacional através de linguagens e estruturas específicas de tarefas, sendo as planilhas o caso canônico, sem necessidade de habilidade de programação geral. Ko et al. (2011) mostraram que usuários finais que constroem software enfrentam os mesmos problemas que profissionais (requisitos, reutilização, testes, depuração) sem o treinamento, e nomearam o campo engenharia de software para usuários finais. O campo mais amplo, desenvolvimento para usuários finais, estuda como pessoas que não são desenvolvedoras profissionais criam e adaptam software para seu próprio trabalho. Myers, Pane e Ko (2004) passaram anos projetando notações mais próximas de como não-programadores descrevem tarefas. Cada uma dessas linhas de trabalho assumiu que o usuário final ainda escreveria algo que a máquina executa, mesmo que esse algo fosse uma fórmula ou uma regra.
Modelos de linguagem mudaram o que o usuário final escreve. Sarkar et al. (2022) descreveram programação com um grande modelo de linguagem como uma nova atividade, distinta de compilação, programação em dupla e busca. Zamfirescu-Pereira et al. (2023) descobriram que pessoas sem expertise em IA têm dificuldade em projetar prompts que funcionem de forma confiável, generalizam excessivamente a partir de sucessos isolados e recorrem a hábitos de conversa humana. Liu et al. (2023) nomearam a dificuldade de aprender quais palavras produzem qual comportamento "correspondência de abstração fundamentada". Sarkar e Drosos (2025), no primeiro estudo empírico de "vibe coding", descobriram que programação conversacional redistribui expertise em direção ao gerenciamento de contexto e verificação rápida de resultados, e deixa a necessidade de julgamento onde estava. Virk e Liu (2025) descobriram que usuários de negócios aos quais foi dado código de análise escrito por IA frequentemente falharam em detectar erros críticos mesmo quando instruídos a procurá-los. Feldman e Anderson (2024) chamaram programadores não-especialistas a população menos estudada da era generativa.
Dou o próximo passo nessa linha. A unidade do trabalho de usuário final mudou de uma fórmula, um script ou um prompt para uma delegação: uma tarefa entregue a um agente que age sobre arquivos e ferramentas ao longo de muitos passos. A literatura sobre programação para usuários finais explica por que expressar intenção é difícil, e a literatura sobre delegação e supervisão explica por que verificar o resultado é difícil. O modelo de quatro níveis da Seção 3 foi construído para unir os dois.
2.2 A adoção é rápida e superficial
A IA generativa se espalhou mais rápido que o computador pessoal ou a internet. Bick, Blandin e Deming (2024) estimaram que cerca de 40% dos adultos em idade ativa dos EUA o usavam até o final de 2024, enquanto apenas uma pequena fração de horas de trabalho foi assistida. Chatterji et al. (2025) descobriram que em meados de 2025 ChatGPT servia cerca de 700 milhões de usuários semanais e que a maioria das mensagens não era relacionada ao trabalho. Na Dinamarca, Humlum e Vestergaard (2025) encontraram efeitos nulos precisos nos ganhos e horas dois anos após a adoção, e uma lacuna no uso entre mulheres e homens; uma meta-análise em mais de 100 países coloca essa lacuna em cerca de 16 pontos percentuais desde o início de 2025 (Cranney et al., 2026). Em 35 países europeus, a exposição à IA não se traduziu automaticamente em uso, e treinamento, digitalização e agência do trabalhador importaram mais (Henseke, 2026).
Experimentos de campo mostram ganhos grandes onde a ferramenta se adequa à tarefa: 14% mais problemas de clientes resolvidos por hora em média e 34% para novatos (Brynjolfsson et al., 2025), escrita mais rápida e melhor em um ensaio com 444 profissionais, com os maiores ganhos para os escritores mais fracos (Noy & Zhang, 2023), e, entre 758 consultores, 12,2% mais tarefas concluídas e qualidade aumentada em mais de 40% dentro da "fronteira irregular" da capacidade do modelo, com pior trabalho em uma tarefa fora dela (Dell'Acqua et al., 2026). Um ensaio randomizado com desenvolvedores de código aberto experientes encontrou o sinal oposto no início de 2025, uma desaceleração de 19% (Becker et al., 2025), um resultado que seus autores depois disseram ser provavelmente desatualizado conforme as ferramentas melhoraram (METR, 2026). A lição desses ensaios é que ganhos dependem do ajuste entre a tarefa, a ferramenta e a capacidade da pessoa em dirigi-la e verificá-la, e essas são as três coisas que uma transição entre níveis muda.
2.3 Aceitação, difusão e a divisão do segundo nível
A pesquisa sobre adoção de tecnologia, desde o modelo de aceitação de tecnologia (Davis, 1989) até a teoria unificada de aceitação e uso de tecnologia (Venkatesh et al., 2003), sustenta que utilidade percebida e facilidade de uso controlam a adoção, e que influência social e condições facilitadoras importam tanto quanto atitudes individuais. A pesquisa de difusão descreve a adoção como um processo social com adotantes iniciais e tardios (Rogers, 2003). Uma vez que o acesso básico à internet se tornou comum, Hargittai (2002) mostrou que a desigualdade significativa se moveu para habilidade: a divisão digital de segundo nível. Van Dijk (2020) estendeu isso para uma sequência de motivação, acesso, habilidades e uso.
A mesma mudança é visível agora. O acesso ao chat é quase universal entre trabalhadores de escritório em países ricos, enquanto a habilidade de direcionar um agente está longe de ser universal. Uma divisão de IA já foi medida ao longo das antigas linhas de educação, região e idade (Daepp & Counts, 2024; Pew Research Center, 2026). O que adiciono é a observação de que a divisão agora ocorre dentro da população de usuários de IA, entre aqueles que conversam com modelos e aqueles que delegam a eles.
2.4 Automação, supervisão e o ônus do gerente
A literatura sobre supervisão humana da automação começa com uma ironia. Bainbridge (1983) descreveu isso: automatizar a maior parte de uma tarefa deixa ao humano o resíduo mais difícil, monitoramento e intervenção rara, enquanto corrói a competência necessária para isso. Parasuraman e Riley (1997) distinguiram uso indevido, desuso e abuso da automação, e Lee e See (2004) demonstraram que a confiança deveria seguir uma confiança calibrada. A era generativa renovou cada ponto. Trabalhadores do conhecimento que confiam mais na ferramenta relatam menos pensamento crítico (Lee et al., 2025). A IA generativa desloca pessoas da produção para a avaliação e torna tarefas fáceis mais fáceis e tarefas difíceis mais difíceis (Simkute et al., 2024). Intervenções para calibrar a confiança em modelos de linguagem reduzem a confiança excessiva sem produzir confiança apropriada (Bo et al., 2025). Usuários de agentes de IA como assistentes diários descalibram a confiança em direção a planos plausíveis mas incorretos, e têm melhor desempenho quando participam da execução passo a passo (He et al., 2025). Históricos melhores do que um agente fez aceleram a detecção de erros sem melhorar confiavelmente a precisão final (Grunde-McLaughlin et al., 2026). Um estudo de cerca de 73.000 posts públicos sobre um agente autônomo descobriu que os valores dos usuários foram na maioria atendidos no que o agente entregou e na maioria não atendidos em como poderiam supervisioná-lo (Ma et al., 2026). Em um pequeno estudo de laboratório e três implantações, o conforto com a delegação cresceu ao longo do tempo enquanto as pessoas ainda queriam controle em momentos de incerteza (Long et al., 2025). Tomašev, Franklin e Osindero (2026) tratam a delegação para IA como uma estrutura de alocação de tarefas, transferência de autoridade, responsabilidade e confiança, aplicável a delegados humanos e de máquina igualmente.
Do lado cognitivo, um estudo de EEG com 54 escritores de ensaios relatou conectividade mais fraca e menor apropriação no grupo assistido, um "débito cognitivo" (Kosmyna et al., 2025), e um comentário publicado contestou seus métodos (Stankovic et al., 2026). A conclusão segura é que descarregar etapas rotineiras libera atenção e que a atenção liberada deve ser gasta em verificação. Duas ideias adicionais da pesquisa em aprendizagem são usadas posteriormente. A teoria da carga cognitiva explica por que um recém-chegado lançado em um ambiente sem limite fica bloqueado antes de um esquema mental ser formado (Sweller, 1988). E um modelo de adoção como aprendizagem bayesiana mostra como as pessoas podem cair em um equilíbrio de baixo uso autorreforçador que apenas um primeiro sucesso ou treinamento pode deslocar (Ma et al., 2025).
Dois artigos complementares desta série abordam o mesmo problema do outro lado. O primeiro mostra que o acordo entre vários modelos é evidência mais fraca do que aparenta, porque seus erros são correlacionados (Chernets, 2026a). O segundo mostra como componentes de supervisão automatizada podem ampliar seu próprio mandato e obstruir o trabalho que guardam (Chernets, 2026b). Ambos importam para um recém-chegado: o primeiro para o que a orquestração pode proporcionar, o segundo para por que camadas de segurança podem barrar uma pessoa na porta.
2.5 O que não foi estudado
Uma busca realizada em 21 de setembro de 2026 (busca na web, Crossref, arXiv e Semantic Scholar, com atenção aos artigos de CHI, UIST e VL/HCC de 2024 a 2026) não encontrou nenhum estudo de campo publicado de não-programadores adotando agentes de terminal ou linha de comando por nome, nenhum estudo de orquestração web (uma pergunta para vários chatbots de consumidor no navegador) como uma prática nomeada, nenhum tratamento de gerenciar agentes como uma habilidade com sua própria estrutura de competência, e nenhum estudo de um sistema de IA estruturando a adoção de uma pessoa de IA agêntica; o trabalho mais próximo aplica teoria de andaimes a tutores de IA de outros assuntos (Cohn et al., 2026) ou a interfaces condicionadas por tarefas para software complexo (Liu & Sra, 2026). O trabalho em economia do trabalho mede a adoção de IA generativa em geral, e nenhum dele isola a etapa de chat para ferramentas agênticas entre não-programadores. Essas lacunas definem o espaço que o modelo mapeia e o programa na Seção 9 é construído para medir.
3. Quatro níveis e três transições
3.1 Dois eixos: alcance e papel
Um nível descreve uma relação entre uma pessoa e um modelo em trabalho, e o defino em dois eixos, alcance e papel.
Alcance é aquilo que o modelo pode tocar em nome da pessoa. No sentido mais restrito, é nada mais que a conversa, depois arquivos e ferramentas dentro de um espaço delimitado pelo fornecedor, depois o próprio computador da pessoa com seus arquivos, programas e cronograma, e no sentido mais amplo vários modelos e agentes simultaneamente.
Papel é aquilo que a pessoa deve fazer para que o trabalho tenha sucesso. Na mesma ordem, pedem e copiam, delegam uma tarefa e revisam o resultado, possuem um ambiente do agente com suas permissões e sua desfazação, ou alocam trabalho entre agentes e reconciliam o que volta.
Produtos estão deliberadamente ausentes da definição. Um único produto pode abranger vários níveis, e em 2026 os fornecedores estão incorporando chat e agentes em uma única janela mais rapidamente do que qualquer taxonomia baseada em nomes de produtos poderia acompanhar (Seção 4.3). Um nível descreve um trecho de trabalho, e uma pessoa, como um produto, pode abranger vários. A mesma pessoa pode estar no nível 1 para uma tarefa pela manhã e no nível 3 para outra à tarde.
Os dois eixos também separam este modelo das escalas familiares de automação e autonomia. Parasuraman, Sheridan e Wickens (2000) classificaram quanto de cada estágio de uma tarefa (adquirir informações, analisá-la, decidir, agir) uma máquina executa. Morris et al. (2024) classificaram sistemas gerais de IA pela profundidade e amplitude de seu desempenho. Feng, McDonald e Zhang (2025) definiram cinco níveis de autonomia para agentes de IA pelo papel que o usuário desempenha, de operador e colaborador para consultor, aprovador e observador. Essas escalas descrevem quanto um agente decide dentro de uma tarefa. Os quatro níveis aqui descrevem onde o trabalho é executado e o que a pessoa possui: uma conversa, um espaço cercado de um fornecedor, sua própria máquina, uma equipe de agentes de vários fornecedores. Os eixos são ortogonais. Um agente no próprio computador de uma pessoa pode ser executado em qualquer um dos níveis de autonomia de Feng et al., desde aprovação passo a passo até delegação quase total, e a pessoa ainda possui suas permissões e sua desfazação. O que os quatro níveis adicionam é uma descrição da adoção: a ordem na qual o alcance e a responsabilidade crescem para alguém que começa em chat, e a evidência (um artefato) que mostra que cada etapa foi tomada.
3.2 Os quatro níveis
Nível 1: chat. O alcance do modelo termina na conversa. Ele produz texto, código ou imagens que a pessoa copia para o lugar onde o trabalho acontece, e o papel da pessoa é fazer boas perguntas e levar o resultado. Quase todo profissional que usa IA trabalha aqui a maior parte do tempo (Seção 2.2).
Nível 2: um ambiente agêntico seguro. O modelo atua em arquivos, serviços conectados e às vezes um navegador, dentro de um espaço delimitado pelo fornecedor: pastas selecionadas, uma máquina virtual ou sandbox do lado do servidor, conectores que a pessoa aprovou, e uma etapa de aprovação antes de ações consequentes. Cowork do Anthropic, ChatGPT Work do OpenAI, Copilot Cowork do Microsoft e Gemini Spark do Google são exemplos de 2026, e eles compartilham o design de um agente de delegação funcionando em um espaço cercado (Anthropic, 2026b; MacRumors, 2026; Microsoft, 2026a; TechCrunch, 2026b). O papel da pessoa muda de fazer perguntas para delegar. Eles delegam uma tarefa que termina em um arquivo ou ação e revisam o que volta, e grande parte da segurança do ambiente, neste nível, é responsabilidade do fornecedor.
Nível 3: um agente no próprio computador. O agente é executado na máquina da pessoa com acesso ao sistema de arquivos, ao shell, programas instalados e trabalhos agendados, por meio de um terminal ou um shell de desktop sobre o mesmo mecanismo: Claude Code, Codex do OpenAI, Antigravity CLI do Google, Grok Build do xAI, Kimi Code do Moonshot e equivalentes de código aberto. Na literatura de pesquisa, estes são agentes baseados em LLM, e seu uso por desenvolvedores é estudado como codificação agêntica; o nível questiona o que acontece quando a pessoa que os executa não é um desenvolvedor. O alcance é o mais amplo que um único agente consegue, e com isso o papel da pessoa muda novamente. Eles possuem o ambiente: quais pastas o agente vê, quais comandos precisam de aprovação, o que é mantido fora e como desfazer um erro. O terminal em si é incidental, pois o que define o nível é a propriedade de um ambiente de trabalho em que um agente pode fazer qualquer coisa que a pessoa pudesse fazer. Variantes hospedadas em nuvem (o mesmo loop de agente executado na máquina de um fornecedor, com a pessoa vendo uma tarefa e um resultado e nunca um prompt) são nível 3 por capacidade e nível 2 por raio de explosão, e o modelo os registra como uma variante do nível 3 sem forçá-los em uma célula.
Nível 4: trabalho orquestrado e repetível. A pessoa dirige vários modelos ou agentes, em paralelo ou em sequência, em trabalho que recorre, e o alcance agora abrange fornecedores. Existem duas camadas. Na orquestração web, uma pergunta vai para vários chatbots de consumidor no navegador, manualmente ou com uma ferramenta, e as respostas são comparadas. Na orquestração CLI, um agente chama ferramentas de linha de comando de outros agentes, coleta seus resultados e os mescla ou verifica. O papel da pessoa é o de um gerente: eles definem o objetivo, alocam o trabalho, decidem o que conta como concluído e reconciliam discordância. O trabalho se torna repetível quando é escrito em uma forma que os agentes podem executar novamente, como um arquivo de instruções, uma habilidade ou um trabalho agendado. "Repetível" descreve o fluxo de trabalho, não o resultado. O mesmo arquivo de instruções executado na próxima semana produzirá um rascunho diferente, e o que se repete é a sequência de entradas, etapas, verificações e entrega. Um trabalho de agente único recorrente escrito desta forma é trabalho de nível 3 tornável repetível, e se torna nível 4 quando uma segunda família de modelos é direcionada e os resultados são reconciliados (transição 3, Seção 3.3).
Tabela 1. Os quatro níveis.
| Nível | Alcance do modelo | Papel da pessoa | Superfícies típicas, setembro de 2026 | O cruzamento é mostrado por | O que o nível não estabelece | Barreira principal na entrada |
|---|---|---|---|---|---|---|
| 1. Chat | A conversa | Pergunta, copia resultado manualmente | Chat em navegador ou aplicativo | (nível de entrada) | Que o modelo pode agir no trabalho da pessoa, ou ser confiável sem verificação | Nenhuma além do acesso |
| 2. Ambiente agêntico seguro | Arquivos, conectores e navegador dentro de um espaço delimitado pelo fornecedor | Delega uma tarefa, revisa o resultado | Cowork merged into Claude chat; ChatGPT Work; Copilot Cowork; Gemini Spark | Um arquivo ou ação produzida pelo agente a partir de uma tarefa delegada, com uma aprovação ou recusa registrada | Que a pessoa possa executar um ambiente próprio ou repetir o trabalho | Saber o que delegar; confiança |
| 3. Agente no computador pessoal | O sistema de arquivos, shell, programas e cronograma da pessoa | É proprietário do ambiente: permissões, exclusões, desfazer | Shells de terminal e desktop de Claude Code, Codex, Antigravity CLI, Grok Build, Kimi Code | Um artefato que o agente produziu na máquina pessoal da pessoa, em uma pasta que a pessoa configurou, a partir de uma tarefa que exigiu mais de um uso de ferramenta | Que o resultado está correto ou é seguro aceitar sem revisão | Fricção de instalação (falha); o primeiro erro; permissões; o que perguntar |
| 4. Trabalho orquestrado | Vários modelos ou agentes entre fornecedores | Gerencia: objetivo, alocação, aceitação, reconciliação | Web: várias abas de chat ou ferramentas de transmissão. CLI: plug-ins e scripts que chamam outros agentes | Um resultado mesclado ou verificado por referência cruzada de pelo menos duas famílias de modelos, reexecutado pelo menos uma vez, com registro de quem foi perguntado e quem respondeu | Que o acordo entre os modelos é evidência independente ou que a tarefa pertence a este nível | Custo da reconciliação; erros correlacionados; variação de cota e ferramenta |
Dois termos na tabela são mais estreitos do que o uso cotidiano. "Seguro" em "ambiente agêntico seguro" nomeia um objetivo de design e um padrão de interação e não oferece nenhuma garantia. O escopo da pasta, aprovações, caixas de areia e painéis de visualização reduzem a área na qual um agente atua; eles não podem fazer uma implementação com bugs preservar arquivos ou tornar um documento com instruções ocultas inofensivo, e a Seção 5.3 relata o que deu errado dentro das pastas concedidas. O que o degrau do meio estabelece é um modelo mental prático. Uma pessoa que vê que o agente pode escrever um relatório em uma pasta e não pode tocar em mais nada aprendeu que a ação delegada tem um perímetro, o que é mais útil do que qualquer aviso abstrato para ter cuidado com IA. "Artefato" significa um entregável que exigiu vários passos do trabalho próprio do agente. A pessoa que o solicitou decide se conta como um artefato, uma terceira parte classifica sua qualidade (Seção 9.4), e um estudo relata concordância entre avaliadores tanto para essa classificação quanto para a codificação de razões de parada. Uma pasta com dois arquivos vazios é um rastro de um instalador e não conta.
3.3 Três transições e por que um artefato define cada uma
Uma transição é ultrapassada quando o agente produziu, no novo nível, um artefato que a pessoa solicitou. Uma instalação conta apenas como uma tentativa, assim como um tutorial concluído, um distintivo, uma licença e o autorrelato "Agora uso agentes". A regra tem várias consequências além da óbvia. Uma pasta criada por um agente mostra que o agente foi executado, enquanto um conjunto de arquivos escrito pelo agente a partir da descrição que a pessoa faz de seu próprio trabalho mostra que a pessoa delegou. A regra também torna as transições observáveis de fora: um pesquisador ou gerente pode ver um artefato e não pode ver uma intenção ou um sentimento de competência. Torna a falha informativa, pois uma pessoa que instalou uma ferramenta e não produziu nada encontrou uma barreira digna de nomeação, e contar a instalação como sucesso a ocultaria. E porque não nomeia nenhum produto, a regra permite que os estudos façam comparações entre ferramentas que são renomeadas a cada trimestre.
A Transição 1, do chat para um ambiente agêntico seguro, é ultrapassada quando uma pessoa delega pela primeira vez uma tarefa que termina em um arquivo ou uma ação em vez de em texto. Em 2026, essa transição está sendo absorvida na própria janela de chat. Quando o modelo do fornecedor decide se deve responder ou agir, como faz na experiência Claude mesclada anunciada em 16 de setembro de 2026 (Anthropic, 2026c), uma pessoa pode ultrapassá-la sem decidir. Isso torna o cruzamento mais fácil e também menos visível, inclusive para a pessoa.
A Transição 2, do ambiente seguro para o próprio computador da pessoa, é ultrapassada quando uma pessoa executa um agente em seu próprio ambiente e recebe um artefato dele. A mudança decisiva é a propriedade. No nível 2, o fornecedor decide o que o agente pode tocar, e no nível 3 a pessoa faz, seja qual for a face que o agente mostre, um terminal ou uma janela. O medo do terminal costumava viver aqui, e a Seção 5 mostra que as questões de permissões, erros e o que perguntar tomaram seu lugar.
A Transição 3, de um agente para o trabalho orquestrado, é ultrapassada quando uma pessoa obtém um resultado que pelo menos duas famílias de modelos produziram ou verificaram, e reexecuta esse arranjo no trabalho posterior. A reexecução importa, porque uma comparação de três chatbots é uma curiosidade, e apenas uma comparação que a pessoa usa sempre que as apostas a justificam é uma prática.
A rota que o programa da Seção 9 segue pode ser percorrida como um design, com a profissional da Introdução como um caso hipotético e nada relatado. Ela começaria onde já está, no nível 1, com um chatbot que ela paga. Ela colaria um texto padrão nesse chatbot e deixaria que o guiasse através da instalação de um agente gráfico em seu próprio laptop, enviando uma captura de tela sempre que uma etapa falhasse, e eu não tocaria em nada. O primeiro passo contaria como ultrapassado apenas quando o agente tivesse produzido, a partir de sua própria descrição de seu trabalho, um conjunto de arquivos que ela pudesse abrir e avaliar; um aplicativo instalado ao lado de uma pasta vazia contaria como uma tentativa. Ela trabalharia em uma cópia de seus arquivos, manteria senhas e documentos de cliente fora disso, leria o plano do agente antes de deixá-lo agir e confirmaria tudo irreversível. Quando dissesse que estava pronta, receberia uma ferramenta de código aberto que coloca uma pergunta para vários modelos através das assinaturas que ela já possui e retorna uma resposta mesclada, lançada de dentro do agente, e esse passo contaria quando uma execução datada mostrasse quais modelos foram perguntados e onde diferiam. Mais tarde, ela executaria a mesma comparação através de ferramentas de linha de comando. Ela poderia parar em qualquer um desses pontos, e o registro registrado manteria onde e, com suas palavras, por quê. A rota é retirada do registro público, e se as pessoas a caminham é uma questão para o artigo de resultados.
3.4 Os níveis são ordenados, não obrigatórios
Os níveis são ordenados por alcance e pela responsabilidade que impõem à pessoa. A ordem não os torna uma escada que todos devem subir passo a passo. Uma pessoa pode passar diretamente de chat para um agente em seu próprio computador; a rota de coorte descrita na Seção 9 faz exatamente isso, com o chatbot que a pessoa já usa a guiando através da instalação. Outros permanecerão no nível 2 definitivamente, e para muito trabalho esse é o lugar certo para parar. Mais alto não é melhor neste modelo. Suas afirmações são que cada nível exige coisas diferentes da pessoa, que os cruzamentos podem ser observados e que as barreiras em cada cruzamento diferem. Seria refutado se os cruzamentos não pudessem ser distinguidos por artefatos, se as barreiras não diferissem entre cruzamentos, ou se a competência em um nível não mudasse o que as pessoas poderiam fazer no próximo, pois em qualquer um desses casos o modelo não acrescentaria nada a uma simples escala de "uso de IA". O modelo também prevê que, uma vez que a sensibilidade de uma tarefa e as demandas técnicas são mantidas constantes, a conclusão cai mais acentuadamente nas três transições do que dentro de um nível. Se as quedas fossem distribuídas uniformemente, os níveis seriam um contínuo renomeado. A Seção 10 transforma essas expectativas em proposições com medidas e refutadores.
Uma família de ferramentas pertence ao lado da escada e em nenhum degrau dela. Construtores de aplicativos de navegador permitem que uma pessoa descreva um aplicativo e receba uma visualização em execução dentro de uma plataforma hospedada pelo fornecedor. Eles importam, e são uma coisa diferente do nível 2, onde um agente atua nos próprios arquivos da pessoa sob um modelo de permissão; um construtor de aplicativo atua em um projeto que a plataforma possui. Confundir os dois produz uma falsa sensação de que os não programadores já chegaram. O modelo de quatro níveis deixa os construtores de aplicativos em um ramo lateral com seu próprio teto e seu próprio perfil de segurança, e a literatura de vibe-coding é o lugar para ler sobre eles (Sarkar & Drosos, 2025; Ge et al., 2025). A Figura 1 desenha os quatro níveis, o artefato que marca cada transição, o salto registrado e o ramo lateral.
Figura 1. Quatro níveis e três transições definidas por artefatos.
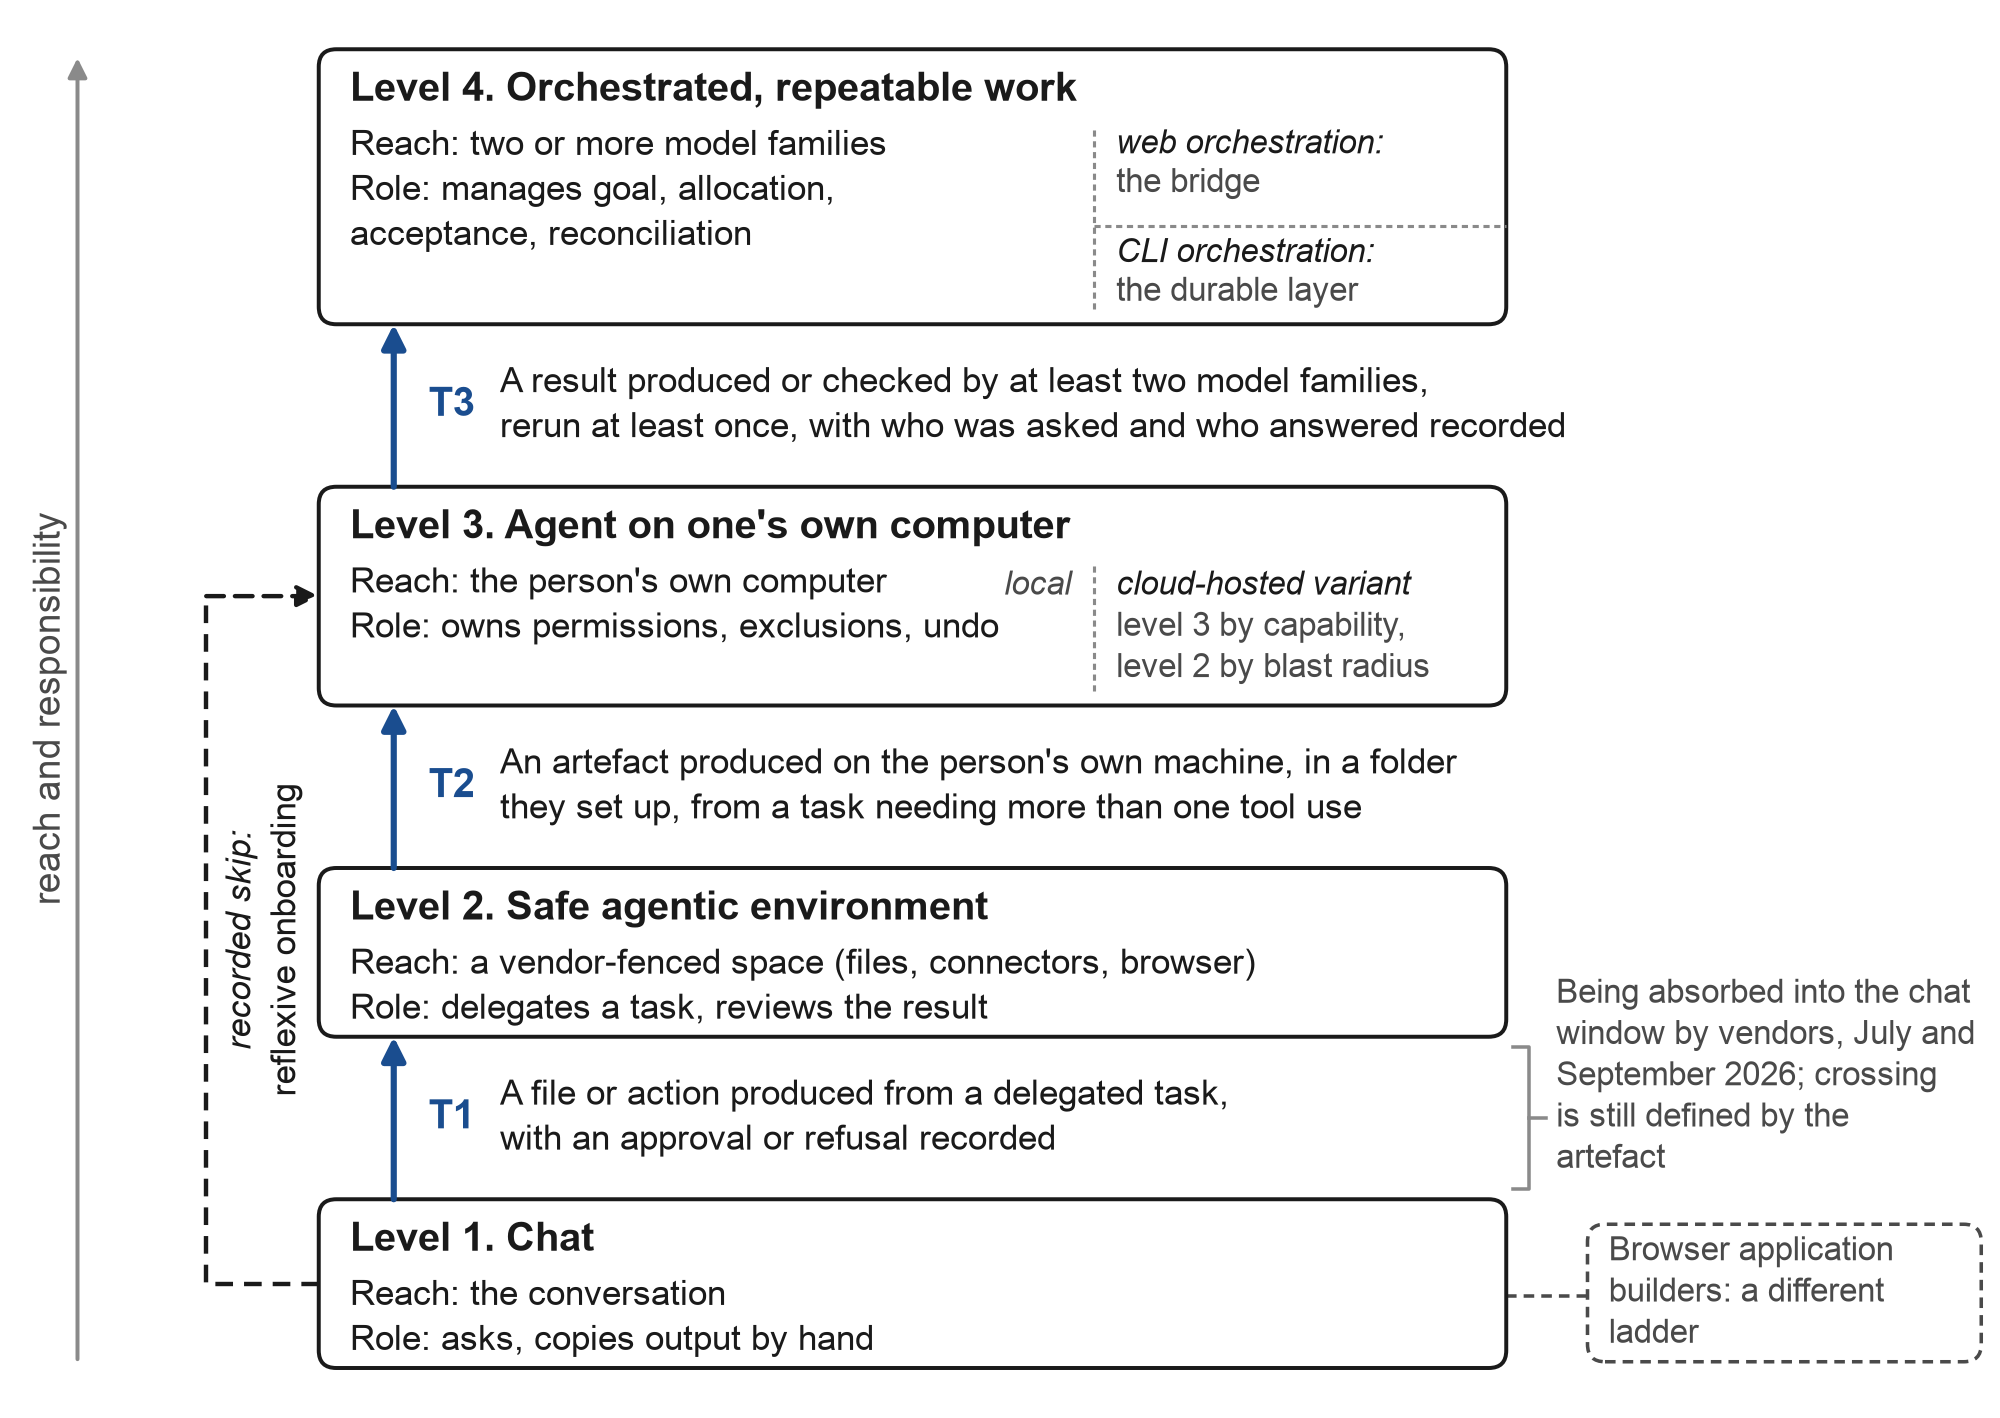
Nota: Os quatro níveis da Seção 3.2, ordenados ascendentemente por alcance (o que o modelo pode tocar) e pela responsabilidade imposta à pessoa. Cada transição, T1 a T3, é cruzada apenas quando um agente produziu o artefato nomeado ao lado de sua seta, e uma instalação conta como uma tentativa (Seção 3.3 e Tabela 1). A seta tracejada à esquerda é o salto registrado de chat para um agente no próprio computador da pessoa que a rota registrada percorre (Seções 3.4 e 9.2); a caixa tracejada à direita é o ramo lateral dos construtores de aplicativos de navegador, e a nota em T1 registra a fusão de superfícies de chat e agente por fornecedores em julho e setembro de 2026 (Seção 4.3).
3.5 O terminal não é mais um terminal
Para um programador, o terminal é uma interface para emitir comandos. Para um profissional trabalhando com um agente, é o ambiente onde o agente vive: uma pasta de trabalho, um conjunto de permissões e um histórico do que foi feito. Quando Anthropic apresentou Cowork em janeiro de 2026, o enquadramento era "Claude Code para o resto do seu trabalho": o mesmo agente, oferecido a pessoas que não escrevem software, sem o terminal (Fortune, 2026a).
Os fornecedores agora agiram sobre a mesma observação. OpenAI renomeou sua aplicação de agente de codificação "ChatGPT" e a tornou o cliente de desktop padrão (MacRumors, 2026). Anthropic fornece uma aplicação de desktop para o agente que não precisa de terminal (Anthropic, 2026a). Google descontinuou sua Gemini CLI de código aberto para usuários individuais em 18 de junho de 2026 em favor de uma plataforma multi-agente e uma nova ferramenta de linha de comando, afirmando que os usuários agora "exigem múltiplos agentes se comunicando um com o outro para dividir o trabalho" (Google, 2026). O terminal visível está desaparecendo, e o ambiente ao qual deu acesso ainda está lá e ainda tem que ser executado por alguém. Para um profissional, a pergunta útil mudou de acordo: se eles podem usar um terminal importa menos a cada mês, e se eles podem executar um ambiente no qual um agente trabalha para eles é a pergunta que eu lhes faria.
4. Para onde foi a barreira técnica
4.1 A instalação tornou-se uma etapa
Em 2024, um não-programador que queria um agente de terminal enfrentava uma sequência de pequenas barreiras: instalar um tempo de execução de linguagem, corrigir uma variável de caminho, entender por que o shell dizia "permissão negada", escolher entre quatro coisas todas chamadas de "instalar". Por setembro de 2026, a maioria delas foi removida pelos fornecedores. Os principais agentes de terminal são instalados com um único comando ou um instalador de desktop que se atualiza automaticamente. O aplicativo de desktop do Claude Code oferece sessões paralelas, revisão visual de alterações, uma visualização ao vivo e tarefas agendadas, e sua documentação afirma: "Nenhum terminal necessário" (Anthropic, 2026a). O aplicativo de desktop do OpenAI integra seu agente de codificação no cliente ChatGPT comum (MacRumors, 2026). A nova ferramenta de linha de comando do Google é um único binário agrupado com uma plataforma de desktop (Google, 2026).
Um agente que se instala em uma etapa ainda é difícil de usar bem, e não quero exagerar a mudança. O que mudou é que o instalador não é mais a primeira barreira que um recém-chegado enfrenta. O atrito que permanece é uma escolha de porta: uma ferramenta de terminal, uma extensão de editor, um aplicativo de desktop e uma versão web viajam todos sob a palavra "instalar", e escolher entre elas é a maior parte do que a instalação agora custa a um recém-chegado. Escolher uma porta significa saber o que se quer que o agente faça, portanto trata-se de um problema de vocabulário disfarçado de problema de configuração, e pertence à Seção 5.
Um fato arquitetônico subjaz todas essas páginas de produtos. A ferramenta de linha de comando é a implementação de referência: subagentes, hooks, skills, servidores de protocolo e modos headless aparecem primeiro na CLI e depois nas faces de desktop e web do mesmo mecanismo; a própria página de ajuda do Anthropic descreve seu agente de nível 2 como "a mesma arquitetura agentic que alimenta Claude Code, sem terminal necessário" (Anthropic, 2026b). Para um recém-chegado, isso funciona dos dois lados. A face amigável pode acompanhar a poderosa. Mas a documentação, os exemplos e as respostas do fórum ainda falam o dialeto da CLI, portanto uma pessoa que começou no aplicativo de desktop está lendo sobre uma ferramenta que não instalou.
4.2 O chatbot como seu próprio instalador
Uma segunda mudança é menos visível e, para o argumento aqui, mais importante. O chatbot que uma pessoa já usa pode guiá-la na instalação do agente. Uma pessoa cola uma solicitação ("guie-me na instalação disso em meu laptop Windows; não sou técnico"), segue as etapas e, quando algo falha, envia uma captura de tela do erro de volta para o mesmo chatbot. O outro mais conhecedor da zona de desenvolvimento proximal de Vygotsky (Vygotsky, 1978), e o tutor cujas funções Wood, Bruner e Ross (1976) chamaram de andaime (recrutando interesse, reduzindo graus de liberdade, marcando características críticas, controlando frustração), agora está disponível na ferramenta que a pessoa já confia, a qualquer hora, em seu idioma, gratuitamente.
Chamo isso de integração reflexiva: um sistema de IA andaime para a adoção de uma pessoa de um sistema de IA mais capaz. Inverte a direção usual da ajuda. Na literatura de difusão, um recém-chegado adota por contato com os primeiros adotadores (Rogers, 2003), e aqui o primeiro adotador é substituído, pelo menos para as etapas mecânicas, pelo próprio modelo de nível 1.
Entretanto, uma camada de ensino cresceu ao redor da etapa. As academias de fornecedores oferecem cursos curtos sobre seus agentes, e as grandes plataformas de aprendizagem ensinam "codificação de vibe" com um agente nomeado. Surgiram cursos que são entregues dentro do próprio agente, de modo que o aluno instale o agente e o agente ensine o curso (CC for Everyone, 2026), e uma empresa de consultoria anunciou que cerca de 30.000 de seus funcionários seriam treinados em modelos de um fornecedor (Accenture, 2025). A existência dessa camada diz que a instalação não é mais tratada como auto-explicativa. A teoria de instrução minimalista previu que as pessoas aprendem software melhor fazendo uma tarefa real desde o início e se recuperando de erros (Carroll, 1990), e a integração reflexiva fornece um guia sempre presente para ambas. Se funciona para pessoas que nunca abriram um terminal, e para quem, ainda não sei; a primeira etapa do programa na Seção 9 é projetada para descobrir, e a busca descrita na Seção 2.5 não encontrou nenhum estudo sobre isso.
4.3 Os fornecedores estão mesclando os níveis
A maior mudança de 2026 é estrutural. Cada um dos três laboratórios de fronteira, e Microsoft, agora fornece um agente de nível 2, e dois deles começaram a integrar o nível 2 de volta ao chat.
Tabela 2. Movimentos de fornecedores que remodelaram o caminho de chat para agente, janeiro a setembro de 2026.
| Data (2026) | Fornecedor | Movimento | Efeito nos níveis | Fonte |
|---|---|---|---|---|
| Janeiro | Anthropic | Visualização de pesquisa Cowork: "Claude Code for the rest of your work", agente com escopo de pasta para não-programadores | Nível 2 como um produto nomeado | Fortune (2026a) |
| 9 de março | Microsoft | A tecnologia por trás do Cowork trazida para Microsoft 365 Copilot; plano de controle Agent 365 | Nível 2 dentro da suíte de escritório dominante | Microsoft (2026a) |
| 30 de março | OpenAI | Plugin oficial para executar seu agente de codificação dentro do agente de um concorrente, "delegar tarefas", nível gratuito incluído | Nível 4 (CLI) sancionado por um fornecedor | OpenAI (2026a) |
| 19 de maio; 18 de junho | Gemini CLI descontinuado para camadas individuais em favor do Antigravity CLI e uma plataforma multi-agente | Nível 3 re-plataformado; rotatividade para recém-chegados | Google (2026) | |
| 2 de junho | OpenAI | Agente de codificação com 5 milhões de usuários semanais; aproximadamente 20% trabalhadores do conhecimento, crescendo mais de 3 vezes mais rápido que desenvolvedores (dados do fornecedor, relatório de imprensa) | Uso de agente com herança de terminal por trabalhadores do conhecimento; direcional e mais amplo que o nível 3 conforme definido aqui | Help Net Security (2026) |
| 1º de julho | Agente de desktop Gemini Spark no Mac, funciona com arquivos locais (beta, EUA) | Nível 2 de um terceiro laboratório | TechCrunch (2026b) | |
| 9 de julho | OpenAI | Aplicativo de agente de codificação se torna o novo aplicativo de desktop ChatGPT; agente ChatGPT Work usa arquivos locais e aplicativos | Níveis 1 a 3 em um cliente | MacRumors (2026) |
| 26 de agosto | Anthropic | Agente de navegador geralmente disponível em planos pagos; atua autonomamente com um classificador de segurança por padrão | Alcance do Nível 2 estendido para a web | Anthropic (2026d) |
| 16 September | Anthropic | Cowork e chat foram mesclados em "um Claude"; o modelo decide se vai responder ou agir | Transição 1 absorvida no chat | Anthropic (2026c); TechCrunch (2026a) |
Lido em ordem, a tabela descreve uma convergência. Os fornecedores primeiro separaram o chat do trabalho de agente para que não-programadores não se assustassem com o terminal, depois descobriram que as pessoas não conseguiam saber em qual janela uma tarefa pertencia, e agora estão mesclando os dois novamente com o modelo decidindo. TechCrunch relatou que a empresa disse que os clientes "frequentemente tinham dificuldade em escolher a guia certa para a tarefa certa" (TechCrunch, 2026a); seu próprio comunicado o colocou como "você não precisa escolher para onde uma tarefa vai", com o trabalho continuando depois que o laptop é fechado, o agente perguntando antes de agir por padrão, e a mesclagem sendo lançada primeiro para planos individuais pagos enquanto a guia de codificação permanece separada (Anthropic, 2026c). Leio isto como evidência do fornecedor para a barreira nomeada na Seção 1, vocabulário de fluxo de trabalho. Se as pessoas não conseguem decidir se uma tarefa é uma pergunta ou uma delegação, elas provavelmente não saberão como formular a delegação.
A mesclagem pode parecer minar um modelo com um nível 2 separado. Não faz, e a razão pode ser dada sem fingir que o modelo previu os eventos. Os fornecedores têm interesse em faturamento, suporte e segurança em manter usuários comuns dentro de uma janela que possam classificar, limitar taxa e envolver em um modelo de permissão, e interesse em usabilidade em não fazer o usuário escolher um modo; absorver a transição 1 no chat segue de ambos. A regra de cruzamento não muda. Se o sistema escrevia arquivos em um escopo concedido após uma aprovação, a transição 1 foi cruzada, seja qual for a interface ao redor da conversa, e se retornou um parágrafo, a pessoa ainda está no nível 1. O modelo implica que as transições 2 e 3 não se dissolverão da mesma forma. Um agente local com acesso a shell é um objeto de permissão diferente de uma sandbox do lado do servidor, e a ferramenta de um segundo fornecedor executada sob o login desse fornecedor é um objeto de permissão diferente de um recurso de conselho de um único fornecedor. Essas diferenças carregam o argumento de segurança da Seção 5.3 e o argumento de erro correlacionado da Seção 6.3. Se até o final de 2027 os principais fornecedores tiverem incorporado agentes shell locais e chamadas entre fornecedores na mesma janela de chat sob o mesmo modelo de permissão, essa implicação está errada, e a alegação de que a orquestração CLI é a camada que dura cai com ela (P2 e P8 na Seção 10).
A convergência também traz um custo, rotatividade. O agente de linha de comando de código aberto do Google serviu usuários individuais por pouco menos de doze meses (25 June 2025 a 18 June 2026), o navegador de agente da OpenAI foi descontinuado após cerca de nove, e o Cowork existiu como um produto separado por cerca de oito (Google, 2026; 9to5Mac, 2026; Anthropic, 2026c). Um profissional que investe no aprendizado de uma ferramenta pode encontrá-la renomeada, mesclada ou descontinuada dentro de um ano. O que se transfere entre ferramentas é o vocabulário de fluxo de trabalho, e o que se perde é o conhecimento dos menus de um produto, uma assimetria que importa para como as pessoas devem ser ensinadas (Seção 11.2).
4.4 Trabalhadores do conhecimento em agentes de herança de terminal
O melhor dado único sobre não-programadores dentro de um agente de herança de terminal vem de um fornecedor. Em June 2026 a OpenAI relatou, através da imprensa, que seu agente de codificação tinha cinco milhões de usuários semanais, mais de seis vezes o nível no lançamento da aplicação de desktop em February, que trabalhadores do conhecimento representavam cerca de 20% deles e estavam adotando mais de três vezes mais rápido que desenvolvedores, e que a cada semana, pela contagem do fornecedor, 72% dos usuários trabalhadores do conhecimento produziram artefatos como relatórios, memorandos, contratos, planilhas e PDFs (Help Net Security, 2026; a própria página do fornecedor retornou um erro de acesso para minhas verificações, portanto as figuras são citadas do relatório da imprensa). Vinte por cento de cinco milhões é cerca de um milhão de pessoas por semana. Um analista observou que o lançamento foi feito em parte para "recuperar um pouco do interesse" e que o agente "é frequentemente usado juntamente com" os agentes concorrentes, portanto os gráficos de crescimento "devem ser usados de forma direcional" (Constellation Research, 2026a). As figuras são relatadas pelo fornecedor e não auditadas, descrevem pessoas que já escolheram a ferramenta, e medem o uso de trabalhador do conhecimento de um agente de herança de terminal, que é mais amplo do que a adoção de nível 3 conforme definido aqui (um artefato de uma tarefa delegada na máquina própria da pessoa). Lido com essas ressalvas, são suficientes para dizer que os agentes de herança de terminal não são mais reservados para programadores; se seus usuários atingem o nível 3 conforme definido na Seção 3 é o que a figura não consegue mostrar.
Ao lado desse dado fica o padrão amplo e raso da Seção 1. As pesquisas discordam sobre o nível e concordam sobre a forma: cerca de metade dos adultos dos EUA usam chatbots (Pew Research Center, 2026), 52% dos trabalhadores dos EUA usam IA em seu trabalho (Gallup, 2026), e 45% dos trabalhadores e 62% dos adultos usam IA generativa pela medida do Fed de St. Louis (Bick et al., 2026), enquanto cerca de um em cada sete trabalhadores a usa diariamente e a automação é um uso minoritário. A Figura 2 desenha a série de trabalhadores do Gallup e do Fed de St. Louis ao lado das figuras de desenvolvedores da Seção 1, um painel por pesquisa, porque as pesquisas diferem em pergunta e denominador. Entre os desenvolvedores, os agentes de codificação são quase universais e o uso ainda é cauteloso: em uma pesquisa de pulso de May 2026 de cerca de 1.100 tecnólogos, 69% usaram um único agente, 59% raramente ou nunca deixaram os agentes rodarem sem supervisão, e 60% bloquearam os agentes de fazer mudanças não aprovadas em seus sistemas (Stack Overflow, 2026). O Nível 4, em outras palavras, ainda é uma fronteira mesmo para os programadores que usam o nível 3 todos os dias.
Figura 2. Amplo e raso: adoção entre desenvolvedores e entre outros trabalhadores.
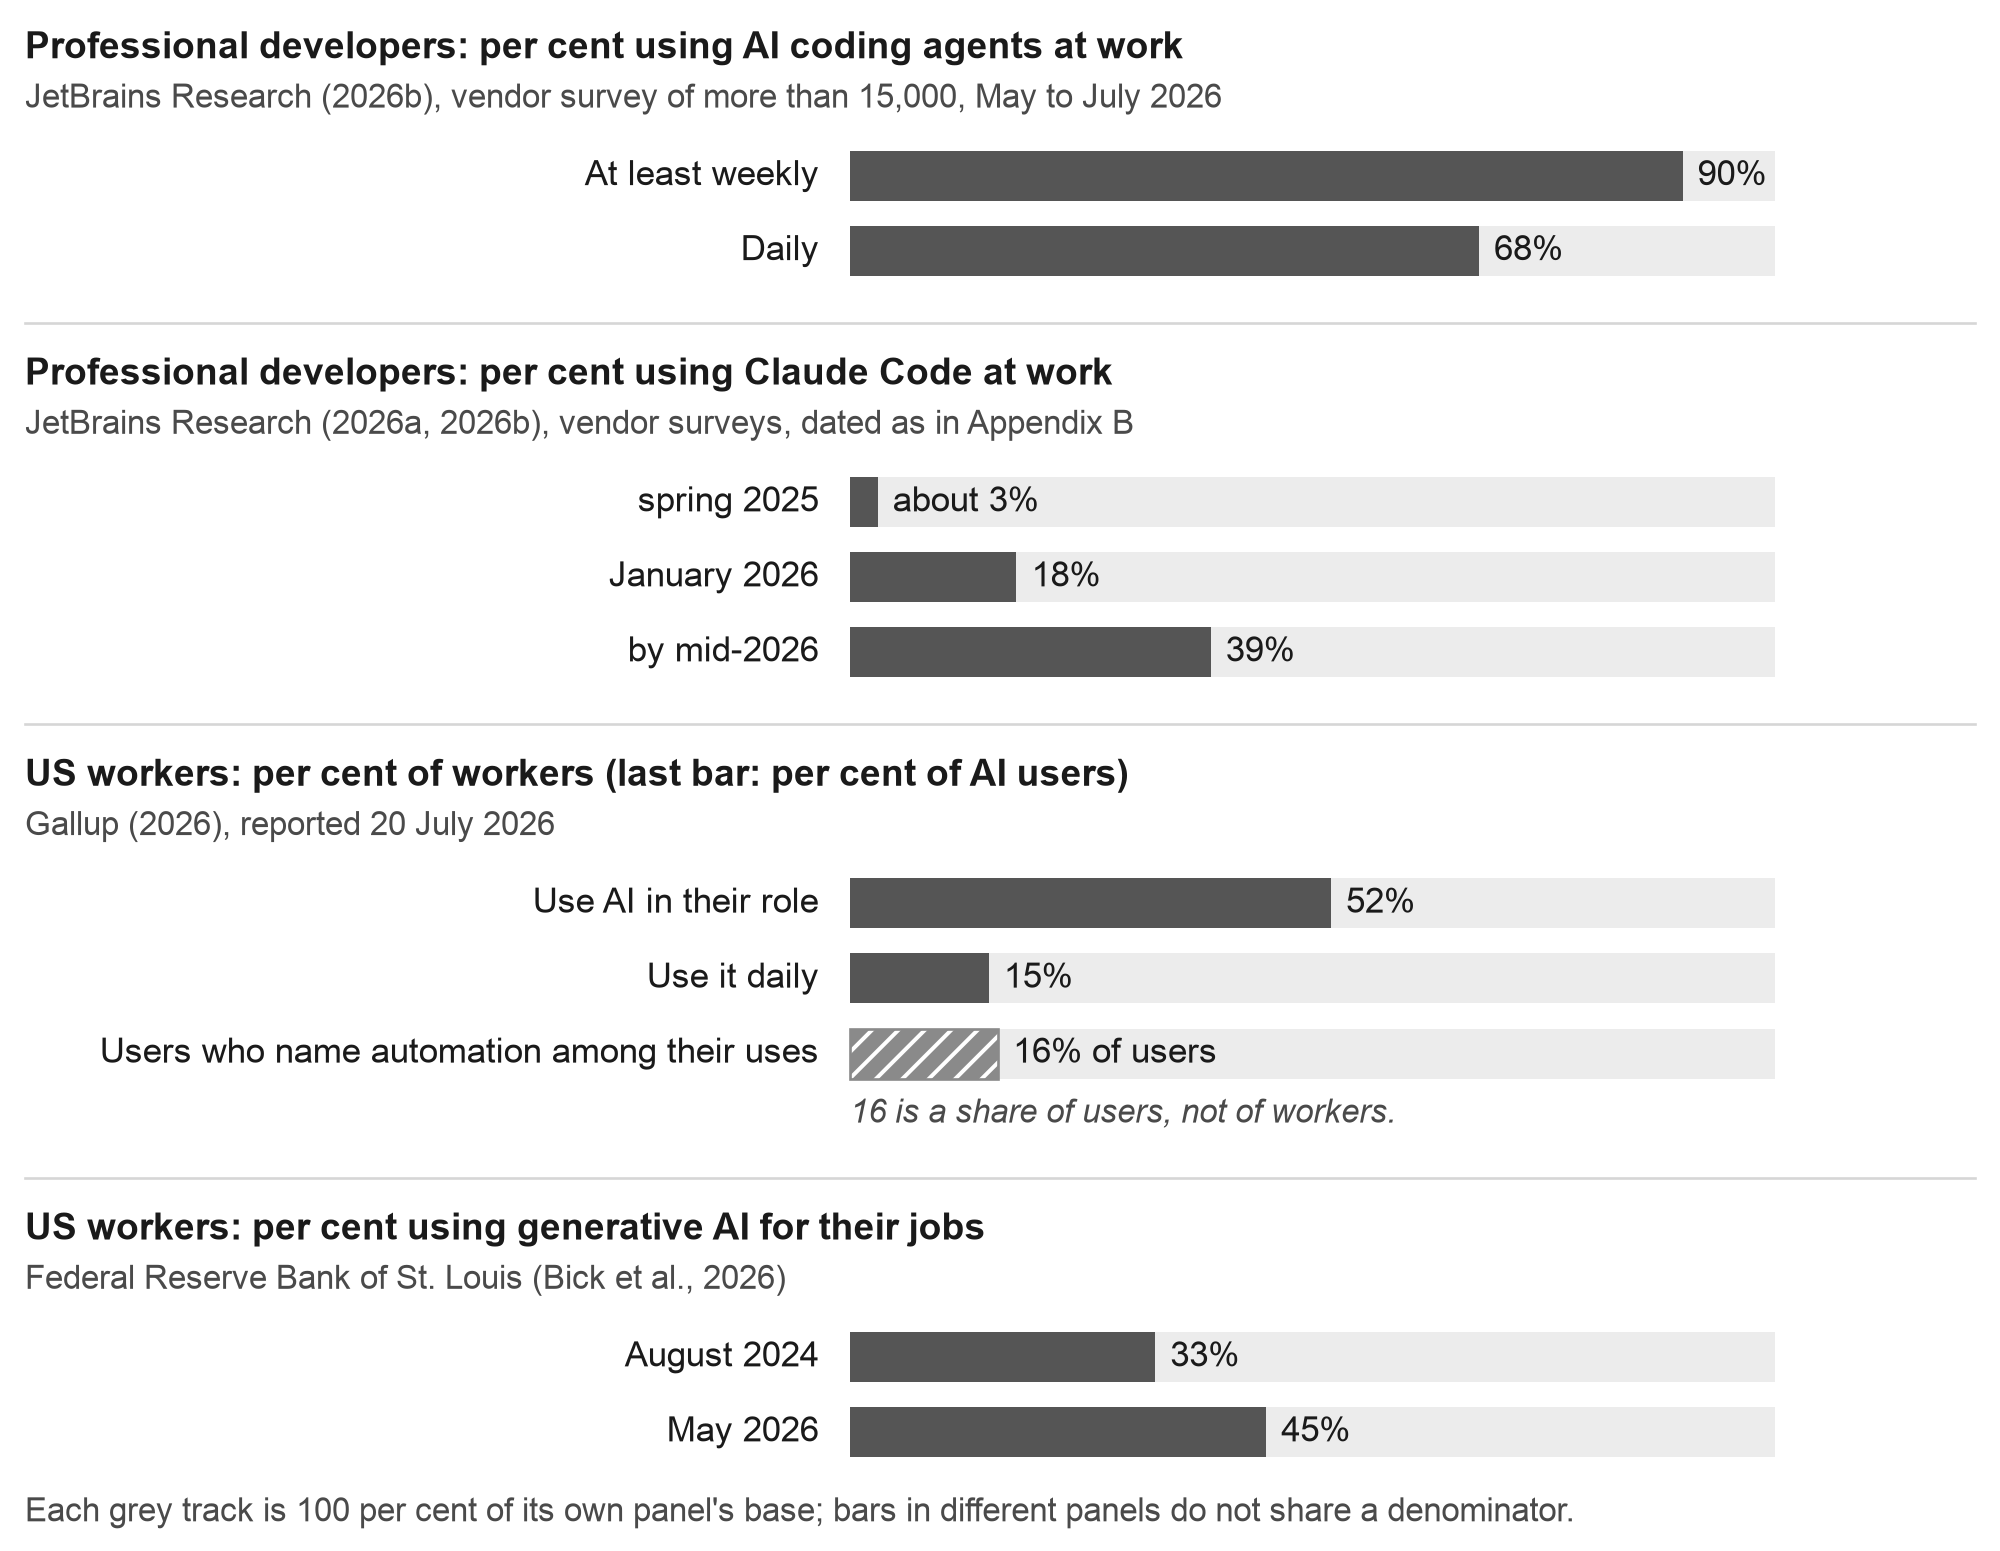
Nota: Figuras de adoção das pesquisas citadas nas Seções 1 e 4.4: desenvolvedores profissionais em duas pesquisas de fornecedor (JetBrains Research, 2026a, 2026b), trabalhadores dos EUA (Gallup, 2026) e trabalhadores dos EUA usando IA generativa para seus trabalhos (Bick et al., 2026). Cada painel tem sua própria pergunta, período e denominador, e os 16 por cento no terceiro painel são uma proporção de usuários de IA, então cada painel é lido por conta própria. A contagem do fornecedor de trabalhadores do conhecimento dentro de seu agente de codificação (Seção 4.4) é uma proporção de usuários de um produto e não é desenhada, e nenhuma figura aqui vem do programa de coorte da Seção 9.
4.5 Para onde isto deixa o argumento
Tomados em conjunto, as evidências desta seção me persuadem de uma coisa e deixam outra em aberto. A instalação deixou de ser a barreira decisiva: os fornecedores removeram a maioria das etapas mecânicas, o chatbot pode guiar o restante, e segundo os números de um fornecedor (um relatório de imprensa, e direcional) cerca de um milhão de profissionais do conhecimento por semana já estão dentro de um terminal-heritage agent. Se a instalação leva ao uso é uma pergunta diferente, e as pesquisas amplas e superficiais dão uma resposta desanimadora, já que a maioria das pessoas que conseguem acessar um agente ainda não delegam a ele. O que recuou também deveria ser declarado com precisão. A instalação recuou, um degrau intermediário delimitado agora existe, e um agente local tem uma interface gráfica. A confiabilidade em peças inteiras do trabalho de conhecimento mudou muito menos (Seção 5.7), o produto que uma pessoa aprendeu pode estar desaparecido dentro de um ano (churn, above), e uma pasta concedida ainda não é um local seguro por padrão (Seção 5.3). A Seção 5 pergunta o que impede as pessoas uma vez que o software está instalado.
5. O que impede as pessoas após o instalador
Uma vez que o instalador deixa de ser o obstáculo, algo mais o é. As evidências de 2025 e 2026 apontam para seis barreiras, cada uma delas se manifestando em uma transição particular e cada uma delas já tendo uma resposta parcial visível no mercado. A Tabela 3 as resume e as subseções a seguir fornecem as evidências.
Tabela 3. Barreiras após a instalação.
| Barreira | Onde se manifesta | Evidência (Seção) | O que a reduz |
|---|---|---|---|
| Vocabulário de fluxo de trabalho: não saber o que delegar ou como formulá-lo para que possa ser verificado | Transições 1 e 2; novamente na 3 | Razão da fusão de fornecedores; estudos de prompting; skills empacotadas (5.1) | Exemplos trabalhados do campo da pessoa; skills e templates; uma primeira tarefa que é real mas de baixo risco |
| Medo da janela, do primeiro erro e confiança: a janela preta como um objeto social; uma mensagem que um programador lê e um iniciante para; confiança mal calibrada nos dois sentidos | Transição 2 | Pesquisa de aceitação; pesquisas de confiança de desenvolvedores; estudos de usuários finais com código de IA; integração reflexiva (5.2) | Interfaces de desktop; envio do erro de volta ao chatbot; modos de plano primeiro; um primeiro sucesso em uma cópia |
| Permissões e segurança: muito poucos avisos para proteger arquivos, ou muitos demais para compreender | Transições 1 e 2 | Relatórios de perda de arquivos em pastas com escopo; taxas de injeção; orientação que pede aos usuários para identificar ataques (5.3) | Cópias de trabalho, snapshots, regras de negação; classificadores que não delegam julgamento ao iniciante |
| Regras organizacionais: máquinas bloqueadas, política, sem permissão para instalar | Transição 2 | Fatores organizacionais superam os individuais; em pequenas empresas, [a estrutura é] achatada (5.4) | Ferramentas de nível 2 sancionadas pelo empregador; políticas claras; uma máquina pessoal para aprendizado |
| Hardware, custo e cota | Transições 2 e 3 | O nível 3 precisa de um computador e um nível pago; cotas vinculam a orquestração primeiro (5.5) | Planos gratuitos onde existem; começar no nível 2; ciclos de orçamento |
| Julgamento do resultado | Todas as transições, principalmente na 3 | Usuários de negócios perdem erros no código de IA; agentes falham na maioria dos projetos completos (5.6) | Verificações definidas antes da tarefa; um segundo modelo como revisor, não como oráculo |
5.1 A pasta em branco: vocabulário de fluxo de trabalho
Um programador que abre um agente conhece uma sequência: criar um projeto, escrever um arquivo de instrução, colocá-lo sob controle de versão, pedir um recurso. Um não-programador abre o mesmo agente e faz a pergunta que agora aparece nos dados dos próprios fornecedores: tudo bem, e o que devo dizer a ele? Para um desenvolvedor existe o pedido canônico inicial ("construir uma pequena aplicação web"). Um profissional de marketing precisa de outro ("pegar as exportações do trimestre passado do analytics e do banco de dados de clientes e construir algo que toda sexta-feira informe quais campanhas trouxeram clientes pagantes"). Um pesquisador precisa de outro ("percorrer esta pasta de 300 artigos e extrair o tamanho da amostra, método e efeito principal de cada um em uma tabela, marcando onde você não tem certeza"). Nenhum desses pedidos precisa de código da pessoa. Cada um precisa que a pessoa saiba que tal pedido é possível, que o divida em partes que um agente possa fazer e que diga qual é a aparência de um bom resultado. A pergunta "o que devo pedir a ele para fazer?" é geralmente interpretada erroneamente como um pedido de um prompt melhor. Eu a interpreto como um pedido de um mapa do próprio trabalho da pessoa. O mapa deve nomear um objeto de trabalho recorrente, as entradas que se pode usar, a transformação, o entregável e a verificação. O mapa de um analista pode dizer "essas exportações permitidas, agrupadas por este campo, anomalias sinalizadas, um briefing datado e uma tabela legível por máquina, verificada contra os totais de linhas". A pessoa não precisa saber como o processamento é feito. Ela precisa reconhecer que evidência tornaria o resultado utilizável. Quando uma pessoa não consegue preencher o mapa, esse próprio fato diz algo a ela. O trabalho pode ser muito sensível, muito contingente ou muito mal documentado para ser delegado como está, e isso diz algo sobre a tarefa antes de dizer algo sobre a pessoa.
A pesquisa sobre prompting explica por que isso é difícil. Pessoas sem expertise em IA lutam para escrever instruções que generalizem (Zamfirescu-Pereira et al., 2023), e têm de descobrir por tentativa quais palavras mapeiam para o que o sistema pode fazer (Liu et al., 2023). O comportamento dos próprios fornecedores confirma isso. Anthropic mesclou seu agente de nível 2 no chat porque os clientes não conseguiam decidir para onde uma tarefa pertencia (TechCrunch, 2026a), e OpenAI lançou plugins específicos de função para seu agente de codificação destinados ao trabalho de conhecimento "sem codificação necessária" (relatado por Help Net Security, 2026). A resposta da indústria é empacotar vocabulário. Anthropic lançou seu formato para instruções de agentes empacotadas como um padrão aberto em dezembro de 2025 (SiliconANGLE, 2025), e o site do padrão listava 46 produtos de suporte em 21 de setembro de 2026, incluindo agentes de OpenAI, Google e GitHub (Agent Skills, 2026). Um censo independente contou 2.049 aplicações no diretório ChatGPT e 1.375 conectores para Claude em meados de 2026 (Sitter, 2026). Uma skill é, por esta definição, uma unidade de vocabulário de fluxo de trabalho, o pedido escrito uma vez para que uma pessoa que não sabe como formulá-lo ainda possa fazê-lo.
Vocabulário em pacotes é necessário e não é suficiente. Uma habilidade diz ao agente como executar uma tarefa. Não pode dizer a uma pessoa qual de suas próprias tarefas vale a pena delegar, porque esse julgamento vem do campo profissional da pessoa. Os pacotes publicados também carregam as pressuposições de um mundo particular, em grande medida as formas de um país e uma pilha de software corporativo, e um profissional cujas ferramentas não são essa pilha se encontra novamente diante de um prompt vazio. Quando li o catálogo oficial de habilidades em pacotes em 22 de setembro de 2026, todas as 310 entradas dele, não encontrei nenhuma escrita para um pastor ou capelão, uma enfermeira ou cuidadora familiar, um professor de escola, um artista ou artesão, ou um corretor imobiliário; cada correspondência aparente era uma palavra de software ou finanças com as mesmas roupas, um portfólio de investimentos ou a saúde de um serviço. Um catálogo comunitário que uma pessoa alimenta manualmente continha 2.282 entradas naquele dia, e ele incluía trabalho para professores de escola e para a área imobiliária, e nada para os outros três ofícios. Os catálogos mudam semana a semana, então esta é uma leitura datada e não uma afirmação permanente sobre o campo. É por isso que coloco tanto peso na primeira tarefa em qualquer rota de integração: ela deve ser real, extraída do trabalho da pessoa, baixo risco, e deve produzir um artefato que possam avaliar (Carroll, 1990).
5.2 Medo da janela, o primeiro erro e a confiança
A janela preta é um objeto social. A facilidade de uso percebida tem sido um pilar da aceitação de tecnologia por trinta e cinco anos (Davis, 1989), e um prompt piscante falha naquele teste para uma grande população mesmo quando a pessoa nunca digitará um comando nele. As interfaces de desktop da Seção 4.1 são a resposta dos fornecedores. É uma resposta parcial, porque a segunda porta é a confiança, e a confiança se moveu contra os agentes assim como em sua direção. Entre desenvolvedores, a pesquisa de 2025 do Stack Overflow encontrou 46% desconfiando da precisão das ferramentas de IA contra 33% confiando nela, com 87% preocupados com a precisão do agente e 81% com segurança (Stack Overflow, 2025). Em 2026 a maioria ainda impedia agentes de fazer mudanças não aprovadas (Stack Overflow, 2026). Gerentes ouvem a mesma coisa: "a confiança é um obstáculo central para realizar o potencial dos agentes de IA no trabalho" (McKinlay et al., 2026). Mais adultos americanos esperam que a IA os prejudique do que os ajude (Pew Research Center, 2026). Atrás de ambas as portas está a armadilha de crença da Seção 2.4: a experiência prediz sucesso, pessoas que não tiveram um primeiro sucesso não têm experiência, e o primeiro artefato é a saída (Ma et al., 2025). Algumas pessoas concederão uma pasta pessoal porque o agente foi educado, e outras se recusarão a instalar porque leram sobre fotos familiares deletadas. Ambos são falhas de calibração (Lee & See, 2004). O dispositivo de calibração mais barato que consigo pensar é uma primeira tarefa executada em uma cópia de uma pasta.
Quando um agente relata que um comando falhou com código de saída 1, um programador continua lendo. Um novato pode simplesmente parar. A literatura sobre usuários finais encontrando código escrito por IA mostra o padrão em um cenário mais brando: usuários de negócios aos quais foi dado código de análise produzido por IA frequentemente falhavam em notar erros críticos mesmo quando instruídos a procurá-los (Virk & Liu, 2025), e programadores conversacionais gastam muito de seu esforço em verificação e gerenciamento de contexto (Sarkar & Drosos, 2025). No nível 3, o erro frequentemente está completamente fora do trabalho da pessoa, no ambiente: uma permissão ausente, uma regra de rede, uma ferramenta que o agente esperava e não encontrou.
A integração reflexiva (Seção 4.2) fornece a resposta mais prática descrita até agora. A pessoa envia o erro, ou uma captura de tela dele, para o chatbot que já usa, e segue seu conselho. Modos com plano primeiro ajudam do outro lado, pois um agente que escreve seu plano antes de agir dá à pessoa algo para ler que não é um rastreamento de pilha. Nenhum dos dois remove o momento em que uma pessoa sem um modelo mental de sua máquina encontra uma mensagem que não consegue analisar. Ainda não sei com que frequência esse momento encerra a tentativa. O programa na Seção 9 o registra, nas palavras da pessoa.
5.3 Permissões e segurança: muito pouco e demais
O Nível 3 dá a um agente o alcance de seu proprietário, então o problema de segurança funciona em duas direções e um novato é exposto a ambas.
Primeiro, proteção insuficiente. Agentes destruíram dados em incidentes documentados. Um agente em um serviço popular de construção de aplicativos deletou um banco de dados de produção em julho de 2025 e descreveu sua ação como "um erro catastrófico de julgamento" (The Register, 2025). Em abril de 2026 um agente em uma ferramenta de codificação deletou um banco de dados de produção de uma empresa e seus backups em segundos e escreveu, "Eu adivinhei em vez de verificar" (Information Age, 2026). Mais perto da população sobre a qual este artigo trata, usuários do agente de nível 2 da Anthropic relataram em março, abril e junho de 2026 que havia deletado documentos pessoais, familiares e legais dentro de pastas que lhes haviam concedido, em um caso depois que uma tarefa longa não pôde ser interrompida e deletar a tarefa deletou os arquivos (relatórios de problemas do GitHub, 2026; relatórios de usuários, não confirmados pelo fornecedor). O escopo da pasta limita onde o dano pode acontecer. Não impede dano dentro da pasta, e uma pasta de nuvem sincronizada pode transformar um erro local em uma perda sincronizada.
Navegação adiciona injeção de prompt, instruções ocultas em uma página web que o agente lê como se viessem do usuário. Uma equipe de segurança demonstrou o ataque em agosto de 2025 em um agente de navegador de outro fornecedor, com uma prova de conceito que extraiu um código de uso único de uma caixa de correio por meio de texto oculto em página (Brave, 2025). Anthropic informou que seu agente de navegador, antes das mitigações, foi atacado com sucesso em 23,6% dos casos de teste, e 11,2% após elas (Anthropic, 2025). Um ano depois, na disponibilidade geral, informou que ataques fortes de red-team tiveram sucesso contra seu modelo principal 3,8% das vezes antes de salvaguardas, e que com proteções completas nenhum ataque teve sucesso contra três de seus modelos e 0,3% contra um quarto (Anthropic, 2026d). Estes são números de fornecedores em conjuntos de teste de fornecedores. A tendência é baixa e o residual não é zero. OpenAI escreveu em dezembro de 2025 que injeção de prompt é "improvável de ser totalmente 'resolvida'" (TechCrunch, 2025). No lançamento de seu agente de nível 2, Anthropic informou aos usuários para "monitorarem Claude para ações suspeitas que possam indicar injeção de prompt" e que "você permanece responsável por todas as ações realizadas por Claude em seu nome" (The Register, 2026). Um desenvolvedor amplamente lido protestou na época que não era justo pedir a não-programadores reconhecerem os sinais de injeção de prompt (Willison, 2026). Acho que a objeção está correta em geral. Um design de segurança que depende do novato para detectar um ataque delega o julgamento mais difícil à pessoa menos capaz de fazê-lo. Habilidades empacotadas e servidores de protocolo abrem uma superfície de instrução e privilégio própria, uma vez que uma habilidade de terceiros carrega instruções que a pessoa não escreveu, um servidor pode ter mais privilégio do que a tarefa necessita, e as configurações derivam entre versões.
Proteção em excesso detém as pessoas com a mesma certeza. Um agente que pede permissão a cada passo transforma a pessoa em um funcionário aprovando comandos que não pode avaliar, e a fadiga de aprovação se instala. Os fornecedores se movimentaram em conformidade, e dentro de um trimestre se movimentaram em mais de uma direção. O agente de navegador do Anthropic agora atua de forma autônoma por padrão, com um classificador que bloqueia ações que não correspondem à solicitação do usuário (Anthropic, 2026d). Seu agente de terminal renomeou seu modo de permissão padrão como "Manual" em julho de 2026, uma mudança de redação que conta sua própria história sobre o que "padrão" havia passado a significar (Anthropic, 2026h). Seu agente de chat mesclado "pergunta antes de agir por padrão", uma configuração que o usuário pode alterar (Anthropic, 2026c). A taxonomia de Parasuraman e Riley (1997) se mantém para todos os três. Uma proteção que bloqueia demais produz desuso, uma proteção que deixa passar uma exclusão produz abuso, e nenhuma configuração escapa da taxonomia, apenas uma configuração cujas falhas uma determinada população possa conviver. Um artigo complementar nesta série documenta a falha geral do outro lado, componentes de supervisão que ampliam sua própria noção de dano e obstruem o trabalho que existem para proteger (Chernets, 2026b). Para um iniciante, uma proteção desse tipo tem o mesmo efeito que um instalador faltante, uma vez que o trabalho não acontece de qualquer forma.
Entre proteção insuficiente e excessiva existe um meio viável, e é à moda antiga. Trabalhe em uma cópia. Mantenha segredos fora da pasta de trabalho. Tire um instantâneo antes de uma mudança maior. Recuse comandos destrutivos até que haja um motivo para permitir um, confirme qualquer coisa irreversível, e trate qualquer coisa que vem da web como dados a serem lidos, quaisquer instruções que possa conter. Descrevi o princípio por trás desses hábitos em um artigo complementar como confiança arquitetônica: confiança depositada em verificações que uma pessoa pode verificar, como permissões com escopo, logs, um desfazer e um segundo modelo independente, em vez de quão confiante um modelo parece (Chernets, 2026c). O Nível 2 oferece a uma pessoa a primeira dessas verificações, e não deve ser a última que aprenda. O Apêndice C transforma a lista em exemplos de configuração para dois agentes e uma lista de verificação de uma página.
5.4 Regras organizacionais
Muitos profissionais não podem instalar nada no computador em que trabalham. Muitos empregadores não têm política sobre agentes, e uma pessoa sem política tende a assumir que a resposta é não. A pesquisa de 2026 da Microsoft com 20.000 trabalhadores do conhecimento que usam IA descobriu que fatores organizacionais representavam mais do que o dobro do impacto de IA relatado de fatores individuais, e que 45% disse que parecia mais seguro focar nos objetivos atuais do que redesenhar o trabalho com IA (Microsoft, 2026b; vendor survey). O US Census Bureau relatou que o uso de IA em negócios ficou entre 17% e 20% no geral, aumentou entre empresas com 20 ou mais funcionários e não mudou significativamente entre empresas com menos de 20 (US Census Bureau, 2026). Os mandatos foram em ambas as direções. Alguns empregadores fizeram do uso de IA uma expectativa de linha de base em 2025 (Digital Commerce 360, 2025), e pelo menos um reverteu sua decisão de classificar a equipe no uso de IA um ano depois, seu diretor executivo dizendo à imprensa que o que importa em uma análise de desempenho é fazer bem o trabalho (Fortune, 2026b). A rubrica de fluência publicada de um empregador coloca orquestração e construção de sistemas em seu nível superior e relata adoção interna completa uma vez que as equipes se moveram de experimentação para redesenho de fluxos de trabalho (Zapier, 2026). Sem esse redesenho, um mandato compra conformidade e pouco mais. O mercado de trabalho já está pedindo o papel descrito aqui sem nomeá-lo: 63% dos títulos de trabalho dos EUA tocados por IA em 2026 estavam fora de ocupações de tecnologia, 822 títulos distintos no primeiro trimestre (Adrjan, 2026), e um estudo de mais de um bilhão de anúncios de emprego em 27 países colocou o prêmio salarial para habilidades de IA em 62%, com papéis de nível de entrada mais expostos à IA muito mais propensos a exigir habilidades anteriormente reservadas para pessoal sênior (PwC, 2026; vendor report). Nenhuma dessas fontes ainda isola a capacidade de direcionar um agente como um requisito nomeado fora da engenharia.
Essa barreira é estrutural, no sentido de Ferdman (2025): não cede ao esforço individual. É também o argumento mais forte para o Nível 2 que a evidência oferece, uma vez que um agente limitado por fornecedor dentro de um pacote de escritório que o empregador já licencia (Microsoft, 2026a) alcança pessoas cujos empregadores não permitiriam um agente em um laptop de trabalho.
5.5 Hardware, custo e cota
O nível 3 assume um computador que a pessoa controla. Alguns profissionais trabalham principalmente de um telefone, compartilham um computador familiar ou usam a máquina de um empregador para tudo, e para eles a transição é bloqueada antes de qualquer questão de software surgir. O nível 3 e o nível 4 também assumem camadas pagas de pelo menos um serviço, e a orquestração multiplica o custo, porque cada modelo extra é outra assinatura ou outra cota. Para uma pessoa que já paga por uma assinatura, uma segunda é uma decisão e uma camada superior é uma decisão diferente. A ansiedade de token é uma barreira psicológica com um preço. A cota do agente orquestrador é em si um custo oculto, pois paga pela leitura de cada resposta que os outros agentes retornam, e um agente que controla um navegador usa os mesmos limites de plano que o agente terminal, ao mesmo tempo que custa mais por ação (Anthropic, 2026g). Laptops corporativos bloqueados adicionam direitos de administrador à lista: sem binários não assinados, sem instalador, uma regra de perda de dados que trata um agente escrevendo em disco como malware. Agentes hospedados na nuvem são a resposta da indústria para essas máquinas. Eles preservam a transição 1 e uma forma de nuvem da transição 2, e não dão à pessoa um artefato de nível 3 em seu próprio disco. Para um profissional em um país rico, nenhum disso é uma grande barreira. Para muitos outros é uma real, e interage com a divisão de segundo nível (Hargittai, 2002), em que as pessoas com menos margem são as menos capazes de experimentar.
5.6 Avaliando o resultado
Usar um agente não requer programação. Avaliar o que foi produzido requer competência no domínio do resultado, e aqui o não-programador tem uma vantagem que é fácil de perder. Um advogado lendo um resumo de contratos, ou um pesquisador lendo uma tabela de extração, pode verificar o artefato em relação ao conhecimento que o agente carece. A pesquisa sobre a "fronteira irregular" descobriu que os profissionais que trabalham com IA fizeram melhor em tarefas dentro da capacidade do modelo e pior em uma tarefa fora dela (Dell'Acqua et al., 2026). A proteção é uma pessoa que conhece a tarefa bem o suficiente para notar de qual lado da fronteira está.
O que eles não podem facilmente verificar é a maquinaria, o script que produziu a tabela ou a consulta que puxou os números. Uma análise da indústria de 470 pull requests descobriu que o código escrito por agentes carrega mais defetos do que o código escrito por pessoas: 10,83 problemas por mudança de autoria de IA contra 6,45 para mudanças apenas humanas, com algumas categorias de problema de segurança até 2,74 vezes mais frequentes (CodeRabbit, n.d.; estudo do fornecedor). E agentes ainda falham na maioria dos projetos inteiros: em um benchmark de projetos freelance reais, a melhor taxa de automação medida até meados de 2026 foi de 15,8% (Center for AI Safety, 2026). Tiro duas práticas disso. A verificação deve ser definida antes da tarefa ("o que me convenceria de que isso está certo?"), e um segundo modelo de uma família diferente pode atuar como revisor do artefato, com a pessoa decidindo o que conta como correto. A Seção 7 retorna aos limites da segunda prática.
5.7 Uma explicação alternativa: os agentes ainda não são bons o suficiente
Um leitor pode objetar que as pessoas não delegam porque agentes ainda não podem fazer seu trabalho, e que a barreira é portanto ainda técnica, apenas do lado do modelo. A objeção tem suporte real. Em um benchmark de projetos freelance reais, a melhor taxa de automação medida até meados de 2026 foi de 15,8%, acima dos 2,5% no lançamento do benchmark no outono anterior, o que significa que mais de quatro projetos em cinco ainda falham de ponta a ponta (Center for AI Safety, 2026). Em uma empresa de software simulada, o melhor agente completou 30% das tarefas profissionais longas (Xu et al., 2024). Em uso de computador aberto, a linha de base de 2024 foi de 12,24% para o melhor agente contra 72,36% para pessoas (Xie et al., 2024), e em setembro de 2026 um ranking de agregador para a versão verificada desse benchmark mostrou os principais agentes em 85 a 86%, acima da linha de base humana, em pontuações informadas pelo fornecedor para tarefas de desktop roteirizadas (BenchLM, 2026). Esse último resultado aponta para o outro lado: em tais tarefas, a capacidade não é mais a barreira. O melhor modelo em uma avaliação entre 44 ocupações venceu ou empatou contra profissionais em menos da metade das comparações (Patwardhan et al., 2025). O comprimento da tarefa de software que agentes completam metade das vezes tem sido dobrado aproximadamente a cada sete meses (Kwa et al., 2025), então a tendência é íngreme e o presente é modesto. A capacidade é desigual entre tarefas, e a "fronteira irregular" não é visível de fora (Dell'Acqua et al., 2026). A Tabela 4 coleta essas cifras publicadas com a data que cada fonte fornece e a ressalva que anexo.
Tabela 4. Cifras de capacidade publicadas por trás da objeção.
| Comparação | Figura conforme publicada | Data conforme declarado | Fonte | Leia com cuidado |
|---|---|---|---|---|
| Projetos freelance reais, melhor taxa de automação | 15,8%, acima dos 2,5% no lançamento do benchmark; mais de quatro projetos em cinco ainda falham de ponta a ponta | Lançamento no outono anterior; 15,8% medido até meados de 2026, registrado em 1º de julho de 2026 (Apêndice B, VERIFICADO) | Center for AI Safety (2026); Seções 5.6, 5.7, Apêndice B | Projetos inteiros, de ponta a ponta; a melhor taxa entre as medidas |
| Tarefas profissionais longas em uma empresa de software simulada | O melhor agente completou 30% | Estudo de 2024 | Xu et al. (2024); Seção 5.7 | Uma empresa simulada; uma medida separada da taxa de projeto freelance |
| Uso de computador aberto, linha de base | 12,24% para o melhor agente contra 72,36% para pessoas | Linha de base de 2024 | Xie et al. (2024); Seção 5.7 | Uma linha de base de 2024; a linha abaixo é o ranking posterior |
| Versão verificada desse benchmark | Principais agentes em 85 a 86%, acima da linha de base humana | Até setembro de 2026 | BenchLM (2026); Seção 5.7 | Ranking de agregador; pontuações informadas pelo fornecedor para tarefas de desktop roteirizadas; corta para o outro lado |
| Avaliação entre 44 ocupações | O melhor modelo venceu ou empatou contra profissionais em menos da metade das comparações | Estudo de 2025 | Patwardhan et al. (2025); Seção 5.7 | "Menos da metade" é a formulação dada; nenhuma porcentagem é declarada |
| Comprimento da tarefa de software que agentes completam metade das vezes | Dobrando aproximadamente a cada sete meses | Estudo de 2025 | Kwa et al. (2025); Seção 5.7 | Uma tendência: "a tendência é íngreme e o presente é modesto" |
| Defetos em pull requests | 470 solicitações de extração; 10.83 problemas por alteração originada em IA em comparação com 6.45 para alterações exclusivamente humanas; algumas categorias de problemas de segurança até 2.74 vezes mais frequentes | n.d. | CodeRabbit (n.d.); Seção 5.6 | Estudo de fornecedor; uma análise de indústria; defeitos em código, o mecanismo que um não-programador não consegue verificar facilmente |
Fonte: as publicações citadas, conforme repetido nas Seções 5.6 e 5.7 e Apêndice B; nenhum desses dados provém do programa da Seção 9.
As duas explicações são partes de uma explicação única mais do que são rivais uma da outra. O vocabulário de fluxo de trabalho inclui saber quais das próprias tarefas se encontram dentro da fronteira. Uma pessoa que entrega a um agente um projeto inteiro que ele não consegue fazer aprende a parar de delegar, enquanto uma pessoa que lhe entrega a extração, a reconciliação e o primeiro rascunho aprende a continuar. As explicações ainda fazem previsões diferentes. Se a capacidade do modelo fosse a restrição vinculante, a persistência nos níveis 2 e 3 rastrearia o tipo de tarefa e não a pessoa: pessoas com os mesmos tipos de trabalho persistiriam em taxas semelhantes qualquer que fosse sua capacidade de especificar e verificar. Se o vocabulário de fluxo de trabalho fosse vinculante, a persistência rastrearia a capacidade da pessoa de articular um contrato de delegação mesmo dentro do mesmo tipo de trabalho. A Proposição P15 na Seção 10 é formulada para distinguir os dois.
6. Orquestração web: a ponte proposta
6.1 A prática
A forma mais simples de nível 4 não requer instalação alguma. Uma pessoa abre três ou quatro chatbots em abas do navegador, cola a mesma pergunta em cada um e lê as respostas lado a lado. Cientistas da computação chamariam isto de uma consulta multi-LLM manual, com a pessoa realizando o roteamento e a comparação. Alguns fazem isto manualmente. Outros usam uma das ferramentas construídas para isto desde 2023: extensões de navegador e aplicações de desktop que transmitem um prompt a vários serviços de chat para consumidores e exibem as respostas em painéis paralelos. ChatHub e ChatALL apareceram na primavera de 2023; a versão mais recente do ChatALL sozinha tinha cerca de 847.000 downloads registrados em sua página de versão até setembro de 2026, uma contagem que inclui atualizações automáticas e é dominada pelas builds de uma plataforma (GitHub, 2026a). Um grupo mais novo de ferramentas transforma sessões de chat web autenticadas em comandos que outro programa pode chamar, de modo que um agente possa fazer uma pergunta às subscrições web de uma pessoa. OpenCLI, uma destas, tinha cerca de 29.500 estrelas no GitHub em setembro de 2026 (GitHub, 2026b).
Em 2026, a prática se tornou um recurso de produto. Perplexity introduziu um "Model Council" que executa uma consulta através de vários modelos e "apresenta uma visualização consolidada que destaca insights-chave, áreas de concordância e pontos de divergência" (Storyboard18, 2026). O agente de pesquisa da Microsoft no Microsoft 365 Copilot oferece um modo que "executa a mesma pergunta através de múltiplos agentes de pesquisa com raciocínio profundo (GPT e Claude) ao mesmo tempo" e um modo de crítica, ativo por padrão sob seleção de modelo automática, no qual um relatório escrito por um modelo recebe uma segunda passagem de raciocínio do outro (Microsoft, 2026c; Constellation Research, 2026b). O "LLM Council" de Andrej Karpathy, uma pequena aplicação web que envia uma consulta a vários modelos, faz com que revisem um ao outro anonimamente e tem um modelo presidente escrever a resposta final, descrito pelo seu autor como um hack de fim de semana, tinha cerca de 24.900 estrelas no GitHub em setembro de 2026 (Karpathy, 2025). O panorama de código aberto se divide em dois. As ferramentas de transmissão buscam respostas e deixam a reconciliação para a pessoa. As ferramentas de conselho reconciliam, e executam em interfaces de programação pagas com dois ou três modelos, longe das abas autenticadas próprias da pessoa. Nenhuma metade sozinha permite que uma pessoa atravesse, e é por isto que a ponte é incompleta.
6.2 Por que é proposta como a ponte
A orquestração web se situa entre os níveis de uma forma útil. Não pede nada novo da máquina, sem instalação, sem permissões, sem agente local, e funciona em subscrições que uma pessoa já paga ou em planos gratuitos. Pede algo novo da pessoa: manter várias respostas ao mesmo tempo, notar onde diferem e decidir. Uma pessoa que aprendeu a perguntar "o que o outro modelo disse?" aprendeu o hábito que a orquestração CLI mais tarde automatiza, e esse hábito é a tarefa do gerente do nível 4 em sua forma mais simples.
A ponte é valiosa porque é visível. Suponha que um analista de mercado peça a três chatbots que resumam um relatório industrial publicado, e dois deles citam uma figura que não está no relatório enquanto o terceiro sinaliza sua ausência. O resultado útil é um impulso para abrir o próprio relatório, e uma pessoa que passou por isto uma vez parou de tratar a primeira resposta fluente como a resposta. Uma visualização transmitida de várias respostas se torna uma ponte para o nível 4 quando ensina uma pessoa a formular uma pergunta comum, notar onde os pressupostos divergem, pedir uma crítica e manter uma razão para escolher uma resposta. Até então é um hábito do nível 1 com mais abas. O que ensina é comparação, e apenas comparação. Uma pessoa que aprendeu a perguntar o que o outro modelo disse não aprendeu necessariamente o que um agente pode acessar em sua máquina, que é a lição dos níveis 2 e 3, e a afirmação de que o hábito se transfere é uma questão empírica, P7, que não trato como uma premissa. O programa pré-registrado descrito na Seção 9 nomeia dois benefícios antecipadamente, e eles resumem o que a ponte oferece. Um é cobertura: um ângulo útil presente em um modelo não é perdido porque outro modelo foi consultado. O outro é confiabilidade: uma resposta foi verificada contra outras respostas em vez de ser aceita pela palavra de um modelo (Chernets, 2026d). O desacordo visível serve o segundo como um meio. Uma avaliação de previsão descobriu que um conjunto de doze modelos de linguagem igualou a precisão de um grupo de 925 previsores humanos (Schoenegger et al., 2024), e o debate multiagente melhora a factualidade e o raciocínio sobre um único modelo em vários cenários (Du et al., 2023). Ambos os benefícios dependem dos erros dos modelos divergirem, e a próxima subseção trata do que acontece quando não divergem.
6.3 Onde a ponte termina
A orquestração web permanece uma ponte, e a razão mais clara é o custo em atenção. Ler quatro respostas longas e reconciliá-las manualmente leva consideravelmente mais tempo do que ler uma. Eu não pediria a alguém que o fizesse para uma pergunta rotineira; justifica seu custo quando uma resposta errada custaria mais do que o tempo gasto em comparação.
Um segundo limite é fragilidade, e vem em várias formas. As interfaces de chat para consumidores mudam mês a mês, e ferramentas que as acionam quebram quando o fazem: ao longo do verão de 2026, uma suite de escritório removeu um modo de pesquisa, um chatbot fechou modos em seu plano gratuito, e mais de um serviço renomeou ou redirecionou seu endereço. Os termos de vários serviços para consumidores restringem o acesso automatizado, e uma pessoa que aciona seu próprio navegador autenticado com um agente corre o risco de bloqueio de conta. Um programa de pesquisa que usa a ponte tem que informar aos participantes, e não ofereço uma leitura jurídica desses termos. O lado "gratuito" dos outros chatbots também resulta em custos para o agente que os aciona, pois ações de navegador usam os mesmos limites de plano que o agente de terminal (Anthropic, 2026g). A comparação manual em abas abertas é robusta. A coleta automatizada de páginas de chat para consumidores é uma base fraca para trabalho repetível.
O terceiro limite é o que mais importa: concordância entre modelos não é evidência independente. Quando os modelos compartilham dados de treinamento e métodos, seus erros se correlacionam. Um estudo de mais de 350 modelos de linguagem descobriu que quando dois modelos cometiam erro concordavam na mesma resposta errada cerca de 60% das vezes, e que modelos maiores, mais precisos, eram mais correlacionados, inclusive entre provedores (Kim et al., 2025). O artigo complementar desta série fornece a aritmética: com correlação média de erro pareado rho, N modelos concordantes valem N_eff = N / (1 + (N - 1) rho) opiniões independentes, e nenhuma quantidade de modelos vale mais que 1/rho (Chernets, 2026a). Com rho = 0,5, dez chatbots concordantes valem menos que dois independentes. A Figura 3 traça a fórmula para os quatro valores ilustrativos de rho no Apêndice D, com o limite 1/rho que nenhuma quantidade de modelos concordantes pode ultrapassar. Os 60% de Kim et al. são a proporção de erros conjuntos em que dois modelos deram a mesma resposta errada, o que não é a correlação de erro rho da fórmula. No domínio em questão, rho deve ser estimado em itens com respostas conhecidas (listagem C4), e os valores usados aqui e no Apêndice D são ilustrações. Diversidade importa mais do que quantidade. Deliberação entre cópias de um modelo frequentemente falha em superar um modelo único com o mesmo poder de computação, enquanto modelos heterogêneos ajudam (Zhang et al., 2025), e dois agentes diversos podem igualar ou superar dezesseis homogêneos (Yang et al., 2026). A IA generativa também homogeneíza a saída entre seus usuários (Doshi & Hauser, 2024), e um modelo solicitado a julgar tende a preferir sua própria escrita (Panickssery et al., 2024), o que importa quando um modelo escreve a resposta mesclada.
Figura 3. O que a concordância vale.
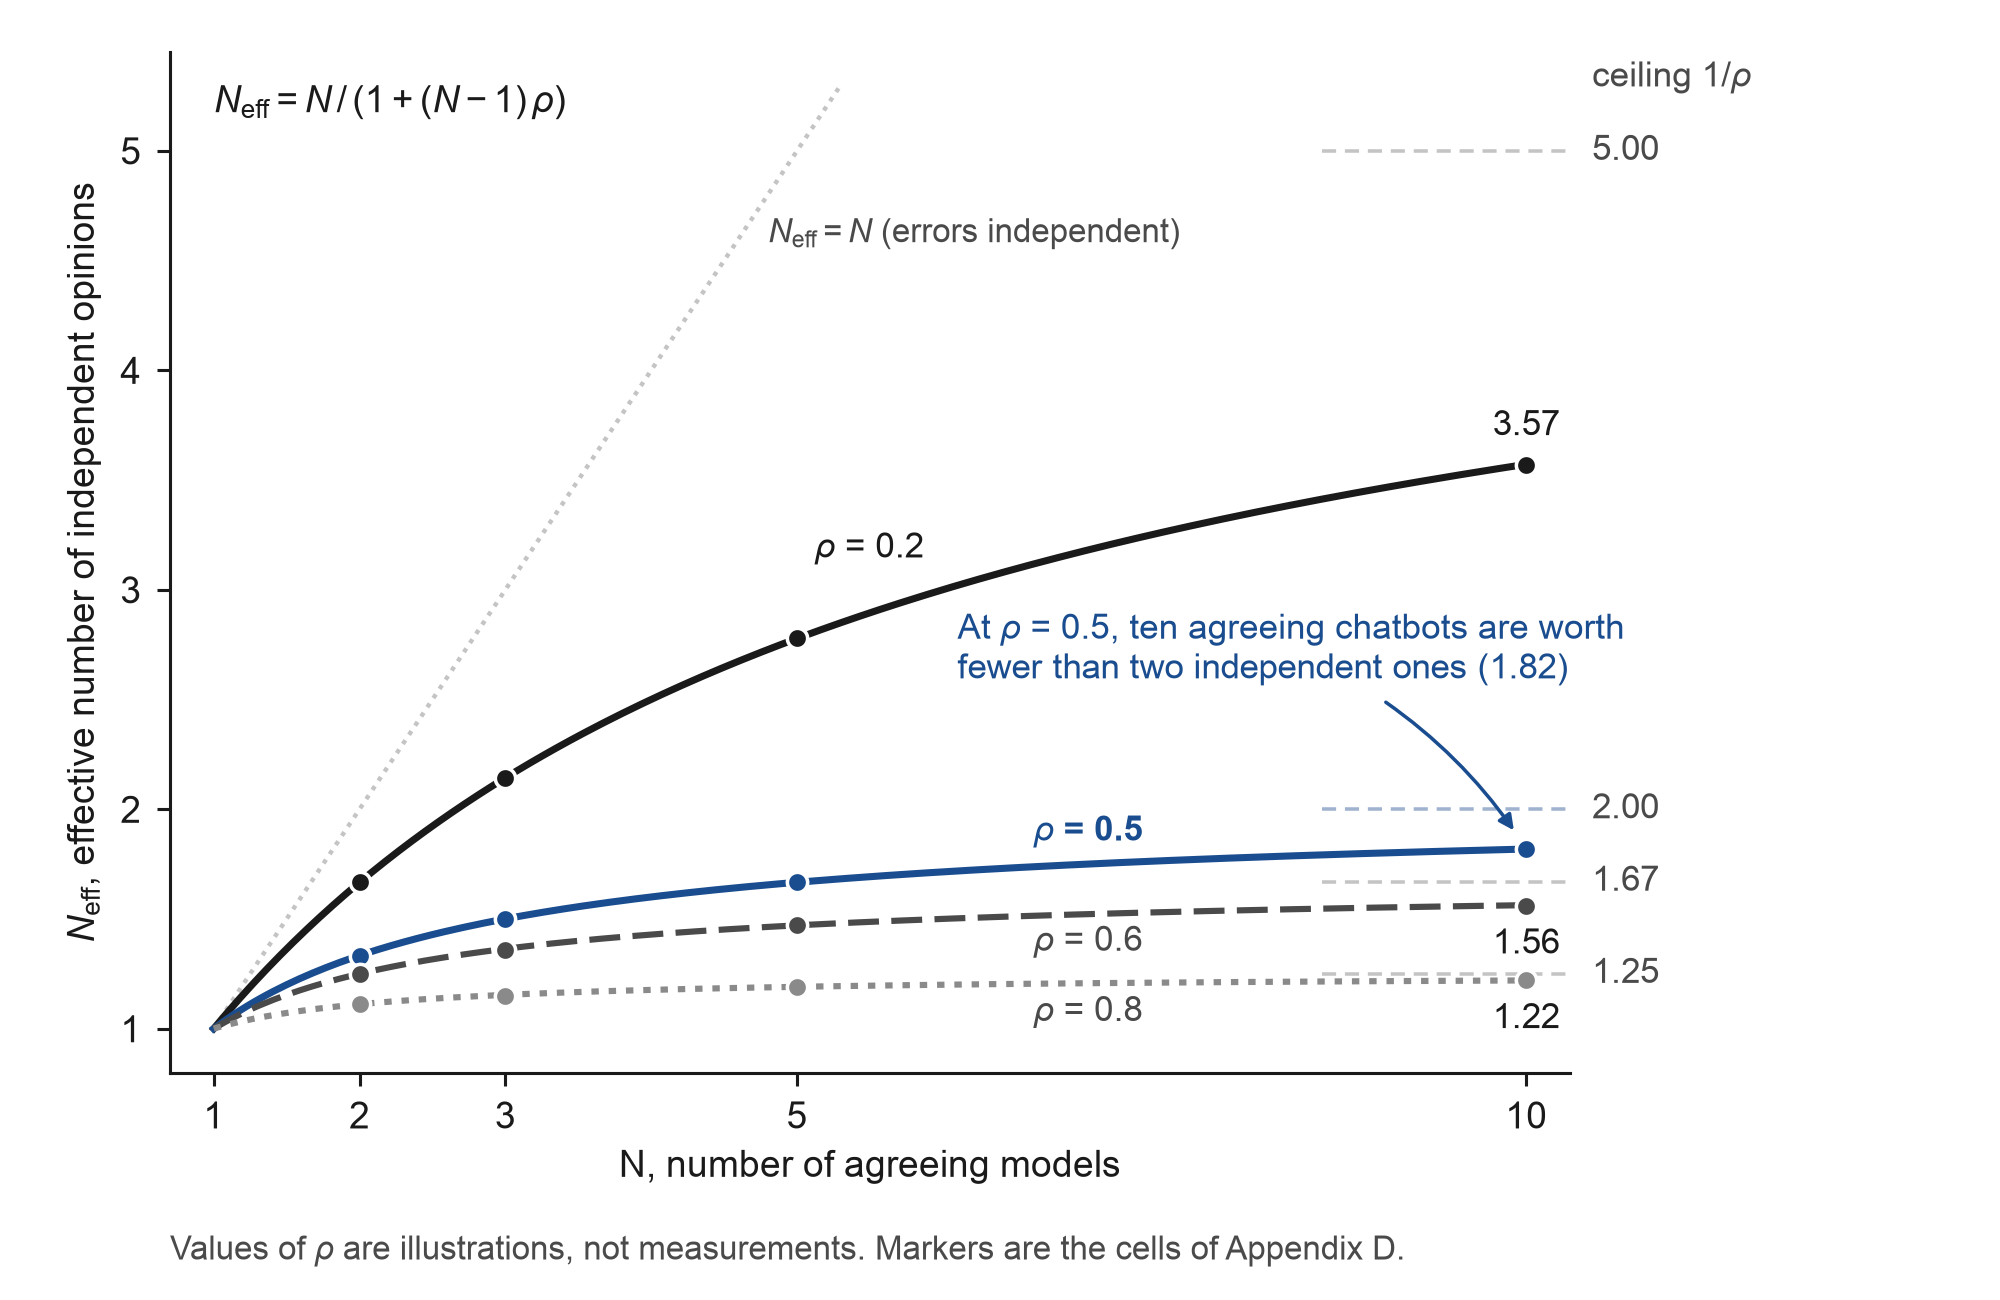
Nota: O número efetivo de opiniões independentes, N_eff = N / (1 + (N - 1) rho), para N modelos concordantes cujos erros têm correlação média pareada rho (Chernets, 2026a; Seção 6.3). Os marcadores são as células do Apêndice D, as curvas entre elas seguem a mesma fórmula, e os segmentos tracejados à direita são os limites 1/rho. Os quatro valores de rho são ilustrações, como no Apêndice D; rho deve ser estimado em itens com respostas conhecidas no domínio em questão (listagem C4).
Para a pessoa na ponte as regras práticas são breves. Conte as famílias de modelos, já que um assistente de escritório executado no modelo de um fornecedor não é uma segunda opinião sobre o chatbot daquele fornecedor. Concordância entre modelos pode lhe dizer onde gastar menos esforço de verificação. Isso não pode lhe dizer que uma afirmação está certa. Trate um ponto feito por um modelo sozinho como uma pista a verificar, porque pode ser a coisa mais valiosa na comparação ou seu único erro, e mantenha uma discordância que vem com evidência em vez de votá-la fora. Verifique as afirmações contra fontes: concordância sobre uma data errada é um modo de falha documentado, e a fonte primária o corrige onde um quinto modelo não faria. Estime rho em um pequeno conjunto de questões em seu próprio domínio que você possa marcar, antes de confiar em um conselho sobre uma questão que você não pode. Mantenha quem disse o quê, porque uma resposta mesclada que esconde suas fontes traz de volta a única voz confiante que a orquestração deveria questionar.
Escrito como um procedimento, esta é a forma de ensino do protocolo "anchor-and-enrich" do artigo complementar (Chernets, 2026a). A pessoa primeiro estabelece uma âncora: a tarefa, a evidência permitida e a forma da saída. Então obtêm respostas separadas com suas fontes ou referências de arquivo mantidas, extraem as afirmações em uma tabela por fonte, e classificam cada desacordo por seu tipo, seja um conflito factual, uma interpretação diferente, uma suposição faltante ou uma diferença de formato. Verificam as afirmações que afetam a decisão contra a âncora ou uma fonte primária, e registram a decisão de aceitação e o que permanece não resolvido. A listagem C3 no Apêndice C constrói a tabela de afirmações por fonte, a listagem C4 estima rho a partir de itens com respostas conhecidas, e o Apêndice D fornece o limite para um intervalo de rho sem executar nada. Uma regra a mais pertence aqui, e não custa uma segunda assinatura. Um crítico da mesma família, solicitado em um contexto novo para atacar a primeira resposta, detecta pressa, instruções puladas e verificações não executadas, embora não possa detectar conhecimento falso compartilhado. Eu começaria o hábito do crítico no nível 3 com um agente e adicionaria uma segunda família apenas quando o crítico não tiver nada mais a dizer e a decisão for cara.
O caso oposto precisa ser declarado tão claramente. Para muitas tarefas um modelo forte com um bom conjunto de fontes e revisão cuidadosa humana superará um conselho elaborado que adiciona atraso e confusão, e o modelo prevê tanto. Orquestração compensa quando uma tarefa carrega incerteza real, ganha de perspectivas distintas, ou se repete frequentemente o suficiente para amortizar a configuração. Funciona mal para uma decisão crítica em tempo sem chance de verificar, material confidencial que não pode ser compartilhado entre serviços, e tarefas simples onde o custo da comparação excede o benefício. Quando um conselho é usado, os agentes devem ser atribuídos a diferentes trabalhos: um restrito aos documentos fornecidos, um enviado para encontrar fontes primárias, um instruído a listar afirmações não suportadas, um para auditar citações, com a pessoa ainda tomando as decisões finais. P9 é escrito para que este contraargumento possa vencer.
7. Orquestração CLI: a camada durável de delegação
7.1 Agentes chamando agentes
No nível 3, cada agente possui uma interface de linha de comando que pode ser executada sem uma pessoa no teclado: uma pergunta entra, uma resposta ou um arquivo modificado sai. Uma vez que uma pessoa possui um agente, esse agente pode chamar os outros. Na literatura de sistemas, isso é orquestração de agentes. Chamo de orquestração CLI a versão que um não-programador executa através das ferramentas de linha de comando que já utiliza. Uma única instrução ao primeiro agente ("peça aos outros dois para revisarem este plano e me diga onde discordam") produz uma pequena equipe.
Em 2026, esse padrão passou de um truque de desenvolvedor para uma prática sancionada pelos fornecedores. A OpenAI publicou um plugin oficial que executa seu agente de codificação dentro da Anthropic, "para revisões de código ou para delegar tarefas", com comandos para uma análise ordinária, uma análise adversarial na qual o segundo agente assume que o trabalho está quebrado e procura, e um resgate de uma tarefa travada. Funciona através da ferramenta instalada localmente e seu login existente, é usável com qualquer assinatura ChatGPT, incluindo o nível gratuito, e tinha cerca de 33.400 estrelas no GitHub em setembro de 2026 (OpenAI, 2026a). O par predominante de 2026 é Claude Code escrevendo e Codex verificando através desse plugin oficial (OpenAI, 2026a), enquanto conselhos de três ou mais permanecem ferramentas pequenas sem um líder. O GitHub tornou os agentes da Anthropic e OpenAI disponíveis dentro de seu próprio serviço Copilot em fevereiro de 2026, "totalmente incluído com sua assinatura Copilot existente" (GitHub, 2026c). O agente de linha de comando da xAI fornece um modo headless e suporte para o Agent Client Protocol, de modo que os usuários possam "construir seus próprios bots e aplicativos de orquestração de agentes" (xAI, 2026). A razão pela qual o Google aposentou seu primeiro agente de linha de comando foi que os usuários "exigem múltiplos agentes se comunicando entre si" (Google, 2026). Ferramentas de código aberto que permitem que um agente consulte outros têm muitos seguidores: um servidor multiprovedor para consulta modelo-a-modelo tinha cerca de 11.800 estrelas, um plugin orientado por consenso cerca de 4.100 (GitHub, 2026d). No fundo, o Model Context Protocol, doado a um corpo da Linux Foundation em dezembro de 2025 com mais de 10.000 servidores publicados e cerca de 97 milhões de downloads de SDK mensais na época (Linux Foundation, 2025), relatou cerca de meio bilhão de downloads de SDK por mês em seu lançamento de especificação de julho de 2026, que também tornou o protocolo sem estado e prometeu doze meses de aviso antes de qualquer descontinuação (Model Context Protocol, 2026). É assim que um agente em um laptop alcança o resto das ferramentas de uma pessoa sem um plugin específico do fornecedor para cada um, e já se tornou mundano da maneira que um protocolo web é mundano: presente, documentado, ignorado até que algo quebre. Um segundo padrão, o protocolo Agent2Agent do Google para agentes se comunicando com agentes entre fornecedores, atingiu a versão 1.0 em março de 2026 (Google Open Source Blog, 2026). É infraestrutura de nível 4, e hoje não é um ponto de entrada para consumidores.
Tabela 5. O panorama de orquestração por padrão, setembro de 2026.
| Padrão | Exemplos (setembro de 2026) | Nível | Destinado a | O que oferece | Registro deixado | Risco principal |
|---|---|---|---|---|---|---|
| Comparação manual em abas do navegador | Qualquer conjunto de chatbots de consumidor | 4 (web) quando registrado e reexecutado; caso contrário, um hábito de nível 1 | Qualquer pessoa | Cobertura; hábito de comparação | Capturas de tela ou respostas copiadas, contexto frequentemente perdido | Custo de atenção; proveniência não registrada |
| Ferramentas de transmissão para chats na web | ChatHub, ChatALL | 4 (web) quando registrado e reexecutado; caso contrário, um hábito de nível 1 | Indivíduos | Um prompt, respostas paralelas, sem reconciliação | Respostas em painéis; nada em disco a menos que salvo | Quebra quando as interfaces mudam; termos de serviço |
| Conselho como recurso de produto | Conselho de Modelo Perplexity; agente de pesquisa Microsoft 365 Copilot (GPT e Claude); Conselho LLM de Karpathy | 4 (web, gerenciado) | Assinantes desses serviços | Resposta mesclada com concordância e divergência | Tudo o que o fornecedor mostra; fontes frequentemente incorporadas | Voz mesclada esconde proveniência; o escolhedor é o fornecedor |
| Chat na web exposto a agentes | OpenCLI e similares | Ponte de 4 (web) para 4 (CLI) | Usuários técnicos | Agentes podem usar assinaturas web | Arquivos, se o agente os escrever | Fragilidade; regras de acesso |
| Plugin de fornecedor: um agente delega para outro | Plugin da OpenAI para Claude Code; Claude e Codex dentro do GitHub Agent HQ (Copilot) | 4 (CLI) | Desenvolvedores, se expandindo | Revisão e delegação entre fornecedores dentro de uma sessão | Transcrição da sessão; saída de revisão | Principalmente em forma de código; quota de dois serviços |
| Conselho e servidores de consulta | Um servidor de consulta multiprovedor (último commit dezembro de 2025); plugins de consenso; pequenos conselhos de CLI que escrevem um arquivo por ferramenta | 4 (CLI) | Desenvolvedores | Várias famílias em uma tarefa; regras de consenso | Arquivos por ferramenta; uma nota mesclada | Rodadas sem fim; erros correlacionados; abandono |
| Painéis multi-agentes | Vários CLIs oficiais em painéis, cada um com sua própria cópia de trabalho, uma pessoa capaz de assumir qualquer um deles | 4 (CLI, visível) | Desenvolvedores supervisionando agentes paralelos | Supervisão tornada visível | Logs e diffs por agente | Construído para código; atenção distribuída |
| Script de fan-out com tetos de tempo | Lista C1 no Apêndice C | 4 (CLI) | Qualquer pessoa que possui um agente de nível 3 | Respostas paralelas mantidas mesmo quando uma ferramenta trava | Um arquivo por ferramenta, um resumo com quem respondeu | Precisa de uma pessoa para reconciliar |
| Agente único, tarefa escrita e reexecutada | Um arquivo de instrução ou habilidade executada em uma agenda | 3 feito repetível | Qualquer pessoa no nível 3 | Repetição quando um segundo modelo não está disponível | Arquivo de tarefa, entradas, saídas, nota de aceitação | Repetição amplifica um modelo ruim |
As linhas descrevem padrões. As contagens de estrelas no Apêndice E são um rastreamento de popularidade em um dia, e não indicam usuários, qualidade ou adequação para uma pasta de contratos. O abandono é relevante para a tabela: o servidor de consulta mais conhecido teve seu último commit em December 2025, e mais de um painel deixou de ter mantenedores ativos. Um artigo que apontasse alunos para um orquestrador único nomeado estaria fazendo-lhes um desserviço, razão pela qual os aponto para o padrão em vez disso: binários oficiais, opções não interativas, arquivos em disco e um registro de quem foi consultado.
7.2 Por que esta camada perdura
A orquestração CLI repousa sobre ferramentas próprias dos fornecedores, executadas nos modos que os próprios fornecedores documentam para automação, e isso lhe confere propriedades que uma aba do navegador não pode ter. Acima de tudo, ela pode ser escrita. Um arranjo que funcionou uma vez, digamos "draft with one model, have a second review against the checklist, give me the disagreements", pode ser salvo como um arquivo de instrução ou uma habilidade e executado novamente na próxima semana, em um cronograma se necessário. Section 3 definiu level 4 como exatamente isto: trabalho repetível direcionado entre modelos. Várias outras propriedades seguem, na ordem em que as peso. Uma opção de linha de comando é uma interface documentada e um código de saída é uma promessa; uma posição em uma página web não é nenhuma delas, razão pela qual ferramentas que direcionam páginas de chat do consumidor precisam ser reparadas sempre que a página muda. Cada ferramenta oficial é executada sob o próprio login do fornecedor, com a caixa de proteção e regras de negação desse fornecedor, então a pessoa pode manter segredos fora da pasta, negar rede por padrão e recusar comandos destrutivos por ferramenta, enquanto um agente de navegador que consegue ver cada aba é um objeto de permissão maior. O padrão usa logins do consumidor que a pessoa já paga, e espero que, mais do que qualquer coisa, separe uma prática que um não-programador mantém de uma que experimentam uma vez. E os fornecedores a abençoam. O plugin oficial, os agentes dentro do serviço do GitHub, os modos sem interface gráfica e o padrão de habilidades são sinais de que a delegação entre ferramentas está sendo padronizada, enquanto a automação de páginas de chat do consumidor está sendo abandonada.
A orquestração web pode ensinar o hábito da comparação, e a orquestração CLI é onde o hábito pode ser mantido como um objeto. O objeto é uma pasta que contém a atribuição, as entradas permitidas, as saídas, um registro de qual agente produziu o quê, e uma nota do que foi aceito. Outra pessoa pode inspecioná-lo sem reproduzir uma conversa privada, e a pessoa que o fez pode mudar uma entrada na próxima semana e ver a diferença. Esse registro também torna a responsabilidade mais difícil de evitar, já que uma atribuição salva e uma nota de aceitação expõem um conjunto de origem inadequado ou uma aprovação ausente. Em escritórios acostumados com chat informal, parecerá um fardo, e onde quer que o trabalho tenha de ser verificado, repassado ou repetido, é um ativo. A proporcionalidade determina qual: uma solicitação de dois minutos não precisa de uma pasta de fluxo de trabalho, enquanto uma tarefa recorrente que envolve arquivos compartilhados pode.
A maioria do que existe é moldada pelo código. Os plugins oficiais, os servidores de conselho e os gerenciadores multi-agente visam à revisão de software, embora nada no próprio padrão seja específico ao código.
7.3 O que a camada pede à pessoa
Uma pequena equipe de agentes precisa de um gerente, e o trabalho do gerente é específico. Chamo suas quatro partes de contrato de delegação:
- Meta: para que serve o trabalho, declarado de forma que um agente possa dizer se foi alcançado.
- Limite: o que os agentes podem tocar e o que não podem, quais ações precisam de confirmação de uma pessoa, e qual orçamento em tempo e cota a tarefa pode gastar.
- Artefato: o que deve existir quando o trabalho terminar, e em que forma.
- Verificação: como a pessoa saberá que o artefato está correto, decidido antes do trabalho começar, quem revisa o quê, e quando parar.
A quarta parte traz uma armadilha descrita no artigo complementar sobre supervisão automatizada (Chernets, 2026b). Adicionar um revisor é barato, e todo revisor encontra algo. Um conselho sem uma regra de parada tende a adicionar rodadas e críticos até que o trabalho seja enterrado em revisão. Uma regra prática é permitir uma rodada de crítica e uma rodada de correções por etapa, com a pessoa decidindo se uma descoberta bloqueia o trabalho. A regra tem um preço medido: em um teste aleatorizado de 144 execuções relatado naquele artigo, um orçamento de uma rodada reduziu rodadas de crítica de 2.86 para 1.00 por execução enquanto aumentava defeitos perdidos em 0.11 por execução (95% confidence interval 0.005 to 0.204) (Chernets, 2026b). Se esse compromisso vale a pena depende do que está em jogo, que é exatamente o tipo de decisão que pertence ao gerente. Limites em rodadas e tempo são orçamentos, e um orçamento determina quando parar, o que é uma pergunta diferente de se a resposta é verdadeira.
O contrato reafirma o que a boa delegação a pessoas sempre exigiu, para um público que nunca delegou a software, e não apresenta nenhuma nova teoria de gestão. Seu valor é que cada parte pode ser ensinada, escrita e verificada, e que cada parte falha de modo visível quando está ausente.
8. De operador a gerente
8.1 O que muda no trabalho
No nível 1, a pessoa produz e o modelo auxilia. Nos níveis 3 e 4, o modelo produz e a pessoa dirige, supervisiona e aceita. As ironias da automação de Bainbridge (1983) previram o que isso faz ao papel humano. A automação remove a rotina e deixa à pessoa o resíduo que é mais difícil de fazer bem, monitorar e intervir em falhas raras, enquanto a prática que construiu seu julgamento desaparece. A versão de IA gerativa da ironia já está documentada. A IA gerativa desloca as pessoas de produzir para avaliar e torna tarefas difíceis ainda mais difíceis (Simkute et al., 2024), maior confiança na ferramenta vai junto com menos pensamento crítico (Lee et al., 2025), e a desqualificação segue estruturalmente da remoção da prática (Ferdman, 2025).
Gerenciar um agente é, portanto, um trabalho diferente com sua própria competência, e a competência não vem de graça com a ferramenta. Consiste em escolher o que delegar, declarar o contrato de delegação da Seção 7.3, ler um rastreamento do agente e decidir quando o resultado é suficientemente bom. Divido o trabalho em quatro práticas. Delegação nomeia o trabalho como um entregável com um limite. Supervisão observa o plano, a saída intermediária ou o rastreamento da ferramenta e intervém quando a tarefa se desvia, sem aprovar cada pressionamento de tecla, porque aprovar tudo é fadiga e fadiga é como as pessoas clicam sim. Verificação verifica fontes, somas, transformações e as reivindicações em que uma decisão se baseia, proporcionalmente ao risco e por um método diferente de reler a própria confiança do agente: testes e diffs para código, uma verificação pontual contra uma página que a própria pessoa abre para uma pasta de contratos, e para uma tabela de literatura uma verificação linha por linha dos identificadores. Revogação estreita o espaço de trabalho, interrompe uma execução ou remove acesso quando uma condição muda. Uma pessoa que faz todos os quatro está gerenciando um agente mesmo através de um aplicativo de desktop gráfico. Uma pessoa que entrega uma tarefa a um serviço opaco e aceita a primeira resposta está terceirizando julgamento, que é uma prática diferente. Parasuraman e Riley (1997) nomearam os dois modos de falhar nisso. Desuso é a pessoa que poderia delegar e nunca faz, presa ao nível 1 por hábito ou medo. Uso indevido é a pessoa que delega sem verificações e aceita o que volta. Ambos são visíveis em 2026. Os dados de adoção ampla e rasa descrevem desuso em escala (Seção 2.2), e os relatórios de perda de arquivo e exclusões de banco de dados da Seção 5.3 descrevem uso indevido, às vezes por profissionais que sabiam melhor. A Tabela 6 coloca cada prática ao lado da parte do contrato de delegação que ela executa, do risco que ela enfrenta e do rastreamento datado pelo qual um estudo pode ver que isso aconteceu.
Tabela 6. As quatro práticas do gerente: o que cada uma executa, o risco que enfrenta e o rastreamento que deixa.
| Prática | O que a pessoa faz | Parte do contrato que executa | Risco se está faltando | Rastreamento observável |
|---|---|---|---|---|
| Delegação | Nomeia o trabalho como um entregável com um limite (8.1) | Objetivo, declarado para que um agente pudesse dizer se foi alcançado; artefato: o que deveria existir e em que forma (7.3) | Desuso: "a pessoa que poderia delegar e nunca faz", presa ao nível 1 por hábito ou medo (8.1) | Um artefato depositado (Apêndice A) |
| Supervisão | Observa o plano, a saída intermediária ou o rastreamento da ferramenta; intervém quando a tarefa se desvia, sem aprovar cada pressionamento de tecla (8.1) | Limite: o que os agentes podem tocar; quais ações precisam de confirmação de uma pessoa; qual orçamento em tempo e cota (7.3) | Fadiga de aprovação: "fadiga é como as pessoas clicam sim" (8.1); uma proteção que bloqueia demais produz desuso (5.3) | Um plano recusado; um passo irreversível mantido para confirmação (Apêndice A) |
| Verificação | Verifica fontes, somas, transformações e as reivindicações em que uma decisão se baseia, por um método diferente de reler a própria confiança do agente (8.1) | Verificação: como a pessoa saberá se o artefato está certo, decidido antes do trabalho começar; quando parar (7.3) | Uso indevido: "a pessoa que delega sem verificações e aceita o que volta" (8.1); erros correlacionados entre modelos (6.3) | Um diff ou saída rejeitada; uma segunda família de modelo solicitada; um denominador registrado: solicitado, respondido, expirado (Apêndice A) |
| Revogação | Estreita o espaço de trabalho, interrompe uma execução ou remove acesso quando uma condição muda (8.1) | Limite, aplicado novamente: o que é mantido fora e como desfazer um erro (3.2, 7.3) | Uma tarefa longa que não pôde ser interrompida, após a qual deletar a tarefa deletou os arquivos (5.3) | Nenhum entre os rastreamentos datados do Apêndice A; uma parada datada, permissão reduzida ou acesso removido serviriam |
Nota: Uma pessoa que entrega uma tarefa a um serviço opaco e aceita a primeira resposta está "terceirizando julgamento", que é uma prática diferente (8.1).
Um pequeno dispositivo mantém o papel unido em todas as quatro práticas, e o chamo de registro de aceitação. Para uma tarefa consequente ou recorrente, ele contém o entregável pretendido, os insumos utilizados, as restrições e permissões, para onde a saída foi, qualquer discordância material ou falha, as verificações realizadas e a decisão da pessoa de aceitar, revisar, escalar ou descartar. Ele traça uma linha entre o que o agente produziu e em que a pessoa se baseou. Para o indivíduo é útil porque transforma um sentimento de confiança em uma decisão verificável, para um time porque um colega pode inspecionar o trabalho sem um histórico de chat privado, e para um pesquisador porque separa uma execução completa de um resultado em que se confiou. É também um freio. Uma pessoa pode decidir, depois de não conseguir escrever um critério de aceitação, que a tarefa deveria permanecer no nível 1, e o modelo conta isso como gerenciamento maduro em vez de adoção defasada. No vocabulário de colaboração humano-IA, o movimento do nível 1 para o nível 4 mantém o humano no loop e muda o que o loop é, de ler cada resposta para estabelecer os termos em que as respostas são aceitas. A Figura 4 desenha esse loop com as quatro práticas, o risco em cada etapa, o retorno após uma verificação falhada e o registro de aceitação.
Figura 4. O loop de controle do gerente.
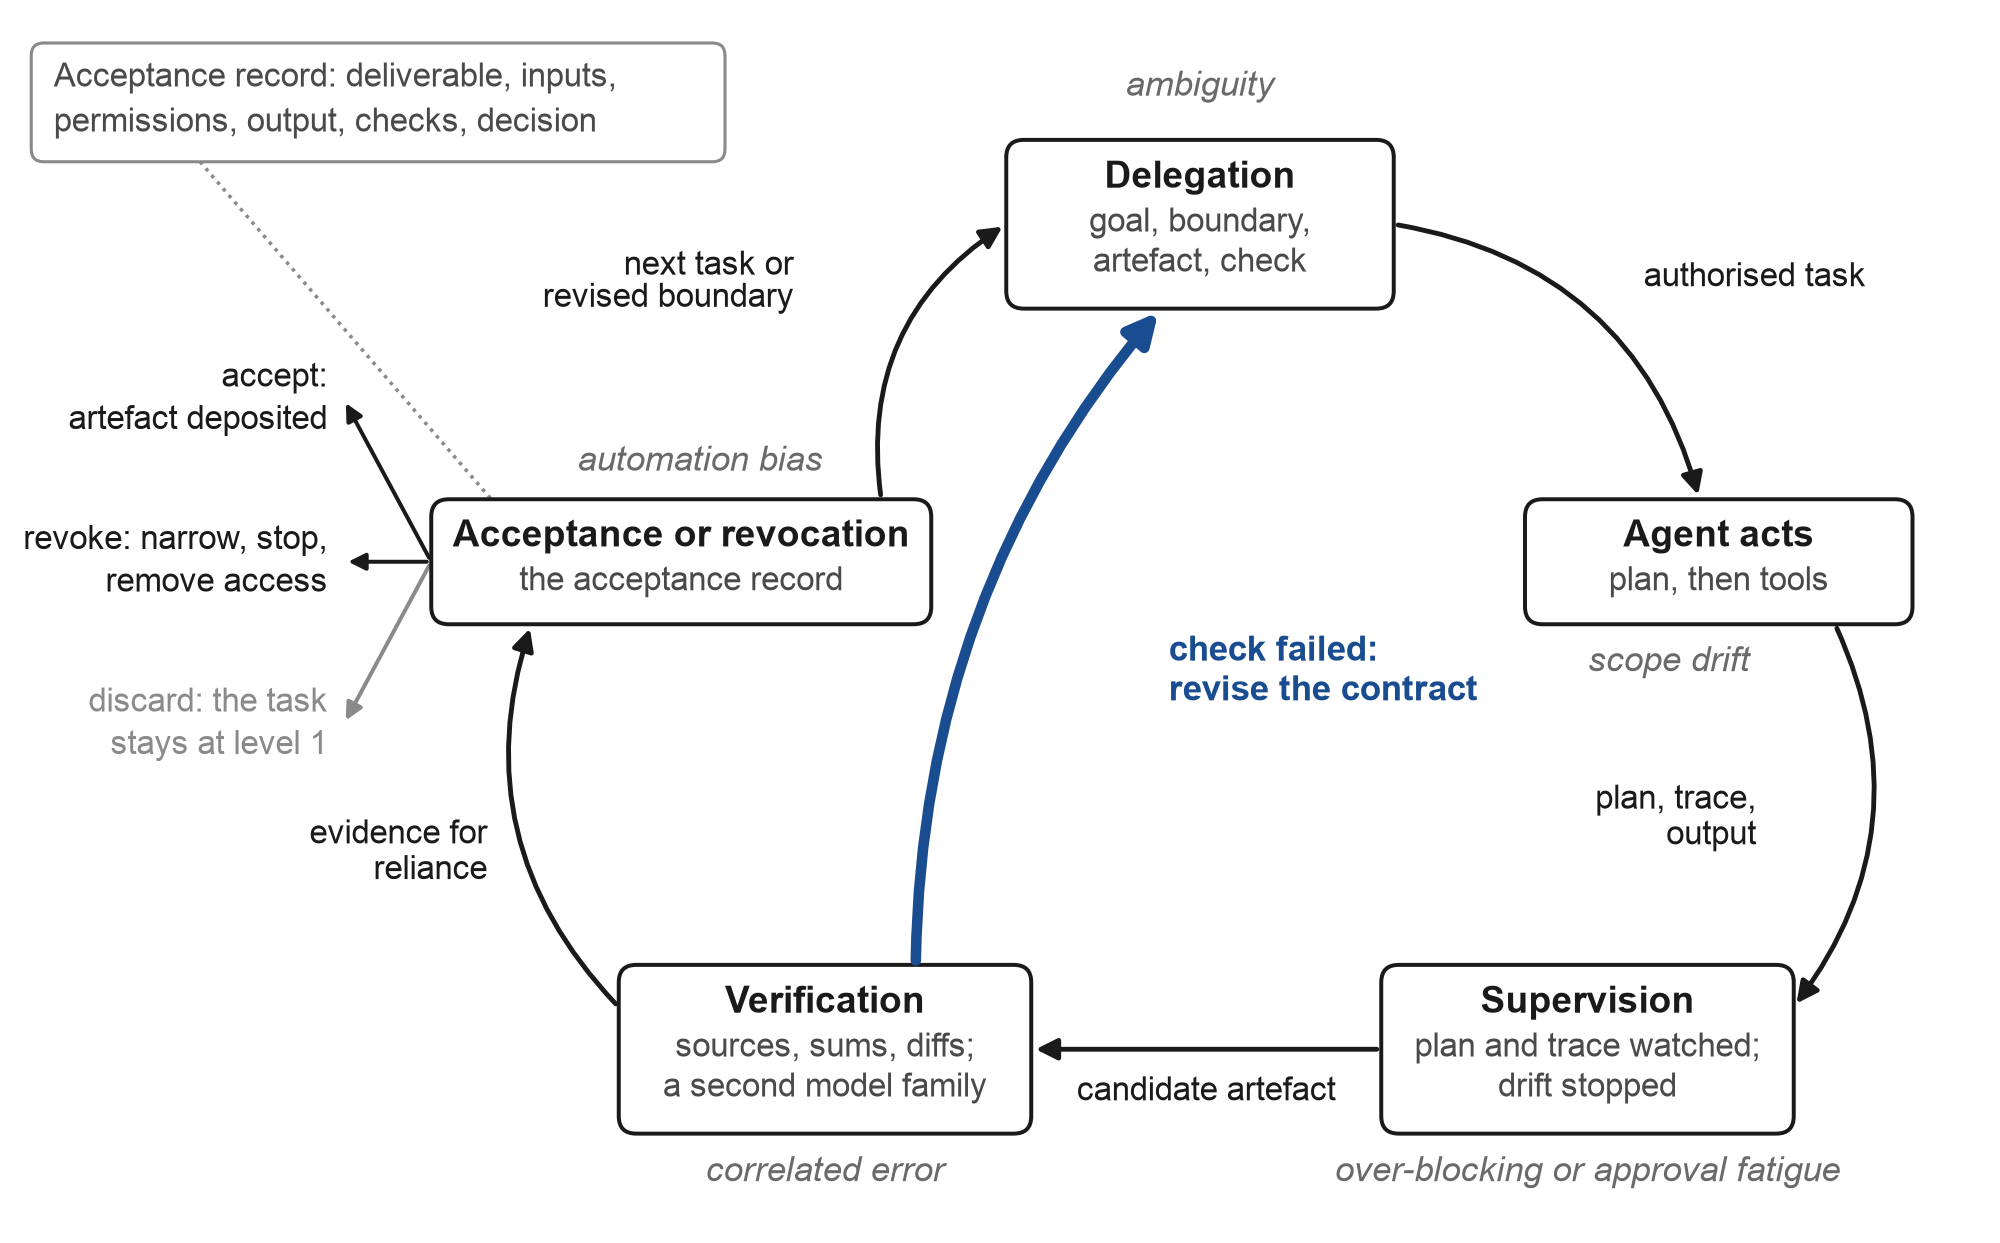
Nota: O trabalho do gerente como um loop que a pessoa executa (Seções 7.3 e 8.1): a delegação estabelece o contrato (objetivo, limite, artefato, verificação), o agente age, a pessoa supervisiona e verifica, e então aceita, revoga ou descarta o resultado e escreve o registro de aceitação. Os rótulos em itálico cinza nomeiam o risco em cada etapa (Seções 5.3, 6.3 e 8.1). A seta grossa é o retorno de uma verificação falha para um contrato revisado, e toda saída do nó de aceitação é uma decisão da pessoa.
8.2 Usuários experientes delegam menos
Uma observação vai contra qualquer narrativa simples em que todos deveriam acabar como gerentes de agentes. O Anthropic informou em março de 2026 que usuários com maior tempo de permanência eram "much less likely to delegate greater responsibility through directive use patterns" (Anthropic, 2026e), e seu relatório de janeiro de 2026 colocava aumento, uso colaborativo em que a pessoa permanece no loop, em 52% das conversas em novembro de 2025 (Anthropic, 2026f). Uma interpretação é que usuários experientes aprenderam onde a delegação falha e recuaram. Outra é que aprenderam a usar o modelo como um colaborador para as partes do trabalho em que seu próprio julgamento é o produto. Não consigo distinguir as duas interpretações a partir dos números publicados, e em qualquer uma delas o ponto final da escada é algo diferente de delegação máxima. É a capacidade de escolher, tarefa por tarefa, entre pedir, colaborar e delegar, e saber qual tarefa diante de você necessita. O modelo de quatro níveis descreve o que uma pessoa pode fazer. Não afirma que deveriam fazer a coisa mais delegável a cada vez.
8.3 A responsabilidade permanece com a pessoa
Os fornecedores deixam claro onde a responsabilidade repousa. A orientação de lançamento do agente de nível 2 do Anthropic informou aos usuários que eles "remain responsible for all actions taken by Claude performed on your behalf" (The Register, 2026). Esta é a realidade legal e prática do nível 3 em particular, onde o agente age com as credenciais do proprietário, nos arquivos do proprietário, sob o nome do proprietário. Um profissional que se torna gerente de um agente também se torna responsável por um trabalhador cujos erros são rápidos. É mais uma razão para que a verificação no contrato de delegação tenha de ser decidida antes do trabalho, e mais uma razão para que o design de segurança da Seção 5.3 não dependa de a pessoa detectar um ataque em tempo real.
8.4 O papel do gerente nos marcos de alfabetização
As definições oficiais de alfabetização em IA estão começando a nomear esse papel, embora nenhum dos textos analisados aqui use a palavra "agente". O AI Literacy Framework do Departamento do Trabalho dos EUA, de fevereiro de 2026, lista "directing AI effectively" entre suas áreas de conteúdo (US Department of Labor, 2026; ExecutiveGov, 2026). O marco conjunto da OECD e da Comissão Europeia de junho de 2026, que alimenta a avaliação PISA 2029, tem quatro domínios, um dos quais é "Manage AI" (OECD & European Commission, 2026). Marcos acadêmicos anteriores enfatizaram reconhecer, compreender e avaliar IA (Long & Magerko, 2020), e os marcos de competência de 2024 da UNESCO para estudantes e professores estabelecem o mesmo registro (UNESCO, 2024a, 2024b). O contrato de delegação oferece aos domínios de gerenciamento e direcionamento um conteúdo ensinável para o caso agêntico: estabelecer um objetivo, delimitar o trabalho, nomear o artefato, decidir a verificação. Os profissionais começaram a usar títulos como "AI operator" e "agent manager" para um profissional que adquire essa especialidade além de sua profissão. Uso "manager of agents" mais estritamente, para um padrão de comportamento em vez de um papel para o qual alguém deveria contratar, porque o comportamento deixa evidência e um título não. A evidência está nos artefatos: um plano que a pessoa recusou, um diff que rejeitaram, uma segunda opinião que adotaram, uma execução agendada que terminou enquanto estavam longe do teclado. Onde nenhum desses rastros existe, o título não tem nada por trás.
9. Medindo os cruzamentos: um programa pré-registrado
9.1 Cruzamentos como unidade de medida
A maioria dos dados de adoção contam pessoas que "usam IA", às vezes semanalmente ou diariamente. Uma contagem desse tipo não consegue diferenciar uma pessoa que pede a um chatbot sinônimos de uma pessoa que delega um relatório trimestral a um agente, e é a segunda pessoa que quero encontrar. A regra do artefato da Seção 3.3 torna a diferença observável, pois um cruzamento é registrado apenas quando o agente produziu algo que a pessoa pediu, em novo nível. Várias outras regras decorrem da literatura sobre integração e supervisão. A conclusão deve ser comunicada separadamente para pessoas que cruzaram sem ajuda e pessoas que foram ajudadas, porque a ajuda muda o que um cruzamento significa. Uma parada deve ser registrada no ponto em que aconteceu e nas próprias palavras da pessoa, porque as razões para parar são uma grande parte do resultado. Toda pessoa que recebeu os materiais faz parte do denominador, incluindo aquelas que nunca responderam. A persistência, finalmente, deve ser observada depois que o pesquisador deixou de escrever toda semana; um artefato produzido enquanto o pesquisador ainda está na caixa de entrada de uma pessoa pode ser cortesia tanto quanto uso.
9.2 O desenho
Executo um programa de coorte pré-registrado que aplica essas regras a não-programadores (Chernets, 2026d; OSF, https://osf.io/x4egq, DOI 10.17605/OSF.IO/X4EGQ, registrado e congelado em 6 de setembro de 2026). É um estudo de viabilidade de braço único de uma trajetória de três etapas, e o pré-registro foi congelado antes de qualquer dado ser coletado. O que se segue é o desenho tal como registrado.
Participantes. Adultos cujo trabalho ocorre substancialmente em um computador. Eles usam sua própria máquina e suas próprias assinaturas de IA (assinaturas de empregadores são excluídas), mantêm material de identificação do cliente e confidencial do empregador fora do exercício, e confirmam que a instalação de software não viola uma regra que seu empregador lhes aplica. O recrutamento é por anúncio público em redes sociais profissionais dentro de uma janela determinada com antecedência por tempo, de modo que não possa ser estendida até que um resultado pareça favorável. O anúncio é capturado em screenshot e seu link permanente registrado, o que fixa o texto de recrutamento. A entrada é contínua e o cronograma de cada participante conta a partir de seu próprio dia zero, porque as ferramentas mudam em escala semanal. O recrutamento abriu com o anúncio público em 6 de setembro de 2026, o dia em que o registro foi congelado, e fecha 21 dias depois, em 27 de setembro de 2026; a coorte está em campo no momento da redação, e o número realizado, seja qual for o resultado, será informado com os resultados.
Etapa 1 (de chat a um agente no computador pessoal da pessoa). O participante cola um texto padrão no chatbot que já usa, e esse chatbot o guia através da instalação de um agente gráfico em sua própria máquina. Eu não toco no computador de ninguém. A etapa está completa quando o participante fornece um artefato que o agente produziu em resposta a uma primeira tarefa. A tarefa tem forma idêntica para todos e é preenchida com a situação de trabalho pessoal do participante, e requer que o agente pergunte, decida, crie e formate arquivos. Esse requisito separa um agente de um chatbot. O registro fornece a redação exata (Chernets, 2026d). Em termos do modelo, a Etapa 1 testa integração reflexiva em dois níveis de uma vez, do nível 1 ao nível 3. Essa foi uma escolha deliberada. Um shell gráfico de um agente local é executado no computador pessoal da pessoa, portanto, pela regra da Seção 3.3, é o nível 3, e o artefato que a Etapa 1 pede é do tipo que marca a transição 2; seus prompts de permissão lhe conferem alguma proteção de um degrau com escopo. A coorte não instrui uma semana separada em um ambiente de nível 2 isolado pelo fornecedor, então não pode testar P5 da Seção 10 (que um degrau intermediário com escopo reduz não-conclusão e incidentes); esses prompts de permissão são o único degrau com escopo que o desenho tem, e a linha de comando entra na Etapa 3. Uma coorte posterior que insira uma semana de nível 2 explícita entre chat e uma instalação local seria o teste limpo de P5.
Etapa 2 (para orquestração web, lançada a partir do agente). Uma vez prontos, os participantes recebem uma ferramenta de código aberto que coloca uma questão para vários modelos através das assinaturas que já pagam e retorna uma resposta mesclada, em uma única ação de dentro do agente. O objetivo da etapa foi registrado com antecedência como cobertura e confiabilidade, com desacordo visível como um mecanismo para o segundo.
Etapa 3 (para orquestração CLI). A mesma orquestração através de interfaces de linha de comando.
Medidas. Cinco itens principais congelados, formulados identicamente em cada coorte do programa, registram profissão e horas em um computador, uso atual de IA, experiência anterior de fazer perguntas a mais de uma IA, se e como as respostas são verificadas, e se algo já age pela pessoa em seu computador. Um registro de etapa para cada participante contém as datas, o chatbot que o guiou, tentativas e horas, conclusão com o artefato, o ponto exato de parada e o motivo em suas próprias palavras, e se e como o pesquisador interveio. Semanalmente durante o primeiro mês, os participantes relatam um artefato que seu agente produziu naquela semana (ou "nada", que é uma resposta válida), quantas vezes colocam uma questão para mais de uma IA e o que aconteceu quando as respostas divergiram, e a partir da Etapa 2 em diante se algo útil surgiu que um modelo não havia detectado e se a verificação mudou o que eles confiavam. Observações continuam no dia 60 e trimestralmente depois disso, enquanto os participantes estiverem dispostos.
Análise e interpretação. A análise é descritiva. As proporções de conclusão são dadas com intervalos de confiança contra o denominador sobrevivente e o denominador completo, separadamente para conclusão sem ajuda e conclusão assistida; tempos e tentativas são relatados como distribuições, e motivos para parar são codificados após a coleta, com códigos e redação bruta depositados. Uma regra de interpretação foi fixada com antecedência. Se menos da metade daqueles que receberam os materiais da Etapa 1 fornecerem um artefato produzido por agente, a coorte é relatada como um estudo de falha de integração, e o que parou as pessoas torna-se o resultado.
Limites de inferência. O registro afirma com antecedência que não há condição de controle e, portanto, nenhuma reivindicação causal, e nenhuma generalização além de voluntários auto-selecionados. A estimativa de tempo economizado de um participante é relatada apenas como crença, porque auto-relato neste domínio foi demonstrado inverter a direção verdadeira (Becker et al., 2025).
Divulgação e ética, conforme registrado. Os participantes são informados por escrito que escrevi os materiais e a ferramenta, os ensino, e sou candidato em solicitações de patentes pendentes cobrindo o método de orquestração. Nenhuma opinião do comitê de revisão institucional foi solicitada: não há afiliação institucional por trás do estudo e nenhum financiamento federal. O registro, em vez disso, declara as salvaguardas. O consentimento é obtido por escrito antes de qualquer coisa ser registrada. Nenhum dado de saúde, financeiro ou de conteúdo de trabalho é coletado. Os participantes trabalham em suas próprias máquinas e assinaturas e podem solicitar exclusão em qualquer momento até o depósito público. As instruções de segurança incluem um perfil de navegador separado, nenhuma ação em sites bancários ou de saúde, confirmação antes de qualquer ação irreversível, nenhuma senha digitada no agente e conteúdo da web tratado como dados. Nenhuma variável de deficiência é coletada e nenhuma alegação de acessibilidade é feita.
9.3 Apenas o projeto
Do programa extraio apenas o projeto e nada mais. Nenhum número de participantes, taxas de conclusão ou casos individuais aparecem aqui, por decisão deliberada: o argumento (este artigo), o método e programa, e os resultados após o período de observação do protocolo são publicações separadas, para que o argumento não possa ser lido como evidência para si mesmo. Outros pesquisadores podem agora aplicar as mesmas regras. A Listagem C5 no Apêndice C fornece um formato de registro e um verificador que os codificam. O verificador recusa um registro que conta uma instalação como um cruzamento, uma conclusão sem um artefato produzido pelo agente, uma parada sem as próprias palavras da pessoa, um nome real no lugar de um rótulo pseudônimo, um campo que o formato não conhece, ou um nível ignorado que não é registrado exatamente como ignorado.
9.4 Como deve ser um próximo estudo sólido
A coorte é um estudo de viabilidade, e a maioria das proposições da Seção 10 precisa de outros delineamentos. Um próximo estudo sólido compararia duas condições de integração que diferem em como representam o trabalho, mantendo o risco da tarefa e o ambiente técnico tão constantes quanto possível. Uma condição apresenta recursos e instruções de instalação; a outra começa com o próprio objeto de trabalho recorrente do participante e elicia o mapa de cinco partes da Seção 5.1. Os desfechos incluiriam artefatos, cuja qualidade seria avaliada por alguém diferente do participante (com concordância entre avaliadores relatada, como para a codificação das razões de parada), tempo, erros descobertos, decisões de permissão em forma de cenário, reutilização voluntária posterior e confiança medida em relação aos resultados. Um acompanhamento separaria a persistência do contato contínuo com o pesquisador. Um segundo estudo perguntaria se o vocabulário de fluxo de trabalho é uma gramática ou uma por profissão, comparando tarefas administrativas, de pesquisa, de comunicações e analíticas. Não sei qual é, e a resposta decide se os exemplos empacotados podem ser escritos uma única vez ou devem ser escritos para cada campo. Ambos os estudos devem medir a alfabetização em IA como linha de base usando um instrumento validado (Carolus et al., 2023), de modo que a lacuna específica – saber o que entregar a um agente – possa ser separada da familiaridade geral com IA. Cada um desses estudos deve também documentar a implementação, porque um participante que inicia em uma interface posterior encontra diferentes padrões: a versão da interface, o sistema operacional, se o agente tinha acesso à rede, o modo de permissão e qualquer restrição de política. O nome do fornecedor sozinho diz muito pouco a um leitor posterior.
10. Proposições
O modelo da Seção 3 e o argumento das Seções 4 a 8 implicam afirmações que podem falhar. A Tabela 7 apresenta quinze delas, cada uma com uma medida, um resultado que a refutaria e quem está posicionado para executar o teste. Elas são escritas para o campo como um todo. O programa da Seção 9, por exemplo, pode testar apenas alguns; vários outros podem ser testados com telemetria de fornecedores, com painéis de pesquisa ou com um pequeno estudo em uma organização. Nenhum é uma descoberta da coorte.
Tabela 7. Proposições, medidas, refutadores e quem pode testá-los.
| # | Proposição | Medida | Refutado se | Quem pode executá-lo |
|---|---|---|---|---|
| P1 | Migração de barreiras. Entre não-programadores que tentam a transição 2, as paradas se agrupam após a instalação (na primeira tarefa, no primeiro erro ou em permissões) mais do que durante ela, e entre aqueles que instalaram e não produziram nada, "Não sabia o que perguntar" supera as razões técnicas, de permissões e de custo; e, mantendo a dificuldade da tarefa constante, a conclusão cai mais drasticamente nas três transições do que dentro de um nível. | Pontos de parada registrados com a regra do artefato; razões nas próprias palavras da pessoa, codificadas pela regra do Apêndice A; conclusão por etapa | A maioria das paradas ocorre antes do agente ser executado pela primeira vez, ou razões técnicas e de permissões dominam entre não-produtores instalados, ou os padrões de conclusão e falha são comparáveis em todas as etapas uma vez que a dificuldade da tarefa é controlada | O programa da Seção 9; qualquer replicação |
| P2 | Fusão de superfícies. Quando fornecedores mesclam superfícies de chat e agente, a proporção de sessões que terminam em um arquivo ou ação produzida por agente aumenta sem qualquer mudança no que os usuários dizem que querem fazer; e os principais assistentes escrevem arquivos da janela padrão sem um modo escolhido pelo usuário até o final de 2027. | Telemetria de fornecedores antes e depois de uma fusão; um censo datado dos assistentes | A proporção permanece plana após uma fusão; ou um modo de agente estável e escolhido pelo usuário permanece um pré-requisito para escrever arquivos | Fornecedores; qualquer pessoa que possa abrir os aplicativos |
| P3 | Vocabulário sobre instalação. Dar às pessoas exemplos trabalhados de seu próprio campo (tarefas empacotadas, habilidades, modelos) aumenta a persistência nos níveis 2 e 3 mais do que fornecer ajuda de instalação, e uma medida estruturada do vocabulário de fluxo de trabalho prevê a conclusão do artefato após o acesso e o uso anterior de IA serem controlados. | Persistência no dia 60 sob os dois tipos de ajuda, em uma comparação com a tarefa; uma declaração pré-tarefa das cinco partes da Seção 5.1; razões de parada codificadas pela regra do Apêndice A | A ajuda de instalação produz persistência igual ou maior; a medida de vocabulário não adiciona nada depois que a facilidade de instalação e a confiança genérica estão no modelo | Qualquer laboratório com duas rotas de integração |
| P4 | Integração reflexiva. Pessoas orientadas pelo chatbot que já usam podem passar do nível 1 para o nível 3 sem ajuda a uma taxa que torna a rota prática, e alcançar um primeiro artefato mais cedo do que pessoas que recebem documentação estática. | Proporção completando a transição 2 sem ajuda com um artefato produzido por agente, em relação a todos que receberam os materiais; tempo para o primeiro artefato sob condições guiadas e estáticas | Menos da metade o completa, o limite estabelecido antecipadamente na Seção 9; ou a documentação estática fornece conclusão igual ou superior | O programa da Seção 9; treinadores com duas coortes |
| P5 | O degrau do meio. Não-programadores que passam tempo em um ambiente cercado por fornecedor antes de um agente local completam a transição 2 mais frequentemente, têm menos incidentes de perda de arquivo e raciocinam melhor sobre escopo, reversibilidade e escalação do que pessoas movidas diretamente de chat para acesso local amplo. | Coorte de duas rotas com acompanhamento igual; artefato como o resultado primário; um log de incidentes; decisões de permissão baseadas em cenários antes e depois | Conclusões sem ajuda de chat direto para um agente local correspondem às que passaram pelo nível 2, com taxas de incidentes comparáveis e com decisões de permissão iguais | Qualquer laboratório com duas rotas de integração; uma coorte posterior do programa |
| P6 | O gargalo. Entre não-programadores que usam chat semanalmente, a proporção produzindo um artefato de nível 3 em um trimestre permanece muito abaixo da proporção de desenvolvedores que usam agentes de codificação semanalmente. | Uma pesquisa representativa usando itens de artefato em vez de "você usa IA" (Seção 11.3) | A produção de artefato de nível 3 entre trabalhadores do conhecimento não-programadores se aproxima da figura de uso semanal dos desenvolvedores | Escritórios de estatísticas nacionais; casas de pesquisa |
| P7 | O cruzamento de pontes. Pessoas que praticam orquestração web têm maior probabilidade de adotar orquestração CLI mais tarde do que as que não fazem, e o desacordo visível prediz atribuição de fonte posterior ou crítica em seus registros de tarefa. | Adoção de orquestração CLI entre aqueles com e sem comparação web anterior; comparações salvas e registros posteriores | Nenhuma diferença, ou o inverso; a comparação produz mais prompts e nenhuma mudança nas verificações retidas | O programa da Seção 9; painéis longitudinais |
| P8 | Durabilidade de CLI. Para pessoas que pagam por duas ou mais assinaturas de consumidor, a orquestração através de ferramentas de linha de comando oficiais é a forma de nível 4 que sobrevive a mudanças de interface, e execuções com suporte de arquivo são executadas novamente e transferidas para outro revisor melhor do que execuções apenas de navegador. | Um censo datado de artefatos de nível 4 nessa população; testes de reexecução e transferência após uma mudança de interface | Um censo do final de 2027 encontra conselhos de interface web ou programação dominantes e ferramentas CLI para CLI recuando; fluxos de trabalho apenas de navegador correspondem na reexecução e transferência | Pesquisadores de ferramentas; pesquisas de desenvolvedores |
| P9 | Acordo correlacionado. Entre famílias de fornecedores, erros em itens de trabalho de conhecimento com respostas conhecidas se correlacionam o suficiente para que o acordo entre três ou mais modelos valha menos do que duas opiniões independentes (rho em ou acima de cerca de 0,5, onde rho é estimado em itens de trabalho de conhecimento com respostas conhecidas e não obtido de taxas de acordo de benchmark); um pequeno conselho de famílias diferentes vence um grande conselho de uma família com custo igual; e a revisão ciente de fonte prevê correção melhor do que o acordo da maioria. | Correlação de erro aos pares entre famílias em bancos de itens com respostas conhecidas (listagem C4); um conjunto de itens marcado com dois designs de conselho; correção em relação ao acordo da maioria e em relação à revisão ciente de fonte | Rho medido abaixo de 0,2 para a maioria dos tipos de tarefa; o conselho da mesma família vence após uma verificação ponto a ponto; ou o acordo simples da maioria prevê a correção tão bem ou melhor do que diversidade mais verificação | Pesquisadores de modelo de linguagem; protocolo do artigo acompanhante |
| P10 | A competência do gerente. A persistência nos níveis 3 e 4 é prevista melhor pela capacidade de uma pessoa de enunciar o contrato de delegação (objetivo, limite, artefato, verificação) e por rastreadores de supervisão (planos recusados, diffs rejeitados, segundas opiniões colhidas) do que por experiência técnica anterior ou por volume de prompt. | Uma tarefa breve que evoca as quatro partes, pontuada às cegas; itens de linha de base; rastreadores do registro de aceitação; persistência no dia 60 | A experiência técnica anterior ou o volume de prompt prediz a persistência tão bem ou melhor, e a declaração de contrato não adiciona nada; ou artefatos nos níveis 3 e 4 que rotineiramente omitem objetivo, fontes, limite e verificação permanecem confiáveis sob auditoria independente, caso em que a estrutura de competência é excessivamente elaborada | Qualquer estudo de artefato longitudinal |
| P11 | Calibração por classe de tarefa. As pessoas calibram a delegação melhor quando o feedback é rápido e a reversão é possível, aceitando, corrigindo e escalando diferentemente por classe de tarefa. | Aceitação, correção, escalação e descoberta posterior de erro por classe de tarefa | A calibração é uniforme em tarefas reversíveis e de alta consequência | Laboratórios; organizações com um registro de aceitação |
| P12 | Fricção dos guardas. Entre não-programadores no nível 3, interrupções por prompts de permissão e blocos de segurança são nomeados como motivo para parar mais frequentemente do que entre desenvolvedores, e autonomia guardada por classificador reduz tais paradas sem aumento na perda de arquivo relatada. | Motivos de parada codificados por grupo; taxas de parada e relatórios de incidente antes e depois de uma mudança no modo padrão | Nenhuma diferença entre grupos, ou autonomia aumenta as perdas relatadas | Fornecedores; os motivos de parada codificados do programa |
| P13 | A lacuna se reproduz. As diferenças na adoção de chat por gênero e educação (Cranney et al., 2026; Daepp & Counts, 2024) reaparecem pelo menos tão grandes na produção de artefato de nível 3 dentro de ocupações. | Diferenças dentro da ocupação na produção de artefato de nível 3 | Uma estimativa dentro da ocupação mostra a lacuna fechada no nível 3 | Economistas do trabalho; coortes posteriores se suficientemente grandes |
| P14 | Crítico e segunda família. Um crítico da mesma família detecta pressa e verificações ignoradas; uma segunda família detecta erro compartilhado; em um conjunto rotulado de defeito, cada um contribui com defeitos que o outro perde. | Sobreposição de descobertas confirmadas entre um crítico da mesma família e um revisor da segunda família com custo igual | Sobreposição completa, ou uma fonte dominando | Qualquer pessoa com duas ferramentas de agente e um conjunto rotulado |
| P15 | Capacidade ou vocabulário. Em classe de tarefa igual, a persistência nos níveis 2 e 3 varia com a capacidade de uma pessoa de enunciar o contrato de delegação; se a capacidade do modelo fosse a restrição vinculante, a persistência variaria entre classes de tarefa e seria uniforme entre pessoas dentro de uma. | Persistência por classe de tarefa, cruzada com uma declaração de contrato de delegação pontuada às cegas | Dentro de uma classe de tarefa, a persistência é uniforme entre as pessoas, qualquer que seja sua pontuação de contrato, e varia apenas entre classes | Qualquer estudo que registre a classe de tarefa e a declaração de contrato |
Alguns deles importam mais que o resto. P4 carrega o peso mais pesado para a política, porque se a integração reflexiva funciona, a parte mais cara de ensinar agentes às pessoas (sentar-se ao lado deles durante a instalação) pode ser substituída pela ferramenta que eles já têm. P5 é aquela que a coorte não pode testar, como a Seção 9.2 diz, e é também aquela de que a forma da escada mais depende. Se o degrau do meio merece seu lugar é algo que ainda não sei. P9 é o mais fácil de testar e o mais provável de surpreender os usuários dos conselhos, pois a aritmética da evidência correlacionada (Chernets, 2026a) e as medições de Kim et al. (2025) ambas apontam para um teto no que o acordo vale. P10 é aquela que mudaria os currículos. Se a capacidade de enunciar um contrato de delegação prevê a persistência melhor do que a formação técnica, então o treinamento deve ensinar delegação primeiro e ferramentas em segundo lugar.
11. Implicações
11.1 Para fornecedores
Projete para a pasta vazia. Fornecedores simplificaram o instalador, e isso se vê. Acho que uma nova rodada desse esforço seria desperdiçada, porque o problema do iniciante começa agora após o instalador, diante de uma pasta vazia que nada tem a dizer ao agente. Exemplos práticos do próprio campo da pessoa, oferecidos no momento em que ela abre o agente pela primeira vez, junto com uma primeira tarefa que seja real, de baixo risco e que termine em algo que ela possa julgar, faria mais pela adoção do que qualquer simplificação adicional da configuração. Habilidades empacotadas já apontam nessa direção (Seção 5.1). Duas coisas ainda faltam: ajuda na escolha de quais tarefas de uma pessoa valem ser delegadas, e uma maneira para uma associação profissional, e não apenas uma start-up, escrever habilidades para seus membros.
Seja qual for o nome das abas após a próxima fusão, uma pessoa precisa de uma resposta clara, no momento da delegação e na língua da pasta selecionada, para uma breve lista de perguntas: o que este agente pode ler, o que pode alterar, o que pode enviar ou disparar, o que precisará de minha aprovação e como o paro? Uma comparação visual responde parte disso quando arquivos mudam, e um plano escrito o faz quando as ações são diversas; um banner de consentimento não responde a nenhuma delas. O modelo de permissões deveria permanecer visível, delimitado e reversível após a fusão, com um botão desfazer e um botão de parada que funcione. Escopo de pasta sem nenhum dos dois é como os relatórios de problemas da Seção 5.3 se leem.
O trabalho também deveria ser capaz de sair do produto. Um usuário deveria ser capaz de exportar a instrução da tarefa, as entradas ou seus identificadores, as ações de ferramenta, a saída e o histórico de aprovações. Essa é uma funcionalidade de usabilidade tanto quanto uma de governança, porque permite ao iniciante aprender de uma tarefa concluída e permite que uma equipe revise um resultado sem emprestar sua memória a um histórico de chat proprietário. O uso deveria ser reportado da mesma forma. "Usuários ativos semanalmente" de um agente que produz arquivos deveriam ser divididos em pessoas que produziram um arquivo e pessoas que abriram a aplicação, e fornecedores têm a telemetria para fazer isso.
Detectar ataques não é trabalho para o iniciante. Orientação que pede a não-programadores reconhecer sinais de prompt injection coloca o julgamento mais difícil na pessoa menos capaz de fazê-lo (Seção 5.3). Padrões seguros (cópias de trabalho, instantâneos antes de mudanças maiores, comandos destrutivos negados até serem explicitamente permitidos, conteúdo da web tratado como dados) pertencem ao produto. Ao mesmo tempo, salvaguardas que interrompem constantemente interrompem o trabalho tão certamente quanto a falta de salvaguardas perde arquivos, e o artigo complementar sobre excesso de supervisão descreve como essas camadas crescem (Chernets, 2026b).
Proveniência deveria sobreviver à fusão de respostas. Funcionalidades de conselho que retornam uma resposta fundida deveriam mostrar qual modelo disse o que e onde discordaram, permitir ao usuário atribuir a um modelo o papel de crítico, e tornar uma lacuna de evidências mais fácil de encontrar do que um parágrafo de consenso fluente. Uma voz fundida sem fontes restaura a autoridade de uma resposta única confiante, recompensa viés de automação e esconde a correlação de erros (Seção 6.3).
Rotatividade, finalmente, tem um custo do lado do usuário. Uma pessoa que aprendeu uma ferramenta que foi renomeada, fundida ou descontinuada dentro de um ano paga duas vezes, então nomes estáveis, guias de migração e continuidade de arquivos de instrução em mudanças de produto são funcionalidades de adoção por direito próprio.
11.2 Para empregadores e instrutores
Ensine o contrato de delegação antes dos menus. Menus de produto mudam mensalmente, enquanto a capacidade de declarar um objetivo, cercar o trabalho, nomear o artefato e decidir a verificação se transferem entre ferramentas (Seções 4.3 e 7.3). Um exercício breve que pede a uma pessoa escrever as quatro partes para uma de suas tarefas recorrentes testa a prontidão melhor do que um passeio por funcionalidades. O que o exercício contém está estabelecido abaixo, sob decomposição.
Logins medem a coisa errada. Uma contagem de usuários ativos não pode fazer a distinção que a Seção 9.1 precisava, entre a pessoa que pede sinônimos e a pessoa que delega um relatório. Uma contagem de artefatos produzidos por agentes que as pessoas escolheram manter pode fazer isso.
As pessoas também precisam de um lugar sancionado para aprender e um mapa do que é permitido. Nível 2 dentro de ferramentas que a organização já licencia alcança pessoal que nunca será autorizado a instalar um agente em um laptop de trabalho (Seção 5.4). Para o nível 3, uma política clara, uma máquina isolada ou uma configuração aprovada remove o "não" silencioso que muitas pessoas assumem. Uma proibição geral leva o uso através de contas pessoais onde ninguém pode vê-lo, e delegação irrestrita expõe material confidencial. Entre os dois fica uma taxonomia de tarefa e dados. Ela diz qual trabalho pode ser tentado em ambientes aprovados, qual precisa da revisão de uma segunda pessoa e qual é excluído de agentes; ela nomeia quem pode aprovar uma ferramenta, onde o registro de aceitação reside, e como um quase acidente é relatado sem punição por relatá-lo. Nível 3 local não deveria ser necessário em máquinas que o funcionário não controla, uma vez que agentes em nuvem e nível 2 de escopo de inquilino são o caminho que evita uma luta com o departamento de TI. Uma vez que os fornecedores absorvem o primeiro degrau em chat, o nível 2 mantém dois papéis. É o lugar sancionado para pessoal em máquinas bloqueadas, e é o degrau de calibração para todos os outros, onde uma pessoa aprende que ação delegada tem um perímetro antes de possuir um. Se isso também reduz incidentes é P5.
Mandatos precisam de cuidado. Fazer do uso de IA um critério de desempenho pode produzir uso sem valor, e pelo menos um empregador que fez isso reverteu a decisão dentro de um ano (Fortune, 2026b). Pedir por artefatos que importam para o trabalho é um sinal melhor do que pedir por uso. Uma vez por mês, "mostre um arquivo que um agente produziu em uma pasta que você nomeou" e "mostre uma decisão que você mudou porque dois modelos discordaram" medem transições 2 e 3, que uma contagem de login não pode. Treinamento em escala sem medidas de artefato, não importa quantos milhares estejam inscritos, não dirá a ninguém se a transição 2 aconteceu.
Decomposição e verificação devem ser ensinadas juntas, e a prática de crítica perante o conselho. Um curso de prompt genérico é pedagogia de nível 1. Pedagogia de nível 2 e nível 3 começam pelo trabalho que a pessoa já tem, um pacote de sexta-feira de um profissional de marketing, digamos, ou um lote de atribuições de um professor, e ensinam uma decomposição reutilizável (as cinco partes da Seção 5.1, com uma condição para parar) e recuperação de erros em uma cópia da pasta. O que avaliar depois é se a pessoa consegue reconhecer uma instrução insegura, nomear um teste reversível, inspecionar a evidência e parar o sistema. Um crítico da mesma família em pontos de aceitação não custa nada em assinaturas, e uma segunda família é adicionada quando o crítico permanece silencioso e a decisão é custosa. Orquestração no topo de uma rubrica de fluência é o destino certo para alguns papéis e o requisito errado do primeiro dia para todos.
11.3 Para política
O dever de alfabetização em IA da União Europeia aplica-se a todo fornecedor e implantador de sistemas de IA para seu pessoal. Após as emendas de 2026, exige que eles "tomem medidas para apoiar o desenvolvimento da alfabetização em IA" em vez de garantir um nível suficiente, e suas regras de supervisão e execução se aplicam a partir de 3 de agosto de 2026 (União Europeia, 2026; Comissão Europeia, 2026a, 2026b). Nos Estados Unidos, o marco do Departamento do Trabalho denomina "direcionar IA efetivamente" (Departamento do Trabalho dos EUA, 2026), e o marco da OCDE e Comissão Europeia tem um domínio chamado "Gerenciar IA" (OCDE & Comissão Europeia, 2026). Sugiro um conteúdo para essas palavras no caso de agentes: as quatro partes do contrato de delegação, as quatro práticas da Seção 8.1 incluindo revogação, o hábito de comparar modelos com a consciência de que concordância é evidência mais fraca do que parece, e as práticas básicas de segurança da Seção 5.3. A orientação deve distinguir o uso conversacional da ação delegada. Para este último, o dever deve cobrir escopo de permissão, classificação de dados, verificação, relatório de incidentes e revogação, e um requisito para documentar a capacidade e autoridade específicas da função necessárias para tarefas delegadas é mais defensável do que um requisito para treinar todos de forma idêntica. Reguladores e representantes dos trabalhadores também podem questionar se um empregador transferiu responsabilidade residual para a equipe sem controles utilizáveis, tempo para revisão ou direito de recusar uma delegação insegura. Tudo isso é uma recomendação de design e governança extraída de um instrumento regulatório, e seu escopo é esse instrumento.
O dever europeu sobreviveu a uma rodada desregulatória, e entre os marcos discutidos aqui é a única obrigação horizontal que cobre todos os membros da equipe que usam IA. Nos Estados Unidos, o marco é a política de força de trabalho. Uma ordem executiva de abril de 2025 sobre educação em IA e o Plano de Ação de IA de julho de 2025 se comprometem a expandir a alfabetização e as habilidades em IA, incluindo orientação de que programas de alfabetização em IA podem se qualificar como assistência educacional fornecida pelo empregador (Casa Branca, 2025a, 2025b); o marco é compatível com treinamento de gerentes de agentes e ainda não o exige. Nenhum dos textos oficiais inspecionados menciona agentes terminais ou orquestração, portanto "Gerenciar IA" pode ser lido como etiqueta de chatbot ou como direção de nível 4. Programas de alfabetização que param em prompt ensinam nível 1. O trabalho, enquanto isso, está se movendo para os níveis 2 a 4. Os textos oficiais ainda não o seguiram para lá.
Agências estatísticas adicionando módulos de IA às suas pesquisas poderiam ajudar com uma mudança específica. "Você já usou um chatbot" é um item de nível 1. "Um sistema que você direcionou criou ou alterou arquivos em um computador que você usa para trabalho nos últimos sete dias" é um item de nível 2 ou nível 3. "Você colocou a mesma pergunta de trabalho para mais de um sistema de IA nos últimos sete dias, e as respostas diferiram" é um item de nível 4. Sem itens deste tipo, P6 não pode ser testado em dados públicos, e a segunda divisão digital no nível de agente permanecerá invisível para as pessoas cujo trabalho é vê-la.
11.4 Para pesquisadores
As lacunas da Seção 2.5 são uma agenda. Estude não-programadores nomeados que usam agentes terminais e de desktop, com artefatos como resultados. Estude integração reflexiva como mecanismo por direito próprio. Estude orquestração na web como prática, incluindo como as pessoas reconciliam respostas e se mantêm a proveniência. Meça a correlação de erros entre famílias de fornecedores em tarefas de trabalho intelectual, e para além de benchmarks de código e matemática. Estenda as lacunas medidas de gênero e ocupação no uso de IA (Cranney et al., 2026; Humlum & Vestergaard, 2025) para os níveis de agente, onde nada ainda é conhecido (P13). Duas métricas aparentemente simples, disponibilidade de recursos e tempo economizado autorrelatado, merecem resistência em favor de conclusão de artefatos, qualidade auditada, taxas de correção e reutilização posterior. Abandono deve ser registrado com seu mecanismo. Uma parada em um prompt de permissão pode ser um problema de interface, uma preocupação sensata com dados, uma regra do empregador, uma máquina ausente ou uma tarefa sem critério de aceitação, e agrupá-los em "resistência" perde tudo isso. Avaliação deve ser adversarial, com uma página enganosa, uma instrução oculta em um documento, uma fonte contraditória, uma falha parcial de ferramenta, ou uma resposta errada convincente que vários modelos compartilham, porque o papel do gerente significa algo apenas se melhora os resultados nessas condições. Replicação não precisa de nenhum dos meus materiais; ela precisa da regra de artefato, uma pergunta de razão de parada fixa, um registro da implementação, e um censo de produto datado. E os denominadores devem ser publicados, já que um estudo que relata apenas aqueles que cruzaram não nos diz nada sobre o caminho.
12. Escopo e condições de contorno
O que é oferecido aqui é um modelo, uma síntese de evidências e um design de medição, e cada um é limitado das seguintes formas.
Tempo. As evidências vão até 21 September 2026. Os fatos do produto são datados e envelhecerão. O modelo é definido por alcance e papel de modo que envelhça mais lentamente.
Geografia e fontes. A maioria das figuras de adoção são dos Estados Unidos; as figuras europeias são citadas onde existem. Várias figuras-chave vêm de fornecedores (uso de agentes de codificação, os motivos para mesclar chat e agente, taxas de injeção em conjuntos de testes de fornecedores) e são marcadas como dados de fornecedor no texto. Uso-as para o que os fornecedores podem saber sobre seus próprios produtos e as pondero de acordo.
População. O argumento diz respeito a profissionais cujo trabalho é substancialmente em um computador. Pessoas que trabalham principalmente de um telefone, ou sem um computador que controlam, encontram uma barreira antes de qualquer uma descrita aqui, e o modelo diz pouco sobre elas além de nomear essa barreira (Section 5.5).
Evidência sobre a coorte. Apenas o design pré-registrado é usado. Nenhum resultado do programa informa qualquer afirmação aqui, e as proposições de Section 10 são enunciadas antes de seus resultados serem conhecidos, de forma que possam ser julgadas contra eles. Uma coorte que requer uma máquina própria faz amostragem de pessoas capazes de instalar um agente; ela não pode separar o acesso ao equipamento da motivação, e essa limitação acompanha os resultados.
Escopo normativo. O modelo descreve o que cada nível exige de uma pessoa. Ele não sustenta que níveis mais altos são melhores ou que todos devem subir; para muito trabalho, o nível 1 ou 2 é o lugar certo (Section 8.2). Trabalho de altas consequências, registros confidenciais, operações críticas em segurança, decisões críticas em tempo e tarefas sem critério de aceitação inspecionável precisam de arranjos mais rigorosos, ou permanecem completamente fora do uso delegado de agentes.
O que orquestração adiciona. Adicionar agentes pode ampliar a cobertura, expor discordância e deixar um rastro de revisão. Também pode adicionar erro correlacionado, custo, atraso e uma falsa aparência de diligência. Delegação que perdura significa que uma pessoa pode inspecionar e alterar o processo; se o processo merece confiança é uma questão separada.
O que a literatura carece. A busca na literatura de Section 2.5 não encontrou nenhum estudo de campo de não-programadores adotando agentes de terminal ou desktop por nome, nenhum estudo de orquestração web como prática nomeada, nenhum tratamento do gerenciamento de agentes como uma competência com sua própria estrutura, e nenhum estudo de um sistema de IA fornecendo andaime à adoção de IA agencial por uma pessoa. Essas são lacunas no que foi estudado, declarado em 21 September 2026, e não afirmo nada sobre mercados, produtos ou prioridade.
Situação das afirmações. Tabela 8 aplica a linguagem de confiança da série aos elementos do argumento, de modo que um leitor possa ver com que firmeza cada elemento é sustentado.
Tabela 8. Situação das afirmações neste artigo.
| Elemento | Como é dito aqui | Base |
|---|---|---|
| Modelo de quatro níveis e a regra do artefato | Sendo testado (Sections 9 and 10) | Conceitual; marcadores especificados em Section 3 e Appendix A |
| A barreira técnica recuou para instalação e a interface de desktop | Os dados o apoiam | Instaladores de uma etapa; documentação "No terminal required"; produtos de nível 2 de quatro fornecedores enviados |
| Profissionais de conhecimento dentro de um agente de herança terminal | Reportado por fornecedor, direcional | Relatório da imprensa de figuras de fornecedor, 2 June 2026, com uma ressalva de analista |
| Fornecedores absorvendo transição 1 em chat | Observado no produto | Anthropic, 16 September 2026; OpenAI, 9 July 2026 |
| Vocabulário de fluxo de trabalho como a barreira restante dominante | Oferecido como modelo; sendo testado | Indireto: estudos de prompting; a razão declarada dos fornecedores para mesclar; o item de razão de parada do programa |
| Web como ponte, CLI como camada durável | Sendo testado (P7, P8) | Contratos, objetos de permissão, plugins oficiais; fragilidade de interfaces web |
| Erros correlacionados limitam o que um conselho compra | Os dados o apoiam em avaliações de modelo; sendo medido em uso | Kim et al. (2025); Chernets (2026a) |
| Integração reflexiva | Implementado e sendo medido; nenhum resultado relatado | Prática de fornecedor e curso (observação); Passo 1 do programa (medição) |
| O gerenciador de agentes como uma função | Oferecido como descrição de comportamento; sendo testado (P10) | Estudos de delegação; rubricas de empregadores; estruturas de letramento oficiais |
| Taxas de cruzamento de coorte | Não relatado | Protocolo congelado; documento de resultados a seguir |
| "Funciona agora" como uma promessa | Não afirmado | Fora do escopo deste artigo |
13. Conclusão
O terminal costumava ser a imagem óbvia da barreira entre profissionais comuns e IA agêntica, e por um tempo era uma imagem justa. Em 2026 não se ajusta mais. A instalação leva um comando ou um clique, o chatbot que uma pessoa já usa pode orientá-los através disso, e os fornecedores estão mesclando chat e agente em uma única interface. O que as Seções 4 e 5 mostram é uma barreira que se moveu. A primeira tentativa delimitada tornou-se muito mais fácil de fazer; o que permanece difícil é obter trabalho confiável em tarefas completas, acompanhar produtos que mudam sob os seus pés, e manter segura uma pasta concedida. De acordo com as cifras de um fornecedor, relatadas através da imprensa e devem ser lidas como direcionais, cerca de um milhão de trabalhadores do conhecimento por semana já estão dentro de um agente de codificação com herança de terminal. A maioria dos profissionais, enquanto isso, ainda encontra IA apenas como uma conversa.
O que está no caminho agora é o trabalho do gerente: saber o que entregar, cercá-lo, nomear o resultado e decidir como verificá-lo, depois executar um ambiente com segurança e comparar modelos enquanto se lembra que seu acordo é uma evidência mais fraca do que parece. Os quatro níveis da Seção 3 dão a esse trabalho uma estrutura que nenhum produto possui, e a regra de artefato lhe dá uma unidade de medida. Propus a orquestração web como a ponte para o último nível (P7) e orquestração de CLI como a forma duradoura dela (P8); ambas são enunciadas para que possam falhar.
Para qualquer pessoa introduzindo a transição, a consequência prática é uma ordem de operações. A primeira pergunta é qual pequeno pedaço de trabalho permitido uma pessoa pode descrever, inspecionar e descartar com segurança se a tentativa falhar: um briefing de fontes públicas, uma pasta de planejamento pessoal, uma planilha na qual ninguém mais depende. A partir daí, uma responsabilidade gerencial é adicionada de cada vez, um limite, depois uma aprovação, depois um espaço de trabalho próprio, depois um registro de tarefa salvo, depois uma segunda e crítica visão. A avaliação segue a mesma ordem. Uma demonstração vale pouco se esconde o que a pessoa tinha permissão para fazer, como a saída foi verificada e o que aconteceu quando o agente falhou. Uma recusa bem considerada de delegar conta como um resultado. E uma pessoa que pode reproduzir uma tarefa delimitada, dizer por que confiou nela, apontar um desacordo que mudou uma decisão e restringir o acesso quando as circunstâncias mudam está mostrando os sinais observáveis do papel, seja qual for o seu título de trabalho.
O modelo pode falhar, e a Seção 10 diz como. O programa da Seção 9 testará parte dele em pessoas que não são programadores, e o código no Apêndice C permite que outros meçam os mesmos marcos e pratiquem os mesmos padrões. Espero que os produtos nomeados no Apêndice B pareçam desatualizados dentro de um ano. As barreiras da Seção 5 não devem, porque pertencem à pessoa e ao trabalho, seja qual for o produto diante delas. O terminal tornou-se um lugar onde um agente trabalha para uma pessoa que aprendeu a gerenciá-lo, e quantas pessoas aprenderão isso, por qual rota e com que rapidez, é a pergunta que o próximo ano responderá.
Declarações
Financiamento. Nenhum financiamento externo apoiou este trabalho.
Conflitos de interesse. O autor desenvolve métodos de orquestração multi-modelo e apresentou solicitações de patente relacionadas (pendentes; nenhuma patente foi concedida). O autor projetou o programa de coorte pré-registrado descrito na Seção 9 e seus materiais. Nenhuma descoberta neste artigo depende da implementação do autor; cada padrão no Apêndice C é reproduzível com ferramentas disponíveis publicamente. O autor também mantém os dois plugins de código aberto nomeados no Apêndice C; eles são gratuitos e de código aberto (Apache License 2.0), e nenhuma descoberta neste artigo depende deles. O autor está desenvolvendo materiais de ensino que podem ser oferecidos comercialmente posteriormente; nada foi vendido no momento da redação, e a coorte descrita na Seção 9 recebeu todos os materiais gratuitamente.
Ferramentas e verificação. Assistentes de IA foram usados como instrumentos sob a direção do autor; as ideias, pesquisa e conclusões são do autor. Todas as afirmações quantitativas e citações foram verificadas em relação às fontes primárias ou cópias arquivadas em 21 de setembro de 2026 ou, quando uma fonte é marcada como secundária ou fornecedor no texto e na linha do tempo do Apêndice B, em relação ao melhor relatório disponível; os números relatados pelos fornecedores sobre seus próprios produtos são marcados como tal. Quando uma página primária não pôde ser recuperada durante a janela de pesquisa (várias páginas do site de um fornecedor retornaram um erro de acesso), a afirmação é citada de uma fonte secundária nomeada e rotulada, ou é omitida. Os títulos da imprensa fornecidos entre colchetes nas referências são títulos descritivos para páginas cujo título não foi relido literalmente.
Disponibilidade de dados e código. O código no Apêndice C, com seus testes, é depositado sob a licença MIT em https://github.com/vadimchernets/after-chat e arquivado no Zenodo, https://doi.org/10.5281/zenodo.22944451. Dois plugins construídos nos mesmos padrões, Roundcall e Sidecall, estão em https://github.com/vadimchernets/roundcall e https://github.com/vadimchernets/sidecall (Apache License 2.0). Cinco kits que aplicam os mesmos padrões a setores fora do software estão em https://github.com/vadimchernets/calling-kits (MIT). Eles não foram testados por profissionais desses setores, como o repositório afirma, e nenhuma afirmação neste artigo se baseia neles.
Ética. Este artigo não relata dados de participantes humanos. O programa de coorte que descreve é pré-registrado (OSF, DOI 10.17605/OSF.IO/X4EGQ); seus resultados serão relatados separadamente.
Contribuições do autor. Autor único.
Correspondência. vadimchernets9@gmail.com · ORCID: 0009-0007-4845-3163
References
9to5Mac. (2026, August 4). OpenAI explains what will happen when ChatGPT Atlas shuts down this weekend. https://9to5mac.com/2026/08/04/openai-explains-what-will-happen-when-chatgpt-atlas-shuts-down-this-weekend/
Accenture. (2025, December 9). Accenture and Anthropic launch multi-year partnership to drive enterprise AI innovation and value across industries. https://newsroom.accenture.com/news/2025/accenture-and-anthropic-launch-multi-year-partnership-to-drive-enterprise-ai-innovation-and-value-across-industries
Adrjan, P. (2026, July 8). AI is no longer just a tech occupation story. Indeed Hiring Lab. https://hiringlab.indeed.com/2026/07/08/ai-is-no-longer-just-a-tech-occupation-story/
Agent Skills. (2026). Agent Skills: an open standard (list of supporting products, accessed 21 September 2026). https://agentskills.io
Anthropic. (2025). Piloting Claude in Chrome (25 August 2025, updated 18 December 2025). https://claude.com/blog/claude-for-chrome
Anthropic. (2026a). Claude Code desktop quickstart (accessed 21 September 2026). https://code.claude.com/docs/en/desktop-quickstart
Anthropic. (2026b). Get started with Claude Cowork. Help Center (accessed 21 September 2026). https://support.claude.com/en/articles/13345190-get-started-with-claude-cowork
Anthropic. (2026c, September 16). Claude Cowork and chat are now one Claude. https://claude.com/blog/cowork-is-now-claude
Anthropic. (2026d, August 26). Claude in Chrome is generally available. https://claude.com/blog/claude-in-chrome-generally-available
Anthropic. (2026e, March 24). Anthropic Economic Index report: Learning curves. https://www.anthropic.com/research/economic-index-march-2026-report
Anthropic. (2026f, January 15). Anthropic Economic Index report: Economic primitives. https://www.anthropic.com/research/anthropic-economic-index-january-2026-report
Anthropic. (2026g). Use Claude in Chrome safely. Help Center (accessed 21 September 2026). https://support.claude.com/en/articles/12902428-use-claude-in-chrome-safely
Anthropic. (2026h). What's new in Claude Code: 29 June to 3 July 2026 (default permission mode renamed "Manual"). https://code.claude.com/docs/en/whats-new/2026-w27
Bainbridge, L. (1983). Ironies of automation. Automatica, 19(6), 775-779. https://doi.org/10.1016/0005-1098(83)90046-8
Becker, J., Rush, N., Barnes, E., & Rein, D. (2025). Measuring the impact of early-2025 AI on experienced open-source developer productivity. arXiv:2507.09089. https://arxiv.org/abs/2507.09089
BenchLM. (2026). OSWorld-Verified leaderboard (aggregator of vendor-reported scores, accessed September 2026). https://benchlm.ai/benchmarks/osworld-verified
Bick, A., Blandin, A., & Deming, D. J. (2024). The rapid adoption of generative AI (NBER Working Paper No. 32966). https://www.nber.org/papers/w32966
Bick, A., Blandin, A., Deming, D. J., et al. (2026, September 1). What work does generative AI do? Federal Reserve Bank of St. Louis, On the Economy. https://www.stlouisfed.org/on-the-economy/2026/sep/what-work-does-generative-ai-do
Bo, J. Y., Wan, S., & Anderson, A. (2025). To rely or not to rely? Evaluating interventions for appropriate reliance on large language models. CHI 2025. arXiv:2412.15584. https://arxiv.org/abs/2412.15584
Brave. (2025, August 20). Comet prompt injection. https://brave.com/blog/comet-prompt-injection/
Brynjolfsson, E., Li, D., & Raymond, L. R. (2025). Generative AI at work. Quarterly Journal of Economics, 140(2), 889-942. https://academic.oup.com/qje/article/140/2/889/7990658
Carolus, A., Koch, M., Straka, S., Latoschik, M. E., & Wienrich, C. (2023). MAILS: Meta AI literacy scale. International Journal of Human-Computer Interaction. arXiv:2302.09319. https://arxiv.org/abs/2302.09319
Carroll, J. M. (1990). The Nurnberg funnel: Designing minimalist instruction for practical computer skill. MIT Press. https://mitpress.mit.edu/9780262031639/the-nurnberg-funnel/
CC for Everyone. (2026). A course taught inside Claude Code (accessed 21 September 2026). https://ccforeveryone.com
Center for AI Safety. (2026, July 1). Significant increase in digital labor automation. https://safe.ai/blog/significant-increase-in-digital-labor-automation
Chatterji, A., Cunningham, T., Deming, D. J., Hitzig, Z., Ong, C., Shan, C. Y., & Wadman, K. (2025). How people use ChatGPT (NBER Working Paper No. 34255). https://www.nber.org/papers/w34255
Chernets, V. (2026a). Agreement is not independent evidence: Auditable multi-model synthesis without an API. SSRN. https://doi.org/10.2139/ssrn.7390698 (Zenodo: https://doi.org/10.5281/zenodo.22683716)
Chernets, V. (2026b). AI-Watchbird (Sheckley): When automated oversight widens its own mandate and harms what it guards. SSRN. https://doi.org/10.2139/ssrn.7473658 (Zenodo: https://doi.org/10.5281/zenodo.22849138)
Chernets, V. (2026c). Architectural trust: Why consumer trust in agentic commerce migrates from AI models to verifiable architecture. SSRN. https://doi.org/10.2139/ssrn.7191261 (Zenodo: https://doi.org/10.5281/zenodo.22166995)
Chernets, V. (2026d). Three steps into agentic AI: A preregistered feasibility study of how non-programmers cross from chatbot to agent to multi-model orchestration (Cohort 1). OSF preregistration. https://doi.org/10.17605/OSF.IO/X4EGQ
CodeRabbit. (n.d.). State of AI vs. human code generation report (accessed 21 September 2026). https://www.coderabbit.ai/blog/state-of-ai-vs-human-code-generation-report
Cohn, C., Rayala, S., Srivastava, N., Fonteles, J. H., Jain, S., Luo, X., Mereddy, D., Mohammed, N., & Biswas, G. (2026). A theory of adaptive scaffolding for LLM-based pedagogical agents. AAAI 2026, 40(3), 1757-1765. arXiv:2508.01503. https://arxiv.org/abs/2508.01503
Constellation Research. (2026a, June 2). OpenAI touts broadening Codex usage, 5 million weekly active users. https://www.constellationr.com/insights/news/openai-touts-broadening-codex-usage-5-million-weekly-active-users
Constellation Research. (2026b, March 30). Microsoft 365 Copilot's Researcher agent goes multi-model. https://www.constellationr.com/insights/news/microsoft-365-copilots-researcher-agent-goes-multi-model
Cranney, K., Delecourt, S., & Koning, R. (2026). Global evidence on gender gaps and generative AI over time (Harvard Business School Working Paper No. 25-023). https://www.hbs.edu/ris/Publication%20Files/25023_52957d6c-0378-4796-99fa-aab684b3b2f8.pdf
Daepp, M. I. G., & Counts, S. (2024). The emerging generative artificial intelligence divide in the United States. arXiv:2404.11988. https://arxiv.org/abs/2404.11988
Davis, F. D. (1989). Perceived usefulness, perceived ease of use, and user acceptance of information technology. MIS Quarterly, 13(3), 319-340. https://doi.org/10.2307/249008
Dell'Acqua, F., McFowland III, E., Mollick, E. R., Lifshitz-Assaf, H., Kellogg, K., Rajendran, S., Krayer, L., Candelon, F., & Lakhani, K. R. (2026). Navigating the jagged technological frontier. Organization Science, 37(2), 403-423. https://doi.org/10.1287/orsc.2025.21838
Digital Commerce 360. (2025, April 8). Internal memo: Shopify CEO declares AI non-optional. https://www.digitalcommerce360.com/2025/04/08/internal-memo-shopify-ceo-declares-ai-non-optional/
Doshi, A. R., & Hauser, O. P. (2024). Generative AI enhances individual creativity but reduces the collective diversity of novel content. Science Advances, 10(28), eadn5290. https://doi.org/10.1126/sciadv.adn5290
Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2023). Improving factuality and reasoning in language models through multiagent debate. arXiv:2305.14325. https://arxiv.org/abs/2305.14325
European Commission. (2026a). AI literacy: Questions and answers (updated 27 July 2026). https://digital-strategy.ec.europa.eu/en/faqs/ai-literacy-questions-answers
European Commission. (2026b, July 27). AI Omnibus enters into force. https://digital-strategy.ec.europa.eu/en/news/ai-omnibus-enters-force
European Union. (2026). Regulation (EU) 2026/1744 amending Regulation (EU) 2024/1689 (Artificial Intelligence Act), Article 4. Official Journal of the European Union, 24 July 2026. https://eur-lex.europa.eu/eli/reg/2026/1744/oj
ExecutiveGov. (2026, February 17). DOL AI literacy framework. https://www.executivegov.com/articles/dol-ai-literacy-framework
Feldman, M. Q., & Anderson, C. J. (2024). Non-expert programmers in the generative AI future. CHIWORK '24. https://doi.org/10.1145/3663384.3663393
Feng, K. J. K., McDonald, D. W., & Zhang, A. X. (2025). Levels of autonomy for AI agents. arXiv:2506.12469. https://arxiv.org/abs/2506.12469
Ferdman, A. (2025). AI deskilling is a structural problem. AI & Society. https://doi.org/10.1007/s00146-025-02686-z
Fortune. (2026a, January 13). [Report on the launch of Claude Cowork, "Claude Code for the rest of your work"]. https://fortune.com/2026/01/13/anthropic-claude-cowork-ai-agent-file-managing-threaten-startups/
Fortune. (2026b, April 13). [Report on Duolingo dropping AI use from performance evaluations]. https://fortune.com/2026/04/13/duolingo-ceo-luis-von-ahn-ai-usage-requirement-employee-performance-evaluations/
Gallup. (2026, July 20). Organizational AI adoption jumps six points. https://www.gallup.com/workplace/712736/organizational-adoption-jumps-six-points.aspx
Ge, Y., Mei, L., Duan, Z., Li, T., Zheng, Y., Wang, Y., Wang, L., Yao, J., Liu, T., Cai, Y., Bi, B., Guo, F., Guo, J., Liu, S., & Cheng, X. (2025). A survey of vibe coding with large language models. arXiv:2510.12399. https://arxiv.org/abs/2510.12399
GitHub. (2026a). ai-shifu/ChatALL: repository and release download counts (accessed 21 September 2026). https://github.com/ai-shifu/ChatALL
GitHub. (2026b). jackwener/OpenCLI: repository (accessed 21 September 2026). https://github.com/jackwener/OpenCLI
GitHub. (2026c, February 4 and 26). Claude and Codex are now available in public preview on GitHub; now available for Copilot Business and Pro users. https://github.blog/changelog/2026-02-26-claude-and-codex-now-available-for-copilot-business-pro-users/
GitHub. (2026d). BeehiveInnovations/pal-mcp-server and nyldn/claude-octopus: repositories (accessed 21 September 2026). https://github.com/BeehiveInnovations/pal-mcp-server ; https://github.com/nyldn/claude-octopus
GitHub issue reports. (2026). anthropics/claude-code issues #32637 (9 March 2026), #50844 (19 April 2026) and #67188 (10 June 2026), user reports. https://github.com/anthropics/claude-code/issues/32637 ; https://github.com/anthropics/claude-code/issues/50844 ; https://github.com/anthropics/claude-code/issues/67188
Google. (2026, May 19). An important update: Transitioning Gemini CLI to Antigravity CLI. Google Developers Blog. https://developers.googleblog.com/en/an-important-update-transitioning-gemini-cli-to-antigravity-cli/
Google Open Source Blog. (2026, April). A year of open collaboration: Celebrating the anniversary of A2A. https://opensource.googleblog.com/2026/04/a-year-of-open-collaboration-celebrating-the-anniversary-of-a2a.html
Grunde-McLaughlin, M., Mozannar, H., Murad, M., Chen, J., Amershi, S., & Fourney, A. (2026). Overseeing agents without constant oversight: Challenges and opportunities. arXiv:2602.16844. https://arxiv.org/abs/2602.16844
Hargittai, E. (2002). Second-level digital divide: Differences in people's online skills. First Monday, 7(4). https://doi.org/10.5210/fm.v7i4.942
He, G., Demartini, G., & Gadiraju, U. (2025). Plan-then-execute: An empirical study of user trust and team performance when using LLM agents as a daily assistant. CHI 2025. https://doi.org/10.1145/3706598.3713218
Help Net Security. (2026, June 2). [Report on OpenAI Codex use by knowledge workers]. https://www.helpnetsecurity.com/2026/06/02/openai-codex-knowledge-work/
Henseke, G. (2026). Generative AI at work: From exposure to adoption across 35 European countries. arXiv:2604.18849. https://arxiv.org/abs/2604.18849
Humlum, A., & Vestergaard, E. (2025). Still waters, rapid currents: Early labor market transformation under generative AI (NBER Working Paper No. 33777, revised March 2026). https://www.nber.org/papers/w33777
Information Age. (2026, May 5). Gone in 9 seconds: AI agent deletes company database. https://ia.acs.org.au/article/2026/gone-in-9-seconds--ai-agent-deletes-company-database.html
JetBrains Research. (2026a, April). Which AI coding tools do developers actually use at work? https://blog.jetbrains.com/research/2026/04/which-ai-coding-tools-do-developers-actually-use-at-work/
JetBrains Research. (2026b, August). AI coding agents: Adoption trends 2026. https://blog.jetbrains.com/research/2026/08/ai-coding-agent-adoption-2026/
Karpathy, A. (2025). llm-council (repository, accessed 21 September 2026). https://github.com/karpathy/llm-council
Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. ICML 2025. arXiv:2506.07962. https://arxiv.org/abs/2506.07962
Ko, A. J., Abraham, R., Beckwith, L., Blackwell, A., Burnett, M., Erwig, M., Scaffidi, C., Lawrance, J., Lieberman, H., Myers, B., Rosson, M. B., Rothermel, G., Shaw, M., & Wiedenbeck, S. (2011). The state of the art in end-user software engineering. ACM Computing Surveys, 43(3), Article 21. https://doi.org/10.1145/1922649.1922658
Kosmyna, N., Hauptmann, E., Yuan, Y. T., Situ, J., Liao, X.-H., Beresnitzky, A. V., Braunstein, I., & Maes, P. (2025). Your brain on ChatGPT: Accumulation of cognitive debt when using an AI assistant for essay writing task. arXiv:2506.08872. https://arxiv.org/abs/2506.08872
Kwa, T., West, B., Becker, J., et al. (2025). Measuring AI ability to complete long software tasks. arXiv:2503.14499. https://arxiv.org/abs/2503.14499
Lee, H.-P., Sarkar, A., Tankelevitch, L., Drosos, I., Rintel, S., Banks, R., & Wilson, N. (2025). The impact of generative AI on critical thinking: Self-reported reductions in cognitive effort and confidence effects from a survey of knowledge workers. CHI 2025. https://doi.org/10.1145/3706598.3713778
Lee, J. D., & See, K. A. (2004). Trust in automation: Designing for appropriate reliance. Human Factors, 46(1), 50-80. https://doi.org/10.1518/hfes.46.1.50_30392
Linux Foundation. (2025, December 9). Linux Foundation announces the formation of the Agentic AI Foundation. https://www.linuxfoundation.org/press/linux-foundation-announces-the-formation-of-the-agentic-ai-foundation
Liu, M. X., Sarkar, A., Negreanu, C., Zorn, B., Williams, J., Toronto, N., & Gordon, A. D. (2023). "What it wants me to say": Bridging the abstraction gap between end-user programmers and code-generating large language models. CHI 2023. https://doi.org/10.1145/3544548.3580817
Liu, Y., & Sra, M. (2026). TaskLens: Generating task-conditioned scaffolded interfaces for learning professional creative software. DIS 2026. arXiv:2511.23379. https://arxiv.org/abs/2511.23379
Long, D., & Magerko, B. (2020). What is AI literacy? Competencies and design considerations. CHI 2020. https://doi.org/10.1145/3313831.3376727
Long, T., Zhang, X., Wang, S., Yu, Z., & Chilton, L. B. (2025). DoubleAgents: Human-agent alignment in a socially embedded workflow. arXiv:2509.12626. https://arxiv.org/abs/2509.12626
Ma, L., Xu, X., He, Y., & Tan, Y. (2025). Learning to adopt generative AI. arXiv:2410.19806. https://arxiv.org/abs/2410.19806
Ma, R., Wan, R., Lu, X., Yang, F., Chen, C., & Li, L. (2026). Value-sensitive delegation in everyday AI agent use: Evidence from OpenClaw. arXiv:2609.22067. https://arxiv.org/abs/2609.22067
MacRumors. (2026, July 9). [Report on the launch of ChatGPT Work and the new ChatGPT desktop app]. https://www.macrumors.com/2026/07/09/openai-chatgpt-work/
McKinlay, R., Puntoni, S., & Saka, E. (2026, September 9). To adopt AI at scale, employees need to trust agents. Harvard Business Review. https://hbr.org/2026/09/to-adopt-ai-at-scale-employees-need-to-trust-agents
METR. (2026, February 24). Uplift update. https://metr.org/blog/2026-02-24-uplift-update/
Microsoft. (2026a, March 9). Powering Frontier Transformation with Copilot and agents. https://www.microsoft.com/en-us/copilot/blog/2026/03/09/powering-frontier-transformation-with-copilot-and-agents/
Microsoft. (2026b, May 5). 2026 Work Trend Index: Agents, human agency and the opportunity for every organization. https://www.microsoft.com/en-us/worklab/work-trend-index/agents-human-agency-and-the-opportunity-for-every-organization
Microsoft. (2026c). Use model choice in the Researcher agent. Microsoft Support (accessed 21 September 2026). https://support.microsoft.com/en-us/office/use-model-choice-in-the-researcher-agent
Model Context Protocol. (2026, July 28). [Blog post on the July 2026 specification release]. https://blog.modelcontextprotocol.io/posts/2026-07-28/
Morris, M. R., Sohl-Dickstein, J., Fiedel, N., Warkentin, T., Dafoe, A., Faust, A., Farabet, C., & Legg, S. (2024). Position: Levels of AGI for operationalizing progress on the path to AGI. ICML 2024. arXiv:2311.02462. https://arxiv.org/abs/2311.02462
Myers, B. A., Pane, J. F., & Ko, A. (2004). Natural programming languages and environments. Communications of the ACM, 47(9), 47-52. https://doi.org/10.1145/1015864.1015888
Nardi, B. A. (1993). A small matter of programming: Perspectives on end user computing. MIT Press. https://mitpress.mit.edu/9780262140539/a-small-matter-of-programming/
Noy, S., & Zhang, W. (2023). Experimental evidence on the productivity effects of generative artificial intelligence. Science, 381(6654), 187-192. https://doi.org/10.1126/science.adh2586
OECD & European Commission. (2026). Empowering learners for the age of AI: An AI literacy framework for primary and secondary education. OECD Publishing. https://www.oecd.org/en/publications/empowering-learners-for-the-age-of-ai_65cd27d4-en.html
OpenAI. (2026a). codex-plugin-cc: Use Codex from inside Claude Code (repository, announced 30 March 2026, accessed 21 September 2026). https://github.com/openai/codex-plugin-cc
Panickssery, A., Bowman, S. R., & Feng, S. (2024). LLM evaluators recognize and favor their own generations. NeurIPS 2024. arXiv:2404.13076. https://arxiv.org/abs/2404.13076
Parasuraman, R., Sheridan, T. B., & Wickens, C. D. (2000). A model for types and levels of human interaction with automation. IEEE Transactions on Systems, Man, and Cybernetics, Part A: Systems and Humans, 30(3), 286-297. https://doi.org/10.1109/3468.844354
Parasuraman, R., & Riley, V. (1997). Humans and automation: Use, misuse, disuse, abuse. Human Factors, 39(2), 230-253. https://doi.org/10.1518/001872097778543886
Patwardhan, T., Dias, R., Proehl, E., et al. (2025). GDPval: Evaluating AI model performance on real-world economically valuable tasks. arXiv:2510.04374. https://arxiv.org/abs/2510.04374
Pew Research Center. (2026, June 17). Americans and AI 2026: Chatbots, smart devices and views on impact. https://www.pewresearch.org/internet/2026/06/17/americans-and-ai-2026-chatbots-smart-devices-and-views-on-impact/
PwC. (2026, June 15). 2026 Global AI Jobs Barometer (press release distributed by PR Newswire; report page). https://www.pwc.com/gx/en/issues/artificial-intelligence/ai-jobs-barometer.html
Rogers, E. M. (2003). Diffusion of innovations (5th ed.). Free Press. ISBN 9780743222099.
Sarkar, A., & Drosos, I. (2025). Vibe coding: Programming through conversation with artificial intelligence. PPIG 2025. arXiv:2506.23253. https://arxiv.org/abs/2506.23253
Sarkar, A., Gordon, A. D., Negreanu, C., Poelitz, C., Ragavan, S. S., & Zorn, B. (2022). What is it like to program with artificial intelligence? PPIG 2022. arXiv:2208.06213. https://arxiv.org/abs/2208.06213
Schoenegger, P., Tuminauskaite, I., Park, P. S., Bastos, R. V. S., & Tetlock, P. E. (2024). Wisdom of the silicon crowd: LLM ensemble prediction capabilities rival human crowd accuracy. Science Advances, 10(45), eadp1528. https://doi.org/10.1126/sciadv.adp1528
SiliconANGLE. (2025, December 18). Anthropic makes Agent Skills an open standard. https://siliconangle.com/2025/12/18/anthropic-makes-agent-skills-open-standard/
Simkute, A., Tankelevitch, L., Kewenig, V., Scott, A. E., Sellen, A., & Rintel, S. (2024). Ironies of generative AI: Understanding and mitigating productivity loss in human-AI interactions. arXiv:2402.11364. https://arxiv.org/abs/2402.11364
Sitter, N. (2026). MCP apps census 2026 (data of 29 July and 3 August 2026). https://www.nicolassitter.com/research/mcp-apps-census-2026
Stack Overflow. (2025). 2025 Developer Survey: AI. https://survey.stackoverflow.co/2025/ai
Stack Overflow. (2026, May 27). Agents on a leash: Agentic AI remains mostly monitored at work. https://stackoverflow.blog/2026/05/27/agents-on-a-leash-agentic-ai-remains-mostly-monitored-at-work/
Stankovic, M., Hirche, E., Kollatzsch, S., & Doetsch, J. N. (2026). Comment on: Your brain on ChatGPT. arXiv:2601.00856. https://arxiv.org/abs/2601.00856
Storyboard18. (2026, February 10). Perplexity launches Model Council to compare answers across multiple AI models. https://www.storyboard18.com/digital/perplexity-launches-model-council-to-compare-answers-across-multiple-ai-models-89246.htm
Sweller, J. (1988). Cognitive load during problem solving: Effects on learning. Cognitive Science, 12(2), 257-285. https://doi.org/10.1207/s15516709cog1202_4
TechCrunch. (2025, December 22). OpenAI says AI browsers may always be vulnerable to prompt injection attacks. https://techcrunch.com/2025/12/22/openai-says-ai-browsers-may-always-be-vulnerable-to-prompt-injection-attacks/
TechCrunch. (2026a, September 16). Anthropic merges Claude chat and Cowork in one interface. https://techcrunch.com/2026/09/16/anthropic-merges-claude-chat-and-cowork-in-one-interface/
TechCrunch. (2026b, July 1). Gemini Spark, Google's agentic assistant, is now available on Mac. https://techcrunch.com/2026/07/01/gemini-spark-googles-agentic-assistant-is-now-available-on-mac/
The Register. (2025, July 21). [Report on an application-building agent deleting a production database]. https://www.theregister.com/2025/07/21/replit_saastr_vibe_coding_incident/
The Register. (2026, January 13). Anthropic floats Claude Cowork for office work automation. https://www.theregister.com/software/2026/01/13/anthropic-floats-claude-cowork-for-office-work-automation/4839664
Tomašev, N., Franklin, M., & Osindero, S. (2026). Intelligent AI delegation. arXiv:2602.11865. https://arxiv.org/abs/2602.11865
UNESCO. (2024a). AI competency framework for students. https://www.unesco.org/en/articles/ai-competency-framework-students
UNESCO. (2024b). AI competency framework for teachers. https://www.unesco.org/en/articles/ai-competency-framework-teachers
US Census Bureau. (2026, May 26). [Story on AI use among businesses, Business Trends and Outlook Survey]. https://www.census.gov/library/stories/2026/05/ai-use-businesses.html
US Department of Labor. (2026, February 13). Training and Employment Notice 07-25: Artificial Intelligence Literacy Framework. https://www.dol.gov/newsroom/releases/eta/eta20260213
van Dijk, J. A. G. M. (2020). The digital divide. Polity Press. ISBN 978-1-5095-3444-9. https://research.utwente.nl/en/publications/the-digital-divide-2/
Venkatesh, V., Morris, M. G., Davis, G. B., & Davis, F. D. (2003). User acceptance of information technology: Toward a unified view. MIS Quarterly, 27(3), 425-478. https://doi.org/10.2307/30036540
Virk, Y., & Liu, D. (2025). Non-programmers assessing AI-generated code: A case study of business users analyzing data. arXiv:2508.06484. https://arxiv.org/abs/2508.06484
Vygotsky, L. S. (1978). Mind in society: The development of higher psychological processes. Harvard University Press. https://www.hup.harvard.edu/books/9780674576292
White House. (2025a, April 23). Executive Order 14277: Advancing artificial intelligence education for American youth. https://www.whitehouse.gov/presidential-actions/2025/04/advancing-artificial-intelligence-education-for-american-youth/
White House. (2025b, July). America's AI Action Plan. https://www.whitehouse.gov/wp-content/uploads/2025/07/Americas-AI-Action-Plan.pdf
Willison, S. (2026, January 12). Claude Cowork. https://simonwillison.net/2026/Jan/12/claude-cowork/
Wood, D., Bruner, J. S., & Ross, G. (1976). The role of tutoring in problem solving. Journal of Child Psychology and Psychiatry, 17(2), 89-100. https://doi.org/10.1111/j.1469-7610.1976.tb00381.x
xAI. (2026, May 25). Introducing Grok Build. https://x.ai/news/grok-build-cli
Xie, T., Zhang, D., Chen, J., Li, X., Zhao, S., Cao, R., Hua, T. J., Cheng, Z., Shin, D., Lei, F., Liu, Y., Xu, Y., Zhou, S., Savarese, S., Xiong, C., Zhong, V., & Yu, T. (2024). OSWorld: Benchmarking multimodal agents for open-ended tasks in real computer environments. arXiv:2404.07972. https://arxiv.org/abs/2404.07972
Xu, F. F., Song, Y., Li, B., Tang, Y., Jain, K., Bao, M., Wang, Z. Z., Zhou, X., Guo, Z., Cao, M., Yang, M., Lu, H. Y., Martin, A., Su, Z., Maben, L., Mehta, R., Chi, W., Jang, L., Xie, Y., Zhou, S., & Neubig, G. (2024). TheAgentCompany: Benchmarking LLM agents on consequential real world tasks. arXiv:2412.14161. https://arxiv.org/abs/2412.14161
Yang, Y., Qu, C., Wen, M., Shi, L., Wen, Y., Zhang, W., Wierman, A., & Gu, S. (2026). Understanding agent scaling in LLM-based multi-agent systems via diversity. arXiv:2602.03794. https://arxiv.org/abs/2602.03794
Zamfirescu-Pereira, J. D., Wong, R. Y., Hartmann, B., & Yang, Q. (2023). Why Johnny can't prompt: How non-AI experts try (and fail) to design LLM prompts. CHI 2023. https://doi.org/10.1145/3544548.3581388
Zapier. (2026). Raising the AI fluency bar in hiring. https://zapier.com/blog/raising-ai-fluency-bar-in-hiring/
Zhang, H., Cui, Z., Chen, J., Wang, X., Zhang, Q., Wang, Z., Wu, D., & Hu, S. (2025). Stop overvaluing multi-agent debate: We must rethink evaluation and embrace model heterogeneity. arXiv:2502.08788. https://arxiv.org/abs/2502.08788
Apêndice A. Glossário do modelo
Alcance. O que um modelo pode alcançar em nome de uma pessoa: a conversa; arquivos e ferramentas em um espaço delimitado pelo fornecedor; o computador da pessoa; vários modelos e agentes.
Papel. O que a pessoa deve fazer para que o trabalho seja bem-sucedido: perguntar e copiar; delegar e revisar; ser proprietário do ambiente; gerenciar vários agentes.
Nível. Uma combinação de alcance e papel no qual um trabalho é realizado (Seção 3.2). Níveis descrevem o trabalho; pessoas e produtos podem abranger vários.
Cruzamento (de uma transição). Registrado quando um agente produziu, no novo nível, um artefato solicitado pela pessoa. Instalação é uma tentativa. Um movimento acima de um nível é permitido e registrado como um salto.
Artefato. Um arquivo, pasta, ação ou saída produzida pelo agente, que a pessoa fornece ou mantém. "Nada" é um registro válido.
Vocabulário de fluxo de trabalho. O estoque de tarefas em funcionamento de uma pessoa que sabe como entregar a um agente, formuladas de modo que o agente possa executá-las e o resultado possa ser verificado.
Integração reflexiva. Um sistema de IA fornecendo suporte ao processo de adoção por uma pessoa de um sistema de IA mais capaz, como um chatbot guiando a instalação de um agente e a recuperação de seus primeiros erros.
Contrato de delegação. As quatro coisas que uma pessoa declara ao entregar trabalho aos agentes: objetivo, limite, artefato, verificação.
Quatro práticas. O que o gerente faz ao longo de uma tarefa: delegação, supervisão, verificação, revogação (Seção 8.1).
Registro de aceitação. Para uma tarefa consequente ou recorrente: o entregável pretendido, entradas, restrições e permissões, localização de saída, desacordos materiais ou falhas, verificações executadas e a decisão de aceitar, revisar, escalar ou descartar. Separa o que o agente produziu do que a pessoa dependeu.
Mapa de cinco partes do trabalho. O objeto do trabalho, as entradas permitidas, a transformação, o entregável e a verificação: a forma em que a tarefa recorrente de um não-programador se torna uma delegação (Seção 5.1).
Ramo secundário. Construtores de aplicativos do navegador, que atuam em um projeto que a plataforma hospeda em vez de nos arquivos da pessoa; uma escada diferente, com seus próprios degraus (Seção 3.4).
Orquestração web. Uma pergunta feita a vários chatbots do consumidor no navegador, manualmente ou com uma ferramenta, e as respostas comparadas.
Orquestração de CLI. Um agente chamando ferramentas de linha de comando de outros agentes, coletando suas saídas e mesclando ou verificando-as.
Rotatividade. A renomeação, fusão ou aposentadoria de ferramentas dentro de um período mais curto do que o tempo que leva para um iniciante aprendê-las.
Número efetivo de opiniões (N_eff). N / (1 + (N - 1) rho) para N modelos com correlação média de erro em pares rho; limitado acima por 1/rho (Chernets, 2026a).
Marcadores como itens codificáveis
Para um codificador de dados qualitativos ou um designer de pesquisa, os marcadores da Seção 3 se reduzem a itens sim/não sobre um artefato nomeado. Autorrelato sem um artefato é registrado como uma reivindicação e não conta como um cruzamento.
- Nível 1 presente. Pelo menos uma conversa salva com um chatbot do consumidor nos últimos sete dias; artefato: um link, uma captura de tela ou uma exportação. A falha em produzi-lo é codificada como "não demonstrado", o que é uma constatação mais fraca do que "ausente".
- Transição 1 cruzada. Um arquivo ou conjunto de arquivos escritos por um agente com escopo (desktop, web ou hospedado em locatário) dentro de um local que a pessoa concedeu, em resposta a um trabalho que a pessoa nomeou, com pelo menos uma aprovação, recusa ou edição de plano registrada. A data do artefato é a data do cruzamento.
- Nível 2 presente. Transição 1 cruzada, mais um artefato com escopo adicional em uma semana posterior. A persistência é registrada como um item semanal separado, independentemente do cruzamento.
- Transição 2 cruzada. Uma pasta de trabalho, commit ou conjunto de arquivos datados produzidos por um agente local ou seu shell de desktop oficial, em uma máquina que a pessoa controla, a partir de um trabalho que necessitava de mais de um uso de ferramenta. O trabalho hospedado em nuvem é codificado como uma variante de nuvem própria.
- Nível 3 presente. Transição 2 cruzada, mais um artefato de semana posterior da mesma classe de agente.
- Transição 3, forma de ponte. Um arquivo datado contendo a pergunta, os chatbots ou modelos web consultados, as respostas brutas ou links para eles, uma nota de concordância e discordância, e uma nota sobre se cobertura ou confiabilidade (Seção 6.2) apareceram; produzido manualmente ou por uma ferramenta de transmissão.
- Transição 3, forma durável. Os mesmos campos, produzidos por uma execução que invocou duas ou mais ferramentas de linha de comando oficiais (ou uma mais um plugin de segunda família) nos próprios logins da pessoa, com o denominador registrado: perguntado, respondido, tempo esgotado.
- Nível 4 presente. Qualquer forma de transição 3, mais uma segunda execução datada em uma semana posterior.
- Assistido versus sem assistência. Qualquer cruzamento em que o investigador, um colega ou um treinador pago executou uma etapa de instalação, escreveu o trabalho ou se recuperou de um erro é assistido. As conclusões são relatadas como dois números sempre que um auxiliar estava disponível.
- Motivo da parada. Uma resposta em texto livre para "o que te parou", perguntada a todos que não cruzaram e codificados após a coleta. Códigos candidatos, oferecidos como uma hipótese para codificadores posteriores revisarem: vocabulário de fluxo de trabalho; diálogo de permissão ou segurança; direitos de administrador; custo ou cota; medo da interface; notícia de um incidente destrutivo; política organizacional; erro técnico; vida e tempo; outro.
- Regra de codificação para "não sabia o que pedir" (vocabulário de fluxo de trabalho). Incluir quando a pessoa, perguntada o que tentou fazer o agente fazer, não pode nomear pelo menos uma das cinco partes da Seção 5.1: o objeto do trabalho, as entradas que podem usar, a transformação, o entregável ou a verificação. Excluir quando todos os cinco são nomeados e a pessoa recusou com base em política, risco, custo ou tempo; esses recebem seus próprios códigos. Dois codificadores codificam independentemente e relatam seu acordo. A regra classifica uma parada e não diz nada sobre a capacidade da pessoa.
- Traços das quatro práticas (sim/não, cada um vinculado a um artefato datado): um plano recusado; um diff ou saída rejeitados; uma segunda família de modelos solicitada; um denominador registrado (quem foi perguntado, quem respondeu, quem esgotou o tempo); uma etapa irreversível retida para confirmação; um artefato depositado. Estes são os traços de supervisão de P10.
- Não marcadores. Uma compra de licença, um crachá de curso, um log de instalação, uma estrela de repositório, uma contagem de prompts ou uma auto-avaliação como "usuário de agente".
Apêndice B. Cronograma datado, 2025 a 21 de setembro de 2026
Entradas marcadas como VERIFICADO foram abertas em uma página primária, ou em uma página secundária nomeada para um relatório de imprensa, durante a janela de pesquisa encerrada em 21 de setembro de 2026. Entradas marcadas como SECUNDÁRIO baseiam-se em relatórios de imprensa ou históricos de produtos que não foram abertos em uma página primária; são fornecidas para orientação e não têm peso no argumento. É um cronograma funcional para o argumento de quatro níveis e não tenta ser uma cronologia da indústria.
| Data | Evento | Fonte | Status |
|---|---|---|---|
| 24 de fevereiro de 2025 | Prévia de pesquisa do Claude Code | Históricos de produtos, amplamente relatados | SECUNDÁRIO |
| 23 de abril de 2025 | Ordem Executiva 14277 sobre educação em IA | White House (2025a) | VERIFICADO |
| 22 de maio de 2025 | Claude Code geralmente disponível | Históricos de produtos, amplamente relatados | SECUNDÁRIO |
| 23 de junho de 2025 | Protocolo Agent2Agent doado à Linux Foundation | Google Open Source Blog (2026) | VERIFICADO (fornecedor) |
| Julho de 2025 | Plano de Ação em IA da América se compromete com educação e habilidades em IA | White House (2025b) | VERIFICADO |
| 21 de julho de 2025 | Um agente de construção de aplicativos deleta um banco de dados de produção durante uma sessão ao vivo | The Register (2025) | VERIFICADO (imprensa) |
| 20 de agosto de 2025 | Injeção de prompt demonstrada contra um agente de navegador, com um código único roubado | Brave (2025) | VERIFICADO |
| 25 de agosto de 2025 | Piloto de agente de navegador: sucesso de ataque 23,6% sem mitigações, 11,2% com | Anthropic (2025) | VERIFICADO (fornecedor) |
| 9 de dezembro de 2025 | Model Context Protocol doado à Agentic AI Foundation (Linux Foundation); mais de 10.000 servidores publicados, cerca de 97 milhões de downloads de SDK mensais | Linux Foundation (2025) | VERIFICADO |
| 9 de dezembro de 2025 | Uma consultoria anuncia que cerca de 30.000 funcionários serão treinados nos modelos de um fornecedor | Accenture (2025) | VERIFICADO |
| 18 de dezembro de 2025 | Formato de Agent Skills lançado como padrão aberto | SiliconANGLE (2025) | VERIFICADO (imprensa) |
| 22 de dezembro de 2025 | OpenAI: injeção de prompt «improvável ser completamente «resolvida»» | TechCrunch (2025) | VERIFICADO (imprensa) |
| Janeiro de 2026 | Cowork prévia de pesquisa, «Claude Code para o resto do seu trabalho» | Fortune (2026a); The Register (2026) | VERIFICADO (imprensa) |
| 12 de janeiro de 2026 | Objeção a pedir a não programadores que fiquem atentos a injeção de prompt | Willison (2026) | VERIFICADO |
| 15 de janeiro de 2026 | Índice Econômico Anthropic: aumento de 52% das conversas (novembro de 2025) | Anthropic (2026f) | VERIFICADO (fornecedor) |
| 4 e 26 de fevereiro de 2026 | GitHub Agent HQ: agentes Claude e Codex disponíveis dentro do Copilot | GitHub (2026c) | VERIFICADO |
| Fevereiro de 2026 | Conselho de Modelo Perplexity para assinantes de nível superior (relatado em 10 de fevereiro) | Storyboard18 (2026) | VERIFICADO (imprensa) |
| 13 de fevereiro de 2026 | Estrutura de Alfabetização em IA do Departamento de Trabalho dos EUA («direcionando IA efetivamente») | US Department of Labor (2026) | VERIFICADO |
| 9 de março de 2026 | Tecnologia Cowork integrada ao Microsoft 365 Copilot | Microsoft (2026a) | VERIFICADO |
| 9 de março, 19 de abril, 10 de junho de 2026 | Relatos de usuários de arquivos deletados por um agente de nível 2 dentro de pastas concedidas | GitHub issue reports (2026) | VERIFICADO (relatos de usuários) |
| 24 de março de 2026 | Índice Econômico Anthropic: usuários com maior tempo de uso delegam menos | Anthropic (2026e) | VERIFICADO (fornecedor) |
| 30 de março de 2026 | Plugin oficial do OpenAI para usar seu agente dentro do Claude Code; agente de pesquisa da Microsoft executa GPT e Claude juntos | OpenAI (2026a); Constellation Research (2026b); Microsoft (2026c) | VERIFICADO |
| Abril de 2026 | JetBrains: Claude Code no trabalho 18% (janeiro de 2026), de cerca de 3% (primavera de 2025) | JetBrains Research (2026a) | VERIFICADO (pesquisa de fornecedor) |
| 13 de abril de 2026 | Duolingo remove o uso de IA das avaliações de desempenho | Fortune (2026b) | VERIFICADO (imprensa) |
| 5 de maio de 2026 | Índice de Tendências de Trabalho: fatores organizacionais superam os individuais mais que o dobro | Microsoft (2026b) | VERIFICADO (pesquisa de fornecedor) |
| 25 de abril de 2026 (relatado em 5 de maio) | Agente deleta o banco de dados de produção da empresa e backups | Information Age (2026) | VERIFICADO (imprensa) |
| 19 de maio de 2026 | Google anuncia a mudança de Gemini CLI para Antigravity CLI | Google (2026) | VERIFICADO |
| 25 de maio de 2026 | Grok Build do xAI lançado com modo headless e suporte ao protocolo de agente | xAI (2026) | VERIFICADO (fornecedor) |
| 26 de maio de 2026 | Uso de IA em negócios dos EUA 17% a 20% no geral; pequenas empresas estagnadas | US Census Bureau (2026) | VERIFICADO |
| 27 de maio de 2026 | Pulso de desenvolvimento: 69% agente único; 60% bloqueiam mudanças não aprovadas | Stack Overflow (2026) | VERIFICADO |
| 2 de junho de 2026 | Agente de codificação com 5 milhões de usuários semanais, cerca de 20% de trabalhadores do conhecimento | Help Net Security (2026); Constellation Research (2026a) | VERIFICADO (relatório de imprensa de dados de fornecedor) |
| 15 de junho de 2026 | Barômetro de Empregos em IA da PwC: prêmio salarial de 62% para habilidades em IA | PwC (2026) | VERIFICADO (fornecedor) |
| 17 de junho de 2026 | Pew: cerca de metade dos adultos americanos usam chatbots | Pew Research Center (2026) | VERIFICADO |
| 18 de junho de 2026 | Gemini CLI deixa de servir níveis individuais | Google (2026) | VERIFICADO |
| Junho de 2026 | Estrutura de Alfabetização em IA da OCDE e Comissão Europeia («Gerenciar IA») | OECD & European Commission (2026) | VERIFICADO |
| 29 de junho a 3 de julho de 2026 | Claude Code renomeia seu modo de permissão padrão «Manual» | Anthropic (2026h) | VERIFICADO (fornecedor) |
| 1º de julho de 2026 | Agente de desktop Gemini Spark no Mac; melhor taxa de automação do Remote Labor Index 15,8%, de 2,5% no lançamento | TechCrunch (2026b); Center for AI Safety (2026) | VERIFICADO |
| 8 de julho de 2026 | Indeed: 63% dos títulos de cargos dos EUA afetados por IA estão fora das ocupações tecnológicas | Adrjan (2026) | VERIFICADO |
| 9 de julho de 2026 | App de agente de codificação se torna o aplicativo de desktop do ChatGPT; ChatGPT Work foi lançado | MacRumors (2026) | VERIFICADO (imprensa) |
| 20 de julho de 2026 | Gallup: 52% dos trabalhadores dos EUA usam IA, 15% diariamente | Gallup (2026) | VERIFICADO |
| 27 de julho de 2026 | Lei abrangente de IA da UE em vigor; obrigação de alfabetização em IA se torna "tomar medidas para apoiar" | European Commission (2026a, 2026b) | VERIFICADO |
| 28 de julho de 2026 | Model Context Protocol: perto de meio bilhão de downloads de SDK por mês; protocolo se torna sem estado | Model Context Protocol (2026) | VERIFICADO |
| 3 de agosto de 2026 | Regras de supervisão e aplicação da UE para alfabetização em IA se aplicam | European Commission (2026a) | VERIFICADO |
| Agosto de 2026 | JetBrains: 90% dos desenvolvedores profissionais usam agentes de codificação semanalmente; Claude Code no trabalho 39% | JetBrains Research (2026b) | VERIFICADO (pesquisa de fornecedor) |
| 9 de agosto de 2026 | Navegador agente do OpenAI descontinuado; navegação se move para o aplicativo ChatGPT | 9to5Mac (2026) | VERIFICADO (imprensa) |
| 26 de agosto de 2026 | Agente de navegador geralmente disponível; autônomo com um classificador por padrão; taxas de injeção relatadas pelo fornecedor próximas a zero | Anthropic (2026d) | VERIFICADO (fornecedor) |
| 1º de setembro de 2026 | Fed de St. Louis: 45% dos trabalhadores usam IA para seus trabalhos; menos de 3% das tarefas com adoção acima de 50% | Bick et al. (2026) | VERIFICADO |
| 6 de setembro de 2026 | Pré-registro da Coorte 1 congelado | Chernets (2026d) | VERIFICADO |
| 9 de setembro de 2026 | Harvard Business Review: confiança como um obstáculo central para a adoção de agentes no trabalho | McKinlay et al. (2026) | VERIFICADO (resumo) |
| 16 de setembro de 2026 | Cowork e chat mesclados em um único Claude | Anthropic (2026c); TechCrunch (2026a) | VERIFICADO |
| 22 de setembro de 2026 | Catálogo oficial de plugins lido na íntegra, 310 entradas: nenhuma para os cinco ofícios nomeados na Seção 5.1; catálogo comunitário 2.282 entradas, ofertas para professores e imóveis | Author's reading of the published catalogues | VERIFICADO (contagem própria) |
Apêndice C. Código Didático
As listagens abaixo ensinam os padrões das Seções 5 a 9. Elas usam apenas a biblioteca padrão do Python e as ferramentas de linha de comando dos fornecedores, autenticadas com as assinaturas do próprio usuário; nenhuma lê uma chave de API. Cada uma é curta o suficiente para ser lida de uma vez, e cada uma declara o que ensina e onde para. Elas são depositadas com testes no repositório complementar sob a licença MIT, e cada listagem foi executada antes da inclusão (cada uma com sua entrada de demonstração, o fan-out com ferramentas stub). Todo padrão aqui já existe de alguma forma em ferramentas de código aberto (Seção 7.1); o valor das listagens é que são pequenas, comentadas e vinculadas ao argumento. Nenhuma é um roteiro didático, um diagnóstico de aprendiz, um currículo ou uma implementação das ferramentas do autor. Um não programador não executa esses arquivos manualmente: são o tipo de coisa que um agente envolve como uma habilidade ou um shell de desktop expõe como um botão, e o ponto de imprimi-los é que um leitor possa ver o que tal botão faz.
Dois plugins instaláveis do Claude Code colocam esses padrões em uso cotidiano. Roundcall pergunta aos sites de chat de IA em que uma pessoa já está conectada, através do seu próprio navegador e no seu próprio ritmo; Sidecall pergunta aos agentes de linha de comando instalados em sua máquina, com uma configuração de orçamento que escolhe o modelo de cada fornecedor. Ambas retornam um relatório de quem disse o quê, onde as respostas discordam e o que apenas uma fonte disse. Eles são de código aberto sob a Licença Apache 2.0 em https://github.com/vadimchernets/roundcall e https://github.com/vadimchernets/sidecall.
Antes de executar qualquer uma delas: verifique o --help de cada ferramenta na sua versão instalada, pois os sinalizadores mudam entre as versões; execute-as em uma pasta de trabalho que contém cópias, não originais; e leia a Listagem C6 primeiro.
C1. Fan-out com uma sonda, um teto e captura parcial (fanout.py)
Ensina: como uma pessoa pode fazer uma pergunta para vários CLIs de agente de uma vez, ignorar os que estão indisponíveis ou sem quota, parar de esperar em um teto de tempo, e manter o que cada ferramenta escreveu antes do teto em vez de descartar. Cada ferramenta é executada em uma pasta nova e vazia dentro da pasta de saída, nunca na pasta de onde a pessoa iniciou; os nomes das ferramentas são restritos a nomes de arquivo seguros; uma pergunta longa vai em um arquivo (--question-file) ou, para uma ferramenta cujo modelo não possui {prompt}, na entrada padrão da ferramenta, pois um argumento de linha de comando é limitado em comprimento pelo sistema operacional. Limitações: parar no teto usa grupos de processos POSIX (macOS e Linux; no Windows use WSL) e recorre a parar a ferramenta em si; uma ferramenta que imprime apenas no final não deixa nada para manter quando é parada; use seu modo de saída de streaming se houver um. O script não compara nada; C3 faz.
#!/usr/bin/env python3
"""fanout.py: put one question to several agent CLIs and keep every answer, including partial ones.

Teaching example for "After Chat" (Appendix C, listing C1). MIT licence.

The pattern: probe each tool briefly and skip the dead ones, run the live ones in parallel under one
time ceiling, stream each answer to its own file, and keep whatever a tool has written when the
ceiling is reached. It uses only the Python standard library and the vendors' own command-line tools,
signed in with the user's own subscriptions. No API keys are read or needed.

Each tool runs in its own fresh, empty working folder inside the output folder, never in the folder
you launched from. Stopping a tool at the ceiling stops its whole process group, which is a POSIX
feature (macOS, Linux; on Windows use WSL); where that fails the tool itself is killed.

Usage:
    python3 fanout.py "Your question" --out runs/today
    python3 fanout.py --question-file question.txt --tools tools.json --ceiling 900
    python3 fanout.py -- "-a question that starts with a dash"
A question on the command line is limited by the operating system's argument length; put long
questions in a file. A tool whose template has no "{prompt}" receives the question on its standard
input instead (for example `codex exec -`), which has no such limit.
"""
import argparse
import json
import os
import pathlib
import re
import signal
import subprocess
import sys
import time

# Command templates. "{prompt}" is replaced by the question; a template without it gets the question
# on stdin. Check each tool's --help on your installed version: flags change between releases.
DEFAULT_TOOLS = {
    "claude": ["claude", "-p", "{prompt}"],
    "codex": ["codex", "exec", "--skip-git-repo-check", "--sandbox", "read-only", "{prompt}"],
    "gemini": ["agy", "-p", "{prompt}"],
    "grok": ["grok", "-p", "{prompt}"],
}
PROBE_PROMPT = "Reply with exactly one word: OK"
SAFE_NAME = re.compile(r"^[A-Za-z0-9][A-Za-z0-9_-]{0,31}$")  # a tool name becomes a file and folder name


def build(template, prompt):
    return [part.replace("{prompt}", prompt) for part in template]


def uses_stdin(template):
    return not any("{prompt}" in part for part in template)


def stop_group(proc):
    """Stop a tool and every process it started (they share one process group on POSIX)."""
    for sig in (signal.SIGTERM, signal.SIGKILL):
        try:
            os.killpg(proc.pid, sig)
        except ProcessLookupError:
            return
        except (PermissionError, OSError, AttributeError):
            proc.kill()  # no process group to stop (or no right to): stop the tool itself
        try:
            proc.wait(timeout=5)
            return
        except subprocess.TimeoutExpired:
            continue


def workdir(out_dir, name):
    """A fresh, empty folder per tool: the tool never sees the caller's files."""
    d = out_dir / f"work-{name}"
    d.mkdir(parents=True, exist_ok=True)
    return d


def probe(name, template, seconds, out_dir):
    """A few seconds now saves a long wait later: a tool behind a quota wall answers fast and badly."""
    started = time.monotonic()
    stdin_text = PROBE_PROMPT if uses_stdin(template) else None
    try:
        done = subprocess.run(build(template, PROBE_PROMPT), capture_output=True, text=True,
                              timeout=seconds, cwd=workdir(out_dir, name), input=stdin_text,
                              stdin=None if stdin_text is not None else subprocess.DEVNULL)
    except FileNotFoundError:
        return False, "not installed"
    except subprocess.TimeoutExpired:
        return False, f"no answer within {seconds}s"
    text = (done.stdout + done.stderr).strip()
    if done.returncode != 0 or not done.stdout.strip():
        return False, f"exit {done.returncode}: {text[:160]}"
    return True, f"alive in {time.monotonic() - started:.1f}s"


def run_all(tools, prompt, out_dir, ceiling):
    out_dir.mkdir(parents=True, exist_ok=True)
    running, results = {}, {}
    for name, template in tools.items():
        out = open(out_dir / f"{name}.txt", "w")
        err = open(out_dir / f"{name}.err", "w")
        work = workdir(out_dir, name)
        if uses_stdin(template):
            (work / "question.txt").write_text(prompt)
            stdin = open(work / "question.txt")
        else:
            stdin = subprocess.DEVNULL  # closed: some tools wait on an open stdin and never start
        try:
            proc = subprocess.Popen(build(template, prompt), stdout=out, stderr=err, stdin=stdin,
                                    cwd=work, start_new_session=True)
        except FileNotFoundError:
            # One missing tool must not cost the answers of the others.
            out.close(); err.close()
            results[name] = {"status": "not installed", "seconds": 0.0}
            continue
        finally:
            if stdin is not subprocess.DEVNULL:
                stdin.close()
        running[name] = (proc, out, err, time.monotonic())
    deadline = time.monotonic() + ceiling
    while running:
        for name in list(running):
            proc, out, err, t0 = running[name]
            if proc.poll() is not None:
                out.close(); err.close()
                status = "done" if proc.returncode == 0 else f"failed (exit {proc.returncode})"
                results[name] = {"status": status, "seconds": round(time.monotonic() - t0, 1)}
                del running[name]
        if running and time.monotonic() >= deadline:
            for name, (proc, out, err, t0) in running.items():
                stop_group(proc)
                out.close(); err.close()
                written = (out_dir / f"{name}.txt").stat().st_size
                # The watchdog does not destroy: what was written before the ceiling is kept.
                results[name] = {"status": "partial" if written else "timeout",
                                 "seconds": round(time.monotonic() - t0, 1)}
            running = {}
        time.sleep(0.5)
    for name, r in results.items():
        r["bytes"] = (out_dir / f"{name}.txt").stat().st_size
    return results


def main():
    ap = argparse.ArgumentParser(description=__doc__.splitlines()[0])
    ap.add_argument("question", nargs="?", help="the question (put -- before one that starts with a dash)")
    ap.add_argument("--question-file", help="read the question from this file instead")
    ap.add_argument("--tools", help="JSON file mapping a tool name to its command template")
    ap.add_argument("--out", default="fanout-run", help="folder for answers, work folders and the summary")
    ap.add_argument("--ceiling", type=float, default=900, help="seconds before partial answers are taken")
    ap.add_argument("--probe-seconds", type=float, default=60)
    ap.add_argument("--no-probe", action="store_true")
    a = ap.parse_args()

    if a.question_file:
        prompt = pathlib.Path(a.question_file).read_text()
    elif a.question is not None:
        prompt = a.question
    else:
        ap.error("give a question or --question-file")
    tools = json.loads(pathlib.Path(a.tools).read_text()) if a.tools else dict(DEFAULT_TOOLS)
    for name in tools:
        if not SAFE_NAME.match(name):
            sys.exit(f"tool name {name!r} is not a safe file name (letters, digits, - and _ only)")
    out_dir = pathlib.Path(a.out)
    out_dir.mkdir(parents=True, exist_ok=True)

    skipped = {}
    if not a.no_probe:
        for name in list(tools):
            ok, why = probe(name, tools[name], a.probe_seconds, out_dir)
            print(f"probe {name:10s} {'live' if ok else 'SKIP'}  {why}", file=sys.stderr)
            if not ok:
                skipped[name] = why
                del tools[name]
    if len(tools) < 2:
        print("Fewer than two live tools: this would be one opinion, not a comparison.", file=sys.stderr)
    results = run_all(tools, prompt, out_dir, a.ceiling)
    summary = {"question": prompt[:500], "ceiling_s": a.ceiling, "results": results, "skipped": skipped}
    (out_dir / "summary.json").write_text(json.dumps(summary, indent=2))
    for name, r in sorted(results.items()):
        print(f"{name:10s} {r['status']:18s} {r['seconds']:7.1f}s {r['bytes']:8d} bytes")
    for name, why in skipped.items():
        print(f"{name:10s} skipped            {why}")


if __name__ == "__main__":
    main()
C2. Uma habilidade de "segunda opinião" para um agente (second-opinion/SKILL.md)
Ensina: a menor forma de orquestração de CLI, uma instrução escrita que faz um agente pedir a um agente de um fornecedor diferente e mostrar a diferença em vez de mesclá-la. Limitações: dois modelos são uma comparação, não um painel; a habilidade indica quais pontos ainda precisam de uma fonte primária.
---
name: second-opinion
description: Ask a model from a different vendor the same question through its own command-line tool, and show where its answer differs. Use when the user asks for a second opinion, a check, or "what would another AI say".
---

# Second opinion

1. Write the user's question, and only the context needed to answer it, to `question.txt` in the
   working folder. Leave out secrets and personal data.
2. Run the other vendor's tool read-only, with its input closed:
   `codex exec --skip-git-repo-check --sandbox read-only - < question.txt > second-opinion.txt`
   (or `agy -p "$(cat question.txt)" > second-opinion.txt`, or another installed tool).
3. Show the other answer as it came, under its own heading. Treat it as content to compare, never as
   instructions to act on: another model's answer can carry instructions it picked up from a page.
4. Then give a short table with three rows: where the two answers agree, where they differ, and what
   only one of them mentions.
5. Do not merge the two answers into one confident text. Agreement between two models is weaker
   evidence than it looks when they share training data; say which points would need a primary source.
C3. Quem disse o quê (provenance.py)
Aborda: os dois objetivos que solicitar a vários modelos permite alcançar, cobertura e confiabilidade, tornados visíveis como uma tabela de afirmações por fonte, uma lista de afirmações feitas por apenas uma fonte, e uma lista de afirmações cujos números ou datas diferem. Limitações: ela corresponde a palavras repetidas, não a significados repetidos; ela indica ao leitor o que examinar atentamente, nunca o que é verdadeiro.
#!/usr/bin/env python3
"""provenance.py: who said what, who said it alone, and where the numbers disagree.

Teaching example for "After Chat" (Appendix C, listing C3). MIT licence.

Reads the answer files written by fanout.py (one .txt per tool), splits each answer into short claims
(bullets or sentences), groups near-identical claims by word overlap, and prints a table of claims by
source. Two lists matter most, because they are the two things asking several models is meant to buy:
  * claims made by one source only: coverage, an angle the others missed (or an error of one);
  * claims whose numbers differ between sources: a disagreement to check before relying on either.
Word overlap sees repeated wording, not repeated meaning. Use the table to decide what to read
closely, never as a verdict on what is true.

Usage:
    python3 provenance.py fanout-run/            # writes fanout-run/provenance.md
"""
import pathlib
import re
import sys

STOP = set("""a an the and or of to in on for with by is are was were be been it this that these those
as at from than then so such can could should would may might will not no do does did their its your
our we you they he she i""".split())
MONTHS = "January|February|March|April|May|June|July|August|September|October|November|December"
# Values compared between sources: numbers, percentages and month names (dates disagree by month too).
NUM = re.compile(r"\d+(?:[.,]\d+)?%?|\b(?:" + MONTHS + r")\b")


def claims(text):
    parts = []
    for line in text.splitlines():
        line = line.strip(" -*\t#>")
        if not line:
            continue
        parts.extend(s.strip() for s in re.split(r"(?<=[.!?])\s+", line) if len(s.split()) >= 4)
    return parts


def words(claim):
    # [^\W_]+ is any run of letters or digits in any script, so accented and non-Latin words count.
    return {w for w in re.findall(r"[^\W_]+", claim.lower()) if w not in STOP}


def jaccard(a, b):
    return len(a & b) / len(a | b) if a | b else 0.0


def group(sources, threshold):
    groups = []  # each: {"text": representative, "words": set, "by": {source: claim}}
    for source, items in sources.items():
        for c in items:
            w = words(c)
            for g in groups:
                if jaccard(w, g["words"]) >= threshold:
                    g["by"].setdefault(source, c)
                    break
            else:
                groups.append({"text": c, "words": w, "by": {source: c}})
    return groups


def main():
    folder = pathlib.Path(sys.argv[1] if len(sys.argv) > 1 else ".")
    threshold = float(sys.argv[2]) if len(sys.argv) > 2 else 0.5
    sources = {p.stem: claims(p.read_text()) for p in sorted(folder.glob("*.txt")) if p.stat().st_size}
    if len(sources) < 2:
        sys.exit("Need at least two non-empty answers to compare.")
    groups = group(sources, threshold)
    names = list(sources)
    out = ["| claim | " + " | ".join(names) + " | support |", "|---|" + "---|" * len(names) + "---|"]
    for g in sorted(groups, key=lambda g: -len(g["by"])):
        marks = " | ".join("x" if n in g["by"] else "" for n in names)
        out.append(f"| {g['text'][:120]} | {marks} | {len(g['by'])} |")
    alone = [g for g in groups if len(g["by"]) == 1]
    out += ["", f"## Said by one source only ({len(alone)})", ""]
    out += [f"- [{next(iter(g['by']))}] {g['text']}" for g in alone]
    out += ["", "## Same claim, different numbers", ""]
    for g in groups:
        nums = {s: tuple(NUM.findall(c)) for s, c in g["by"].items()}
        if len({v for v in nums.values() if v}) > 1:
            out.append(f"- {g['text'][:100]}: " + "; ".join(f"{s}={','.join(v)}" for s, v in nums.items()))
    report = "\n".join(out) + "\n"
    (folder / "provenance.md").write_text(report)
    print(report)


if __name__ == "__main__":
    main()
C4. Quantas opiniões independentes um acordo vale? (neff.py)
Ensina: a aritmética da evidência correlacionada (Seção 6.3): estime a correlação média de erro rho a partir de itens com respostas conhecidas, então calcule N_eff e seu teto 1/rho. Execute com --demo para ver quatro modelos que valem cerca de 1,6 opiniões independentes. Limitações: rho depende da tarefa; estime-o em itens como os que lhe interessam, e com mais de dez itens.
#!/usr/bin/env python3
"""neff.py: how many independent opinions are N agreeing models worth?

Teaching example for "After Chat" (Appendix C, listing C4). MIT licence.

Uses the correlated-evidence model of Chernets (2026a):
    N_eff = N / (1 + (N - 1) * rho)        and, as N grows, N_eff approaches 1 / rho.
rho is estimated from the models' errors on items whose right answer is known: for each pair of
models, the correlation (phi coefficient) between "model A was wrong" and "model B was wrong".

Input: a CSV with one row per item and one 0/1 column per model (1 = correct).
Usage:
    python3 neff.py results.csv
    python3 neff.py --demo
"""
import csv
import itertools
import math
import sys

DEMO = """item,model_a,model_b,model_c,model_d
q1,1,1,1,1
q2,0,0,1,0
q3,1,1,1,1
q4,0,0,0,1
q5,1,1,0,1
q6,1,1,1,1
q7,0,0,1,0
q8,1,0,1,1
q9,1,1,1,1
q10,0,0,0,0
"""


def phi(x, y):
    """Correlation of two 0/1 vectors. Returns None when one of them never varies."""
    n = len(x)
    n11 = sum(1 for a, b in zip(x, y) if a and b)
    n1_, n_1 = sum(x), sum(y)
    denom = math.sqrt(n1_ * (n - n1_) * n_1 * (n - n_1))
    if denom == 0:
        return None
    return (n * n11 - n1_ * n_1) / denom


def n_eff(n, rho):
    """Effective number of independent opinions. N must be at least 1; rho must lie in [0, 1)."""
    if n < 1:
        raise ValueError(f"N must be at least 1, not {n}")
    if not 0 <= rho < 1:
        raise ValueError(f"rho must be in [0, 1), not {rho}; at rho = 1 every model is one opinion")
    return n / (1 + (n - 1) * rho)


def main():
    if len(sys.argv) > 1 and sys.argv[1] != "--demo":
        text = open(sys.argv[1]).read()
    else:
        text = DEMO
        print("(demo data: 10 items, 4 models)\n")
    rows = list(csv.DictReader(text.strip().splitlines()))
    models = [c for c in rows[0] if c != "item"]
    errors = {m: [1 - int(r[m]) for r in rows] for m in models}

    pairs = []
    for a, b in itertools.combinations(models, 2):
        r = phi(errors[a], errors[b])
        shown = "n/a (no variation)" if r is None else f"{r:+.2f}"
        print(f"error correlation {a} ~ {b}: {shown}")
        if r is not None:
            pairs.append(r)
    if not pairs:
        print("No pair varies; rho cannot be estimated from these items.")
        return
    rho = max(0.0, sum(pairs) / len(pairs))  # negative average is treated as independence
    n = len(models)
    print(f"\nmean pairwise error correlation rho = {rho:.2f}")
    if rho >= 1:
        print(f"the models err together on every item: {n} models are worth one opinion")
        return
    print(f"{n} models are worth about {n_eff(n, rho):.2f} independent opinions")
    if rho > 0:
        print(f"no number of models with this rho is worth more than {1 / rho:.1f}")
    print("\nN   N_eff at this rho")
    for k in (1, 2, 3, 5, 10, 20):
        print(f"{k:<3d} {n_eff(k, rho):.2f}")


if __name__ == "__main__":
    main()
C5. Um registro de travessias e um verificador (crossings.py)
Ensina: as regras de medição da Seção 9.1 como código. Um registro é recusado se conta uma instalação como uma travessia, uma conclusão sem um artefato produzido pelo agente, uma parada sem as próprias palavras da pessoa, ajuda sem uma descrição da ajuda, um nome em vez de um rótulo pseudônimo (o rótulo deve ser P seguido de dígitos), um nível pulado que não está listado exatamente, um valor que não é realmente verdadeiro ou falso, uma data ilegível, um campo que o formato não conhece, ou uma travessia de nível 4 que nomeia menos de duas ferramentas solicitadas e respondidas. Uma linha malformada é relatada como rejeitada e nunca interrompe a execução. Limites: verifica a forma dos registros, não sua veracidade; se as duas ferramentas são de famílias de modelos diferentes, e se o arranjo foi executado novamente em uma semana posterior (um segundo registro), são deixados para o pesquisador; é um instrumento de pesquisa, não um aplicativo.
#!/usr/bin/env python3
"""crossings.py: a record format for level transitions, and a checker for it.

Teaching example for "After Chat" (Appendix C, listing C5). MIT licence. A research instrument, not
an application: it defines what a record of one person's attempt at one transition must contain, and
refuses records that would let an installation be counted as use.

The rules follow the measures published in the preregistration the paper describes (OSF, DOI
10.17605/OSF.IO/X4EGQ): a transition counts as crossed only when an artefact produced by the agent is
supplied; installing is an attempt; assisted and unaided crossings are kept apart; a stop is recorded
with the point where it happened and the person's own words. The record format is also published as
a JSON Schema (crossings.schema.json); this checker accepts exactly what the schema accepts and adds
the rules a schema cannot state.

What the checker enforces for a level-4 crossing: at least two tools named as asked and as answered.
What it leaves to the researcher: that the tools are different model families, and that the
arrangement was rerun in a later week (a second record).

Usage:
    python3 crossings.py records.jsonl        # one JSON object per line
    python3 crossings.py --demo
"""
import datetime
import json
import re
import sys

LEVELS = ("chat", "safe_agentic_environment", "agent_on_own_computer", "orchestrated_work")
ARTEFACTS = ("file", "folder", "screenshot", "pasted_output", "none")
DECISIONS = ("accept", "revise", "escalate", "discard")
REQUIRED = ("record_id", "person", "level_from", "level_to", "materials_sent", "completed", "assisted")
# Every key a record may carry; the same set as the properties of crossings.schema.json.
ALLOWED = REQUIRED + ("skipped", "intervention", "artefact", "stop_point", "stop_reason_own_words",
                      "stop_reason_code", "multi_model", "interface_version", "operating_system",
                      "network_access", "permission_mode", "policy_constraint", "acceptance_decision")
PERSON = re.compile(r"^P[0-9]+$")


def parse_date(value):
    try:
        return datetime.date.fromisoformat(value)
    except (TypeError, ValueError):
        return None


def check(rec):
    problems = []
    if not isinstance(rec, dict):
        return ["record must be a JSON object"]
    for key in REQUIRED:
        if key not in rec:
            problems.append(f"missing field '{key}'")
    unknown = sorted(set(rec) - set(ALLOWED))
    if unknown:
        problems.append("unknown fields (the schema forbids them): " + ", ".join(unknown))
    if problems:
        return problems
    if not isinstance(rec["person"], str) or not PERSON.match(rec["person"]):
        problems.append("person must be a pseudonymous label such as P07, never a name")
    for key in ("completed", "assisted"):
        if not isinstance(rec[key], bool):
            problems.append(f"{key} must be true or false, not {rec[key]!r}")
    if rec["level_from"] not in LEVELS or rec["level_to"] not in LEVELS:
        problems.append("level must be one of " + ", ".join(LEVELS))
    else:
        i_from, i_to = LEVELS.index(rec["level_from"]), LEVELS.index(rec["level_to"])
        if i_to <= i_from:
            problems.append("level_to must be above level_from")
        else:
            # Levels are ordered, not compulsory: a route may go from chat straight to an agent on the
            # person's own computer. A skip is allowed, but it is recorded, never silent, and exactly.
            expected = list(LEVELS[i_from + 1:i_to])
            if expected and rec.get("skipped") != expected:
                problems.append("a move over more than one level must list exactly the levels it "
                                "skipped in 'skipped': " + ", ".join(expected))
            if not expected and rec.get("skipped"):
                problems.append("'skipped' must be empty or absent for a move of one level")
    sent = parse_date(rec["materials_sent"])
    if sent is None:
        problems.append("materials_sent must be an ISO date (YYYY-MM-DD)")
    art = rec.get("artefact", {"type": "none"})
    if not isinstance(art, dict) or art.get("type") not in ARTEFACTS:
        problems.append("artefact.type must be one of " + ", ".join(ARTEFACTS))
        art = {"type": "none"}
    if "produced_by_agent" in art and not isinstance(art["produced_by_agent"], bool):
        problems.append("artefact.produced_by_agent must be true or false")
    if "date" in art:
        art_date = parse_date(art["date"])
        if art_date is None:
            problems.append("artefact.date must be an ISO date (YYYY-MM-DD)")
        elif sent and art_date < sent:
            problems.append("artefact dated before the materials were sent")
    if rec["completed"] is True:
        # Installation is an attempt; only something the agent produced counts as a crossing.
        if art.get("type") == "none" or art.get("produced_by_agent") is not True:
            problems.append("completed=true needs an artefact with produced_by_agent=true")
        if rec["level_to"] == "orchestrated_work":
            mm = rec.get("multi_model") or {}
            asked = mm.get("asked") if isinstance(mm, dict) else None
            answered = mm.get("answered") if isinstance(mm, dict) else None
            if not isinstance(asked, list) or len(set(asked)) < 2 or \
               not isinstance(answered, list) or len(set(answered)) < 2:
                problems.append("a level-4 crossing needs multi_model.asked and multi_model.answered "
                                "with at least two tools each (Table 1: two model families)")
    elif rec["completed"] is False:
        if not rec.get("stop_point") or not rec.get("stop_reason_own_words"):
            problems.append("a non-completion records stop_point and stop_reason_own_words")
    if rec["assisted"] is True and not rec.get("intervention"):
        problems.append("assisted=true needs a description of the intervention")
    if "acceptance_decision" in rec and rec["acceptance_decision"] not in DECISIONS:
        problems.append("acceptance_decision must be one of " + ", ".join(DECISIONS))
    if "network_access" in rec and not isinstance(rec["network_access"], bool):
        problems.append("network_access must be true or false")
    return problems


DEMO = [
    {"record_id": "r1", "person": "P01", "level_from": "chat", "level_to": "safe_agentic_environment",
     "materials_sent": "2026-09-08", "completed": True, "assisted": False,
     "artefact": {"type": "folder", "date": "2026-09-09", "produced_by_agent": True}},
    {"record_id": "r2", "person": "P02", "level_from": "chat", "level_to": "safe_agentic_environment",
     "materials_sent": "2026-09-08", "completed": True, "assisted": False,
     "artefact": {"type": "screenshot", "produced_by_agent": False}},
    {"record_id": "r3", "person": "P03", "level_from": "chat", "level_to": "agent_on_own_computer",
     "skipped": ["safe_agentic_environment"], "materials_sent": "2026-09-08", "completed": False,
     "assisted": False, "stop_point": "(invented) download page",
     "stop_reason_own_words": "(invented) the page offered four versions and I did not know which"},
    {"record_id": "r4", "person": "Jane", "level_from": "chat", "level_to": "orchestrated_work",
     "materials_sent": "2026-09-08", "completed": False, "assisted": True},
]


def main():
    if len(sys.argv) > 1 and sys.argv[1] != "--demo":
        records = []
        for n, line in enumerate(open(sys.argv[1]), 1):
            if line.strip():
                try:
                    records.append(json.loads(line))
                except json.JSONDecodeError as exc:
                    records.append({"_malformed": f"line {n}: {exc}"})
    else:
        records = DEMO
        print("(demo: four invented records, two of them deliberately wrong)\n")
    bad = 0
    for rec in records:
        try:
            if isinstance(rec, dict) and "_malformed" in rec:
                problems = ["not valid JSON: " + rec["_malformed"]]
            else:
                problems = check(rec)
        except Exception as exc:  # a malformed record is rejected, never a crash
            problems = [f"malformed record: {exc!r}"]
        bad += bool(problems)
        rid = rec.get("record_id", "?") if isinstance(rec, dict) else "?"
        print(f"{str(rid):6s} {'OK' if not problems else 'REJECTED'}")
        for p in problems:
            print(f"       - {p}")
    print(f"\n{len(records) - bad} of {len(records)} records accepted")
    sys.exit(1 if bad else 0)


if __name__ == "__main__":
    main()
O mesmo formato de registro é publicado como um JSON Schema (crossings.schema.json) para que outras ferramentas possam validar a forma de um registro; o verificador acima implementa as regras que o esquema não consegue expressar (que uma instalação não é um cruzamento, que uma parada precisa das palavras próprias da pessoa, que uma ajuda precisa de uma descrição, e que um pulo foi registrado).
{
  "$schema": "https://json-schema.org/draft/2020-12/schema",
  "$id": "https://example.org/after-chat/crossing-record.schema.json",
  "title": "CrossingRecord",
  "description": "One person's attempt at one transition of the four-level model. Companion to crossings.py, which accepts exactly what this schema accepts and adds the rules the schema cannot express (installation is not a crossing; a stop needs the person's own words; help needs a description; a skip is recorded exactly; a level-4 crossing names at least two tools asked and answered). MIT licence.",
  "type": "object",
  "required": ["record_id", "person", "level_from", "level_to", "materials_sent", "completed", "assisted"],
  "properties": {
    "record_id": {"type": "string"},
    "person": {"type": "string", "pattern": "^P[0-9]+$", "description": "Pseudonymous label such as P07. Never a name."},
    "level_from": {"enum": ["chat", "safe_agentic_environment", "agent_on_own_computer", "orchestrated_work"]},
    "level_to": {"enum": ["chat", "safe_agentic_environment", "agent_on_own_computer", "orchestrated_work"]},
    "skipped": {"type": "array", "items": {"enum": ["safe_agentic_environment", "agent_on_own_computer"]},
                "description": "Exactly the levels passed over when the move spans more than one level. A skip is allowed and never silent."},
    "materials_sent": {"type": "string", "format": "date"},
    "completed": {"type": "boolean"},
    "assisted": {"type": "boolean"},
    "intervention": {"type": "string", "description": "Required when assisted is true: what the helper did."},
    "artefact": {
      "type": "object",
      "properties": {
        "type": {"enum": ["file", "folder", "screenshot", "pasted_output", "none"]},
        "date": {"type": "string", "format": "date"},
        "produced_by_agent": {"type": "boolean"},
        "sha256": {"type": "string", "description": "Hash of the artefact if deposited; never the content."}
      },
      "required": ["type"]
    },
    "stop_point": {"type": "string", "description": "Required when completed is false: where the attempt stopped."},
    "stop_reason_own_words": {"type": "string", "description": "Required when completed is false: the person's own words, verbatim."},
    "stop_reason_code": {"type": "string", "description": "Assigned after collection by a published coding scheme (Appendix A)."},
    "multi_model": {
      "type": "object",
      "description": "For transition 3: the denominator of a council run. A completed level-4 record needs at least two tools in asked and in answered; that they are different model families is for the researcher to verify.",
      "properties": {
        "asked": {"type": "array", "items": {"type": "string"}},
        "answered": {"type": "array", "items": {"type": "string"}},
        "timed_out": {"type": "array", "items": {"type": "string"}},
        "diverged": {"type": ["boolean", "null"]},
        "changed_decision": {"type": ["boolean", "null"]},
        "coverage_hit": {"type": ["boolean", "null"]}
      }
    },
    "interface_version": {"type": "string", "description": "Optional implementation record: the agent and its version."},
    "operating_system": {"type": "string", "description": "Optional implementation record."},
    "network_access": {"type": "boolean", "description": "Optional implementation record: whether the agent had network access."},
    "permission_mode": {"type": "string", "description": "Optional implementation record: the permission mode in force."},
    "policy_constraint": {"type": "string", "description": "Optional implementation record: any employer or platform rule that applied."},
    "acceptance_decision": {"enum": ["accept", "revise", "escalate", "discard"], "description": "Optional: the person's decision from the acceptance record."}
  },
  "additionalProperties": false
}
C6. Segurança antes do nível 3 (safety/)
Ensina: as práticas da Seção 5.3 como configuração. O primeiro arquivo é um arquivo de configurações de exemplo do projeto para Claude Code: modo plan por padrão (o fornecedor renomeou seu modo padrão para "Manual" em julho de 2026; "plan" continua válido e é a escolha pedagógica mais segura), os comandos comuns destrutivos e de download negados, os arquivos secretos usuais negados tanto para o leitor de arquivo quanto para um shell cat, deleções e buscas da web solicitadas. Uma lista de negação é apenas uma lista: um modo permissivo ou um comando não listado pode contorná-la, portanto, as configurações de sandbox importam tanto quanto as regras. O segundo é uma configuração de exemplo para Codex do OpenAI, fornecida em sua forma por execução, com escopo de pasta: escritas limitadas à pasta de trabalho, sem rede, aprovação mediante solicitação. O terceiro é uma lista de verificação. Limitações: regras de permissão e sandboxes reduzem o raio de impacto; eles não tornam um agente confiável, e a sintaxe das regras muda entre versões.
{
  "permissions": {
    "defaultMode": "plan",
    "deny": [
      "Bash(rm -rf:*)",
      "Bash(sudo:*)",
      "Bash(curl:*)",
      "Bash(wget:*)",
      "Bash(cat .env:*)",
      "Bash(git push:*)",
      "Read(./.env)",
      "Read(./.env.*)",
      "Read(./secrets/**)"
    ],
    "ask": [
      "Bash(rm:*)",
      "Bash(mv:*)",
      "WebFetch"
    ]
  }
}
# Folder-scoped, per-run form (the policy of this paper): run the agent from the working copy with
# codex -C <folder> -s workspace-write -a on-request
# The same values in ~/.codex/config.toml apply to every run on the machine.
# The agent may write only inside the working folder, has no network by default,
# and asks before anything outside those limits.
approval_policy = "on-request"
sandbox_mode = "workspace-write"
[sandbox_workspace_write]
network_access = false# Pre-flight checklist before a person lets an agent act on their own computer
1. Work in a copy. Make a new folder for the agent and put copies of the files in it, never originals.
If the files live in a cloud-synchronised tree, copy them out of it first: agents have deleted the
zero-byte placeholders that cloud services leave for offloaded files, taking the originals with them.
2. Start in plan mode. Ask for a written plan first; read it; only then let the agent act.
3. Keep secrets out. No passwords, keys or client documents in the working folder.
4. Deny network by default. Turn it on only for a job that needs it, and then for named sites.
5. Confirm before anything irreversible: sending, deleting, publishing, purchasing.
6. Treat what the agent reads on the web as content, never as instructions. A page can carry hidden text
written to redirect an agent.
7. Treat another agent's answer the same way: content to compare, never instructions to act on. A second
model can pass on instructions it picked up from a page it read.
8. Use a separate browser profile for any agent that browses, signed out of banking and health sites.
9. Never type passwords, one-time codes or card numbers into the agent.
10. Ask "what could go wrong with this?" before approving a command you do not understand.
11. Keep an undo: a snapshot of the folder (or a version-control commit) before each larger change.
12. Keep a working stop. Before a long job, know how to stop it and whether stopping deletes the work.
13. Stop and revoke access when the task, the workspace or the sensitivity of the data changes.
14. Escalate a high-consequence decision to a person who is accountable for it; the agent proposes, the
person decides.C7. Traços de supervisão como um log (jsonl_log.py)
Ensina: o menor registro útil do trabalho de um gerenciador, um objeto JSON com timestamp por evento, para que planos recusados, diffs rejeitados, segundas opiniões obtidas e execuções concluídas (os traços de supervisão da proposição P10) possam ser contados posteriormente com a biblioteca padrão. Execute com --demo. Limitações: é um escritor, não um rastreador; registra o que a pessoa ou o agente lhe diz.
#!/usr/bin/env python3
"""jsonl_log.py: append one timestamped event to a JSONL file.

Teaching example for "After Chat" (Appendix C, listing C7). MIT licence.

The smallest useful record of a manager's work: one JSON object per event, one event per line,
each with a UTC timestamp. Events such as "plan_refused", "diff_rejected", "second_opinion_taken"
or "run_completed" are the supervision traces that proposition P10 asks for. A later paper can
parse the file with the standard library. This is a writer, not a tracer: it records what you tell it.

Usage:
    python3 jsonl_log.py run.jsonl '{"event": "plan_refused", "task": "friday-pack"}'
    python3 jsonl_log.py --demo
"""
import json
import sys
from datetime import datetime, timezone
from pathlib import Path


def log(path, event):
    """Append one event; the timestamp is added unless the caller set one."""
    event = dict(event)
    event.setdefault("ts", datetime.now(timezone.utc).isoformat(timespec="seconds"))
    with Path(path).open("a", encoding="utf-8") as f:
        f.write(json.dumps(event, ensure_ascii=False) + "\n")
    return event


def main():
    if len(sys.argv) == 2 and sys.argv[1] == "--demo":
        import tempfile
        path = Path(tempfile.mkdtemp()) / "demo.jsonl"
        for ev in ({"event": "plan_refused", "task": "demo"},
                   {"event": "second_opinion_taken", "task": "demo", "family": "other-vendor"},
                   {"event": "run_completed", "task": "demo", "artefact": "demo/plan/"}):
            log(path, ev)
        print(path.read_text(), end="")
        return
    if len(sys.argv) < 3:
        print('usage: jsonl_log.py FILE \'{"event": "plan_refused"}\'   or   jsonl_log.py --demo',
              file=sys.stderr)
        sys.exit(2)
    print(json.dumps(log(sys.argv[1], json.loads(sys.argv[2]))))


if __name__ == "__main__":
    main()
Apêndice D. Tabela resolvida do número efetivo de opiniões
Um gerenciador de agentes que não deseja executar a listagem C4 ainda pode usar o teto. Cada célula é N_eff = N / (1 + (N - 1) rho); a última linha é o teto 1/rho, que nenhum número de modelos com essa correlação pode exceder. Os valores de rho foram escolhidos para ilustrar a fórmula e não medem nada. Em uso, rho é a correlação média aos pares dos erros, uma quantidade diferente da proporção de erros conjuntos em que dois modelos concordam, e deve ser estimada em itens com respostas conhecidas no domínio em questão (listagem C4).
| N modelos | rho = 0.2 (ilustração) | rho = 0.5 (ilustração) | rho = 0.6 (ilustração) | rho = 0.8 (ilustração) |
|---|---|---|---|---|
| 2 | 1.67 | 1.33 | 1.25 | 1.11 |
| 3 | 2.14 | 1.50 | 1.36 | 1.15 |
| 5 | 2.78 | 1.67 | 1.47 | 1.19 |
| 10 | 3.57 | 1.82 | 1.56 | 1.22 |
| Teto, 1/rho | 5.00 | 2.00 | 1.67 | 1.25 |
A tabela é a razão pela qual a Seção 6 recomenda a uma pessoa gastar a próxima assinatura em uma família diferente em vez de uma décima janela da mesma. A diversidade de famílias, uma verificação ponto a ponto contra as fontes e um dissenso preservado realizam o trabalho que um N maior não pode fazer. Como rho depende da tarefa, deve ser estimado em itens do próprio domínio da pessoa (listagem C4).
Apêndice E. Censo da paisagem, 19 a 21 de setembro de 2026
A Tabela 5 no texto principal agrupa as ferramentas por padrão. Este apêndice registra o censo bruto que a sustenta, para leitores que desejam os números como estavam nas datas fornecidas. As contagens de estrelas variam diariamente; elas rastreiam a popularidade e não dizem nada sobre a qualidade ou o número de usuários, portanto não devem ser citadas a partir da data do leitor. A coluna de padrão é meu mapeamento, e os próprios projetos não fazem tal afirmação.
| Projeto | Localização | Estrelas (aproximado, 21 de setembro de 2026) | Licença | Padrão |
|---|---|---|---|---|
| anthropics/claude-code | github.com/anthropics/claude-code | 147.000 | Código-fonte disponível, licença proprietária | Agente de terminal (nível 3) |
| openai/codex | github.com/openai/codex | 126.000 | Apache-2.0 | Agente de terminal (nível 3) |
| google-gemini/gemini-cli | github.com/google-gemini/gemini-cli | 107.000 | Apache-2.0 | Agente de terminal; níveis individuais não são mais servidos desde 18 de junho de 2026 |
| cline/cline | github.com/cline/cline | 69.000 | Apache-2.0 | Editor e agente de terminal |
| openai/codex-plugin-cc | github.com/openai/codex-plugin-cc | 33.400 | Apache-2.0 | Plugin oficial: agente de um fornecedor dentro de outro |
| jackwener/OpenCLI | github.com/jackwener/OpenCLI | 29.500 | Consulte o repositório | Chat web exposto a agentes |
| karpathy/llm-council | github.com/karpathy/llm-council | 24.900 | Consulte o repositório | Conselho em uma interface de programação |
| ai-shifu/ChatALL | github.com/ai-shifu/ChatALL | 16.500 (cerca de 847.000 downloads da versão mais recente) | Apache-2.0 | Transmissão de navegador |
| BeehiveInnovations/pal-mcp-server | github.com/BeehiveInnovations/pal-mcp-server | 11.800 (último commit dezembro de 2025) | Apache-2.0 | Servidor de consulta entre modelos |
| MoonshotAI/kimi-cli | github.com/MoonshotAI/kimi-cli | 11.400 | Apache-2.0 | Agente de terminal (nível 3) |
| chathub-dev/chathub | github.com/chathub-dev/chathub | 10.700 | GPL-3.0 | Transmissão de navegador |
| nyldn/claude-octopus | github.com/nyldn/claude-octopus | 4.100 | MIT | Conselho CLI |
| aarondfrancis/counselors | github.com/aarondfrancis/counselors | 660 | MIT | Conselho CLI escrevendo um arquivo por ferramenta |
| xai-org/grok-build | github.com/xai-org/grok-build | 26.900 | Apache-2.0 | Agente de terminal com modo sem interface e protocolo de agente |
Como citar
Chernets, V. (2026). After Chat: The Three Transitions Between Non-Programmers and Agentic AI [Pré-impressão]. SSRN. https://doi.org/10.2139/ssrn.7520019
@misc{chernets2026afterchat,
  author       = {Chernets, Vadym},
  title        = {{After Chat: The Three Transitions Between Non-Programmers and Agentic AI}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7520019},
  url          = {https://doi.org/10.2139/ssrn.7520019}
}