Театр верифікації: виміряні режими відмов панелей верифікаторів ШІ
Це переклад. Основна версія — оригінал англійською; посилайтеся на неї.
Vadym Chernets, Незалежний дослідник · ORCID 0009-0007-4845-3163
Zenodo DOI 10.5281/zenodo.23197641 · GitHub
Прийнято як постер на воркшопі NeurIPS 2026 "Хто верифікує агентів? На шляху до надійного розроблення агентів" (не архівна). Архівована копія: 10.5281/zenodo.23197641. PDF: verification-theater.pdf. Фігури та таблиці, наведені нижче, конвертовані з LaTeX-джерела; PDF є авторитативним.
Анотація
Багатоагентна верифікація стає стандартним механізмом довіри: відповідь довіряють, тому що незалежні моделі погодилися з нею. Використовуючи попередньо зареєстровану, сліпу колекцію з нульовою температурою, в якій шістнадцять моделей (дев'ять провідних продавців, сім локальних з відкритими вагами) відповіли на одні й ті ж 1500 фактичних питань (плюс 750-питанне розділення з множинним вибором та розвідувальним діалоговим розділенням), ми вимірюємо, коли верифікація панелі перестає працювати, але продовжує виглядати як що працює—стан, який ми називаємо театром верифікації. Ми звітуємо про чотири режими відмови. По-перше, інверсія складності: підйом сертифікації незалежної згоди—2.7–4.6 на легших трьох квінтилях питань—падає до 0.82 на другому найважчому квінтилі та до нуля на найважчому, де повторювані відповіді були правильними в 0 з 342 випадків (13 очікуваних за незалежності). Перестратифікація без панелі (складність ранжована 13 непанельними моделями) усуває об'єднану інверсію (78/354 правильних, підйом 2.36) тоді як нуль зберігається для кроскноблокової панелі (0/116); ми звітуємо про обидві кодування разом протягом: на питанях, які розгорнута популяція вважає найважчими, згода функціонує як сертифікація помилки. По-друге, обмежені простори відповідей: під час множинного вибору (локальний рівень), панелі одностайно сертифікували неправильну відповідь на 4.0–7.9% питань, порівняно з 1.5–4.6% на відкритих формах того ж рівня та 0.3–4.9% провідних відкритих форм. По-третє, етикетки, використані як проксі для незалежності, емпірично не спрацьовують: геополітичний блок не передбачає кореляцію помилок (середня внутрішньоблокова 0.285 проти кроскноблокової 0.274, різниця ), та модель міркування, дистильована з однієї й тієї ж основи як її партнер на панелі, була серед найменш корельованих пар виміряних (; 14-та з 15 місцевих пар блоку США/КНР, 20-та з усіх 21 місцевих пар). По-четверте, конформність: верифікатор, який не погодився з відповіддю, схвалив ту ж саму відповідь у 38.5% випадків, коли показали її як колегіну; контроль зворотного запиту показує, що ці переходи відслідковують наявність впевненої пропозиції, а не її правильність (38.9% до неправильної проти 34.7% до правильної; McNemar exact ). Ми стверджуємо, що ці режими мають спільний економічний корінь, та виводимо дисципліну вимірювання, яка розділяє верифікацію від її театру.
Вступ: театральна проблема
Панелі моделей ШІ, які перевіряють одна одну, розповсюджуються як інфраструктура довіри, і домовленість між ними все частіше розглядається як доказ. Дослідження безпеки давно назвало механізми, які створюють естетику захисту без його сутності (Schneier, 2003); ми запитуємо, на основі вимірювань, а не метафори, коли перевірка панеллю заслуговує цієї назви. Основний висновок – це інверсія: цінність сертифікації згоди зосереджена на легких питаннях і зникає — або змінюється на протилежну — саме там, де перевірка має найбільше значення. Ми розглядаємо це не як одну аномалію, а як один із чотирьох окремих режимів, у яких панель перевірювача зберігає видимість перевірки, втрачаючи її сутність, і ми пов'язуємо чотири з однією спільною економічною причиною та однією спільною відповіддю.
Конкретно, цей документ робить такі внески: (C1) розшаровані за складністю вимірювання приросту сертифікації, що показує, що цінність сертифікації незалежної згоди зосереджена на легких питаннях і, за мірою складності популяції, інвертується на найважчому квінтилі (0 з 342 відтворених правильних відповідей; за складністю, незалежною від панелі, об'єднана інверсія зникає і нуль залишається для міжблокової панелі, 0/116) — два кодування звітуються разом протягом; (C2) свідчення того, що обмежені (множинні вибори) простори відповідей доводять помилку одноголосної сертифікації до 4,0–7,9%, значно вище, ніж діапазон відкритої форми 0,3–4,9%; (C3) два попередньо зареєстровані нульові результати, що показують, що мітки, які регулярно використовуються як проксі незалежності — геополітичний блок і родовід моделі — не передбачають кореляцію помилок, тому незалежність має вимірюватися для кожної пари як -матриця, а не передбачатися на основі бренду або родоводу; (C4) вимірювання відповідності з контролем зворотного запиту, що демонструє, що верифікатори режиму діалогу відстежують наявність впевненої пропозиції, а не її істинність. Протокол сліпого збору та конструкт довіри викладені повністю у супровідній роботі та тут узагальнені лише наскільки вимірювання вимагають; все, що повідомляється як результат у цій роботі (C1–C4), вимірюється тут і не повторюється з неї. З них ми виводимо (C5) дисципліну вимірювання — опубліковані -матриці для кожного класу завдань, претензії на сертифікацію, розшаровані за складністю, запит сліпо першим, та укрупнення важких режимів — які операційно розділяють перевірку від її театру.
Попередні роботи та рамкування
Відказостійкий консенсус (BFT) припускає незалежні відмови—припущення, яке ми тестуємо і вважаємо невиправданим. Література про парадокс консенсусу вже називає помилку, стабілізовану угодою, у однорідних роях (Shehata and Li, 2026). zkML перевіряє, що обчислення запустилося, а не що його відповідь правильна—доповнюючі, а не конкуруючі. Дилема Верифікатора забезпечує аналіз стимулів; (Raji et al., 2022) забезпечують задачу вибору аудитора; (Du et al., 2024), (Farquhar et al., 2024) і (Ding, 2026) забезпечують літературу сигналу угоди, яку цей документ піддає тестуванню на стійкість. Сама конструкція довіри була представлена в супровідній статті (Chernets, 2026); ця робота показує, де двигун верифікації конструкції виходить з ладу, здаючись при цьому працюючим. Робота з обчислення на момент тестування дійшла до доповнюючого висновку з конструктивного боку: ансамблі верифікаторів різних аспектів перевищують будь-якого окремого верифікатора (Lifshitz et al., 2025), панель малих суддів, відібраних з непересічних сімей, перевищує одного великого судді за дріб вартості (Verga et al., 2024), і систематична переоцінка багатоагентної дебати визначає гетерогенність моделі як один надійний покращувач (Zhang et al., 2025); напрямок дебати демонструє структурований противоставний аргумент, що допомагає слабшим суддям досягати правдивіших відповідей (Khan et al., 2024). Рецензована доказова база вже документує суттєву кореляцію помилок між провайдерами—найбільшу саме серед найточніших моделей, навіть у межах різних архітектур та провайдерів (Kim et al., 2025)—що незалежно мотивує вимірювання залежності, а не висновок про неї на основі позначок. Та література вибирає панелі для різноманітності; ця робота вимірює, яка цінність у вибраної-для властивості—і що мовчазно коштує її відсутність—у верифікації.
Дані та вимірювання
Одна попередньо зареєстрована, сліпа збірка (протокол заморожено публічно перед збиранням підтвердження даних; публічна реєстрація за адресою https://osf.io/4y9dv): шістнадцять моделей попередньо зареєстрована випадкова підвибірка 1,500 з 4,326 елементів SimpleQA (фіксований seed, відібрано перед будь-якою збіркою; CSV підвибірки з приєднаним SHA-256 до замороженої реєстрації) при температурі нуль зі вказаною впевненістю 0–100 (13,446 чистих відповідей передового рівня; 8,802 відповіді локального рівня); плече TruthfulQA MC1 з 750 елементів на локальному рівні, отримане з замороженої копії офіційного файлу репозиторію (790 елементів, байт-ідентичне канонічному CSV) попередньо зареєстрованим конструктором, що вимагає щонайменше двох різних неправильних варіантів на елемент (фіксований seed перетасування; 695 елементів повністю відповіли всіма сімома моделями); дослідницьке плече активного порівняння зі слідкою взаємодією. SimpleQA зібрана адверсарно проти моделі передового рівня з однією безспірною відповіддю на питання (Wei et al., 2024): важкий шар тому зондує справжні межі параметричного знання, а оцінка зводиться до еквівалентності золотому стандарту. TruthfulQA забезпечує плече обмеженого простору відповідей (Lin et al., 2022). Панелі є аналітичними комбінаціями однієї слідкої збірки; весь повторний аналіз є детермінованим (кодування рядкової еквівалентності, де відмови та нульове перекриття рахуються як неузгодженість; невизначені пари у дужках). Складність операціоналізується спостережно як середня точність 16-моделей на питання, розділено на квінтилі рангу з 300 питань. Та сама необроблена збірка підтримує супровідну роботу (Chernets, 2026), яка повідомляє про об'єднані коефіцієнти сертифікації та короткі резюме аналізів, деталізованих тут; розшарована за складністю драбина піднесення, набір надійності, -матриця та розкладання конформності з'являються лише в цій роботі, і кожне залишилось перекриття виділено перехресно в тексті.
Оцінка вільної форми є двостадійною: детермінований проход рядкової еквівалентності (26,8% оцінок передового рівня) плюс виявлення відмови (6,6%), з залишилими 66,5% оцінено LLM-оцінювачем; людська вибіркова перевірка узгодилася з оцінювачем на 98% випадкової вибірки (). Оскільки дві третини оцінок вироблені моделлю, всі основні результати супроводжуються переділенням, чутливим до помилок оцінювача (10% вердиктів, отриманих від моделі, змінено, 200 переділень із затравою; Розділ 4 та Додаток A).
Режим невдачі I: інверсія складності
Три попередньо визначені фронтальні панелі являють собою аналітичні комбінації 3-моделей з одноразової сліпої вибірки: US-bloc (Anthropic, OpenAI, Google), CN-bloc (DeepSeek, Alibaba, Moonshot) та cross-bloc (Anthropic, DeepSeek, Mistral); відповідь вважається реплікованою, коли принаймні один з двох членів панелі первинної моделі незалежно виробив еквівалентну відповідь під час замороженого детермінованого кодування Розділу 3, і підйом становить . Об'єднані по трьох панелях, ймовірність того, що реплікована відповідь є правильною, зростає від 0.0% (0/342, CI 0.0–1.1) на найтруднішому квінтилі через 12.8%, 57.5% і 81.0% до 95.1% на найлегшому; відповідний підйом над нереплікованими відповідями становить 0.00 / 0.82 / 2.68 / 3.09 / 4.56. На найтруднішому 20% запитань кожна спостережена угода сертифікувала неправильну відповідь, а на наступному квінтилі точкова оцінка розміщує угоду нижче паритету з розбіжністю (0.82, CI [0.51, 1.21]); нульовий показник найтруднішого квінтилю реплікується в кожній панелі окремо (US 0.00–4.25, CN 0.00–9.76, cross-bloc 0.00–4.04); субпаритет Q2 зберігається в панелях CN та cross-bloc, тоді як підйом Q2 у панелі US становить 1.20. Значна частина об'єднаного сертифікаційного підйому забезпечується легкими запитаннями, тому неестратифікована претензія на підйом перебільшує те, що верифікація забезпечує там, де це необхідно. Нульовий Q1 вимірюється відносно живого базового показника, а не підлоги: невідтворені відповіді Q1 є правильними 3.9% часу (89/2286), тому незалежність передбачає правильних реплікованих відповідей—спостережуваний 0 (верхня межа 1.1%) розташований значно нижче базового показника самого шару. Еталон незалежності тут консервативний, а не ліберальний: нуль, що зберігає всю виміряну структуру міжмодельної кореляції—одна поширена перестановка етикеток коректності по запитанням шару, структура репліації заморожена (2,000 перестановок)—очікує 11.7–12.4 правильних реплікованих відповідей і ніколи не виробляла спостережуваний 0 (; мінімум 3); складання виміряної попарної в аналітичний двовимірний нуль піднімає очікування далі, оскільки позитивно корельовані помилки передбачають позитивно корельовані правильні відповіді. Те, що заповнює шар, саме по собі є інформативним: 342 комірки охоплюють 106 запитань—звичайні вузькі фактоїди (медіана 17 слів), не неоднозначне формулювання, а моделі рідко утримуються від них (0.5 з 9 відповідей за запитання). Їхні неправильні відповіді кластеризуються: на 70.8% цих запитань принаймні три з дев'яти фронтальних моделей виробили однакову неправильну відповідь, а на 67.4% запитань, реплікованих більш ніж однією панеллю, незалежно складені панелі сертифікували однаковий неправильний консенсус—типово відповідь про славетного сусіда, що витісняє правильну, але менш видатну сутність. Ручна експертна оцінка всіх 106 золотих мітків виявила 2 сумнівних та 0 явно неправильних; надання кредиту одній явно обґрунтованій панельній відповіді та двом частково обґрунтованим переносить рахунок найтруднішого квінтилю з 0/342 на максимум 13/342 (3.8%), тому висновок близький до нуля зберігається, пом'якшуючи від буквального нуля (одна позначена мітка: 2010 Royal Academy election, оцінена проти титулу честей, який академія не надає). Твердження прямо піддається перевірці: це передбачає підйом Q1 у будь-якій репліції, стратифікованій власною точністю розгорнутої популяції (за панельно-незалежної стратифікації передбачення є нульовим cross-bloc, а не об'єднаним підйомом). Нуль також не є артефактом оцінювача: незалежний другий оцінювач від сім'ї постачальника за межами кожної панелі та первинного оцінювача (температура нуль, ідентичний замороженому еквівалентно-до-золота запит) перевиробив усі 342 вердикти Q1 репліції та погодився на 342/342 (переходить до правильного 0/342, верхня межа 1.1%); синтетичне перевертання 10% оцінених моделлю мітток аналогічно залишає сертифіковану частку помилок на рівні або вище 86.5% у кожному новому зразку (додаток).
Залишення-панелі-вне перестратифікація.
Оскільки члени панелі сприяють індексу складності популяції, найскладніша квінтиль частково обумовлена власною невдачею панелі. Перестратифікуючи тільки за 13 непанельними моделями, репліковані відповіді на найскладнішій квінтилі є коректні в 78/354 випадків (22.0%, об'єднаний коефіцієнт поліпшення 2.36, вище за 33/354 очікуваних при незалежності), і нуль зберігається тільки для міжблокової панелі (0/116; 0/88 на страті, де всі 13 непанельних моделей дають збій). Нуль, що вижив, сам собою характеризується: базова ставка страти становить 31/778 = 3.98% (Wilson 2.8–5.6%), що дає очікування незалежності 4.6 коректних із 116; перестановочна нульова гіпотеза, що зберігає кореляцію (2,000 перестановок) дає , 95% діапазон і —значно нижче за нулову гіпотезу, хоча досяжна під нею. Наведена вище інверсія тому є твердженням про те, де перевірка не вдається щодо того, що розгорнута популяція вважає складним, а не щодо панель-незалежної складності. Як другу перевірку чутливості ми переотримали драбину під кодуванням реплікації без позначень (детермінованим порівнянням рядків сліпих відповідей тільки, ніколи не звертаючись до позначення коректності): результат Q1 по суті не змінився (2/344 репліковані відповіді коректні, 0.6% [0.2–2.1]; коефіцієнт поліпшення 0.15) і коефіцієнти поліпшення нижче 1 на двох найскладніших квінтилях зберігаються, тоді як коефіцієнт поліпшення верхньої квінтилі ослабивається (4.56 до 2.33), тому що чисте порівняння рядків пропускає поверхневі варіанти однієї й тієї ж коректної відповіді; результати множинного вибору залишаються без змін, оскільки там згода кодується буквою відповіді й за побудовою не залежить від позначень.
Три перевірки стійкості підтримують інверсію. (i) Завантажувальна вибірка на рівні питання (2,000 насіяних повторних вибірок в межах квінтилі) дає 95% ДІ для п'яти коефіцієнтів поліпшення [0.00, 0.00], [0.51, 1.21], [2.32, 3.09], [2.84, 3.35] та [4.16, 5.03]: інтервали режиму складності повністю виключають інтервали режиму легкості. (ii) Чутливість до помилок оцінювача: перевертання 10% вердиктів, оцінених моделлю (200 насіяних повторних вибірок; 97.1% з 342 реплікованих відповідей найскладніших квінтилів оцінюються моделлю і таким чином можуть перевертатись) залишає визнану частку помилок найскладнішої квінтилі на рівні або вище 86.5% в кожній повторній вибірці, зберігає коефіцієнт поліпшення Q1 нижче 1 в 92% повторних вибірок (медіана 0.82) та ніколи не наближає коефіцієнти Q1–Q2 до коефіцієнтів Q3–Q5, які залишаються вище 2 в усіх 200 повторних вибірках. (iii) Локальний рівень семи моделей реплікує контраст складність–легкість з незалежними моделями та панелями немонотонно (Q3 ): коефіцієнти поліпшення 0.00 / 0.94 / 0.00 / 1.89 / 4.37 по всіх одних і тих самих квінтилях, з 0 з 166 реплікованих відповідей коректних на найскладнішій квінтилі; цей рівень на 94.8% оцінюється LLM та охоплюється тією ж чутливістю оцінювача повторною вибіркою як (ii).
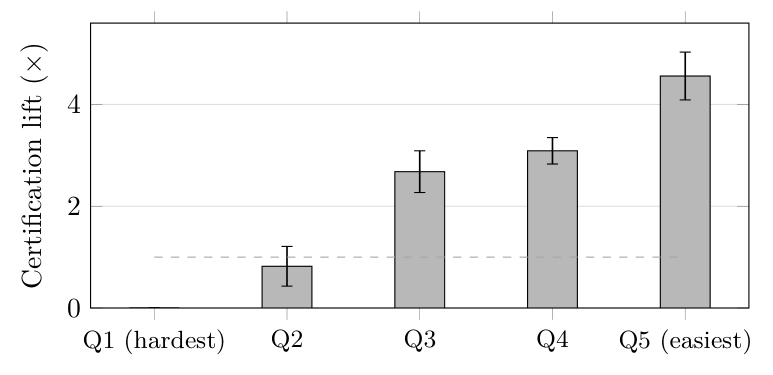 Коефіцієнт сертифікації за складністю квінтилю, об'єднаний по трьом передовим панелям, з інтервалами 95% завантажувальної вибірки на рівні питання (2,000 насіяних повторних вибірок; Додаток A.1). Штрихована лінія позначає lift = 1, паритет з не реплікованими відповідями: дві найскладніші квінтилі розташовані на рівні або нижче за нею за точковою оцінкою (Q1 0.00×—виміряний нуль, а не відсутні дані; Q2 0.82×, його ДІ перетинає паритет), три найлегші значно вище за нею.
Режим відмови II: обмежені простори відповідей
За запитаннями з множинним вибором чотири попередньо задані локальні панелі одностайно зійшлись на неправильному варіанті в 4.0–7.9% із 695 повністю відповідених питань (за панеллю: 4.0, 5.9, 6.6, 7.9), проти детерміністичного діапазону 0.3–4.9% для впевнених одностайних неправильних відповідей у відкритій формі на граничному рівні. Перерахунок тієї ж метрики сертифікації на основі власних відповідей у відкритій формі локального рівня (8,802 оцінених відповідей SimpleQA) усуває змішування рівня та формату: ті ж локальні панелі сертифікують одностайні впевнені помилки лише на 1.5–4.6% елементів у відкритій формі під час суворого детерміністичного кодування (до 9.8% включно з невизначеним діапазоном), що відповідає діапазону граничної відкритої форми—закономірність, що відповідає обмеженому простору відповідей, а не рівню моделі, яка спричиняє сертифікацію помилок; однак залишається одне змішування: гілка множинного вибору та гілки відкритої форми — це різні набори питань (TruthfulQA MC1 проти SimpleQA), тому формат та набір питань тут не розділені, й причинна форма твердження розв'язується лише шляхом обміну форматом одного питання, який ми не виконали.1 Бутстреп за панеллю встановлює інтервали на розриву, де це виправдано: МВ мінус помилка консенсусу відкритої форми становить pp [2.9, 6.8] (пілотна), pp [3.9, 8.1] (US-локальна), та pp [2.6, 6.3] (крос-блокова), кожна виключає нуль; панель CN-локаль, чия комірка відкритої форми спирається на набір з 87 елементів виноски, не розв'язує це. Меню перетворює розсіяні помилки на спільні: коли простір відповідей малий, подібні моделі потрапляють на той же відволікаючий варіант, і одностайність панелі стає посилювачем помилок. Показники не пояснюються незалежними помилками: коли кожен член незалежно помиляється за своєю граничною частиною й помилки розповсюджуються на неправильних варіантів (), очікувана частина одностайної однієї неправильної відповіді становить 0.49–0.92% на чотирьох панелях—спостережувана 4.0–7.9% становить надлишок у 4.9–13.5 порівняно з базовою лінією незалежності. Наслідок проектування, виражений як перевіряємо правило: будь-який інтерфейс, який передає агентам фіксований набір варіантів, повинен очікувати матеріально вищу помилку консенсусу, ніж вилучення у відкритій формі на тому ж змісту.
Вимога вказаної впевненості від усіх трьох панелистів навряд чи впливає на ефект: діапазон помилки консенсусу зміщується з 4.0–7.9% на 4.0–7.2% (за панеллю 4.0, 5.2, 6.0, 7.2), тобто майже всі одностайні неправильні відповіді також впевнені. Невдача також не обмежена тематичною нішею: на десяти категоріях TruthfulQA по мінімум 20 елементів, об'єднаний показник помилки консенсусу становить 1.0% (Теорії змови) до 8.6% (Економіка), з Правом, Здоров'ям та Соціологією між ними (Додаток A).
Режим відмови III: етикетки незалежності не передбачають незалежність
На основі 36 пар передових постачальників (1 448 спільних питань) попарна кореляція помилок охоплює 0.123–0.395, і спектр організований не за етикетками, до яких люди звертаються: найбільш і найменш корельовані пари — обидві внутрібльокові (googlexai 0.395 проти googleopenai 0.123), середні внутрібльокові та міжбльокові відрізняються на , а пара однакового походження займає 14-е місце з 15 пар, утворених шістьма локальними моделями блоку US/CN на 695 повністю відповідених питаннях з множинним вибором (; сьома локальна модель належить до EU-блоку і знаходиться поза попередньо зареєстрованою конструкцією блоку/походження — включення її дає 21 пару, з яких пара однакового походження займає 20-е місце). Обидві попередньо зареєстровані нульові гіпотези (блок, походження) залишаються після переаналізу; те, що залишається передбачуваним, — це сама виміряна кореляція. Практичне правило: незалежність — це величина, що вимірюється для кожної пари, для кожного класу завдань (матриця ), а не виведена з бренду, прапора чи сімейного дерева — складання панелі за етикетками — це припущення, а не перевірка. Попарна вимірює емпіричну залежність помилок, а не повну статистичну незалежність: низька не виключає залежність вищого порядку в панелях із трьома або більше, додаткова причина розглядати незалежність як виміряну, обумовлену завданням величину, а не як припущену властивість.
Точний тест перестановок над усіма 630 присвоєннями етикеток блоків дев'яти постачальникам не знаходить ніяких доказів ефекту блоку: спостережена різниця внутрібльокового мінус міжбльокового перевищена або дорівнює 132 з 630 переозначень (односторонній ; 95% довірчий інтервал на основі кластеризованого бутстрепу для різниці ). Тест обмежує твердження — малі ефекти блоку не виключаються — і операційний висновок залишається: етикетка не несе сигналу, придатного для використання замість вимірювання для кожної пари. Оскільки обмежена зверху, коли базові показники помилок пари відрізняються, ми повторно запустили аналіз на маргінально-нормалізованому коефіцієнті : обидві попередньо зареєстровані нульові гіпотези залишаються (різниця блоку , перестановка ; пара однакового походження залишається 14-ю з 15), спектр зберігається (0.278–0.821 по передових парам), і крайні значення переміщуються до двох міжбльокових пар (anthropicmoonshot 0.821, mistralopenai 0.278) — за будь-якою метрикою, жодна етикетка не організує спектр. Розширюючи матрицю на всі шістнадцять моделей: на 81 питанні, відповідану кожною моделлю, попарна охоплює до (120 пар; блокові середні значення: передовий–передовий 0.320, локальний–локальний 0.350, передовий–локальний 0.210) — спектр на порядок величини, який жодна таксономія етикеток у наших даних не передбачає (Figure 2). При 81 спільному елементі окремі оцінки клітин мають широкі інтервали; результат — сам спектр, а не будь-яка окрема клітина.
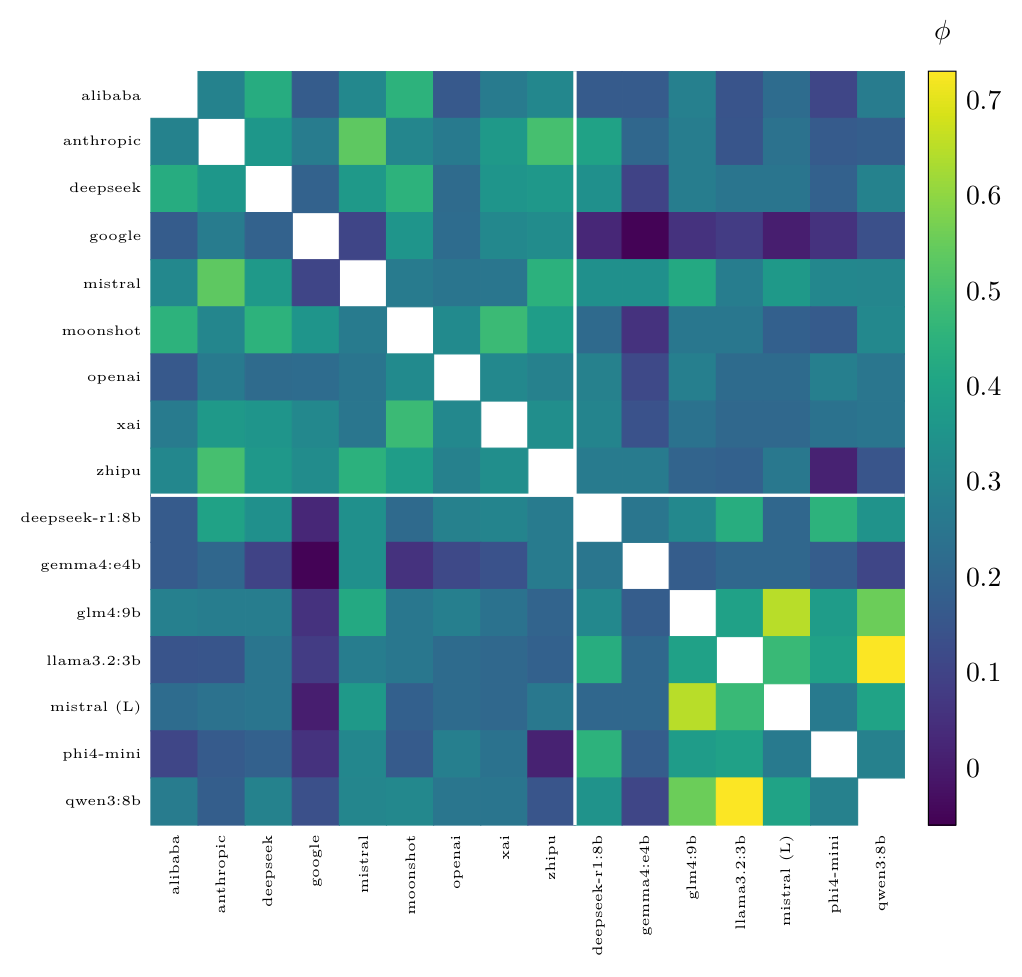 Попарна кореляція помилок (ϕ) серед усіх шістнадцяти моделей за 81 питанням, на які дали відповідь усі моделі (дев'ять провідних постачальників, потім сім локальних моделей з відкритими вагами; розділення провідних/локальних позначено білими лініями). Кожна позадіагональна комірка — це одна з 120 унікальних пар; діагональ (автокореляція = 1,0) залишена порожною за задумом, щоб вона не стискала шкалу кольорів. ϕ охоплює −0,05 до 0,73 (середнє 0,27): розкид на порядок величини в кореляції помилок будь-яких двох верифікаторів, яку не передбачає жоден блок чи мітка родоводу в наших даних. Значення видаються детерміновано функцією emit_phi_matrix.py (повторно використовуючи analysis_week1.py розд. W5); жодне не введено вручну.
Режим відмови IV: перевірка, що капітулює (дослідницька)
Коли верифікатор, що спочатку мав незгоду, побачив ту саму відповідь, що й пропозиція колеги, він капітулював у 38,5% випадків (168/436); коли він наосліп виробив правильну відповідь, він замінив її неправильною у 30,9% (46/149), з частотами відмови за провайдерами від 13,1% до 51,6% (капітуляція за провайдерами на всій підмножині з попередньою незгодою становить 20.4–58.1%).
Чи могли б ці переходи бути раціональним оновленням переконань, а не конформізмом? Контроль зі зворотною підказкою свідчить проти цього. На локальній панелі з шести моделей ми повторили парну процедуру з перевернутим напрямком впливу: верифікатору, що спочатку мав незгоду, для того ж набору запитань показували або впевнену неправильну відповідь (пряма гілка), або еталонну відповідь (зворотна гілка). Обидві гілки мали однакову підказку—один спільний шаблон («Запропонована відповідь: …»), показана відповідь відрізнялась лише змістом, без відображення значення впевненості чи атрибуції джерела—тому контраст ізолює істинність показаної відповіді. Якби верифікатори оновлювали переконання на основі доказів, ознайомлення з правильною відповіддю мало б на них більший вплив; натомість обидві гілки дали майже однакову частоту переходів—38,9% у бік неправильної відповіді, 34,7% у бік правильної—і внутрішньопарне порівняння суперечить оновленню: з 174 неузгоджених пар верифікатор залишив свою первісну позицію на користь неправильної відповіді у 104 випадках і на користь правильної у 70 (McNemar точна ). На рівні моделей обидві гілки були невиразні (схильність до переходу 89,9% проти 89,9% для найслухнянішого верифікатора, 1,5% проти 1,5% для найменш слухняного): те, що викликає згоду, — це наявність впевненої пропозиції, а не те, що вона істинна—панельна верифікація як прояв послужливості, навченої переважаннями (Sharma et al., 2024). Асиметрія також не залежить від найслухнянішого верифікатора: виключаючи його, залишаємо 835 парних пунктів з неузгоджених рахунків 94 проти 60 (точна ). Два подальші розкладання підтримують цю інтерпретацію (Додаток A): кожний записаний перехід в будь-якій гілці супроводжувався заявленою впевненістю після впливу (0 переходів нижче цього порога, ), і в прямій гілці верифікатори, що наосліп були правильні, залишили правильну відповідь у 40,8% випадків (20/49), повторюючи основне знаходження. Контроль працював на локальному рівні (Обмеження). Текстовий опис цього контролю також з'являється у супровідній статті (Chernets, 2026); розкладання за моделями, розділення за порогом впевненості та аналіз відмови від правильних відповідей наосліп повідомляються лише тут.
Це обмежує дизайнерське твердження: коли мета — виміряти незалежну незгоду, отримання відповідей має проходити спочатку наосліп—панель, яка обговорює позиції перед їх затвердженням, не вимірює свою розбіжність, вона її стирає.
Обговорення: економіка театру (припущення, а не докази)
Цей розділ є обговоренням, а не доказом: він не наводить нових вимірювань, і ніщо в ньому не слід розглядати як рівнозначне чотирьом виміряним режимам, наведеним вище. Враховуючи це, чотири режими можуть зберігатися, оскільки жодна зі сторін не отримує плату за їх помічання: споживачи не можуть оцінити якість верифікації, платформи отримують плату за впевненість, а не за сумніви, і найдешевша стратегія кожного верифікатора — погодитися. Додайте проблему вибору аудитора (незалежність є властивістю того, хто обирає перевіряючих) та прецедент link-farm (будь-який сигнал згоди, який має комерційну вагу, спонукає до фермування), і театр є рівновагою, а не випадком — припущення, яке вимірювання мотивують, але не перевіряють. Облік стимулів доповнює, а не виключає, інженерну інерцію та відсутність стандартів вимірювання; його виділяють, оскільки це фальсифікабельний компонент. Цей розділ робить фальсифікабельні ринкові прогнози, а не нормативні твердження — наприклад, неперевірені панелі повинні з часом наближатися до композицій із мінімальною різноманітністю, оскільки корельовані панелі дешевші й більше узгоджуються.
Від театру до вимірювання
Засобом є дисципліна, а не компонент: (1) опублікувати виміряну панеллю -матрицю для кожного класу завдань, а не її список брендів (однієї сліпої колекції для кожного класу завдань достатньо—16-модельна матриця цієї роботи отримана з одного проходу по 1500 елементам); (2) стратифікувати кожну претензію на сертифікацію за складністю та окремо звітувати про підйом у важкому режимі (складність визначається для кожного класу завдань на основі колекції калібрування, а не для кожного елемента на етапі висновку); (3) еліцитувати сліпо-спочатку, завжди—схема commit-reveal верифікації панелі, яка переупорядковує еліцитацію, а не додає обчислень, оскільки сліпі відповіді можна паралелізувати; (4) розглядати найскладніший режим як тригер ескалації—на питаннях, де виміряний панеллю підйом становить , узгодження повинне маршрутизуватися до людини або до утримання, ніколи до сертифікації. Кожне правило сформульовано так, щоб розгорнута система могла бути перевірена на його відповідність.
Як розроблений приклад застосуйте процедуру до власної передової панелі цієї роботи. Правило (1): її незалежність звітується як виміряна -матриця Розділу 6 (діапазон 0.123–0.395), а не як перелік постачальників—що приховала б факт, що найбільш корельована пара є внутрішньоблоковою (googlexai). Правило (2): її сертифікаційний підйом звітується стратифікований (Таблиця 1), з підйомом у важкому режимі ( на Q1, на Q2) сформульований окремо, а не включений в один об'єднаний заголовок. Правило (3): кожна відповідь тут була еліцитована сліпо до того, як будь-яка панель була зібрана, що саме робить гілку відповідності (Розділ 7) вимірюваною, а не змішаною. Правило (4): оскільки виміряний панеллю підйом становить на двох найскладніших квінтилях, перевірене розгортання цієї самої панелі маршрутизувало б ці питання на утримання або людський огляд, ніколи на консенсус-сертифікацію. Дисципліна тому не гіпотетична: це протокол, за яким були отримані результати роботи.
Обмеження
Одна сім'я еталонів на рівень (SimpleQA відкритої форми передовий; TruthfulQA MC локальне), тому межи режимів залежать від еталонів; кожен постачальник передових моделей представлений однією моделлю бюджетного/середнього рівня, тому не висуваються твердження про можливості постачальника. Розшарування складності є спостережувальним (post-hoc щодо попередньо зареєстрованої збірки) і призначення квінтилів ділиться даними з оцінених моделей. Напрямок конформності є дослідницьким і скромним за ; його контроль із зворотним запитом використовував локальні моделі, тому передача на панелі передових моделей здійснюється за аналогією, а не за вимірюванням. Приблизно дві третини оцінок відкритої форми надходять від оцінювача LLM (точкова перевірка людиною з 98% узгодженістю; повторна оцінка всіх 342 тиражованих вердиктів найскладнішого квінтиля узгодилися 342/342; аналіз чутливості з повторною вибіркою в додатку). Обидва еталони є громадськими, тому витік навчального набору не можна виключити; на SimpleQA його спрямованість сприяє запам'ятованим-правильним відповідям, що зменшує складний шар і робить результати режиму складності консервативними; на TruthfulQA громадський корпус містить самі помилкові уявлення, тому спрямованість там не є чітко визначеною — альтернативне прочитання вже обмежено застереженням щодо формату та змісту розділу 5. Не робляться причинні твердження про те, чому узгодженість не вдається на складних питаннях — можливі механізми (спільні приорітети, спільні сліпі плями, спільні навчальні дані) названі, але не розділені.
Висновок
Узгодженість є свідченням тільки після вимірювання незалежності та компетентності, і вимірювання дешеве—вся повторна аналізація тут виконується за секунди на стандартному обладнанні з публічних необроблених файлів. Поки панелі не поставляються з їхніми -матрицями та стратифікованими підніманнями, "верифіковано консенсусом" слід читати так, як інженери безпеки навчилися читати пошук у сумці.
References
B. Schneier. Beyond Fear: Thinking Sensibly About Security in an Uncertain World. Copernicus Books, 2003.
D. Shehata and M. Li. The inverse-wisdom law: Architectural tribalism and the consensus paradox in agentic swarms. arXiv:2604.27274, 2026.
I. D. Raji, P. Xu, C. Honigsberg, and D. Ho. Outsider oversight: Designing a third party audit ecosystem for AI governance. In AIES, pages 557–571, 2022.
Y. Du, S. Li, A. Torralba, J. B. Tenenbaum, and I. Mordatch. Improving factuality and reasoning in language models through multiagent debate. In ICML, 2024. arXiv:2305.14325.
S. Farquhar, J. Kossen, L. Kuhn, and Y. Gal. Detecting hallucinations in large language models using semantic entropy. Nature, 630(8017):625–630, 2024.
Kaihua Ding. When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv preprint arXiv:2607.08065, 2026.
E. Kim, A. Garg, K. Peng, and N. Garg. Correlated errors in large language models. In ICML, 2025. arXiv:2506.07962.
M. Sharma, M. Tong, T. Korbak, D. Duvenaud, et al. Towards understanding sycophancy in language models. In ICLR, 2024. arXiv:2310.13548.
A. Khan, J. Hughes, D. Valentine, L. Ruis, et al. Debating with more persuasive LLMs leads to more truthful answers. In ICML, 2024. arXiv:2402.06782.
J. Wei, K. Nguyen, H. W. Chung, Y. J. Jiao, S. Papay, A. Glaese, J. Schulman, and W. Fedus. Measuring short-form factuality in large language models. arXiv:2411.04368, 2024.
S. Lin, J. Hilton, and O. Evans. TruthfulQA: Measuring how models mimic human falsehoods. In ACL, 2022. arXiv:2109.07958.
S. Lifshitz, S. A. McIlraith, and Y. Du. Multi-agent verification: Scaling test-time compute with multiple verifiers. arXiv:2502.20379, 2025.
P. Verga, S. Hofstätter, S. Althammer, Y. Su, A. Piktus, A. Arkhangorodsky, M. Xu, N. White, and P. Lewis. Replacing judges with juries: Evaluating LLM generations with a panel of diverse models. arXiv:2404.18796, 2024.
H. Zhang, Z. Cui, J. Chen, et al. Stop overvaluing multi-agent debate—we must rethink evaluation and embrace model heterogeneity. arXiv:2502.08788, 2025.
Vadym Chernets. Architectural trust: Verifiable decision architecture for agentic commerce. SSRN working paper 7191261, 2026. https://doi.org/10.2139/ssrn.7191261 (cited for the trust construct and for its summary treatment of the shared blind collection; overlapping analyses are cross-flagged where they occur).
Додаток відтворюваності
Всі повторні аналізи детерміновані на основі вихідних оцінених файлів JSONL і двох скриптів із фіксованим насінням (базовий скрипт, який відтворює кожен заголовний результат, та додаток першого тижня, що виробляє таблиці бутстреп, чутливості та декомпозиції нижче); повний перерахунок займає менше 15 секунд на товарному обладнанні без GPU, мережі або викликів моделі. Заморожена реєстрація та пакет репліації (публічна реєстрація OSF): https://osf.io/4y9dv.
Довірчі інтервали бутстреп для драбини ліфту
Повторна вибірка на рівні запитань у межах квінтиля, 2000 вибірок із фіксованим насінням, об'єднані за трьома панелями кордону.
| Квінтиль | Wilson 95% | Boot 95% | Ліфт | Ліфт boot 95% | |
|---|---|---|---|---|---|
| Q1 (найважче) | 0/342 = 0.0% | [0.0, 1.1] | [0.0, 0.0] | 0.00 | [0.00, 0.00] |
| Q2 | 46/359 = 12.8% | [9.7, 16.7] | [8.2, 18.2] | 0.82 | [0.51, 1.21] |
| Q3 | 272/473 = 57.5% | [53.0, 61.9] | [50.7, 64.6] | 2.68 | [2.32, 3.09] |
| Q4 | 732/904 = 81.0% | [78.3, 83.4] | [76.6, 85.1] | 3.09 | [2.84, 3.35] |
| Q5 (найлегше) | 1700/1788 = 95.1% | [94.0, 96.0] | [93.4, 96.6] | 4.56 | [4.16, 5.03] |
Ліфт сертифікації за квінтилем складності з інтервалами Wilson та бутстреп 95% (відсотки для , коефіцієнти для ліфту). Під складністю виключення панелі (ранжовано за 13 непанельними моделями) об'єднана клітинка Q1 становить 78/354 (22,0%, ліфт 2,36), нуль зберігається для перехресної панелі блоків (0/116); Розділ 4. Базові ставки за квінтилем: 3,9 / 15,6 / 21,5 / 26,2 / 20,8% ( = 2286 / 2308 / 2209 / 1778 / 912).
Чутливість до помилок оцінювача
Інвертування 10% з 8948 вердиктів на кордоні, оцінених моделями (200 повторних вибірок із фіксованим насінням; кодування узгодженості та присвоєння квінтиля заморожені на вихідному детерміністичному кодуванні протоколу, тому рухаються лише мітки коректності): клітинка найважчого квінтиля «сертифіковано коректно» зростає з 0/342 до медіани 33/342 (9,6%; діапазон 95% 23–46), тому сертифікована частка помилок узгодженості Q1 залишається на рівні або вище 86,5% у кожній повторній вибірці; ліфт Q1 залишається нижче 1 у 92% повторних вибірок (медіана 0,82, діапазон 95% 0,56–1,08), тоді як ліфти Q3–Q5 ніколи не падають нижче 2 (медіани 2,17 / 2,51 / 3,42). З 342 реплікованих відповідей Q1 332 (97,1%) оцінені моделями і тому можуть інвертуватися в цій вправі. Крім синтетичних інверцій, міжсімейний аудит переоцінив усі 342 реплікованих вердикти Q1 незалежним другим оцінювачем (родина постачальника поза межами кожної панелі та поза межами родини оригінального оцінювача; temperature 0; запит, заморожений і ідентичний по байтах): узгодженість 342/342 (інверцій до коректного 0/342, верхня межа Wilson 1,1%), однакова для оцінених моделями (332) та кодованих рядком/відмовою (10) клітинок. Оскільки 342 клітинки охоплюють 106 унікальних запитань, консервативне трактування на рівні кластера розглядає запитання як одиницю: 0/106 дає верхню межу Wilson 3,4%; нуль перестановки на рівні запитання з Розділу 4 вже працює на рівні кластера.
Контроль зворотного запиту: декомпозиція за моделями
Шість локальних моделей, 2,399 валідних парних спостережень; зміна = верифікатор відмовляється від своєї сліпої відповіді на користь показаної.
| Верифікатор | Пряме (до неправильної) | Зворотне (до правильної) | Різниця |
|---|---|---|---|
| qwen3:8b | 204/227 = 89.9% | 196/218 = 89.9% | pp |
| mistral | 132/213 = 62.0% | 113/203 = 55.7% | pp |
| glm4:9b | 66/213 = 31.0% | 39/200 = 19.5% | pp |
| llama3.2:3b | 40/234 = 17.1% | 38/227 = 16.7% | pp |
| gemma4:e4b | 33/202 = 16.3% | 19/195 = 9.7% | pp |
| phi4-mini | 2/137 = 1.5% | 2/130 = 1.5% | pp |
| Об'єднано | 477/1226 = 38.9% | 407/1173 = 34.7% | pp |
Показники змін за верифікатором та варіантом. Жодна модель не змінюється до правильної відповіді частіше, ніж до впевненої неправильної. Повторний облік: 1,028 елементів присутні в обох варіантах (296 змінилися в обох, 558 не змінилися); дискордантні пари 104 (тільки неправильні) проти 70 (тільки правильні), точний біноміальний McNemar (асимптотичний ). Усі 884 записаних змін мають вказану впевненість після експозиції ; показник зміни нижче цього порогу становить 0/547.
MC помилка сертифікованого консенсусу за категоріями TruthfulQA
Об'єднано за чотирма попередньо визначеними локальними панелями (подій на елемент-панель; категорії щонайменше з 20 елементів): Економіка 8.6%, Художна література 6.2%, Паранормальне 6.0%, Право 5.9%, Забобони 5.7%, Стереотипи 5.4%, Соціологія 4.9%, Здоров'я 4.9%, Помилкові уявлення 2.6%, Змови 1.0%. Показники за панелями з усіма трьома членами при впевненості : 4.0% (CN-local), 5.2% (cross-bloc), 6.0% (pilot), 7.2% (US-local).
Верхня межа 4.6% опирається на одну локальну панель, яка має лише 87 спільних елементів з 98 оцінюваними відповідями моделі міркування; виключаючи цю панель, строгий локальний діапазон відкритої форми становить 1.5–1.8%.↩︎
Як цитувати
Chernets, V. (2026). Verification Theater: Measured Failure Modes of AI Verifier Panels [Презентація доповіді]. NeurIPS 2026 Workshop: Who Verifies the Agents?. Zenodo. https://doi.org/10.5281/zenodo.23197641
@misc{chernets2026verificationtheater,
  author       = {Chernets, Vadym},
  title        = {{Verification Theater: Measured Failure Modes of AI Verifier Panels}},
  year         = {2026},
  howpublished = {Zenodo; NeurIPS 2026 Workshop: Who Verifies the Agents?},
  doi          = {10.5281/zenodo.23197641},
  url          = {https://doi.org/10.5281/zenodo.23197641}
}