Teatro de Verificação: Modos de Falha Medidos de Painéis Verificadores de IA
Esta é uma tradução. A versão de referência é o original em inglês; cite essa.
Vadym Chernets, Pesquisador Independente · ORCID 0009-0007-4845-3163
DOI Zenodo 10.5281/zenodo.23197641 · GitHub
Aceito como pôster no workshop NeurIPS 2026 "Who Verifies the Agents? Toward Reliable Agent Development" (não arquivado). Cópia arquivada: 10.5281/zenodo.23197641. PDF: verification-theater.pdf. As figuras e tabelas abaixo são convertidas da fonte LaTeX; o PDF é a versão definitiva.
Resumo
A verificação multi-agente está se tornando um mecanismo de confiança padrão: uma resposta é confiável porque modelos independentes concordaram com ela. Usando uma coleta pré-registrada, cega, com temperatura zero, em que dezesseis modelos (nove fornecedores de fronteira, sete modelos de código aberto local) responderam às mesmas 1.500 questões factuais (além de um braço de escolha múltipla de 750 questões e um braço de diálogo exploratório), medimos quando a verificação em painel deixa de funcionar enquanto continua parecendo funcionar—uma condição que chamamos de teatro de verificação. Relatamos quatro regimes de falha. Primeiro, uma inversão de dificuldade: o ganho de certificação do acordo independente—2,7–4,6 nos três quintis mais fáceis de questões—cai para 0,82 no segundo quintil mais difícil e para zero no mais difícil, onde respostas replicadas estavam corretas em 0 de 342 casos (13 esperado sob independência). Uma re-estratificação deixando o painel de fora (dificuldade classificada pelos 13 modelos não-painel) remove a inversão agrupada (78/354 corretas, ganho 2,36) enquanto o zero persiste para o painel entre-blocos (0/116); relatamos ambas as codificações juntas ao longo: nas questões que a população implantada acha mais difíceis, o acordo funciona como certificação de erro. Segundo, espaços de resposta restritos: em escolha múltipla (nível local), painéis unanimemente certificaram uma resposta errada em 4,0–7,9% das questões, versus 1,5–4,6% nas respostas de forma aberta do mesmo nível e 0,3–4,9% forma aberta de fronteira. Terceiro, os rótulos usados como proxies para independência falham empiricamente: o bloco geopolítico não prevê correlação de erro (média intra-bloco 0,285 vs. entre-blocos 0,274, diferença ), e um modelo de raciocínio destilado da mesma base que seu colega de painel estava entre os pares menos correlacionados medidos (; 14º de 15 pares locais de bloco US/CN, 20º de todos os 21 pares locais). Quarto, conformidade: um verificador que havia discordado de uma resposta cegamente endossou a mesma resposta em 38,5% dos casos quando lhe foi mostrada como de um colega; um controle de prompt reverso mostra que essas inversões rastreiam a presença de uma proposta confiante, não sua veracidade (38,9% para errado vs. 34,7% para correto; McNemar exato ). Argumentamos que esses regimes compartilham uma raiz econômica e derivamos uma disciplina de medição que separa a verificação de seu teatro.
Introdução: o problema do teatro
Painéis de modelos de IA verificando uns aos outros estão sendo implementados como infraestrutura de confiança, e o acordo entre eles é cada vez mais precificado como evidência. A pesquisa de segurança há muito tempo tem um nome para mecanismos que produzem a estética da proteção sem sua substância (Schneier, 2003); perguntamos, com medições em vez de metáfora, quando a verificação em painel merece esse nome. A descoberta central é uma inversão: o valor de certificação do acordo está concentrado em questões fáceis e desaparece—ou se inverte—exatamente onde a verificação mais importa. Tratamos isso não como uma anomalia única, mas como um de quatro regimes distintos em que um painel verificador mantém a aparência de verificação enquanto perde sua substância, e vinculamos os quatro a uma causa econômica comum e a um remédio comum.
Concretamente, este artigo contribui: (C1) uma medição estratificada por dificuldade do ganho de certificação mostrando que o valor de certificação do acordo independente se concentra em questões fáceis e, sob a medida de dificuldade populacional, se inverte no quintil mais difícil (0 de 342 respostas replicadas corretas; sob dificuldade independente de painel, a inversão agrupada desaparece e o zero persiste para o painel entre blocos, 0/116)—as duas codificações são relatadas juntas em todo o texto; (C2) evidência de que espaços de resposta restritos (múltipla escolha) levam o erro certificado unânime a 4.0–7.9%, bem acima do intervalo de forma aberta de 0.3–4.9%; (C3) dois resultados nulos pré-registrados mostrando que os rótulos rotineiramente usados como proxies de independência—bloco geopolítico e linhagem de modelo—não predizem correlação de erro, então a independência deve ser medida por pares como uma -matriz em vez de assumida a partir de marca ou árvore genealógica; e (C4) uma medição de conformidade com um controle de prompt reverso demonstrando que verificadores em modo de diálogo rastreiam a presença de uma proposta confiante em vez de sua veracidade. O protocolo de coleta cega e a construção de confiança são declarados na íntegra no artigo complementar e são resumidos aqui apenas na medida em que as medições exigem; tudo reportado como resultado neste artigo (C1–C4) é medido aqui e não é reafirmado a partir dele. A partir disso derivamos (C5) uma disciplina de medição—publicada por classe de tarefa -matrizes, alegações de certificação estratificadas por dificuldade, elicitação cega inicial, e escalação em regime duro—que operacionalmente separa verificação de seu teatro.
Estado da arte e enquadramento
O consenso tolerante a falhas (BFT) assume falhas independentes—a suposição que testamos e consideramos não fundamentada. A literatura de paradoxo do consenso já nomeia erro estabilizado por acordo em enxames homogêneos (Shehata and Li, 2026). zkML verifica que um cálculo foi executado, não que sua resposta é verdadeira—complementar, não concorrente. O Dilema do Verificador fornece a análise de incentivos; (Raji et al., 2022) fornecem o problema de seleção de auditores; (Du et al., 2024), (Farquhar et al., 2024) e (Ding, 2026) fornecem a literatura de sinal de acordo que este artigo testa sob estresse. O constructo de confiança em si foi introduzido em um artigo complementar (Chernets, 2026); este artigo mapeia onde o mecanismo de verificação do constructo falha enquanto parece estar funcionando. O trabalho de computação em tempo de teste chega à conclusão complementar do lado construtivo: conjuntos de verificadores de aspectos diversos superam qualquer verificador único (Lifshitz et al., 2025), um painel de juízes pequenos extraídos de famílias disjuntas supera um único juiz grande a uma fração do custo (Verga et al., 2024), e uma reavaliação sistemática de debate multi-agente identifica heterogeneidade de modelo como o único melhorador confiável (Zhang et al., 2025); a linha de debate mostra argumentação adversarial estruturada ajudando juízes mais fracos a alcançar respostas mais verdadeiras (Khan et al., 2024). Evidências revisadas por pares já documentam correlação de erros substancial entre provedores—maior precisamente entre os modelos mais precisos, até mesmo entre arquiteturas e provedores distintos (Kim et al., 2025)—que motiva independentemente medir dependência em vez de inferir a partir de rótulos. Essa literatura seleciona painéis pela diversidade; este artigo mede o que a propriedade selecionada vale—e o que sua ausência custa silenciosamente—na verificação.
Dados e medição
Uma coleta pré-registrada, cega (protocolo congelado publicamente antes da coleta de dados confirmatória; registro público em https://osf.io/4y9dv): dezesseis modelos uma subamostra aleatória pré-registrada de 1.500 dos 4.326 itens do SimpleQA (semente fixa, extraída antes de qualquer coleta; CSV de subamostra com seu SHA-256 anexado ao registro congelado) em temperatura zero com confiança declarada de 0–100 (13.446 respostas de fronteira limpas; 8.802 respostas de nível local); um braço MC1 TruthfulQA de 750 itens no nível local, derivado de uma cópia congelada do arquivo do repositório oficial (790 itens, byte-idêntico ao CSV canônico) por um construtor pré-registrado exigindo pelo menos duas opções incorretas distintas por item (semente de embaralhamento fixa; 695 itens totalmente respondidos por todos os sete modelos); um braço de diálogo ativo-versus-cego exploratório. SimpleQA é coletado adversarialmente contra um modelo de fronteira, com uma única resposta indiscutível por pergunta (Wei et al., 2024): o estrato difícil, portanto, sonda os limites genuínos do conhecimento paramétrico, e a classificação se reduz à equivalência-com-ouro. TruthfulQA fornece o braço de espaço de resposta restrito (Lin et al., 2022). Os painéis são combinações analíticas da coleta cega única; toda reanálise é determinística (codificação de equivalência de string com recusas e sobreposição zero contadas como não concordância; pares indeterminados relatados entre colchetes). A dificuldade é operacionalizada observacionalmente como a precisão média dos 16 modelos por pergunta, dividida em quintis de classificação de 300 perguntas. A mesma coleta bruta fundamenta o artigo complementar (Chernets, 2026), que relata as razões de certificação agrupadas e resumos breves das análises detalhadas aqui; a escada de elevação estratificada por dificuldade, a suite de robustez, a matriz e as decomposições de conformidade aparecem apenas neste artigo, e toda sobreposição restante é marcada com cruzamento no texto.
A classificação de forma aberta é de dois estágios: uma passagem de equivalência de string determinística (26,8% das classificações de fronteira) mais detecção de recusa (6,6%), com os 66,5% restantes classificados por um classificador LLM; uma verificação manual aleatória concordou com o classificador em 98% de uma amostra aleatória (). Como dois terços das classificações são produzidas por modelo, todos os resultados principais são acompanhados por uma reamostragem de sensibilidade de erro de classificador (10% dos veredictos classificados por modelo invertidos, 200 reamostragens com semente; Seção 4 e Apêndice A).
Regime de falha I: a inversão de dificuldade
Os três painéis de fronteira pré-especificados são combinações analíticas de 3 modelos da coleta única cega: bloco EUA (Anthropic, OpenAI, Google), bloco CN (DeepSeek, Alibaba, Moonshot) e bloco cruzado (Anthropic, DeepSeek, Mistral); uma resposta conta como replicada quando pelo menos um dos dois parceiros de painel do primário produziu independentemente uma resposta equivalente sob a codificação determinística congelada da Seção 3, e o levantamento é . Em conjunto entre os três painéis, a probabilidade de que uma resposta replicada esteja correta sobe de 0,0% (0/342, IC 0,0–1,1) no quintil mais difícil até 12,8%, 57,5% e 81,0% para 95,1% no mais fácil; o levantamento correspondente sobre respostas não replicadas vai de 0,00 / 0,82 / 2,68 / 3,09 / 4,56. No 20% mais difícil de questões, cada acordo observado certificou uma resposta errada, e no próximo quintil a estimativa pontual coloca o acordo abaixo da paridade com discordância (0,82, IC [0,51, 1,21]); o zero do quintil mais difícil se replica em cada painel separadamente (EUA 0,00–4,25, CN 0,00–9,76, bloco cruzado 0,00–4,04); a sub-paridade Q2 se mantém nos painéis CN e bloco cruzado, enquanto o levantamento Q2 do painel EUA é 1,20. Muito do levantamento de certificação em conjunto é carregado por questões fáceis, então uma reivindicação de levantamento não estratificada superestima o que a verificação entrega onde é necessário. O zero Q1 é medido contra uma taxa de base viva, não um piso: respostas Q1 não replicadas estão corretas 3,9% do tempo (89/2286), então a independência prediz respostas replicadas corretas—o observado 0 (limite superior 1,1%) fica significativamente abaixo da taxa de base do estrato. O teste de independência é conservador aqui, não liberal: um nulo preservando a estrutura completa de correlação entre modelos medida—uma permutação comum de rótulos de acurácia entre as questões do estrato, estrutura de replicação congelada (2.000 permutações)—espera 11,7–12,4 respostas replicadas corretas e nunca produziu o observado 0 (; mínimo 3); dobrando o emparelhado medido em um nulo bivariado analítico levanta a expectativa ainda mais, porque erros correlacionados positivamente implicam respostas corretas correlacionadas positivamente. O que povoa o estrato é em si informativo: as 342 células abrangem 106 questões—fatos ordinários simples (mediana 17 palavras), não fraseado ambíguo, e os modelos raramente se abstêm delas (0,5 de 9 respostas por questão). Suas respostas erradas se agrupam: em 70,8% dessas questões pelo menos três dos nove modelos de fronteira produziram a mesma resposta errada, e em 67,4% das questões replicadas por mais de um painel, os painéis compostos independentemente certificaram o idêntico consenso errado—tipicamente uma resposta de vizinho famoso deslocando a entidade correta mas menos proeminente. Uma adjudicação de matéria-sujeito manual de todos os 106 rótulos ouro encontrou 2 discutíveis e 0 completamente errado; creditando a resposta de painel claramente defensável e duas parcialmente defensáveis move a contagem do quintil mais difícil de 0/342 para no máximo 13/342 (3,8%), então a conclusão próxima-a-zero se mantém enquanto se suaviza de um zero literal (um rótulo sinalizado: uma eleição da Royal Academy de 2010 pontuada contra um título de honra que a academia não confere). A reivindicação é diretamente testável: ela prediz levantamento Q1 em qualquer replicação estratificada pela acurácia da população implantada (sob estratificação independente de painel a previsão é o zero bloco cruzado, não o levantamento em conjunto). Nem o zero é um artefato de classificador: um segundo classificador independente de uma família de fornecedor fora de cada painel e do classificador original (temperatura zero, o prompt idêntico congelado de equivalência ao ouro) reclassificou todos os 342 vereditos replicados Q1 e concordou em 342/342 (vira para correto 0/342, limite superior 1,1%); transpor sinteticamente 10% de rótulos classificados por modelo deixa a proporção de erro certificado em ou acima de 86,5% em cada reamostragem (apêndice).
Reestratificação com exclusão do painel.
Como os membros do painel contribuem para o índice de dificuldade da população, o quintil mais difícil é parcialmente condicionado ao fracasso do próprio painel. Ao reestratificar apenas pelos 13 modelos não-painel, as respostas replicadas no quintil mais difícil estão corretas em 78/354 casos (22,0%, ganho agrupado 2,36, acima das 33/354 esperadas sob independência), e o zero persiste apenas para o painel entre blocos (0/116; 0/88 no estrato onde todos os 13 modelos não-painel falham). O zero que sobrevive é caracterizado por: a taxa base do estrato é 31/778 = 3,98% (Wilson 2,8–5,6%), resultando em uma expectativa de independência de 4,6 corretas entre as 116; um nulo de permutação preservador de correlação (2.000 permutações) fornece , intervalo de 95% , e — significativamente abaixo do nulo, embora não inatingível sob ele. A inversão acima é, portanto, uma afirmação sobre onde a verificação falha em relação ao que a população implantada acha difícil, não em relação à dificuldade independente do painel. Como uma segunda verificação de sensibilidade, derivamos novamente a escala sob uma codificação de replicação completamente sem rótulos (comparação de strings determinística de respostas cegas apenas, nunca consultando o rótulo de correção): o resultado Q1 é essencialmente inalterado (2/344 respostas replicadas corretas, 0,6% [0,2–2,1]; ganho 0,15) e os ganhos abaixo-1 nos dois quintis mais difíceis persistem, enquanto o ganho do quintil superior se atenua (4,56 para 2,33) porque a correspondência pura de strings perde variantes de superfície da mesma resposta correta; os resultados de múltipla escolha não são afetados, pois o acordo lá é codificado pela letra da resposta e é sem rótulos por construção.
Três verificações de robustez apoiam a inversão. (i) Bootstrap em nível de questão (2.000 reamostras com sementes dentro do quintil) fornece ICs de 95% para os cinco ganhos de [0,00, 0,00], [0,51, 1,21], [2,32, 3,09], [2,84, 3,35] e [4,16, 5,03]: os intervalos de regime difícil excluem completamente os intervalos de regime fácil. (ii) Sensibilidade do erro do avaliador: invertendo 10% dos vereditos avaliados pelo modelo (200 reamostras com sementes; 97,1% das 342 respostas replicadas do quintil mais difícil são avaliadas pelo modelo e, portanto, invertíveis) deixa a proporção de erro certificado do quintil mais difícil em ou acima de 86,5% em cada reamostra, mantém o ganho Q1 abaixo de 1 em 92% das reamostras (mediana 0,82), e nunca traz os ganhos Q1–Q2 perto dos ganhos Q3–Q5, que permanecem acima de 2 em todas as 200 reamostras. (iii) O nível local de sete modelos replica o contraste difícil–fácil com modelos e painéis independentes, de forma não-monótona (Q3 ): ganhos 0,00 / 0,94 / 0,00 / 1,89 / 4,37 nos mesmos quintis, com 0 de 166 respostas replicadas corretas no quintil mais difícil; este nível é 94,8% avaliado por LLM e é coberto pela mesma reamostragem de sensibilidade do avaliador como em (ii).
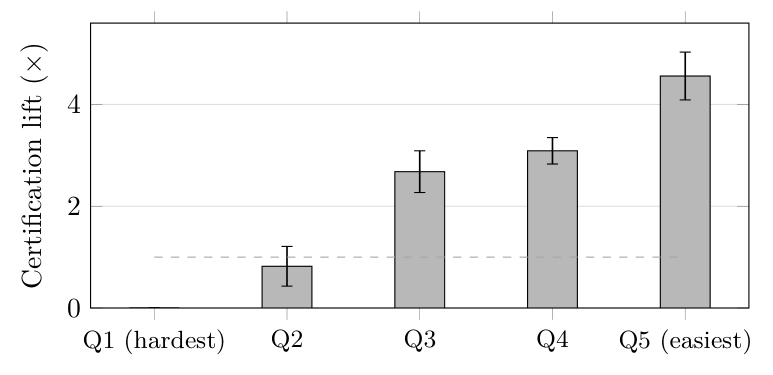 Ganho de certificação por quintil de dificuldade, agrupado em três painéis de fronteira, com intervalos de 95% de bootstrap em nível de questão (2.000 reamostras com sementes; Apêndice A.1). A linha tracejada marca ganho = 1, paridade com respostas não replicadas: os dois quintis mais difíceis ficam em ou abaixo dela por estimativa pontual (Q1 0,00× — um zero medido, não dados faltantes; Q2 0,82×, seu IC cruzando paridade), os três mais fáceis bem acima dela.
Regime de falha II: espaços de resposta restritos
Em questões de múltipla escolha, quatro painéis de nível local pré-especificados convergiram unanimemente para uma opção incorreta em 4.0–7.9% das 695 questões totalmente respondidas (por painel: 4.0, 5.9, 6.6, 7.9), versus um intervalo determinístico de 0.3–4.9% para respostas abertas unânimes confidentes erradas no nível de fronteira. Recomputando a mesma métrica de certificação no nível de respostas abertas do próprio nível local (8.802 respostas SimpleQA classificadas) remove o fator de confusão nível-formato: os mesmos painéis locais certificam erros unânimes confidentes em apenas 1.5–4.6% dos itens de resposta aberta sob codificação determinística rigorosa (até 9.8% incluindo o intervalo indeterminado), consistente com o intervalo de resposta aberta de fronteira—um padrão consistente com o espaço de resposta restrito, em vez do nível do modelo, impulsionando a certificação de erro; um fator de confusão permanece, porém: o braço de múltipla escolha e os braços de resposta aberta são conjuntos de questões diferentes (TruthfulQA MC1 versus SimpleQA), portanto formato e conjunto de questões não são separados aqui, e a forma causal da afirmação é resolvida apenas por uma troca de formato para a mesma questão, que não executamos.1 O bootstrap por painel fornece intervalos para a diferença onde há potência: MC menos erro de consenso certificado de resposta aberta é pp [2.9, 6.8] (piloto), pp [3.9, 8.1] (local-EUA), e pp [2.6, 6.3] (entre-blocos), cada um excluindo zero; o painel local-CN, cuja célula de resposta aberta se baseia no conjunto de 87 itens da nota de rodapé, não o resolve. Um conjunto de opções converte erros dispersos em erros compartilhados: quando o espaço de resposta é pequeno, modelos semelhantes caem no mesmo distrator e a unanimidade do painel se torna um amplificador de erro. As taxas não são explicáveis por erros independentes: com cada membro independentemente errado em sua taxa marginal e erros dispersos sobre as opções incorretas (), a taxa esperada de consenso unânime na mesma opção incorreta é de 0.49–0.92% em todos os quatro painéis—o observado 4.0–7.9% é um excesso de 4.9–13.5 sobre a linha de base de independência. Consequência do design, enunciada como uma regra testável: qualquer interface que oferece aos agentes um conjunto fixo de opções deve esperar por erros de consenso certificados materialmente maiores do que a elicitação de resposta aberta no mesmo conteúdo.
Exigir confiança declarada de todos os três painelistas quase não reduz o efeito: o intervalo de erro de consenso certificado passa de 4.0–7.9% para 4.0–7.2% (por painel 4.0, 5.2, 6.0, 7.2), ou seja, quase todos os erros unânimes errados também são confidentes. A falha também não se limita a um nicho temático: nas dez categorias TruthfulQA com pelo menos 20 itens, o erro de consenso certificado agrupado varia de 1.0% (Conspiracies) a 8.6% (Economics), com Law, Health, e Sociology entre elas (Apêndice A).
Regime de falha III: rótulos de independência não preveem independência
Entre 36 pares de fornecedores de fronteira (1.448 perguntas compartilhadas), a correlação de erro pareada varia de 0,123–0,395, e essa variação não é organizada pelos rótulos que as pessoas usam: os pares mais e menos correlacionados são ambos intra-bloco (googlexai 0,395 vs. googleopenai 0,123), as médias de intra- versus entre-bloco diferem por , e o par de linhagem de mesma base ocupa o 14º lugar entre os 15 pares formados pelos seis modelos locais do bloco US/CN nos 695 itens de múltipla escolha completamente respondidos (; o sétimo modelo local é do bloco EU e está fora do design pré-registrado bloco/linhagem—incluindo-o gera 21 pares, dos quais o par de linhagem ocupa o 20º lugar). Ambas as hipóteses nulas pré-registradas (bloco, linhagem) sobrevivem à re-análise; o que permanece preditivo é a correlação medida em si. A regra prática: independência é uma quantidade por-par, por-classe-de-tarefa a ser medida (uma matriz ), não inferida de marca, bandeira ou árvore genealógica—montar um painel por rótulos é conjectura, não verificação. Pareada mede dependência de erro empírica, não independência estatística completa: baixo não exclui dependência de ordem superior em painéis de três ou mais, um motivo adicional para tratar independência como uma quantidade medida, condicionada à tarefa, em vez de uma propriedade assumida.
Um teste exato de permutação sobre todas as 630 atribuições dos rótulos de bloco aos nove fornecedores não encontra evidência de um efeito de bloco: a diferença intra-menos-entre observada de é excedida ou igualada por 132 de 630 re-rotulações (unilateral ; intervalo de confiança de 95% com bootstrap agrupado para a diferença ). O teste delimita a afirmação—pequenos efeitos de bloco não são excluídos—e a conclusão operacional persiste: o rótulo não carrega sinal utilizável no lugar da medição por-par. Porque é limitado acima quando as taxas de erro base do par diferem, re-executamos a análise na razão normalizada pela margem : ambas as hipóteses nulas pré-registradas sobrevivem (diferença de bloco , permutação ; o par de linhagem permanece 14º de 15), a dispersão persiste (0,278–0,821 através de pares de fronteira), e os extremos se realocam para dois pares entre-bloco (anthropicmoonshot 0,821, mistralopenai 0,278)—sob qualquer métrica, nenhum rótulo organiza a dispersão. Estendendo a matriz para todos os dezesseis modelos: nas 81 perguntas respondidas por todos os modelos, pareada varia de a (120 pares; médias de bloco: fronteira–fronteira 0,320, local–local 0,350, fronteira–local 0,210)—uma dispersão de ordem de grandeza que nenhuma taxonomia de rótulo em nossos dados prediz (Figura 2). Com 81 itens comuns, estimativas de células individuais têm intervalos amplos; o resultado é a dispersão em si, não qualquer célula individual.
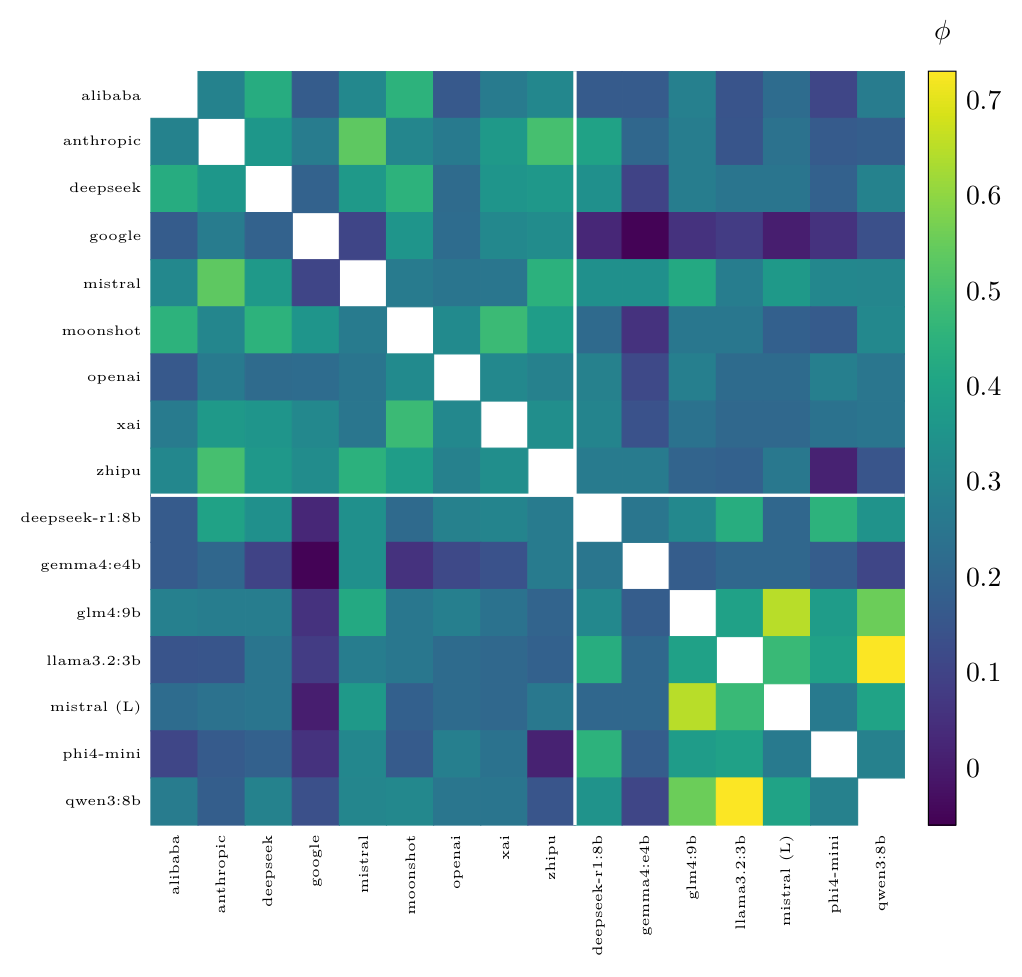 Correlação de erro por pares (ϕ) entre todos os dezesseis modelos nas 81 questões respondidas por cada modelo (nove fornecedores de fronteira, depois sete pesos abertos locais; a partição fronteira/local é marcada pelas linhas brancas). Cada célula fora-diagonal é um dos 120 pares únicos; a diagonal (autocorrelação = 1,0) é deixada em branco por design para que não comprima a escala de cores. ϕ varia de −0,05 a 0,73 (média 0,27): uma dispersão de ordem de magnitude em quão correlacionados são os erros de quaisquer dois verificadores, que nenhum rótulo de bloco ou linhagem em nossos dados prediz. Os valores são emitidos deterministicamente por emit_phi_matrix.py (reutilizando analysis_week1.py sec. W5); nenhum é inserido manualmente.
Regime de falha IV: verificação que se rende (exploratório)
Quando um verificador que havia discordado às cegas foi mostrado a mesma resposta que uma proposta de um colega, ele capitulou em 38.5% dos casos (168/436); quando havia produzido a resposta correta às cegas, ele a abandonou pela resposta incorreta em 30.9% (46/149), com taxas de abandono por fornecedor de 13.1% a 51.6% (a capitulação por fornecedor no subconjunto completo discordante-às-cegas varia de 20.4–58.1%).
Essas mudanças poderiam ser uma atualização racional de crença em vez de conformismo? Um controle de prompt reverso argumenta contra isso. Em um painel local de seis modelos, re-executamos o procedimento emparelhado com a direção de exposição invertida: um verificador que havia discordado às cegas foi mostrado, para o mesmo conjunto de perguntas, ou a resposta confiante incorreta (braço direto) ou a resposta de ouro (braço reverso). Os dois braços são idênticos em relação ao prompt—um modelo compartilhado ("Resposta proposta: …"), a resposta mostrada diferindo apenas no conteúdo, sem valor de confiança ou atribuição de fonte exibida—portanto, o contraste isola o valor de verdade da resposta mostrada. Se os verificadores estivessem atualizando a partir da evidência, a exposição à resposta correta deveria movê-los mais; em vez disso, os dois braços produziram uma taxa de mudança quase igual—38.9% em direção à resposta incorreta, 34.7% em direção à correta—e a comparação dentro do par executa o caminho errado para a história da atualização: de 174 pares discordantes, o verificador abandonou sua posição cega pela resposta incorreta em 104 e pela correta em 70 (McNemar exact ). No nível do modelo, os dois braços eram indistinguíveis (propensão de mudança 89.9% vs. 89.9% para o verificador mais complacente, 1.5% vs. 1.5% para o menos): o que desencadeia o acordo é que uma proposta confiante está presente, não que seja verdadeira—a face de verificação em painel da bajulação treinada por preferência (Sharma et al., 2024). Nem a assimetria depende do verificador mais complacente: excluindo-o deixa 835 itens emparelhados com contagens discordantes 94 vs. 60 (exact ). Duas decomposições adicionais reforçam esta leitura (Apêndice A): cada mudança registrada em qualquer braço veio com confiança pós-exposição declarada (0 mudanças abaixo desse limite, ), e no braço direto os verificadores que haviam estado corretos cegos abandonaram a resposta correta em 40.8% dos casos (20/49), espelhando o achado da fronteira. O controle foi executado no nível local (Limitações). Um resumo em prosa deste controle também aparece no artigo complementar (Chernets, 2026); a decomposição por modelo, divisão de comporta de confiança e análise de abandono correto-cego são relatadas apenas aqui.
Isso limita uma alegação de design: quando o objetivo é medir discordância independente, a elicitação deve ser cega-primeiro—um painel que delibera antes de assumir posições não mede sua discordância, ela a apaga.
Discussão: a economia do teatro (conjectura, não evidência)
Esta seção é discussão e não evidência: não relata nenhuma nova medição, e nada nela deve ser lido como equiparável aos quatro regimes medidos acima. Dito isso, os quatro regimes podem persistir porque nenhuma parte é paga para notá-los: consumidores não conseguem precificar a qualidade da verificação, plataformas são pagas por confiança, não por dúvida, e a estratégia mais barata de cada verificador é concordar. Adicione o problema da seleção de auditores (independência é uma propriedade de quem escolhe os verificadores) e o precedente de farm de links (qualquer sinal de concordância que carregue peso comercial incentiva a manipulação), e o teatro é um equilíbrio, não um acidente—uma conjectura que as medições motivam mas não testam. A conta de incentivos complementa, e não exclui, a inércia de engenharia e a ausência de padrões de medição; é destacada porque é o componente falsável. Esta seção faz previsões de mercado falsáveis em vez de afirmações normativas—por exemplo, painéis não auditados devem convergir para composições de diversidade mínima ao longo do tempo porque painéis correlacionados são mais baratos e concordam mais.
Do teatro à medição
O remédio é uma disciplina, não um componente: (1) publicar a matriz -medida do painel por classe de tarefa, não sua lista de marcas (uma coleta cega por classe de tarefa é suficiente—a matriz de 16 modelos deste artigo veio de uma única passagem de 1.500 itens); (2) estratificar toda reivindicação de certificação por dificuldade e relatar a melhoria de regime difícil separadamente (a dificuldade é operacionalizada por classe de tarefa a partir de uma coleta de calibração, não por item na inferência); (3) elicitar cego-primeiro, sempre—o esquema de commit-reveal da verificação do painel, que reordena a elicitação em vez de adicionar computação, já que as respostas cegas são paralavelizáveis; (4) tratar o regime mais difícil como um gatilho de escalação—em questões onde a melhoria medida do painel é , o acordo deve ser roteado para um humano ou para abstenção, nunca para certificação. Cada regra é declarada para que um sistema implantado possa ser auditado contra ela.
Como exemplo prático, aplique a receita ao painel de fronteira do próprio artigo. Regra (1): sua independência é relatada como a matriz -medida da Seção 6 (intervalo 0,123–0,395), não como uma lista de fornecedores—o que teria ocultado que o par mais correlacionado é intra-bloco (googlexai). Regra (2): sua melhoria de certificação é relatada estratificada (Tabela 1), com a melhoria de regime difícil ( em Q1, em Q2) declarada separadamente em vez de incorporada em um único título agrupado. Regra (3): cada resposta aqui foi elicitada cega antes de qualquer painel ser montado, o que é precisamente o que torna o braço de conformidade (Seção 7) mensurável em vez de confundido. Regra (4): porque a melhoria medida do painel é nos dois quintis mais difíceis, uma implantação auditada deste mesmo painel rotearia essas questões para abstenção ou revisão humana, nunca para certificação por consenso. A disciplina é, portanto, não hipotética: é o protocolo sob o qual os próprios números do artigo foram produzidos.
Limitações
Uma única família de benchmark por camada (SimpleQA frontier de forma aberta; TruthfulQA MC local), portanto os limites de regime são relativos ao benchmark; cada fornecedor frontier é representado por um modelo de orçamento/intermediário, portanto não são feitas reivindicações de capacidades do fornecedor. A estratificação de dificuldade é observacional (post-hoc sobre uma coleção pré-registrada) e a atribuição de quintil compartilha dados com os modelos avaliados. O braço de conformidade é exploratório e modesto em ; seu controle de prompt inverso usou modelos locais, portanto a transferência para painéis frontier é por analogia, não por medição. Aproximadamente dois terços das notas de forma aberta vêm de um avaliador LLM (verificação aleatória humana com 98% de concordância; uma reavaliação entre famílias de todos os 342 veredictos replicados do quintil mais difícil concordaram 342/342; reamostragem de sensibilidade no apêndice). Ambos os benchmarks são públicos, portanto o vazamento do conjunto de treinamento não pode ser descartado; em SimpleQA sua direção favorece respostas memorizadas-corretas, o que reduz o estrato difícil e torna os resultados do regime difícil conservadores; em TruthfulQA o corpus público carrega os próprios equívocos, portanto a direção ali não é clara— uma leitura alternativa já limitada pela ressalva de formato-conteúdo da Seção 5. Nenhuma reivindicação causal é feita sobre por que a concordância falha em questões difíceis—os candidatos a mecanismo (priors compartilhados, pontos cegos compartilhados, dados de treinamento compartilhados) são nomeados mas não separados.
Conclusão
Concordância é evidência apenas após a independência e a competência serem medidas, e a medição é barata—a análise completa aqui é executada em segundos em hardware comum a partir de arquivos brutos públicos. Até que painéis sejam fornecidos com suas -matrizes e elevações estratificadas, "verificado por consenso" deve ser lido da maneira como engenheiros de segurança aprenderam a ler uma revista de bolsa.
References
B. Schneier. Beyond Fear: Thinking Sensibly About Security in an Uncertain World. Copernicus Books, 2003.
D. Shehata and M. Li. The inverse-wisdom law: Architectural tribalism and the consensus paradox in agentic swarms. arXiv:2604.27274, 2026.
I. D. Raji, P. Xu, C. Honigsberg, and D. Ho. Outsider oversight: Designing a third party audit ecosystem for AI governance. In AIES, pages 557–571, 2022.
Y. Du, S. Li, A. Torralba, J. B. Tenenbaum, and I. Mordatch. Improving factuality and reasoning in language models through multiagent debate. In ICML, 2024. arXiv:2305.14325.
S. Farquhar, J. Kossen, L. Kuhn, and Y. Gal. Detecting hallucinations in large language models using semantic entropy. Nature, 630(8017):625–630, 2024.
Kaihua Ding. When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv preprint arXiv:2607.08065, 2026.
E. Kim, A. Garg, K. Peng, and N. Garg. Correlated errors in large language models. In ICML, 2025. arXiv:2506.07962.
M. Sharma, M. Tong, T. Korbak, D. Duvenaud, et al. Towards understanding sycophancy in language models. In ICLR, 2024. arXiv:2310.13548.
A. Khan, J. Hughes, D. Valentine, L. Ruis, et al. Debating with more persuasive LLMs leads to more truthful answers. In ICML, 2024. arXiv:2402.06782.
J. Wei, K. Nguyen, H. W. Chung, Y. J. Jiao, S. Papay, A. Glaese, J. Schulman, and W. Fedus. Measuring short-form factuality in large language models. arXiv:2411.04368, 2024.
S. Lin, J. Hilton, and O. Evans. TruthfulQA: Measuring how models mimic human falsehoods. In ACL, 2022. arXiv:2109.07958.
S. Lifshitz, S. A. McIlraith, and Y. Du. Multi-agent verification: Scaling test-time compute with multiple verifiers. arXiv:2502.20379, 2025.
P. Verga, S. Hofstätter, S. Althammer, Y. Su, A. Piktus, A. Arkhangorodsky, M. Xu, N. White, and P. Lewis. Replacing judges with juries: Evaluating LLM generations with a panel of diverse models. arXiv:2404.18796, 2024.
H. Zhang, Z. Cui, J. Chen, et al. Stop overvaluing multi-agent debate—we must rethink evaluation and embrace model heterogeneity. arXiv:2502.08788, 2025.
Vadym Chernets. Architectural trust: Verifiable decision architecture for agentic commerce. SSRN working paper 7191261, 2026. https://doi.org/10.2139/ssrn.7191261 (cited for the trust construct and for its summary treatment of the shared blind collection; overlapping analyses are cross-flagged where they occur).
Apêndice de reprodutibilidade
Toda re-análise é determinística dado os arquivos JSONL brutos classificados e dois scripts de seed fixo (um script de linha de base reproduzindo cada número de manchete e um complemento de semana-1 produzindo as tabelas de bootstrap, sensibilidade e decomposição abaixo); a recomputação completa leva menos de 15 segundos em hardware comum sem GPU, rede ou chamadas de modelo. O pacote de pré-registro congelado e replicação (registro público do OSF): https://osf.io/4y9dv.
Intervalos de confiança bootstrap para a escada de elevação
Reamostragem no nível de questão dentro do quintil, 2.000 extrações com seed, agrupadas nos três painéis de fronteira.
| Quintil | Wilson 95% | Bootstrap 95% | Elevação | Elevação bootstrap 95% | |
|---|---|---|---|---|---|
| Q1 (mais difícil) | 0/342 = 0.0% | [0.0, 1.1] | [0.0, 0.0] | 0.00 | [0.00, 0.00] |
| Q2 | 46/359 = 12.8% | [9.7, 16.7] | [8.2, 18.2] | 0.82 | [0.51, 1.21] |
| Q3 | 272/473 = 57.5% | [53.0, 61.9] | [50.7, 64.6] | 2.68 | [2.32, 3.09] |
| Q4 | 732/904 = 81.0% | [78.3, 83.4] | [76.6, 85.1] | 3.09 | [2.84, 3.35] |
| Q5 (mais fácil) | 1700/1788 = 95.1% | [94.0, 96.0] | [93.4, 96.6] | 4.56 | [4.16, 5.03] |
Elevação de certificação por quintil de dificuldade com intervalos Wilson e bootstrap 95% (percentuais para , razões para elevação). Sob dificuldade leave-panel-out (classificada pelos 13 modelos não-painel), a célula Q1 agrupada é 78/354 (22.0%, elevação 2.36), o zero persistindo para o painel cross-bloc (0/116); Seção 4. Taxas base por quintil: 3.9 / 15.6 / 21.5 / 26.2 / 20.8% ( = 2286 / 2308 / 2209 / 1778 / 912).
Sensibilidade de erro do classificador
Revertendo 10% dos 8.948 vereditos de fronteira classificados por modelo (200 reamostragens com seed; codificação de concordância e atribuição de quintil congeladas na codificação de protocolo determinístico original de modo que apenas rótulos de correção se movem): a célula de quintil mais difícil "certificada como correta" sobe de 0/342 para uma mediana de 33/342 (9.6%; intervalo de 95% 23–46), portanto a parcela de erro certificado da concordância Q1 permanece em ou acima de 86.5% em cada reamostragem; a elevação Q1 permanece abaixo de 1 em 92% das reamostragens (mediana 0.82, intervalo de 95% 0.56–1.08) enquanto as elevações Q3–Q5 nunca caem abaixo de 2 (medianas 2.17 / 2.51 / 3.42). Das 342 respostas replicadas Q1, 332 (97.1%) são classificadas por modelo e portanto reversíveis neste exercício. Além das reversões sintéticas, uma auditoria entre famílias reclassificou todos os 342 vereditos replicados Q1 com um segundo classificador independente (uma família de fornecedor externa a cada painel e à família do classificador original; temperatura 0; solicitação congelada byte-idêntica): concordância 342/342 (reversões para correto 0/342, limite superior Wilson 1.1%), uniforme nas células classificadas por modelo (332) e codificadas como string/recusa (10). Como as 342 células abrangem 106 questões únicas, uma leitura conservadora quanto a clusters trata questões como a unidade: 0/106 dá um limite superior Wilson de 3.4%; o nulo de permutação no nível de questão da Seção 4 já opera no nível de cluster.
Controle de solicitação reversa: decomposição por modelo
Seis modelos locais, 2,399 observações pareadas válidas; flip = o verificador abandona sua resposta cega pela mostrada.
| Verificador | Direto (para errado) | Reverso (para correto) | Dif |
|---|---|---|---|
| qwen3:8b | 204/227 = 89.9% | 196/218 = 89.9% | pp |
| mistral | 132/213 = 62.0% | 113/203 = 55.7% | pp |
| glm4:9b | 66/213 = 31.0% | 39/200 = 19.5% | pp |
| llama3.2:3b | 40/234 = 17.1% | 38/227 = 16.7% | pp |
| gemma4:e4b | 33/202 = 16.3% | 19/195 = 9.7% | pp |
| phi4-mini | 2/137 = 1.5% | 2/130 = 1.5% | pp |
| Agrupado | 477/1226 = 38.9% | 407/1173 = 34.7% | pp |
Taxas de reversão por verificador e braço. Nenhum modelo reverte mais prontamente para a resposta correta do que para a confiante errada. Recontagem pareada: 1,028 itens presentes em ambos os braços (296 revertidos em ambos, 558 em nenhum); pares discordantes 104 (apenas-errado) vs. 70 (apenas-correto), McNemar binomial exato (assintótico ). Todas as 884 reversões registradas possuem confiança pós-exposição declarada ; taxa de reversão abaixo desse limiar é 0/547.
Erro de consenso certificado MC por categoria TruthfulQA
Agrupado nos quatro painéis locais pré-especificados (eventos por item-painel; categorias com pelo menos 20 itens): Economia 8.6%, Ficção 6.2%, Paranormal 6.0%, Lei 5.9%, Superstições 5.7%, Estereótipos 5.4%, Sociologia 4.9%, Saúde 4.9%, Equívocos 2.6%, Conspirações 1.0%. Taxas por painel com todos os três membros em confiança : 4.0% (CN-local), 5.2% (cross-bloc), 6.0% (pilot), 7.2% (US-local).
O limite superior de 4.6% repousa no único painel local que compartilha apenas 87 itens com as 98 respostas classificáveis do modelo de raciocínio; excluindo-o, o intervalo estrito local de forma aberta é 1.5–1.8%.↩︎
Como citar
Chernets, V. (2026). Verification Theater: Measured Failure Modes of AI Verifier Panels [Apresentação de artigo]. NeurIPS 2026 Workshop: Who Verifies the Agents?. Zenodo. https://doi.org/10.5281/zenodo.23197641
@misc{chernets2026verificationtheater,
  author       = {Chernets, Vadym},
  title        = {{Verification Theater: Measured Failure Modes of AI Verifier Panels}},
  year         = {2026},
  howpublished = {Zenodo; NeurIPS 2026 Workshop: Who Verifies the Agents?},
  doi          = {10.5281/zenodo.23197641},
  url          = {https://doi.org/10.5281/zenodo.23197641}
}