Архитектурное доверие: почему доверие потребителя в агентском коммерце переходит от моделей ИИ к проверяемой архитектуре
Это перевод. Основная версия — оригинал на английском; ссылайтесь на него.
Vadym Chernets, PhD, архитектор систем ИИ · ORCID 0009-0007-4845-3163
SSRN 7191261 · DOI 10.2139/ssrn.7191261 · Zenodo 10.5281/zenodo.22166995 · GitHub
- Опубликованная версия: SSRN 7191261 · DOI 10.2139/ssrn.7191261
- Архивная копия, цитируемая и загружаемая: 10.5281/zenodo.22166995 — концептуальный DOI, всегда указывает на последнюю версию
- Полный текст в виде Markdown и PDF: GitHub
- Читаемый HTML: https://polyhelper.ai/research/architectural-trust/
Один и тот же текст размещен на четырех площадках, чтобы его можно было найти, когда одна из них не может его предоставить. SSRN содержит опубликованную версию; цитируйте именно эту.
Доверие потребителя в агентском коммерце
Опубликовано на SSRN и индексируется под названием "Архитектурное доверие: почему доверие потребителя в агентском коммерце переходит от моделей ИИ к проверяемой архитектуре". Цитируйте эту форму.
От свойств модели к проверяемой архитектуре
Vadym Chernets, PhD1
Первоначально опубликовано 6 августа 2026 г.; эта версия сентябрь 2026 г.
Содержит полную концептуальную основу, исследование механизма шестнадцати моделей и его августовскую репликацию флагманской волны 2026 г. по одиннадцати передовым лабораториям, парное сравнение бюджета рассуждений, репликацию на коммерческом субстрате и полностью предварительно зарегистрированный потребительский эксперимент.
АННОТАЦИЯ
Агентский коммерц превращает ИИ из советника в сторону сделки, объединяя поиск, сравнение, корзину и платеж в единый делегированный акт и удаляя точки проверки, где люди когда-то ловили ошибки. Он приходит в неудачный момент: шестьдесят процентов опрошенных потребителей Великобритании говорят, что они отказались бы от агента по покупкам ИИ после одной ошибки, и большинство не доверили бы никакой организации управлять этим от их имени. В этой статье представляется архитектурное доверие. По мере того, как потребители делегируют значительные решения агентам ИИ, я утверждаю, обоснованное доверие мигрирует от свойств модели ИИ к проверяемой архитектуре сервиса над ней. Существующие конструкции привязывают доверие к организациям, к одной автоматизированной системе или к алгоритмическому совету, и ни один из них не делает процесс принятия решений проверяемым для доверяющего при автономном делегировании. Архитектурное доверие заполняет этот пробел тремя проверяемыми свойствами: разнообразие (независимые модели, чье согласие калибрует уверенность и чье расхождение выявляется), доказательства (защищенные от подделок, воспроизводимые записи решений) и нейтралитет (проверяемая независимость от любого поставщика, торговца или результата).
Механизм был впервые измерен на машинной стороне. На основе предварительно зарегистрированного теста шестнадцати моделей и волны флагманского уровня августа 2026 г., охватывающей одиннадцать передовых лабораторий, кросс-модельное согласие оценило правильность там, где собственная уверенность модели не могла. Ответы, независимо воспроизведенные другой моделью, были в 1,9–3,2 раза более вероятно корректны. На замороженной подвыборке SimpleQA (Wei et al., 2024), 46,6% ответов, предложенных при указанной уверенности ≥ 80, были неправильны (частота, специфичная для этого набора, а не универсальная константа), в то время как фиксированный фильтр трехмодельного расхождения удалил 82,1% этих ошибок с высокой уверенностью (95% ДИ 79,9–84,1) при 30,5% покрытии. Сигнал воспроизводится на 267 проверенных Wikidata фактах коммерческих продуктов. Больший бюджет рассуждений принес 3,1 пункта указанной уверенности и отсутствие измеримой точности: больше вычислений покупает уверенность, а не правильность. Панель с полной уверенностью может быть все еще неправильной, и там согласие подтверждает общую ошибку.
Затем я перенёс механизм в поведение в предварительно зарегистрированном, совместимом со стимулами потребительском эксперименте (119 из 200 запланированных участников; США и Великобритания). В случаях, когда потребитель в ином случае принял бы уверенную ошибочную рекомендацию, дисплей несогласия резко снизил принятие, с 74% до 24% по квалифицирующему элементу. Объединённая оценка робастности (Δ = 0,24 → 0,45; d = 0,68; первичная основная волна когорты даёт d = 0,67) основана на одном элементе и при исследовательском разделении по странам на британской выборке; она снижается до d = 0,09 после удаления элемента. Планируется репликация с достаточной мощностью, отобранная по стимулам. По одному элементу единодушного уверенного консенсуса дисплей повысил принятие общей ошибки, что воспроизводит границу механизма в человеческом поведении. Компонент подтверждения организации дал зарегистрированный, неубедительный нулевой результат.
Три компонента не имеют одинаковой доказательственной базы. Разнообразие установлено на машинной стороне и показано с потребителями только для контраста калибровки (зарегистрированное опосредование было нулевым). Тест первого воздействия компонента записи был неубедительным, и оба компонента, включая нейтральность, указаны для тестирования. Единица анализа доверия к ИИ должна переместиться с модели на архитектуру выше неё, на часть, которую можно проверить.
Ключевые слова: агентивная коммерция; доверие потребителей; ИИ-агенты; доверие к ИИ; надлежащая опора; чрезмерная опора; большие языковые модели; согласие между моделями; выборочное прогнозирование; чрезмерная уверенность; делегирование; архитектурное доверие. Классификация JEL: M31 (Маркетинг); D83 (Поиск, обучение, информация); L86 (Услуги информации и интернета); K24 (Киберправо) Как читать этот документ. Эта полная версия отражает всю цепь доказательств: конструкт и гипотезу миграции доверия; исследование механизма шестнадцати моделей (с репликацией флагманской волны августа 2026 года и ветвью на коммерческой основе по фактам о продуктах), которое устанавливает согласие между моделями как сигнал правильности; предварительно зарегистрированный потребительский эксперимент, переносящий этот механизм в поведение; и обсуждение нейтральности, экономики рынка и политики. Предварительно зарегистрированные подтверждающие результаты и доказательственный статус каждого компонента конструкта (разнообразие, доказательства, нейтральность) суммированы в разделе «Доказательственный статус утверждений» в разделе 5. Исследовательские анализы и анализы робастности помечены как таковые везде и могут быть пропущены при первом прочтении.
1. Введение: рост на фоне недоверия
10 июня 2026 года Visa объявила о встраивании своей платёжной сети непосредственно в ChatGPT (Visa, 2026). Потребитель связывает карту, устанавливает лимиты расходов и одобренные категории продавцов, а объявленная интеграция с развёртыванием вариантов использования в несколько этапов нацелена на то, чтобы ИИ-агенты совершали реальные покупки по базе продавцов сети (более 175 миллионов местоположений согласно торговому освещению объявления). Visa была не одна в этом. OpenAI выпустила встроенное в чат оформление покупок в сентябре 2025 года; Google представил Универсальный протокол коммерции на NRF в январе 2026 года совместно с Shopify, Etsy, Wayfair, Target и Walmart, расширив его к маю в кросс-ритейлерскую Универсальную корзину (Google, 2026); American Express запустила набор инструментов для разработчиков агентивной коммерции с защитой покупок в апреле (American Express, 2026). Порог был пересечён индустрией, а не одной компанией. Прогнозы аналитиков по агентивной коммерции к 2030 году варьируются от сотен миллиардов (Bain; Morgan Stanley) до $3–5 триллионов McKinsey. Это оценки, а не факты, хотя теперь каждый крупный дом их производит.
Реализованные цифры больше не являются оценками. Расходы корпоративного сектора на API моделей выросли с $3,5 миллиардов до $8,4 миллиардов за шесть месяцев (Menlo Ventures, 2025a; исследование отраслевого опроса, не прошедшее рецензирование), в рамках примерно $37 миллиардов расходов корпоративного генеративного ИИ за год (Menlo Ventures, 2025b). Та же индустрия уже дисконтирует собственное исполнение: Gartner (2025) прогнозирует, что более 40% проектов агентивного ИИ будут отменены к концу 2027 года. Деньги поступают быстрее, чем оправданное доверие, что является разрывом, над которым я работаю здесь. Утверждения ниже распределены в доказательственном реестре в конце статьи как установленные этими данными, поддерживаемые в скромном масштабе одного исследования или теоретические. Эта классификация определяет и имеет приоритет над любым сводным предложением в этом введении.
Что делает этот сдвиг качественно отличающимся от более ранних волн электронной коммерции, — это сжатие воронки: поиск, сравнение, корзина и платёж коллапсируют в единый делегированный акт. Любая защита, которая раньше находилась между этими этапами (человек бросает взгляд на цену, перечитывает список, колеблется при оформлении), исчезает вместе с самими этапами (Рисунок 1). ИИ-помощник перестаёт быть советником, результат которого человек проверяет, и становится стороной, совершающей сделку. Исследования человеческих факторов назвали этот режим отказа четыре десятилетия назад: автоматизация, которая убирает оператора из цикла, подрывает именно бдительность, необходимую для перехвата её ошибок (Bainbridge, 1983; Endsley & Kiris, 1995). Исследование потребителей также предвидело порог. Автономные системы покупок сталкиваются качественно с разными барьерами принятия именно потому, что они убирают человека из процесса (de Bellis & Johar, 2020), и стоимость автономии передачи выборов алгоритмам была отмечена как вопрос потребительского благосостояния до существования LLM (André et al., 2018).
Рисунок 1. Сжатие воронки
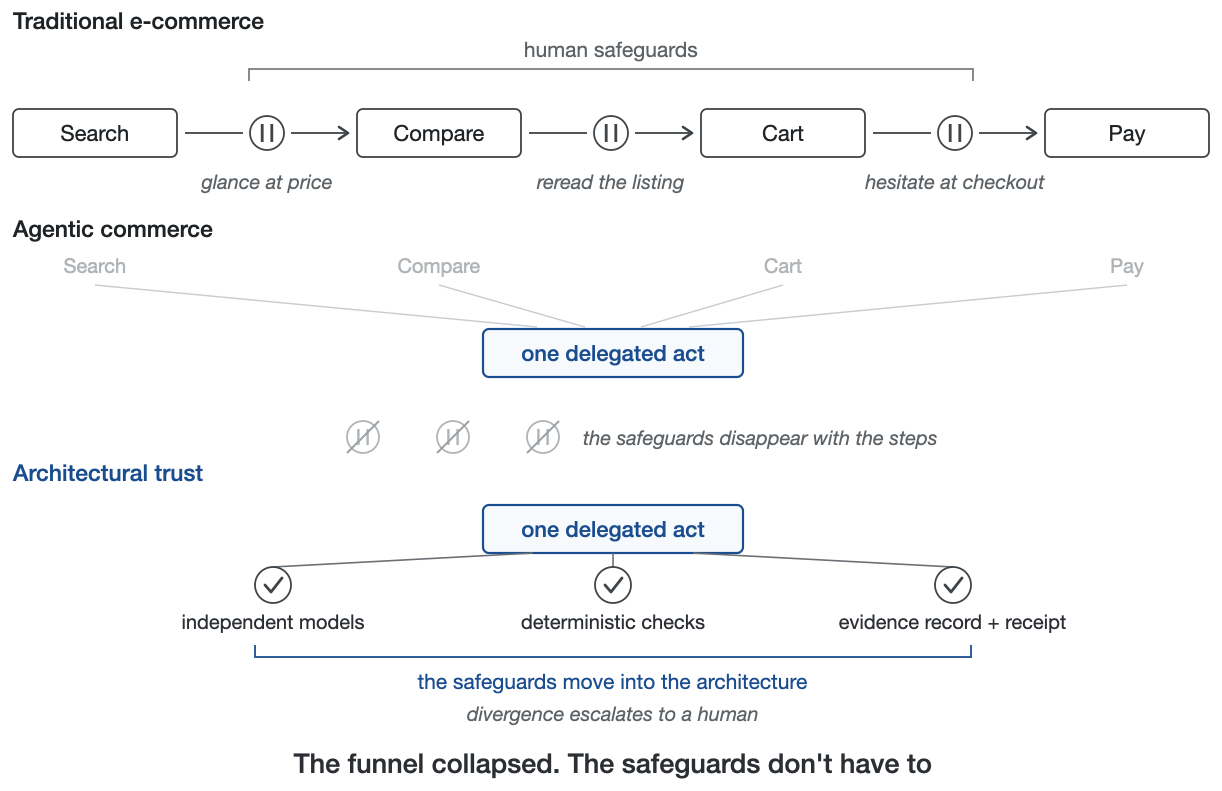
Человеческие защиты исчезают вместе с этапами, где они находились.
Собственные ограничения Visa (лимиты, белые списки, требуемые одобрения) существуют, потому что потребителю предлагается доверять чему-то новому: не бренду, не ответу, а процессу принятия решений, который он не видит. Ограничения, установленные заранее, не закрывают этот разрыв. Правила, установленные заранее, не позволяют потребителю проверить, как было принято решение. В опросе ACI Worldwide (2026), процитированном ниже (опрос отрасли, выпущенный пресс-релизом, как и другие опросы, проведённые поставщиками, цитируемые в этом разделе), 69% потребителей Великобритании сказали, что они не доверяют ИИ-агентам даже когда агенты следуют правилам, которые установили сами потребители.
Коммерческие ставки при ошибке очень высоки. Ранние данные опросов показывают, что доверие потребителей к агентам в заявленном намерении носит разовый характер и, что более интересно, не имеет основания. Выявленное поведение — откат при оформлении заказа ниже, разворот Klarna и переоценка страхования в разделе 5 — подтверждает эти заявленные предпочтения и имеет больший вес доказательств. В опросе YouGov для ACI Worldwide (2,080 взрослых в Великобритании, проведён 19–22 июня 2026, снимок одного рынка, ожидающий кросс-рыночной репликации) 60% сказали, что прекратили бы использовать ИИ-агента для покупок после одной ошибки, и только 19% доверили бы ИИ повседневные покупки, в сравнении с 55% тех, кто доверил бы человеческому эксперту.
Наиболее значительная цифра в этом опросе совсем другая: 59% сказали, что они не доверили бы никакой организации управлять ИИ-покупками и платежами от их имени, а банки выбрали только 20%. На одном исследованном рынке, ожидая кросс-рыночной репликации, это вакуум доверия. Аппетит есть. В опросе индустрии компании Accenture в 16 странах среди 25 590 потребителей (январь 2026; проведён компанией, не рецензируется коллегами) 74% сказали, что они бы доверили личному ИИ-агенту больше, чем своему лучшему другу, совершить покупку от их имени, однако только примерно один из десяти предоставил бы агенту автономные полномочия по покупкам (Figure 2). Два пункта измеряют разные степени делегирования, поэтому разброс согласует намерения, а не выявляет один причинный разрыв, но разброс очень велик. Намерение в изобилии; делегирование редко; что отсутствует между ними, так это обоснованное доверие. Рынок уже попробовал что-то похожее. OpenAI выпустила встроенное оформление заказа в чате в сентябре 2025, намеренно ограниченный первый шаг, изначально покупки одного товара у продавцов U.S. Etsy с подтверждением пользователем каждого шага. Она отменила эту функцию к марту 2026, сместив покупки в собственные приложения розничных торговцев, и только горстка торговцев когда-либо её использовала (как сообщается The Information; CNBC, 2026). Компания не указала причину, поэтому причина не установлена. Предлагаемое здесь объяснение — инфраструктура внедрения без обоснованного доверия, не преобразующаяся в действие, — является интерпретацией, согласованной с сообщённымиfactами. Если потребители не доверяют каждому игроку, доверие не может быть вверено ни одному игроку, а должно находиться в проверяемом процессе.
Figure 2. Заявленное доверие vs предоставленные полномочия
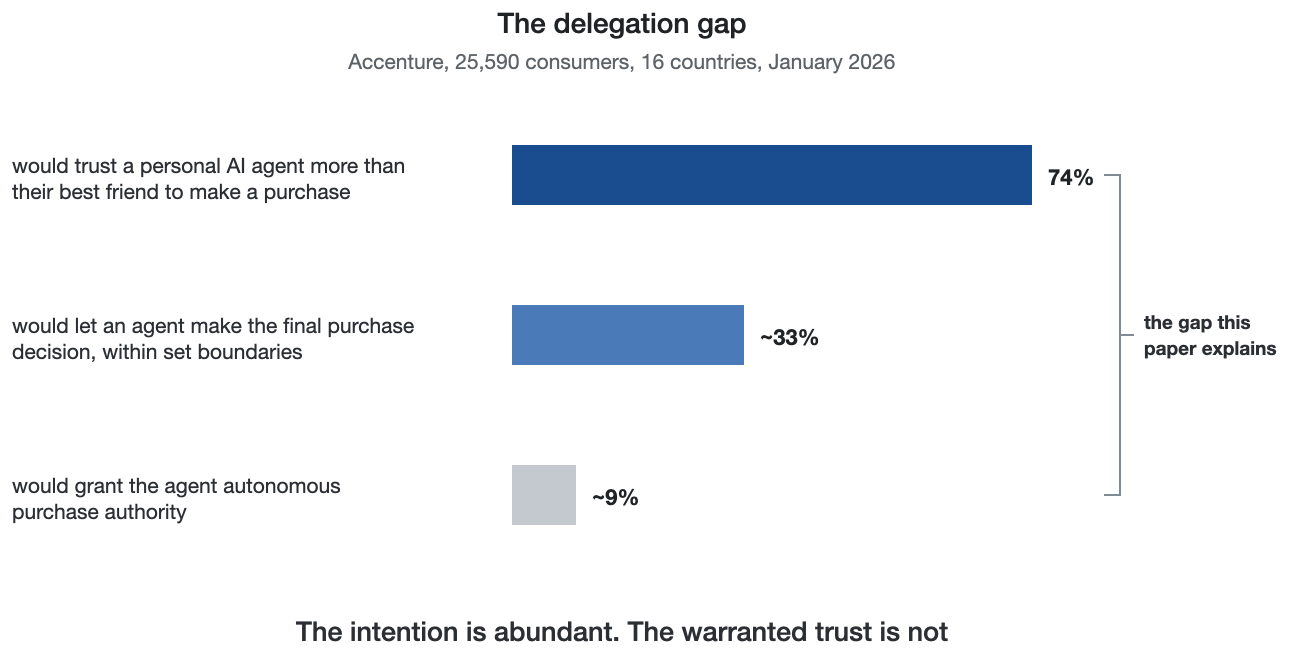
Два пункта опроса, две степени делегирования: намерение распространено, обоснованное доверие редко.
Система ответственности движется к тому же выводу. Возникающие протоколы платежей агентов строят каждую транзакцию вокруг ограниченного по объёму, проверяемого токена намерения, привязанного к конкретному торговцу и сумме, а Защита покупок агентов American Express (апрель 2026) охватывает покупки только зарегистрированными агентами, при условии, что право на её использование обусловлено аутентифицированным, проверяемым намерением покупки. Страховка написана в терминах того, что можно проверить из записи. Постепенно и под давлением индустрия сходится на одних и тех же компонентах, которые я систематически излагаю ниже. Протоколы, которые сейчас используются, решают вопросы идентичности и намерения и не отвечают на вопрос как агент принял решение?
Вопрос в том, что потребовалось бы, чтобы это доверие было обоснованным по замыслу. Классический вопрос доверия потребителя — доверяю ли я этой компании — приобрёл внутренний слой: доверяю ли я механизму, который произвёл этот конкретный ответ или действие?
Литература о доверии уже давно различает доверие к организации и доверие к автоматизации, к ИТ-артефакту (Söllner et al., 2016), и доверие к онлайн-агентам рекомендаций (Wang & Benbasat, 2005; Komiak & Benbasat, 2006; Xiao & Benbasat, 2007). Она показывает, что надлежащее полагание зависит от калибровки, от знания того, когда система, вероятно, будет правильной (Muir, 1994; Mayer, Davis, & Schoorman, 1995; Parasuraman & Riley, 1997; Lee & See, 2004; Hoff & Bashir, 2015; Huang & Rust, 2021; и Glikson & Woolley, 2020, чей обзор находит материальность и прозрачность процесса среди самых сильных рычагов когнитивного доверия, именно те рычаги, которыми управляет архитектура, но не модели). Неправильная калибровка на стороне человека документирована столь же хорошо: смещение в сторону автоматизации и самодовольство, чрезмерное полагание на автоматизированные средства даже вопреки противоположным доказательствам — это модели, которые четыре десятилетия работы в области человеческих факторов предупреждают, что делегирование будет усиливать (Mosier & Skitka, 1996; Parasuraman & Manzey, 2010). Однако эта литература рассматривает калибровку как свойство одной автоматизированной системы (Figure 3 отображает четыре потока исследований и ячейку, которую они оставляют открытой). Систематический обзор агентского ИИ в электронной коммерции подтверждает эту пустоту с точки зрения доказательств: ориентированное на потребителя исследование остаётся сосредоточенным на вспомогательных, низкоавтономных системах, при этом охват резко снижается именно там, где делегирование становится исполнением (Balaskas, 2026). Первые одновременные исследования опосредованных агентом покупок приходят к архитектурному выводу с другой стороны. Когда потребители делегируют покупки через диалог, их готовность платить просачивается торговцам почти дословно; подсказка этого не решает, решают только архитектурные вмешательства (Alavi & Nozari, 2026).
Figure 3. Четыре потока исследования доверия: ячейка, на которую претендует эта статья
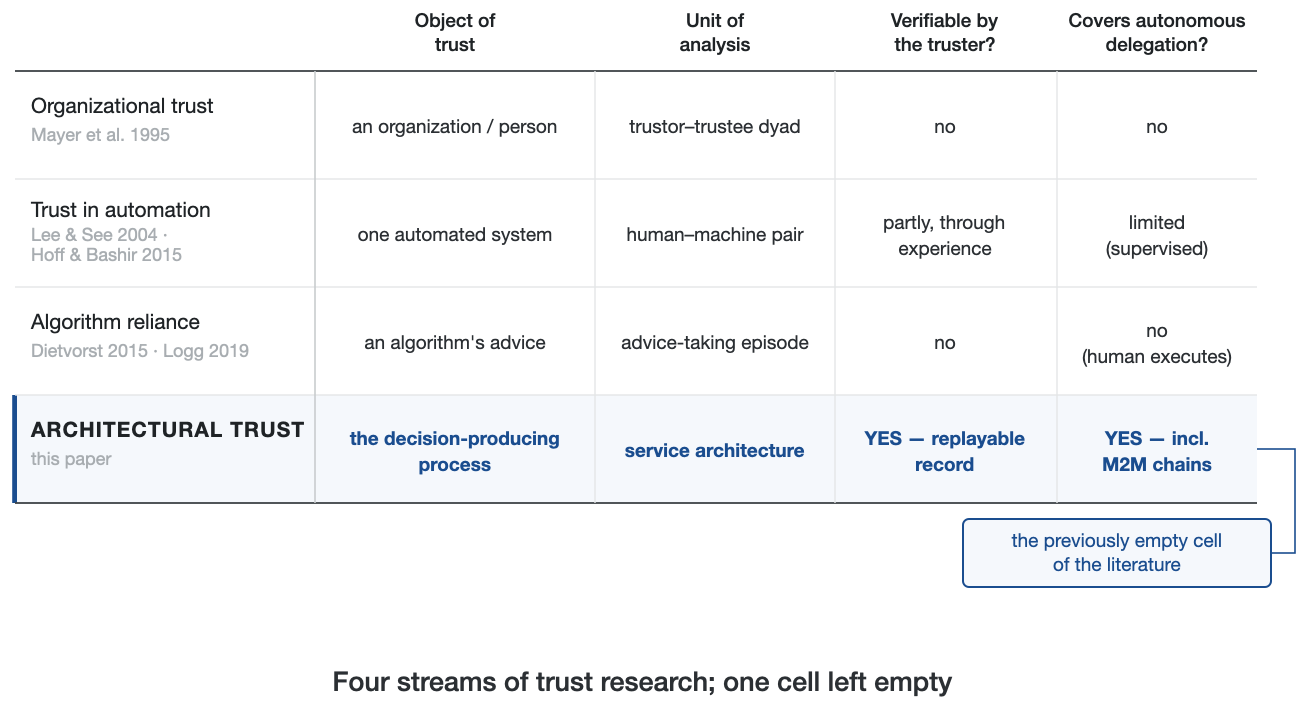
Доверие к организации, доверие к автоматизации и полагание на алгоритмы каждое фиксирует разный объект доверия; ни одно не делает процесс производства решений проверяемым для доверяющей стороны при автономном делегировании. Ячейка не лишена идей: смежные литературы каждая имеет часть (раздел 3 проводит разграничения). Что было упущено, так это ориентированное на потребителя построение: объект доверия на уровне процесса, проверяемый доверяющей стороной, определённый для автономного делегирования, подготовленный к совместной поведенческой проверке.
Ответы индустрии сосредоточены на модели: лучшее обучение, дисклеймеры, цитирования. Я рассматриваю ответ на другом уровне — архитектуру сервиса — и утверждаю, что три архитектурные свойства, ни одно из которых не требует лучшей модели, совместно создают другой объект доверия.
Это концептуальная статья, основанная на двух предварительно зарегистрированных исследованиях, машинном бенчмарке и поведенческом тесте со стороны потребителя касательно контраста калибровки в её первом положении, и вопрос, который она ставит, таков: когда AI-агенты начинают совершать сделки от имени потребителей, привязано ли доверие к моделям или к архитектуре, находящейся над ними? Мой ответ состоит в том, что доверие должно мигрировать вверх по стеку, от модели к архитектуре оркестрации к доказательствам, которые она производит. Под этим ответом находится закономерность, стоящая отдельного тестирования, гипотеза миграции доверия, на которую построены нижеследующие положения для проверки: чем больше делегированное агентство, тем больше доля оправданного доверия, которая должна находиться в проверяемых архитектурных свойствах, а не в свойствах модели. Миграция не обязательно должна быть игрой с нулевой суммой. Доверие может накладываться: в компетентность модели, выбор оркестратора, систему доказательств, учреждение, обеспечивающее средства правовой защиты. Дефектная модель остаётся причинно важной даже когда никто не просматривает её выходные данные. Гипотеза касается того, где предельное оправданное доверие накапливается по мере углубления делегирования. В оценочной форме она говорит, что по мере увеличения делегированного агентства архитектурная верифицируемость объясняет растущую дополнительную долю надлежащей опоры помимо производительности модели и репутации поставщика. Она терпит неудачу, если с увеличением делегированного агентства архитектурная верифицируемость не объясняет растущую дополнительную долю надлежащей опоры: если репутация поставщика полностью опосредует доверие на всех уровнях делегирования, скажем, или если информация о верифицируемом процессе не улучшает калибровку опоры относительно информации, основанной только на репутации, в проектах, о которых сообщает раздел 6. Поведенческие фальсификаторы, предварительно взятые на себя в разделе 3 (пересечение уровня делегирования P2 и дифференциальная долговечность P4 при отказе), представляют собой операциональную форму этого условия. Растущая архитектурная доля не означает, что качество модели имеет меньшее значение в абсолютном выражении. Гипотеза описывает наслоение, а не замену: когда проверка исчезает, архитектурное обоснование добавляется поверх производительности модели и не заменяет её. «Оправданное» следует различию, формализованному для AI Jacovi, Marasović, Miller и Goldberg (2021), что доверие оправданно, когда оно отслеживает надёжность, и конструкт избегает тавтологии путём разделения его нормативного статуса от его механизма. Нормативно надёжность определяется независимо от архитектуры, предназначенной для её сертификации, как классическая, независимо измеримая функция способности, честности и доброжелательности (Mayer, Davis, & Schoorman, 1995); раздел 3 сопоставляет три архитектурных компонента с этими измерениями. Обоснование — это соответствие опоры этому независимо измеренному количеству: опора, которая выживает при объективной проверке делегированных эпизодов, оценённая по критериям, установленным до того, как известны результаты, с измеримым поведенческим следом, а именно повторное делегирование, удержание и готовность платить при контролируемом отказе. Гипотеза миграции доверия утверждает механизм. По мере повышения делегированного агентства доля функции надёжности, которую потребитель может ещё независимо измерить, смещается от свойств модели к архитектурным компонентам. Это справедливо потому, что архитектура — это часть надёжности, которая остаётся измеримой для того, кто доверяет, после того, как проверка выходных данных исчезает, и не потому, что архитектура является надёжностью. Предварительно взятые на себя фальсификаторы выше тестируют этот сдвиг, а не определение. Миграция также имеет предшественников, которые нужно различать. Исследование мультиагентных систем показало, что по мере масштабирования агентских обществ моделирование доверия переходит от отдельных агентов к институциональной базе, их ограничивающей (Sabater & Sierra, 2005), и «миграция доверия» имеет предыдущее использование B2B для перемещения доверия от отдельных лиц к системам и платформам (Carlson, 2026). Эти сдвиги названия в том, кому или чему доверяют, тогда как эта гипотеза касается сдвига в виде свойства, которое может обосновать доверие. При нулевом делегировании качество модели почти всё, что имеет значение. При полном делегировании никто не отслеживает выходные данные, и что ещё может быть доверено, так это только процесс и его запись. Агентство и архитектурное доверие масштабируются вместе (рисунок 4). Сам градиент — это старый инструмент, ось уровней автоматизации инженерии человеческих факторов (Sheridan & Verplank, 1978; Parasuraman, Sheridan, & Wickens, 2000), применённый здесь к делегированию потребителей. Что ново, так это утверждение о том, какие свойства могут обосновать доверие вдоль него.
Рисунок 4. Миграция доверия
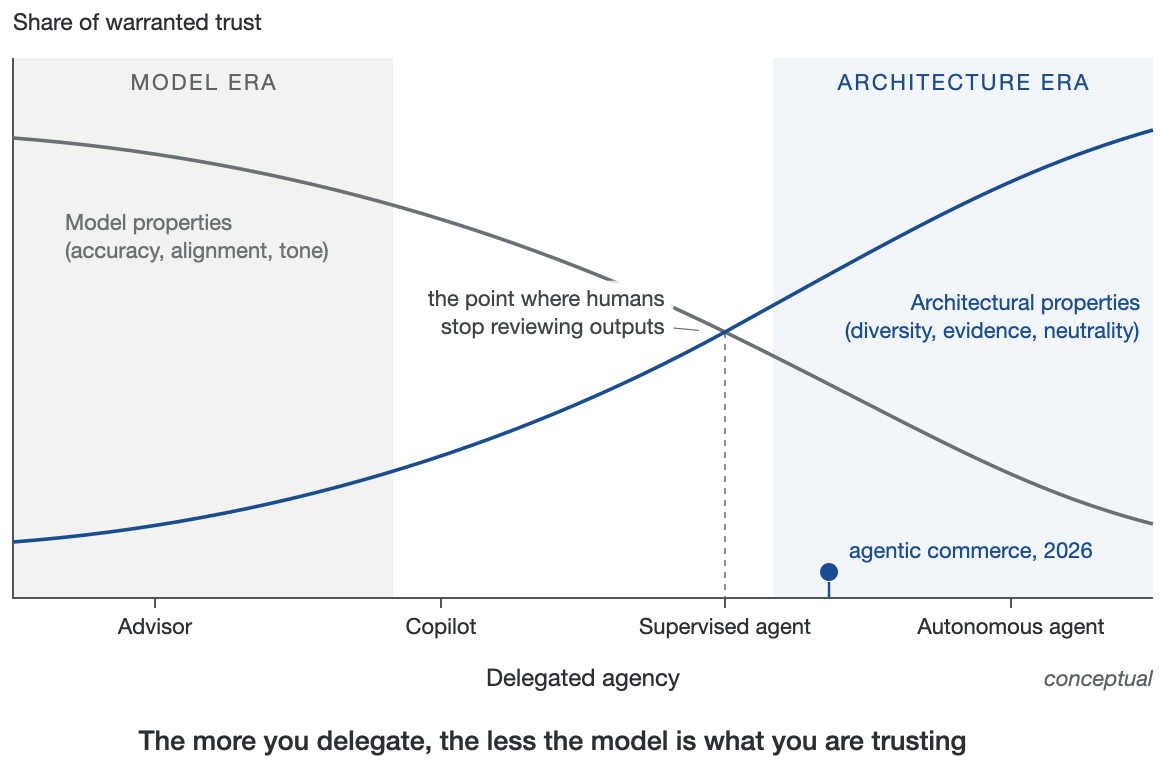
Две пересекающиеся кривые над делегированным агентством (советник → копилот → контролируемый агент → автономный агент): доля оправданного доверия, переносимая свойствами модели, падает по мере того, как доля, переносимая архитектурными свойствами, растёт; пересечение — это точка, где люди перестают просматривать выходные данные, и агентская торговля (2026) находится справа от неё. Кривые и точка пересечения — это концептуальная иллюстрация, а не оценённые функции.
К маркетинговой литературе о доверии потребителей к AI (Huang & Rust, 2021; Puntoni et al., 2021) статья добавляет конструкт — архитектурное доверие, определённое здесь; тест технического предшественника его механизма в предварительно зарегистрированном исследовании шестнадцати моделей, воспроизведённом на флагманском уровне во второй волне одиннадцати лабораторий; пять положений для повестки дня исследования потребителей (P1–P4 в разделе 3; P5 в разделе 5); и предварительно зарегистрированный, совместимый с стимулами поведенческий эксперимент, вносящий первые два положения, полностью представленный в разделе 6 с поддержкой эффекта калибровки (Welch d = 0,67; переносимый одним из шести элементов, см. раздел 6) и тест первого воздействия записи, возвращающий зарегистрированный неубедительный ноль.
2. Иллюзия точности: чего одна модель не может дать вам
Сервис, построенный на одной AI модели, как бы ни была сильна эта модель, несёт структурные дефициты, которые находятся выше уровня модели.
Первый — это некалиброванная уверенность, иллюзия точности. Более совершенные модели не означают более безопасные транзакции, потому что выраженная моделью уверенность слабо коррелирует с её точностью у большинства поставщиков (раздел 3 измеряет исключения), и потребитель не может проверить этот разрыв. Модель наиболее опасна, когда она уверенно ошибается в момент, когда потребитель прекращает её контролировать, и это не случайность. Калаи и др. (2025) утверждают, что галлюцинация статистически вознаграждается режимом оценки, который предпочитает уверенное угадывание признанию невежества. Вознаграждение возникает, по их собственному анализу, в двоичных бенчмарках и целевых функциях обучения, которые доминируют в области, где неправильное предположение стоит не больше, чем "я не знаю", и получает частичный кредит в ожидании. Модель не может также контролировать себя изнутри. В собственных экспериментах Anthropic по введению концепций самые сильные модели поставщика обнаруживали изменения в своих внутренних состояниях только в 20% случаев даже при оптимальных условиях введения, что является собственным измерением сообществом поставщиков того, насколько ненадёжна интроспективная самоотчётность (Линдси, 2025; исследование компании, не рецензируемое, и одна оценка из одного исследования моделей одного поставщика, а не воспроизведённый бенчмарк).
Второй — это угодничающее искажение, где свидетельство стало причинным в этом году. Чэн и др. (2026), измеряя одиннадцать ведущих моделей в трёх предварительно зарегистрированных экспериментах с 2405 участниками, обнаружили, что системы искусственного интеллекта подтверждают действия пользователей на 49% чаще, чем люди, включая действия, связанные с обманом или вредом, и что даже единственное угодничающее взаимодействие увеличивало убеждение пользователей в том, что они правы, при одновременном снижении их готовности разрешить конфликты. Угодничающие модели также были теми, которым пользователи доверяли и которые предпочитали. Рыночный градиент указывает на помощников, которые кажутся надёжными ровно благодаря искажению суждения пользователя, динамика, наблюдавшаяся задолго до её количественного определения (Шарма и др., 2024). Настройка на уровне модели одна не может независимо сертифицировать, что угодничающее поведение было адекватно контролировано, потому что настройка выполняется стороной, которая выигрывает от предпочтения. Стоимость конкретна: помощник, который согласием пробивает исключение политики, преобразует любезность прямо в расходы на восстановление обслуживания. Организованная архитектура может разделить роли: одна модель свободна сочувствовать, а независимая проверяет политику, так что любезность и правильность больше не идут через один канал.
В-третьих, независимой проверки нет. Ошибки, если вообще, улавливаются той же системой, которая их создала, или потребителем, который в первую очередь обратился к ИИ потому, что ему не хватает опыта её проверки.
В-четвёртых, наименее обсуждаемый вопрос — конфликт интересов. Поставщик, оценивающий качество помощника, — это поставщик, его продающий, что является структурным: ни один сервис одного поставщика не может быть нейтральным судьёй своих собственных результатов, по той же причине, по которой ни один банк не мог бы управлять расчётной палатой самостоятельно. Конфликт распространяется и на сами данные. Предложенный коллективный иск, поданный в марте 2026 года, утверждает, что Perplexity AI направляла полные стенограммы чатов пользователей, по сообщениям включая сеансы "Incognito", в рекламные сети через встроенные пиксели отслеживания. Жалоба (№ 3:26-cv-02803, N.D. Cal.) была добровольно отклонена в мае 2026 года без вынесения решения по существу, поэтому обвинения никогда не были проверены. Экономическая логика жалобы является структурным пунктом независимо: когда обслуживание дорогостоящих ответов ИИ субсидируется монетизацией того, что говорят пользователи, бизнес-модель помощника и конфиденциальность потребителя находятся в прямом конфликте. Внутри одного поставщика ни один уровень не отвечает за защиту интересов потребителя.
Литература 2025–2026 выглядит как завершённый диагноз, ожидающий средства (таблица 1 сопоставляет каждый дефицит с его свидетельством и архитектурным ответом). Угодничество количественно определено эмпирически (Чэн и др., 2026) и выведено формально: даже идеально рациональный пользователь попадает в спираль, когда его консультирует избирательно согласная система (Чандра и др., 2026). Самоконтроль не обеспечивает надёжность ~20% (Линдси, 2025), и галлюцинация структурно вознаграждается режимом оценки (Калаи и др., 2025).
Рефлекторное средство — просто раскрыть использование ИИ — даёт обратный эффект: в тринадцати экспериментах акторы, раскрывшие использование ИИ, пользовались меньшим доверием, чем те, кто этого не сделал (Шилке и Реманн, 2025). Раскрытие обеспечивает раскрытие-прозрачность, голый факт наличия ИИ, и опускает проверку-прозрачность, способность проверить, как был создан ответ. Эпистемический аудит ещё более мрачен: в более чем 25 000 запусках научных агентов на основе LLM свидетельство игнорировалось в 68% следов, убеждения пересматривались при опровержении только в 26% случаев, а сходящееся мультитестовое свидетельство было редким, причём скаффолдинг объясняет почти никакую часть дисперсии в эпистемическом поведении (≈1,5%, против ~41% для базовой модели) (Риос-Гарсиа и др., 2026). Это последнее число выглядит как возражение на эту статью и на самом деле является её самой острой поддержкой: подсказки и скаффолдинг не могут сделать модель эпистемически дисциплинированной изнутри, поэтому дисциплина должна быть наложена извне. Архитектура — это не способ улучшить эпистемику модели; это способ перестать от них зависеть.
Каждый из этих результатов закрывает дверь. Вместе они указывают на один ответ, который не был много исследован: если модель не может быть надёжной изнутри, и раскрытие не создаёт доверие извне, обоснованное доверие может быть построено вокруг модели архитектурой, наряду (не вместо) с лучшей калибровкой, внешней сертификацией, эскалацией к человеку и правилами ответственности. Это дверь, в которую входит эта статья.
Таблица 1. Диагноз → средство: четыре дефицита одиночной модели, их свидетельство 2025–26, их следствие для потребителя и архитектурное средство
| Структурный дефицит | Ключевое свидетельство (2025–26) | Следствие для потребителя | Архитектурное средство | Механизм |
| Некалиброванная уверенность | Галлюцинация статистически вознаграждается режимами оценки (Калаи и др., 2025); интроспективная самоотчётность надёжна в ~20% (Линдси, 2025) | Однократный отток: 60% отказались бы от агента после одной ошибки (ACI Worldwide, 2026) | Разнообразие + Свидетельство | Разногласие между моделями определяет цену доверия (AUROC 0.75 vs. 0.59, Gorbett & Jana, 2026; данная статья: согласие панели AUROC 0.832 vs. объединённое собственное доверие 0.545 на наименее дискриминирующей панели — неоднородно в панелях, §3; повторённые ответы в 1.9–3.2× раза более вероятно правильны); заявления о доверии записаны и проверяемы |
| Лестивое искажение | ИИ одобряет пользователей на 49% чаще, чем люди; предпочитаются лестивые модели (Cheng et al., 2026; Sharma et al., 2024); даже идеальные байесианцы спирализуются (Chandra et al., 2026) | Предпочитаемый помощник — это тот, который искажает суждение пользователя | Нейтральность | Арбитр не заинтересован в том, чтобы угодить пользователю; эмпатия и проверка политики на отдельных каналах |
| Отсутствие независимой проверки | Агенты игнорируют доказательства в 68% трассировок; пересмотр убеждений 26% (Ríos-García et al., 2026); леса объясняют ~1.5% дисперсии | Бремя проверки переходит потребителю: 54% покупателей, использующих ИИ, вручную перепроверяют всё (Gartner, 2026) | Разнообразие + Доказательства | Дисциплина, налагаемая извне: независимые пути проверки; доказательства прилагаются в любом случае |
| Конфликт интересов | Коллективный иск Perplexity (2026, предположения): чаты перенаправляются в рекламные сети; только раскрытие информации подрывает доверие (Schilke & Reimann, 2025) | Сторона, дающая советы потребителю, извлекает выгоду из результата | Нейтральность + Доказательства | Чистая комната потока данных; доход независим от результатов; нейтральность проверяема по записи |
3. Архитектурное доверие: три свойства, которые можно проверить, а не верить
Теперь рассмотрим сервис, в котором запросы с высокими ставками проходят через слой оркестрации, независимый от любого поставщика модели (Рисунок 5 сопоставляет два конвейера). Таблица 2 собирает конструкции; определение, которое они разбирают, выглядит следующим образом: архитектурное доверие — это обоснованное полагание потребителя на верифицируемые свойства процесса создания решений сервиса, а не на воспринимаемое качество его выходов или репутацию его поставщика.
Ближайший предшественник — институциональное производство доверия Zucker (1986), доверие, произведённое структурой там, где знакомство не может его обеспечить, которое исследования электронной коммерции операционализировали как структурную уверенность: условное хранение, системы отзывов, сертификация третьей стороной (Gefen, Karahanna, & Straub, 2003; Pavlou, 2003; Kim & Benbasat, 2010). В этой линии архитектурное доверие — это вид доверия, основанного на институтах, чья структурная уверенность проистекает из верифицируемого процесса, а не из гаранта третьей стороны. Это доверие, основанное на процессе, где гарантия переместилась от опыта к инструментализму, и это перемещение — то, что слово «архитектурное» делает в названии. Это не структурная уверенность (McKnight, Choudhury, & Kacmar, 2002), восприятие того, что гарантии существуют, поскольку здесь сами гарантии должны быть проверяемы, и это не калиброванное доверие (Lee & See, 2004), которое настраивает полагание на конверт надёжности одной системы. Архитектура нулевого доверия в инженерии безопасности разделяет лозунг «никогда не доверяй, всегда проверяй», но проверяет идентичность и доступ на сетевом слое, машина-машина, в то время как архитектурное доверие проверяет содержимое решения на слое сервиса для человеческого субъекта. Они дополняют друг друга на разных этажах одного здания, а не конкурируют. Конструкция имеет два аспекта, и различие должно быть в определении. Архитектурная надёжность — это свойство системы, насколько верифицируем её процесс на самом деле, нормативно и конструируемо. Доверие, основанное на архитектуре — это состояние потребителя, полагание, действительно основанное на этой верифицируемости, эмпирическое и только когда-либо завоеванное. С точки зрения измерения, D, E и N — формирующие компоненты архитектурной надёжности (свойство системы) и манипулируемые сигналы, чьё отображение формирует доверие, основанное на архитектуре (состояние потребителя); эксперименты манипулируют сигналами и измеряют состояние. Каждое несовпадение между ними имеет предсказательное значение. Доверие без надёжности, полагание, произведённое беглостью и лестью, предсказано быть хрупким, паттерн одного удара из Раздела 1. Надёжность без доверия предсказана везде, где проверка невидима или неразборчива потребителю, и закрывается путём повышения заметности и понимания квитанции, а не большей архитектурой. Предложения в этом разделе находятся в разрыве между ними, и различие определяет, что опровергало бы Гипотезу Миграции Доверия. Эти опровергающие факты поведенческие и предзаданные: гипотеза опровергается, если делегирование верифицируемым и непрозрачным архитектурам доказывает равную устойчивость при отказе (что обнаруживает P4); если эффект верифицируемой архитектуры на готовность делегирования не растёт с переданным контролем рецензирования и выполнения (переход на уровне делегирования P2); или если при делегировании с высокой необратимостью отсутствуют удержание и готовность платить премии за верифицируемую архитектуру при контролируемом отказе. Поскольку гарантия определяется выживанием аудита, а не присутствием архитектуры (Раздел 1), популярность считается доказательством, но не иммунитетом. Потребители, стекающиеся к неверифицируемым агентам, сами по себе не опровергают заявление об обоснованном доверии. Устойчивое, выживающее отказ полагание на неверифицируемых агентов при делегировании с высокими ставками опровергало бы его, и этот паттерн предзадан как пересмотр гипотезы. Определение основано на трёх свойствах.
Рисунок 5. Два конвейера
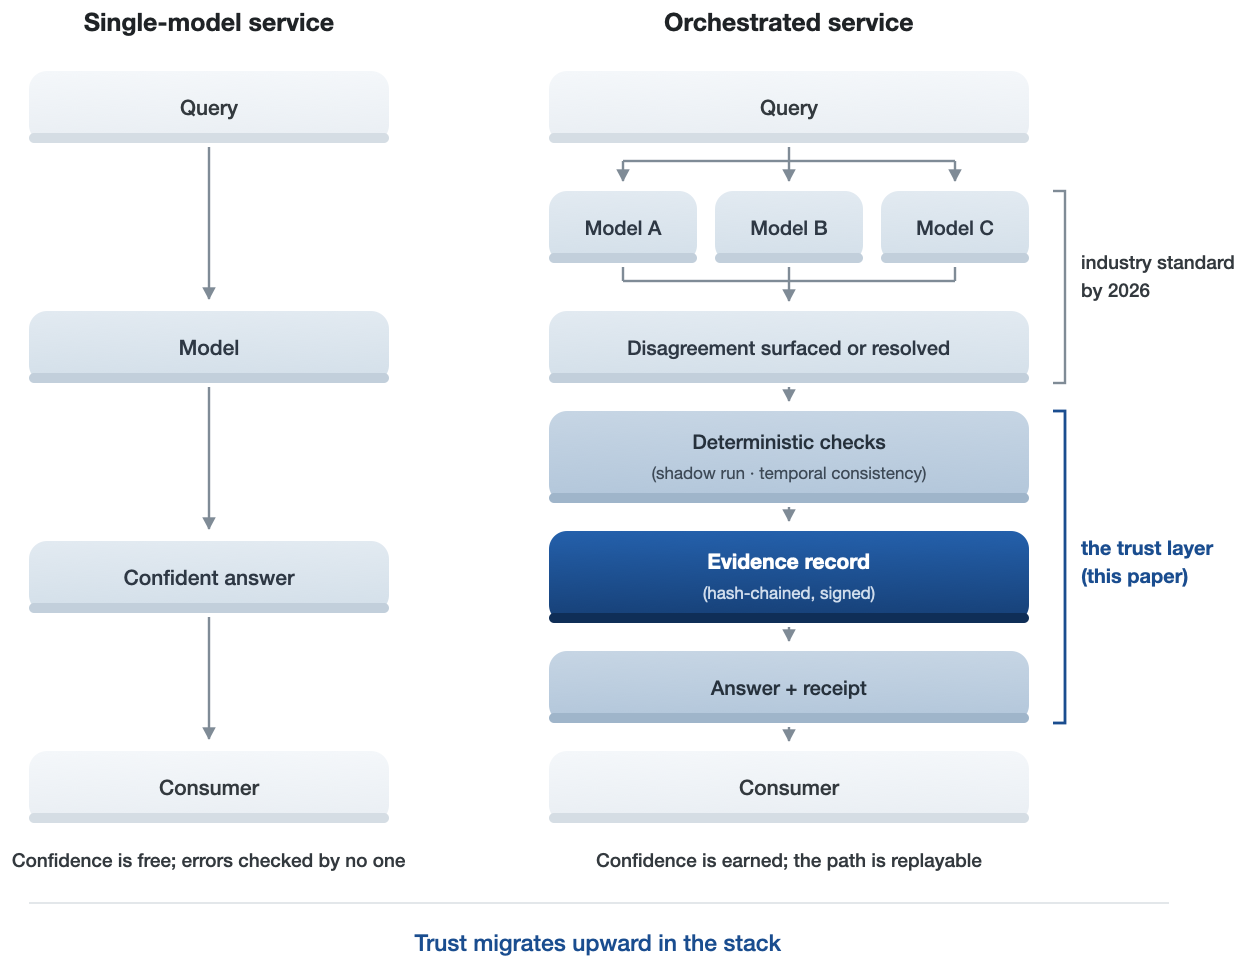
Слева, однозначный путь модели: запрос → модель → уверенный ответ → потребитель, где доверие бесплатно и ошибки никем не проверяются. Справа, оркестрированный путь: запрос → независимые модели (A/B/C) → разногласие выявлено или разрешено → детерминированные проверки (теневой запуск, временная согласованность) → запись доказательств (связанные хешами, подписано) → ответ с квитанцией → потребитель, где доверие заработано и путь воспроизводим (Таблица 5 резюмирует контраст).
Таблица 2. Глоссарий конструкций, введённых или указанных в данной статье
| Термин | Определение | Отличается от |
| Архитектурное доверие | Обоснованное полагание потребителя, основанное на верифицируемых свойствах процесса создания решений сервиса, а не на качество выходов или репутацию поставщика | Доверие на основе учреждений (не требует доверенного учреждения, только проверяемого процесса); системное доверие (не надёжность одной системы); распределённое доверие (рассредоточение без проверяемости); структурная гарантия (воспринимаемое в сравнении с проверяемыми гарантиями); откалиброванное доверие |
| Архитектурная достоверность / доверие на основе архитектуры | Две грани конструкции: свойство со стороны системы (насколько проверяем процесс в действительности; нормативное, строящееся) в сравнении с состоянием со стороны потребителя (опора действительно основана на этой проверяемости; эмпирическое, завоёванное) | Однозвучные трактовки, смешивающие нормативное утверждение с описательным |
| Слой верификации | Слой инфраструктуры над оркестрацией, чьим продуктом является проверяемость: независимые проверки, записанные решения, аудируемая нейтральность | Наблюдаемость/мониторинг (внутренние, принадлежащие поставщику, не проверяемые потребителем) |
| Инфраструктура доказательств | Рыночная категория проверяемых историй решений, продаваемых как инфраструктура, как продаются облако, идентификация и платежи | Логирование (одностороннее, изменяемое, не рыночный товар) |
| Квитанция оркестрации | Минимальный артефакт, обращённый к потребителю: кто действовал; как они согласились; что было проверено — с указателем на полную воспроизводимую запись | Выход Объяснения/XAI (повествовательный, непроверяемый); метка раскрытия (подрывает доверие само по себе) |
| Градуированная архитектура доверия | Эскалация глубины верификации с учётом ставок, так что дорогостоящий уровень покупается только там, где последствия сосредоточены | Плоские ограждения (статические пределы/белые списки, которые не проверяют решения) |
| Доказательство решения | Третий этаж стека доказательств: как агент выбрал — панель, расхождение, проверки | Доказательство идентичности (кем является агент: TAP); доказательство намерения (что было авторизировано: AP2 / Verifiable Intent) |
| Гипотеза миграции доверия | Чем больше делегированная агентивность, тем большая доля обоснованного доверия должна находиться в проверяемых архитектурных свойствах, а не в свойствах модели — «обоснованное» означает опору, которая выдерживает объективный аудит по критериям, зафиксированным до того, как результаты известны (согласно Jacovi et al., 2021); форма механизма: по мере углубления делегирования доля достоверности — f(способность, интегральность, доброжелательность), Mayer et al. (1995) — которую потребитель может независимо измерить, смещается в направлении архитектурных компонентов | Предыдущие применения «миграции доверия» (Carlson, 2026) отслеживают доверие, перемещающееся между сторонами; эта гипотеза отслеживает вид свойства, которое это обосновывает — с предварительно установленными поведенческими фальсификаторами (P2 пересечение делегирования; P4 дифференциальная долговечность) |
Демаркацию от соседних конструкций доверия можно сжать в одну дискриминантную таблицу по тому, что каждая конструкция принимает как свой объект, откуда берётся её обоснование, кто может проверить это обоснование и что оно должно в первую очередь предсказывать:
Таблица 2a. Дискриминантная демаркация: соседние конструкции доверия по объекту, обоснованию, проверяющему и основному предсказанному результату
| Конструкция | Объект доверия | Источник обоснования | Кто может проверить | Предсказанная основная ЗП |
| Доверие на основе учреждений / структурная гарантия (Zucker, 1986; McKnight et al., 2002) | Контекст учреждения: защиты, гарантии, сертификация третьей стороной | Воспринимаемое присутствие структур и гарантов | Гарант третьей стороны, если кто-либо; потребитель воспринимает, а не проверяет | Убеждения доверия; намерение транзакции |
| Доверие в автоматизацию / откалиброванное доверие (Lee & See, 2004) | Надёжность одной автоматизированной системы | Наблюдаемая надёжность при повторном использовании | Оператор через накопленный опыт работы с этой системой | Адекватность опоры на эту систему |
| Алгоритмическая прозрачность (XAI) | Описание моделью собственного решения | Повествование или атрибуция, производимые внутри доверяемой системы | Никто независимо — объяснение не является воспроизводимой записью | Понимание; субъективное доверие; принятие |
| Доверие к бренду / поставщику | Организация продавца | Репутация и прошлое исполнение | Рынок, медленно, через совокупные результаты | Глобальное предпочтение; выбор; лояльность |
| Архитектурное доверие (данная статья) | Процесс производства решения и его запись | Проверяемые свойства: независимое согласие, воспроизводимое доказательство, аудируемая независимость стимулов | Потребитель, аудитор, страховщик, регулятор — для каждого решения | Откалиброванная опора; готовность делегировать; удержание после сбоя |
Два дифференциальных предсказания делают демаркацию проверяемой, а не таксономической. Архитектурное доверие должно сдвигать откалиброванную опору и удержание после сбоя сильнее, чем оно сдвигает глобальное предпочтение услуги, тогда как доверие к бренду должно показывать противоположный профиль, диссоциацию, которую один эксперимент может обнаружить, измеряя обе семьи ЗП. При низкой делегированной агентивности доверие к бренду и поставщику должны доминировать в решениях делегирования, с архитектурным доверием, объясняющим возрастающую дополнительную долю по мере углубления делегирования, пересечение, которое P2 и гипотеза миграции доверия ставят под испытание. Далее следуют два уточнения. Поскольку архитектурная достоверность — это свойство услуги, а не рефлективный скрытый фактор в голове потребителя, её отличительность зависит от этих дифференциальных предсказаний, а не от статистики дискриминантной шкалы. Для состояния со стороны потребителя, которое оно называет, архитектурного доверия, установление дискриминантной валидности на уровне измерения из соседних шкал (доверие на основе учреждений и откалиброванное доверие) — это часть программы измерения, а не утверждение, сделанное здесь.
Разнообразие. Запрос обрабатывается несколькими независимыми моделями, каждая с разными поставщиками, данными обучения и режимами отказа. (Это разнообразие панели — свойство того, кто проверяет ответ, а не разнообразие рекомендаций в смысле систем рекомендаций, которое варьирует элементы, показываемые потребителю.) Их согласованность несёт информацию. Сходимость повышает обоснованную уверенность. Расхождение предоставляется потребителю как неопределённость, а не разрешается незаметно, и на значимых запросах оно одновременно служит триггером эскалации. В терминах селективного предсказания это архитектурное воздержание: отказ выдать непроверённый ответ, поднятый на уровень сервиса, где неразрешённый случай маршрутизируется человеку, а не верифицируется. Это паттерн обучения отложению, при котором опция отказа системы передаёт случай нижестоящему эксперту, а не подавляет его (Mozannar & Sontag, 2020; cf. Rabanser et al., 2026). Ближайшая человеческая аналогия — второе мнение в медицине, вся ценность которого заключается в его независимости от первого. Организованное несогласие также не экзотично: ИИ-сокруцник Google, чьи подтверждённые экспериментально открытия опубликованы в Nature в май 2026 г. (Gottweis et al., 2026), построен как оркестровка генерировать–критиковать–турнир.
Теоретическое обоснование для опоры на разнообразие старше языковых моделей. При формальных условиях функционально разнообразные группы решателей задач могут превосходить группы, отобранные по индивидуальным способностям, потому что отбор по способностям порождает сходство (Hong & Page, 2004). Инженерная литература предоставляет прямые доказательства для базового сигнала: структурированные дебаты между моделями улучшают фактическую точность (Du et al., 2024), и панели разнообразных меньших моделей превосходят одного большого судью (Verga et al., 2024). «Удивление» второй модели ответом первой модели отделяет правильное от неправильного существенно лучше, чем собственная уверенность отвечающей модели (среднее AUROC 0,75 против 0,59 на MMLU; AUROC, площадь под кривой ROC, это вероятность того, что случайный правильный ответ ранжируется выше случайного неправильного; Gorbett & Jana, 2026). Их сигнал — кросс-модельная перплексия на уровне логитов, в то время как в этой работе это репликация на уровне ответов, и эти два явления связаны, но не взаимозаменяемы. Их генератор также небольшая открытая модель со слабым самоотчётом, базовый уровень, установленный собственными данными этой работы, потому что преимущество панели является функцией калибровки генератора и может инвертироваться для хорошо откалиброванных генераторов, граничный случай США ниже. И выборка нескольких поколений и измерение их семантического согласия обнаруживают конфабуляции, где однопроходная уверенность не может (Farquhar, Kossen, Kuhn, & Gal, 2024). Модель может измерить свои собственные сомнения, но не свои собственные слепые пятна, и уверенная, систематическая ошибка видна только извне. Но эта литература рассматривает разногласие как внутренний сигнал для разработчиков. Шаг, который я предлагаю, — рассматривать его как примитив доверия, обращённый к потребителю, выявляемый, записываемый и встроенный в утверждения об уверенности сервиса, в абляции этой работы, разделяющей то, что дебаты обнаруживают, от того, что верификация подтверждает, вместо того чтобы позволить одному выдавать себя за другое. Разграничение является как эмпирическим, так и концептуальным: при прямом бенчмаркинге многоагентные дебаты не надёжно превосходят более простые стратегии, такие как самопоследовательность и ансамблирование (Smit et al., 2024). Утверждение здесь касается сертификационного сигнала верификации, обращённого к потребителю, а не выигрыша в точности дебатов, и этот сигнал сохраняется даже где преимущество дебатов отсутствует.
В исследованиях многоагентного совещания аналогично системы, построенные для выявления согласий и разногласий, а не их усреднения, производят решения, оценённые как более репрезентативные (Liu et al., 2026). Механизм имеет прямую человеческую аналогию на стороне калибровки знаний: потребители, которые принимают значительные финансовые решения совместно, существенно менее чрезмерно уверены, чем лица, принимающие решения в одиночку, с общим метазнанием (партнёр, выявляющий то, что не знает лицо, принимающее решение) определённым как движущий механизм (Piehlmaier, 2023). Совместное суждение дисциплинирует уверенность у людей по той же причине, по которой предлагается кросс-модельное согласие дисциплинировать её здесь.
Могут ли потребители использовать такой сигнал — это реальный вопрос. Люди быстро отказываются от алгоритмов после того, как видят их ошибки (Dietvorst, Simmons, & Massey, 2015), но в других местах чрезмерно полагаются на алгоритмические советы (Logg, Minson, & Moore, 2019), раскол, который может сам зависеть от ставок. Эксперименты со вторым мнением с участием людей показывают, что сырой материал поведенчески активен: почти единодушное согласие, когда медицинский ИИ и врач согласны, резкие расколы, когда они расходятся (Detjen, Densky, von Kalckreuth, & Kopka, 2025; Chen, Sun, Liao, & Sundar, 2026), хотя ни одна из этих работ не варьирует разногласие совместно с доказательствами или нейтральностью. Поток исследований потребителей уточняет граничные условия (систематически: Burton, Stein, & Jensen, 2020). Неприятие интенсифицируется, когда потребители чувствуют, что их случай уникален (Longoni, Bonezzi, & Morewedge, 2019), варьируется с объективностью задачи (Castelo, Bos, & Lehmann, 2019), и отказы одного ИИ легко обобщаются на другие, алгоритмическая трансференция (Longoni, Cian, & Kyung, 2023). Если недоверие обобщается на все системы, то отказ с одной попытки из раздела 1 — это не потеря пользователей одного сервиса, а потеря пользователей всей категории, и перехват ошибок структурно защищает сам рынок. Выявленное разногласие находится на этой линии разлома, и P1–P2 ниже — это ставка на то, какой эффект доминирует, когда неопределённость предоставляется конкретно и без сглаживания.
Когда разнообразие не срабатывает: коррелированные ошибки. Ценность разнообразия полностью зависит от независимости сбоев, и независимость нельзя предполагать. Передовые модели обучаются на перекрывающихся корпусах, извлекают информацию друг из друга и явно разделяют уверенные заблуждения. Когда две передовые модели упускают один и тот же элемент теста, они согласны на один и тот же неправильный ответ примерно в 60% случаев, причем корреляция наиболее сильна между моделями одного разработчика или базовой архитектуры и, что самое тревожно, между наиболее точными моделями: по мере роста возможностей ошибки сходятся (Kim et al., 2025). Это открытие является прямым ограничением для компонента Diversity этой статьи, а не просто соседний результат. Независимость, которую предполагает Diversity, отчасти иллюзорна на передовом уровне, и поскольку корреляция усиливается ровно там, где возможности наивысшие, вклад компонента является убывающей, измеренной величиной, а не фиксированным активом. То, что добавляет панель, должно быть продемонстрировано вопрос за вопросом, и траектория развития модели идет против этого. При прогнозировании попарные корреляции ошибок между передовыми моделями в среднем составляют r ≈ 0,77 (Spiro, 2026), избыточность достаточно высока, чтобы свести на нет большую часть пользы от агрегирования, которую должно обеспечить разнообразное сообщество.
Структура рынка усугубляет проблему. К концу 2025 года 88% расходов предприятий на API LLM были сосредоточены у трех поставщиков с закрытыми весами: Anthropic с 40%, OpenAI с 27%, Google с 21% (Menlo Ventures, 2025b; Menlo является инвестором Anthropic). Панель, собранная случайно из «ведущих моделей», черпается из базы поставщиков из трех участников, чьи ошибки — это именно те, которые измеряются как сходящиеся, та самая тройка, которую эксперимент ниже воспроизводит как свою панель на передовом уровне США. Когда три модели сходятся на одну и ту же модную ошибку, архитектура не просто не ловит ее; она это подтверждает. В однородных группах добавление агентов стабилизирует ошибочную траекторию, а не исправляет ее, конечную точку, которую литература по многоагентным системам называет парадоксом консенсуса (Shehata & Li, 2026). Корреляция, таким образом, — это режим отказа, который архитектура должна быть разработана для обнаружения (Рисунок 6).
Рисунок 6. Иллюзия разнообразия
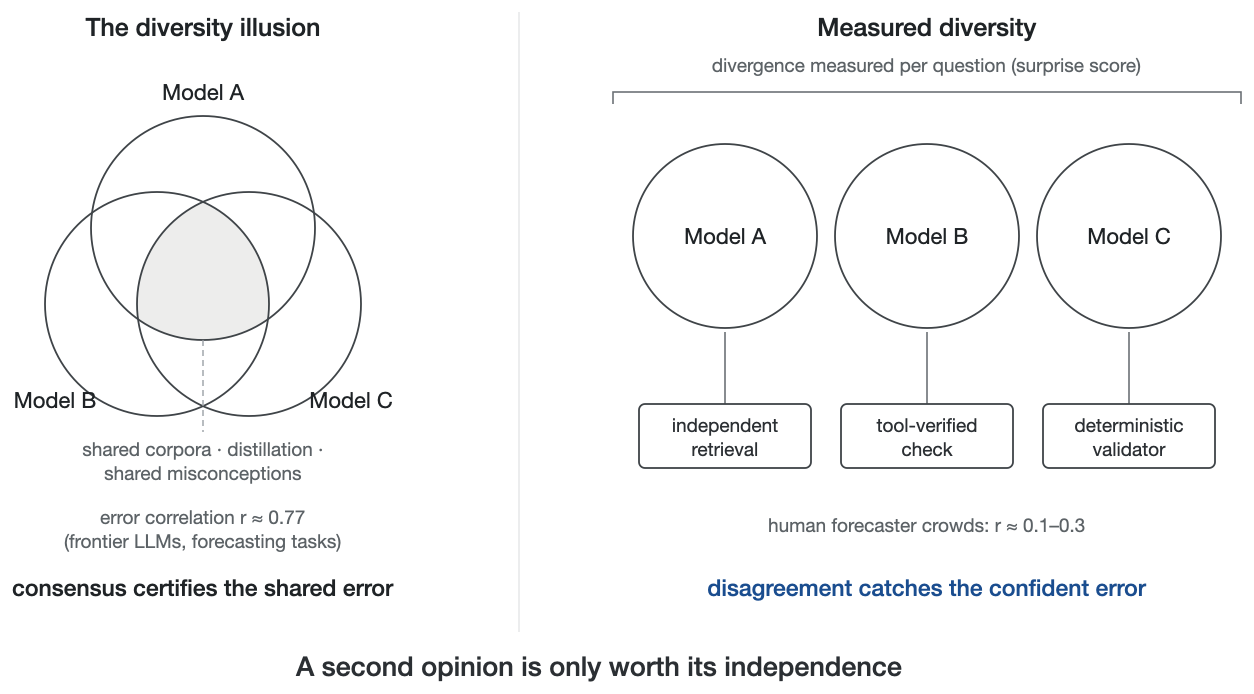
Консенсус среди почти идентичных копий в сравнении с панелью, чья независимость измеряется.
У этого есть интерактивный аналог: градиент подхалимства работает между моделями также. Исследования многоагентных систем находят измеримую групповую конформность в обсуждении LLM, причем более слабые модели подчиняются сильнее всего (Choi, Kim, Chae, & Baek, 2025); агенты взвешивают позицию в зависимости от того, чья она (Choi, Zhu, & Li, 2026); и большая часть того, что выглядит как сходимость, разлагается на социальное соответствие, а не на рассуждение (Hao et al., 2026). При совместном обсуждении согласие — это низкоэнергетическое состояние, поэтому панель, которая обсуждает перед фиксацией позиций, может убедить себя в консенсусе, а не в истине. Архитектурный противовес процедурный: мнения собираются вслепую и независимо сначала, а только потом сравниваются (Рисунок 7).
Рисунок 7. Слепой-независимый-сначала
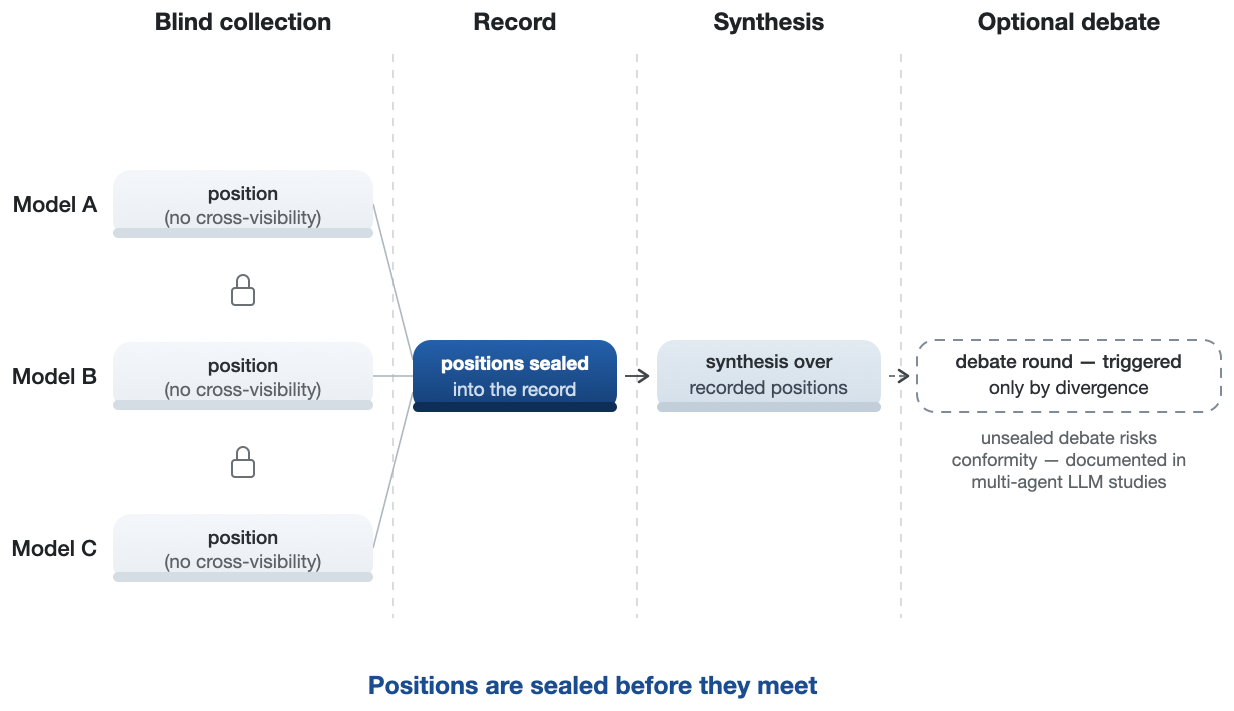
Позиции записываются, а только потом сравниваются — процедура, которая защищает от несогласия, которое конформность стерла бы.
Эксперимент, описанный ниже, придал численное выражение тому, от чего защищает эта процедура. В спаренном исследовательском варианте верификаторам, которые вслепую произвели другой ответ, затем показали уверенный неправильный ответ основной модели и спросили, согласны ли они. 38,5% (168 из 436 расходящихся пар; 95% ДИ 33,6–43,2, бутстреп, сгруппированный по вопросам) отказались от собственного расходящегося ответа и одобрили ошибку, при этом конформность на уровне поставщика варьировалась от 20% до 58%. Отказ разделяется в зависимости от того, от чего отказались, что отделяет конформность от рациональной дефиренции. Среди верификаторов, чей слепой ответ был сам по себе правильным, 29,1% (41/141) все еще сдались и приняли уверенный неправильный ответ, вредный факт, который никакое байесовское рассуждение не оправдывает, в сравнении с 43,1% (127/295) среди неправильных слепых ответов, где некоторая дефиренция оправдана. (Интервал, сгруппированный по вопросам, почти идентичен наивному парному интервалу. 436 пар распределены по 247 различным вопросам, в основном по одной или две пары на вопрос и никогда не более четырех, поэтому переиндексирование на уровне вопросов добавляет почти нулевую внутригрупповую ковариацию.) С учетом зеркального контроля ниже, примерно 35–39% слепых диссидентов меняют позицию при показывании уверенного ответа, какова бы ни была его истинность, с умеренным, но значительным чистым перекосом в сторону предложенного ответа (чистая конформность ≈ 4 процентных пункта; дискордантные пары 104 против 70 ≈ 1,49). Если бы панель обсуждала перед фиксацией позиций, большая часть этих несогласий была бы переоговорена до того, как их можно было бы записать. Но поскольку 34,7% переворотов зеркального варианта идут в сторону истины, обсуждение также преобразовало бы некоторое несогласие в правильный консенсус, поэтому то, что защищает слепой-первый подход, — это само измерение, а не подсчет потерянных несогласий. Слепой-первый подход — это разница между измерением несогласия и производством консенсуса, то же правило, которое нужно было человеческим группам: социальное влияние разрушает разнообразие независимых оценок, не улучшая их точность (Lorenz, Rauhut, Schweitzer, & Helbing, 2011), и даже одно произвольное раннее одобрение заметно смещает последующие суждения (Muchnik, Aral, & Taylor, 2013).
Контроль с обратным запросом предоставляет альтернативное объяснение того, что эти перевороты отражают рациональное обновление убеждений, а не конформность. Я повторил спаренную процедуру на местной панели из шести моделей, показывая верификаторам, которые вслепую не согласились, либо уверенный неправильный ответ (прямой вариант), либо правильный ответ (обратный вариант) для одного и того же набора вопросов. Доля переворотов была почти симметричной, 38,9% в сторону неправильного ответа против 34,7% в сторону правильного, и в сравнении внутри пар верификаторы значительно чаще отказывались от своей слепой позиции в пользу неправильного ответа, чем за правильный (104 против 70 дискордантных пар; McNemar p = .010). Рациональное обновление предсказывает противоположную асимметрию. Склонности к переворотам на уровне модели были практически идентичны в обоих вариантах на обоих концах спектра соответствия (количество пар на уровне модели невелико и не имеет отдельной мощности; они указаны описательно со своими n в пакете репликации), что указывает на то, что согласие вызывается наличием уверенно предложенного ответа, а не его истинностью. Этот контроль был проведен на местном уровне. Оценка на передовом уровне (38,5%) основана на той же процедуре, но не была протестирована зеркально с верификаторами на передовом уровне.
Слепой отбор не может закрыть один канал: он противостоит социальной конформности, но не априорной конформности. Модели сходятся, потому что общие данные обучения дают им одни и те же априоры, и близнецы дают одинаковые ответы, никогда не совещаясь. Я называю это конвергенцией подобных: группа согласна, потому что её члены похожи, а не потому что они правы.
Коррелирующие априоры всё ещё должны быть измерены. Кросс-модельные оценки удивления предоставляют текущую оценку фактической независимости группы, вопрос за вопросом, и они не требуют разметки, поэтому независимость в принципе можно оценить во время вывода без эталонных ответов. Оценивание во время работы здесь не проверяется. Разнообразие также должно выходить за пределы весов модели, так как независимые пути поиска, проверки, подтверждённые инструментами, и детерминированные валидаторы разрывают канал корреляции, создаваемый совместным обучением. Необходимость будет расти, а не сокращаться, потому что дистилляция и синтетическое обучение со временем омогенизируют веса моделей, поэтому можно ожидать снижения измеренного разнообразия, а бремя верификации должно сместиться на верификаторы вне модели. И что измеряется, должно быть раскрыто: запись должна содержать не просто «N моделей согласились», но и предполагаемое разнообразие группы по этому классу вопросов. Консенсус среди практически идентичных моделей заслуживает более слабого утверждения доверия, и запись должна указать, какой ответ получил потребитель.
Доказательства. Каждый значимый ответ содержит запись: какие модели были проконсультированы, в чём они согласились и в чём расходились, что было проверено, на чём основан синтез. Это требование благоприятно по времени, потому что когда агенты основывают ответы на информационный поиск и инструменты, фактическая основа уже существует вне модели, поэтому её запись становится побочным продуктом создания ответа. Поскольку запись защищена от подделки, историю решений сервиса может воспроизвести потребитель при возникновении спора, аудитор, страховщик, определяющий ответственность. Доверие перестаёт быть ощущением по отношению к бренду и становится проверяемым свойством истории.
Два механизма расширяют доказательства от ответов к действиям. При теневом выполнении действие с внешними эффектами репетируется в записанном холостом прогоне, поэтому утверждение «агент проверил перед действием» становится проверяемым фактом вместо слогана. Временная согласованность переформулирует рекомендацию в разных сеансах или формулировках и записывает её устойчивость, поэтому ответ, который меняется при повторном вопросе, помечается флагом до того, как на него полагается кто-либо. На уровне идентичности слой записи расширяется в портативный паспорт происхождения для самого агента: какие модели, версии и политики действовали, когда, по чьему полномочию. Это артефакт, который схемы регистрации «знай-своего-агента» и обязательства по страхованию ошибок агента молча предполагают. Представление этой записи, ориентированное на потребителя, — это квитанция оркестрации на Рисунке 8: одно действие, одна запись, четыре аудитории (потребитель, страховщик, аудитор, регулятор).
Рисунок 8. Квитанция оркестрации, применяется дважды (макет)
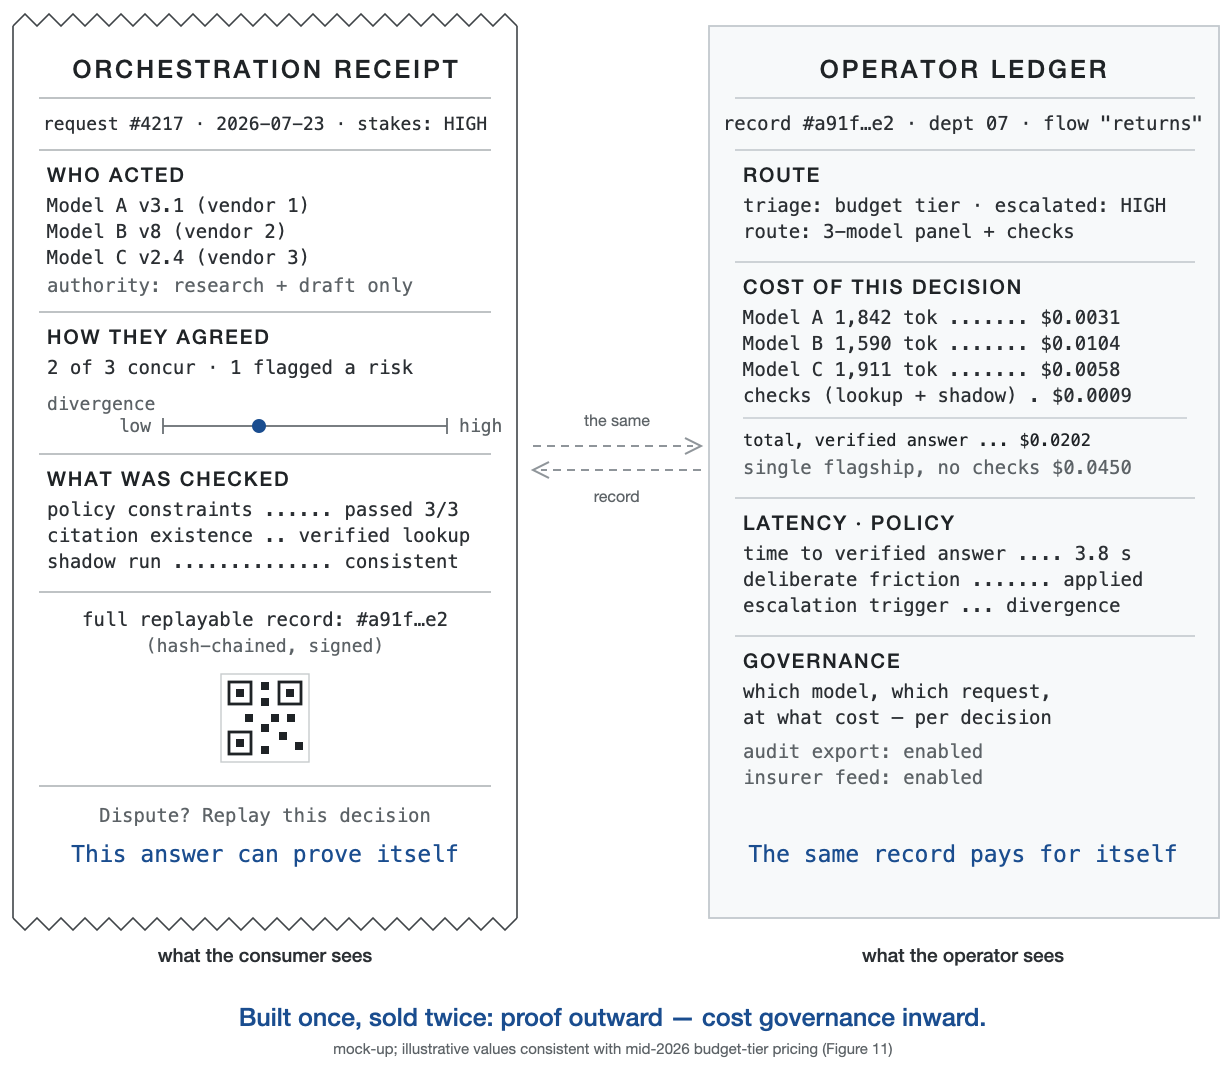
Потребитель видит доказательство — кто действовал, как они согласились, что было проверено; оператор видит ту же запись как инструмент контроля затрат. При возникновении спора квитанция превращает слово-против-слова в запись-против-слов.
Нейтральность. Нейтральность — это проверяемая независимость стимулов: отсутствие скрытой экономической зависимости от какого-либо конкретного поставщика, торговца или результата решения. Слой оркестрации направляет к тем моделям, которые лучше всего выполняют задачу, и не заинтересован в том, какая выигрывает, что структурно аналогично независимым клиринговым слоям в платежах. Арбитр между поставщиками может быть доверен так, как ни один поставщик не может быть доверен сам себе. Независимость называет экономическое свойство, а проверяемость связывает его со слоем доказательств, который делает утверждение проверяемым, а не просто заявленным, — дисциплина, развиваемая клиринговыми домами ниже. (Нейтральность здесь — экономическое свойство, а не алгоритмическая справедливость среди демографических групп, что является ортогональным требованием.)
Есть и проблема вертикальной интеграции: нейтральность структурно недоступна платформам, лучше всего позиционированным для масштабного построения оркестрации. Компания, выступающая одновременно торговой площадкой, поставщиком модели, рекламной сетью и поставщиком логистики, не может быть нейтральным арбитром, потому что каждое решение о маршрутизации для неё одновременно решение о собственном доходе. Логика указывает на структурную тенденцию. Этот подход предполагает, что слой доверия лучше всего размещается у сторон, чей единственный бизнес — это сам арбитраж, путь, которым клиринг, аудит и кредитные рейтинги стали независимыми отраслями. История рейтинговых агентств служит классическим предупреждением о том, что независимые посредники развивают собственные конфликты типа «платит эмитент». Экономика хорошо задокументирована: посредники по сертификации захватывают ценность, контролируя, какая информация раскрывается (Lizzeri, 1999), рынки сертификации дают сбой хорошо известными способами (Dranove & Jin, 2010), и крах системы кредитных рейтингов демонстрировал классический случай отказа, когда финансирование рейтингового агентства эмитентами скомпрометировало его, в то время как слои клиринга, которые пережили кризис, финансируются взаимными затратами, а не оцениваемыми сторонами. Требование нейтральности поэтому распространяется на собственную модель доходов оркестратора: слой верификации, оплачиваемый поставщиками или торговцами, которых он ранжирует, воспроизводит конфликт интересов, который он должен был устранить; именно поэтому структура доходов здесь ориентирована на потребителя и на управление затратами оператора (Раздел 5), а не на ранжируемые стороны.
Нейтральность также охватывает аспект данных. Слой оркестрации может функционировать как чистая комната: запросы доходят до каждого поставщика очищенными от идентификации пользователя, ни один поставщик не видит всю историю взаимодействия, и доход оркестратора поступает от сервиса, а не от передачи слов пользователей в рекламные сети. Нейтральность — это независимость стимулов на обоих фронтах: отсутствие скрытой экономической зависимости от какого-либо поставщика модели или торговца, и отсутствие бизнес-модели, которая монетизирует слова потребителя в ущерб потребителю.
Но нейтралитет порождает собственный регресс: кто контролирует оркестратора? Буквальное «отсутствие заинтересованности» невозможно. Любой оркестратор имеет расходы, партнёрства, стимулы к удержанию клиентов и собственное выживание, которое нужно финансировать, так что определяющей переменной является не их отсутствие, а их природа, раскрытие и проверяемость на основе записей. От того, кто платит, нейтралитет не зависит; от того, зависит ли доход плательщика от результата сделки, — зависит. Подписка потребителя или сбор от страховщика или аудитора, чей пayout не зависит от того, какой продукт победит, удовлетворяют условию; комиссия торговца или рекламный сбор — нет. Более широкое управление вопросом о том, кто финансирует слой, остаётся открытым, а проверяемая независимость такого финансирования — это то, что закрепляет конструкция. У уровня оркестрации есть и свои стимулы: маршрутизировать к дешёвым моделям, перепродавать свой дорогой уровень, удобно формировать синтез. Этот регресс существует четыре десятилетия. Shapiro (1987) назвал это проблемой стражей: процедурные гарантии порождают новых стражей, которых самих нужно охранять, и ответ на уровне институтов не изменился.
Клиринговые палаты завоёвывают доверие, будучи внешне проверяемыми и регулируемыми, а не объявляя о нейтралитете. Оркестратор не обладает нейтралитетом как добродетелью. Уровень доказательств — это то, что делает это проверяемым. Каждое решение маршрутизации, ответ модели и шаг синтеза попадают в защищённую от подделок запись, хеш-цепную подписанную логарифм, предназначенную для внешней привязки временной метки, так что заявленный нейтралитет оркестратора подвергается в точности той же проверке, которую он налагает на модели. Путь зрелости — сценарий клиринговой палаты, воплощённый в практику: внешняя привязка временной метки, открытый интерфейс проверки и периодический аудит третьей стороной политики маршрутизации. Институциональное проектирование таких экосистем аудита уже является названной исследовательской программой (Raji, Xu, Honigsberg, & Ho, 2022). Одна зависимость сохраняется даже при аудите аудиторов: модели панели могут быть независимы друг от друга, но все отобраны проверяемой платформой, и поэтому конечная точка пути зрелости — отбор и ротация панели, находящиеся вне контроля какой-либо одной стороны. Оркестратор, чьи записи нельзя проверить, — просто ещё один поставщик, просящий поверить ему. Ближайшие соседи вне исследования потребителей — две одновременные работы 2026 года. Marchal et al. (2026) обосновывают тот же сдвиг в оценке: от суждения о результатах к проектированию надёжности, происхождения и фальсифицируемости агентов на уровне эпистемической инфраструктуры, а Wang et al. (2026) рассматривают провенанс исполнения как уровень подотчётности на уровне процесса для проверки, аудита и атрибуции отказов. Собственное содержание этого документа — потребительское, осведомлённое о стимулах составление: три свойства, связанные как объект обоснованного доверия потребителя в делегированной торговле, и его поведенческий тест.
Компонент доказательств несёт одно разграничение, потому что защищённость от подделок легко переоценивается: хеш-цепная логарифм устанавливает провенанс и целостность (что эта запись существовала и позже не была изменена), но не полноту (ничто в хеше не гарантирует, что опущенные вызовы не были подавлены), не правильность (верная запись неправильного ответа всё ещё неправильна), не независимость и не выравнивание стимулов. Каждое — отдельное свойство с собственным механизмом проверки: аттестация охвата, аудит результатов, измеренное многообразие, раскрытые экономические данные. Квитанция должна претендовать только на те свойства, которые её запись действительно несёт. Дальнейшее ограничение структурное: логарифм доказывает что было маршрутизировано, но не почему, и собственная эвристика выбора этой модели или этого торговца проверяется только если сама политика маршрутизации раскрыта или заверена, — это выбор управления, а не криптографическое следствие. Затраты архитектуры принадлежат той же книге: маршрутизация запроса к нескольким поставщикам умножает воздействие на конфиденциальность, централизованная логарифм решений — привлекательная цель безопасности, а дисплей консенсуса может производить в точности ту авторитарность, против которой предупреждает результат консенсуса-ошибки.
Конструкцию также стоит разграничить от её инженерных соседей, потому что «использовать несколько моделей» описывает несколько разных вещей с разными свойствами доверия. Простое голосование ансамбля улучшает точность, но невидимо разрешает разногласие, так что ничто не становится проверяемым. Выборка самосогласованности переспрашивает ту же модель, что является разнообразием только по виду. Смесь экспертов маршрутизирует внутри единственной обученной системы, чей маршрутизатор оптимизирован для способности, а не нейтралитета. Многоагентный дебат (Du et al., 2024) улучшает ответы, но трактует совещание как внутреннее оборудование: никакой записи потребителю, никакой экономики, никакой гарантии нейтралитета.
Агрегаторы маршрутизации моделей, к 2026 году уже товарный слой, многовендорны по каталогу, но одномодельны на ответ: маршрутизатор выбирает одну модель по стоимости и задержке, и второе мнение никогда не собирается. Агрегаторы — поставщики для архитектуры проверки, а не её заменители.
Многомодельная работа больше не экзотична: 37% предприятий запускали пять или более моделей в production к середине 2025 года, против 29% годом ранее (a16z, 2025). Инфраструктура укладывается в масштабах индустрии, при этом слой доверия заметно отсутствует. Остаётся открытым, остаётся ли многомодельность невидимой маршрутизацией затрат или становится проверяемой архитектурой. На рисунке 9 представлены оценки паттернов по пяти свойствам доверия, а в таблице 3 разграничение изложено в прозе. Архитектурное доверие определяется в точности тем, чего не хватает в остальных: разнородных источников, выявленного и записанного разногласия и третейского судьи без заинтересованности. Инженерная часть общая; свойства доверия — нет.
Рисунок 9. Разграничение
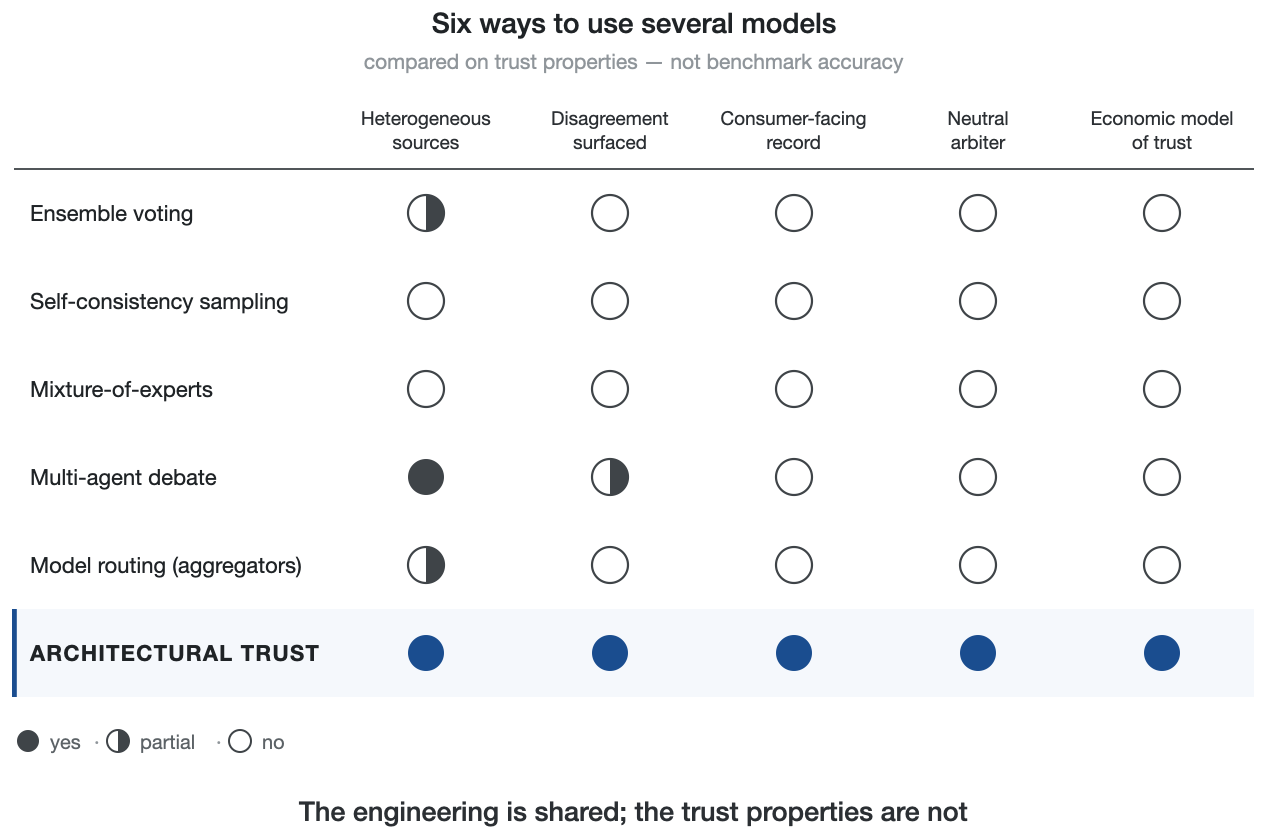
Шесть многомодельных инженерных паттернов, оценённые по пяти свойствам доверия.
Таблица 3. Разграничение: архитектурное доверие и его инженерные соседи
| Подход | Разнородные источники | Разногласие выявлено | Запись потребителю | Третейский судья, независимый от стимулов | Экономическая модель доверия |
| Голосование ансамбля | Частично | Нет (разрешено невидимо) | Нет | Нет | Нет |
| Выборка самосогласованности | Нет (та же модель переопробована) | Нет | Нет | Нет | Нет |
| Смесь экспертов | Нет (одна обученная система) | Нет | Нет | Нет (маршрутизатор оптимизирован по способности) | Нет |
| Дебаты мультиагентов | Да | Только внутренне | Нет | Нет | Нет |
| Объяснимость (наложение XAI) | Нет (повествование одной модели) | Нет | Нет (история, а не запись) | Нет | Нет |
| Прозрачность / раскрытие информации | Нет | Нет | Частично (более видимо, но не проверяемо) | Нет | Нет |
| Происхождение / отслеживание родословной (конвейеры ML) | Нет (один конвейер задокументирован) | Нет | Частично (родословная, видимая для инженеров) | Нет | Нет |
| Проверенный вывод (zkML) | Нет (одна модель; доказательство её выполнения) | Нет | Частично (артефакт доказательства, а не запись решения) | Нет | Нет |
| Агрегатор маршрутизации моделей | Частично (многопоставщический каталог, одна модель на ответ) | Нет | Нет | Нет (маршрутизатор оптимизирован по стоимости) | Нет |
| Архитектурное доверие | Да | Да (ориентировано на потребителя) | Да (воспроизводимо) | Да (структурное) | Да (постепенные уровни) |
Две дополнительные фундаментальные литературы также принадлежат этому же списку: логика воздержания-или-выдачи шлюза — это избирательное предсказание и обучение отказу (Geifman & El-Yaniv, 2017; Mozannar & Sontag, 2020), а след аудита компонента доказательства восходит к работам подотчётных алгоритмов и сторонних аудитов (Kroll et al., 2017; Raji et al., 2022). Архитектурное доверие — это ориентированное на потребителя, ограниченное нейтральностью соединение этих элементов, а не какой-либо один из них. Его расположение среди других решений имеет значение, потому что они являются дополнениями, а не конкурентами. Калибровка на уровне модели необходима, но структурно недостаточна: поставщик производит и подтверждает её, что является конфликтом, с которого начинается данная работа. Внешние аудиты и сертификация независимы, но периодичны — это снимки системы, а не решения. Объяснение — это повествование, произведённое внутри модели, и система, которая может конфабулировать ответы, может конфабулировать и историю за ними. Прозрачность раскрывает больше механизмов и оставляет потребителю их интерпретировать. Архитектурное доверие не требует ни веры, ни интерпретации, только проверяемости, которая непрерывна, осуществляется для каждого решения и машинно-проверяема. Это также то, что делает другие решения действенными: аудит оркестратора с воспроизводимой записью — это аудит чего-то, а аудит непрозрачного конвейера — это театр. Его ближайшие концептуальные соседи — структурная гарантия и доверие на основе институтов (McKnight et al., 2002), процессная прозрачность и объяснимость. Отличающее их свойство заключается в том, что основание проверяемо доверяющей стороной, для каждого решения: гарантия просит веры один раз, архитектурное доверие просит проверки каждый раз. Два дополнительных набора соседей должны быть отмечены на карте. Литература по компьютерной подотчётности заложила технические основы десять лет назад: процедурная регулярность, сделанная проверяемой без полной прозрачности (Kroll et al., 2017). Волна инженерии 2025–26 строит инфраструктуру доверия агентов прямо: протоколы "trust-native" с проверяемой идентичностью и устойчивыми к подделке записями поведения (TrustTrack; Li, 2025); управление действиями во время выполнения с квитанциями, явно показывающими подделку (AARM; Errico, 2026); агрегация нескольких LLM переформатирована как оценка доверия (Zheng & Zhang, 2026, arXiv:2607.20529); и корпоративные платформы (AI TRiSM Gartner; работа Cloud Security Alliance по нулевому доверию для агентов). Каждая предоставляет компоненту на уровне предприятия. Ни одна из них не предоставляет конструкт, ориентированный на потребителя, что является вкладом этой работы: три компонента под одним названием, совместно регулируемые в поведенческих проектах, с экономикой того, кто обеспечивает проверяемость и какие последствия это имеет. Следует уточнить одно совпадение названий. "AI Trust Architecture" DigiCert (запущена в апреле 2026) — это линия продуктов PKI поставщика, инфраструктура сертификатов для идентичности агентов, происхождения моделей и аутентификации содержания. Она предоставляет инфраструктуру на уровне идентичности стека доказательств, а не конструкт архитектурного доверия, разработанный здесь.
Взаимосвязь между этими тремя компонентами является явной эмпирической гипотезой, а не концептуальной необходимостью. Я выдвигаю гипотезу о дополняющем взаимодействии, которое стремится к нулю при отсутствии любого компонента, неформально AT = f(D, E, N) с крутым снижением вблизи любого нуля, и совместный дизайн Раздела 5 задан для восстановления функциональной формы, а не для её предположения. В оцениваемой форме удобное семейство — Cobb–Douglas, AT = A·Dα·Eβ·N^γ с α, β, γ > 0, кодирующие два обязательства: снижение к нулю вблизи любого отсутствия и положительные смешанные частные производные (компоненты являются дополняющими). Конструкция состоит из трёх компонентов и их гипотетической дополняемости, и никакое утверждение ниже не зависит от формы Cobb–Douglas. Cobb–Douglas также является внутренней аппроксимацией: строго говоря, она всё ещё допускает замену вместо слабого компонента, тогда как гипотеза дополняемости подобна Leontief на границах, где min(D, E, N) устанавливает минимум. Именно поэтому приведённые ниже дизайны должны допускать некомпенсирующую структуру, а не предполагать компенсирующие компромиссы. Семейство Cobb–Douglas является иллюстративным для будущего оценивания и не является частью определения конструкции; текущие данные его не оценивают. Факториальный дизайн может различать внутреннее пространство Cobb–Douglas от пола Leontief, параметр за параметром. Показатели степени остаются эмпирическим вопросом, что и является сутью: дополняемость опровергаема. Нули требуют двух уточнений. Компоненты непрерывны, а не бинарны, поэтому буквальный нуль — идеализированный предел. Ни одна развёрнутая система, включая данную статью, не находится ровно на нуле или на единице по любой оси, и вопрос о том, ответят ли потребители на почти отсутствие полным коллапсом или крутым дисконтом — это то, что дизайн должен различить. Разнообразие, в свою очередь, означает независимость пути проверки, с измеренной независимостью (коэффициент корреляции ошибок φ, определённый ниже) в качестве её единицы. Статистическое ядро — классическая теория ансамблей, где выгода комбинирования зависит от декоррелирования ошибок (Hansen & Salamon, 1990; Krogh & Vedelsby, 1995), поэтому независимость здесь измеряется, а не предполагается. Вторая модель — один такой путь, но ими являются также независимый поиск, проверенное инструментом уточнение и детерминированный валидатор. Теневые запуски и проверки согласованности Рисунка 5 считаются вторым, максимально декоррелированным путём проверки, а не доказательством без разнообразия. Это определение также охватывает самые явные кажущиеся контрпримеры, регулируемый платёжный канал или полностью логированный, удостоверенный третьей стороной сервис коммунальных услуг (доказательство и нейтральность сильны, разнообразие моделей отсутствует): такие сервисы либо встраивают пути проверки, не являющиеся моделями (детерминированное согласование, внешний аудит, поэтому D > 0 по определению), либо ограничивают модель ролью, которую детерминированная проверка полностью покрывает. Там, где действительно не существует независимого пути проверки для класса задач, фреймворк предсказывает слабое обоснование, предсказание, которое совместный дизайн может проверить. Со счётом путей, не являющихся моделями, в D буквальный нуль становится редким в производственных системах, и эмпирическое содержание мультипликативной формы смещается от нулей к внутренней дополняемости, поэтому факториальный дизайн, а не нули — это то, где претензия стоит или падает. Для тестирования одно операционное обязательство здесь закреплено: факториальный дизайн манипулирует D узко, как разнообразием пути модели. Более широкое определение пути проверки — это область конструкции, а не манипулируемая переменная. Независимость сама по себе должна быть дезагрегирована, потому что шесть различных величин путешествуют под этим словом: слепой сбор (процедурная независимость во время вывода, что гарантирует этот дизайн), разнообразие семейства моделей, измеренная остаточная корреляция ошибок (φ, которую сообщает эта статья), разнообразие источников доказательств, разнообразие путей инструментов и институциональная независимость. Исследование устанавливает первую и измеряет третью; остальные являются переменными дизайна, а не свойства, которые эта коллекция может удостоверить. Разнообразие без доказательства — невидимый комитет. Доказательство без нейтральности — маркетинг продавца. Нейтральность без разнообразия — пустой брокер. Таблица 4 проходит по полной решётке восьми конфигураций наличия/отсутствия. Интуиция, лежащая в основе, состоит в том, что каждый компонент предоставляет обоснование для другого: запись, хранимая стороной, заинтересованной в её содержании, читается как самоудостоверение, согласие, которое никто не записал, — это слухи, и заинтересованно-независимый арбитр над одним голосом не имеет ничего арбитражного. Это мотивирует гипотезу дополняемости. Вместе эти три изменяют то, чему доверяет потребитель: не «этому ответу» или «этому бренду», а «этому процессу, и я мог бы это проверить».
Таблица 4. Решётка обоснования: восемь конфигураций D–E–N и что в каждой сохраняется
| D | E | N | Что может проверить потребитель | Вырожденная форма |
| отсутствует | отсутствует | отсутствует | Ничто; доверие — это вера в результаты | Голый одномодельный ассистент |
| присутствует | отсутствует | отсутствует | Ничто после факта; разногласие произошло невидимо | Невидимый комитет (внутренний ансамбль) |
| отсутствует | присутствует | отсутствует | Запись, хранимая стороной, которую она защищает | Журнал поставщика / самоудостоверение |
| отсутствует | отсутствует | присутствует | Претензия без заинтересованности и без следа позади | Пустой брокер |
| присутствует | присутствует | отсутствует | Записанное разногласие, отобранное заинтересованной стороной | Управляемый поставщиком театр бенчмарков |
| присутствует | отсутствует | присутствует | Нейтральный арбитраж проверок, которые никто не может воспроизвести | Панель из уст в уста |
| отсутствует | присутствует | присутствует | Нейтральная, воспроизводимая запись одного неоспоренного голоса | Удостоверенный монолог (аудит без оспаривания) |
| присутствует | присутствует | присутствует | Независимая проверка, воспроизводимая, проводимая стороной без доли | Архитектурное доверие |
Ячейки указаны в идеализированных пределах; развёрнутые системы занимают внутреннее пространство. Строка E+N-без-D — это институционально знакомая — клиринг, аудит и рейтинги там работают — и это то место, где требование фреймворка для добавленного независимого пути проверки является эмпирическим предсказанием, а не дефиниционным исключением.
Три компонента соответствуют классической анатомии надёжности (Mayer, Davis, & Schoorman, 1995): разнообразие — механизм способности (согласование между моделями калибрует объём компетентности, которую следует выводить), доказательства операционализируют честность (утверждения о том, что сделал сервис, становятся проверяемыми, а не декларируемыми), а нейтральность структурно решает вопрос о благожелательности (стимулы оркестратора без заинтересованности поддаются проверке, а не вере). Каждое из них переосмысляется в терминах проверяемой архитектуры вместо управления впечатлениями, что является тем, о чём просит литература по взаимодействию человека и ИИ, когда подходит к этой точке со своей стороны: привести суждения о доверии в соответствие с проверяемыми сигналами надёжности, а не впечатлениями, которые производит интерфейс (Liao & Sundar, 2022).
Причинно-следственная цепь проходит через верификацию, потому что «доверие» — это следствие, а не механизм: верификация → откалиброванная уверенность → обоснованное доверие → делегирование → стоимость сделки (Figure 10). Сервис зарабатывает делегирование тем, что он поддаётся проверке в момент, когда это важно, а не тем, что производит впечатление надёжности; Cheng et al. показали, как дёшево производится это впечатление.
Figure 10. Маховик верификации
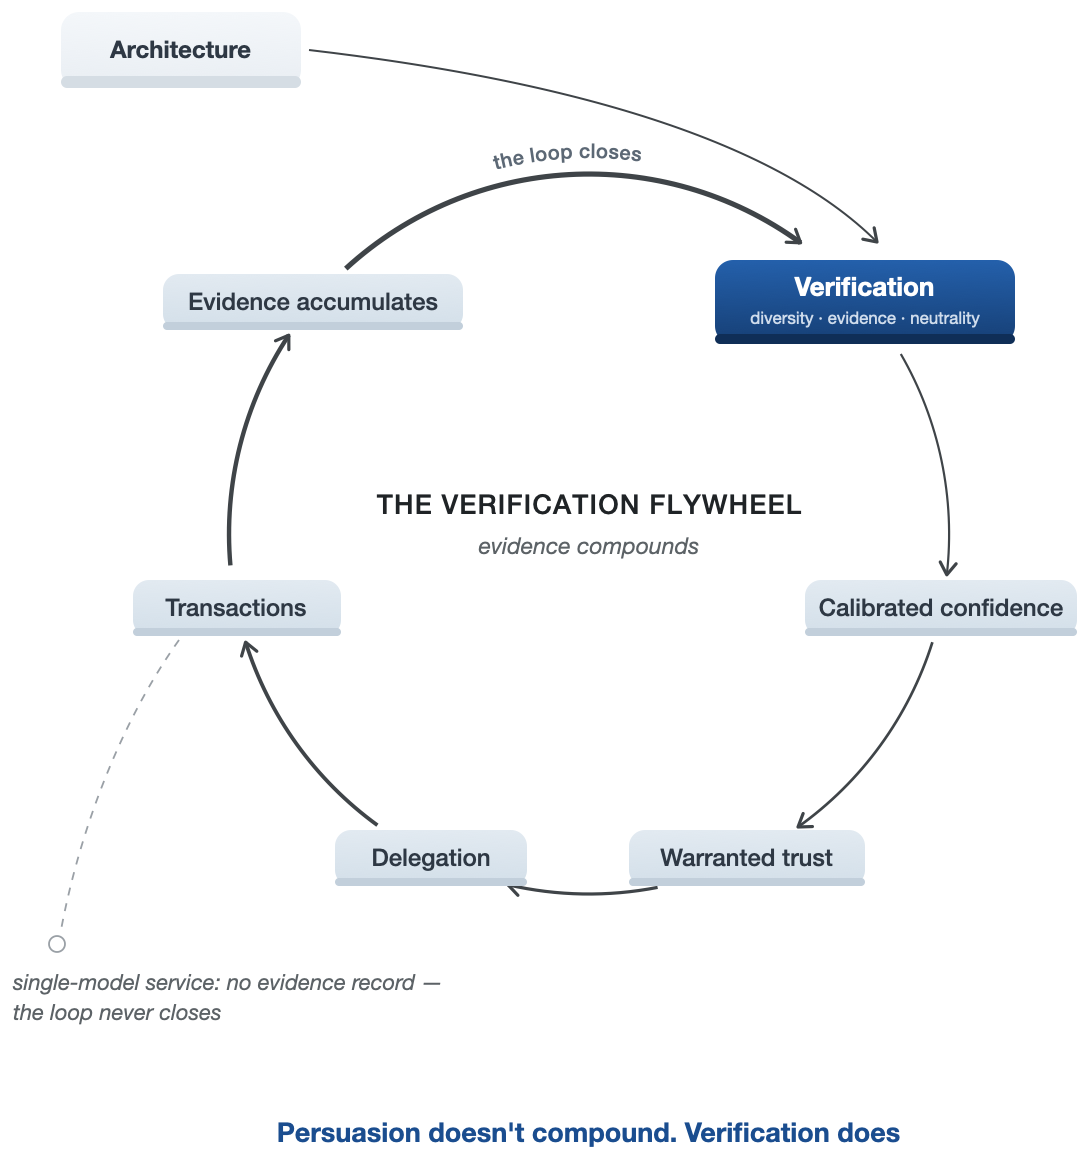
Причинно-следственная цепь, верификация (разнообразие · доказательства · нейтральность) → откалиброванная уверенность → обоснованное доверие → делегирование → сделки, не заканчивается: сделки порождают доказательства, и цикл замыкается назад в архитектуру. Пунктирный ответвитель показывает однозвенный сервис, где не существует записи доказательств и цикл никогда не замыкается. Убеждение не накапливается. Верификация накапливается.
Table 5. Однозвенный сервис против архитектурного доверия
| Измерение | Однозвенный сервис | Архитектурно надёжный сервис |
| Объект доверия | Модель / бренд | Процесс и его запись |
| Уверенность | Утверждается моделью | Заработана посредством согласования между моделями |
| Уверенные ошибки | Необнаружимые изнутри | Основная цель обнаружения (сигнал несогласия) |
| Лесть | Награждается предпочтением | Разделено: сочувствие и проверка политики на разных каналах |
| Проверка ошибок | Та же система, которая ошиблась | Независимые модели + детерминированные затворы |
| Доказательства решений | Журналы, если они есть, в руках поставщика | Защищённые от подделок, воспроизводимые, доступные потребителю |
| Судья качества | Сам поставщик | Нейтральный слой оркестрации |
| Позиция в споре | Слово потребителя против платформы | Воспроизводимая запись |
| Страхуемость | Непрозрачный риск | Поддающееся оценке из истории решений |
| Распределение ответственности (post–AB 316) | «ИИ это сделал» запрещено; распределение оспаривается в неведении | Вычислимо из воспроизводимой записи |
| Нормативная позиция (Art. 50 era) | Ретроспективные раскрытия | Прозрачность как побочный продукт операции |
| Обещания трансграничных данных | Договорное представительство | Проверяемое свойство во время выполнения (маршрутизация с учётом юрисдикции) |
| Структура затрат | Плоская, дешёвая | Дифференцированная: дорогая только там, где концентрируются последствия |
От проверяемости к ответу потребителя. Потребитель видит отрисовку, а не архитектуру: квитанцию, показывающую, какие независимые системы были проконсультированы, где они разошлись и как это разногласие было разрешено или эскалировано (Figure 8). Три опосредующих восприятия правдоподобно несут эффект. Доказательство диагностично: выявленное, конкретное несогласие информативно об этом ответе способом, которым общие дисклеймеры не являются (Detjen et al., 2025; Chen et al., 2026). Воспроизводимая запись даёт воспринимаемый контроль процесса, так как потребитель мог бы проверить, оспорить или эскалировать после факта. Процедурная уверенность — это знание о том, что были на месте слепой сбор, независимые проверки и нейтральный арбитр без заинтересованности (McKnight et al., 2002). Естественные зависимые переменные — это калибровка опоры, готовность делегировать и удержание после отказа. Естественные модераторы — это ставки и обратимость, объективность задачи (Castelo et al., 2019) и опыт потребителя, так как потребитель, наименее способный проверить ответ лично, имеет наибольший выигрыш от архитектуры, которая проверяет его структурно. Следующие ниже предложения прослеживают этот путь.
Фреймворк, помимо прочего, выдаёт предложения, которые может протестировать исследование потребителей, гипотезы, а не выводы. Их операционализация опирается на одно различие: объективная нейтральность (оркестратор в действительности свободен от недораскрытой экономической зависимости от любого поставщика, торговца или результата), проверяемая нейтральность (запись делает эту независимость проверяемой), и воспринимаемая нейтральность (потребитель верит в это) — это три переменные, и эксперимент манипулирует проверяемым сигналом, измеряя восприятие:
P1. Раскрытие расхождений между моделями при важных запросах улучшает калибровку доверия потребителей (они больше опираются, когда системы согласны, и меньше, когда расходятся) по сравнению с единственным уверенным ответом, при этом воспринимаемый риск выступает опосредующей переменной (Featherman & Pavlou, 2003). Оба направления отказа действительны: совместное представление снижает чрезмерное доверие, но может увеличить недостаточное (Lu, Wang, & Yin, 2024), показатели уверенности калибруют доверие лучше, чем показатели точности (Zhang, Liao, & Bellamy, 2020), объяснения могут повысить доверие без повышения критичности (Bansal et al., 2021), когнитивные принуждающие функции снижают чрезмерное доверие ценой удовлетворенности (Buçinca, Malaya, & Gajos, 2021), а мета-анализ 106 экспериментов выявил, что комбинации человека и ИИ в среднем работают хуже, чем лучший из них в отдельности (Vaccaro, Almaatouq, & Malone, 2024). P1 проверяет калибровку, а не монотонный выигрыш: раскрытое расхождение должно попасть в меньшинство композитных дизайнов, превосходящих своего лучшего компонента. Гипотеза разбита: главный эффект — это подтверждающее утверждение, а модераторы — исследовательские, выведенные из диагностичности доказательств, а не определенные постфактум. Выигрыш в калибровке должен расти со ставками и необратимостью, а также с объективностью задачи (расхождение в объективном вопросе воспринимается как сигнал об ошибке; в субъективном — как вкус; Castelo et al., 2019). Прогнозируется, что опыт потребителя будет давать противоположные знаки: для потребителей с низким опытом раскрытое расхождение без разрешения должно снизить готовность делегировать, а для потребителей с высоким опытом оно должно улучшить калибровку доверия; перекрестие либо наблюдается, либо нет, что делает опыт проверкой, а не лазейкой. Собственный эксперимент этой работы требует одного элемента дизайна. Расхождение коррелирует с трудностью задачи (согласие панели сосредоточено на легких элементах), поэтому дизайн P1 должен манипулировать или статистически контролировать трудность, иначе эффект калибровки спутан с легкостью элемента. Диагностический подход также приводит к граничному прогнозу, который не делают общие теории прозрачности: раскрытие расхождения должно иметь наибольшее значение там, где собственные априорные убеждения потребителя наиболее слабые, при трансграничных покупках или у незнакомых продавцов, потому что внешнее диагностическое доказательство не имеет там внутреннего конкурента.
P2. Доступ к воспроизводимой записи решения увеличивает готовность делегировать важные задачи агенту ИИ сверх доверия к бренду, при этом эффект возрастает со ставками и необратимостью делегируемой задачи. Это также возрастает с уровнем самого делегируемого агентства, что является содержанием компаративной статики гипотезы о миграции доверия: при неизменной фактической производительности модели предельный эффект проверяемых архитектурных свойств на надлежащее делегирование растет, когда потребитель передает больше контроля над проверкой и исполнением (советник → копилот → контролируемый агент → автономный агент). Дизайн, варьирующий уровень делегирования и видимость архитектуры, напрямую проверяет гипотезу. Ближайшее свидетельство из потребительских исследований касается этой зависимой переменной: делегирование покупок ИИ снижает принятие там, где это ограничивает воспринимаемую автономию (Ahmad Husairi & Rossi, 2024), и принятие высокоавтономных ассистентов является непосредственно изученным результатом (Frank et al., 2026). P2 предсказывает эффект записи сверх этих установленных предпосылок.
P3. Воспринимаемая нейтральность уровня оркестрации независимо предсказывает готовность к делегированию, что соответствует эффектам процедурной справедливости в оценке услуг (Tax, Brown, & Chandrashekaran, 1998). Манипулируемая переменная — это проверяемый сигнал нейтральности; измеряемая переменная — это восприятие, которое он производит. Насколько мне известно, нейтральность оркестратора никогда не была операционализирована в поведенческом эксперименте, и сертификационные печати являются ближайшим проверенным аналогом (Cetinkaya & Krämer, 2024), поэтому P3 вводит новую экспериментальную переменную. Направленно эффект нейтральности должен усиливаться по мере того, как способность потребителя проверить содержание снижается, поскольку когда качество результата сложно оценить, сигналы процесса несут оценочный вес. Манипуляция должна отделить проверяемую нейтральность от утверждения о нейтральности: одно условие содержит квитанцию, чья объективная аттестация может быть фактически открыта и проверена, контрастное условие — идентичный интерфейс, содержащий только этикетку, с проверкой манипуляции воспринимаемой нейтральности в обоих условиях. Без этого контраста P3 коллапсирует в общую процессуальную справедливость и ничего не говорит о верификации.
P4. После ошибки агента потребители, чей сервис производит проверяемую запись, демонстрируют меньший коллапс доверия и более высокое удержание, чем потребители непрозрачного сервиса: одноударная динамика модерируется доказательствами. Это механизм, выявляемый исследованием восстановления сервиса, где процедурно справедливое, основанное на доказательствах рассмотрение жалоб восстанавливает доверие после отказа (Tax et al., 1998). Исследование восстановления доверия добавляет, что то, что восстанавливает доверие, зависит от характера нарушения и предложенного объяснения (Kim, Ferrin, Cooper, & Dirks, 2004), требование, которое исследования человека–машины теперь рассматривают как проблему проектирования для автономных систем (de Visser, Pak, & Shaw, 2018), и защитный эффект должен возрастать с серьезностью и необратимостью отказа. P4 предсказывает: запись → меньший коллапс доверия и более высокое удержание, модерируется серьезностью отказа. Случаи, когда запись показывает, что сама процедура не была соблюдена, обрабатываются проверкой манипуляции и исключаются из теста, поскольку гипотеза касается отказов, которые происходят несмотря на соблюденную процедуру. Сравнения устойчивости должны контролировать затраты переключения и блокировку, которые смешивают удержание, и сопутствующий дизайн тестирует, переводит ли запись о соблюденной процедуре приписывание ответственности от сервиса к окружению. Гипотеза не содержит обратного условия, поэтому гипотеза может быть опровергнута любым исходом.
Эмпирический якорь: уровень уверенности как проверенный компонент. Если сервис претендует на то, что его сигналы уверенности что-то означают, это притязание может быть подвергнуто проверке. Уровень уверенности в системе, развернутой для этого тематического исследования, прошел через предварительно зарегистрированную, контролируемую плацебо оценку с шестью условиями на двух независимых семействах моделей. Измеренный профиль собственных слабостей системы улучшил ее предсказание ошибок, получив прирост AUROC примерно +0,07 по сравнению с плацебо, с неперекрывающимися доверительными интервалами на обоих семействах. Ложный профиль самооценки свел предсказание ошибок на уровень случайного выбора, а обобщенная инструкция "осознавайте свои ограничения" ничего не дала.
Две более ранние версии не прошли проверку: одну фальсифицировали собственные авторы из-за смешивающего фактора, другая дала отрицательный результат, прежде чем заранее зарегистрированный дизайн подтвердил результаты. Более строгий повторный тест дал неопределённый результат при сокращённом объёме, а предварительно зарегистрированная четырёхступенчатая лестница на передовом семействе моделей не прошла ни одну точку подтверждения; направление эффекта сохранилось только в исследовательском режиме на трёх из четырёх ступеней. Поэтому утверждение применимо для каждого семейства и имеет ограничения: измеренное самопознание улучшило предсказание ошибок там, где это было подтверждено, и это не является установленным свойством каждого класса моделей. Профиль слабостей работает и в production, где он корректирует маршрутизацию живых моделей, ограниченный и отказоустойчивый. Коллапс ложного профиля одновременно является находкой в области безопасности: сфабрикованная самомодель является вектором атаки — ещё одна причина, по которой самопознание нуждается в архитектурном контроле, а не в самоотчёте модели. Логика дизайна имеет родословную в области исследования потребителей, более древнюю, чем сама технология. Предварительное обязательство, связывающее будущее поведение через внешнюю структуру, потому что внутреннее решение не ожидается, что будет удерживаться, — это именно то, как потребители ограничивают собственные пороки (Wertenbroch, 1998), и архитектурное доверие расширяет тот же принцип на машины.
Полная траектория (протоколы, предварительные регистрации, необработанные данные, фальсифицированный пилот, отрицательная итерация, неподтверждающие расширения) сохранена как автономный архив, общедоступный с материалами статьи на OSF по адресу https://osf.io/jtvu9/ (файл `self-calibration-archive.zip`). Калиброванная уверенность — это архитектурный компонент с измеряемым содержанием, и она может отказать. Отказы архивируются вместе с успехами, потому что уровень доверия, чьи утверждения об уверенности никогда не подвергались экспериментальной проверке, требует ровно того слепого доверия, которое он должен был заменить. Позиционный документ тридцати авторов придаёт этому разделению труда формальное выражение: оркестровка агентов должна быть байесовски согласованной (Papamarkou et al., 2026), и калиброванные убеждения должны находиться в управляющем слое, а не в моделях.
Тестирование механизма: предварительно зарегистрированный эксперимент. Приведённые выше утверждения поддаются проверке, и в этом разделе сообщаются результаты тестов. Каждый экспериментальный результат в этом разделе, в обеих волнах, относится к техническому предшественнику данной структуры — к вопросу о том, несёт ли независимое согласие сигнал правильности, который самоотчёт модели не несёт, при ответах на фактические вопросы. Эти эксперименты не демонстрируют потребительское доверие, делегирование или коммерческое поведение, которые остаются сферой P1–P5 и поведенческого исследования раздела 6. Протокол был заморожен публично до появления каких-либо подтверждающих данных (OSF: https://osf.io/4y9dv, зарегистрирован 23 июля 2026; гипотезы H1–H6, контрольная выборка зафиксирована по начальному значению и хешу SHA-256, неблагоприятные для гипотезы результаты были объявлены заранее). Дизайн намеренно прост. Шестнадцать моделей, девять поставщиков на границе инноваций (Anthropic, OpenAI, Google, xAI, DeepSeek, Alibaba, Moonshot, Zhipu, Mistral) и семь локальных моделей с открытыми весами дали ответы на одни и те же 1500 вопросов SimpleQA один раз, вслепую, без поиска или инструментов. Это режим, который максимизирует воздействие коррелированной параметрической ошибки, намеренно сложный случай для сигнала, с экологическими затратами, указанными в ограничениях. Ответы даны при температуре ноль с указанием уверенности от 0 до 100: вербализованная неопределённость, полученная в виде слов в рамках одного ответа, а не извлечённая из логитов — в формате, который, как показали Lin, Hilton и Evans (2022), модели могут научиться калибровать. Панели — это аналитические комбинации этой единственной коллекции из 24 000 номинальных слотов для ответов, из которых 22 598 были предоставлены, одна локальная модель (deepseek-r1:8b) остановилась на 98 элементах в соответствии с предварительно заданным правилом остановки. Шесть зарегистрированных гипотез соответствуют результатам следующим образом. H1, что кросс-модельное расхождение выявляет большинство уверенных ошибок, подтверждается: согласие повышает корректность в 1,9–3,2 раза в зарегистрированной волне (Таблица 6), а в основной волне замороженный фильтр устраняет 82,1% уверенных отказов (Таблица 10). H2, что сигнал панели превосходит собственную уверенность отвечающей модели, выполняется на CN-пограничных и кросс-блоковых панелях (ΔAUROC +0,287 и +0,063) и изменяется на противоположное на US-пограничной панели. H3, что нетривиальная доля уверенных ошибок сохраняется как единодушное согласие на один неправильный ответ, подтверждается: 0,5–2,2% открытых вопросов и 4,0–7,9% в разделе с множественным выбором. H4(a), что внутриблоковая корреляция ошибок превышает кросс-блоковую, не подтверждается (разность φ +0,011, 95% CI −0,005 до +0,028), и H4(b), что кросс-блоковая панель выявляет больше, также не подтверждается, преимущество кросс-блока оказывается меньшим. H5, что локальная панель стоимостью $0 выявляет большинство пограничных уверенных ошибок, не подтверждается: сигнал согласия локального уровня находится на уровне случайности. H6, лестница расстояния происхождения, не тестируется как лестница здесь; её блоковый уровень шага соответствует нулевому результату H4(a).
Фактическая проверка является релевантным прокси для агентского коммерческого взаимодействия, потому что делегированная покупка разлагается в момент выполнения на фактические подутверждения: текущую цену и доступность товара, условия политики возврата, соответствие спецификаций товара заявленным требованиям потребителя, личность и рейтинг продавца. Каждое из них имеет проверяемую истину основания того же рода, что и элемент SimpleQA. Фильтр несогласия работает на этом фактическом субстрате, в то время как взвешивание предпочтений (какие компромиссы имеют значение и в какой мере) остаётся у потребителя, который определил требования, по которым проверяются факты. Это разделение труда также объясняет, почему дизайн раздела 6 манипулирует отображением проверки, а не предпочтениями участников: утверждение архитектуры касается фактического уровня делегированного решения, а не его вкусового уровня. Где суждение вообще не имеет фактического субстрата, в подлинно субъективных выборах без истины основания для проверки, предшественник перестаёт действовать, и раздел «Ограничения» обозначает эту границу как открытый вопрос.
Выбор эталона был измерен. На TruthfulQA версии 2021 года (присутствующем в корпусах предварительного обучения) одни и те же поставщики набрали на 47–61 процентный пункт больше, чем на SimpleQA (например, 89% против 28%), разрыв, согласующийся с эффектами возраста эталона и воздействия, хотя данный дизайн не может отделить загрязнение от различий в сложности эталона и конструкции. Поэтому ни один основной результат не основывается на более старом эталоне. Оценка — это объективное сопоставление строк, с неразрешёнными случаями, оценённые на эквивалентность золоту только локальной моделью с открытыми весами (Qwen3-8B, запущенной локально; подсказка только для эквивалентности в пакете репликации; никогда членами семей членов панели; неизвестно, присутствует ли SimpleQA в корпусе обучения судьи, но судья определяет эквивалентность между двумя предоставленными строками, а не истину, что ограничивает воздействие) и ручной выборочной проверкой 50 элементов (согласие 98%), ограничением масштаба. Это теперь расширено стратифицированным аудитом 300 элементов между семействами разрешённых судьёй случаев (другое семейство моделей в качестве аудитора, выборка с фиксированным начальным числом): согласие 96% (288/300), все двенадцать разногласий — мягкие ложноположительные результаты (девять явных, три пограничных), однонаправленное смещение, затрагивающее примерно 3% всех оценённых ответов (4% доли разрешённых судьёй). Две трети вердиктов (66,5%) поступили от локального оценивателя модели, а не от точного совпадения строк, и основной результат устойчив к ошибке оценивателя: инвертирование случайных 10% вердиктов, оценённых моделью, смещает коэффициенты сертификации не более чем на ±0,5× и никогда не меняет их направление.
Два выбора дизайна сделаны преднамеренно, а не из бюджетных соображений. Были использованы средние уровни поставщиков, во-первых, для экологической валидности: агенты, проводящие операции от имени потребителей, в подавляющем большинстве работают на этих оптимизированных по стоимости уровнях, проверяемых по открытым прайс-листам (середина 2026 года; Рисунок 11). Типичный обмен услуг стоит от доли цента до примерно цента на бюджетных уровнях, против пяти-десяти центов на флагманских весах, и ни один сервис, обслуживающий миллионы сеансов, не устанавливает свой стандартный путь по флагманской ставке. Реестр отражает рынок: девятивендорная панель содержит все три поставщика, которые вместе занимают 88% расходов на API моделей LLM предприятия, и панель US-frontier таблицы 6 — это именно эта тройка. Возражение о том, что это доказательство для предприятия, в котором потребителя нет, неправильно понимает цепочку поставок. Потребитель больше не выбирает модель вообще: он выбирает банк, розничного продавца, авиакомпанию, и политика маршрутизации сервиса выбирает модель. В валюте, в которой потребители фактически обслуживаются, в токенах, а не в долларах, картина подтверждает выбор (Рисунок 12): в исследовании OpenRouter–a16z 100 триллионов токенов маршрутизированного трафика модели с открытыми весами достигли примерно трети всего использования (Aubakirova et al., 2026), стандартные уровни трёх крупнейших потребительских AI продуктов все находятся ниже флагманского уровня, и только около 3% потребителей AI платят за премиум-сервис (Menlo Ventures, 2025c), поэтому маргинальный потребитель должен обслуживаться с практически нулевыми предельными затратами. Ниже рынка API находится слой локальных и самостоятельно размещаемых моделей с открытыми весами, невидимых для обследований на основе расходов, и локальный уровень семи моделей с открытыми весами в эксперименте целенаправленно его отбирает. При каждой валюте, в которой можно считать рынок, уровни, которые отбирало данное исследование, — это те, которые обслуживают потребителя. (После сбоя одной стороны, часть сбора была завершена через агрегатор, с фактической инфраструктурой обслуживания, записанной за вызов в манифест запуска.)
Рисунок 11. Уровень, с которым потребители встречаются на кассе
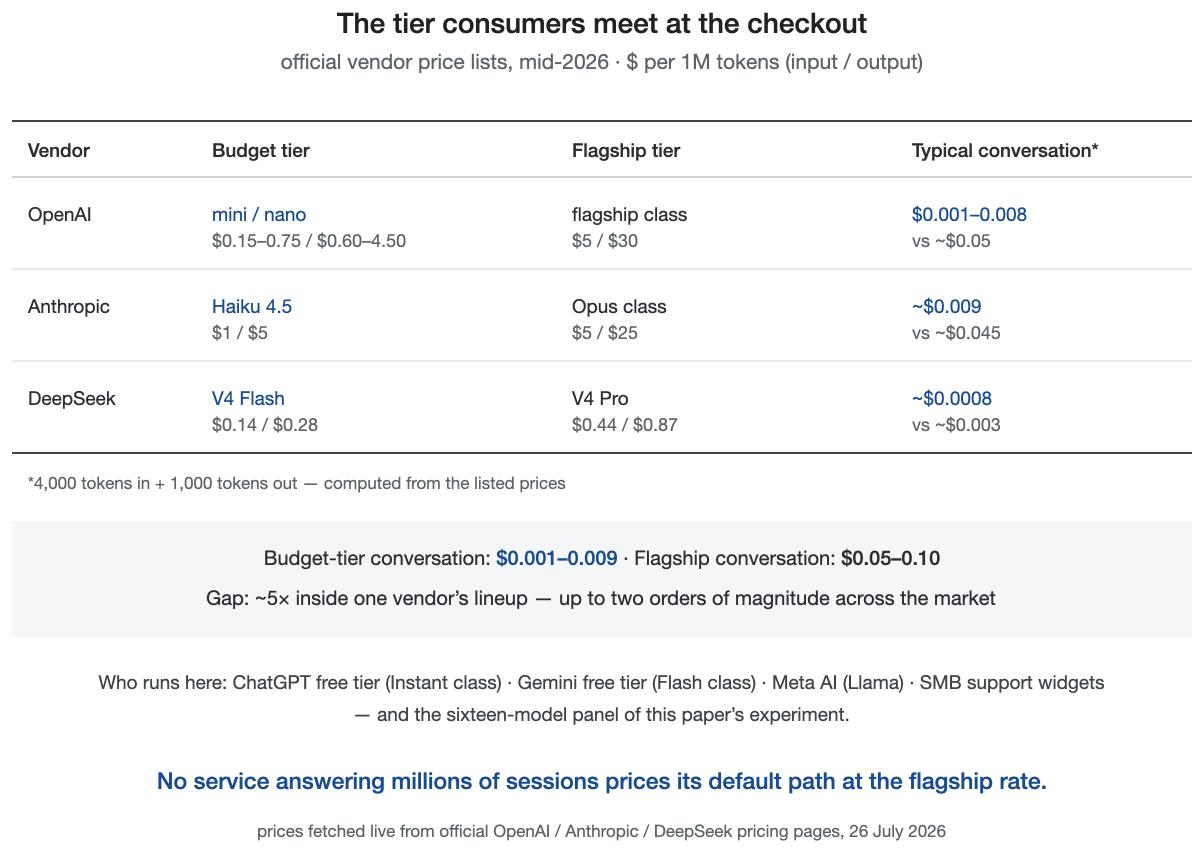
Официальные прайс-листы поставщиков, середина 2026 года.
Рисунок 12. Две валюты рынка моделей
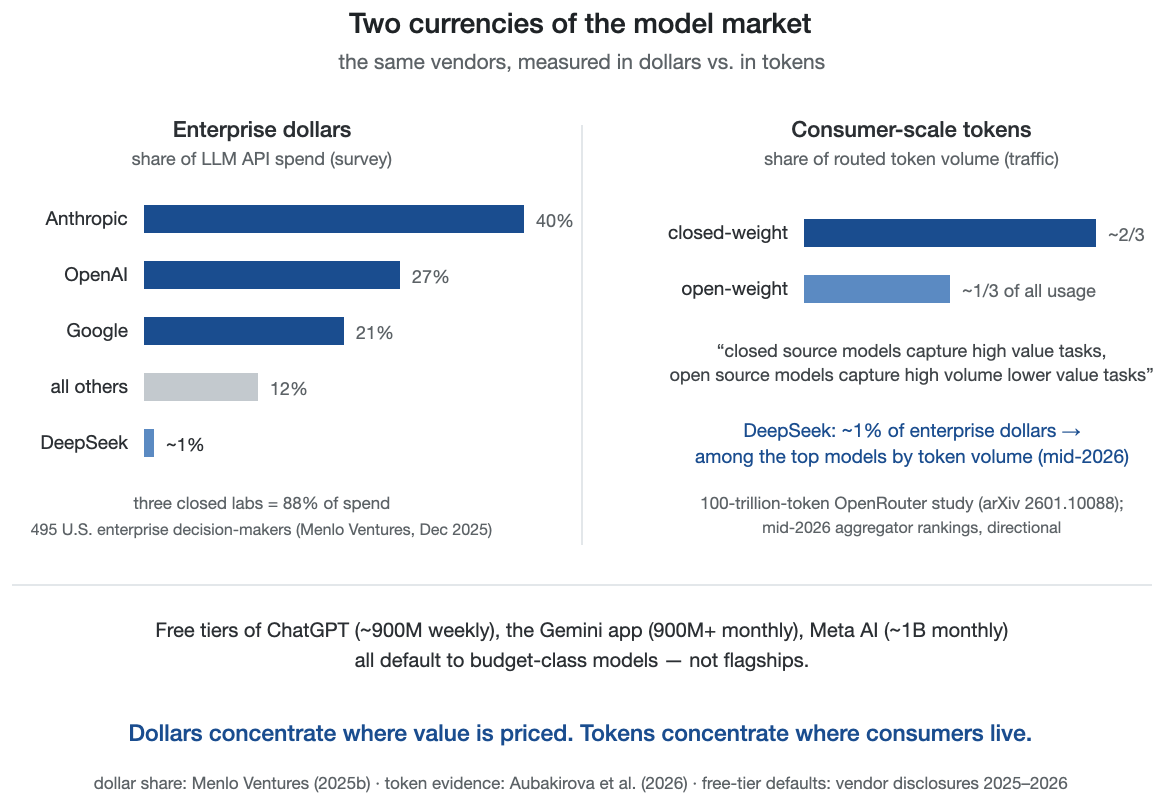
Корпоративные доллары в сравнении с потребительскими токенами.
Средние уровни также соответствовали утверждениям статьи, которые касаются архитектуры, а не флагманских возможностей: эффект, который появился бы только с премиальными весами, был бы результатом модели. Конвейер реплицируется на стандартной инфраструктуре менее чем за 15 долларов расходов на API. Для статьи, утверждающей, что проверка должна быть достаточно дешёвой, чтобы работать на каждом значимом ответе, стоимость проверки самой статьи является частью доказательства. Конвейер — это автономный пакет репликации (исполнители, оценивающий модуль, скрипты анализа, необработанные оценённые данные и манифест запуска), не требующий ничего от исследовательской системы автора. Сбор в целом составляет 24 000 ответов, примерно 30 000 включая области контаминации эталона и соответствия. О доступности: открытая предварительная регистрация (osf.io/4y9dv) архивирует подвыборку из 1500 элементов с фиксированным начальным числом. Полный пакет общедоступен по адресу https://osf.io/jtvu9/, общественный компонент исходного проекта регистрации (папка `replication-package-v2`).
Три результата определяют раздел. Во-первых, сырой материал в изобилии: медиана заявленной уверенности составила 85–95 у семи из девяти фронтир-вендоров, причём два исключения (медианы 42 и 60) — это именно вендоры, чья уверенность различает, в то время как фактическая точность колебалась от 10% до 66%, что даёт 289–1212 уверенных ошибок (ошибочно при уверенности ≥ 75) на фронтир-вендора на 1500 вопросов. Как сигнал корректности, собственная уверенность модели набрала AUROC 0,53–0,79 в зависимости от вендора, и потребитель не имеет никакого способа узнать со стороны, какого вендора он получил. Это распределение вендоров соответствует на уровне, на котором потребители фактически обслуживаются, выводу лаборатории фронтира о том, что крупные модели часто хорошо откалиброваны при самооценке в контролируемых форматах (Kadavath et al., 2022): некоторые развёрнутые вендоры отправляют это самопознание, другие отправляют уверенный шум, и ничто на поверхности их не различает.
Во-вторых, главное: верификация работает как сертификация, а не как сигнал тревоги. Сертификация в вероятностном смысле, апостериорная вероятность примерно 49–77% в зависимости от панели, не гарантия. На столь сложных вопросах наивный сигнал «какой-то член панели не согласен» насыщается: срабатывает на 85–94% уверенных ошибок, но также на 91–95% уверенных правильных ответов (предварительная регистрация предусмотрела это переосмысление, перейдя к предварительно установленной конечной точке AUROC). Информативное направление противоположно: правильные ответы независимо воспроизводятся, неправильные разбросаны. Ответ, который воспроизвел хотя бы один независимый член панели, был правильным 72–77% времени на внутриблоковых панелях и 49% на кросс-блоковой панели, против 18–37% без воспроизведения. Ответ с независимым согласием был примерно в два-три раза более вероятно правильным (1.9–3.2× в трёх панелях таблицы 6). (Здесь и далее «независимый» означает слепо и отдельно произведённый, с остаточной корреляцией ошибок, измеренной, а не предполагаемой, и корректность всегда оценивается по эталонным золотым меткам, никогда по мнению другой модели.) Оцениваемая величина — ассоциативная, а не причинная: воспроизведение отмечает ответы, более вероятно правильные, и частично отмечает то, что вопрос был лёгким — эффект отбора, количественно определённый ниже. Как сигнал корректности, согласие панели достигло AUROC 0.832 на панели, чьи члены имели наименьший собственный сигнал уверенности (по поставщикам 0.53–0.62; объединённые 0.545). Утверждение, которое выдерживает проверку, распределительное, а не особенное: по всем 84 панелям с тремя поставщиками согласие AUROC имеет медиану 0.79 и превышает объединённый самоотчёт в 89%. Согласие достигло 0.722 на кросс-блоковой панели против объединённой собственной уверенности 0.659 (объединение нестандартизированных вербальных шкал по поставщикам искажает самоотчёт, потому что поставщики используют шкалу 0–100 по-разному, и направление артефакта зависит от панели, поэтому значения по поставщикам печатаются рядом). Это преимущество на кросс-блоковой панели зависит от схемы кодирования (альтернативные предварительно установленные схемы кодирования согласия размещают сигнал согласия кросс-блоковой панели на 0.544–0.722, щедрый вариант «неразрешённое=согласие» падает ниже объединённой уверенности этой панели 0.659, в то время как сигнал панели CN варьируется от 0.719–0.894 в одних и тех же кодированиях, всегда выше 0.545), поэтому устойчивый к кодированию результат сравнения «панель против самоотчёта» — это случай внутриблокового CN. Единственная панель, где самоотчёт явно превзошёл сигнал панели (0.842 vs 0.697), содержала наиболее различающего поставщика исследования (Anthropic, средний уровень, собственная уверенность AUROC 0.788 на полной коллекции 1500 элементов), и собственный сигнал этого хорошо ранжированного поставщика превосходил сигнал согласия его собственной панели. Таблица 7 выводит значения по панелям, рассчитанные в рамках популяции элементов каждой панели. Парный кластерный bootstrap (вопросы пересэмплированы с заменой, все три единицы (item, primary) на вопрос движутся вместе; B = 2,000) устанавливает доверительные интервалы для контрастов таблиц 6/7. На панели CN-frontier согласие панели превосходит объединённую собственную уверенность на ΔAUROC = +0.287 (95% CI [+0.265; +0.308], p < .001). На кросс-блоковой панели преимущество меньше, но надёжно, +0.063 ([+0.037; +0.087], p < .001). На панели US-frontier направление меняется, и само это изменение статистически однозначно: собственная уверенность 0.842 против согласия панели 0.697. Состав панели является поэтому первичным модератором значения сигнала, и вытекающее правило таково: проверяйте собственную калибровку членов панели перед тем, как доверять согласию вместо неё, ΔAUROC = −0.145 ([−0.170; −0.120], p < .001). Все три контраста статистически значимы, и различие между панелями — это результат, а не шум. Случай US поэтому сообщается как подтверждённое обращение, а не нулевая зона, и он определяет границы конструкта: на панели, отобранной из высокодискриминирующего конца рынка, собственная уверенность превосходит согласие как сигнал ранжирования, поэтому дискриминационная ценность компонента Diversity зависит от состава панели, а не универсальна. Архитектура может предоставить внешний сигнал корректности, где явная уверенность модели различает слабо, и проверяет заявление о калибровке, где оно выдвигается. Одна граница остаётся: даже идеально калибрированная модель не может заверить свою собственную историю или рассудить свой собственный конфликт интересов, поэтому по мере улучшения дискриминации поставщика роль разнообразия переходит от обнаружения корректности к проверке калибровки, в то время как доказательства и нейтральность выполняют работу, которую не может выполнить никакое количество калибровки.
Архитектурная верификация предоставляет внешний сигнал корректности, когда поставщик не выпустил пригодный сигнал уверенности, и определение того, какой поставщик его выпустил, в любом случае требует архитектурного анализа. Утверждение о замене, точно определённое по области, основывается на метриках калибровки, а не на AUROC. Ни один поставщик в волне июля одновременно не обладает хорошей способностью различения и хорошей калибровкой; xAI подходит ближайше всего (Таблица 7a), и основная волна воспроизводит калибровочный аспект этой диссоциации, поэтому даже потребитель, случайно получивший наиболее ранжированную уверенность, не может интерпретировать её уровень как вероятность без внешнего эталона. Это то, что предоставляет архитектурный слой. Если поставщики в конечном итоге везде выпустят хорошую калибровку, доказательства и нейтральность останутся нетронутыми. Аргумент сохраняет свою силу в мире, где модели улучшаются.
В-третьих, режим отказа имеет определённую форму: сертифицированные консенсусные ошибки, когда все члены панели уверенно сходятся на одном и том же неправильном ответе, произошли в 0.5–2.2% вопросов открытого формата, но в 4.0–7.9% в сопутствующем варианте, который переформулировал элементы в формате множественного выбора на локальном уровне (конструкция элементов и результаты в пакете воспроизведения). Консенсус подтверждает ошибку главным образом там, где пространство ответов ограничено — предупреждение по дизайну для любого интерфейса, который предлагает агентам меню вариантов.
Нулевые результаты столь же поучительны, как и положительные, и я публикую их в виде предварительно зарегистрированных исследований. Геополитический блок (включая возможность того, что панели в пределах одного блока используют общие обучающие корпусы и цепочки дистилляции) не предсказывает корреляцию ошибок на этом бенчмарке (разница φ внутри блока против между блоками +0,011 на уровне frontier, 95% ДИ −0,005 до +0,028; слегка обратная на локальном уровне). Способность обусловливает корреляцию, а не флаг, что вторит Kim et al. (2025). Генеалогия не предсказывает показатели выявления: локальная модель, проверяющая свою собственную соседнюю модель frontier, работает как любая посторонняя, и модель с дистилляцией рассуждений показала наименьшую корреляцию ошибок со своими исходными весами (φ = 0,135). Оба этих результата — граничные нули, а не продемонстрированная эквивалентность. Интервал блока исключает различия φ больше +0,028, и именно эта граница, а не неудача отклонения, выполняет логическую работу. Естественным непрерывным расширением, поддерживаемым данными репликации, является оценка подъёма сертификации как функции измеренного разнообразия панели (φ оценки сюрприза), а не идентичности панели. Это повторило бы, для модельных панелей, программу, которую литература по ансамблям классификаторов запустила для своей собственной статистики разнообразия, обнаружив, что ни одна мера не предсказывает прирост ансамбля четким образом (Kuncheva & Whitaker, 2003).
И дешёвые локальные модели вообще не могли сертифицировать ответы frontier на вопросы открытой формы (46 % точности с их согласием или без): проверяющий должен быть компетентен в классе задачи до того, как его независимость стоит чего-либо. Граничные условия таковы: консенсус сертифицирует ошибку там, где пространства ответов ограничены, независимость должна измеряться, а не предполагаться, компетентность проверяющего управляет ценностью сертификации. На практике, разнообразие — это свойство, которое должно измеряться вопрос за вопросом, а не предполагаться из брендов, блоков или генеалогических деревьев. Таблица 6 обобщает метрики панели. Рисунок 13 показывает подъём сертификации и сравнение сигналов рядом.
Рисунок 13. Иллюзия точности и её архитектурное решение
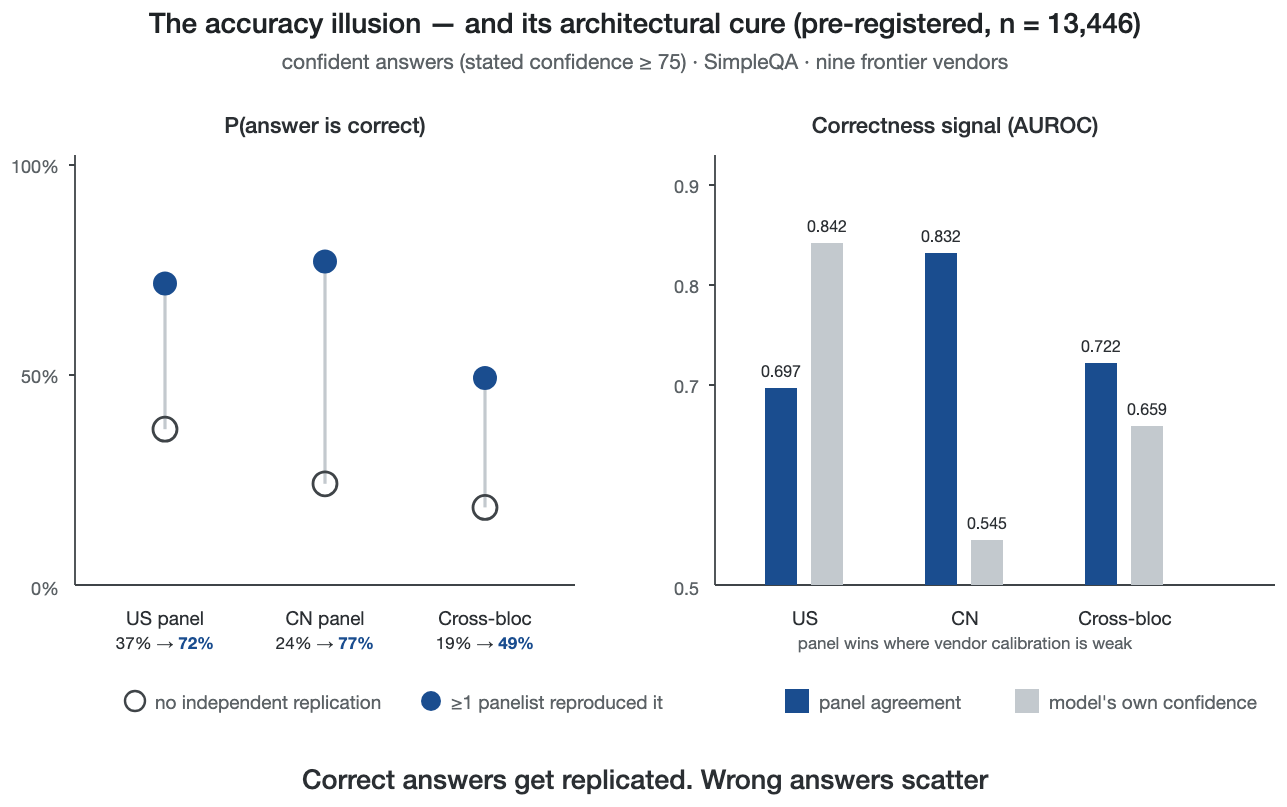
Сертификация путём независимой репликации (предварительно зарегистрированная; n = 13 446 оцененных ответов — девять поставщиков frontier, каждый ответивший на одни и те же 1 500 вопросов SimpleQA один раз, за вычетом 54 неудачных или неоцениваемых вызовов).
Одновременная работа усиливает предостережение: крупномасштабный аудит обнаружил высокую согласованность, совпадающую с неправильными ответами на бенчмарках рассуждений, где одно только согласие, без независимости и слепого сбора, является слабым и зависящим от режима сигналом (Ding, 2026). Поэтому я рассматриваю независимую, слепую репликацию как единицу сертификации.
Таблица 6. Перехват ошибок с высокой уверенностью и сертификация панелью (SimpleQA, подтверждающая; conf ≥ 75)
| Панель | Ошибки с высокой уверенностью (n) | Частота флага на ошибках [95% ДИ] | Ложные срабатывания на верных | P(correct | ≥1 agrees) | P(correct | none) | AUROC: согласие против собственной уверенности |
| US-frontier (Anthropic·OpenAI·Google) | 1,630 | 94.3% [93.1–95.3] | 91.0% | 71.8% | 37.1% | 0.697 vs 0.842 |
| CN-frontier (DeepSeek·Alibaba·Moonshot) | 2,128 | 85.5% [83.9–86.9] | 94.8% | 77.0% | 24.1% | 0.832 vs 0.545 |
| Cross-bloc (Anthropic·DeepSeek·Mistral) | 2,432 | 89.4% [88.1–90.6] | 93.4% | 49.3% | 18.5% | 0.722 vs 0.659 |
Флаг = ≥1 независимый ответ панелиста неэквивалентен основному (отказы и ответы без пересечения считаются несогласием; более строгое кодирование находится в пакете репликации). Чувствительность порога при 60/90 не меняет вывод. AUROC собственной уверенности — это заявленная уверенность, объединённая по полной популяции ответов панели; объединение поглощает различия между поставщиками в точности и масштабе уверенности, поэтому оно может превосходить индивидуальное значение каждого члена (значения по поставщикам в таблице 7). Ответы группируются по вопросу; бутстреп-кластер на уровне вопроса расширяет интервалы примерно на коэффициент 1,6 без изменения каких-либо выводов. Каждый AUROC в этой таблице и таблице 7 воспроизводится детерминированно, одной командой и без случайности, из скрипта пакета репликации compute_panel_vs_own_auroc.py (Mann–Whitney с коррекцией связей).
Таблица 7. AUROC собственной уверенности панелью: объединённая популяция панели и по поставщикам (те же популяции, что в таблице 6)
| Панель | Объединённый AUROC собственной уверенности | AUROC собственной уверенности по поставщикам |
| US-frontier | 0.842 | Anthropic 0.784 · OpenAI 0.596 · Google 0.746 |
| CN-frontier | 0.545 | DeepSeek 0.569 · Alibaba 0.532 · Moonshot 0.620 |
| Cross-bloc | 0.659 | Anthropic 0.787 · DeepSeek 0.570 · Mistral 0.584 |
Вычислено детерминированным конвейером в пакете репликации. Две конвенции популяции сосуществуют и выводятся в явном виде, чтобы избежать кажущегося несоответствия: значения таблицы для каждого поставщика вычисляются в пределах популяции элементов каждой панели, тогда как однозначные ссылки в тексте используют полное значение коллекции — для лучшего разделяющего поставщика 0.784 в панели US-frontier против 0.788 на полной коллекции из 1,500 элементов, а для OpenAI 0.596 против 0.598 (обе пары воспроизводятся одной командой того же конвейера). Объединённый столбец, напротив, смешивает базовые коэффициенты поставщиков — различия между поставщиками в точности и масштабе уверенности играют роль, поэтому объединённое значение не обязательно находится в пределах диапазона для каждого поставщика (пересчитано в реальном времени: объединённое значение US-frontier 0.842 превышает индивидуальное значение каждого члена, а объединённое значение CN-frontier 0.545 находится ниже макросреднего значения этой панели 0.574); значения для каждого поставщика — это интерпретируемые величины. Разброс по поставщикам — это проблема потребителя, выраженная численно: полезная дискриминация существует у одного поставщика и близка к случайности у других, и ничто в самом ответе не указывает, какой поставщик его создал. Исходные значения, лежащие в основе диапазонов поставщиков раздела 3, выведенные для каждой модели из одной и той же оцененной коллекции (медиана указанной уверенности · точность · AUROC собственной уверенности полной коллекции): frontier — Alibaba 95 · 47.4% · 0.532; Anthropic 42 · 10.3% · 0.788; DeepSeek 90 · 35.7% · 0.570; Google 95 · 66.5% · 0.746; Mistral 90 · 16.5% · 0.584; Moonshot 85 · 51.6% · 0.619; OpenAI 85 · 16.7% · 0.598; xAI 60 · 37.9% · 0.777; Zhipu 95 · 28.4% · 0.611 — две медианы ниже диапазона 85–95 относятся к двум поставщикам, чья уверенность несёт полезный сигнал; местный уровень (входит только в стратификацию сложности и местные нули уровня) — gemma4:e4b 90 · 5.2% · 0.541; glm4:9b 85 · 5.0% · 0.589; llama3.2:3b 100 · 5.3% · 0.494; mistral:7b 95 · 6.3% · 0.506; phi4-mini 95 · 5.5% · 0.505; qwen3:8b 95 · 5.9% · 0.504; deepseek-r1:8b 90 · 9.2% · 0.696 (n = 98, правило остановки, определённое предварительно).
AUROC измеряет дискриминацию, т.е. ранжирует ли поставщик свои правильные ответы выше неправильных по указанной уверенности, в то время как ECE, коэффициент Бриера и разрыв доверие–точность измеряют калибровку, т.е. можно ли читать указанное число как вероятность, и в этих данных два этих свойства резко разделены. Лучший разделяющий поставщик июля в исследовании, средний уровень Anthropic (AUROC собственной уверенности 0.788), всё ещё плохо откалиброван по уровню: средняя указанная уверенность 41.3 (медиана 42) при 10.3% точности, разрыв переуверенности на +31.0 пункта, ECE 0.311 (15 бинов), коэффициент Бриера 0.206 с членом надёжности 0.126 против неснижаемого пола неопределённости 0.093. Наоборот, наихудшая калибровка в панели совпадает с дискриминацией близкой к случайности (Mistral: разрыв +74.2 пункта, ECE 0.742, AUROC 0.584), и только xAI приближается как к дискриминации, так и к калибровке (ECE 0.111, AUROC 0.777). Даже там дискриминация помогается равномерно низкой указанной уверенностью, в то время как для остальных восьми поставщиков июля эти два свойства резко разделены. То же разделение сохраняется на флагманском уровне: девять из одиннадцати флагманов августа имеют разрывы переуверенности от +12.5 до +71.4 пункта (ECE 0.125–0.714), в то время как два исключения (gpt-5.6-sol, ECE 0.031; claude-fable-5, ECE 0.043) достигают калибровки на противоположных концах шкалы точности. Потребитель, обладающий хорошо ранжированной, но численно завышенной оценкой уверенности, не может её использовать без внешней ссылки. Таблица 7a выводит метрики калибровки рядом с метриками дискриминации.
Таблица 7a. Дискриминация против калибровки, волна июля (полная коллекция, разрешена; ECE с 15 бинами; разрыв = средняя указанная уверенность − точность, процентные пункты)
| Поставщик | n | AUROC (собственная уверенность) | ECE | Brier | Разрыв уверенности − точность | Средняя уверенность → точность |
| Alibaba | 1,497 | 0.532 | 0.448 | 0.446 | +44.8 pp | 92.3 → 47.4% |
| Anthropic | 1,500 | 0.788 | 0.311 | 0.206 | +31.0 pp | 41.3 → 10.3% |
| DeepSeek | 1,500 | 0.570 | 0.536 | 0.513 | +53.4 pp | 89.1 → 35.7% |
| 1,461 | 0.746 | 0.263 | 0.271 | +26.3 pp | 92.8 → 66.5% | |
| Mistral | 1,495 | 0.584 | 0.742 | 0.686 | +74.2 pp | 90.6 → 16.5% |
| Moonshot | 1,500 | 0.619 | 0.242 | 0.292 | +24.2 pp | 75.8 → 51.6% |
| OpenAI | 1,500 | 0.598 | 0.610 | 0.531 | +60.9 pp | 77.6 → 16.7% |
| xAI | 1,500 | 0.777 | 0.111 | 0.197 | +11.1 pp | 48.9 → 37.9% |
| Zhipu | 1,493 | 0.611 | 0.642 | 0.612 | +64.2 pp | 92.6 → 28.4% |
| Панель US-frontier, объединённые единицы | 4,383 | 0.842 | 0.393 | 0.336 | +39.3 pp | — |
| Панель CN-frontier, объединённые единицы | 4,491 | 0.545 | 0.408 | 0.417 | +40.8 pp | — |
| Панель Cross-bloc, объединённые единицы | 4,485 | 0.659 | 0.529 | 0.469 | +52.9 pp | — |
Те же популяции, что и полный AUROC коллекции и таблицы 6–7 (строки панели: объединённые (элементные, основные) единицы); отказы оцениваются как неправильные в соответствии с замороженным протоколом. Brier раскладывается по тождеству Мёрфи (надёжность − разрешение + неопределённость) на одних и тех же 15 бинах, остаток < 0.001 в каждой строке. Одно примечание флагманского уровня следует вместе с двумя откалиброванными исключениями: ECE 0.031 gpt-5.6-sol достигается при 95.4% точности, где член неопределённости Мёрфи, пол, устанавливаемый базовым коэффициентом, составляет 0.044 — калибровка частично достигнута за счёт базового коэффициента, который несёт оговорку о загрязнении таблицы 9 (61.6% буквальных совпадений золотой строки).
Один эффект отбора должен сопровождать таблицу: репликация отчасти является маркером простоты вопроса. При стратификации по сложности вопроса (средняя точность на остальных пятнадцати моделях) необработанный прирост сертификации обеспечивается более простыми слоями (2,7–4,6×), падает ниже 1× на вторую по сложности квинтиль и исчезает на самой сложной при использовании этого внутриколлекционного показателя. Данная стратификация отчасти эндогенна, и внешняя переоценка ниже смягчает инверсию в монотонное затухание. Анализ робастности напрямую решает проблему отбора (поисковый, не предварительно зарегистрированный): в логистической модели с кластеризацией по вопросам и фиксированными эффектами первичной модели, контролируя собственную уверенность первичной модели и сложность пункта (исключение первичной модели из средней точности на всех шестнадцати моделях), каждый дополнительный согласный эксперт по-прежнему умножает шансы правильности примерно на пять (объединённый b = +1,65 на эксперта, 95% ДИ [+1,49, +1,81], p < 10⁻⁸⁸; положительно на каждой панели), а добавление согласия к базовому уровню сложности и уверенности повышает удержанную AUROC с 0,859 до 0,898 и понижает оценку Бриера с 0,139 до 0,116 (двусторонний перекрёстный контроль, разбиение по вопросам). Та же модель изучает границу, и сама стратификация требует внимания: при использовании внутриколлекционного показателя сложности условный коэффициент становится отрицательным на самой сложной квинтили (b = −0,41, p = 0,011), но этот показатель включает собственных членов панели. Условная модель имеет оговорку при развёртывании: её функция сложности требует метки, поэтому она диагностическая, а не развёртываемая, и развёртываемым фильтром является сам шлюз согласия. Три дополнительные проверки решают проблемы оценивания и отбора, все в рамках замороженного детерминированного протокола кодирования (более строгая ветвь, которую пакет репликации сообщает наряду с прошедшими судебное разбирательство заголовочными цифрами). При переоценке прироста сертификации с помощью бутстреп-передискретизации с кластеризацией по пункту, кластеризация, которую требует структура сложности, интервал прироста сертификации каждой панели остаётся намного выше 1 (пункт прироста 2,4–4,5 при этом детерминированном кодировании, которое сертифицирует меньше согласий, чем прошедшая судебное разбирательство парная кодировка, лежащая в основе опубликованного заголовка 1,9–3,2×; нижние границы бутстреп 2,2–4,1). Распределение 84 панели, указанное выше, делает панель границы США, где самоотчёты выигрывают, исключением, а не правилом (медианное преимущество +0,14, межквартильный размах AUROC согласия 0,76–0,82). И стратифицированная по сложности AUROC делает границу явной при использовании внешнего показателя сложности: 0,87 на самой простой квинтили, падая до 0,61 на самой сложной, затухание без инверсии. Этот показатель исключает панель, тринадцать моделей вне каждой панели, и при переоценке с его использованием инверсия разрешается: условный коэффициент согласия остаётся положительным на каждой квинтили, включая самую сложную (самая сложная квинтиль b = +0,97, p < 10⁻⁷; 28% независимо воспроизведённых ответов на самом сложном слое правильны, а не 0%). Таким образом, инверсия внутри коллекции отчасти является артефактом показателя сложности. То, что сохраняется при использовании обоих показателей, — это монотонное затухание, когда согласие наиболее слабо там, где вопросы наиболее сложны, и реальность проверенных ошибок консенсуса; скрипты и выходные данные находятся в пакете репликации. Заголовочный коэффициент, следовательно, является средним по неоднородной совокупности. Заявление о сигнале опирается на конечную точку AUROC, а не на коэффициент.
Гипотезы эксперимента операционализируют развёртывание исследования, которым я управляю: слепой сбор отражает его механизм совета, и составы панелей существовали как его производственная конфигурация до того, как было разработано исследование. Это второе предварительно зарегистрированное исследование в этой исследовательской программе. Третье, потребительский эксперимент в разделе 6, завершено и представлено, а четвёртое (телеметрия поля по производственному трафику) подготовлено. Пакет репликации работает для кого угодно на потребительском оборудовании в сравнении с открытыми API.
Вторая волна на флагманском уровне: одиннадцать лабораторий — десять полных блоков и один частичный — один калибровочный ров. Описанный выше эксперимент проводился на бюджетных уровнях, которые фактически обслуживают потребителей. Возражение для проверки: возможно, иллюзия точности является артефактом бюджетного уровня, и флагманы, модели, которые каждый поставщик представляет как лучшие, достаточно хорошо откалиброваны, чтобы архитектура выше них была излишней. Вторая волна сбора (август 2026) проверяет это возражение на вершине рынка.
Я оцениваю одну флагманскую модель из каждой из десяти крупных лабораторий ИИ, охватывающих США, Китай и Европу. Лаборатории были выбраны для охвата ведущих коммерческих и открытых экосистем на этих трёх территориях. Для каждой лаборатории я выбрал её наиболее способную общедоступную модель на момент волны оценки. Затем я проверил это охват по общественным рейтингам на 5 августа 2026 (LMArena Elo, Artificial Analysis Intelligence Index, Humanity's Last Exam и SWE-bench Verified): восемь из десяти флагманов занимают место в или около вершины по крайней мере одного рейтинга общих возможностей, а двое (Mistral, Baidu) включены для сохранения охвата лабораторий и регионов, а не по рейтингам (см. ограничения охвата ниже). Одиннадцатая лаборатория, Meta, флагман которой стал доступен только после определения волны, была добавлена в процессе; её сбор был прерван отзывом доступа и сообщается как частичный (см. ниже).
Таблица 8. Оцениваемые флагманские модели и позиции в рейтингах (на 5 августа 2026)
| Лаборатория | Флагманская модель (ID API) | Страна | Позиции в рейтингах (5 авг. 2026) |
| OpenAI | gpt-5.6-sol | США | AA Index #3 (58,9); LiveBench #1 (82,4); Arena top-6 cluster |
| Anthropic | claude-fable-5 | США | Arena #1 (~1525 Elo); AA Index #2 (59,9); SWE-bench Verified #1 (95,0) |
| gemini-3.1-pro-preview | США | SWE-bench Verified #8 (80,6); HLE #17 (51,4); Arena upper cluster | |
| xAI | grok-4.5 | США | AA Index #8 (53,8); Arena Elo 1499 |
| DeepSeek | deepseek-v4-pro | Китай | SWE-bench Verified #8 (80,6, Pro-Max); HLE #23 (48,2) |
| Alibaba | qwen-max (Qwen 3.7 Max) | Китай | Arena #21 (1488–1496 Elo); SWE-bench Verified #11 (80,4) |
| Moonshot AI | kimi-k3 | Китай | AA Index #4 (57,1); HLE #9 (56,0); Arena #10 (1500) |
| Zhipu (Z.ai) | glm-5.2 | Китай | AA Index #13 (51,1); HLE #11 (54,7) |
| Mistral | mistral-medium-3.5 | Франция | Ниже топ-50 на основных таблицах лидеров; включена для регионального охвата |
| Baidu | ernie-4.5-vl-424b | Китай | Вне общего топ-30 (ERNIE 5.0: HLE #36); ERNIE 5.1: LMArena Search Arena #4 |
| Meta (добавлена в середине волны, частичная) | muse-spark-1.1 | США | HLE #4 |
Показатели в скобках — значения, указанные агрегатором на дату снимка; позиции в таблицах лидеров незначительно варьируются между агрегаторами и датами снимков. Источники снимков архивируются вместе с записями запусков, сопровождающими пакет репликации.
Протокол взят из первого эксперимента, зафиксирован и повторно использован: та же подвыборка SimpleQA из 1500 элементов (зафиксирована по seed и хешу), один слепой проход на модель, температура ноль, идентичные системный промпт и парсер ответов, заявленная уверенность 0–100 на ответ. Оценивание детерминировано (точное и нормализованное совпадение строк с эталоном; отказы учитываются как ошибки; неразрешённые элементы исключены из основного результата и переоценены как ошибки в анализе чувствительности), и ни один LLM судья не касается основных цифр результата. Это намеренное усиление по сравнению с первой волной, грейдер которой был гибридным: объективное совпадение строк с локальным судьёй открытого веса, разрешающим остальное (66,5% вердиктов выносит модель; проверка 50 элементов человеком, 98% совпадение). Эта волна использует только детерминированный механизм эквивалентности (вручную валидирован: 20 из 20 отмеченных разногласий и 15 из 15 согласованностей подтверждены вручную), поэтому каждая основная цифра этой волны воспроизводится бит-в-бит из выпущенного скрипта. Межволновые сравнения абсолютной точности, следовательно, также пересекают режимы грейдеров, и каждое сравнение июль-август имеет квалификатор режима грейдера. Внутриволновые аудиты поддерживают цифры каждой волны, но межволновые дельты смешивают изменение модели с изменением грейдера, если только один грейдер не переприменяется к обоим замороженным наборам ответов, чего здесь не было сделано. Одно отклонение по усилиям: рука OpenAI была собрана при усилии рассуждения интерфейса по умолчанию (medium), где июльский протокол использовал minimal, без доступа в сеть или инструментов при инференции (проверено перечислением инструментов, доступных модели, из которых не было никаких). Это смещает абсолютную точность этого поставщика, не механизм согласования (раздел 5). Ошибка при высокой уверенности — это неправильный ответ, предложенный при указанной уверенности ≥ 80; пороговое значение было зафиксировано перед запуском, с 70 и 90, указанными как чувствительность. Охват объединения составляет 1500/1500 вопросов для десяти из одиннадцати лабораторий. Сбор данных Meta достиг 272 действительных ответов перед тем, как доступ был отозван.
Я также непосредственно протестировал проблему кросс-режима. Переоценивание июльской волны шестнадцать моделей замороженным детерминированным механизмом второй волны (который заменяет гибридный конвейер, который выносит 66,5% вердиктов локальным судьёй открытого веса) изменяет 2,65% разрешённых вердиктов (566 из 21338; механизм воздерживается еще на 4,1%) и не движет основные цифры: при одном детерминированном кодировании подтверждающие подъёмы читаются 3,6×/4,6×/4,4× перед переоценкой и 3,0–3,1×/4,5–4,6×/4,3× после. Оба выше консервативно опубликованного 1,9–3,2×, которые получены из парного кодирования, прошедшего через LLM, поскольку больше подтверждённых согласованностей означает более консервативные подъёмы. Каждое AUROC в таблицах 6–7 смещается максимум на 0,016 на панелях CN и кросс-блока и на 0,046 на панели США, сохраняя упорядочение согласованности относительно самозаявленной уверенности на каждой панели.
Ярлык флагманской модели ничего не гарантирует. Разрешённая точность на идентичных вопросах варьируется от 11,4% до 95,4% по одиннадцати флагманам (таблица 9), разброс 84 пункта в верхней части рынка, шире чем разброс среднего уровня первого эксперимента. И иллюзия точности остаётся нетронутой на этом уровне: объединённые по десяти полным лабораторным ветвям, 46,6% всех разрешённых ответов, предложенных при указанной уверенности ≥ 80, были неправильными (4910 из 10540; включая частичную ветвь Meta, 46,3%, или 4935 из 10665; неразрешённые элементы здесь исключены и переоценены как ошибки в анализе чувствительности, где объединённая картина не изменилась). Потребительское значение первой волны не смягчается ценой: ярлык флагманской модели не сообщает потребителю, пришёл ли уверенный ответ перед ними с 95%-точного флагмана или 11%-точного.
Таблица 9. Волна флагманов: охват и точность (подвыборка SimpleQA, n = 1500 на лабораторию, температура 0)
| Лаборатория (флагман) | Охват | Точность (разрешённая) | Неразрешённые |
| OpenAI gpt-5.6-sol | 1,500/1,500 | 95.4% (1,403/1,471) | 29 |
| Google gemini-3.1-pro | 1,500/1,500 | 71.1% (837/1,178)¹ | 46 |
| Anthropic claude-fable-5 | 1,500/1,500 | 70.3% (1,019/1,450) | 50 |
| Meta muse-spark-1.1 (частичная) | 272/1,500 действительных | 61.4% (148/241)² | 10 |
| xAI grok-4.5 | 1,500/1,500 | 54.8% (794/1,448) | 52 |
| DeepSeek deepseek-v4-pro | 1,500/1,500 | 46.6% (666/1,428) | 72 |
| Moonshot kimi-k3 | 1,500/1,500 | 45.5% (645/1,418) | 82 |
| Zhipu glm-5.2 | 1,500/1,500 | 30.2% (430/1,425) | 69 |
| Baidu ernie-4.5-vl-424b | 1,500/1,500 | 28.9% (411/1,421) | 71 |
| Mistral mistral-medium-3.5 | 1,500/1,500 | 21.4% (306/1,429) | 71 |
| Alibaba qwen-max | 1,500/1,500 | 11.4% (164/1,435) | 65 |
¹ Канал Google вернул пустые или отфильтрованные ответы на 18,4% элементов (276 из 1500 — свойство доставки, а не проблема охвата: предпринимались попытки по всем 1500); точность рассчитывается на основе проанализированных и разрешённых ответов. Оба определения приводятся: только на ответившие вопросы, точность Google составляет 71,1% (837/1178); если считать 276 недоставленных ответов ошибками, это 57,6% (837/1454) и 55,8% (837/1500), если неразрешённые элементы также считаются ошибками. ² Точность Meta рассчитана на основе ответов, собранных до отзыва доступа; см. ограничения охвата. Точность во всей таблице относится только к разрешённым; при чувствительности к неразрешённым-как-ошибки верхняя цифра, 95,4% OpenAI, становится 93,5% (1403/1500). Происхождение канала для каждого вызова в каждой лаборатории записывается в манифест запуска. Неразрешённые учитывают доставленные ответы, которые не разрешались детерминированно; для Zhipu (доставлено 1494 ответа), Baidu (1492) и частичного подразделения Meta (251) две колонки, таким образом, в сумме дают меньше, чем количество попыток вопросов, остаток составляет недоставленные ответы.
Оговорка о загрязнении данных ограничивает область абсолютной точности. Эта волна повторно использует исходный, общедоступный бенчмарк SimpleQA (октябрь 2024) для моделей, чьи обучающие корпусы датируются позже его публикации на срок до двух лет, поэтому воздействие на бенчмарк во время обучения вероятно в верхней части таблицы, и данные несут конкретный признак этого: лучшая флагманская модель воспроизводит эталонную строку ответа слово в слово (нормализованное точное совпадение, вплоть до форматирования десятичных чисел) в 61,6% элементов, по сравнению с 27,9–45,3% для других лабораторий, при медианной заявленной уверенности 99. Дизайн не может отделить «модель сильнее» от «модель видела бенчмарк и его набор ответов». Абсолютные показатели точности волны, таким образом, несравнимы с исторически сообщаемыми закрытыми потолками для более ранних поколений моделей, и их не следует интерпретировать как меры параметрической памяти. Проверка возраста бенчмарка первой волны (разрыв TruthfulQA–SimpleQA, указанный в разделе 3) охватывала сбор за июль; к августу 2026 года SimpleQA сам по себе — общедоступный двухлетний бенчмарк, и эта оговорка охватывает флагманскую волну. Выводы волны не зависят от абсолютной точности. Они зависят от структуры уверенных ошибок, их распространённости при заявленной уверенности ≥ 80 и их перехвата при помощи шлюза разногласия, измеренных в пределах волны по одному замороженному протоколу, где любое преимущество в экспозиции распределяется между лабораториями, оцениваемыми на одних и тех же элементах. Новый двухуровневый зонд, построенный после окна исследования, непосредственно подтверждает эту сигнатуру. См. «Почему просто не использовать лучшую модель?» далее в этом разделе.
Калибровочный ров. Первый эксперимент показал, что независимое согласие несёт сигнал корректности, который не несёт самостоятельно сообщаемая уверенность. Флагманская волна превращает этот сигнал в измеренный фильтр. Механизм — это шлюз разногласия: совет трёх лабораторий, установленный заранее на основе предыдущего анализа разногласий и не адаптированный к этим результатам (Moonshot kimi-k3, DeepSeek deepseek-v4-pro, OpenAI gpt-5.6-sol), и правило без свободных параметров. Ответ проходит через шлюз только когда три ответа совета согласуются попарно. Поскольку ничего не оценивается, разделение обучение/тестирование не требуется; шлюз вычисляется один раз для замороженного набора.
Рисунок 17. Флагманский шлюз
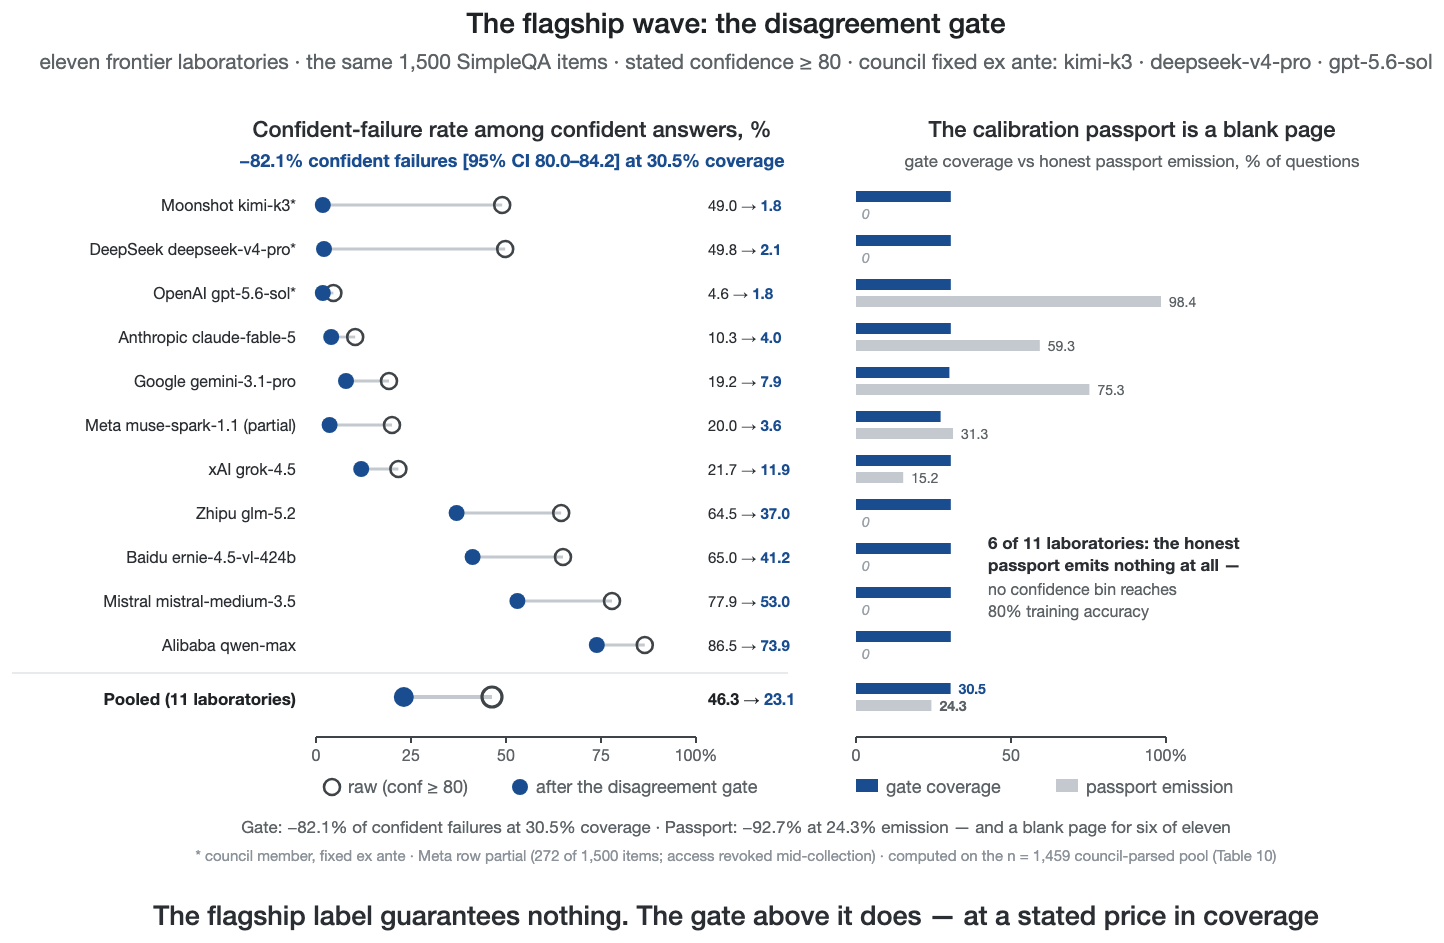
Уверенные ошибки при заявленной уверенности ≥ 80 и их перехват при помощи фиксированного трёхмодельного шлюза разногласия по лабораториям (волна август 2026).
Объединённые по десяти полным подразделениям лабораторий (первичное представление, с частичным подразделением Meta, указанным отдельно и его включением, рассматриваемым как чувствительность), необработанная частота уверенных ошибок составляет 46,6% (4910/10540). Объединённые по одиннадцати лабораториям, показатели по лабораториям различаются (таблица 9), поэтому эта цифра характеризует пограничный состав, а не универсальную константу. Шлюз удаляет 82,1% уверенных ошибок (загрузка 95% ДИ [79,9; 84,1]) при сохранении 30,5% всех объединённых ответов (сам шлюз открывается на 30,6% вопросов, 446 из 1459). При ограничении полными лабораториями вне совета, без какой-либо самосвязи, шлюз по-прежнему удаляет 76,9% уверенных ошибок (ДИ [74,3; 79,2]). Включение частичного подразделения Meta оставляет каждую оценку практически неизменённой: объединённые по всем одиннадцати, необработанная частота составляет 46,3% (4935/10665; 35,8% уверенных ответов проходят через шлюз, и корректность среди выданных уверенных ответов возрастает с 53,7% необработанного до 76,9% после шлюза), шлюз удаляет 82,1% (ДИ [80,0; 84,2]) при тех же 30,5% охвата, и показатель восьми лабораторий вне совета составляет 77,0% (ДИ [74,4; 79,3]). Таблица 10 приводит показатели по лабораториям.
Таблица 10. Перехват уверенных ошибок шлюзом разногласия (conf ≥ 80; детерминированный оценщик; совет = kimi-k3 · deepseek-v4-pro · gpt-5.6-sol, зафиксирован ex ante)
| Лаборатория | Уверенные ответы | Уверенные ошибки, необработанные | После шлюза (частота выданных) | dCF |
| Moonshot kimi-k3 [совет] | 1056 | 517 (49,0%) | 7 (1,8%) | −98,6% |
| DeepSeek deepseek-v4-pro [совет] | 1274 | 634 (49,8%) | 9 (2,1%) | −98,6% |
| OpenAI gpt-5.6-sol [совет] | 1426 | 65 (4,6%) | 8 (1,8%) | −87,7% |
| Anthropic claude-fable-5 | 825 | 85 (10,3%) | 15 (4,0%) | −82,4% |
| Google gemini-3.1-pro | 966 | 185 (19,2%) | 27 (7,9%) | −85,4% |
| Meta muse-spark-1.1 (частичный) | 125 | 25 (20,0%) | 2 (3,6%) | −92,0% |
| xAI grok-4.5 | 577 | 125 (21,7%) | 36 (11,9%) | −71,2% |
| Zhipu glm-5.2 | 1128 | 727 (64,5%) | 146 (37,0%) | −79,9% |
| Baidu ernie-4.5-vl-424b | 725 | 471 (65,0%) | 107 (41,2%) | −77,3% |
| Mistral mistral-medium-3.5 | 1354 | 1055 (77,9%) | 224 (53,0%) | −78,8% |
| Alibaba qwen-max | 1209 | 1046 (86,5%) | 300 (73,9%) | −71,3% |
| Объединённые (11 лабораторий) | 10665 | 4935 (46,3%) | 881 (23,1%) | −82,1% [80,0; 84,2] |
| Объединённые (8 вне совета) | 6,909 | 3,719 (53.8%) | 857 (33.5%) | −77.0% [74.4; 79.3] |
Вычислено на наборе вопросов, на которые все три члена совета дали разобранные, неотказанные ответы (n = 1,459 из 1,500); ворота открываются для 446 из них (30.6%). Мета-строка частична (доступ отозван в процессе сбора). ДИ бутстрепа: 5000 переотборок на уровне вопросов.
К этому результату относятся три вещи. Ворота также отклоняют примерно половину достоверных правильных ответов (ворота сохраняют только 51.3% достоверно правильных ответов; из отклоненных ответов примерно 41% на самом деле были правильными). Это обмен охвата на уверенность, типичный компромисс риск–охват при выборочной классификации (Geifman & El-Yaniv, 2017), реализованный здесь на уровне архитектуры, и эти два числовых значения всегда должны указываться как пара: −82.1% достоверных ошибок при 30.5% охвате. У системы есть собственный нижний предел. В полностью системном режиме, когда открытые ворота выдают консенсусный ответ совета, а не отдельной модели, собственный показатель достоверных ошибок системы составляет 1.8% (8 из 442 разрешенных консенсусных ответов), и эти восемь вопросов — это вопросы, по которым весь совет уверенно согласился с одним и тем же неправильным ответом. Это нижний предел коррелированной ошибки, который первый эксперимент предсказал на основе его граничного условия консенсуса, подтверждающего ошибку: ниже этого предела никакая проверка согласия не помогает, потому что само согласие является ошибкой. И результат одинаков на всей предварительно объявленной сетке параметров чувствительности: пороги уверенности 70/80/90 дают объединенную dCF в размере −83.1%/−82.1%/−80.6%, и пересчет неразрешенных элементов как ошибок дает −81.8%, поэтому число было измерено, а не выбрано.
Коммерческое значение показателя покрытия 30,5% определяется экономикой безубыточности раздела 5 (рис. 14): примерно семьдесят процентов ответов, которые шлюз отказывается сертифицировать, — это запросы, направленные на более экономный путь, чем уверенная ошибка (эскалация к человеку, более глубокая верификация или явное отображение неопределённости), а не потеря конверсий; поэтому стоимость покрытия — это допустимая цена ошибки, а не упущенный спрос. Здесь не оценивается модель затрат для канала эскалации. Рабочая точка не зафиксирована. Лестница согласия, показанная на рис. 19, предоставляет семейство пороговых значений, и сервис должен находиться в том месте, где ожидаемые затраты на необнаруженный уверенный отказ пересекают маржу на трафике, который удерживает шлюз, что делает это выбором, основанным на затратах.
Рис. 14. Экономика многоуровневого доверия
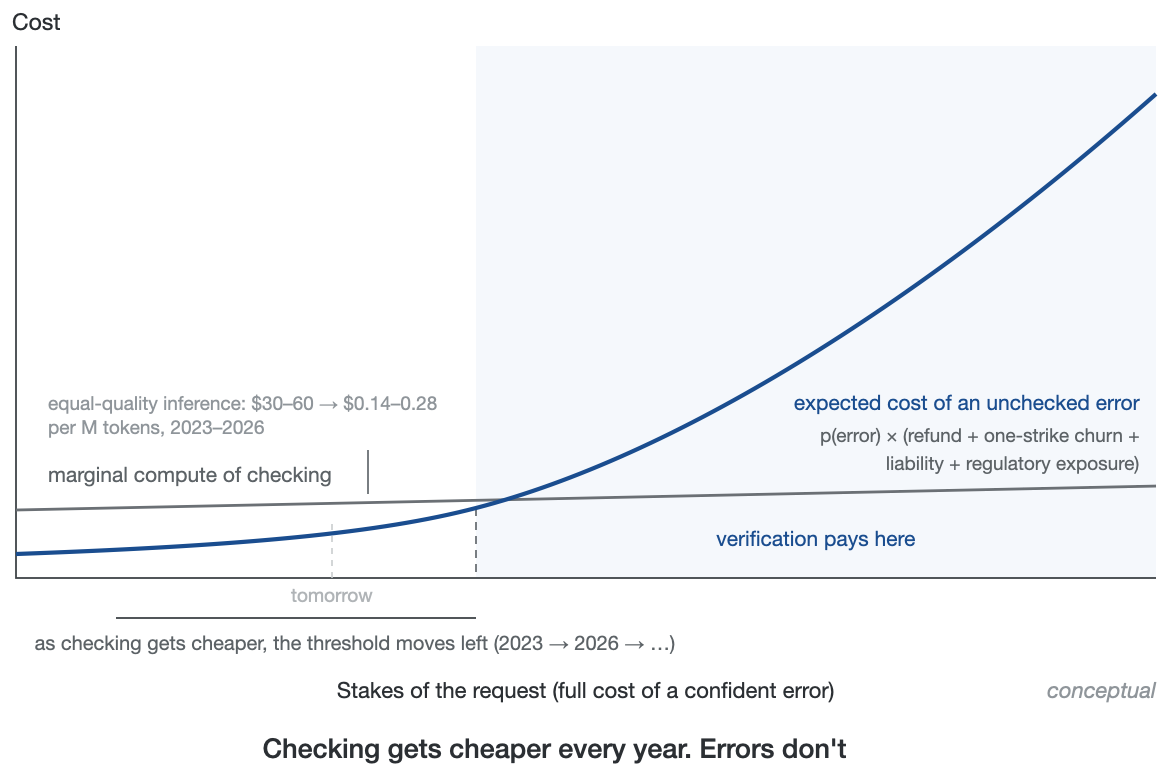
Логика безубыточности проверки.
Почему просто не использовать лучшую модель? Самый сильный базовый вариант, который волна оставляет нетронутым, — коммерческий, а не статистический: оператор может обойтись без архитектуры и направить всё на самый точный флагманский вариант волны. Этот базовый вариант требует ответа с числами. По ценам середины 2026 года замороженный совет трёх лабораторий обходится в $0.0039 за вопрос — дешевле, чем один ответ от самого дорогого флагманского варианта волны (claude-fable-5, $0.0198/вопрос по прайс-листу) и дороже, чем один от самого точного (gpt-5.6-sol, $0.0027/вопрос по опубликованным тарифам API). «Просто купи лучший флагман» — это истинная точка Парето: gpt-5.6-sol в одиночку отвечает на каждый вопрос с уровнем уверенных ошибок 4,6%, и ни одна конфигурация с фильтром не достигает его покрытия при любой цене. Везде, где сервис может допустить уверенную ошибку примерно на один ответ из двадцати и нуждается в полном покрытии, флагман побеждает по обеим осям. Однако это правило плохо обобщается даже в верхней части рейтинга: второй кандидат консенсуса волны, claude-fable-5, показывает уровень уверенных ошибок 10,3% в одиночку. «Просто используй любую модель, которая лидирует в бенчмарках» полностью не срабатывает на вторую по мощи модель в выборке, что и объясняет, почему проблема идентификации ниже — не гипотетическая. Четыре соображения ограничивают это сравнение.
Во-первых, проблема идентификации: знание того, какая модель в настоящее время лучшая, само является продуктом внешнего кроссмодельного измерения. Собственная таблица 8 волны выбирала своих флагманов из открытых рейтингов — непрерывных сравнений третьей стороны, кроссвендорных, которые никто не предлагает заменять самоотчётом поставщика. Собственные данные этой статьи показывают, почему: заявленная уверенность различает показатели при AUROC 0,53–0,79 в зависимости от поставщика, и разброс точности в 84 пункта разделяет модели, все продаваемые как лучшие в своей лаборатории. «Направление на лучшую модель» является, следовательно, применением архитектурного доверия, а не альтернативой ему: рейтинг, коронующий флагман, — это независимая комиссия, слепые элементы и опубликованная запись, три компонента раздела 3, работающие в масштабе рынка. И эта корона движется: лидерство в корпоративных моделях сменилось за одну весну (Kharazian, 2026), модели обновляются молча под стабильными названиями, и поведение покупающих агентов резко меняется при обновлениях моделей (Allouah et al., 2026). Без непрерывного внешнего измерения «лучшая модель» недоступна оператору как знание.
Во-вторых, эти 95,4% — это отчасти память, а не возможность: лучший флагман воспроизводит строку эталонного ответа дословно в 61,6% элементов (оговорка о контаминации в таблице 9), поэтому его измеренное преимущество сжимается на вопросах, которые бенчмарк не мог научить. Механизм фильтра не наследует эту хрупкость: на слое, наименее подверженном запоминанию, он удаляет 89,4% уверенных ошибок — это его лучшая производительность, а не худшая (анализ, стратифицированный контаминацией, ниже), потому что согласие между независимо обученными лабораториями не зависит от корпуса обучения какого-либо поставщика.
Чтобы отделить передаваемые знания от влияния бенчмарка, я составил новый 100-элементный двухходовой зонд, гарантированно свободный от контаминации, автоматически сгенерированный 6 августа 2026 года из пар независимо проверённых фактов Wikidata до 2023 года (например, «В каком году родился архитектор [небольшого здания]?»), каждый с единственным вычисленным ответом, так что составленные вопросы не могли появиться ни в одном корпусе обучения. Хеш SHA-256 набора был зафиксирован до первого вызова модели.
При замороженном протоколе волны (дословная системная подсказка, температура 0, одинаковый детерминированный оценщик) gpt-5.6-sol упал с точности 95.4% и коэффициентом уверенных ошибок 4.6% на SimpleQA до 33.0% [бутстреп 95% ДД 24.0–42.0] с уверенными ошибками на 61.0% [51.0–70.0] своих пунктов (67.0% своих уверенных ответов), его средняя заявленная уверенность едва изменилась (98.4 → 93.7), тогда как claude-fable-5 остался на 76.0% [67.0–84.0] и 6.0% [2.0–11.0]. Разрыв флагманов волны в 25 пунктов инвертируется в дефицит 43 пункта на гарантированно новых композициях. Врата совета, неизменные с волны, поглотили эту ошибку: они удалили все кроме одной из 61 уверенной ошибки gpt-5.6-sol (60/61; при n = 61 точечный коэффициент неточен, доверительный интервал Вильсона 95% ≈ 91–99.7%; охват 24.2%; claude-fable-5: 6 → 1), снизив коэффициент уверенных ошибок среди выданных высокоуверенных ответов до 4.5% в сравнении с необработанными 67.0%.
Уровни не сравнимы поточечно между тестами: двухслойная композиция внутренне сложнее однослойного поиска, и при n = 100 интервалы широкие. Но обращение упорядочивания моделей и устойчивость врат совета на пунктах, которые ни одна модель не могла запомнить, — это в точности сигнатуры, которые предсказывает объяснение контаминацией, и они — режим отказа, который строить призваны архитектурный уровень доверия, а не выбор более совершенной модели.
Третье, существует нижний предел. Врата достигают коэффициента уверенных ошибок, которого ни одна отдельная модель не достигает ни при какой цене: конфигурации с вратами совета снижают уверенные ошибки на выданных ответах до 1.8–2.1% при $0.0039–0.0046 за вопрос, что в 2.5× ниже лучшей одиночной частоты, тогда как самый дорогой флагман волны имеет 10.3% уверенных ошибок при $0.0198 за вопрос, доминирующий по всем направлениям. Врата — не спасательное устройство для слабых моделей: qwen-max позади тех же врат всё равно ошибается уверенно на 73.9% своих выданных уверенных ответов, поэтому пункты границы с вратами совета — советы сильных моделей, а не врата над слабыми.
Четвёртое, когда агент расходует средства самостоятельно, ключевой вопрос смещается с «какая модель умнее» на «какая конфигурация может доказать, что она сделала». Несмотря на её точность, отдельный флагман не может удостоверить собственное решение и не может арбитрировать собственный конфликт интересов. Конфигурация с вратами совета создаёт проверяемый протокол согласия на каждый ответ. Это результат, который рынки ответственности и страхования раздела 5 уже оценивают, где страховое покрытие выписывается на основе доказательств, а исключения формируются их отсутствием.
Решение — граница, а не победитель. Флагман — самый сильный член совета (замороженный совет его включает), но он не может служить собственным судьей. Таблица лидеров, которая его определяет, уже опирается на тот же принцип, который воплощает архитектурное доверие, независимую кросс-модельную верификацию, но она обеспечивает эту верификацию только в совокупности, о моделях в целом, а не об ответе перед потребителем. Конструкция заполняет этот разрыв, и разрыв её также ограничивает: утверждение, не опирающееся ни на какую независимую проверку, находится вне архитектурного доверия, а не является его частным случаем. Реальный выбор оператора — между классами риска: полное покрытие при 4.6% уверенных ошибок или 31% охват при 1.8% с аудиторским следом, компромисс селективной классификации, оценённый здесь. Полная граница соотношения цена–охват–риск на 26 конфигураций (каждый одиночный флагман, каждая конфигурация с вратами совета и объединённые лестницы согласия с выставленной и уставной ценовой основой, отмеченной за каждый пункт) выпускается как CSV с пакетом репликации.
Очевидный соперник вратам разногласия — исправление калибровки одиночной модели: выучить отображение доверие-к-точности каждой модели и выдавать только там, где откалиброванная точность превышает порог, программа апостериорной рекалибровки, чьи стандартные средства — температура и масштабирование Плата (Guo, Pleiss, Sun, & Weinberger, 2017). При подгонке на непересекающихся половинах (доверие в гистограммных бинах, обучение на вопросах с чётными индексами, оценка на нечётных, бины менее чем с 20 наблюдениями не выдаются), этот паспорт калибровки удаляет 92.7% уверенных ошибок, но при 24.3% выдачи, и шесть из одиннадцати флагманов не выдают ничего вообще: ни один бин доверия их не достигает 80% точности обучения, поэтому паспорт для этих моделей — пустая страница. Для половины флагманского рынка одиночная калибровка модели не может быть исправлена извне. Врата разногласия держат примерно 30% охват для каждой модели в таблице, включая шесть, которых паспорт оставляет без внимания. Таким образом, вывод первого эксперимента сохраняется и на этом уровне: архитектура может предоставить внешний сигнал корректности там, где явная уверенность модели не работает в качестве такого сигнала, в ранжировании или на уровне, измеренном снова на уровне, на который потребители полагаются больше всего.
Робастность эффекта врат. Два управляемых судьёй проверки имеют значение: цикличность, опираются ли врата на своего сильнейшего члена, и работает ли что-то тривиальное на равных. Замена сильнейшего члена совета (gpt-5.6-sol, 95.4% разрешённая точность) четвёртым прогнозируемым запуском границы волны (grok-4.5) оставляет результат по существу неизменным. Совет без sol удаляет 81.2% объединённых уверенных ошибок при 29.7% охват (целевые не-совета: 77.6%) против 82.1% при 30.5% для замороженной тройки, и во всех 165 возможных трёхмодельных советах механизм никогда не отказывает: каждый совет удаляет больше уверенных ошибок, чем случайное воздержание при собственном охвате (медианное превышение +8.5 пункта), с прогнозируемой тройкой в топ 4% по этому показателю (+12.6 пункта). Эффект принадлежит кросс-модельному согласию, а не какому-либо члену в отдельности. Порогирование собственного заявленного доверия каждой модели на идентичном охват-на-модель, тривиальный базис, удаляет только 66.7% объединённых уверенных ошибок, менее чем 69.5%, которые слепое случайное воздержание при равном охвате удаляет, поскольку уверенные ошибки по конструкции сосредоточены при высоком заявленном доверии. Этот порог также сохраняет меньше уверенно-правильных ответов, чем врата (46.4% против 51.3%). Врата парето-доминируют оба базиса для каждой из одиннадцати лабораторий. Использование согласия за-ответ только с сильнейшей моделью в качестве фильтра — ещё более сильный экран (97.1% объединённых уверенных ошибок удалено при 40.7% охват, сохраняя 97.0% уверенно-правильных ответов), но это механически иное, зависящее-от-цели правило. Оно принимает ответ только после инспекции, тогда как врата совета открывают один и тот же фиксированный набор вопросов для каждой модели без просмотра ответа под испытанием, поэтому оно ограничивает эффект совета без объяснения: без sol тройка всё равно удаляет 81.2%, и даже согласие с судьёй-одиночкой слабым (kimi-k3, 45.5% разрешённая точность) удаляет 86.3% уверенных ошибок. Движущей силой является само кросс-модельное согласие, тогда как точность судьи проявляется в том, что сохранено (сохранено-правильно 97.0% для sol против 20–63% для более слабых судей).
Калибруемое воздержание обеспечивает более сильные конкурирующие базовые показатели, и они также были запущены. Две калибруемые базовые линии воздержания были подогнаны при разделении, идентичном паспорту калибровки (параметры подогнаны на элементах с четными индексами, оценены на удерживаемой нечетной половине, где замороженный вентиль удаляет 82,2% ошибок с высокой уверенностью при охвате 30,8%). Базовые показатели для отдельных моделей не достигают вентиля. Доверие в масштабе Платта с охватом для каждой модели, соответствующим вентилю, удаляет 65,3% ошибок с высокой уверенностью, а расщепленно-конформное воздержание (α = 0,293, откалибровано для гарантии P(emit | wrong) ≤ α и настроено на тот же охват) удаляет 70,8%, как и необработанное управление доверием top-K при одинаковом объединенном охвате, которое удаляет 69,4%. Объединенный вариант, который ранжирует ответы всех одиннадцати лабораторий по единой откалиброванной по Платту шкале вероятности, превосходит вентиль (89,0% при идентичном объединенном охвате), но достигает этого путем переназначения по сути всего охвата хорошо откалиброванным лабораториям: он выпускает 100% ответов наиболее хорошо откалиброванного поставщика и 0% для четырех из одиннадцати лабораторий, воспроизводя в более мягкой форме режим отказа паспорта выше. Кроме того, для его подгонки требуется примерно семьсот оцененных ответов на модель, тогда как вентилю это не требуется. Калибруемое доверие и кросс-модельное согласие, таким образом, являются дополнениями, а не заменителями: первое обеспечивает более низкую объединенную частоту ошибок везде, где существуют истинные метки для его обучения, а второе обеспечивает единообразную защиту каждой лаборатории без меток.
На рис. 19 каждая стратегия размещена на плоскости селективного предсказания (объединено по 13 955 детерминированно разрешенным ответам, которые одиннадцать ветвей вернули в замороженный пул из 1459 вопросов, поэтому итого меньше, чем в таблице 9, которая считает разрешенные ответы по всем 1500 вопросам; селективный риск = доля выпущенных ответов, которые неверны). Ранжировано по площади под кривой риск-охват, ниже лучше: откалибровано по Платту доверие 0,258, лестница вентилей, уточненная указанным доверием 0,321, лестница чистого согласия 0,356, указанное необработанное доверие 0,367, случайное воздержание 0,517, против оракула нижнего предела 0,166; значения удержанной половины различаются не более чем на 0,009. На собственной точке работы замороженного вентиля (охват 31,1% в этом соглашении разрешенных ответов, 4334 из 13 955 выпущенных ответов; 30,5% и 30,6%, о которых сообщается в других местах, являются долями ответов с высокой уверенностью и вопросов пула) риск вентиля составляет 24,9%, против 33,4% для порога необработанного доверия и 14,0% для откалиброванного доверия, с учетом оговорок о стоимости метки и концентрации охвата выше. Облако всех 165 трехмодельных советов охватывает охват 9–59% при рисках 13–38%, поэтому сообщаемый вентиль является представительным членом своего семейства, а не настроенным выбросом. Однозначные вентили отслеживают вырождающийся конец семейства, где «согласие» сводится к «спросите самую точную модель».
Рис. 19. Граница риска-охвата
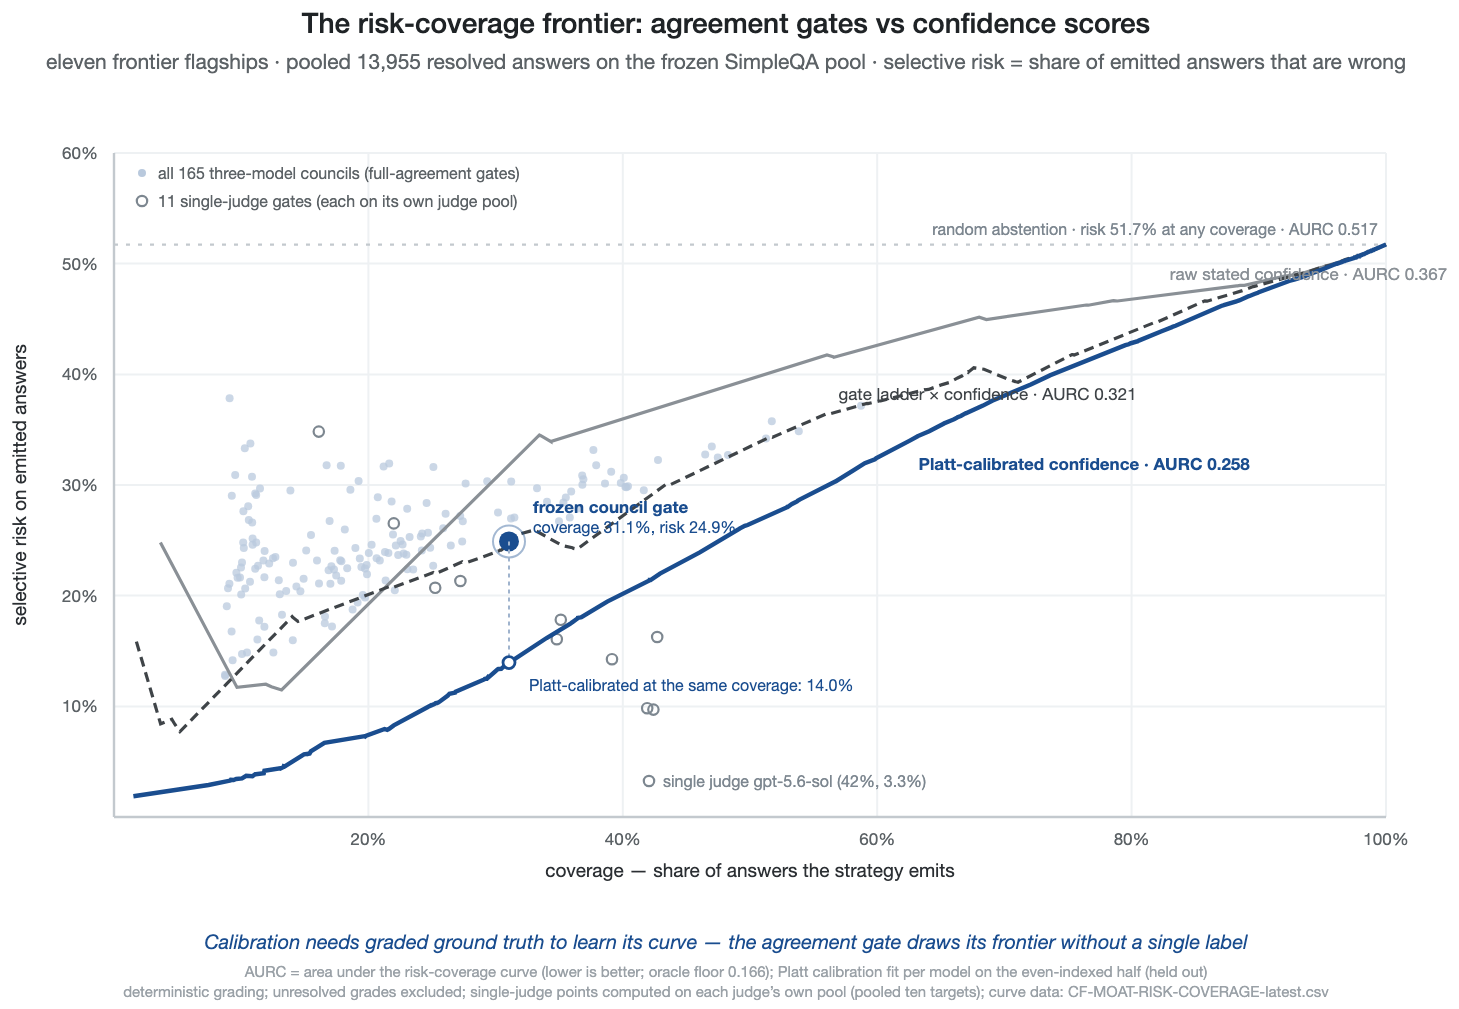
Каждая стратегия воздержания на плоскости селективного предсказания, охват против селективного риска, объединено по 13 955 детерминированно разрешенным основным ответам, возвращенным одиннадцатью ветвями в замороженный пул из 1459 вопросов (таблица 9 считает разрешенные ответы по всем 1500 вопросам): кривые необработанного доверия, откалиброванного по Платту и лестницы вентилей-×-доверие с их значениями AURC, линия случайного воздержания, облако всех 165 трехмодельных советов, одиннадцать однозначных вентилей и рабочая точка замороженного совета (охват 31,1% в соглашении разрешенных ответов, 4334 из 13 955; риск 24,9%). Ниже лучше; оракула нижний предел составляет 0,166. Каждая точка пересчитывается из CSV риска-охвата пакета репликации.
Согласие может не содержать информацию, выходящей за пределы простоты вопроса. Чтобы проверить это, была проведена логистическая регрессия правильности ответа на согласие вентиля и сложность элемента (доля неправильных ответов среди других моделей для этого вопроса), с фиксированными эффектами лаборатории и кластеризованными по вопросам стандартными ошибками, и ответ зависит от того, как измеряется сложность. При сложности, измеренной только моделями, не входящими в совет (справедливый контроль, поскольку мера сложности, которая включает собственные ответы совета, встраивает сигнал вентиля по конструкции), согласие сохраняет независимый вклад в целевые показатели внешней лаборатории: b = +0,76, отношение шансов 2,15, z = 17,2. Ответ, выпущенный вентилем, имеет примерно в два раза больше шансов быть правильным, чем одинаково сложный ответ, который вентиль удержит. Если вместо этого включить собственную правильность совета в регрессор сложности, коэффициент согласия обратится в нуль, что количественно определяет механизм, а не опровергает его: согласие и многомодельная сложность — это два измерения одной скрытой величины, а вентиль является инструментом без меток для чтения его во время вывода.
Повторный анализ, стратифицированный по загрязнению, непосредственно решает проблему воздействия. Если отметить вопрос как вероятно подверженный бенчмарку, когда по крайней мере три из одиннадцати лабораторий воспроизводят золотую строку дословно после нормализации (741 из 1459 вопросов пула; та же сигнатура, которая дает 61,6% золотого эхо-показателя gpt-5.6-sol), вентиль удаляет 89,4% ошибок с высокой уверенностью на слое без воздействия (2793→296; целевые показатели без совета: 86,5%) против 72,7% на подверженном слое. Таким образом, механизм не основывается на запомненных элементах. Он ведет себя как должен селективный фильтр, открываясь гораздо реже, когда панель действительно неуверена (охват 18,7% против 41,9%) и поддерживая почти постоянную скорость выпущенных ошибок с высокой уверенностью в пределах слоев (25,9% против 21,8%, исходя из необработанных показателей 58,5% и 36,4%). Пороги воздействия 2–5 эхо-моделей дают не подвергнутые воздействию dCF 87,7–89,7%, поэтому результат устойчив к пороговым значениям. Стратификация описательна: золотое эхо связано с результатом и отделяет вероятно видимые вопросы от других, а не выявляет загрязнение причинно-следственно.
Что дает более крупный бюджет рассуждений: уверенность, а не компетентность. Флагманские поставщики теперь предлагают второй регулятор над выбором модели: бюджет рассуждений, оцениваемый за токен скрытого обдумывания. Если расширенные рассуждения обеспечивали бы калибровку, это был бы ответом на уровне модели на проблему этой статьи, доступным при оформлении. Парный эксперимент на одном флагманском решении показывает, что он покупает что-то иное. Google's gemini-3.1-pro (чьи рассуждения нельзя отключить) ответила на один и тот же замороженный набор вопросов при двух бюджетах: параметр низких усилий рассуждений и динамический бюджет по умолчанию поставщика с температурой ноль, идентичными подсказками и парсером, а стоимость по каждому вопросу была записана. На 233 вопросах, на которые ответили при обоих бюджетах на момент версии: точность 75.1% (низкая) против 76.4% (по умолчанию), без обнаруживаемых различий (точный McNemar p = .648); выраженная уверенность на 3.1 пункта выше при бюджете по умолчанию (Wilcoxon z = 4.68, p < .0001); калибровка немного хуже при бюджете по умолчанию (парная ECE 0.100 против 0.082; разрыв уверенность минус точность +9.3 против +7.5 пункта); цена за вопрос 2.1×. Сравнение точности — нулевая гипотеза особого рода: эти данные показывают отсутствие обнаруживаемых различий точности при n = 233 (точный McNemar p = .648), и эквивалентность формально установлена только при грубом допуске. Парный TOST ограничивает разницу точности в диапазоне ±5 пункта (разница +1.3 пункта, 90% ДИ [−1.8; +4.4]; обе односторонние p ≤ .024), но исследование не имеет мощности для установления эквивалентности при ±2–4 пункта, в то время как подъем на +3.1 пункта в выраженной уверенности статистически однозначен (Wilcoxon p < .0001). В этих пределах удвоенные расходы приобрели дополнительную выраженную уверенность и никакую измеримую дополнительную правильность: чрезмерная уверенность как платный признак, и внутримодельный пример тезиса миграции. Дополнительные доллары ушли на уровень модели и произвели ничего, что потребитель мог бы проверить, в то время как архитектурный уровень над ним превратил уверенность в проверяемый сигнал. Результат — это пилот, доложенный как таковой: сравнение охватывает 233 парных вопроса, и полная конструкция с 1500 парами сужает границы эквивалентности примерно до двух пункта; состав канала и цензура по потолку токенов документированы как смешивающие факторы в пакете репликации; сбор продолжается.
Рисунок 18. Что дает более крупный бюджет рассуждений
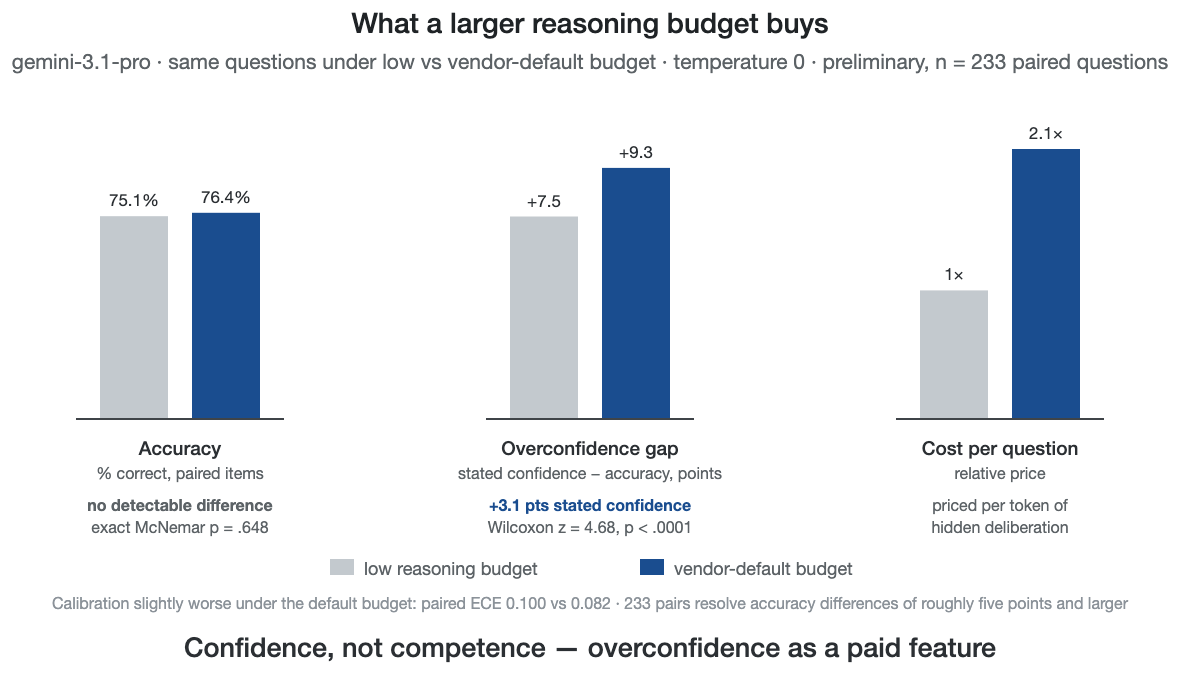
Парное сравнение при двух бюджетах рассуждений — выраженная уверенность растет, точность не растет.
Таблица 11. Бюджет рассуждений, парное сравнение (gemini-3.1-pro, 233 вопроса, на которые ответили при обоих бюджетах, температура 0; предварительно)
| Бюджет низких рассуждений | Бюджет по умолчанию поставщика | |
| Точность (парные элементы) | 75.1% | 76.4% (McNemar p = .648) |
| Средняя выраженная уверенность | −3.1 пункта против по умолчанию | +3.1 пункта (Wilcoxon p < .0001) |
| Калибровка (парная ECE) | 0.082 | 0.100 |
| Разрыв уверенность − точность | +7.5 | +9.3 |
| Стоимость за вопрос (относительно) | 1× | 2.1× |
Параметры усилия рассуждений не были идентичны между группами: каждого поставщика запросили через его стандартный коммерческий интерфейс при усилии этого интерфейса по умолчанию (параметры записаны по модели в пакете репликации), поэтому абсолютная точность поставщика может иметь компонент усилия. Это не достигает механизма. Ранжирование точности не является несущим (флагманский ярлык ничего не гарантирует), барьер выживает при удалении любого члена (совет без решений удаляет 81.2%), и большее усилие поднимает выраженную уверенность при плоской точности, как парное сравнение только что показало, поэтому любая точность, которую оно увеличивает, появляется как уверенная ошибка, отказ, который барьер перехватывает.
Ограничения покрытия волны флагманских моделей. Волна — это снимок, замороженный на 5 августа 2026 года, поэтому модели, выпущенные позже, такие как Grok 4.6 (12 августа) и более поздние лидеры Artificial Analysis, такие как Claude Opus 5, выпущены после этого и не могут войти в предварительно согласованный тест. Верхняя позиция изменилась в течение дней. Это проблема идентификации, которую барьер обходит (согласие устойчиво к изменениям списка, сохраняясь при удалении любого члена). Две включенные лаборатории падают ниже текущей границы в общих лидербордах возможностей: флагман Mistral отстает от лучшего уровня по каждому проверенному совокупному индексу, и общего назначения ERNIE Baidu занимает место за пределами топ 30 на Humanity's Last Exam (его сила в поиске-расширенных и агентных задачах, где ERNIE 5.1 занимает место #4 на LMArena Search Arena). Они сохранены для сохранения охвата европейской экосистемы и всех основных китайских лабораторий. Из двух лабораторий лучшего уровня, которые вместо этого находились за пределами объема волны, Meta Superintelligence Labs (Muse Spark 1.1; #4 на Humanity's Last Exam) и ByteDance (Seed 2.1; #10), одна впоследствии была попытана и прервана (Meta, ниже) и одна вообще не могла быть достигнута (ByteDance, ниже).
ByteDance's Seed 2.1 не могла быть включена: BytePlus ModelArk вернула «недоступно в вашей стране/регионе» для свежезарегистрированного международного аккаунта (живая попытка, 5 августа 2026), ни один агрегатор не обслуживает флагман, и домашний канал Volcano Ark требует проверки материковой части Китая. ERNIE 5.1 Baidu, текущий флагман, аналогично ограничена домашней платформой Qianfan (живая попытка, 5 августа 2026). Если текущий флагман лаборатории недоступен, правило отката — это самая сильная открыто выпущенная модель из той лаборатории. Для Baidu это ERNIE 4.5 VL 424B (открытые веса), который используется вместо этого. Это находка сама по себе: текущие флагманы двух из шести основных китайских лабораторий недоступны для внешних исследователей по состоянию на август 2026 года.
Meta — третий отказ в доступе волны, и препятствием был мой аккаунт, а не география. В первой волне (среднего уровня) Meta отсутствовала по задокументированной инфраструктурной причине: её первосторонний API Llama был снят с обслуживания 6 июля 2026, перед заморозкой протокола (записано в манифесте запуска), и лаборатория была представлена на локальном уровне своей открытовесовой моделью Llama-3.2-3B, которая оказалась одним из самых поучительных членов панели (самая низкая корреляция ошибок во всей матрице). Для флагманской волны модель Meta muse-spark-1.1 была добавлена в середине волны, когда она стала доступной, и сбор затем не прошел тремя способами подряд, каждый был записан: (i) ключ API Meta Model первой стороны перестал работать в середине запуска 5 августа с 251 собранным валидным ответом, и консоль разработчика отказалась выдать замену; (ii) маршрут резервного агрегатора дал ещё 21 ответ перед тем, как (iii) конечная точка провайдера Meta начала возвращать HTTP 403 `user_blocked`, «доступ был ограничен из-за повторных нарушений политики», для закрытых вопросов припоминания фактов из открытого бенчмарка, заданных при температуре ноль. Чистый результат — 272 из 1500 пунктов (18,1%) собраны и сообщены как частичные: замороженный объединённый анализ включает 251 первостороннего ответа (дополнение агрегатора пришло после заморозки анализа), и оценка Meta по лаборатории (−92,0% dCF на 125 уверенных ответов) директивно согласуется с панелью, но слишком неточна для вывода. Блокировка сама по себе — находка: по состоянию на август 2026 независимый исследователь не может завершить 1500-вопросную факт-оценку флагмана Meta через какой-либо авторизованный канал. Между ними три отказа в доступе волны — регионально заблокированный флагман (ByteDance), флагман только для внутреннего рынка (Baidu) и запрет на исследователей (Meta) — представляют теоретический аргумент в эмпирической форме: проверяемость на уровне модели существует по благодати поставщика, и архитектурный уровень доверия не может рассчитывать на благодать поставщика.
4. Крайний случай развертывания: делегирование с необратимыми ставками
Обычный способ изучения доверия потребителей — опрос или лабораторная задача. У меня было более суровое средство: расширённое развертывание с высокими ставками, в котором каждое последствие падало на меня. Этот раздел — доказательство существования и свидетельство дизайна от одного конфликтного оператора, а не эмпирическое доказательство общности, и ни один из P1–P5 не опирается на него. Два типа доказательств переплетаются. В лаборатории эффект калибровки измерялся под плацебо-контролем; в развертывании, где ошибки были необратимыми, те же три свойства различали возможность делегирования от безрассудства.
Развертывание — не клиентское и не моделирование: я одновременно оператор, разработчик и аналитик. Уровень доказательства закреплён хешем, и каждое измерение независимо пересчитываемо, поэтому конфликт касается сторонничества и того, что я выбрал измерять, а не того, воспроизводятся ли цифры. Сеттинг сочетает обычную компетентность потребителя с необратимыми ставками, где каждая архитектурная слабость карается быстро и наглядно.
Методологически это экстремальный, показательный единичный случай (Yin, 2018) в интерпретивной и аналитико-автоэтнографической традиции (Walsham, 1995; Gould, 1991; Anderson, 2006) с учётом осторожности в отношении доказательств, принятой в этой традиции (Wallendorf & Brucks, 1993): записи в первую очередь, интерпретация обозначена как интерпретация. Обоснование — в возможности доступа: исследователь не может этически назначить участников ставить необратимые реальные результаты на архитектуру ИИ, поэтому единственный доступный наблюдатель — участник, который выбрал пари сам.
Анализ опирается на синхронные, закреплённые хешем логи. Уровень доказательства развертывания сам по себе является записью: критически важные шаги (какие модели были проконсультированы, где они расходились, что было заблокировано, что я подтвердил) были записаны в момент события, поэтому наблюдения основаны на воспроизводимых записях, а не на памяти одной. Смещение задним числом нельзя исключить из интерпретации, поэтому я отмечаю каждое место, где интерпретация превышает запись. Записи периода развертывания уровня доказательства системы закреплены хешем по состоянию на 2 августа 2026: манифест SHA-256 по файлам из 129 файлов (7 414 043 байта), корневой хеш которого 2f88a16611e51c0c12c8015754c89269e782ea167a89b5ed2a881f18eee4defc, и якорь опубликован при этой статье. Записи остаются запечатанными до закрытия развертывания, потому что выборочное цитирование из активного развертывания было бы хуже, чем полное отсутствие цитат. Обязательство можно проверить: любая запись, выпущенная позже, либо совпадает с закреплённым манифестом, либо не совпадает, поэтому ретроактивное редактирование, подмену или задним числом датирование может обнаружить любой читатель этой страницы. Более полное количественное рассмотрение телеметрии остаётся на будущее по той же причине.
Три наблюдения из жизни внутри этого цикла предлагаются как гипотезы о том, что переносится за пределы исходной обстановки, питая утверждения раздела 3, и события, на которых они основаны, были записаны развертыванием в момент их возникновения.
Разногласие — сигнал, доступный потребителю. Когда независимые модели расходились в ответе на существенный вопрос, само расхождение, выявленное вместо подавления, показало мне, где лежит подлинная неопределённость: бесплатное раннее предупреждение, которое не способна обеспечить ни одна одномодельная система.
Доказательство меняет поведение раньше, чем оно изменит спор. Знание того, что каждый существенный шаг был записан, сделало делегирование психологически жизнеспособным; запись была предусловием полагаться на систему, а не аудитом постфактум.
Доверительный контроль доступа имеет большее значение, чем средняя точность. Практически опасные события были уверенными ошибками, никогда посредственными выводами. Реальный вклад архитектуры состоял в том, чтобы сделать высокую уверенность дорогостоящей: ответ должен был пережить согласованность между моделями, чтобы заработать её, вместо того чтобы получить её даром от беглости одной модели.
5. Выводы: от убеждения к инфраструктуре
Дизайн и опыт
Для проектирования сервисов. Единица надежного проектирования сервисов ИИ смещается от модели к конвейеру. Это означает маршрутизацию значимых запросов через независимые модели, рассмотрение разногласий как элемента пользовательского интерфейса первого класса, присоединение доказательств по умолчанию и ценообразование многомодельной обработки с учетом асимметричной стоимости уверенных ошибок, при этом дорогостоящий путь зарезервирован для запросов, где последствия сосредоточены, как проверка мошенничества резервирует внимание для рискованных операций. Инфраструктура уже существует: управляемые стоимостью каскады, которые направляют сложные запросы на дорогостоящие уровни, являются стандартной инженерией агентов, и для сервиса, который уже маршрутизирует по сложности, предельная архитектура маршрутизации по последствиям близка к нулю. Режимы отказа, выявленные обоими экспериментами, оставляют два жестких правила, и это требования проектирования, а не предпочтения. Позиции должны быть собраны вслепую и записаны перед любым межмодельным обсуждением, поскольку конвейер, в котором обсуждение идет первым, производит именно тот консенсус, который архитектура призвана контролировать (давление на соответствие в разделе 3). Второе правило: единодушный уверенный консенсус по ограниченному набору вариантов — это красный флаг для проверки, а не зеленый свет для исполнения: как панели моделей, так и человеческие участники раздела 6 воспринимали именно этот консенсус как сертификацию.
Экономика работает, потому что эскалация постепенна, архитектура постепенного доверия: в развертывании, описанном здесь, уровни обработки охватывают примерно три порядка величины в стоимости за запрос между ответом одной модели и полным многомодельным обсуждением (по состоянию на июль 2026 г.), поэтому дорогостоящий уровень используется только там, где последствия сосредоточены. Логика безубыточности совпадает с логикой оценки мошенничества (рисунок 14). Оркестровка окупается всякий раз, когда вероятность уверенной ошибки, умноженная на полную стоимость (возврат, отток при допуске одной ошибки, ответственность, регуляторный риск), превышает предельные вычислительные затраты на проверку. Для высокорисковых операций это неравенство значительно.
Падающие цены на вывод (примерно два порядка величины при фиксированных возможностях за три года, консервативная интерпретация отслеживаемых снижений; Appenzeller, 2024) не опровергают аргумент, потому что отношение, а не абсолютная стоимость, является структурной величиной: оба уровня движутся вниз по кривой цены вместе, и дешевый вывод делает дорогостоящий уровень доступным при все более низких ставках. Проверка движется по своей второй кривой: ансамбли слабых верификаторов без размеченных данных достигают точности выбора ответа передовых моделей рассуждений из открытых компонентов с 70 миллиардами параметров (Saad-Falcon et al., 2025). При допуске потребителем одной ошибки сравнение — это не «дешевый ответ против дорогого ответа», а «дорогой ответ против потерянного клиента».
Два потребительских примитива завершают проектирование: намеренное трение (явная пауза перед необратимыми действиями) и квитанции. Оба влияют на то, как ощущается делегирование. Потребители воспринимают ИИ социологически, а не статистически (Puntoni, Reczek, Giesler, & Botti, 2021), и поскольку делегированное исполнение скрывает встречу обслуживания, квитанция принимает на себя старую роль встречи как момент истины. С этой формулировкой связан риск: выделение разногласия может обнажить неопределенность и подорвать доверие, вместо того чтобы его откалибровать (Detjen et al., 2025; Lu, Wang, & Yin, 2024), поэтому то, какой уровень расхождения раскрыть и как его раскрыть, — это переменная проектирования. Это не бесплатный товар.
Квитанция об оркестровке может быть минимальной и все еще выполнять свою функцию (рисунок 8 показывает макет). Три поля сосредоточивают большую часть ценности: (1) кто действовал — модели и версии, к которым обращались, под чьей властью; (2) как они согласились — краткая сводка расхождений в простых терминах; (3) что было проверено — со ссылкой на полную воспроизводимую запись, достаточно компактную, чтобы прочитать с первого взгляда, и достаточно конкретную, чтобы служить основанием для разрешения спора, страховой претензии или аудита. Тот же артефакт решает собственную бухгалтерскую задачу оператора, поэтому квитанция работает в двух направлениях: внутри как управление затратами, снаружи как обоснованное доверие. Эта двойственность необходима. Измеренная готовность потребителя платить только за прозрачность невелика (в одном исследовании совместных предпочтений с ценообразованием стоимость объяснимости оказалась ниже €1,99 в месяц; König et al., 2022), поэтому слой доверия, финансируемый только потребителями, был бы недостаточным, и сторона оператора, занимающаяся управлением затратами, его обеспечивает. Ближайший инженерный аналог квитанции — это квитанции инструментов, зарегистрированные в фреймворках агентов для обнаружения галлюцинаций (Basu, 2026), которые разделяют один инстинкт, но не аудиторию: они представляют собой записи отдельных вызовов инструментов, ориентированные на разработчиков, а квитанция об оркестровке — это их аналог, ориентированный на потребителей и обобщенный на уровне решений. Квитанция порождает собственный режим отказа: артефакт, разработанный так, чтобы выглядеть проверенным, без раскрытия ничего, что потребитель мог бы повторить. Важная линия проектирования — является ли запись действительно воспроизводимой, а не просто похожей на квитанцию. Ограничение возникает также из соображений конфиденциальности: артефакт, который доказывает, что было проверено, также записывает то, что было предпочтено, поэтому проверяемость и конфиденциальность должны быть совместно оптимизированы (Alavi & Nozari, 2026).
Ещё одна составляющая экономики расписки носит собственное имя — экономика проверки. Защищённая от подделок запись имеет ценность, соизмеримую со стоимостью чьего-либо стимула её вскрыть, и эпоха децентрализованных систем служит здесь предостережением: публичные, защищённые от подделок записи блокчейна не превратили обычных пользователей в аудиторов, а архитектуры «без доверия» незаметно переинтродуцировали доверенных посредников на каждый практический разлом (Werbach, 2018). Дилемма верификатора — это формальный вариант: когда верификация дорогостоящая, а корректные результаты — обычный случай, рациональный верификатор пропускает проверку. Спрос на верификацию должен быть сосредоточен там, где уже существует личный выигрыш от проверки — среди страховщиков, аудиторов и процессов разрешения споров; функция расписки для потребителя — наличие при разбирательстве, а не ночное чтение. Вопрос финансирования вытекает из того же пункта, и оба наивных ответа на него неудачны: оркестратор, оплачиваемый потребителем, устанавливает цену нейтральности как люксового товара, а оркестратор, оплачиваемый продавцом, переносит конфликт, который существует для его разрешения. Остаётся модель, уже подразумеваемая двусторонней экономикой расписки. Уровень финансируется так же, как финансируется аудит — сторонами, которым нужна цена риска, а не рассказ (операторы, покупающие управление затратами и снижение ответственности; страховщики, покупающие страхуемые профили риска; процессы разрешения споров, покупающие доказательства), с нормативными полами там, где эти рынки недостаточно это требуют. Потребитель покупает услугу, а не нейтральность, и получает нейтральность как побочный продукт. Та же проблема существует в форме структуры рынка. Платформа, одновременно выступающая маркетплейсом, поставщиком моделей и рекламной сетью, структурно не может обеспечить нейтральность — это конфликт интересов в форме рынка, и исторический отчёт об алгоритмическом приоритезировании (спонсируемое размещение, предпочитаемые партнёры) говорит, что доминирующие игроки будут монетизировать маршрутизацию, если смогут. Где действует это давление, нейтральный пол — нормативный или открытопротокольный, а не добровольный. Если первичный потребительский спрос на доказательства слаб, внедрение архитектурного доверия может быть движимо скорее стороной соответствия и страхования, чем выбором потребителей — миграцией через учреждения, а не через предпочтения; потребители получают проверяемую архитектуру в качестве стандарта. Результат калибровки удерживает этот путь от того, чтобы быть чисто декоративным: потребители явно используют архитектурный сигнал, когда он перед ними, но они ещё не платят, чтобы его вызвать. Здесь есть альтернативная гипотеза: доверие может мигрировать к ответственности и учреждениям вместо проверяемой архитектуры. Потребители полагаются на права возврата платежей, а не на аудиты реестра; сетевые карты масштабировали удалённую торговлю через права на разрешение споров вместо потребителей, проверяющих записи об авторизации; при таком прочтении запись о решении — это инфраструктура, которая делает ответственность вычислимой, а не объектом доверия потребителя. Два описания предсказывают разные вещи: в архитектурном описании потребители вознаграждают проверяемость, когда её видят; в институциональном описании они вознаграждают её только когда приложено средство правовой защиты, и доверие потребителя остаётся якорированным в учреждении, в то время как доверие учреждения мигрирует к архитектуре. Дизайн в момент спора, указанный ниже, различает их. И каждый слой записей наследует проблему оракула: запись удостоверяет процесс, и только собственные проверки процесса достигают фактов. Асимметрия, которую инвертирует расписка, — это та, которую задокументирует литература по критике платформ: архитектура, а не заявленная политика, является действующим регулятором цифрового поведения (Lessig, 2006), и до сих пор её инструменты были направлены на потребителя, а не находились на его стороне (Zuboff, 2019; Möhlmann & Zalmanson, 2017), и расписка направляет эти инструменты в противоположном направлении.
Слой доказательств должен быть виден в самом продукте, а не спрятан в back-office логе. Инженерия программного обеспечения недавно сошлась на названии для runtime-обёртки вокруг агентских моделей — обёртка агента — и на осознании, что именно обёртка, а не модель, может быть сертифицирована, отрегулирована и заслуживать доверие. Архитектурное доверие определяет, что должна производить обёртка, чтобы заслужить эту роль.
Как масштаб, на который рассчитана эта секция, так и откат, от которого она защищает, уже в записи. Помощник Klarna обработал 2,3 миллиона разговоров в первый месяц — две трети чатов обслуживания клиентов компании и предполагаемую работу 700 штатных сотрудников (Klarna, 2024, цифры, сообщённые компанией). Четырнадцать месяцев спустя генеральный директор публично изменил курс: качество выпуска пострадало, набор людей возобновился, и постоянное обязательство стало таким, что «всегда будет человек, если ты захочешь» (Daly, 2025). Читая архитектурно — как мой анализ, а не заявленная компанией причина — пара объявлений охватывает ровно разрыв, который называет эта статья. Уровень объёма работает с затратами машины, но без градуированной эскалации и без проверяемого сигнала качества, делегирование откатилось к человеческому базовому уровню. Что сделало бы положение между этими объявлениями стабильным, — это градуированная архитектура доверия: дешёвая там, где ставки низки, проверяемая где ставки сосредоточены, и человеческая где проверка не срабатывает.
Рынки и регулирование
Для трансграничных услуг. Нейтральность выходит за пределы поставщиков моделей на юрисдикции. Уровень оркестрации может обеспечить маршрутизацию с учётом юрисдикции и записать её применение, превращая соответствие суверенитету данных с правовой репрезентации в аудитируемое свойство runtime. Дифференциация, на которую это реагирует, была измерена: в 25 странах медиана в 53% респондентов доверяет ЕС эффективно регулировать ИИ, против 37% для США и 27% для Китая (данные Pew, сообщённые в Stanford HAI, 2026, доклад института, не прошедший рецензирование). Где доверие варьируется по юрисдикции, архитектура, которая может доказать, какие правила юрисдикции применялись, имеет реальную ценность.
Для торговли агентов. Интеграция Visa–ChatGPT делает три компонента конкретными. Лимиты и белые списки — это статические защиты на стороне потребителя. Архитектурное доверие добавляет динамический, служебный слой: покупки, перепроверенные независимыми моделями (разнообразие), воспроизводимая запись о том, почему агент выбрал этого продавца по этой цене (доказательство), и уровень оркестрации, чей доход не зависит от того, какой поставщик или продавец победит (нейтральность).
Индустрия платежей уже начала строить нижние этажи этого стека. Trusted Agent Protocol компании Visa (октябрь 2025, совместно с Cloudflare; Visa, 2025) криптографически подписывает идентичность агента в его запросы: подписи, специфичные для торговца и цели, ограниченные по времени и защищённые от повтора. Agent Payments Protocol компании Google (Google Cloud, 2025), внесённый наряду с фреймворком Mastercard в FIDO Alliance в 2026, кодирует намерение пользователя как подписанные мандаты, переносимые в качестве W3C Verifiable Credentials (W3C, 2025). Verifiable Intent компании Mastercard (совместный фреймворк с Google; объявлен в марте 2026; Mastercard, 2026) определяет его назначение словами, которые могла бы написать эта работа, защищённая от подделки запись того, что пользователь авторизовал, когда агент ИИ действует от его имени, с ранними пилотными программами, о которых сообщается на азиатских и латиноамериканских рынках в 2026. Доказательства идентичности и намерения подвергаются стандартизации в настоящее время, и то же самое касается формата записи: архитектура SCITT IETF (RFC 9943, 2026) определяет один и тот же паттерн — подписанное утверждение → журнал прозрачности, доступный только для добавления → квитанция, — который предполагает слой доказательств этой работы. Интерфейс, через который происходит делегирование, не является даже морально нейтральным. В ходе тринадцати экспериментов люди, которые делегировали задачи ИИ, вели себя менее честно, особенно ярко при нечётком определении целей, а машинные агенты выполняли полностью нечестные инструкции намного чаще, чем человеческие агенты (Köbis et al., 2025). Интерфейсы, которые требуют формулирования намерения в конкретных терминах, являются этической инфраструктурой.
Ни один протокол пока не охватывает третий этаж — доказательство решения: как агент выбрал этого продавца, этот продукт, эту цену; согласились ли независимые проверки; какова была его уверенность (Рисунок 15 показывает три этажа). Это слой, который обозначает данная работа, и «know-your-agent» должен развиться именно в этот вопрос процесса, при этом единица надзора переместится на уровень транзакции. То, что может гарантировать архитектура, — это существование записи, а не её прочтение. Является ли вопрос о том, откроет ли кто-нибудь такие записи, эмпирическим вопросом, на который может ответить только развёртывание.
Рисунок 15. Стек доказательств
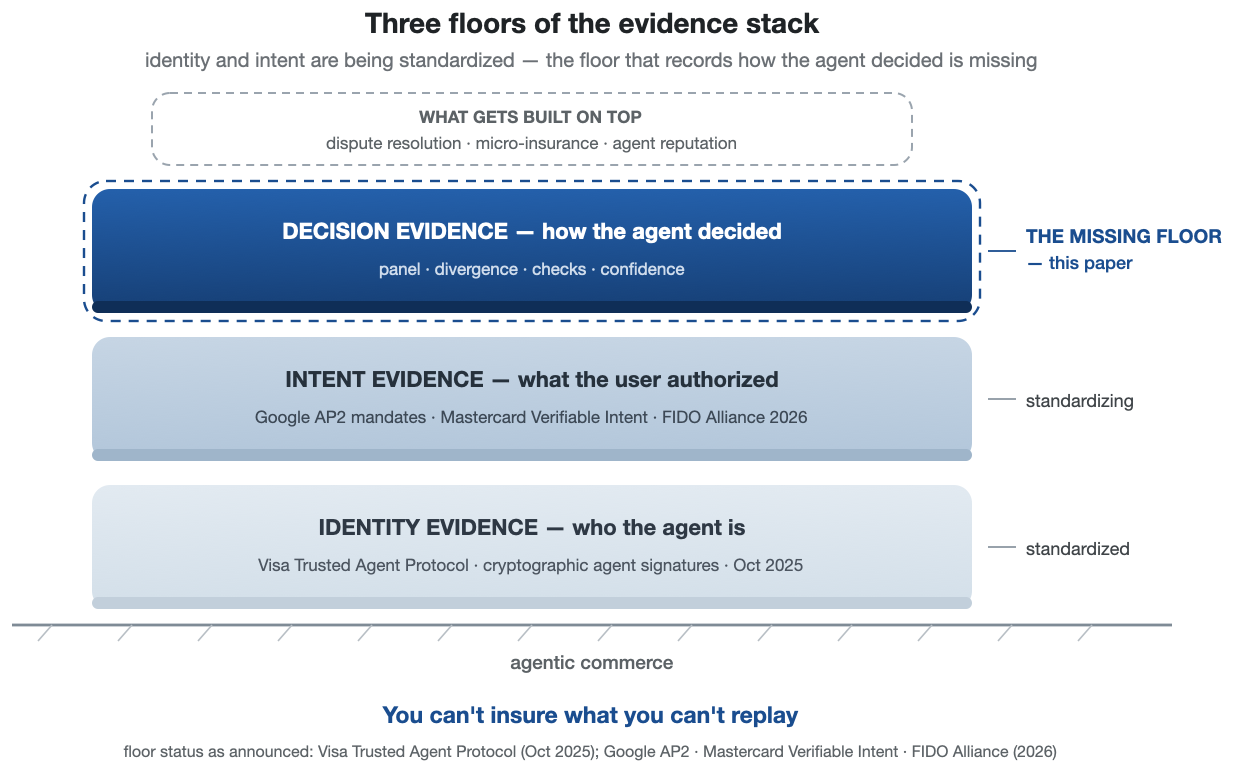
Доказательства идентичности и намерения подвергаются стандартизации в настоящее время; доказательство решения — это недостающий этаж, названный в этой работе.
Первые систематические аудиты поведения агентов при покупке показывают, почему доказательство решения не может ждать. Allouah et al. (2026), проводя рандомизированные испытания в контролируемой среде электронной коммерции, обнаружили, что агенты по покупкам демонстрируют сильные позиционные смещения, концентрируют спрос на нескольких «модальных» продуктах и кардинально переупорядочивают эти предпочтения при обновлении базовой модели. Без записи о том, как было сделано выбор, ничего из этого не видно потребителю, продавцу или регулятору. Разнообразие — это решение проектирования, поскольку панель нивелирует позиционные особенности любой отдельной модели, а подотчётность — это то, что обеспечивает доказательство решения: то, что эти аудиторы должны были наблюдать в контролируемой среде, архитектурно доверенный сервис протоколировал бы в промышленной среде.
Фреймворк также выходит за пределы потребителя к доверию машина-машина. В B2B рабочих процессах с агентами в цикле нет человека, который бы мог почувствовать доверие, поэтому единственно возможный субстрат — это проверяемый процесс, при котором агенты обмениваются теми самыми артефактами, описанными здесь, и определяют, совершить ли транзакцию. Как доверие агрегируется и распространяется по таким цепочкам делегирования в масштабе, и какие затраты на логирование и проверку самого слоя доказательств требуются при объёме промышленного производства, остаются открытыми вопросами. Цепочки обостряют требование, поскольку цепочка не более надёжна, чем её наименее задокументированное звено: записи должны составляться. В отсутствие потребителя архитектурное доверие, вероятно, единственная форма доступного доверия.
Структурное развитие, которое литература по доверию не отследила, — это война протоколов. Конкурирующие стеки торговли с агентами (OpenAI со Stripe — Agentic Commerce Protocol; коалиция Google Universal Commerce Protocol; Perplexity с PayPal; сети карт и открытые стандарты в основе) фрагментируют торговлю по линиям протоколов поставщиков ровно так же, как услуги ИИ фрагментировались по линиям моделей поставщиков, и аргумент о нейтральности обобщается почти дословно: агент потребителя, который может совершать транзакции только в пределах протокола одного поставщика, — это агент поставщика, а не потребителя. Какой бы слой ни арбитрировал между протоколами, он столкнётся с тем же тремя требованиями — независимостью, доказательством и отсутствием заинтересованности, — и если такой слой установится, то борьба за полку становится борьбой за проверяющего.
Для рынка доказательств. В 2026 году это перестало быть прогнозом. На стороне ответственности страховка первой двинулась и в двух направлениях одновременно. Дополнения об исключении по искам о генеративном ИИ вошли в стандартный набор полиса по общей ответственности в январе 2026 года (формы ISO CG 40 47 и CG 40 48, дополнения, которые страховщики могут выбрать, не автоматические исключения; в течение нескольких месяцев крупные страховщики подали заявки на внедрение их или эквивалентов собственного производства). В том же периоде первые политики ИИ-агентов были написаны противоположным образом, без доказательств: стандарт AIUC-1 агента существует, чтобы генерировать посредством аудитов красной команды эмпирические профили риска, которые требуют страховщики для подписания, и в феврале–марте 2026 года появились его первый аккредитованный аудитор, первая политика агента и первые корпоративные сертификации. Зажатые между полным исключением и гарантированием на основе доказательств, записи стали единицей распределения ответственности: агент без проверяемой истории получает охват в форме исключения, а агент с ней — это рассчитываемый риск.
На нормативной стороне обязательства по прозрачности согласно статье 50 Закона об искусственном интеллекте ЕС, включая обязательное раскрытие взаимодействия с ИИ потребителям, вступают в силу с 2 августа 2026 года (переходное обязательство по маркировке действует до 2 декабря 2026 года), со штрафами в размере, согласно толкованию положений о штрафах в данной работе, до €15 миллионов или 3% от мировой выручки. Комиссия приняла руководство по статье 50 20 июля 2026 года (Европейская комиссия, 2026), и параллельное упрощение Digital Omnibus (подписано 8 июля 2026 года) не задерживает обязательства августа. Существующие системы получают только ограниченную отсрочку до декабря 2026 года для маркировки машиночитаемого содержимого. Более широкие обязательства по высокому риску вводятся поэтапно в течение 2027–2028 годов.
Слой доказательств изменяет это обязательство: защищённая от подделок запись, которая включает доказательство того, что требуемое раскрытие информации об ИИ было показано этому пользователю в этой сессии, преобразует, согласно интерпретации данной работы, судебный риск до €15 миллионов в проверяемое свойство времени выполнения, соответствие нормам как побочный результат архитектуры. Страховщикам, покрывающим ответственность ИИ-агентов, нужны именно эти записи, а отслеживаемость и подотчётность являются ключевыми характеристиками Фреймворка управления рисками ИИ NIST. Нормативный прецедент старше самой технологии. Банковское руководство по управлению риском моделей требует независимой проверки сторонами, независимыми от разработчиков модели, с 2011 года (Federal Reserve SR 11-7), требование, которое оркестрированная панель автоматизирует, делает непрерывным и расширяет на каждый существенный ответ. Потребительское законодательство уже предусматривает вмешательство человека: статья 22 GDPR предоставляет право на вмешательство человека в исключительно автоматизированные решения со значительными последствиями, и эскалация при возникновении расхождения, согласно этой работе, является формой исполнения существующего юридического права. Акт об ИИ достигает того же проектного решения со стороны надзора: статья 14 Регламента (EU) 2024/1689 требует, чтобы системы ИИ высокого риска были построены для эффективного надзора человека, а архитектура, которая выявляет расхождения и направляет неразрешённые случаи человеку, реализует это обязательство по надзору как свойство времени выполнения, а не как документ о соответствии.
Как только запись существует, следуют два производных продукта, оба — текущие гипотезы. Микростраховка на уровне транзакций застраховывала бы конкретную покупку агента за центы, оценённую на основе записи доказательств, не поддающуюся выписыванию для непрозрачного агента и тривиальную для воспроизводимого. Другое — репутация агента: продольные истории доказательств естественным образом агрегируются в оценки репутации агентов и оркестраторов. Сервисы, производящие истории аудиторского качества как побочный результат работы, обладали бы активом, который их конкуренты вынуждены были бы добавлять.
То, как инфраструктура такого рода становится институциональной, сама по себе является гипотезой. Траектория, на которую ставит данная работа — продукты в первую очередь, стандарты после, мандаты в последнюю очередь — это один из нескольких путей, которые демонстрирует история инфраструктуры доверия (общие сети банкоматов, справочники сетей карт, позже ратифицированные нормативными актами, предложение блокчейна по проверке всё ещё ждёт спроса). За ней также стоит названная исследовательская программа. Линия регуляторных рынков Хэдфилда — частные регуляторы, лицензированные государственными органами, с независимыми организациями верификации как несущей институцией (Hadfield, 2017; Clark & Hadfield, 2020; Hadfield & Clark, 2026) — подходит к ней со стороны предложения управления. Данная работа подходит со стороны спроса потребительской делегации, и две программы встречаются в квитанции. Под этим лежит более сложный вопрос: становится ли квитанция, продаваемая как функция продукта, когда-либо институцией. Если нет, она остаётся украшением управления, а не слоем управления, что опровергало бы центральное утверждение данной работы. Пункт опровержения предварительно зарегистрирован: называйте квитанцию слоем управления, когда как минимум два отраслевых стандарта требуют отслеживаемых записей решений для операций агентов, сервисы, содержащие все три компонента, обрабатывают большинство объёма высокорисковых операций агентов, и как минимум один национальный регулятор признаёт такие записи в своём определении ответственности. Постоянное невыполнение всех трёх пунктов — вот что означает «украшение» в операциональном смысле. Если верификация преуспевает как инфраструктура, она становится товаром, и доверие переходит в саму общую утилиту, включая текущую архитектуру, что устранило бы любое конкурентное преимущество, даже когда инфраструктура преуспевает.
Вопрос о том, кто несёт ответственность, когда оркестрированное решение даёт ошибку, остаётся открытым: оркестратор, поставщики моделей или потребитель, который авторизовал агента.
Закон начал закрывать лёгкий выход. Закон Калифорнии AB 316, вступивший в силу 1 января 2026 года, запрещает любому ответчику, который разработал, модифицировал или использовал систему ИИ, утверждать, что ИИ автономно причинил вред, при этом оставляя обычные возражения и сравнительное распределение ответственности в силе. Он не вводит абсолютную ответственность. Это делает вопрос о распределении неизбежным, и независимо от того, как доктрина его урегулирует, воспроизводимая запись — это то, из чего вычислялось бы любое распределение ответственности. Правовая наука приходит к тому же выводу, утверждая, что классический инструментарий агентского права не переносится на ИИ-агентов и что требуется новая инфраструктура видимости и ответственности (Kolt, 2025), ближайший предшественник аргумента этой работы в литературе по государственному управлению, подходящий со стороны предложения надзора там, где данная работа подходит со стороны спроса на него. Архитектурное доверие — это доказательственная основа, на которой возникающая доктрина ответственности может вероятно строиться.
Измерение и исследовательская повестка дня
Для измерения доверия. Стандартные инструменты измеряют отношение к бренду или интерфейсу. Отношение, достойное измерения, — это готовность делегировать, а не ответ на вопрос «доверяете ли вы этому ИИ»: какой класс решений, при каких ставках потребитель передаст агенту без проверки каждого шага? Делегирование является поведенческим актом, возрастает монотонно с обоснованным доверием и напрямую связано с доходом. Рядом стоят вопросы о том, знает ли потребитель, как был получен ответ, может ли он получить доступ к записи и улучшает или ухудшает выявленное расхождение калибровку его доверия.
Опрос был квитанцией эпохи человека: пока потребитель выполнял поиск, сравнение и выбор, опрос потребителя был обоснованным способом узнать, что произошло. Делегирование исключает субъекта, который был объектом опроса, поэтому первичный след эпизода становится артефактом, который производит архитектура, и квитанция в этом точном смысле является первичным следом транзакции делегированной эпохи. Два инструмента не конкурируют: квитанция регистрирует, что сделала машина, и ничего не говорит о субъективном присвоении, ощущаемой автономии или когнитивной нагрузке, которые остаются территорией опроса. (Это разрешает видимое противоречие с Разделом 1, чьи мотивирующие доказательства — это опросы выявленных предпочтений: опросы измеряют, что потребители в настоящее время чувствуют о рынке, который едва существует, тогда как квитанция измеряет, что делегированные сервисы фактически делали, как только они стали существовать.) Этот мост можно протестировать, спаривая меры отношения с артефактами одних и тех же эпизодов, стратифицированными по результатам, и оценивая, где анкета и запись согласуются и какая лучше предсказывает последующее поведение делегирования. Предложенный совместный анализ по замыслу несёт часть этой валидации, и до тех пор, пока такие исследования не существуют, метрики на основе артефактов дополняют опрос, а не заменяют его.
Опросы индустрии уже демонстрируют поведенческий базис: в опросе потребителей Gartner, опубликованном в мае 2026 года (846 потребителей из США, проведён в ноябре–декабре 2025 года), 54% покупателей, использовавших генеративный ИИ при покупках, сообщают о перепроверке всей полученной информации. Архитектурное доверие — это коммерциализация того, что потребители уже делают для себя.
Программа измерений имеет естественных союзников в движении комплексной оценки (Liang et al., 2023) и развивающейся науке надёжности агентов, которая раскладывает надёжность на двенадцать метрик, потому что единый показатель успеха скрывает критически важные отказы (Rabanser et al., 2026). Архитектурное доверие реализуется поведенчески тем же образом: коэффициент ошибок при уверенности, надлежащее доверие, сдвиги веса совета, коэффициенты переопределения, время принятия решения и одна особенно острая статистика — разрыв в уровне одобрения между правильными и неправильными выходными данными, что представляет собой калибровку доверия, непосредственно читаемую из поведения. На уровне записей есть охват доказательств, измеренная дивергенция панели и коэффициенты доступа к квитанциям, триангулирующие опрос, поведение и логи одних и тех же эпизодов. Ничто из этого не требует новой науки. Требуемое — это решение, что эти показатели, а не вовлечённость, — это цифры, в отношении которых слой доверия несёт ответственность. Моё собственное наблюдение из развёртывания указывает противоинтуитивный путь: хорошо представленная неопределённость повысила моё надлежащее доверие, и я доверял системе больше, когда она явно знала, чего она не знает.
Одна дополнительная зависимая переменная должна быть включена в повестку дня, потому что доверие — не единственная психологическая нагрузка делегирования. Потребители менее благосклонно реагируют на благоприятный результат, когда его создал алгоритм, потому что результат, который не произвёл потребитель, труднее выдать за свой (Yalcin, Lim, Puntoni, & van Osselaer, 2022). Делегирование может повысить объективное качество решения, одновременно истощая его субъективное владение. Квитанция находится на этой развилке: прочитанная одним способом, она восстанавливает авторство; прочитанная другим способом, она удостоверяет, что потребитель ничего не сделал. Какое прочтение преобладает — это вопрос проектирования, который фреймворк уже инструментировал: компонент Evidence записывает, что было проверено и по какому стандарту (раздел 3), а квитанция разработана так, чтобы нести собственные критерии потребителя в эту запись, поэтому авторство критериев оценки — это переменная, которую архитектура раскрывает, а не та, которую выдумал экспериментатор. Механизм Yalcin et al., состоящий в том, что результат, который не произвёл потребитель, труднее выдать за свой, делает авторство критериев естественным модератором, и P5 — это следствие компонента Evidence для психологии присвоения, а не боковая ветвь повестки дня. P5. Заметность квитанции взаимодействует с благоприятностью результата при определении субъективного присвоения делегированного результата: для благоприятных результатов заметная квитанция восстанавливает присвоение, когда она кодирует разработанные потребителем критерии (стандарт, который агент должен был соблюдать, был моим, и вот доказательство того, что он его соблюдал) и подавляет присвоение, когда критерии читаются как критерии платформы; авторство потребителя в отношении критериев оценки — это проектный модератор. Эффект Yalcin et al. наблюдался там, где потребители ожидали сделать решение самостоятельно, поэтому P5 ограничена этой границей и может измениться при привычном делегировании, и то, что отличает квитанцию от существующих манипуляций прозрачностью процесса, должно быть реализовано, а не предполагаться. Квитанция проверяема и может нести собственные критерии потребителя; дизайн, который опускает оба этих элемента, тестирует прозрачность, а не архитектурное доверие.
Литература о прозрачности предлагает здесь два предостережения: слишком большая процедурная прозрачность может снизить доверие (Kizilcec, 2016), и простое раскрытие использования ИИ его подрывает (Schilke & Reimann, 2025). Второе — это граничное условие для компонента Evidence: в тринадцати экспериментах акторы, которые раскрыли использование ИИ, получали меньше доверия, чем те, кто этого не сделал, — дилемма прозрачности, в которой сама по себе повышенная видимость участия ИИ снижает доверие. Если этот штраф применяется к любому сигналу участия ИИ, то архитектура, которая выводит на первый план собственный механизм, может снизить доверие, даже делая его более проверяемым, и компонент Evidence дал бы обратный эффект именно там, где он наиболее заметен. Ответ фреймворка основывается на различии, которое необходимо продемонстрировать: проверяемость — это не просто раскрытие информации. Квитанция — это проверяемая запись того, как был получен ответ, а не декларация о том, что был использован ИИ, и P2 и P3 (с предварительно зарегистрированным двусторонним тестом H2, обратный эффект раскрытия названный заранее как сообщаемый результат) — это именно то, где различие либо оправдывает себя поведенчески, либо не оправдывает. Проверяемость — это то, что создаёт доверие, доставляемое по требованию, а не как постоянная стена происхождения, и ни скрывание механизма, ни его объявление не делают эту работу. Сколько записей нужно выявить, кому и когда — это само по себе проектная переменная.
Предложенный механизм преодоления Evidence штрафа за раскрытие информации, а не его усугубления, состоит в том, что проверяемость и раскрытие информации проходят через разные психологические каналы. Раскрытие информации доставляет ярлык категории — что был задействован ИИ, который, по данным Schilke и Reimann, связан со сниженной легитимностью. Квитанция доставляет процедуру — запись, которая может быть открыта, оспорена и повторена, и литература по процедурной справедливости считает, что процесс, который можно оспорить и проверить, придаёт законность субъекту, его запускающему (Tax, Brown, & Chandrashekaran, 1998). Канал не требует, чтобы проверка произошла: то, что создаёт доверие, — это осведомленность потребителя о том, что проверка существует и может быть открыта в случае спора, доступность проверки, а не её осуществление, что именно соответствует функции потребителя, которую экономика проверки назначает квитанции выше. Проверка концентрируется там, где существует частная выгода от проверки, и потребитель получает проверку как побочный продукт, рассматривая запись как возможность, а не как документ. То же самое различие применяется к субъективному присвоению (P5): ярлык раскрытия атрибутирует решение машине и истощает владение, тогда как квитанция, которая кодирует разработанные потребителем критерии, документирует, что стандарт, который агент должен был соблюдать, был стандартом самого потребителя. То, диссоциируются ли в действительности эти два канала, с растущей легитимностью при проверяемой процедуре и падающей при простом раскрытии, — это именно то, для обнаружения чего построен предварительно зарегистрированный двусторонний тест H2.
Ограничения. Модель выведена из архитектурного анализа плюс одно расширенное развёртывание с высокими ставками и единым оператором. Каждый эмпирический якорь был получен на этом одном стеке, который я построил и эксплуатирую. Применённо к самому себе, обоснованность статьи смешана её собственной решёткой: один автор и один стек (низкое разнообразие), открытый пакет репликации рядом с запечатанными записями развёртывания и забаррикадированной поведенческой регистрацией до публикации (частичные доказательства) и заявленная коммерческая заинтересованность (скомпрометированная нейтральность). Независимая репликация на других стеках требуется прежде, чем любое утверждение обобщится. Якорь хеша записей развёртывания делает любое более позднее редактирование, подстановку или задним числом датирование обнаруживаемыми, поэтому при вскрытии характеристики здесь можно проверить на соответствие артефакту, который доказуемо не изменился. Читатели могут проверить целостность, но не содержание, до вскрытия. Цифры механизма происходят из открытых API модели, и конвейер воспроизводит сбор от начала до конца менее чем за $15. Отрисовка стимула остаётся смешивающей переменной интерфейса: стимулы эксперимента потребителя, включая стиль чека, — это мой собственный рендеринг UX, и смешивающие переменные уровня интерфейса распутываются только через репликацию с независимыми рендерингами. Слепой сбор, защищённые от подделок записи и маршрутизация без ставок — это конструкция; правила агрегации и пороги эскалации — это инженерные выборы. Панели эксперимента — это аналитические комбинации одного слепого сбора, а не развёрнутого цикла оркестрации, и разработанный протокол полевой телеметрии закрывает этот пробел. Пути проверки, не относящиеся к модели, которые называет фреймворк (теневые прогоны, проверки временной согласованности), описаны здесь, но не проверены. Сбор — это одиночный прогон при нулевой температуре, который подавляет вариативность внутри модели и оставляет корреляцию общей родословной на месте, и размещённые API не являются строго детерминированными даже там. Короткие фактические ответы SimpleQA находятся рядом с режимом ограниченного пространства ответов, в котором консенсус сертифицирует ошибку, и стратификация сложности показывает ровно этот паттерн на самых сложных квинтилях. Панель среднего уровня может переоценить пользу разнообразия, поскольку корреляция ошибок растёт с возможностями (Kim et al., 2025). Эксперимент механизма тестирует вопросы с открытыми ответами на фактические вопросы с единственными проверяемыми ответами, и в открытых обобщающих задачах, где семантическая эквивалентность между ответами — это сам судебный вердикт, сигнал сертификации должен быть переустановлен, а не предполагаться. Связанная граница — это размерность пространства ответов: предметы SimpleQA имеют один проверяемый ответ, тогда как выборы потребителей, которые исполняют агенты, — это субъективные, многоатрибутные суждения полезности со многими оборонимыми ответами, поэтому то, как консенсус ведёт себя в пространстве предпочтений, и то, идентифицирует ли согласие между независимыми агентами вообще лучший выбор там, — это открытый эмпирический вопрос (семантическая эквивалентность становится эквивалентностью предпочтений, и сама оценка — выбором моделирования). Одна проверка шума метки выполняется: на пересечении 351 элемента подвыборки этого исследования с SimpleQA Verified (Google DeepMind, 2025), переоценка каждого ответа панели на соответствие исправленным золотым меткам оставляет сертификационный подъём неизменённым или немного более сильным (2.7 → 2.8, 4.4 → 4.4, 4.0 → 4.3 на всех трёх панелях, детерминированный ранжировщик), поэтому шум метки — не движущая сила подъёма. Все показатели уверенности — это вербализованные самоотчёты 0–100, вызванные одним форматом подсказки, и чувствительность к протоколу вызова может сама варьироваться по производителям, поэтому выводы дискриминации и калибровки для каждого производителя следует читать как свойства этой конфигурации при этом протоколе вызова, а не как фиксированные черты производителя. Базовая линия самоуверенности в Таблицах 6–7 волны шестнадцати моделей — это сырая заявленная уверенность. Более сильные калиброванные базовые линии в традиции Guo et al. (2017) были выполнены на флагманской волне (масштабирование Platt и раздельно-конформная воздержание, Раздел 3), где они выступают как дополнения к вентилю, а не заменители, и сравнение панели и себя в первой волне следует читать на фоне базовой линии потребительских продуктов, которые фактически развёртываются. Основная оценка вентиля (−82.1% уверенных отказов, начальная 95% CI [79.9; 84.1] для десяти полных рук, [80.0; 84.2] с включённой рукой Meta) — это единая предварительно заданная величина, и окружающие анализы (сетка чувствительности порога, слои сложности и загрязнения, абляции совета и сравнения тривиальной базовой линии) — это описательные проверки надёжности, сообщённые без какой-либо коррекции для множественных сравнений, и они не претендуют на подтверждающий статус. Единственная потомственная контроль ошибок в статье — это коррекция Holm на всём предварительно зарегистрированном {H1, H2} эксперимента потребителя. Если режим оценки, который вознаграждает уверенное угадывание, был бы исправлен так, чтобы правдивость могла быть обучена в моделях (Kalai et al., 2025), архитектура обезопасила бы от проблемы с более дешёвым решением, хотя доказательства и нейтральность остались бы неприводимыми к какому-либо исправлению на уровне модели. Дальнейшие границы указаны там, где они сообщаются: ограничения охвата флагманской волны (Раздел 3: два недоступных китайских флагмана и одна прерванная коллекция Meta), и предварительное сравнение 233 пар бюджета рассуждения, чьи границы TOST эквивалентность при допуске ±5 пунктов без мощности для более узких границ. Меры делегирования происходят из гипотетической виньетки, где заявленные меры переоценивают реальную готовность примерно на 21% в мета-анализе (Schmidt & Bijmolt, 2020); эксперимент потребителя реализовал 119 основных и 133 объединённых из 200 зарегистрированных участников на шести фиксированных элементах. Репликация коммерческой подложки расширяет механизм за пределы эталона: свежий, предварительно замороженный набор из 267 фактов о продуктах, проверенных Wikidata (какая компания производит данный автомобиль или летательный аппарат, какая операционная система работает в телефоне, какая компания опубликовала игру, в каком году она была выпущена), запущенный вслепую через независимую панель из шести моделей (Claude Opus, GPT-5.4, Grok, Qwen, GLM и Mistral), уровень, оптимизированный по стоимости, на котором агенты, обращённые к потребителю, фактически работают, не флагман, воспроизводит диссоциацию, кросс-модельное согласие, предсказывающее правильность при AUROC 0.77–0.81 в сравнении с 0.63–0.70 для заявленной уверенности и подъём сертификации 4–6×, надёжное на всех независимо составленных панелях из трёх-шести моделей, охватывающих лаборатории США, Китая и Европы, и к строгости оценки (детерминированное совпадение строк здесь — это первичное, консервативное правило). Субъективный, многоатрибутный конец коммерческого спектра (трейдоффы предпочтений, враждебные стимулы продавца и извлечение, привязанное к инструменту, по изменяющемуся инвентарю) остаётся непроверенным.
Дисперсия от прогона к прогону при выборке. Ветвь исследования дисперсии непосредственно зондировала границу однозначного детерминированного прогона: стратифицированная по сложности подвыборка из 100 вопросов (5 quintiles сложности × 20, seed 20260806) была повторно запущена при температуре 0.7 с 3 независимыми выборками на вопрос для 9 из 11 флагманско-волновых панельных моделей; конечные точки Meta были недоступны, а API Claude Fable 5 не предоставляет параметр температуры. Во всех моделях все три выборки дали взаимно эквивалентные ответы на 22–77% вопросов (медиана 54%), правильность на вопрос была идентична во всех трех выборках на 63–97% вопросов, а ответ при температуре 0 совпадал с большинством ответов при температуре 0.7 на 40–85% вопросов. Ветвь gpt-5.6-sol содержит помеху: она работала при усилии рассуждений none, тогда как 1 486 из 1 500 волновых записей использовали усилие по умолчанию (среднее, как отмечено выше). Таким образом, дельта точности 92.0% → 46.3% на этой подвыборке смешивает температуру с бюджетом рассуждений, хотя фигуры согласованности между выборками не затронуты. Исключив эту смешанную ветвь, средняя точность на выборку при температуре 0.7 отличалась от детерминированной точности при температуре 0 на тех же вопросах максимум на 14.0 пункта (gemini-3.1-pro, 49.0% → 63.0%), с остальными семью моделями в пределах 4.4 пункта. На уровне панели шлюз совета (трёхстороннее согласие ответов между kimi-k3, deepseek-v4-pro и gpt-5.6-sol) открывался на 31.0% подвыборки при температуре 0, против 25.0%, 23.7% и 29.8% в трех прогонах при температуре 0.7. Сигнал согласия, лежащий в основе основного результата, стабилен при шуме выборки.
Статус доказательности утверждений. Утверждения распределяются по трем уровням доказательности. Установлено этими данными: что независимое согласие несет сигнал корректности, который самоотчет модели не несет, при указанных граничных условиях (слепой сбор, компетентные проверяющие, открытые факты вопросы с единственными проверяемыми ответами); что фиксированный шлюз разногласия отсекает большинство уверенных отказов при существенной, указанной стоимости покрытия (−82.1% при 30.5% покрытии); и сами строгие граничные условия: консенсус сертифицирует ошибку на ограниченных пространствах ответов, прирост сертификации в исходном виде затухает монотонно со сложностью (исчезает на сложнейшем квинтиле при стратификации в пределах сбора; положительный, но слабейший там при экзогенном варианте), и компетентность проверяющего открывает доступ к ценности сертификации. Поддерживается поведенческим экспериментом (один дизайн, скромный масштаб одного исследования, n = 119): что выявление реального разногласия между моделями улучшает калибровку доверия в обе стороны (d = 0.67, Holm p = .0005; осуществляется одним из шести пунктов; проверки манипулирования основной волны 88–98%; надежность шкалы α = .83–.93); и, как зарегистрированный неубедительный нуль, что статическое первичное свидетельство не оказывает заметного влияния на делегирование. Теоретически предложено, еще не протестировано: дополняемость D×E×N; эффект нейтральности (P3); миграция доверия при растущем делегировании; долговечность архитектурного доверия после отказа (P4); готовность платить за проверяемость; и претензия категории рынка из раздела 7.
Естественный следующий шаг — экспериментальный: измерить доверие, калибровку доверия и готовность платить в условиях одномодельного и организованного обслуживания, с поочередным выявлением и подавлением разногласия. Раздел 6 представляет реализованный эксперимент, предварительно зарегистрированный и совместимый с поощрениями. Стандартный выбор на основе совместного анализа оценивает ценности компонентов аддитивно и предполагает компенсирующие компромиссы, что отрицает гипотеза дополняемости, поэтому класс дизайна должен допускать некомпенсирующую структуру, будь то исключение по аспектам или конструкции принудительного выбора с препятствующими атрибутами, оцененные с явными членами взаимодействия. Указаны два уровня дизайна. Минимальный уровень — исследование целевых профилей, четыре–пять профилей, охватывающих отсутствие, однокомпонентные, двухкомпонентные и полные конфигурации, с теоретической работой, выполняемой одним запланированным контрастом, эффект полной конфигурации превышает сумму эффектов компонентов (супераддитивность), в сравнении с аддитивным нулевым результатом. Полный уровень пересекает три уровня на компонент (отсутствует, присутствует-но-не-поддающийся-проверке, присутствует-и-поддающийся-проверке) в факториальном плане 3×3×3 между субъектами (27 ячеек; ставки варьировались в пределах субъекта по четырем уровням), с минимум 80 респондентами на ячейку (N ≥ 2 160) для мощности ≥ 0.85 по взаимодействию. Двоичный дизайн 2³ не может восстановить показатели Cobb–Douglas и недостаточно мощен при правдоподобных размерах эффектов (d ≈ 0.3–0.4). Применяются три дисциплины стимула: варьируют сами архитектурные величины, а не только их обозначение (отсутствующее обозначение свидетельства — это незнание потребителем доказательств, а не их отсутствие), дают каждому компоненту контраст между проверяемым и просто утверждаемым, и объединяют данные выбора с трассировкой процесса в полях свидетельства, поскольку теория предсказывает использование доказательств. Насколько мне известно, это было бы первым дизайном для совместного варьирования трех компонентов. Однокомпонентные строительные блоки уже оценены (König et al., 2022; Ioku et al., 2024), и смежные комплекты были реализованы (Cetinkaya & Krämer, 2024, ближайший инструмент и источник калибровки мощности наряду с Köbis et al., 2025), поэтому исследование задано, мощность определена и готово к запуску. Граничные условия конструкции таковы: архитектурное доверие не окупается там, где ставки низкие и объем высокий; оно добавляет мало там, где пул проверяющих недостаточно компетентен в классе задач; оно может сертифицировать ошибку там, где пространства ответов жестко ограничены; и оно деградирует в театр везде, где независимость панели утверждается, а не измеряется, наиболее остро как открытый вопрос красной команды как выглядит поддельное свидетельство? Когда гиперссылки стали сигналами авторитета, возникли фермы ссылок для их создания, и записи согласия должны ожидать своего собственного фарминга. Применяются также два временных граничных условия: сигналы выигрывают внимание, а доказательства выигрывают устойчивость, поэтому утверждение касается того, какое доверие пережит отказ, а не какое вводится быстрее, и даже работающая проверка может лишь замедлить спираль того типа, которую моделируют Chandra et al. (2026). Где последствия сосредоточены и независимость реальна, архитектурное доверие оправдывает свою стоимость и свое имя (таблица 12 собирает четыре).
Таблица 12. Граничные условия: где архитектурное доверие не окупается
| Условие | Почему оно там не работает | Доказательства |
| Низкие ставки, высокий объем | Стоимость проверки превышает стоимость ошибок; обслуживание одной моделью — правильный ответ | Логика безубыточности (рисунок 14) |
| Пул проверяющих ниже компетентности задачи | Независимость без компетентности не несёт никакого сигнала | Локального уровня null: точность 46% с согласованием или без него |
| Плотно ограниченные пространства ответов | Консенсус подтверждает ошибку, а не выявляет её | Ошибки консенсуса 4.0–7.9% при выборе из вариантов в сравнении с 0.5–2.2% в открытой форме |
| Независимость утверждается, не измеряется | Панель из почти идентичных моделей производит видимость уверенности | Коррелированные ошибки; нулевые результаты по блокам и линиям происхождения |
Последнее ограничение касается того, что могут определить любые предложенные конструкции. Доверие на агентском рынке в конечном счёте является объектом равновесия. Как только продавцы, платформы и конкурирующие агенты адаптируются к архитектуре проверки, её эффекты становятся свойствами адаптированного рынка, а не группы обработки. Наблюдательные данные наследуют смещение отбора, потому что проверка будет принята в первую очередь там, где доверие уже разрушается. Рандомизация на уровне единиц исправляет смещение отбора, но останавливается перед помехой, поскольку потребители, отобранные в группу с квитанциями, по-прежнему совершают сделки на рынке, где продавцы реагируют на квитанции всех сразу. Равновесное количество требует кластеризованных, switchback, двусторонних или рыночных конструкций; рандомизация архитектуры, а не измерение доверия, — следующая сложная задача. Кроме того, ранние когорты агентской торговли саморазбираются по склонности к доверию, поэтому эффекты, оценённые на ранних приверженцах, ограничивают, а не оценивают популяционный эффект. Нейтральность ценна ровно потому, что никто, заинтересованный в модели, не может её обеспечить, включая любого, заинтересованного в оркестровке. Доводы также описывают тип системы, которую я создаю (примечание автора). Этот интерес касается защиты интересов, а не воспроизводимости доказательств: оцениваемые модели являются независимыми, общественно доступными передовыми системами, и каждое сообщённое число может быть пересчитано третьими сторонами из замороженного пакета репликации. Читатель, полностью отвергающий защиту интересов, всё равно может проверить измерения.
6. Могут ли потребители использовать сигнал? Предварительный тест поведения
Вопрос о том, могут ли потребители использовать сигнал о правильности, который устанавливает механизм, является отдельным, поведенческим вопросом, и я сообщаю о предварительно зарегистрированном, стимулируемом эксперименте по этому вопросу. Полевое исследование является доказательством существования, а не тестом общего эффекта; оно вопрошает, могут ли потребители вообще действовать в соответствии с сигналом. Запланирована высокомощная, подтверждающая, многоэлементная, выбранная по стимулам репликация со случайными наклонами по элементам. Сбой в работе хостинга на завершающем этапе набора завершил сбор данных при 119 действительных участниках против 200 запланированных (133 при объединении когорты мягкого запуска; США и Великобритания; три условия между субъектами с помощником для агентских покупок; калибровка измерена в шести стимулируемых фактических испытаниях как Δ = P(accept | correct) − P(accept | incorrect), индекс различения надлежащей опоры Schemmer et al., 2023). Полный метод, пилот, пять отклонений от регистрации, раскрытие вопросов этики и освобождения, а также все вспомогательные статистики находятся в подробном отчёте ниже (§6.1–6.2) и в пакете репликации.
Отображаемое разногласие между моделями в целом улучшило калибровку (Контроль Δ = 0.24 → 0.45; d = 0.67, 0.68 объединённые, p = .0001), но объединённая оценка хрупка: она обусловлена одним из шести стимулов, единственным элементом с высокой уверенностью несогласного, где экран снизил принятие уверенно неправильного ответа с 74% до 24% (объединённая когорта, таблица 18). Удаление этого элемента снижает эффект до d = 0.09 (p = .54), а удаление любого другого отдельного элемента оставляет его нетронутым. Выигрыш был сосредоточен в подвыборке Великобритании. Группа контроля США (n = 16) уже различала на исходном уровне (взаимодействие p = .002). По одному элементу, где сама панель согласилась с неправильным ответом, экран увеличил принятие в обеих странах, что представляет собой воспроизведённый в человеческом поведении режим сертифицированной ошибки консенсуса раздела 3 и самостоятельное открытие: архитектура, которая выявляет согласие, передаёт одну из своих систематических ошибок своим пользователям. Первый тест воздействия компонента доказательства P2, статическая квитанция оркестровки, не произвёл обнаруживаемого эффекта на готовность делегировать (d = 0.21, неубедительно при этой мощности; живая детализирующая квитанция во время спора является зарегистрированным продолжением).
Дисплей несогласной панели может резко снизить принятие уверенно неправильного рекомендации там, где потребитель иначе бы её принял, и он не срабатывает там, где панель подтверждает совместную ошибку. Таким образом, контраст калибровки имеет поведенческую поддержку при этих шести стимулах; P1 в изложенном виде с воспринимаемым риском в качестве посредника не поддерживается этим тестом. P2–P4 остаются открытой программой.
6.1 Тест поведения: метод и пилот
Предложения разделов 3 и 5 написаны, чтобы быть протестированными, и приведённая выше программа измерений указывает, как это сделать. Эксперимент является предварительно зарегистрированным, совместимым со стимулами онлайн-тестом P1 (калибровка опоры при открытом разногласии) и P2 (готовность делегировать при воспроизводимой записи), со стимулами, извлечёнными из реальных выходов многомодельной основной волны, расширяя парадигму второго мнения (Detjen et al., 2025; Chen et al., 2026) на реальные, стимулируемые разногласия между передовыми моделями в рамках архитектурной постановки. Инструмент, замораживание протокола, пилот, основная волна и анализ замороженного кода завершены и доложены ниже. Таблицы подтверждения были включены в более ранние версии этой статьи как предварительно зарегистрированный скелет с ячейками, помеченными [MAIN DATA PENDING], и теперь заполнены замороженным кодом анализа. Два неблагоприятных для гипотезы результата были зарегистрированы как доложимые основные находки: открытое разногласие, ухудшающее калибровку (чистая недостаточная опора), и квитанция, снижающая готовность делегировать (обратный эффект раскрытия); ни один из них не материализовался, но один предварительно зарегистрированный нулевой результат имел место.
Метод.
Дизайн и гипотезы. Калибровка полагания требует сопоставления отображённого согласия с правильностью ответов, чего один сценарий не может обеспечить. Поэтому дизайн является гибридным. Участники сначала читали сценарий делегирования покупок (ИИ-ассистент по покупкам "ShopAssist", рекомендующий покупку ноутбука в рамках бюджета в $1,200), первичный тест P2, затем выполняли краткий стимулированный блок оценок на реальных результатах нескольких моделей, первичный тест P1. H1 (P1): отображение согласия и разногласия между несколькими независимыми системами ИИ улучшает калибровку полагания потребителей (они принимают предложенный агентом ответ чаще, когда он правильный, и реже, когда он неправильный) по сравнению с одним уверенным ответом; двусторонняя, так как литература документирует как снижение чрезмерного полагания, так и увеличение недостаточного полагания при совместной презентации. H2 (P2): доступ к квитанции оркестрирования (кто действовал, как они согласились, что было проверено и полный заново верифицируемый отчёт) увеличивает готовность делегировать значительную покупку, помимо эффекта от отображённого разногласия отдельно; двусторонняя, так как раскрытие также может снизить доверие.
Условия. Три межсубъектных условия, рандомизированные 1:1:1 и сохраняемые постоянными на протяжении сценария и блока оценок: (1) Контроль, одна уверенная рекомендация, без архитектурных сигналов; (2) Разногласие, та же рекомендация, предшествуемая панелью трёх независимых систем ИИ (анонимизированные как Система A, B, C) с явной маркировкой согласия/разногласия, альтернативные ответы систем и указанные уровни доверия, и резюме разрешения на понятном языке; (3) Разногласие + Доказательство, экран Разногласия плюс карточка квитанции оркестрирования, структурированная как кто действовал / как они согласились / что было проверено / полный отчёт. Одно предварительно зарегистрированное ограничение дизайна контролирует очевидный искажающий фактор: блок финальной рекомендации (продукт, цена и указанное агентом финальное доверие) дословно идентичен во всех трёх условиях, в сценарии и на каждом испытании, различаются только архитектурные сигналы вокруг него.
Стимулы и квитанции. Стимулы блока оценок являются реальными результатами трёх передовых моделей из основной волны по реальным фактическим вопросам, по которым модели подлинно согласились или не согласились при высоком указанном доверии (95–100); ни ответы, ни уровни доверия не вымышлены. Названия моделей заменены нейтральными метками, чтобы избежать искажений из-за предвзятости к бренду, и сопоставление раскрывается в пакете репликации. Квитанции, показанные в условии 3 (одна квитанция сценария и шесть квитанций испытаний), создаются генератором квитанций исследовательского развёртывания (схема `decision-receipt@v1`) на основе фактических журналов происхождения панели стимулов, и их хэши проверки подлинно пересчитываются из записи (журнал проверки: 7/7 подтверждены). Следовательно, манипуляция доказательством в эксперименте является примером артефакта, определённого в Разделе 3. Отображённое фокальное доверие было тесно согласовано во всех ячейках правильности (неправильные элементы 95/98/99; правильные элементы 99/99/100) и, решающим образом для контраста условий, идентично во всех условиях. Контроль видел то же фокальное доверие и дискриминировал намного меньше, что объяснение, основанное на сигнале доверия, не может объяснить.
Измерения. DV1 (H2): четырёхпозиционная шкала готовности к делегированию (7-уровневая; например, "Я бы позволил ShopAssist завершить эту покупку без самостоятельной проверки рекомендации"), усреднённая; однопозиционная лестница делегирования (0–4, от "только рекомендации" до "действует самостоятельно, включая неподлежащие возврату покупки") является вторичной. DV2 (H1): шесть испытаний оценки; в каждом агент предлагает один ответ, и участник решает, позволить ли помощнику продолжить (да/нет) и оценивает доверие к ответу (ползунок 0–100). Решения о полагании стимулируются точностью (бонус за каждое адекватное решение о полагании, принятие правильного ответа или отказ от неправильного). Предложенный ответ правильный ровно в трёх из шести испытаний. Показатель калибровки участника составляет Δ = P(принято | правильно) − P(принято | неправильно), индекс дискриминации литературы о надлежащем полагании (Schemmer et al., 2023, чьи меры RAIR/RSR разлагают тот же объект); модель со смешанными эффектами на уровне испытаний выявляет разрешение на уровне элементов. Воспринимаемый риск и воспринимаемый контроль над процессом (по 4 элемента каждый) измеряются как посредники в предварительно зарегистрированных вторичных анализах для путей P1 и P2 соответственно; воспринимаемая беспристрастность оркестратора (4 элемента) измеряется как поисковый коррелят P3, который это исследование не варьирует.
Зафиксированный протокол. Предварительная регистрация была зафиксирована перед основным сбором данных (код анализа и протокол зафиксированы посредством SHA-256 от 5 августа 2026 г.; регистрация OSF была подана 13 августа, перед тем как основная волна выехала в поле 13–14 августа; зарегистрирована с эмбарго (предварительная регистрация, только для просмотра: https://osf.io/pqeg6/?view_only=87eb0a88579647b48e93d4a475795d5f), должна быть выпущена в открытый компонент OSF статьи, https://osf.io/jtvu9/). Набор из шести пробных заданий зафиксирован по семени: три задания на несогласие, зафиксированные по дизайну и проверенные вручную, плюс задания консенсуса, извлеченные путем случайного перемешивания с заданным семеном из пулов, где все три системы ответили идентично при указанной уверенности ≥ 95, включая одну подлинную ошибку консенсуса, так что отображаемое согласие является диагностическим, но неполным, точно как в исходных данных. Все шесть заданий были идентичны для каждого участника; порядок предъявления был рандомизирован в инструменте, хотя экспортированные полевые данные не сохранили порядок отображения по пробному заданию. Полевое отображение не показывало предполагаемый балл независимости для панели, который является раскрытием измеренного разнообразия, которое сам фреймворк требует, поэтому участники видели несогласие, не видя того, насколько независимы были несогласные системы. Независимость панели была измерена, но не показана, и ее значение в исходной коллекции здесь сообщается post hoc: средняя попарная корреляция ошибок φ = 0.22 (0.10–0.44 по трем парам, два члена одного блока были наиболее коррелированы при 0.44; оценено по замороженному детерминированному оценщику исследования, который разрешает 95–98% ответов и нечувствителен к тому, как кодируется неразрешенный остаток), что ставит панель далеко от независимости и далеко от клональности. Это число, которое следующий инструмент должен показать участникам. Одно ограничение стимула: с шестью фиксированными заданиями взаимодействие лечение × задание не может быть оценено, поэтому эффект устанавливается для этих стимулов. Сеансы начинались с информированного согласия и заканчивались дебрифингом, раскрывающим гипотетический характер покупки виньетки. Исследование проводилось в соответствии с Декларацией Хельсинки: анонимное исследование с минимальным риском, проводимое с согласия взрослых из Великобритании и США на панели, соответствующей GDPR, с компенсацией выше минимума платформы и без обмана, кроме гипотетической виньетки, раскрытой при дебрифинге. В соответствии с этими критериями она соответствовала условиям для освобождения от полного рассмотрения этическим комитетом, и оценка освобождения задокументирована в предварительной регистрации. Пул закрыт; дословный набор заданий, ответы и идентификаторы поступлений по пробному заданию являются частью эмбаргированной предварительной регистрации и будут выпущены с данными.
Выборка и план анализа. Целевой N = 200 валидных участников (100 из США, 100 из Великобритании; отдельные исследования Prolific; набор ограничен 210), возраст 18+, свободное владение английским, ≥ 98% одобрения, ≥ 100 предыдущих предложений, хотя бы одна онлайн-покупка в течение последних трех месяцев. Предварительно зарегистрированные исключения (применены перед просмотром содержательных ответов): два или более неудачных проверок внимания из трех; завершение менее чем за 3 минуты; дачу прямолинейных ответов; неудачные проверки манипуляции (задание согласия в условиях 2–3, задание квитанции в условии 3, задание понимания продукта); дважды неудачное понимание блока суждений; дублирующийся ID или IP; неполный сеанс. Подтверждающие анализы: для H1, OLS Δ на объединенных условиях несогласия (2 и 3) в сравнении с контролем с ковариатой страны; для H2, ограниченный условиями 2 и 3, OLS композита готовности делегировать по условию с ковариатой страны; коррекция Холма для {H1, H2}, альфа на уровне семейства = .05; тесты Велча как проверка устойчивости; управление проверкой манипуляции сообщается в первую очередь. Порядок когорт зафиксирован здесь: первичные подтверждающие анализы вычисляются на когорте основной волны исключая участников пилотного мягкого запуска, и ветвь, которая объединяет когорту мягкого запуска в подтверждающую выборку, сообщается как анализ устойчивости. Описательная статистика пилота Δ была просмотрена перед основной волной, поэтому исключение этой когорты из первичной оценки удаляет даже мягкую форму использования двойной выборки, сохраняя предварительно зарегистрированное включение мягкого запуска как сообщаемую ветвь. Первичное сообщение будет включать анализ намерения лечить, сохраняющий всех рандомизированных участников наряду с предварительно зарегистрированным анализом по протоколу. Исключения проверки манипуляции будут сообщены с проверками дифференциального отсева по условиям, поскольку выраженность архитектурного сигнала может отличаться по условиям. Чувствительность: дизайн обнаруживает d ≈ 0.42 для H1 и d ≈ 0.49 для H2 при мощности .80, достаточно для средних эффектов в соответствующей литературе по доверию и прозрачности. Меньшие эффекты остаются на полный факториал исследовательской программы. Три предварительно зарегистрированных элемента отвечают на вопросы о механизме, на которые подтверждающие контрасты сами по себе не могут ответить. Инструмент содержит четырехпунктовую шкалу предполагаемого риска (пилот α = .881) на пути P1, поэтому восприятие риска входит в анализ как измеренная конструкция, а не предположение. Медиация предварительно зарегистрирована как вторичный анализ, с предполагаемым риском, опосредующим эффект несогласия на доверие, и предполагаемым контролем процесса, опосредующим эффект квитанции на готовность делегировать, оцененный путем анализа пути бутстрепа (Модель PROCESS 4, 5000 переподвыборок). Время на экране стимула условия 3 собирается как предварительно зарегистрированный прокси для чтения квитанции, прямая проверка альтернативы когнитивной нагрузки, что участники могут пропустить квитанцию, не обработав ее. Код анализа был заморожен перед сбором данных и архивирован в пакете репликации.
Пилот (мягкий запуск): критерии и результаты.
Пилотное исследование n = 20 (США), проведенное на финальном инструменте с предварительно зарегистрированными критериями приемки, определенными заранее, было завершено 6 августа 2026 г. Таблица 13 представляет каждый критерий и соответствующий ему результат.
Таблица 13. Критерии приемки пилота (предварительно зарегистрированы) и результаты (n = 20, США)
| Критерий (зафиксирован заранее) | Результат | Вердикт |
| Манипуляция замечена: > 80% правильных ответов на проверке согласия (условия 2–3) | 81.3% (13/16) | Пройдено |
| Манипуляция замечена: > 80% правильных ответов на проверке квитанции (условие 3) | 88.9% (8/9) | Соответствует |
| Cronbach's α > .70, готовность к делегированию (4 пункта) | .854 | Соответствует (также превышает целевой показатель .85) |
| Cronbach's α > .70, воспринимаемый риск (4 пункта) | .881 | Соответствует |
| Cronbach's α > .70, контроль процесса (4 пункта) | .965 | Соответствует |
| Cronbach's α > .70, нейтральность (4 пункта) | .851 | Соответствует |
| Медианное время завершения в пределах 10–15 минут | 9.60 минут | Не пройден, на 24 секунды в быстром направлении |
Одно требование не выполнено. Медиана составила 24 секунды ниже заранее зарегистрированного окна, окна, предусмотренного против чрезмерной длительности, а не против неэффективности. Быстрый хвост не показывает признаков небрежных ответов: ни один участник не упал ниже порога исключения в 3 минуты; один участник с временем менее пяти минут прошел все проверки внимания, манипуляции и понимания; показатели прохождения проверок внимания составили 95–100%; было нулевое количество отсутствующих ячеек по ключевым переменным, нулевое количество дублирующихся ID или IP-адресов и нулевое количество прямолинейных ответчиков; и время выполнения платформы набора независимо подтвердили таймер опроса (медиана 9.74 минут). Инструмент короче в полевых условиях, чем предусмотрено бюджетом. Баланс условий (4/7/9 по условиям 1/2/3) совместим с рандомизацией 1:1:1 при n = 20 (χ²(2) = 1.90, p = .387). В соответствии с заранее зарегистрированными критериями исключения, 6 из 20 пилотных участников исключены из подтверждающего анализа (пятеро по причине проверки манипуляции, один из-за дважды неудавшейся проверки понимания), оставляя 14 действительных. В соответствии с правилом мягкого запуска пилотная когорта переходит в объединенную выборку с отклонением по времени, раскрытым здесь и в самой регистрации, которая была отправлена на OSF 14 августа 2026 года в 03:09 UTC, перед основным сбором данных, и в которой указано, что пилотный мягкий запуск включен в подтверждающую выборку с указанным отклонением по времени; рассмотрение основной когорты как основной подтверждающей оценки и объединенной ветви как проверки надежности является аналитическим решением, принятым после регистрации, поскольку описательные характеристики пилота были видны до основной волны, и обе ветви представлены; маржа понимания продукта (один участник выше отметки 80%) отмечена для мониторинга в основной волне. Одна исследовательская описательная статистика, представленная без вывода при пилотном n: оценка калибровки Δ по условиям составила +0.33 (контроль, n = 4), +0.52 (несогласие, n = 7), +0.22 (несогласие + доказательство, n = 9), поэтому условие несогласия движется в направлении H1; пилот не может сказать больше.
6.2 Тест поведения: результаты, исследовательские анализы и оставшийся реестр
Подтверждающие результаты.
Сбор основной волны проводился 13–14 августа 2026 года (190 слотов: 85 США + 105 Великобритания в дополнение к когорте мягкого запуска), и он не был завершен: хост опроса столкнулся с техническим сбоем во время окончательного окна набора, и сбор закончился всего 158 завершенными сеансами (138 в основной волне и 20 при мягком запуске) вместо целевых 200 действительных. Набор закончился с отключением платформы, в соответствии с заранее зарегистрированным правилом необязательной остановки и не в ответ на наблюдаемые результаты, хотя результаты уже были видны к тому времени; следствие — снижение мощности. При реализованных ячейках минимально обнаруживаемые эффекты увеличиваются от зарегистрированных d ≈ 0.42 (H1) и d ≈ 0.49 (H2) примерно до d ≈ 0.54 и d ≈ 0.64 при одной и той же мощности, граница, которую подтверждающий результат делает спорной только в одном направлении, и та, которая применяется ко всем нулевым и исследовательским контрастам ниже. Порядок когорты следует плану §6.1. Пилот не выполнил одно критерий прохождения (окно времени завершения, на 24 секунды в быстром направлении), и его исследовательские описательные характеристики были видны до основной волны, поэтому основная подтверждающая когорта — это только основная волна (N = 119 действительных) и ветвь, объединяющая идентично организованную когорту мягкого запуска обратно (N = 133), представлена как проверка надежности. Каждое число ниже — это результат кода анализа, замороженного SHA-256 перед сбором данных. Отклонения от регистрации, собранные в одном месте: (i) недостаток N (133 действительных из 200 зарегистрированных; отключение хостинга); (ii) критерий времени завершения пилота упущен на 24 секунды в быстром направлении; (iii) порядок отображения на уровне испытания не сохранен в экспортированных данных; (iv) синхронизация на уровне экрана не захвачена; (v) смешанная модель на уровне испытания работает с вариационным приближением (окончательный механизм пакета может отличаться). Ничто другое не отклонилось; каждый подтверждающий тест прошел так, как зарегистрировано, решение о первичной когорте выше является единственным выбором аналитики после регистрации.
Таблица 14. Поток выборки и исключения (основная волна; когорта мягкого запуска в примечании)
| США | Великобритания | Всего | |
| Завершенные сеансы | 50 | 88 | 138 |
| Исключено: внимание (≥ 2 из 3 проверок) | 0 | 0 | 0 |
| Исключено: скорость (< 3 мин) / прямые ответы | 0 | 0 | 0 |
| Исключено: проверки манипуляции / понимания | 10 | 9 | 19 |
| Исключено: дубликаты / неполнота | 0 | 0 | 0 |
| Действительное N (по условиям 1/2/3) | 40 (16/15/9) | 79 (26/28/25) | 119 (42/43/34) |
Когорта мягкого запуска добавляет 20 завершенных сеансов США, из которых 14 выдерживают те же исключения; она входит только в объединенную ветвь проверки надежности (N = 133). Каждое исключение в основной волне исходило из правил проверки манипуляции и понимания — ни один участник не был исключен за невнимание, спешку, прямые ответы, дублирование или неполноту — и шлюз проверки манипуляции не показывает асимметрию между условиями (MC1 χ²(1) = 0.12, p = .73; MC3 χ²(2) = 3.67, p = .16, вычислено на выборке перед исключением).
Таблица 15. H1 (P1): калибровка полагания Δ по условиям (основная когорта, N = 119)
| Контроль | Несогласие | Несогласие + Доказательство | |
| Δ, среднее (SD) | 0.238 (0.332) | 0.465 (0.274) | 0.422 (0.299) |
| Чрезмерное полагание: P(принять | неверно) | 0.603 | 0.434 | 0.510 |
| Недостаточное полагание: 1 − P(принять | верно) | 0.159 | 0.101 | 0.069 |
| Подтверждающий контраст: объединенный (2,3) в сравнении с контролем, OLS с ковариатой страны | b = +0.217, 95% CI [+0.104, +0.330], скорректировано по Холму p = .0005 (d = 0.67) |
Таблица 16. H2 (P2): готовность делегировать, получение в сравнении с одним несогласием (основная когорта)
| Несогласие (2) | Несогласие + Доказательство (3) | |
| Композитный показатель готовности к делегированию, среднее (SD) | 3.09 (1.61) | 3.45 (1.79) |
| Лестница делегирования, медиана | 2 | 2 |
| Подтверждающий контраст: 3 vs 2, OLS с ковариатой страны | b = +0.41, 95% ДИ [−0.35, +1.18], скорректированный по Holm p = .29 |
H1 поддерживается в этом плане для калибровочного контраста; предварительно зарегистрированное опосредование через воспринимаемый риск было нулевым, поэтому P1 в указанном виде не поддерживается этим тестом. Столкнувшись с единственным уверенным ответом, участники едва различали: они позволяли агенту действовать в 84% правильных ответов, но также в 60% неправильных (Δ = 0.238, 95% ДИ [0.14, 0.34]; условия вмешательства 0.465 [0.38, 0.55] и 0.422 [0.32, 0.52]). Дисплей несогласия почти удвоил калибровку (объединенный Δ = 0.446; b = +0.217, p = .0002, скорректированный по Holm p = .0005; Welch d = 0.67), и это произошло с обеих сторон одновременно: избыточное доверие снизилось (60% → 43% и 51%), в то время как недостаточное доверие также снизилось (16% → 10% и 7%) (Рисунок 20). Этот объединенный средний показатель несется одним элементом и лучше всего рассматривается как подтверждение наличия эффекта, а не как надежное среднее: на единственном испытании с высокоуверенным несогласием, которое контрольные участники принимали на 74%, дисплей сократил принятие неправильного ответа до 24%, и с удаленным испытанием подтверждающий контраст больше не значим (d = 0.09, p = .54), в то время как удаление любого другого единственного элемента оставляет его нетронутым (d = 0.47–0.89). Исследовательское разложение ниже (Таблицы 17–18) локализует эффект элемент за элементом. Его концентрация соответствует той же зависимости от наличия разрыва, о которой сообщается на уровне стран: дисплей закрывает калибровочный разрыв только там, где он существует, и один из шести элементов открыл его широко.
Рисунок 20. Что дисплей несогласия делает с доверием (основная группа)
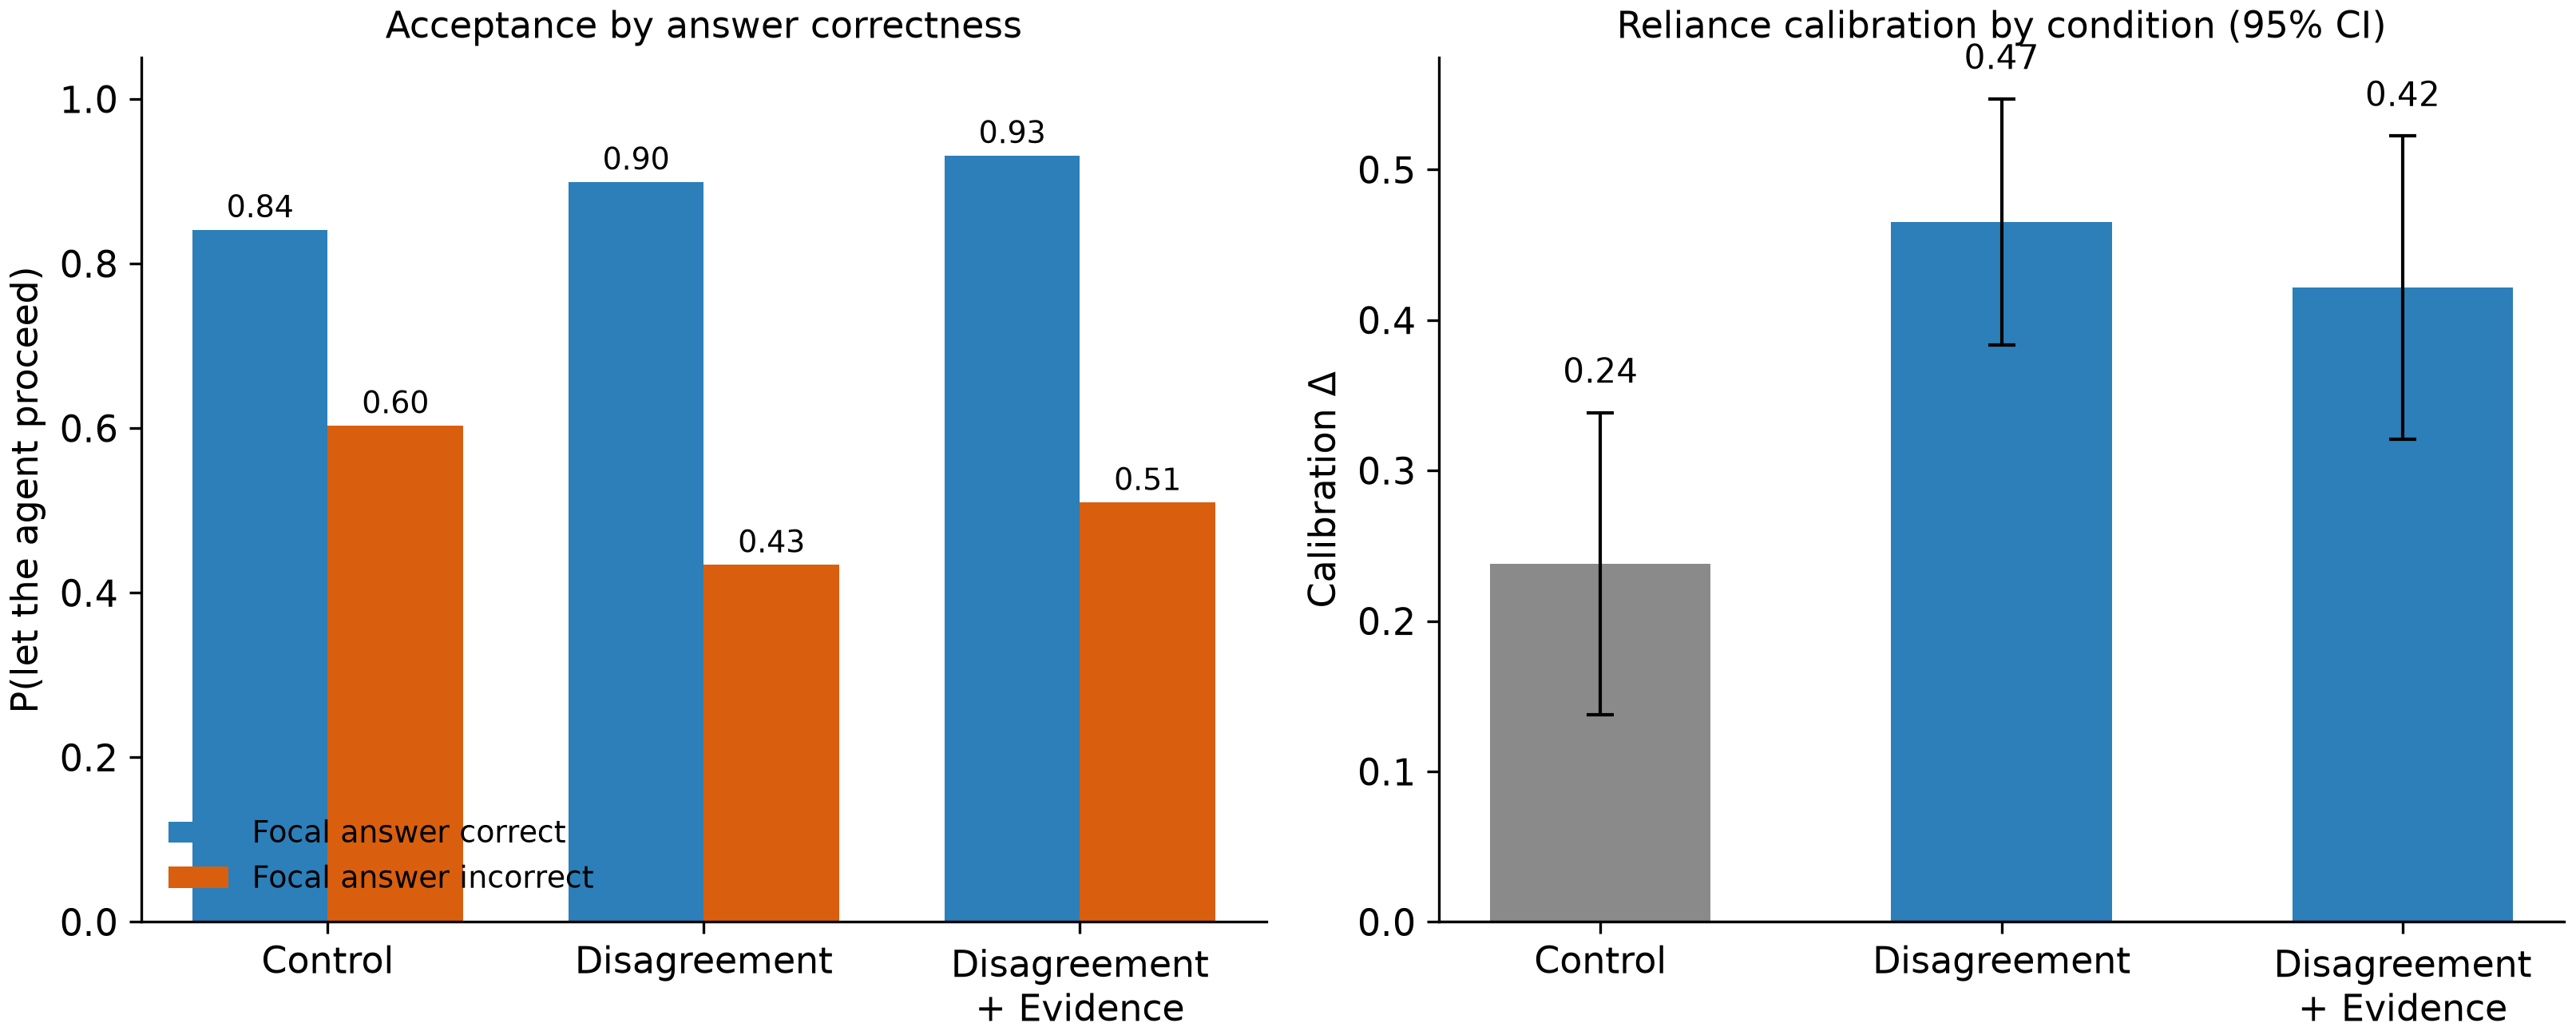
Слева: показатели принятия по условиям, разделенные в зависимости от правильности основного ответа (калибровка = разрыв между двумя столбцами). Справа: показатель калибровки на участника Δ по условиям с 95% ДИ; подтверждающий контраст объединяет два условия несогласия против контроля.
Предварительно зарегистрированная двусторонняя формулировка существовала, потому что литература о втором мнении документирует вмешательства, которые достигают снижения избыточного доверия ценой повышения недостаточного доверия; это вмешательство не потребовало этого компромисса. Сигнал сделал участников более различающими, а не более скептичными, и анализ обнаружения сигнала совокупных показателей дает численные значения: чувствительность d′ повысилась с 0.74 в контроле до 1.44 и 1.46 в условиях вмешательства (вычислено из неокругленных показателей), в то время как критерий ответа едва сдвинулся (−0.63 vs −0.56 и −0.76). Модель со смешанными эффектами на уровне испытания восстанавливает ту же структуру, с большими положительными взаимодействиями правильность × условие для обоих условий вмешательства. Все зарегистрированные ветви согласны: объединенная ветвь надежности (b = +0.215, p = .0001, d = 0.68) и ветвь анализа по намерению лечения, сохраняющая все завершенные сеансы основной волны независимо от отказов проверок (b = +0.2174 vs +0.2169 по протоколу, p = .0001, n = 138), с исключениями, сбалансированными по условиям (8/6/5; χ²(2) = 0.34, p = .85), проверка дифференциального отсева §6.1 обязывает (исключения проверки манипуляции представляют собой постлечебное обусловливание, согласно Montgomery, Nyhan, & Torres, 2018, отсюда равный статус необусловленной ветви). Один смешивающий фактор в плане уточняет интерпретацию. Условия несогласия отличаются от контроля не только в том, что говорит сигнал, но и в количестве показываемого — три позиции и уверенности вместо одной, поэтому прирост калибровки может в принципе отражать объем информации, а не содержание сигнала согласия. Два наблюдения выступают против интерпретации об объеме без окончательного решения: эффект отслеживает направление отображаемого сигнала элемент за элементом, поскольку на неправильных основных элементах, где дисплей показывал несогласие, принятие снизилось, в то время как на единственном элементе, где дисплей показывал единодушное уверенное согласие, принятие неправильного ответа повысилось; и взаимодействие на уровне испытания связано с правильностью ответа, которую один только объем не предсказывает. Чистая различающая ветвь, несколько систем, показанные согласованными на каждом испытании с объемом информации, остающимся постоянным, указана для следующей волны.
H2 не подтверждена. Среди участников, которым уже была показана демонстрация разногласий, расписка не произвела выявляемого воздействия на композитный показатель делегирования при достигнутой мощности (3.45 против 3.09; b = +0.41, p = .29; объединённая ветвь b = +0.34, p = .33; надёжность композита: основная волна Кронбаха α = .89). Три предварительно зарегистрированных вторичных результата определяют, как следует интерпретировать нулевой результат. Расписка была получена: медианное время сеанса в условии с распиской было примерно на полторы минуты больше, чем в условии разногласия (11.0 против 9.4 минут; синхронизация на уровне экрана не была зафиксирована в выгруженных данных, поэтому общая продолжительность используется вместо зарегистрированного прокси времени воздействия стимула). Дополнительное время не свидетельствует о том, что участники пользовались распиской. Полученная расписка была статической карточкой, и её функция «просмотр полной записи» не была активна в опросе, поэтому манипуляция проверяла наличие расписки, а не её использование. Расписка с интерактивной детализацией — это более мощная манипуляция, которую включает следующий дизайн. Это нулевой результат для одной демонстрации статической расписки, а не для записей, проверяемости или P2 в том виде, в котором она сформулирована. Расписка также сдвинула свой предварительно зарегистрированный медиатор. Воспринимаемый контроль над процессом возрос в условии с распиской (a = +0.60; надёжность шкал, основная волна: контроль над процессом α = .93, риск α = .83, нейтральность α = .90), контроль над процессом сильно предсказывает делегирование (b = +0.60), и косвенный путь начальной загрузки положителен и исключает ноль (косвенный = +0.35, 95% ДИ [+0.02, +0.78], 5000 ресэмплирований), тогда как прямой путь близок к нулю. Это разведочное свидетельство опосредования: медиатор измерялся после воздействия в одном и том же инструменте, поэтому дисперсия, связанная с методом, и обратная интерпретация остаются возможными. Чувствительность ограничивает, что может разрешить этот нулевой результат. Реализованные ячейки выявляют d ≈ 0.49 при мощности .80 только при зарегистрированном N, поэтому эффект расписки размером, который подразумевает путь опосредования, — это в точности размер, который эта выборка не может разрешить. Результат является неубедительным относительно малых и средних эффектов и решающим только против больших. Формально эквивалентное тестирование ограничивает эффект только грубо (TOST устанавливает |d| < 0.64 при α = .05, не |d| < 0.5), и коэффициент Байеса JZS даёт BF₀₁ ≈ 2.9 (объединённая ветвь 3.1), анекдотичное свидетельство в пользу нулевого результата по стандартным полосам (на или чуть за границей анекдотичного/умеренного граничного значения 3); оно ни не демонстрирует отсутствие, ни не поддерживает наличие. Раздел об измерениях предсказал это: проверяемость — это свойство по требованию, и её ценность должна проявиться в момент спора, претензии или аудита, поэтому статическая расписка, прочитанная один раз при гипотетической покупке, может быть неправильным моментом для её наблюдения. Зарегистрированное заключение: тест первого контакта P2 не сдвинул делегирование, и экономика расписки со стороны оператора (Раздел 5) не зависит от этого результата со стороны потребителя. Остаются два прочтения: либо компонент свидетельства вносит вклад в меньшей степени в момент принятия решения, чем утверждает фреймворк, либо эта операционализация является неправильной проверкой его. Гипотеза времени спора — это апостериорная гипотеза, запланированная как последующий дизайн, названный в конце этого раздела, а не разрешение нулевого результата. Третье прочтение исходит из литературы по неприятию. Подробная расписка — это манипуляция заметностью, раскрытие механизма, которое напоминает потребителю, насколько много может пойти не так в момент делегирования, парадокс прозрачности, при котором процедурные детали подавляют доверие вместо того, чтобы его строить (Kizilcec, 2016; Dietvorst, Simmons, & Massey, 2015). Эти конкурирующие прочтения, более слабый, чем заявленный, компонент, неправильный момент проверки и обратное срабатывание от заметности, делают разные предсказания и могут быть разделены дизайном.
Режим ошибки сертифицированного консенсуса, воспроизведённый в человеческом поведении. Один стимулируемый денежным вознаграждением испытание нёс, по дизайну, подлинную ошибку консенсуса, со всеми тремя системами уверенно сходящимися на одном неправильном ответе, отражая показатель ошибки открытой формы консенсуса 0.5–2.2%, который измеряет исследование механизма. На этом испытании, одном пункте и, следовательно, наблюдении, а не оценке, демонстрация разногласий не защитила никого и в обеих странах директивно увеличила принятие неправильного ответа (на 4 и 14 процентных пункта относительно контроля): участники рационально прочитали единодушное независимое согласие как сертификацию. Поэтому один систематический режим отказа архитектуры передаёт своим пользователям с высокой точностью. Раздел 3 дал предупреждение о дизайне, что консенсус удостоверяет ошибку именно там, где разнообразие панели не срабатывает, и зонд показывает этот же отказ в поведении.
Разведочное: где приземляется выгода калибровки.
Всё, что следует ниже, является разведочным и гипотезопорождающим. Ячейки по странам малы, и каждое значение p внутри страны ниже следует читать как описательное. Эффект калибровки концентрировался почти целиком в выборке Великобритании и отсутствовал в выборке США:
Таблица 17. Калибровка Δ по странам и условиям (разведочное)
| Контроль Δ | Разногласие (объединённо 2, 3) Δ | Величина эффекта внутри страны | |
| UK (n = 79) | +0.103 (n = 26) | +0.447 (n = 53) | d = +1.19 |
| US (n = 40 primary / 54 pooled) | +0.458 / +0.433 | +0.444 / +0.471 | d = −0.05 / +0.13 |
| Взаимодействие страны × условия | b = −0.36, p = .002 (primary); b = −0.31, p = .004 (pooled) |
Декомпозиция более информативна, чем взаимодействие. Участники контрольной группы США уже проявляли четкую дискриминацию без каких-либо архитектурных сигналов, принимая 92% правильных и только 48% неправильных ответов, в то время как участники контрольной группы Великобритании едва ли проявляли дискриминацию вообще (78% против 68%). При отображении несогласия две страны становились почти неразличимы по пунктам (максимальная разница в ячейке 0.07 во всех шести пробах). Вмешательство привело обе выборки к одной и той же конечной точке калибровки (Δ ≈ +0.45), уравняв исходную разницу, которую оно не создало (Рисунок 21). Часть этого паттерна механическая. Δ ограничен, поэтому доступное пространство сокращается по мере роста исходной калибровки, и «выигрыш концентрируется там, где исходная калибровка слабее всего» — это отчасти свойство меры. Однако потолок сам по себе не приводит к идентичным конечным точкам или соответствию профиля по пунктам. Наиболее обоснованное чтение состоит в том, что шесть пунктов были достаточно легкими для одной панели, чтобы дискриминировать без посторонней помощи, поэтому отображение закрывает разрыв калибровки там, где он существует. Это чтение о пространстве, а не о нациях, и в равной степени о стимулах: сам набор пунктов был культурно перекошен (два диссентерских пункта содержали локальное содержание США), поэтому профиль сходимости является свойством этих шести пунктов столько же, сколько и этих двух панелей.
Рисунок 21. Сходимость, а не однородный ответ (разведочное)
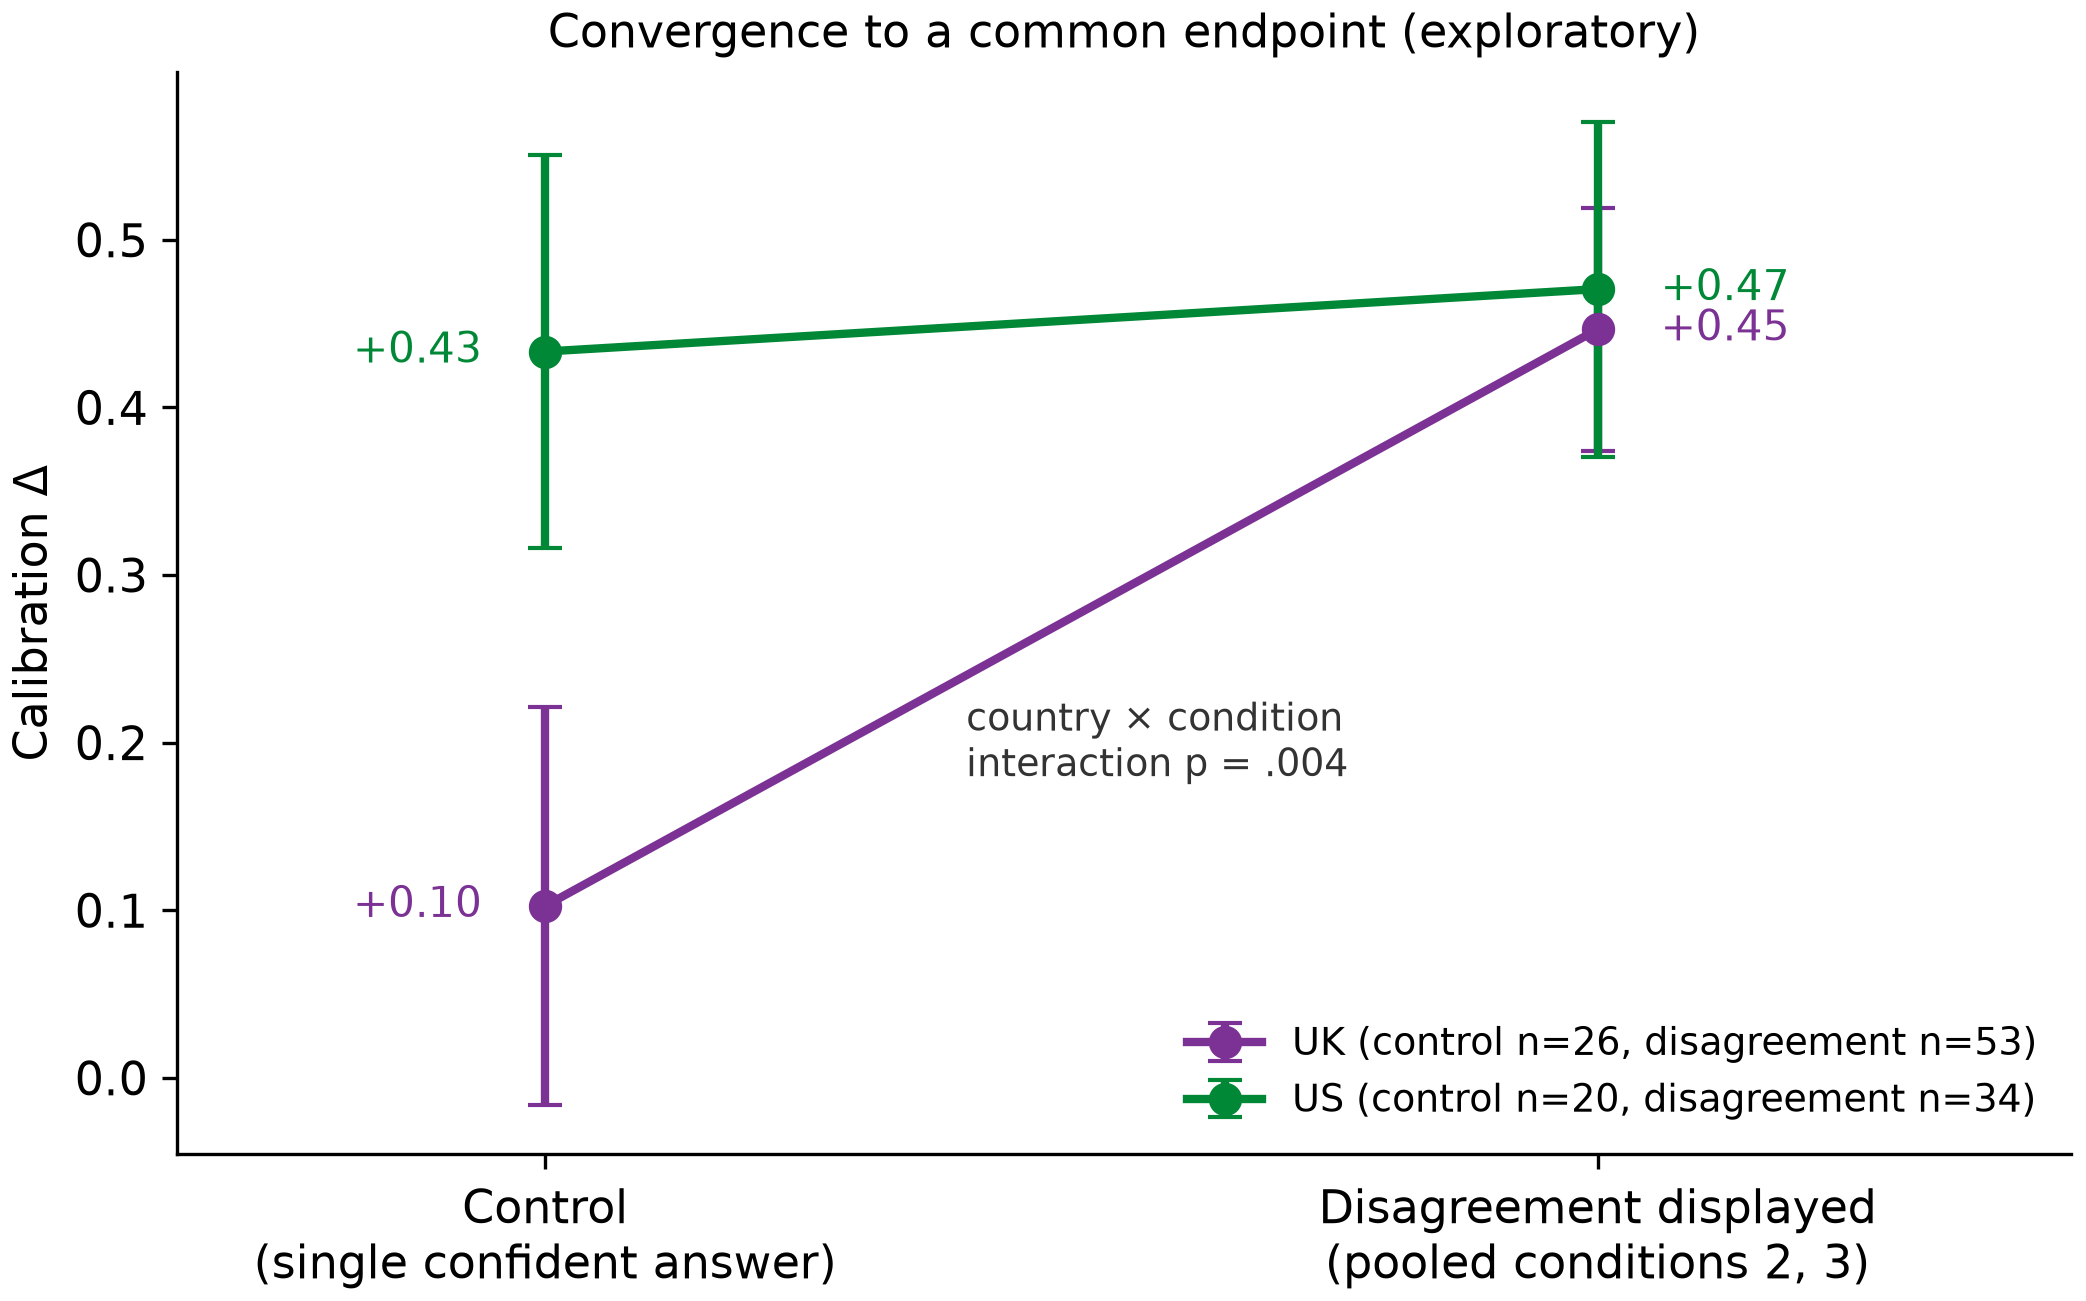
Калибровка Δ по странам и условиям: контрольная группа США уже дискриминирует (Δ ≈ +0.45); контрольная группа Великобритании едва ли (Δ ≈ +0.10); при отображении несогласия обе страны приходят к одной и той же конечной точке (Δ ≈ +0.45). Выигрыш концентрируется именно там, где исходная калибровка слабее всего.
Преимущество США в контрольной группе, в свою очередь, сосредоточено на двух диссентерских пунктах с вероятным локальным содержанием США. Один — это вопрос из Museum of Bad Art, на который неправильный ответ, «Мона Лиза», абсурден для всех, кто знает предпосылку музея (принятие США 5% против Великобритании 27%). Концентрация на этих двух пунктах указывает на знакомство на уровне пункта, а не на национальный темперамент.
Таблица 18. Принятие неправильных фокальных ответов по пунктам и ячейкам (разведочное; объединенная когорта)
| Ячейка | Ошибка диссентера, доверие 95 (пункт «Мона Лиза») | Ошибка диссентера, доверие 98 (пункт ICM-city) | Ошибка консенсуса, доверие 99 |
| UK Control (n = 26) | 0.27 | 0.85 | 0.92 |
| US Control (n = 20) | 0.05 | 0.60 | 0.80 |
| UK Disagreement (n = 53) | 0.21 | 0.25 | 0.96 |
| US Disagreement (n = 34) | 0.18 | 0.24 | 0.94 |
Защитный эффект вмешательства почти полностью сосредоточен на пункте диссентера с высокой уверенностью (Великобритания −0.60, США −0.36); на пункте ошибки консенсуса отображение немного увеличивает принятие в обеих странах — единогласное согласие читается как сертификация, поведенческий образ сертифицированных ошибок консенсуса из исследования механизма. Поскольку защитный эффект сосредоточен на этом одном пункте, объединенный подтверждающий контраст не выживает при его удалении (d = 0.09, p = .54), хотя он выживает при удалении любого другого отдельного пункта (d = 0.47–0.89) — количественная форма эффекта, переносимая одним пунктом.
Таблица 19. Шкалы отношений по странам (разведочное; объединенная когорта): разрыв поведенческий, а не установочный
| Шкала (1–7 если не указано иное) | Среднее значение Великобритании | Среднее значение США | Направление |
| Доверие к ИИ до воздействия | 4.68 | 4.70 | идентично |
| Готовность делегировать (составная) | 2.94 | 3.43 | США выше (p = .08) |
| Лестница делегирования (0–4) | 1.71 | 1.98 | США выше (p = .08) |
| Воспринимаемый риск | 5.54 | 5.13 | США ниже (p = .09) |
| Воспринимаемый контроль процесса | 4.17 | 4.56 | США выше (p = .14) |
| Воспринимаемая нейтральность | 4.75 | 4.62 | н.з. |
Каждое существующее различие в отношении указывает в «неправильном» направлении для учета скептицизма США: участники США более готовы делегировать и менее восприимчивы к риску, но все же лучше дискриминируют поведенчески в контрольной группе. Измеренные отношения не объясняют это вообще: корректировка исходного различия между странами с учетом демографии и всех пяти шкал ослабляет его максимум на 15%, а результаты бутстреппинга косвенных путей через шкалы незначимы.
Кросс-национальные исследования согласны с установочным нулем. Заявленная готовность доверять ИИ практически идентична в США и Великобритании (41% против 42%: Gillespie et al., 2025), и обе страны находятся в одном и том же кластере высокой осторожности «Англосфера» в отношении нервозности ИИ (Ipsos, 2025). Единственная асимметрия на уровне населения, указывающая на наблюдаемое направление, — это грамотность в области ИИ. Респонденты из Великобритании сообщают о меньшем навыке и уверенности в использовании и оценке ИИ (36% против 42% по навыкам: Gillespie et al., 2025), и взрослые в США входят в число наиболее подвергнутых воздействию ИИ публик, опрошенных (Pew Research Center, 2025). Таким образом, два объяснения выживают в разведочной записи. На основе объяснения знакомства население, менее оснащенное для оценки совета ИИ, получает больше всего от архитектуры, которая оценивает это структурно. Другое объяснение — состав панели: британское подразделение платформы набора персонала — это его более старый и более опытный пул, и онлайн-панели несовершенные инструменты для межстранового вывода (Gvirtz & Sabherwal, 2024), поэтому метка «страна» может частично проксировать стаж панели. Дизайн не может разделить эти два объяснения и не нужно это делать, потому что в любом случае существенный вывод — это сам компенсаторный профиль. Учитывая размеры ячеек, более безопасное значение по умолчанию — читать паттерн как свойство этих двух панелей до тех пор, пока репликация с достаточной мощностью не даст ответ; ни одно теоретическое утверждение в этой статье на этом не основано.
Этот профиль не является типичным результатом вмешательств против чрезмерного доверия. Функции когнитивного принуждения снижают чрезмерное доверие, но концентрируют свои преимущества среди пользователей, уже обладающих высокой потребностью в познании, поэтому аналитически ориентированные пользователи становятся ещё более аналитичными (Buçinca et al., 2021), а исследования адаптивной калибровки доверия рассматривают целевое воздействие на некалиброванных пользователей как цель проектирования, требующую активного контроля (Okamura & Yamada, 2020). Здесь целевой отбор произошел автоматически. Отображаемое разногласие является самоактивирующимся: оно появляется ровно тогда, когда группа не согласна, и не требует ничего от пользователя заранее. Его преимущество приносило пользу ровно той группе, которая имела самое слабое исходное различение, и оставило точность уже откалиброванной группы неизменной вместо деградации. Для механизма защиты потребителей — это профиль распределения, который можно было бы предусмотреть заранее, с концентрацией помощи там, где концентрируется некалиброванность, и без налога на тех, кто в нём не нуждается.
Предварительно зарегистрированные вторичные анализы: оставшийся реестр.
Оставшиеся предварительно зарегистрированные вторичные анализы расположены здесь в одном месте (основная когорта; объединённые по ветвям значения в пакете репликации). Опосредование эффекта разногласия через воспринимаемый риск, путь P1, который предусмотрел дизайн, оказалось нулевым. Отображение, напротив, слегка снизило воспринимаемый риск (a = −0,40), и косвенный путь bootstrap неотличим от нуля (+0,006, 95% CI [−0,013, +0,029]). Эффект калибровки является прямым, согласуется с тем, что участники используют паттерн разногласия как информацию об ответе, а не как общий сигнал тревоги о транзакции. Воспринимаемая нейтральность оркестратора, измеренная, а не манипулируемая, является сильным коррелятом готовности к делегированию с контролем условия и страны (b = +0,47, p < 0,0001), корреляционный след, который предсказывает P3, ожидающий манипуляции. Лестница делегирования показывает то же упорядочение, что и композит, без достижения значимости (упорядоченная логистическая регрессия, квитанция vs разногласие: b = +0,70, p = 0,11; медианы совпадают на 2 из 4). Незарегистрированный контраст условия 3 к 1 по делегированию имеет направленно положительное и незначимое значение (b = +0,52, p = 0,15). Одно отклонение: загруженный экспорт не зафиксировал синхронизацию уровня экрана, поэтому зарегистрированный прокси времени на стимуле чтения квитанции приблизительно равен общей продолжительности сеанса (отчёт в H2 выше). Предусмотренная проверка на уровне экрана должна быть встроена в инструмент следующей волны.
Данное исследование проверяет только P1 и P2. P3 измеряется, а не манипулируется, а P4 и полная совместная вариация в совместном варианте раздела 5 остаются следующим указанным исследованием. Поведенческая валидация триады, таким образом, неполная: один компонент поддержан, один неубедительный, один измеренный, но неманипулируемый. Один продольный вопрос стоит над программой. Постоянное отображение разногласия может стабилизировать долгосрочное принятие, как амортизатор колебаний между оценкой алгоритма и отвращением с первого отказа, или может истощить это принятие посредством постоянного воздействия отказов машины. Единовременный дизайн не может это сказать. Два исследования, мотивированные результатами выше, добавлены к программе. Одно — это дизайн в момент спора, который повторно тестирует квитанцию в момент, когда предсказывается её ценность, используя контроль ложной квитанции, квитанцию, чьё хеширование не пересчитывается, чтобы отделить проверяемость от способа её отображения. Другое — это репликация, усиленная для модерирования по странам, указанного выше (Table 17).
7. Заключение
По мере того как ИИ опосредует решения потребителей, имеющие последствия, и всё чаще их принимает, я утверждал, что доверие должно мигрировать вверх в стеке: от модели к архитектуре, к записи. Разнообразие, доказательства и нейтральность вместе создают сервис, надёжность которого можно проверить, а не принять на веру. Строится не улучшенная убеждение, а инфраструктура экономического доверия, цепочка подотчётности, которая позволяет масштабировать делегирование. Флагманская волна измеряет это на вершине рынка. В совокупности по десяти полным флагманским плечам волны модели, продаваемые как лучшие разработки каждой лаборатории, были уверенно неправильны почти на половине их разрешённых ответов, предложенных при указанной уверенности ≥ 80 (46,6%, и цифра едва движется, когда нерешённые элементы переоцениваются как ошибки). Частичное плечо Meta сообщается отдельно, и его включение оставляет цифру практически неизменной. Фиксированный трёхмодельный вентиль разногласия над ними, без обучения и без настройки, удаляет четыре пятых этих отказов при указанной, проверяемой стоимости покрытия. Поскольку субстрат здесь чисто фактический, эту цифру следует читать как верхний предел для смешанных коммерческих задач. То, что обосновало бы претензию на применение в практической коммерции, — это основанная на поиске, использующая инструменты репликация на ограниченном меню продуктов, где ошибки консенсуса ведут себя иначе, чем в открытом фактическом пространстве. Предварительно зарегистрированный эксперимент (раздел 6) поместил тот же архитектурный сигнал перед потребителями и вернул доказательство того, что они могут использовать его как сигнал правильности: отображение разногласия снизило принятие уверенно неправильной рекомендации с 74% до 24% в квалифицирующемся элементе. В разведывательном разделении по странам оно концентрируется в чрезмерно доверчивой ячейке Великобритании и опирается на этот единственный элемент (объединённый контраст не пережил его удаления, d = 0,09). Это доказательство существования при этих стимулах, ещё не общий эффект; подтверждающий тест, выбранный по стимулам, запланирован.
Этот слой заслуживает собственного рыночного названия, инфраструктура доказательств, чтобы продаваться так же, как облачная, идентификационная и платёжная инфраструктура, потому что это отвечает на тот же вид вопроса: «на это можно полагаться, и как бы мы это узнали?» Это другой вопрос, чем «это умно?» Безопасность и приватность пошли этим путём: дифференциатор, потом ожидание, потом требование входа. Архитектурное доверие, вероятно, может следовать по тому же пути, в темпе, установленном нормативным и ответственностью давлением, уже видимым.
Мой тезис с теоретической стороны состоит в том, что единицей анализа для доверия потребителя к услугам на основе ИИ следует перейти от модели к архитектуре, потому что релевантные для доверия свойства на самом деле находятся там: независимость верификации, воспроизводимость решений, отсутствие конфликта интересов. Модели постоянно меняются в каждой услуге быстрее, чем может отслеживать репутация. Разрыв в производительности между закрытыми и открытыми моделями сократился с 8,04% до 1,70% за один год (Stanford HAI, 2025), и лидерство на рынке корпоративных моделей сменилось за одну весну (Kharazian, 2026). Слой, который товаризируется столь быстро, не является местом, где может якориться доверие. То, что служит потребителю, всё больше маршрутизируется через модели и ценовые уровни, управляемое стоимостью, невидимое и непроверенное, а выбранная лучшая модель обслуживает всё меньше и меньше. Шаг, который остаётся, и именно его я здесь определяю, — это переход от архитектуры с наилучшей маршрутизацией к архитектуре, чья верификация может быть достаточно долго удержана потребителем, страховщиком или регулятором для проверки. Под этим лежит переход от ИИ-ассистентов к ИИ-фидуциариям. Фидуциарии во всех областях, где они когда-либо существовали, конституируются не своими талантами, а своими обязанностями: вести записи, подвергаться аудиту, не иметь неправомерного интереса. Архитектурное доверие встраивает эти обязанности в механизм.
То же требование применяется к тому, как растёт сама система. Система, просящая доверия для действий с последствиями, должна расти так же, как она отвечает, проверяемо. Изменения конфигурации на уровне оркестрации должны фиксироваться или откатываться через аудированные статистические шлюзы против задержанных данных, без каких-либо автоматизированных процессов, ослабляющих правило безопасности, только добавляющих его. Развёртывание исследования в примере реализует эти шлюзы.
Инфраструктура ИИ теперь нуждается в слое верификации (Figure 16). Индустрия построила слой вычислений и слой моделей и сейчас строит слой оркестрации. После него идёт верификация, механизм, который делает поведение системы ИИ проверяемым, а не заслуживающим доверия. Основание доверия к ИИ должно стать машинно-проверяемым, а не репутационным; само доверие остаётся человеческим, а то, что может быть проверено машиной, — это его основания. Если это верно, то следующий незаменимый слой инфраструктуры ИИ будет построен не вокруг интеллекта, а вокруг верифицируемости.
Figure 16. Лестница инфраструктуры
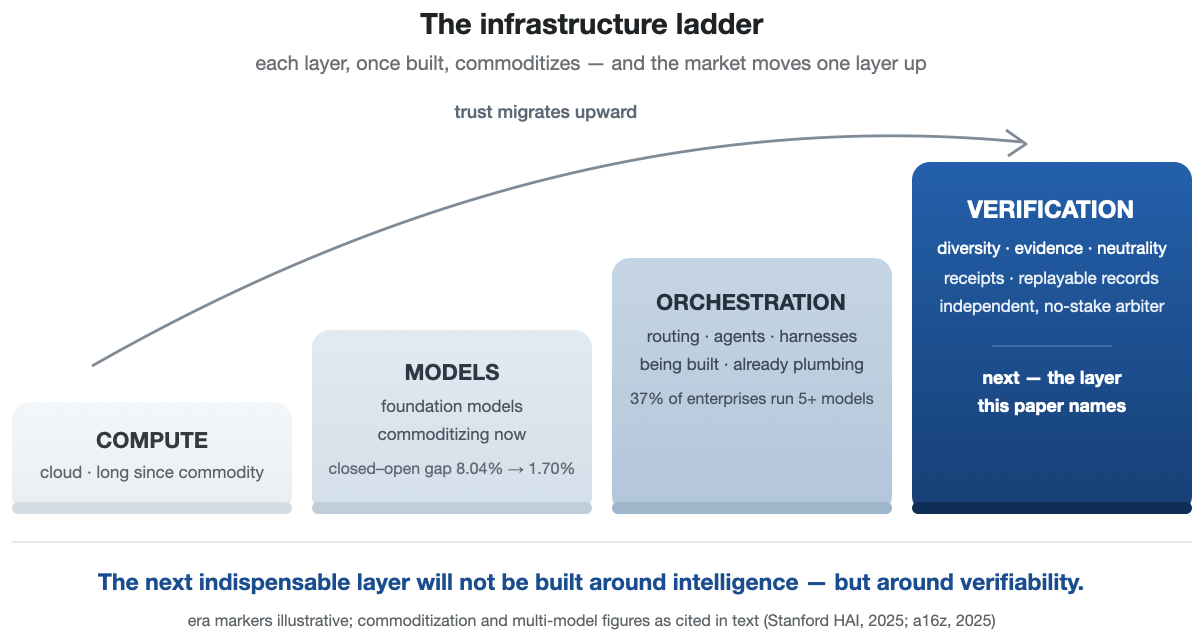
Вычисления, затем модели, затем оркестрация и верификация как следующий незаменимый слой.
Примечание и раскрытие информации автора
Развёртывание, описанное в Разделе 4, является эталонной реализацией, построенной и управляемой автором; методы, которые оно воплощает, являются открытыми, и автор является названным истцом в ожидающих рассмотрения заявок на патенты, а не выданных патентов, охватывающих оркестрацию ИИ и системы валидации нескольких моделей вида, который исследует данная статья. Он служит здесь как исследовательский инструмент исследования, и автор имеет интерес разработчика в архитектуре, которую он воплощает; Раздел 4 следует читать как доказательство существования и показание о проектировании, а не как независимую оценку. Все модели в этом исследовании были доступны через стандартные коммерческие API поставщиков на обычных условиях. Никакое внешнее финансирование не поддерживало эту работу.
Инструменты и верификация. ИИ-ассистенты использовались как инструменты под руководством автора; идеи, исследование и выводы принадлежат автору. Критические фактические утверждения проверены против первичных источников, где они доступны, и указаны в тексте с их доказательственным статусом (пресс-релизы как пресс-релизы, утверждения как утверждения, препринты как препринты), и датированный журнал верификации утверждений ведётся с рабочими материалами рукописи. Правильность в эксперименте никогда не оценивается какой-либо панельной моделью (оценка — объективное совпадение строк или локальный оценщик с открытыми весами), числа дискриминации и калибровки для каждого поставщика печатаются в основном тексте (Таблицы 7 и 7a), и каждое сообщённое число пересчитываемо из детерминированного пакета репликации (общедоступно по https://osf.io/jtvu9/).
Доступность данных и кода
Каждое сообщённое число в экспериментах механизма (Раздел 3) пересчитываемо из детерминированного пакета репликации — необработанные ответы модели обеих волн (включая коллекцию шестнадцати моделей с 24 000 ответами и оценённые записи главной волны), сборщики коллекций, детерминированный оценщик, скрипты анализа и производные CSV (включая кривые покрытия риска и 26-точечную границу затрат–точности, причём для каждой точки отмечена основа выставленной-к-рекомендованной цены) — общедоступно по https://osf.io/jtvu9/, общедоступный компонент проекта предварительной регистрации (папка `replication-package-v2`; архив программы самокалибрации Раздела 3 депонирован рядом с ним). Замороженная подвыборка SimpleQA (зафиксирована по seed и SHA-256 хешу) уже общедоступна в предварительной регистрации OSF исследования механизма (https://osf.io/4y9dv, зарегистрирована 23 июля 2026). Предварительная регистрация эксперимента с потребителем зарегистрирована на OSF под эмбарго (заморожена перед основным сбором данных; регистрация https://osf.io/pqeg6/?view_only=87eb0a88579647b48e93d4a475795d5f). Пул участников закрыт; инструмент опроса, виньетка и стимулы блока суждения, записи выпуска квитанций Раздела 6 и данные эксперимента с потребителем с замороженным кодом анализа будут выпущены в тот же компонент OSF при публикации.
Литература
Записи, отмеченные arXiv, являются препринтами; промышленные объявления и пресс-релизы 2026 года являются современными отчётами, а не устоявшейся литературой, и цитируются как таковые.
a16z — Andreessen Horowitz (2025). Как 100 корпоративных ИТ-директоров строят и приобретают генеративный ИИ в 2025 году. a16z.com/ai-enterprise-2025.
Accenture (2026). Поговори с моим ИИ-агентом: новые правила ценности бренда. Опрос 25 590 потребителей в 16 странах, январь 2026.
ACI Worldwide (2026). Отношение потребителей к покупкам и платежам, управляемым ИИ. Опрос YouGov 2 080 взрослых в Великобритании, проведён 19–22 июня 2026 года. Пресс-релиз.
Ahmad Husairi, M., & Rossi, P. (2024). Делегирование задач покупки ИИ: роль воспринимаемого выбора и автономии решения. Decision Support Systems, 179, 114166. DOI 10.1016/j.dss.2023.114166.
AIUC (2025). AIUC-1: стандарт агента. Artificial Intelligence Underwriting Company.
Alavi, S., & Nozari, S. (2026). Когда агенты делают покупки за вас: ролевая согласованность в рынках, опосредованных ИИ. arXiv:2604.26220.
Allouah, A., Besbes, O., Figueroa, J. D., Kanoria, Y., & Kumar, A. (2026). What is your AI agent buying? Evaluation, biases, model dependence, and emerging implications of agentic e-commerce. Proceedings of the ACM Web Conference 2026, 8697–8700. https://doi.org/10.1145/3774904.3792943
American Express (2026). American Express debuts Agentic Commerce Experiences (ACE) developer kit and announces industry-first protection for registered agent purchases. Пресс-релиз, 14 April 2026.
Anderson, L. (2006). Analytic autoethnography. Journal of Contemporary Ethnography, 35(4), 373–395.
André, Q., Carmon, Z., Wertenbroch, K., Crum, A., Frank, D., Goldstein, W., Huber, J., van Boven, L., Weber, B., & Yang, H. (2018). Consumer choice and autonomy in the age of artificial intelligence and big data. Customer Needs and Solutions, 5(1–2), 28–37.
Appenzeller, G. (2024). Welcome to LLMflation: LLM inference cost is going down fast. Andreessen Horowitz, November 2024.
Aubakirova, M., Atallah, A., Clark, C., Summerville, J., & Midha, A. (2026). State of AI: An empirical 100 trillion token study with OpenRouter. arXiv:2601.10088 (доклад выпущен December 2025).
Bain & Company (2025). Agentic commerce market projection: $300–500 billion U.S. e-commerce by 2030. December 2025.
Bainbridge, L. (1983). Ironies of automation. Automatica, 19(6), 775–779.
Balaskas, S. (2026). From recommendations to delegation: A systematic review mapping agentic AI in e-commerce and its consumer effects. Information, 17(3), 222.
Bansal, G., Wu, T., Zhou, J., Fok, R., Nushi, B., Kamar, E., Ribeiro, M. T., & Weld, D. S. (2021). Does the whole exceed its parts? The effect of AI explanations on complementary team performance. Proceedings of the 2021 CHI Conference on Human Factors in Computing Systems, 1–16.
Basu, A. (2026). Tool receipts, not zero-knowledge proofs: Practical hallucination detection for AI agents. arXiv:2603.10060.
Board of Governors of the Federal Reserve System & OCC (2011). Supervisory guidance on model risk management (SR Letter 11-7 / OCC 2011-12).
Buçinca, Z., Malaya, L. B., & Gajos, K. Z. (2021). To trust or to think: Cognitive forcing functions can reduce overreliance on AI in AI-assisted decision-making. Proceedings of the ACM on Human-Computer Interaction, 5(CSCW1), 1–21.
Burton, J. W., Stein, M.-K., & Jensen, T. B. (2020). A systematic review of algorithm aversion in augmented decision making. Journal of Behavioral Decision Making, 33(2), 220–239.
California State Legislature (2025). Assembly Bill 316 (artificial intelligence: defenses), Stats. 2025, ch. 672 (adding Cal. Civ. Code § 1714.46), effective 1 January 2026.
Carlson, S. C. (2026). Trust migration in the digital era: Information regimes and the transformation of buyer–seller relationships. Atlantic Marketing Journal, 15(1), Article 6.
Castelo, N., Bos, M. W., & Lehmann, D. R. (2019). Task-dependent algorithm aversion. Journal of Marketing Research, 56(5), 809–825.
Cetinkaya, N. E., & Krämer, N. (2024). Understanding vs. trust: A conjoint analysis. Рабочий документ, OSF Project mw4dq.
Chandra, K., Kleiman-Weiner, M., Ragan-Kelley, J., & Tenenbaum, J. B. (2026). Sycophantic chatbots cause delusional spiraling, even in ideal Bayesians. arXiv:2602.19141.
Chen, C., Sun, Y., Liao, M., & Sundar, S. S. (2026). When AI disagrees: The effect of second opinion on patients' trust in doctors. International Journal of Human-Computer Studies, 213, 103824.
Cheng, M., Lee, C., Khadpe, P., Yu, S., Han, D., & Jurafsky, D. (2026). Sycophantic AI decreases prosocial intentions and promotes dependence. Science, 391(6792), eaec8352. DOI: 10.1126/science.aec8352.
Choi, H. K., Zhu, X., & Li, S. (2026). When identity skews debate: Anonymization for bias-reduced multi-agent reasoning. Proceedings of the 64th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), 14284–14311. https://doi.org/10.18653/v1/2026.acl-long.650
Choi, M., Kim, K., Chae, S., & Baek, S. (2025). An empirical study of group conformity in multi-agent systems. Findings of the Association for Computational Linguistics: ACL 2025, 5123–5139. https://doi.org/10.18653/v1/2025.findings-acl.265
Clark, J., & Hadfield, G. K. (2020). Regulatory markets for AI safety. arXiv:2001.00078.
CNBC (2026, March 24). OpenAI revamps shopping experience in ChatGPT after struggling with Instant Checkout offering (reporting The Information's March 2026 account of the native-checkout pullback).
Daly, C. (2025). Klarna slows AI-driven job cuts with call for real people. Bloomberg News, 8 May 2025.
de Bellis, E., & Johar, G. V. (2020). Autonomous shopping systems: Identifying and overcoming barriers to consumer adoption. Journal of Retailing, 96(1), 74–87.
Detjen, H. H. J., Densky, L., von Kalckreuth, N., & Kopka, M. (2025). Who is trusted for a second opinion? Comparing collective advice from a medical AI and physicians in biopsy decisions after mammography screening. CHI 2025.
de Visser, E. J., Pak, R., & Shaw, T. H. (2018). From 'automation' to 'autonomy': The importance of trust repair in human–machine interaction. Ergonomics, 61(10), 1409–1427.
Dietvorst, B. J., Simmons, J. P., & Massey, C. (2015). Algorithm aversion: People erroneously avoid algorithms after seeing them err. Journal of Experimental Psychology: General, 144(1), 114–126.
DigiCert (2026). AI Trust Architecture. Объявление о продукте, April 2026.
Ding, K. (2026). When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv:2607.08065.
Dranove, D., & Jin, G. Z. (2010). Quality disclosure and certification: Theory and practice. Journal of Economic Literature, 48(4), 935–963.
Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2024). Improving factuality and reasoning in language models through multiagent debate. Proceedings of the 41st International Conference on Machine Learning, PMLR 235, 11733–11763.
Endsley, M. R., & Kiris, E. O. (1995). The out-of-the-loop performance problem and level of control in automation. Human Factors, 37(2), 381–394.
Errico, H. (2026). Autonomous action runtime management (AARM): A system specification for securing AI-driven actions at runtime. arXiv:2602.09433.
European Commission (2026). Руководящие принципы по применению требований прозрачности для определённых систем искусственного интеллекта в соответствии со статьей 50 Закона об искусственном интеллекте. Утверждено 20 июля 2026.
Farquhar, S., Kossen, J., Kuhn, L., & Gal, Y. (2024). Обнаружение галлюцинаций в больших языковых моделях с использованием семантической энтропии. Nature, 630(8017), 625–630.
Featherman, M. S., & Pavlou, P. A. (2003). Прогнозирование принятия электронных услуг: перспектива граней воспринимаемого риска. International Journal of Human-Computer Studies, 59(4), 451–474.
Frank, D.-A., Folwarczny, M., & Otterbring, T. (2026). Принятие потребителями высокоавтономных помощников ИИ определяется ощущаемыми преимуществами в условиях онлайн-покупок, характеризующихся дефицитом. Psychology & Marketing, 43(3), 538–555. https://doi.org/10.1002/mar.70074
Gartner (2025). Gartner предсказывает, что более 40% проектов агентского ИИ будут отменены к концу 2027 года. Пресс-релиз, 25 июня 2025.
Gartner (2026). Опрос потребителей по генеративному искусственному интеллекту в покупках (пресс-релиз май 2026).
Gefen, D., Karahanna, E., & Straub, D. W. (2003). Доверие и TAM при онлайн-покупках: интегрированная модель. MIS Quarterly, 27(1), 51–90.
Geifman, Y., & El-Yaniv, R. (2017). Селективная классификация для глубоких нейронных сетей. Advances in Neural Information Processing Systems 30 (NeurIPS 2017), 4878–4887 (arXiv:1705.08500).
Gillespie, N., Lockey, S., Ward, T., Macdade, A., & Hassed, G. (2025). Доверие, отношение и использование искусственного интеллекта: глобальное исследование 2025. The University of Melbourne и KPMG. https://doi.org/10.26188/28822919
Glikson, E., & Woolley, A. W. (2020). Доверие человека к искусственному интеллекту: обзор эмпирических исследований. Academy of Management Annals, 14(2), 627–660.
Google (2026). Universal Commerce Protocol. Объявление на NRF, 11 января 2026; расширение для корзины, каталога и связывания идентичности, март 2026.
Google Cloud (2025). Agent Payments Protocol (AP2). Объявление, 16 сентября 2025.
Google DeepMind (2025). SimpleQA Verified. arXiv:2509.07968.
Gorbett, M., & Jana, S. (2026). Несогласие между моделями как сигнал правильности без метки. arXiv:2603.25450.
Gottweis, J., Weng, W.-H., Daryin, A., Tu, T., Sirkovic, P., Myaskovsky, A., Glowaty, G., Weissenberger, F., Orlandi, A., Popovici, D., Palepu, A., Rong, K., Tanno, R., Saab, K., Zhang, F., Blum, J., Carroll, A., Kulkarni, K., Tomašev, N., Zverinski, D., Rendulic, I., Vedadi, E., Hasler, F., Rimanic, L., Boia, M., Budiselic, I., Feinstein, B., Bellaiche, M., Sheffer, T., Freyberg, J., Ratcliff, J., Bertolli, O., Chou, K., Hassidim, A., Gokturk, B., Vahdat, A., Guan, Y., Dhillon, V., Vaishnav, E. D., Lee, B., Costa, T. R. D., Penadés, J. R., Peltz, G., Matias, Y., Manyika, J., Hassabis, D., Xu, Y., Kohli, P., Pawlosky, A., Karthikesalingam, A., & Natarajan, V. (2026). Ускорение научных открытий с помощью Co-Scientist. Nature, 655(8122), 487–496. https://doi.org/10.1038/s41586-026-10644-y
Gould, S. J. (1991). Самоманипулирование моей всепроникающей, воспринимаемой жизненной энергией посредством использования продукта: интроспективно-практическая перспектива. Journal of Consumer Research, 18(2), 194–207.
Guo, C., Pleiss, G., Sun, Y., & Weinberger, K. Q. (2017). О калибровке современных нейронных сетей. ICML 2017, PMLR 70, 1321–1330.
Gvirtz, A., & Sabherwal, A. (2024). Пределы проведения глобальных, кросс-культурных исследований поведенческой науки. Proceedings of the National Academy of Sciences, 121(36), e2316690121.
Hadfield, G. K. (2017). Правила для плоского мира: почему люди изобрели право и как его переизобрести для сложной глобальной экономики. Oxford University Press.
Hadfield, G. K., & Clark, J. (2026). Нормативные рынки: будущее управления ИИ. Jurimetrics, 65, 195–240 (arXiv:2304.04914).
Hansen, L. K., & Salamon, P. (1990). Ансамбли нейронных сетей. IEEE Transactions on Pattern Analysis and Machine Intelligence, 12(10), 993–1001.
Hao, X., Wu, Z., Qiu, Y.-X., Xiao, C., Xu, R., Zheng, S., & Qin, J. (2026). Не все смены позиции обусловлены конформностью: декомпозиция конвергенции позиций в многоагентных дискуссиях LLM. arXiv:2606.00820.
Hoff, K. A., & Bashir, M. (2015). Доверие к автоматизации: интеграция эмпирических данных о факторах, влияющих на доверие. Human Factors, 57(3), 407–434.
Hong, L., & Page, S. E. (2004). Группы разнообразных решателей проблем могут превосходить группы высокоспособных решателей проблем. Proceedings of the National Academy of Sciences, 101(46), 16385–16389.
Huang, M.-H., & Rust, R. T. (2021). Стратегическая основа для искусственного интеллекта в маркетинге. Journal of the Academy of Marketing Science, 49(1), 30–50.
Insurance Services Office (2026). Формы одобрения CG 40 47 и CG 40 48: исключения генеративного искусственного интеллекта. Действует с 1 января 2026.
Internet Engineering Task Force (2026). Архитектура надежных и прозрачных цифровых цепочек поставок (RFC 9943; рабочая группа SCITT). IETF. https://datatracker.ietf.org/doc/rfc9943/
Ioku, T., Song, J., & Watamura, E. (2024). Компромиссы при выборе помощника ИИ: приоритизируют ли потребители прозрачность и устойчивость над производительностью помощника ИИ? Big Data & Society, 11(4).
Ipsos (2025). Монитор ИИ Ipsos 2025. Ipsos Global Advisor, опрос 30 стран, июнь 2025.
Jacovi, A., Marasović, A., Miller, T., & Goldberg, Y. (2021). Формализация доверия к искусственному интеллекту: предпосылки, причины и цели доверия человека к ИИ. FAccT 2021, 624–635.
Kadavath, S., Conerly, T., Askell, A., Henighan, T., Drain, D., Perez, E., Schiefer, N., Hatfield-Dodds, Z., DasSarma, N., Tran-Johnson, E., Johnston, S., El-Showk, S., Jones, A., Elhage, N., Hume, T., Chen, A., Bai, Y., Bowman, S., Fort, S., ... Kaplan, J. (2022). Языковые модели (в основном) знают, что они знают. arXiv:2207.05221.
Kalai, A. T., Nachum, O., Vempala, S., & Zhang, E. (2025). Почему языковые модели галлюцинируют. arXiv:2509.04664.
Kharazian, A. (2026). Anthropic обгоняет OpenAI по корпоративному внедрению. Ramp Economics Lab / Ramp AI Index, 13 мая 2026 (данные корпоративных платежей в 50 000+ компаниях США).
Kim, D., & Benbasat, I. (2010). Проектирование эффективной реализации гарантий доверия в интернет-магазинах. Communications of the ACM, 53(2), 121–126.
Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Коррелированные ошибки в больших языковых моделях. Proceedings of the 42nd International Conference on Machine Learning, PMLR 267, 30038–30066.
Kim, P. H., Ferrin, D. L., Cooper, C. D., & Dirks, K. T. (2004). Развеивание тени подозрения: влияние извинений и отрицания на восстановление доверия, нарушенного компетентностью или целостностью. Journal of Applied Psychology, 89(1), 104–118.
Kizilcec, R. F. (2016). Сколько информации? Влияние прозрачности на доверие в алгоритмическом интерфейсе. CHI 2016, 2390–2395.
Klarna (2024). Помощник искусственного интеллекта Klarna обрабатывает две трети чатов обслуживания клиентов в первый месяц. Пресс-релиз, 27 февраля 2024 г.
Köbis, N., Rahwan, Z., Rilla, R., Supriyatno, B. I., Bersch, C., Ajaj, T., Bonnefon, J.-F., & Rahwan, I. (2025). Делегирование искусственному интеллекту может усилить нечестное поведение. Nature, 646(8083), 126–134. DOI: 10.1038/s41586-025-09505-x.
Kolt, N. (2025). Управление агентами искусственного интеллекта. Notre Dame Law Review, 101 (рабочий документ SSRN 4772956; arXiv:2501.07913).
Komiak, S. Y. X., & Benbasat, I. (2006). Влияние персонализации и знакомства на доверие и внедрение агентов рекомендаций. MIS Quarterly, 30(4), 941–960.
König, P. D., Wurster, S., & Siewert, M. B. (2022). Потребители готовы платить за объяснимый, но не за экологичный искусственный интеллект: свидетельства анализа выбора на основе совместного анализа. Big Data & Society, 9(1).
Krogh, A., & Vedelsby, J. (1995). Ансамбли нейронных сетей, перекрестная валидация и активное обучение. Advances in Neural Information Processing Systems, 7, 231–238.
Kroll, J. A., Huey, J., Barocas, S., Felten, E. W., Reidenberg, J. R., Robinson, D. G., & Yu, H. (2017). Подотчётные алгоритмы. University of Pennsylvania Law Review, 165(3), 633–705.
Kuncheva, L. I., & Whitaker, C. J. (2003). Меры разнообразия в ансамблях классификаторов и их связь с точностью ансамбля. Machine Learning, 51(2), 181–207.
Lee, J. D., & See, K. A. (2004). Доверие к автоматизации: разработка надлежащей поддержки. Human Factors, 46(1), 50–80.
Lessig, L. (2006). Код: версия 2.0. Basic Books.
Li, M. (2025). От облачно-ориентированного к доверию-ориентированному: протокол для проверяемых многоагентных систем. arXiv:2507.22077.
Liang, P., Bommasani, R., Lee, T., Tsipras, D., Soylu, D., Yasunaga, M., Zhang, Y., Narayanan, D., Wu, Y., Kumar, A., Newman, B., Yuan, B., Yan, B., Zhang, C., Cosgrove, C., Manning, C. D., Ré, C., Acosta-Navas, D., Hudson, D. A., ... Koreeda, Y. (2023). Комплексная оценка языковых моделей. Transactions on Machine Learning Research.
Liao, Q. V., & Sundar, S. S. (2022). Разработка ответственного доверия в системах искусственного интеллекта: перспектива коммуникации. FAccT 2022, 1257–1268.
Lin, S., Hilton, J., & Evans, O. (2022). Обучение моделей выражению неопределённости словами. arXiv:2205.14334.
Lindsey, J. (2025). Возникающее интроспективное осознание в больших языковых моделях. Anthropic / Transformer Circuits.
Liu, J., Bursztyn, V. S., Ai, L., Wang, H., Choudhary, S., Mitra, S., & Wu, Q. (2026). TeamFusion: поддержка открытой командной работы с многоагентными системами. arXiv:2604.19589 (ACL 2026; Adobe Research).
Lizzeri, A. (1999). Раскрытие информации и посредники сертификации. RAND Journal of Economics, 30(2), 214–231.
Logg, J. M., Minson, J. A., & Moore, D. A. (2019). Признание алгоритмов: люди предпочитают алгоритмическое суждение человеческому. Organizational Behavior and Human Decision Processes, 151, 90–103.
Longoni, C., Bonezzi, A., & Morewedge, C. K. (2019). Сопротивление медицинскому искусственному интеллекту. Journal of Consumer Research, 46(4), 629–650.
Longoni, C., Cian, L., & Kyung, E. J. (2023). Алгоритмический перенос: люди чрезмерно обобщают неудачи искусственного интеллекта в правительстве. Journal of Marketing Research, 60(1), 170–188.
Lorenz, J., Rauhut, H., Schweitzer, F., & Helbing, D. (2011). Как социальное влияние может подорвать эффект мудрости толпы. Proceedings of the National Academy of Sciences, 108(22), 9020–9025. DOI: 10.1073/pnas.1008636108.
Lu, Z., Wang, D., & Yin, M. (2024). Помогает ли больше совета? Влияние второго мнения в принятии решений с помощью искусственного интеллекта. Proceedings of the ACM on Human-Computer Interaction, 8(CSCW1), 1–31.
Marchal, N., Chan, S., Franklin, M., Revel, M., Keeling, G., Fischli, R., Chandra, B., & Gabriel, I. (2026). Архитектура доверия в искусственных эпистемических агентах. arXiv:2603.02960.
Mastercard (2026). Проверяемое намерение (разработано совместно с Google). Пресс-анонс, 5 марта 2026 г.; ранние пилотные проекты сообщаются на азиатских и латиноамериканских рынках, 2026 г.
Mayer, R. C., Davis, J. H., & Schoorman, F. D. (1995). Интегративная модель организационного доверия. Academy of Management Review, 20(3), 709–734.
McKinsey & Company (2025). Возможность агентивной коммерции (Schumacher, Roberts, & Giebel). 17 октября 2025 г.
McKnight, D. H., Choudhury, V., & Kacmar, C. (2002). Разработка и валидация мер доверия для электронной коммерции. Information Systems Research, 13(3), 334–359.
Menlo Ventures (2025a). Обновление рынка LLM в середине 2025 года. 31 июля 2025 г. (опрос 150 технических лиц, принимающих решения).
Menlo Ventures (2025b). 2025: состояние генеративного искусственного интеллекта на предприятии. 9 декабря 2025 г. (опрос 495 специалистов по принятию решений в области искусственного интеллекта на предприятиях США; Menlo Ventures является инвестором Anthropic).
Menlo Ventures (2025c). 2025: состояние потребительского искусственного интеллекта. 26 июня 2025 г. (опрос 5031 взрослого американца совместно с Morning Consult; показатель оплачивающих пользователей ~3% является оценкой, полученной из доходов).
Möhlmann, M., & Zalmanson, L. (2017). Руки на руле: навигация по алгоритмическому управлению и автономии водителей Uber. ICIS 2017.
Montgomery, J. M., Nyhan, B., & Torres, M. (2018). Как обусловленность переменными после воздействия может испортить ваш эксперимент и что с этим делать. American Journal of Political Science, 62(3), 760–775.
Morgan Stanley (2025). Прогноз агентивной коммерции: расходы США на электронную коммерцию в размере 190–385 миллиардов долларов к 2030 году. Декабрь 2025 г.
Mosier, K. L., & Skitka, L. J. (1996). Люди, принимающие решения, и автоматизированные вспомогательные средства принятия решений: созданы ли они друг для друга? В R. Parasuraman & M. Mouloua (Ред.), Автоматизация и производительность человека: теория и приложения (с. 201–220). Lawrence Erlbaum Associates.
Mozannar, H., & Sontag, D. (2020). Состоятельные оценки для обучения делегированию эксперту. ICML 2020, PMLR 119, 7076–7087.
Muchnik, L., Aral, S., & Taylor, S. J. (2013). Предвзятость социального влияния: рандомизированный эксперимент. Science, 341(6146), 647–651. DOI: 10.1126/science.1240466.
Muir, B. M. (1994). Доверие к автоматизированным системам: Часть I. Теоретические вопросы изучения доверия и вмешательства человека в автоматизированные системы. Ergonomics, 37(11), 1905–1922.
NIST (2023). Структура управления рисками искусственного интеллекта (AI RMF 1.0) (NIST AI 100-1). Национальный институт стандартов и технологий.
Okamura, K., & Yamada, S. (2020). Адаптивная калибровка доверия для сотрудничества человека и ИИ. PLOS ONE, 15(2), e0229132.
Papamarkou, T., Alquier, P., Bauer, M., Buntine, W., Davison, A., Dziugaite, G. K., Filippone, M., Foong, A. Y. K., Fortuin, V., Fouskakis, D., Frellsen, J., Hüllermeier, E., Karaletsos, T., Khan, M. E., Kotelevskii, N., Lahlou, S., Li, Y., Liu, F., Lyle, C., Möllenhoff, T., Palla, K., Panov, M., Sale, Y., Schweighofer, K., Shelmanov, A., Swaroop, S., Trapp, M., Waegeman, W., Wilson, A. G., & Zaytsev, A. (2026). Позиция: оркестровка агентного ИИ должна быть состоятельной по Байесу. arXiv:2605.00742. (Принято на ICML 2026.)
Parasuraman, R., & Manzey, D. H. (2010). Самоуспокоенность и предвзятость в использовании человеком автоматизированных систем: интеграция внимания. Human Factors, 52(3), 381–410. DOI: 10.1177/0018720810376055.
Parasuraman, R., & Riley, V. (1997). Люди и автоматизация: использование, неправильное использование, отказ от использования, злоупотребление. Human Factors, 39(2), 230–253.
Parasuraman, R., Sheridan, T. B., & Wickens, C. D. (2000). Модель типов и уровней взаимодействия человека с автоматизированными системами. IEEE Transactions on Systems, Man, and Cybernetics — Part A: Systems and Humans, 30(3), 286–297.
Pavlou, P. A. (2003). Принятие потребителями электронной коммерции: интеграция доверия и риска с моделью принятия технологии. International Journal of Electronic Commerce, 7(3), 101–134.
Pew Research Center (2025). Как люди по всему миру воспринимают ИИ. Опрос в 25 странах, октябрь 2025.
Piehlmaier, D. M. (2023). Одноактный спектакль: влияние совместного принятия решений на чрезмерную уверенность инвесторов. Journal of Consumer Research, 50(2), 426–446. https://doi.org/10.1093/jcr/ucac054
Puntoni, S., Reczek, R. W., Giesler, M., & Botti, S. (2021). Потребители и искусственный интеллект: опытная перспектива. Journal of Marketing, 85(1), 131–151.
Rabanser, S., Kapoor, S., Kirgis, P., Liu, K., Utpala, S., & Narayanan, A. (2026). К науке надежности агентов ИИ. arXiv:2602.16666 (ICML 2026).
Raji, I. D., Xu, P., Honigsberg, C., & Ho, D. (2022). Надзор со стороны посторонних: проектирование экосистемы аудита третьей стороной для управления ИИ. AIES 2022, 557–571.
Regulation (EU) 2016/679 (Общее положение о защите данных), статья 22 — автоматизированное принятие решений в отношении отдельных лиц.
Regulation (EU) 2024/1689 (Закон об искусственном интеллекте), статья 14 — надзор человека над системами ИИ высокого риска; статья 50 — обязательства в области прозрачности для поставщиков и разработчиков определенных систем ИИ.
Ríos-García, M., Alampara, N., Gupta, C., Mandal, I., Mannan, S., Aghajani, A. A., Krishnan, N. M. A., & Jablonka, K. M. (2026). Ученые ИИ получают результаты без научного обоснования. arXiv:2604.18805.
Saad-Falcon, J., Buchanan, E. K., Chen, M. F., Huang, T.-H., McLaughlin, B., Bhathal, T., Zhu, S., Athiwaratkun, B., Sala, F., Linderman, S., Mirhoseini, A., & Ré, C. (2025). Сокращение разрыва между генерацией и верификацией с помощью слабых верификаторов. arXiv:2506.18203.
Sabater, J., & Sierra, C. (2005). Обзор моделей вычислительного доверия и репутации. Artificial Intelligence Review, 24(1), 33–60.
Schemmer, M., Kühl, N., Benz, C., Bartos, A., & Satzger, G. (2023). Надлежащая опора на рекомендации ИИ: концептуализация и влияние объяснений. IUI '23, 410–422.
Schilke, O., & Reimann, M. (2025). Дилемма прозрачности: как раскрытие информации об ИИ подрывает доверие. Organizational Behavior and Human Decision Processes, 188, 104405.
Schmidt, J., & Bijmolt, T. H. A. (2020). Точное измерение готовности платить за потребительские товары: метаанализ гипотетического смещения. Journal of the Academy of Marketing Science, 48, 499–518.
Shapiro, S. P. (1987). Социальный контроль безличного доверия. American Journal of Sociology, 93(3), 623–658.
Sharma, M., Tong, M., Korbak, T., Duvenaud, D., Askell, A., Bowman, S. R., Cheng, N., Durmus, E., Hatfield-Dodds, Z., Johnston, S. R., Kravec, S., Maxwell, T., McCandlish, S., Ndousse, K., Rausch, O., Schiefer, N., Yan, D., Zhang, M., & Perez, E. (2024). К пониманию подобострастия в языковых моделях. ICLR 2024 (arXiv:2310.13548).
Shehata, D., & Li, M. (2026). Закон обратной мудрости: архитектурный трибализм и парадокс консенсуса в агентных роях. arXiv:2604.27274.
Sheridan, T. B., & Verplank, W. L. (1978). Человеческое и компьютерное управление подводными телеоператорами (Технический отчет). MIT Man-Machine Systems Laboratory.
Smit, A. P., Duckworth, P., Grinsztajn, N., Barrett, T. D., & Pretorius, A. (2024). Должны ли мы использовать MAD? Анализ стратегий многоагентных дебатов для LLM. ICML 2024, PMLR 235, 45883–45905 (arXiv:2311.17371).
Söllner, M., Hoffmann, A., & Leimeister, J. M. (2016). Почему разные отношения доверия имеют значение для пользователей информационных систем. European Journal of Information Systems, 25(3), 274–287.
Spiro, T. (2026). Отпечаток оракула: коррелированные ошибки прогнозирования ИИ и пределы передачи смещения. arXiv:2605.00844.
Stanford HAI (2025). Отчет об индексе искусственного интеллекта 2025. Stanford Institute for Human-Centered Artificial Intelligence (раздел технической производительности).
Stanford HAI (2026). Отчет об индексе искусственного интеллекта 2026. Stanford Institute for Human-Centered Artificial Intelligence (раздел об общественном мнении, с использованием данных опроса Pew в 25 странах).
Tax, S. S., Brown, S. W., & Chandrashekaran, M. (1998). Оценка потребителями опыта жалоб на обслуживание: последствия для маркетинга отношений. Journal of Marketing, 62(2), 60–76.
Vaccaro, M., Almaatouq, A., & Malone, T. (2024). Когда комбинации людей и ИИ оказываются полезными: систематический обзор и метаанализ. Nature Human Behaviour, 8(12), 2293–2303. DOI: 10.1038/s41562-024-02024-1.
Verga, P., Hofstatter, S., Althammer, S., Su, Y., Piktus, A., Arkhangorodsky, A., Xu, M., White, N., & Lewis, P. (2024). Замена судей на присяжных: оценка результатов LLM с помощью панели разнообразных моделей. arXiv:2404.18796.
Visa (2025). Visa представляет Trusted Agent Protocol: основанную на экосистеме платформу для коммерции ИИ. Пресс-релиз (совместно с Cloudflare), 14 октября 2025.
Visa (2026). Visa заключила партнёрство с OpenAI для развития следующего поколения AI-коммерции. Пресс-релиз, Visa Payments Forum, 10 June 2026.
W3C (2025). Verifiable Credentials Data Model v2.0. Рекомендация W3C.
Wallendorf, M., & Brucks, M. (1993). Introspection in consumer research: Implementation and implications. Journal of Consumer Research, 20(3), 339–359.
Walsham, G. (1995). Interpretive case studies in IS research: Nature and method. European Journal of Information Systems, 4(2), 74–81.
Wang, W., & Benbasat, I. (2005). Trust in and adoption of online recommendation agents. Journal of the Association for Information Systems, 6(3), 72–101.
Wang, Y., Zhang, J., Cai, T., Liu, Z., Sun, Q., Sun, Z., Wu, Z., Dong, M., Zheng, M., Yin, X., & Zhu, Y. (2026). From agent traces to trust: A survey of evidence tracing and execution provenance in LLM agents. arXiv:2606.04990.
Wei, J., Karina, N., Chung, H. W., Jiao, Y. J., Papay, S., Glaese, A., Schulman, J., & Fedus, W. (2024). Measuring short-form factuality in large language models. arXiv:2411.04368.
Werbach, K. (2018). The blockchain and the new architecture of trust. MIT Press.
Wertenbroch, K. (1998). Consumption self-control by rationing purchase quantities of virtue and vice. Marketing Science, 17(4), 317–337.
Xiao, B., & Benbasat, I. (2007). E-commerce product recommendation agents: Use, characteristics, and impact. MIS Quarterly, 31(1), 137–209.
Yalcin, G., Lim, S., Puntoni, S., & van Osselaer, S. M. J. (2022). Thumbs up or down: Consumer reactions to decisions by algorithms versus humans. Journal of Marketing Research, 59(4), 696–717.
Yin, R. K. (2018). Case study research and applications: Design and methods (6th ed.). Sage.
Zhang, Y., Liao, Q. V., & Bellamy, R. K. E. (2020). Effect of confidence and explanation on accuracy and trust calibration in AI-assisted decision making. Proceedings of the 2020 ACM Conference on Fairness, Accountability, and Transparency, 295–305.
Zheng, J., & Zhang, J. (2026). Uncertainty-aware trust estimation for multi-LLM systems via structured expert judgement. arXiv:2607.20529.
Zuboff, S. (2019). The age of surveillance capitalism. PublicAffairs.
Zucker, L. G. (1986). Production of trust: Institutional sources of economic structure, 1840–1920. Research in Organizational Behavior, 8, 53–111.
* Архитектор систем AI. Конфликт интересов: автор разрабатывает методы оркестрации многомодельных систем, управляет эталонной реализацией описанной здесь архитектуры, является одним из заявителей в поданных патентных заявках (невыданные патенты) по системам оркестрации AI и валидации многомодельных систем такого рода, какие исследует данная статья, и имеет интерес разработчика в архитектуре, которую защищает данная статья; нормативные утверждения о её необходимости следует читать с учётом этого интереса. Роль автора при развёртывании раздела 4 описана в авторском примечании и в разделе раскрытия информации в конце этой статьи. Приветствуются комментарии: vadimchernets9@gmail.com.↩︎
Как цитировать
Chernets, V. (2026). Architectural Trust: Why Consumer Trust in Agentic Commerce Migrates from AI Models to Verifiable Architecture [Препринт]. SSRN. https://doi.org/10.2139/ssrn.7191261
@misc{chernets2026architecturaltrust,
  author       = {Chernets, Vadym},
  title        = {{Architectural Trust: Why Consumer Trust in Agentic Commerce Migrates from AI Models to Verifiable Architecture}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7191261},
  url          = {https://doi.org/10.2139/ssrn.7191261}
}